

Фильтрация Вьеториса — Рипса в MQL5: Построение симплексов и граничной матрицы
 115
 0

Содержание
- Введение: от облака точек к форме
- Фильтрация на графике
- Симплексы: строительные блоки
- Фильтрация Вьеториса — Рипса
- Реализация: CTDARips
- Сортировка и поиск за O(1)
- Граничная матрица над Z/2
- Реализация: CTDABoundary
- Разбор примера и проверка корректности
- Что дальше?
- Заключение
Введение: от облака точек к форме
В предыдущей статье были получены два конкретных геометрических объекта: облако точек, полученное с помощью вложения Такенса, и его полная матрица попарных расстояний. Эти объекты необходимы, но недостаточны для ответа на интересующие нас топологические вопросы (Существуют ли кластеры? Есть ли длительно сохраняющийся цикл?). Далее нам нужен воспроизводимый и поддающийся вычислению топологический объект, который фиксирует, при каких значениях параметра масштаба эпсилон появляются симплексы по мере увеличения этого параметра: фильтрация Вьеториса — Рипса (а также граничные соотношения, позволяющие вычислять гомологии).
Конкретная задача этой статьи — реализация следующей процедуры: по заданному облаку из N точек, полученному с помощью вложения, и порогу отсечения maxEpsilon перечислить все симплексы размерности не выше maxDim ≤ 2, присвоить каждому симплексу его значение фильтрации (для вершины — 0, для ребра — расстояние между его концами, для треугольника — максимальная из длин трех его ребер) и получить две структуры данных, пригодных для редукции. Реализация должна обеспечивать соблюдение ключевых инвариантов, необходимых для этапа редукции: симплексы отсортированы по значению фильтрации (при равенстве значений приоритет отдается меньшей размерности, так что грани идут перед когранями), таблицы поиска вершин и ребер обеспечивают отображение в глобальные индексы за время O(1), а индексы в каждом столбце граничной матрицы хранятся в порядке возрастания, чтобы его ведущий элемент можно было определить без дополнительных операций. Практические ограничения (число ребер O(N²), число треугольников O(N³)) обусловливают необходимость ограничения размерности и использования таблиц поиска, повышающих скорость работы за счет дополнительного расхода памяти.
Фильтрация на графике
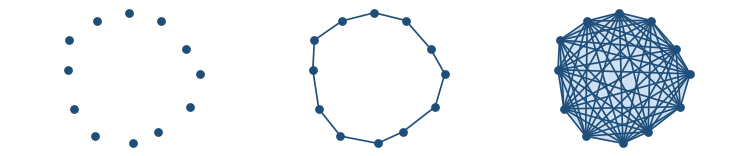
Рис. 1. Одно облако точек в трёх масштабах. При малом значении эпсилон точки изолированы. При среднем значении эпсилон кольцо из ребер образует цикл. При большом значении эпсилон треугольники заполняют цикл, и он исчезает.
Рисунок выше передает суть всей статьи. На нем трижды изображено одно и то же облако точек при трех значениях параметра масштаба, который мы называем эпсилон. Сами точки на всех трех изображениях остаются неизменными. Изменяется лишь правило их соединения.
Слева величина эпсилон невелика. Расстояние между любыми двумя точками превышает эпсилон, поэтому облако состоит лишь из изолированных точек. Здесь двенадцать компонент связности и ни одного цикла. В середине величина эпсилон больше. Теперь каждая точка соединяется со своими соседями, и ребра смыкаются, образуя кольцо. Имеется одна компонента связности и один цикл. Справа величина эпсилон ещё больше. Теперь соединяются и точки на противоположных сторонах кольца, треугольники заполняют его внутреннюю область, и цикл исчезает. Одна компонента связности, без циклов.
Цикл на средней панели — это сигнал. Он возник, когда кольцо замкнулось, и исчез, когда его внутренняя область заполнилась. Диапазон значений эпсилон, в котором цикл существовал, — это его персистентность. Цикл, сохраняющийся длительное время, — это реальная особенность данных. Цикл, который возникает и почти сразу же исчезает, — это шум. В данной статье разрабатывается инструментарий именно для измерения персистентности. Далее объясняется, как он работает.
Симплексы: строительные блоки
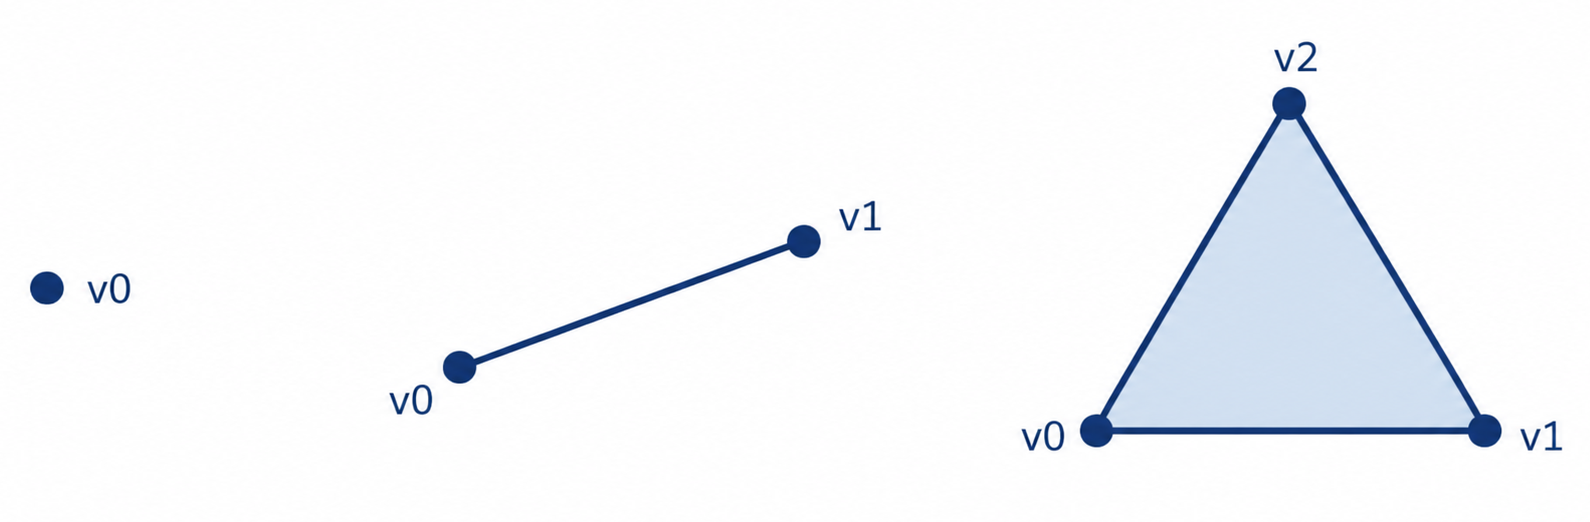
Рис. 2. Три типа симплексов, используемых в этой библиотеке: вершина (размерность 0), ребро (размерность 1) и заполненный треугольник (размерность 2).
Симплициальный комплекс состоит из простых частей, называемых симплексами. 0-симплекс — это одна вершина. 1-симплекс — это ребро, соединяющее две вершины. 2-симплекс — это заполненный треугольник с тремя вершинами. Существуют и симплексы более высоких размерностей (3-симплекс — это тетраэдр вместе с его внутренней областью), но эта библиотека ограничивается треугольниками, которых достаточно для выявления связных компонент и циклов.
Размерность симплекса на единицу меньше числа его вершин. Симплекс-вершина состоит из одной вершины и имеет размерность 0. Ребро имеет две вершины и размерность 1. Треугольник имеет три вершины и размерность 2. Библиотека хранит каждый симплекс в небольшой структуре фиксированного размера.
//+------------------------------------------------------------------+
//| SSimplex - one simplex in the filtration                         |
//|                                                                  |
//|  Stores the vertex set (sorted ascending), the filtration value  |
//|  at which the simplex enters, and its dimension. Up to 3 vertices|
//|  are kept (max dim = 2 = triangle); unused slots hold -1.        |
//+------------------------------------------------------------------+
struct SSimplex
  {
   double   filtration;     // filtration value at which simplex appears
   int      dim;            // 0 = vertex, 1 = edge, 2 = triangle
   int      v[3];           // sorted vertex indices, unused = -1

   void     Reset()
     {
      filtration = 0.0;
      dim        = 0;
      v[0]       = -1;
      v[1]       = -1;
      v[2]       = -1;
     }
  };
Структура содержит три элемента: значение фильтрации, при котором появляется симплекс, его размерность и множество вершин. Массив вершин вмещает три индекса, поскольку треугольник — симплекс наибольшей размерности из тех, что мы строим. Для вершины используется одна ячейка, а в двух остальных остаётся значение -1. Для ребра используются две ячейки. Вершины хранятся в порядке возрастания их индексов, что важно при последующем поиске ребра по его конечным точкам.
Значение фильтрации является ключевым полем. Для вершины это значение равно 0, поскольку каждая точка присутствует с самого начала. Для ребра это расстояние между его двумя конечными точками, поскольку это наименьшее значение эпсилон, при котором ребро появляется в комплексе. Для треугольника это наибольшая из длин трёх его рёбер, поскольку для образования треугольника необходимо наличие всех трёх рёбер. Это единственное правило — значение фильтрации равно длине самого длинного ребра — составляет суть построения Вьеториса — Рипса.
Фильтрация Вьеториса — Рипса
Правило Вьеториса — Рипса применяется механически. Зафиксируем параметр масштаба эпсилон. Тогда:
Ребро (i, j) существует, если расстояние (i, j) ≤ эпсилон. Треугольник (i, j, k) существует, если существуют все три его ребра.
По мере увеличения эпсилон от 0 симплексы только добавляются и никогда не удаляются. При малом значении эпсилон получается разреженный комплекс из изолированных вершин. При большом значении эпсилон получается плотный комплекс, в котором каждая тройка вершин образует заполненный треугольник. Фильтрация представляет собой полную упорядоченную последовательность симплексов, каждый из которых помечен значением эпсилон, при котором он входит в комплекс.
Запись непрерывного диапазона значений эпсилон была бы невозможна. Ключевое наблюдение, позволяющее получить конечное представление фильтрации, состоит в том, что комплекс изменяется только при определённых значениях эпсилон — когда появляется новое ребро или треугольник. Эти значения и есть значения фильтрации симплексов. Поэтому вместо того, чтобы изменять эпсилон по всему непрерывному диапазону, мы строим каждый симплекс один раз, помечаем его значением фильтрации и сортируем всё множество по этому значению. Чтение отсортированного списка от начала до конца точно воспроизводит процесс фильтрации.
В порядке сортировки есть одна тонкость. Если два симплекса имеют одинаковое значение фильтрации, то симплекс меньшей размерности должен стоять первым. Ребро не может появиться раньше своих конечных точек, а треугольник — раньше своих ребер. При равных значениях фильтрации сортировка по размерности гарантирует, что каждый симплекс появляется после своих граней; это условие необходимо для последующего построения граничной матрицы.
Стоит явно указать вычислительные затраты на это построение. Для N точек существует не более N(N-1)/2 ребер и N(N-1)(N-2)/6 треугольников, поэтому количество треугольников растёт пропорционально кубу N. При окне в 80 баров облако точек состоит из 78 точек, а полный комплекс насчитывает десятки тысяч треугольников. Именно из-за этого кубического роста в четвёртой статье установлено ограничение на размер окна, а этап редукции в следующей статье является наиболее ресурсоёмкой частью конвейера.
Реализация: CTDARips
Класс CTDARips выстраивает фильтрацию на основе матрицы расстояний. Он хранит симплексы в одном динамическом массиве, отслеживает число симплексов каждой размерности и предоставляет функции поиска, необходимые модулю построения границ.
//+------------------------------------------------------------------+
//| CTDARips - builds the Vietoris-Rips filtration up to maxDim <= 2 |
//+------------------------------------------------------------------+
class CTDARips
  {
private:
   SSimplex          m_simplices[];     // sorted filtration order
   int               m_count;           // total simplex count (logical size)
   int               m_capacity;        // allocated capacity of m_simplices
   int               m_N;               // number of points
   int               m_maxDim;          // max dim built (<= 2)
   double            m_maxFiltration;   // max filtration value in complex

   int               m_vertexIdx[];     // [N]    : global idx of vertex {v}
   int               m_edgeIdx[];       // [N*N]  : global idx of edge {i,j}
   int               m_dimCount[3];     // simplex count per dim

   //--- helpers
   void              SwapSimplex(int i, int j);
   bool              SimplexLess(int a, int b) const;
   void              QuickSort(int low, int high);
   void              BuildLookups();
   void              EnsureCapacity(int needed);
   void              AppendSimplex(double f, int dim, int v0, int v1, int v2);

public:
                     CTDARips();
                    ~CTDARips() {}

   bool              Build(const CTDADistance &dist,
                           double maxEpsilon,
                           int    maxDim = 2);

   int               Size()          const { return m_count; }
   int               SizeByDim(int d) const;
   double            MaxFiltration() const { return m_maxFiltration; }
   bool              Get(int idx, SSimplex &out) const;

   int               VertexGlobalIdx(int v)      const;
   int               EdgeGlobalIdx(int i, int j) const;
  };
Симплексы хранятся в одном плоском массиве m_simplices, емкость которого увеличивается удвоением по той же схеме с амортизированной оценкой сложности, что была представлена в предыдущей статье. Перечисление симплексов по одному с увеличением размера массива на единицу для каждого из них имело бы квадратичную сложность. Удвоение емкости обеспечивает амортизированную сложность O(1) для каждой операции добавления. Два массива поиска — m_vertexIdx и m_edgeIdx — заполняются после сортировки; их назначение описано в следующем разделе.
В методе Build формируется фильтрация. Метод выполняет три прохода: сначала добавляет вершины, затем ребра, затем треугольники.
//+------------------------------------------------------------------+
//| Build the full Vietoris-Rips filtration                          |
//+------------------------------------------------------------------+
bool CTDARips::Build(const CTDADistance &dist, double maxEpsilon, int maxDim)
  {
   m_N      = dist.Size();
   m_maxDim = (maxDim > 2 ? 2 : (maxDim < 0 ? 0 : maxDim));

   if(m_N < 2)
     {
      Print("TDARips::Build - need at least 2 points");
      return false;
     }
   if(maxEpsilon <= 0.0)
     {
      Print("TDARips::Build - maxEpsilon must be > 0");
      return false;
     }

   //--- reset logical size, keep allocated capacity for reuse
   m_count            = 0;
   m_maxFiltration    = 0.0;
   m_dimCount[0]      = 0;
   m_dimCount[1]      = 0;
   m_dimCount[2]      = 0;

   //--- 0-simplices: every vertex, filtration 0
   for(int i = 0; i < m_N; i++)
      AppendSimplex(0.0, 0, i, -1, -1);

   if(m_maxDim < 1)
     {
      QuickSort(0, m_count - 1);
      BuildLookups();
      return true;
     }

   //--- 1-simplices: edges with d <= maxEpsilon
   for(int i = 0; i < m_N; i++)
      for(int j = i + 1; j < m_N; j++)
        {
         double d = dist.Get(i, j);
         if(d > maxEpsilon) continue;
         AppendSimplex(d, 1, i, j, -1);
        }

   if(m_maxDim < 2)
     {
      QuickSort(0, m_count - 1);
      BuildLookups();
      return true;
     }

   //--- 2-simplices: triangles with all three edges within maxEpsilon
   for(int i = 0; i < m_N; i++)
      for(int j = i + 1; j < m_N; j++)
        {
         double dij = dist.Get(i, j);
         if(dij > maxEpsilon) continue;
         for(int k = j + 1; k < m_N; k++)
           {
            double dik = dist.Get(i, k);
            if(dik > maxEpsilon) continue;
            double djk = dist.Get(j, k);
            if(djk > maxEpsilon) continue;

            double f = MathMax(dij, MathMax(dik, djk));
            AppendSimplex(f, 2, i, j, k);
           }
        }

   //--- sort the entire filtration in ascending order
   QuickSort(0, m_count - 1);
   BuildLookups();
   return true;
  }
Сначала метод ограничивает максимальную размерность диапазоном 0–2 и проверяет корректность входных данных. Затем он сбрасывает логический размер, повторно используя ранее выделенную емкость. После этого выполняется три прохода.
В первом проходе каждая вершина добавляется со значением фильтрации 0. Если при вызове запрошена только размерность 0, метод выполняет сортировку и завершает работу. Во втором проходе перебираются все пары (i, j), где j больше i, считывается расстояние между точками каждой пары и добавляется ребро, если это расстояние не превышает maxEpsilon. Значение фильтрации ребра равно самому расстоянию. В третьем проходе перебираются все тройки (i, j, k), проверяется, что длины всех трех ребер не превышают maxEpsilon, и добавляется треугольник, значение фильтрации которого равно наибольшей из трех длин ребер. Операторы continue позволяют сразу перейти к следующей тройке, как только одно из ребер оказывается слишком длинным, и тем самым избежать считывания третьего расстояния, если уже первое не удовлетворяет условию.
После всех проходов один вызов QuickSort сортирует весь массив сначала по значению фильтрации, а затем по размерности. Заключительный вызов BuildLookups индексирует отсортированные вершины и ребра. После завершения метода Build объект содержит полный список симплексов, упорядоченный в соответствии с фильтрацией.
Сортировка и поиск за O(1)
Компаратор сортировки реализует правило разрешения равенства из теоретического раздела: по возрастанию значения фильтрации, а при равенстве значений — по возрастанию размерности.
//+------------------------------------------------------------------+
//| Sorting order: filtration ascending, ties broken by dim ascending|
//+------------------------------------------------------------------+
bool CTDARips::SimplexLess(int a, int b) const
  {
   if(m_simplices[a].filtration < m_simplices[b].filtration) return true;
   if(m_simplices[a].filtration > m_simplices[b].filtration) return false;
   return (m_simplices[a].dim < m_simplices[b].dim);
  }
Симплекс с меньшим значением фильтрации идет первым. Если значения фильтрации двух симплексов равны, первым идет симплекс меньшей размерности. Это свойство гарантирует, что грани симплекса появляются раньше самого симплекса. Библиотека использует быструю сортировку «на месте» вместо встроенной, поскольку компаратор осуществляет сравнение по трём полям, а массив хранит структуры по значению.
После сортировки положение каждого симплекса в массиве соответствует его глобальному индексу, и именно по этому индексу на него ссылаются все остальные компоненты конвейера. Модуль построения границ, получив треугольник, должен быстро ответить на конкретный вопрос: каков глобальный индекс ребра между вершинами i и j? Просмотр всего массива в поисках этого ребра привел бы к квадратичной сложности построения границы. Таблицы поиска позволяют этого избежать.
//+------------------------------------------------------------------+
//| After sort, build vertex/edge -> global-index lookup tables      |
//+------------------------------------------------------------------+
void CTDARips::BuildLookups()
  {
   ArrayResize(m_vertexIdx, m_N);
   for(int v = 0; v < m_N; v++) m_vertexIdx[v] = -1;

   ArrayResize(m_edgeIdx, m_N * m_N);
   ArrayInitialize(m_edgeIdx, -1);

   for(int s = 0; s < m_count; s++)
     {
      const int dim = m_simplices[s].dim;
      if(dim == 0)
        {
         m_vertexIdx[m_simplices[s].v[0]] = s;
        }
      else if(dim == 1)
        {
         int a = m_simplices[s].v[0];
         int b = m_simplices[s].v[1];
         m_edgeIdx[a * m_N + b] = s;
         m_edgeIdx[b * m_N + a] = s;     // symmetric
        }
     }
  }
Функция BuildLookups заполняет два массива. Таблица вершин позволяет по индексу точки напрямую получить глобальный индекс симплекса, которому принадлежит эта вершина. Таблица ребер представляет собой сетку размером N на N, которая сопоставляет паре индексов точек глобальный индекс соединяющего их ребра или -1, если это ребро отсутствует в комплексе. Записываются оба направления — (i, j) и (j, i), — поэтому вызывающий код может найти ребро без предварительного упорядочивания его вершин. С помощью этих таблиц модуль построения границ находит глобальный индекс любой грани за постоянное время.
Таблица ребер использует N² целых чисел. При размерах окон, используемых в трейдинге, такая таблица содержит несколько тысяч записей и заменяет квадратичный поиск поиском за постоянное время. Тот же компромисс — память в обмен на скорость — используется во всей библиотеке.
Граничная матрица над Z/2
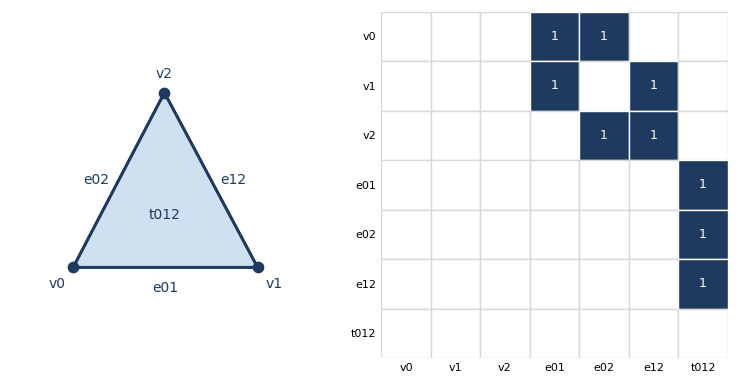
Рис. 3. Граничная матрица над Z/2 для одного заполненного треугольника. В каждом столбце перечислены грани одного симплекса: ребра указывают на две свои вершины, а треугольник — на свои три ребра.
Фильтрация показывает, когда появляется каждый симплекс. Граничная матрица показывает, как симплексы соединяются друг с другом. Граница симплекса образована симплексами размерностью на единицу меньше. Граница ребра — это две вершины, являющиеся его конечными точками. Граница треугольника — это его три ребра. Граница вершины пуста.
Мы работаем над полем Z/2, состоящим из двух элементов, что означает, что коэффициенты принимают значения либо 0, либо 1, а арифметические операции выполняются по модулю 2. Здесь не нужно учитывать знаки и ориентации, благодаря чему матрицу просто хранить, а её редукция выполняется быстро. Столбец либо содержит заданную грань, либо не содержит её. На рисунке выше показана полная матрица для одного заполненного треугольника: три пустых столбца вершин, три столбца ребер, каждый из которых указывает на две вершины, и один столбец треугольника, указывающий на три ребра.
Работа над полем Z/2 также придаёт сложению столбцов простой и ясный смысл. Сумма двух столбцов представляет собой симметрическую разность множеств их граней: грань, присутствующая в обоих множествах, исключается, а грань, присутствующая только в одном из них, сохраняется. Например, при сложении границы ребра (v0, v1) с границей ребра (v1, v2) получается:
{v0, v1} + {v1, v2} = {v0, v2}
Общая вершина v1 встречается дважды и сокращается по модулю 2, так что остаются две крайние вершины. Это сложение посредством симметрической разности множеств — единственная операция, которую алгоритм редукции повторяет тысячи раз в следующей статье, поэтому граница хранится в виде, позволяющем выполнять эту операцию с минимальными затратами.
Реализация: CTDABoundary
Полная граничная матрица размером N × N состояла бы почти исключительно из нулей: граница треугольника содержит лишь три ребра из тысяч. CTDABoundary хранит матрицу в разреженном виде: как плоский список индексов граней и набор смещений для каждого столбца.
//+------------------------------------------------------------------+
//| CTDABoundary - sparse column form of the boundary over Z/2       |
//|                                                                  |
//|  Column j stores the global indices of the (k-1)-faces of the    |
//|  k-simplex at position j in the sorted filtration:               |
//|    - 0-simplex (vertex)    : empty column                        |
//|    - 1-simplex (edge ij)   : {vertex(i), vertex(j)}              |
//|    - 2-simplex (tri ijk)   : {edge(ij), edge(ik), edge(jk)}      |
//+------------------------------------------------------------------+
class CTDABoundary
  {
private:
   int               m_entries[];      // flat face-index storage
   int               m_colStart[];     // start offset of column j
   int               m_colSize[];      // size of column j
   int               m_numCols;        // = number of simplices
   int               m_totalEntries;   // logical size used in m_entries
   int               m_entriesCap;     // allocated capacity of m_entries

   void              Sort3Asc(int &a, int &b, int &c) const;
   void              ReserveEntries(int needed);

public:
                     CTDABoundary();
                    ~CTDABoundary() {}

   bool              Build(const CTDARips &rips);

   int               NumCols()      const { return m_numCols; }
   int               ColSize(int j) const;
   int               Entry(int j, int k) const;
   void              GetColumn(int j, int &out[]) const;
   int               TotalEntries() const { return m_totalEntries; }
  };
Данные хранятся в трёх массивах. Массив m_entries представляет собой один длинный буфер, в котором индексы граней всех столбцов хранятся подряд. Массив m_colStart хранит позицию начала каждого столбца в этом буфере, а массив m_colSize — число записей в каждом столбце. Чтение столбца j означает чтение m_colSize[j] записей, начиная с m_colStart[j]. При этом вся разреженная матрица упаковывается в три массива без лишних нулей.
Метод `Build` один раз проходит по отсортированной фильтрации и записывает по одному столбцу на каждый симплекс.
//+------------------------------------------------------------------+
//| Build the boundary column-by-column over the sorted filtration   |
//+------------------------------------------------------------------+
bool CTDABoundary::Build(const CTDARips &rips)
  {
   m_numCols = rips.Size();
   if(m_numCols <= 0)
     {
      Print("TDABoundary::Build - empty filtration");
      return false;
     }

   ArrayResize(m_colStart, m_numCols);
   ArrayResize(m_colSize,  m_numCols);
   m_totalEntries = 0;
   ReserveEntries(3 * m_numCols);

   for(int j = 0; j < m_numCols; j++)
     {
      SSimplex s;
      rips.Get(j, s);
      m_colStart[j] = m_totalEntries;

      if(s.dim == 0)
        {
         m_colSize[j] = 0;          // vertices have empty boundary
         continue;
        }

      if(s.dim == 1)
        {
         // boundary of edge {i,j} = vertex i + vertex j
         int va = rips.VertexGlobalIdx(s.v[0]);
         int vb = rips.VertexGlobalIdx(s.v[1]);
         int lo = (va < vb ? va : vb);
         int hi = (va < vb ? vb : va);

         m_entries[m_totalEntries]     = lo;
         m_entries[m_totalEntries + 1] = hi;
         m_totalEntries += 2;
         m_colSize[j] = 2;
         continue;
        }

      // boundary of triangle {i,j,k} = edge(i,j) + edge(i,k) + edge(j,k)
      int eab = rips.EdgeGlobalIdx(s.v[0], s.v[1]);
      int eac = rips.EdgeGlobalIdx(s.v[0], s.v[2]);
      int ebc = rips.EdgeGlobalIdx(s.v[1], s.v[2]);
      Sort3Asc(eab, eac, ebc);

      m_entries[m_totalEntries]     = eab;
      m_entries[m_totalEntries + 1] = eac;
      m_entries[m_totalEntries + 2] = ebc;
      m_totalEntries += 3;
      m_colSize[j] = 3;
     }
   return true;
  }
Для каждого симплекса метод сохраняет начальную позицию столбца, а затем выбирает ветвь алгоритма в зависимости от размерности. Для вершины записывается пустой столбец. Для ребра метод находит глобальные индексы двух его концевых вершин с помощью таблицы поиска вершин, сохраняет их в порядке возрастания и записывает столбец из двух элементов. Для треугольника метод находит глобальные индексы трех его ребер с помощью таблицы поиска ребер, сортирует их по возрастанию и записывает столбец из трех элементов.
Сортировка элементов каждого столбца по возрастанию выполняется намеренно. Алгоритм редукции, описанный в следующей статье, считывает ведущий элемент столбца как его последнюю запись, поэтому каждый столбец сортируется на этапе построения, чтобы это считывание не требовало дополнительных операций. В буфере заранее зарезервировано по три записи на каждый столбец — это максимальное количество, необходимое для любого столбца, — поэтому размер буфера никогда не изменяется во время выполнения цикла. После завершения работы метода Build граничная матрица полностью построена и доступна только для чтения.
Разбор примера и проверка корректности
Небольшой пример поможет наглядно представить, как работает цикл. Возьмем четыре точки в вершинах квадрата и выберем эпсилон так, чтобы стороны квадрата уже соединялись ребрами, а диагонали — еще нет.
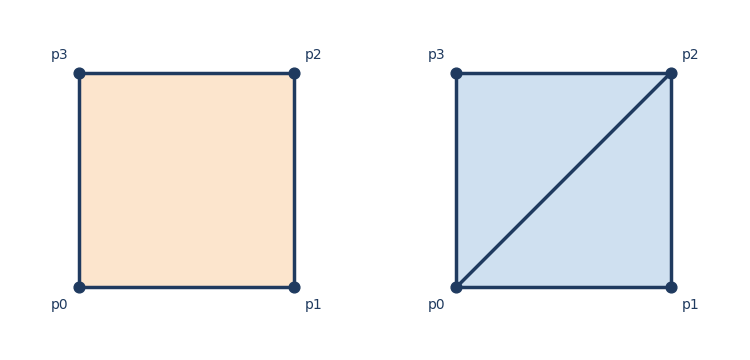
Рис. 4. Слева: четыре ребра замыкают цикл вокруг пустого центра — одномерной дыры (H1). Справа: как только длина диагонали становится не больше эпсилон и входит в комплекс, два треугольника заполняют квадрат, и цикл исчезает.
Четыре стороны превращаются в ребра. Обе диагонали длиннее эпсилон, поэтому они отсутствуют в комплексе, а без диагоналей не образуется ни одного треугольника. В результате получается замкнутое кольцо из четырёх ребер, окружающее пустое пространство в центре. Эта пустая область в центре представляет собой одномерную дыру — особенность H1, возникшую в тот момент, когда четвёртое ребро замкнуло кольцо. Если бы эпсилон увеличился настолько, что появилась бы диагональ, два треугольника заполнили бы квадрат, и дыра исчезла бы. Это та же история рождения и смерти, что и на средней панели первого рисунка, но сведённая к четырём точкам, чтобы всё можно было проверить вручную.
Библиотека воспроизводит этот процесс для больших наборов данных. Прилагаемый скрипт TDA_Rips_Demo.mq5 извлекает окно цен закрытия с текущего графика, выполняет весь конвейер обработки вплоть до построения граничной матрицы и выводит сводку по каждому этапу.
#include <TDA/TDAPointCloud.mqh>
#include <TDA/TDADistance.mqh>
#include <TDA/TDARips.mqh>
#include <TDA/TDABoundary.mqh>

input int    InpWindow     = 80;    // bars of close history to embed
input int    InpEmbDim     = 3;     // embedding dimension d
input int    InpDelay      = 1;     // time delay tau
input double InpMaxEpsFrac = 1.0;   // VR cutoff = frac * max pairwise distance
input int    InpMaxDim     = 2;     // max simplex dim (1 = edges, 2 = triangles)

void OnStart()
  {
   double closes[];
   int copied = CopyClose(_Symbol, _Period, 0, InpWindow, closes);
   if(copied != InpWindow)
      return;

   //--- point cloud and distance matrix
   CTDAPointCloud cloud;
   if(!cloud.Build(closes, InpWindow, InpEmbDim, InpDelay))
      return;

   CTDADistance dist;
   if(!dist.Build(cloud, TDA_NORM_EUCLIDEAN))
      return;

   //--- Vietoris-Rips filtration up to maxDim
   double maxEps = InpMaxEpsFrac * dist.MaxDistance();
   CTDARips rips;
   if(!rips.Build(dist, maxEps, InpMaxDim))
      return;
   rips.PrintSummary();

   //--- boundary matrix over Z/2
   CTDABoundary boundary;
   if(!boundary.Build(rips))
      return;
   boundary.PrintSummary();
  }
При запуске на окне из 80 баров GBPUSD H1 с порогом отсечения по умолчанию скрипт выдаёт следующие результаты.
| Этап | Показатель | Значение |
|---|---|---|
| Облако точек | Точки (N) | 78 |
| Фильтрация | Вершины | 78 |
| Фильтрация | Рёбра | 3003 |
| Фильтрация | Треугольники | 76076 |
| Фильтрация | Общее количество симплексов | 79157 |
| Фильтрация | Максимальное значение фильтрации | 0,014544 |
| Граница | Ненулевые элементы | 234234 |
Эти числа уже сами по себе позволяют проверить корректность результатов. По умолчанию порог отсечения равен полному диаметру облака точек, поэтому расстояние между любой парой точек не превышает этот порог: каждая пара образует ребро, а каждая тройка — треугольник. Число ребер 3003 точно соответствует C(78,2) — количеству способов выбрать две точки из 78. Число треугольников 76076 точно соответствует C(78,3). Число ненулевых элементов граничной матрицы равно 234234: 3003 ребра по две грани плюс 76076 треугольников по три грани. Полученные количества в точности совпадают с комбинаторными расчётами, что служит простейшим подтверждением полноты и корректности перечисления.
Геометрическая структура тоже соответствует ожиданиям. Обработка этим конвейером облака точек, полученного выборкой из зашумлённой окружности, даёт комплекс, который на промежуточных масштабах содержит ровно одно персистентное кольцо — как на рисунке в начале статьи. Полная численная проверка значений рождения и смерти будет проведена в следующей статье, где этап редукции превратит этот каркас в полноценную диаграмму персистентности. На данный момент фильтрация и её граница построены, упорядочены и проверены посредством подсчёта.
Что дальше?
У нас есть фильтрация и граничная матрица. Но персистентность мы пока не вычислили. Граничная матрица кодирует, какие симплексы входят в границы других симплексов, но циклы и компоненты связности в ней пока представлены лишь неявно. В следующей статье мы извлечём их из матрицы.
- Гомологии разных размерностей: H0 — для компонент связности, H1 — для циклов, H2 — для полостей.
- Стандартный алгоритм редукции: сложение столбцов над Z/2 до тех пор, пока ведущие элементы столбцов не станут попарно различными.
- CTDAReduction, преобразующий граничную матрицу в список пар рождения и смерти, характеризующих персистентность.
- CTDADiagram и фасад CTDA, а также полная численная проверка библиотеки.
Заключение
В этой статье расстояния преобразуются в формальный топологический каркас, необходимый для вычисления персистентных гомологий, и создаются две проверенные структуры данных, готовые к использованию.
Что было построено
- CTDARips: перечисляет вершины, ребра и треугольники размерности ≤ 2, присваивает каждому симплексу значение фильтрации, сортирует весь список по возрастанию значения фильтрации, а при равенстве значений — по возрастанию размерности, и строит таблицы поиска с доступом за время O(1), задающие отображения (вершина) → глобальный индекс и (i,j) → глобальный индекс ребра. Глобальный индекс симплекса — это его позиция в отсортированном массиве фильтрации.
- CTDABoundary: принимает отсортированную фильтрацию и записывает разреженную граничную матрицу над Z/2 в столбцовом виде. В каждом столбце хранятся глобальные индексы граней (столбцы вершин пусты, столбцы ребер содержат два индекса вершин, а столбцы треугольников — три индекса ребер). Индексы в каждом столбце хранятся по возрастанию, поэтому ведущий элемент столбца — это последняя запись, и дополнительная сортировка не требуется.
Инварианты и верификация
- Грани всегда предшествуют кограням (при равенстве значений фильтрации порядок определяется размерностью), поэтому индексы граней в столбцах граничной матрицы меньше индекса самого столбца.
- Индексы в столбцах предварительно отсортированы, что позволяет процедуре редукции считывать ведущие элементы за время O(1).
- Компромисс между расходом памяти и скоростью (таблица поиска ребер размером N², плоский буфер записей) обеспечивает быстрое построение границ ценой небольшого дополнительного расхода памяти.
- Проверка корректности при реальном запуске (N = 78) показала точное совпадение с комбинаторными формулами (число ребер = C(78,2), число треугольников = C(78,3), общее число ненулевых элементов граничной матрицы = 2 × число ребер + 3 × число треугольников), что подтвердило полноту и правильность индексирования.
Когда фильтрация и разреженная граничная матрица готовы, а инварианты соблюдены, конвейеру остается выполнить лишь этап редукции, чтобы получить пары рождения и смерти. В следующей статье будет реализован CTDAReduction, построены диаграммы персистентности и проведена численная проверка значений рождения и смерти.
| # | Имя файла | Тип | Описание |
|---|---|---|---|
| 1 | TDAPointCloud.mqh | Заголовочный файл | Вложение Такенса в фазовое пространство (из предыдущей статьи) |
| 2 | TDADistance.mqh | Заголовочный файл | Матрица попарных расстояний (из предыдущей статьи) |
| 3 | TDARips.mqh | Заголовочный файл | Фильтрация Вьеториса — Рипса (представлена в этой статье) |
| 4 | TDABoundary.mqh | Заголовочный файл | Разреженная граничная матрица над Z/2 (представлена в этой статье) |
| 5 | TDA_Rips_Demo.mq5 | Скрипт | Готовая к запуску демонстрационная программа: строит фильтрацию и граничную матрицу, выводит сводку |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23106
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


