

Анализ рекуррентных сетей (RNA) в MQL5: От матриц рекуррентности к сложным сетям
 28
 0

Содержание
- Введение
- RNA на графике
- От матриц рекуррентности к сложным сетям
- Сетевые метрики
- Архитектура библиотеки
- CRNAMetrics: механизм расчета метрик графа
- CRNAWindow: анализ сети одного временного ряда в скользящем окне
- CJRNAWindow: совместный анализ рекуррентных сетей в скользящем окне
- CRNA и CJRNA: фасады
- Индикатор RNA
- Индикатор JRNA
- Что дальше?
- Заключение
Введение
В первых трех статьях этой серии последовательно расширялся набор инструментов для анализа рекуррентности. В первой статье был представлен количественный анализ рекуррентности (RQA) одного временного ряда: выполнение вложения ряда, построение матрицы рекуррентности и вычисление двенадцати метрик, характеризующих детерминированность, ламинарность, энтропию и тренд. Во второй статье этот подход был расширен до количественного анализа кросс-рекуррентности, позволяющего сравнивать траектории двух различных рядов в фазовом пространстве. В третьей статье был добавлен количественный анализ совместной рекуррентности, позволяющий выявлять одновременную рекуррентность в двух системах путем поэлементного применения логического И к их матрицам рекуррентности.
Во всех трех статьях матрица рекуррентности рассматривалась как сетка с характерными структурами: диагональными линиями, вертикальными линиями и изолированными точками. Метрики отражали количество таких структур. В этой статье представлен принципиально иной взгляд на те же данные. Вместо анализа структур из линий мы интерпретируем матрицу рекуррентности как матрицу смежности сложной сети. Каждый момент времени становится узлом. Каждый случай рекуррентности становится ребром. В результате получается граф, топология которого отражает динамическую структуру базовой системы.
Эта новая интерпретация получила название "анализ рекуррентных сетей" (RNA). Это дает нам доступ ко всему набору инструментов теории сложных сетей: коэффициентам кластеризации, длинам кратчайших путей, центральности по посредничеству, ассортативности и многому другому. Эти меры теории графов отражают структурные свойства, которые не могут быть выражены с помощью исходных метрик RQA, основанных на подсчете линий. Матрица рекуррентности с небольшим числом диагональных линий, но плотными кластерами взаимосвязанных узлов дает иную картину, чем матрица с длинными диагональными линиями, но слабой кластеризацией. RNA позволяет увидеть это различие.
В этой статье представлены пять новых файлов и обновлен один существующий файл. CRNAMetrics вычисляет двенадцать графовых метрик на основе любой квадратной матрицы рекуррентности. CRNAWindow вычисляет эти метрики в скользящем окне для одного временного ряда. CJRNAWindow выполняет то же самое для двух рядов с использованием совместной матрицы рекуррентности. Два индикатора (RNA_Indicator.mq5 и JRNA_Indicator.mq5) отображают на графике в режиме реального времени пять выбранных сетевых показателей. Как и в предыдущих статьях, здесь не разрабатывается торговая стратегия. Цель — создать проверенный аналитический слой, который можно сразу же использовать в экспериментах.
RNA на графике
На изображении ниже показан индикатор RNA, работающий на графике в MetaTrader 5 в режиме реального времени. В отдельном окне отображаются пять сетевых показателей: средний коэффициент кластеризации (ACC), транзитивность (Transitivity), нормированная средняя длина пути (NormAPL), ассортативность (Assortativity) и средняя центральность по посредничеству (AvgBetweenness). Каждый из них вычисляется по скользящему окну цен закрытия, при этом матрица рекуррентности для каждого окна рассматривается как сеть.
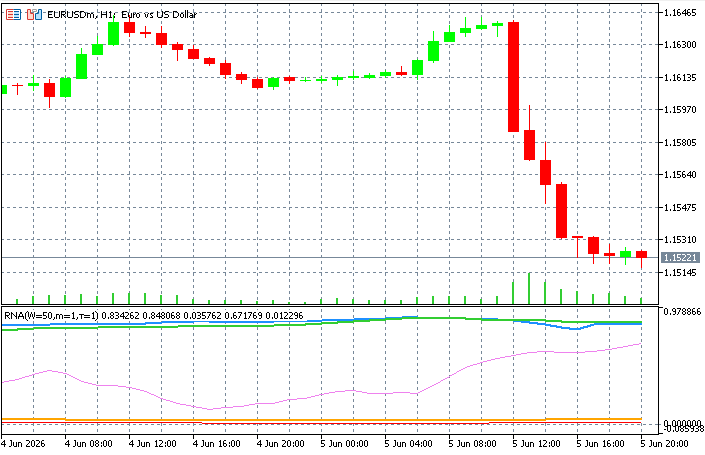
Рис. 1. Индикатор RNA на графике EURUSD H1, отображающий пять сетевых показателей, рассчитанных по матрицам рекуррентности для скользящих окон
При высоком значении ACC рекуррентные состояния образуют плотно связанные кластеры: рынок вновь проходит через группы взаимосвязанных состояний, образующих единое целое. Когда показатель транзитивности снижается, эти кластеры распадаются. При низком значении NormAPL любые две временные точки можно соединить короткой цепочкой рекуррентных связей, что указывает на структуру сети малого мира в динамике системы. Ассортативность показывает, имеют ли узлы с большим количеством связей (часто повторяющиеся состояния) тенденцию соединяться друг с другом. Средняя центральность по посредничеству позволяет выявить временные точки, которые служат мостами между кластерами рекуррентных состояний, в остальном обособленными друг от друга.
Второй индикатор, JRNA_Indicator, рассчитывает те же пять показателей, но по совместной рекуррентной сети двух торговых инструментов. В нем предусмотрены выравнивание по временным меткам и нормализация с использованием того же подхода, что и в индикаторе CRQA из второй статьи.
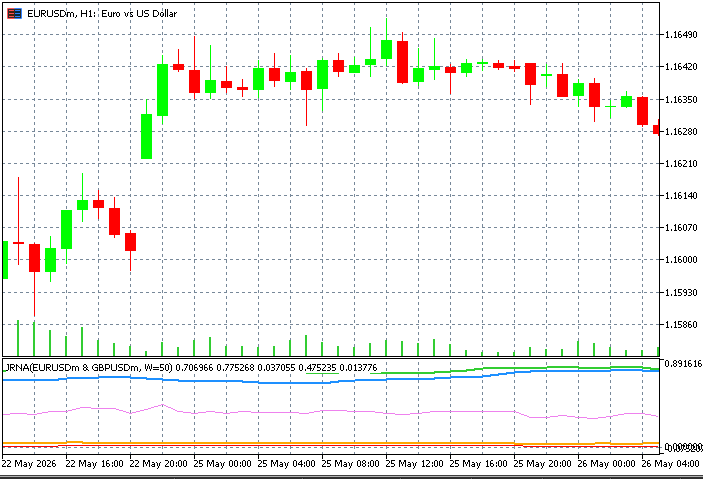
Рис. 2. Индикатор JRNA, сравнивающий пары EURUSD и GBPUSD и отображающий сетевые показатели, рассчитанные по совместным матрицам рекуррентности для скользящих окон
Именно это и является результатом работы библиотеки. Далее в статье объясняется, как библиотека получает эти результаты.
От матриц рекуррентности к сложным сетям
Матрица рекуррентности R(i,j), построенная с помощью CRQAMatrix, является бинарной: каждая ячейка содержит либо 1 (состояния рекуррентны), либо 0 (состояния не рекуррентны). При анализе рекуррентности одного и того же ряда матрица является квадратной (N × N) и симметричной: R(i,j) = R(j,i). Все элементы главной диагонали равны 1, поскольку каждое состояние совпадает с самим собой. Это в точности свойства матрицы смежности неориентированного невзвешенного графа, за одним исключением: элементы главной диагонали соответствуют петлям, которые не несут информации.
Переосмысление не представляет сложности. Возьмите матрицу рекуррентности, обнулите ее главную диагональ (удалив петли) и интерпретируйте результат как граф:
- Узлы: каждая временная точка i = 0, 1, ..., N-1, представленная в пространстве вложения.
- Ребра: неориентированное ребро между i и j существует тогда и только тогда, когда R(i,j) = 1 и i != j.
Это преобразование не требует вычислительных затрат. Данные остаются прежними. Меняется лишь интерпретация. Но такое изменение точки зрения открывает целую область математики. Теория сложных сетей предлагает десятки показателей для описания топологии графов: кластеризация, эффективность передачи информации, центральность узлов, структура сети малого мира и ассортативность.
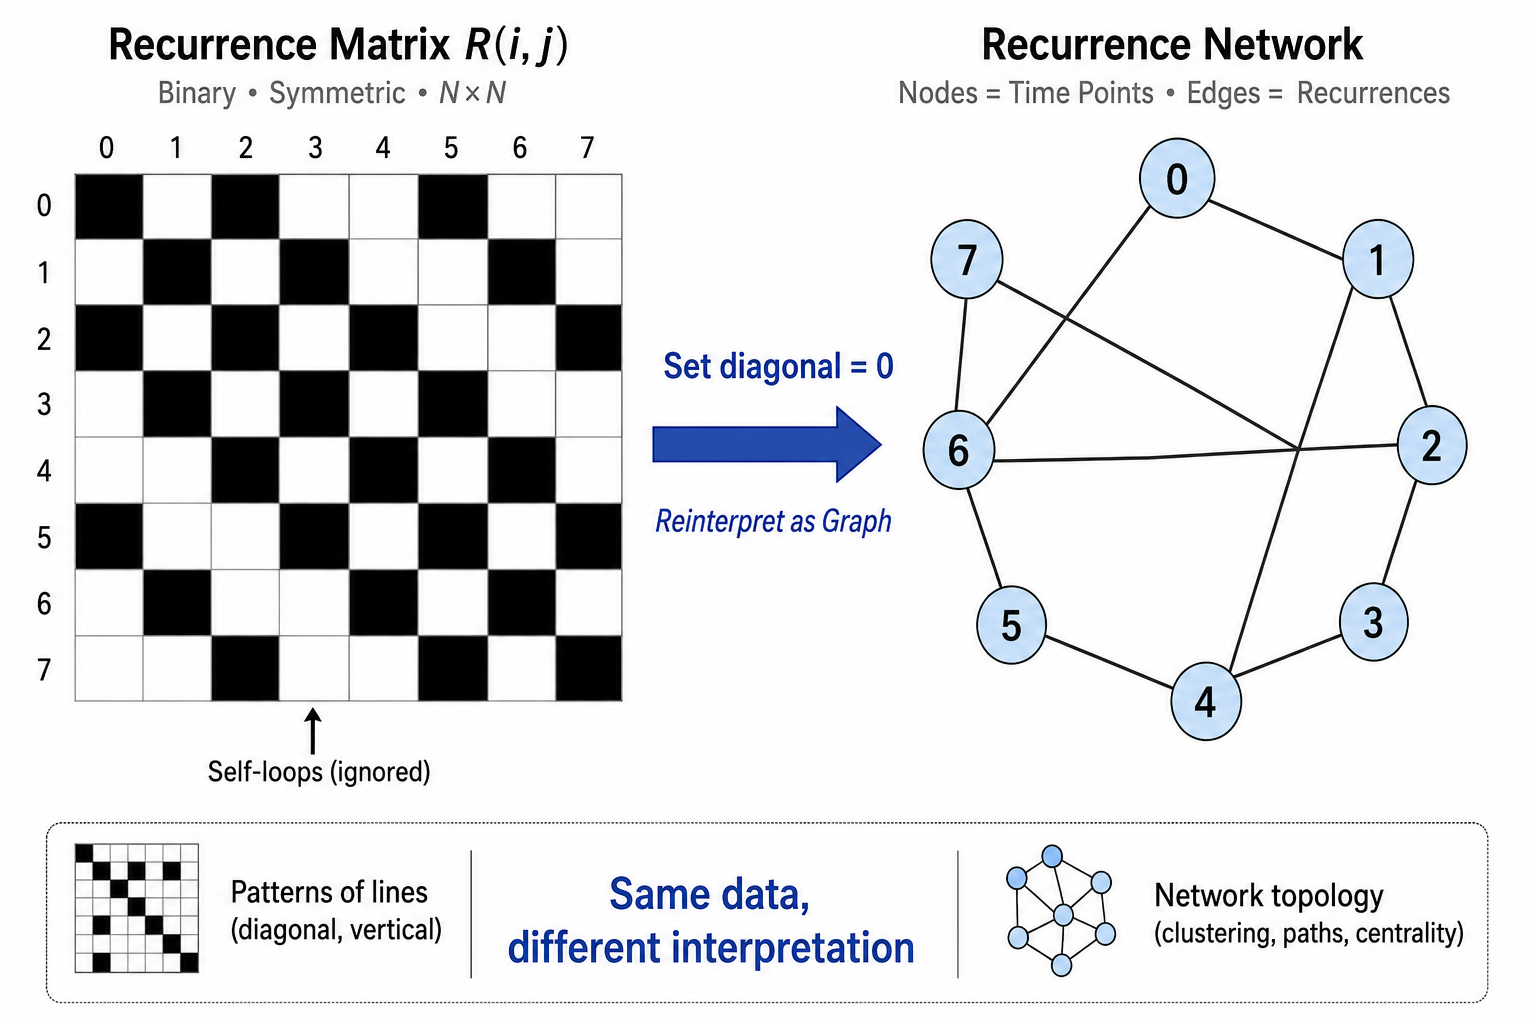
Рис. 3. Матрица рекуррентности (слева), переосмысленная в виде сложной сети (справа). Черные ячейки превращаются в ребра; главная диагональ исключается
Та же логика применима к совместной матрице рекуррентности JR(i,j) из третьей статьи. Матрица JR также квадратная, симметричная и бинарная. Обнуление ее главной диагонали дает матрицу смежности совместной рекуррентной сети. Ребро в этой сети означает, что оба временных ряда одновременно вернулись к своим соответствующим прошлым состояниям в моменты времени, заданные этими индексами. При этом сетевые показатели характеризуют топологию синхронизированной рекуррентности между двумя системами.
Класс CRNAMetrics в данной библиотеке работает с любой квадратной симметричной бинарной матрицей. Он принимает либо непосредственно объект CRQAMatrix (для RNA одного временного ряда), либо одномерный массив смежности (для совместной рекуррентности или любого другого ее варианта). Благодаря этому его можно повторно использовать для всех типов рекуррентности, поддерживаемых библиотекой.
Важная оговорка: сетевые метрики требуют больших вычислительных затрат, чем метрики RQA, основанные на подсчете линий. Для вычисления центральности по посредничеству необходимо выполнять поиск в ширину (BFS) из каждого узла; вычислительная сложность составляет O(N²) для каждого исходного узла и O(N³) в целом. Вычислительная сложность подсчета треугольников для расчета транзитивности составляет O(N² * k), где k — средняя степень узла. При размере окна 50 число узлов N примерно равно 50, поэтому на одно окно приходится O(50³) = 125 000 операций. Такой объем вычислений приемлем, но он растет кубически. При размерах окон свыше 100 затраты становятся заметными. Для вычисления сетевых метрик библиотека использует только CPU, поскольку поиск в ширину (BFS) и подсчет треугольников по своей природе последовательны.
Сетевые метрики
CRNAMetrics вычисляет двенадцать сетевых метрик на основе матрицы смежности. Каждая из них отражает свой аспект топологии графа. В приведенной ниже таблице представлена краткая справочная информация. Далее мы подробнее остановимся на самых важных из них.
| Метрика | Обозначение | Формула | Что измеряется |
|---|---|---|---|
| Средняя степень узла | AvgDegree | sum(k_i) / N | Среднее количество ребер на узел. Чем выше значение, тем больше в среднем рекуррентных связей. |
| Максимальная степень узла | MaxDegree | max(k_i) | Узел с наибольшим числом связей. Выявляет момент времени, которому соответствует состояние с наибольшим числом рекуррентных связей с остальной частью ряда. |
| Стандартное отклонение степеней узлов | DegreeStd | std(k_i) | Разброс значений в распределении степеней. Высокое стандартное отклонение означает, что одни состояния характеризуются гораздо большей рекуррентностью, чем другие. |
| Средний коэффициент кластеризации | ACC | mean(C_i), C_i = 2*links / (k_i*(k_i-1)) | Средняя локальная кластеризация. Высокое значение ACC означает, что рекуррентные состояния образуют тесно связанные группы. |
| Транзитивность | T | 3 * triangles / connected_triples | Глобальная кластеризация. Доля связных троек, замыкающихся в треугольники. |
| Средняя длина пути | APL | среднее значение d(i,j) по парам взаимно достижимых узлов | Средняя длина кратчайшего пути. Низкое значение APL означает, что узлы сети тесно связаны между собой (свойство "малого мира"). |
| Диаметр | D | max(d(i,j)) | Самый длинный кратчайший путь. Максимальное расстояние между любыми двумя взаимно достижимыми узлами. |
| Средняя центральность по посредничеству | AvgBC | среднее значение BC_i, нормированное | Средняя центральность по посредничеству. Высокий показатель означает, что многие узлы выступают в роли мостов между кластерами. |
| Максимальная центральность по посредничеству | MaxBC | max(BC_i), нормированное | Узел с наибольшей центральностью. Определяет момент времени, наиболее важный для связности сети. |
| Средняя центральность по близости | AvgCC | mean(closeness_i), по Вассерману — Фаусту | Средняя центральность по близости. Высокое значение означает, что узлы в среднем могут быстро достигать других узлов. |
| Ассортативность | r | Коэффициент корреляции Пирсона между степенями узлов на концах ребер | Корреляция между степенями. Положительное значение: узлы-концентраторы соединяются с другими узлами-концентраторами. Отрицательное значение: узлы-концентраторы соединяются с периферийными узлами. |
| Плотность | rho | 2|E| / (N*(N-1)) | Доля существующих ребер среди всех возможных. Эквивалентна RR (уровню рекуррентности) в сети. |
ACC (средний коэффициент кластеризации) — это, пожалуй, наиболее характерный сетевой показатель для анализа рекуррентности. Для каждого узла i локальный коэффициент кластеризации C(i) показывает, какая доля его соседей также связана между собой. Если узел i рекуррентно связан с узлами j, k и l, а пары j–k и k–l также имеют рекуррентные связи, то узел i находится в плотном кластере. ACC усредняет это значение по всем узлам. С точки зрения рынка высокое значение ACC указывает на то, что ценовой ряд многократно возвращается к группам взаимно схожих состояний. Это когерентные динамические режимы, при которых система циркулирует в четко очерченной области пространства состояний.
Транзитивность является глобальным аналогом ACC. В то время как ACC усредняет локальные коэффициенты кластеризации, транзитивность измеряет долю связных троек, образующих треугольники, во всей сети: T = 3 * triangles / connected_triples. Множитель 3 учитывает то, что каждый треугольник образует три связные тройки. Транзитивность и ACC часто изменяются синхронно, но могут расходиться, если распределение степеней является неоднородным. Несколько узлов-концентраторов с высокой степенью могут завышать значение ACC, не увеличивая общую плотность треугольников.
Средняя длина пути (APL) показывает, сколько ребер в среднем разделяет два узла, на основе кратчайших путей, вычисленных с помощью поиска в ширину (BFS). Низкое значение APL означает, что рекуррентная сеть компактна: любые две временные точки связаны короткой цепочкой промежуточных рекуррентных связей. Это отличительная черта сети малого мира. С точки зрения рынка низкое значение APL указывает на то, что состояния системы тесно взаимосвязаны, а изолированных режимов мало. Высокое значение APL (или фактически бесконечное, если сеть несвязна) указывает на фрагментированную динамику с обособленными, взаимно недостижимыми режимами.
Центральность по посредничеству позволяет выявить узлы, выполняющие роль мостов. Для узла v посредничество показывает число кратчайших путей между другими парами узлов, проходящих через v, нормированное по общему числу таких путей. Узлы с высоким значением посредничества играют ключевую роль в обеспечении связности сети. С точки зрения рекуррентности временная точка с высоким значением посредничества связывает кластеры рекуррентности, которые иначе были бы разобщены. Это может соответствовать переходному состоянию между рыночными режимами.
Ассортативность (Newman, 2002) позволяет определить, предпочитают ли узлы с высокой степенью связываться с другими узлами с высокой степенью (положительная ассортативность) или с узлами с низкой степенью (отрицательная ассортативность). В рекуррентных сетях положительная ассортативность означает, что часто повторяющиеся состояния рекуррентны по отношению друг к другу и образуют ядро тесно взаимосвязанных состояний, соответствующих узлам-концентраторам. Отрицательная ассортативность означает, что состояния, соответствующие узлам-концентраторам, связаны преимущественно с периферийными состояниями, у которых мало других связей.
Архитектура библиотеки
Расширение RNA добавляет в библиотеку три новых файла. В отличие от предыдущих расширений (CRQA, JRQA), RNA не вводит новый тип матрицы рекуррентности. Вместо этого RNA работает с существующими матрицами (CRQAMatrix для анализа одного временного ряда, CJRQAMatrix для совместного анализа) и вычисляет на их основе метрики теории графов. CRNAMetrics — основной вычислительный модуль. CRNAWindow и CJRNAWindow обеспечивают анализ в скользящем окне. Два фасада (CRNA и CJRNA) в файле RQA.mqh объединяют всю функциональность в интерфейсы, позволяющие выполнить анализ одним вызовом.
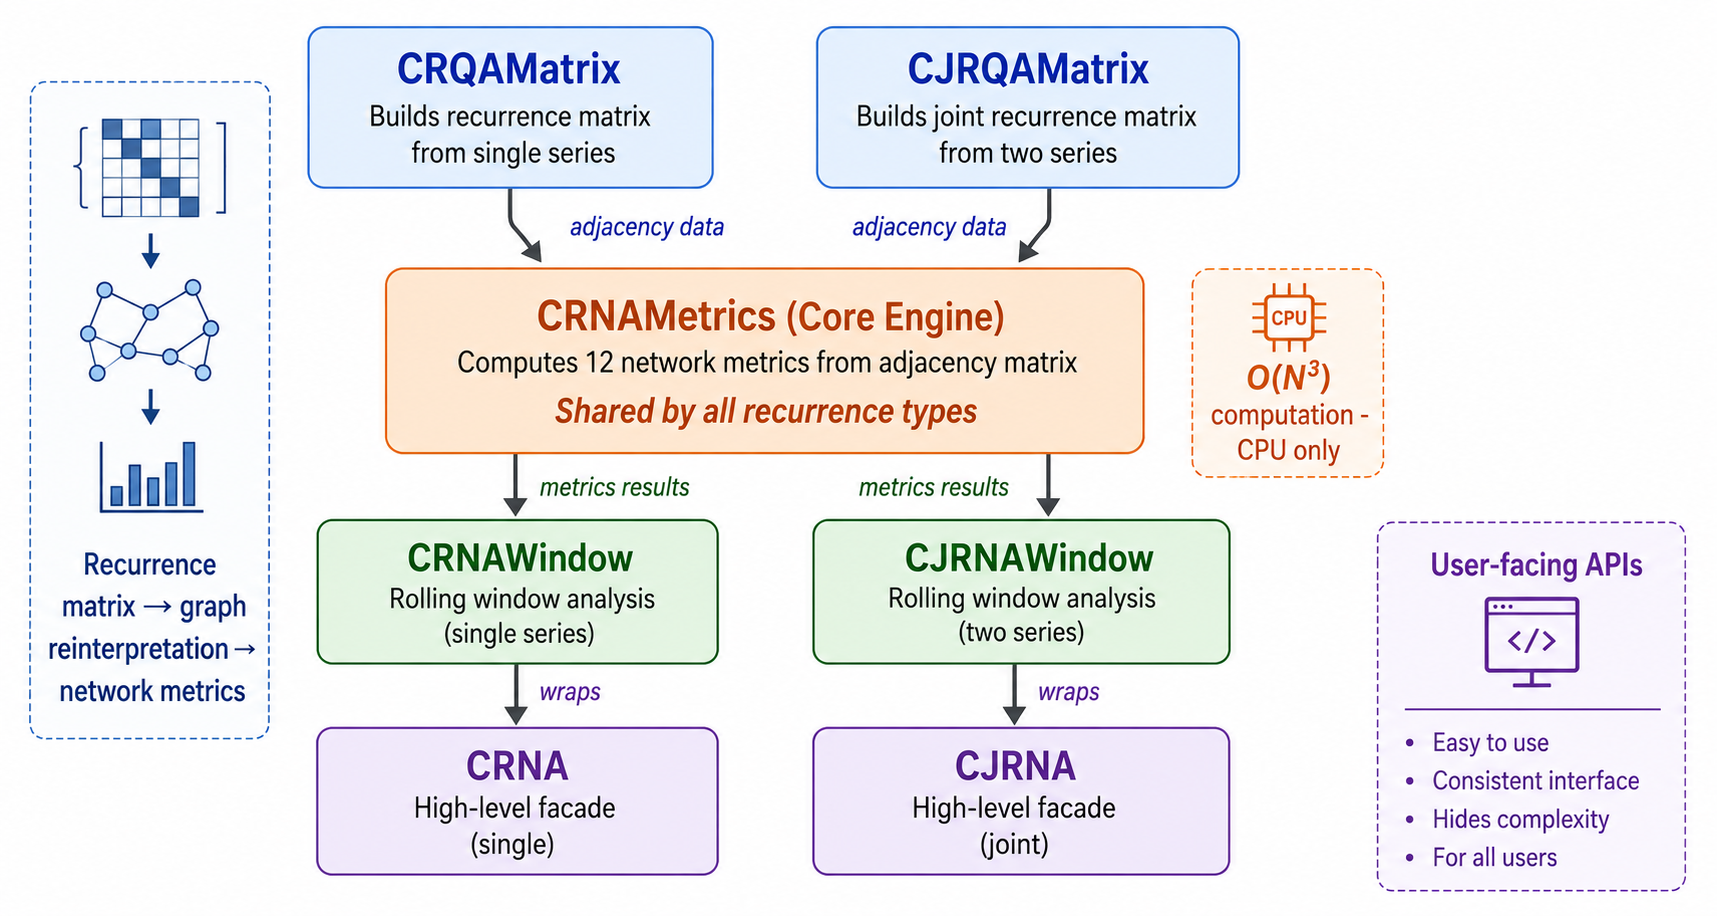
Рис. 4. Архитектура библиотеки RNA. CRNAMetrics — общий вычислительный модуль, работающий с любой квадратной матрицей смежности
| Файл | Класс | Назначение |
|---|---|---|
| RNAMetrics.mqh | CRNAMetrics | Модуль вычисления метрик графа. Вычисляет степени узлов, кластеризацию, транзитивность, метрики путей на основе поиска в ширину (BFS), центральность по посредничеству (алгоритм Брандеса), центральность по близости и ассортативность по матрице смежности, хранящейся в одномерном массиве. Работает с любой квадратной матрицей рекуррентности. |
| RNAWindow.mqh | CRNAWindow | RNA в скользящем окне для одного временного ряда. Сдвигает окно, формирует матрицу CRQAMatrix для каждого окна, передает ее в CRNAMetrics и сохраняет результаты. Вычисления только на CPU. |
| JRNAWindow.mqh | CJRNAWindow | JRNA в скользящем окне для двух временных рядов. Сдвигает окно, формирует матрицу CJRQAMatrix для каждого окна, извлекает матрицу смежности и передает ее в CRNAMetrics. Вычисления только на CPU. |
| RQA.mqh | CRNA, CJRNA | Фасады высокого уровня. CRNA объединяет CRQAMatrix и CRNAMetrics для анализа рекуррентной сети одного временного ряда. CJRNA объединяет CJRQAMatrix и CRNAMetrics для совместного анализа рекуррентных сетей. |
Для этих классов предусмотрена одна вспомогательная структура:
- SRNAResult содержит значения всех двенадцати сетевых метрик, а также метод Reset(). Эта структура используется как в RNA, так и в JRNA, поскольку метрики графа одинаковы независимо от того, получена ли матрица смежности из стандартной рекуррентной диаграммы или из совместной рекуррентной диаграммы.
- SRNAWindowResult связывает объект SRNAResult с индексом бара, указывая, к какому окну относятся метрики. Также используется как в CRNAWindow, так и в CJRNAWindow.
У CRNAMetrics есть две точки входа: метод Compute() напрямую принимает объект CRQAMatrix (удобная обертка для RNA одного временного ряда), а метод ComputeFromAdj() принимает исходный одномерный массив смежности типа char[] (используется в CJRNAWindow и при работе с любыми другими источниками данных о смежности). Оба пути сходятся в одном и том же внутреннем вычислительном конвейере.
Чтобы использовать библиотеку, по-прежнему достаточно одной директивы включения:
#include <RQA\RQA.mqh> Теперь вам доступны все стандартные классы количественного анализа рекуррентности (RQA), классы количественного анализа кросс-рекуррентности (CRQA), классы количественного анализа совместной рекуррентности (JRQA), а также новые классы RNA/JRNA. Схема именования сохраняется: для классов RNA используется префикс "C + RNA" (CRNAMetrics, CRNAWindow), для фасадов — префиксы "CRNA" и "CJRNA", а для структуры результата — префикс "S + RNA" (SRNAResult).
CRNAMetrics: механизм расчета метрик графа
CRNAMetrics — это основная тема данной статьи. Класс принимает матрицу смежности в виде одномерного массива (массив char[] длиной N*N, где A[i*N+j] != 0 означает наличие ребра между узлами i и j) и вычисляет все двенадцать сетевых метрик. Класс не имеет состояния. Все вычисления выполняются в рамках вызова Compute() или ComputeFromAdj(), а результаты записываются в структуру SRNAResult.
Структура SRNAResult
Все метрики хранятся в одной структуре с методом Reset(), который обнуляет все значения. Это соглашение об обмене данными между CRNAMetrics и остальной частью библиотеки.
struct SRNAResult
  {
   double   AvgDegree;
   double   MaxDegree;
   double   DegreeStd;
   double   AvgClustering;
   double   Transitivity;
   double   AvgPathLength;
   double   Diameter;
   double   AvgBetweenness;
   double   MaxBetweenness;
   double   AvgCloseness;
   double   Assortativity;
   double   Density;
   void     Reset()
     {
      AvgDegree=0; MaxDegree=0; DegreeStd=0;
      AvgClustering=0; Transitivity=0;
      AvgPathLength=0; Diameter=0;
      AvgBetweenness=0; MaxBetweenness=0;
      AvgCloseness=0; Assortativity=0; Density=0;
     }
  };
Сравните эту структуру с SRQAResult из первой статьи или SCRQAResult из второй. Здесь используется тот же шаблон: структура без вложенных структур, с именованными полями и методом Reset(). Но поля совершенно другие. SRQAResult содержит статистические данные по диагональным и вертикальным линиям. SRNAResult содержит статистические данные о топологии графа. Они описывают одну и ту же базовую матрицу с двух разных математических точек зрения.
Обертка для удобства использования
Метод Compute() позволяет получать сетевые метрики непосредственно из объекта CRQAMatrix. Он извлекает матрицу смежности (обнуляя главную диагональ) и передает дальнейшие вычисления методу ComputeFromAdj().
//+------------------------------------------------------------------+
//| Convenience wrapper: extract CRQAMatrix into flat adjacency      |
//+------------------------------------------------------------------+
bool CRNAMetrics::Compute(const CRQAMatrix &mat,
                         SRNAResult &result) const
  {
   int N = mat.Size();
   if(N < 3)
     {
      Print("CRNAMetrics::Compute: network too small (min 3 nodes)");
      return false;
     }
   char adj[];
   ArrayResize(adj, N * N);
   for(int i = 0; i < N; i++)
      for(int j = 0; j < N; j++)
         adj[i * N + j] = (char)((i != j && mat.Get(i, j)) ? 1 : 0);
   return ComputeFromAdj(adj, N, result);
  }
Условие i != j гарантирует исключение петель. CRQAMatrix хранит полную матрицу размером N × N, включая главную диагональ (элементы которой при анализе рекуррентности одного ряда всегда равны 1), однако матрица смежности сети должна иметь нули на диагонали. Полученный массив char[] передается в функцию ComputeFromAdj(), которая выполняет полный цикл вычисления метрик.
Вычисление степени узла
Степень узла — это просто количество ребер, инцидентных ему. В случае матрицы смежности это сумма элементов соответствующей строки. Функция ComputeDeg() вычисляет степени для всех узлов за один проход.
//+------------------------------------------------------------------+ //| Compute node degrees (row sums; self-loops already excluded) | //+------------------------------------------------------------------+ void CRNAMetrics::ComputeDeg(const char &A[], int N, int °rees[]) const { ArrayResize(degrees, N); ArrayInitialize(degrees, 0); for(int i = 0; i < N; i++) { int off = i * N; for(int j = 0; j < N; j++) if(A[off + j] != 0) degrees[i]++; } }
Массив степеней используется практически во всех последующих вычислениях: при расчете показателей кластеризации, транзитивности, ассортативности и итоговых сводных статистических показателей. Предварительное однократное вычисление этого массива позволяет избежать повторных вычислений.
Локальный коэффициент кластеризации
Коэффициент кластеризации узла i показывает, насколько плотно взаимосвязаны его соседи. Для узла степени k максимальное возможное количество ребер между его k соседями равно k*(k-1)/2. Коэффициент кластеризации представляет собой отношение фактического числа ребер между соседями к этому максимальному значению.
//+------------------------------------------------------------------+ //| Local clustering coefficient per node | //| C(i) = 2 * links_among_neighbors / (k * (k-1)) | //+------------------------------------------------------------------+ void CRNAMetrics::ComputeClust(const char &A[], int N, const int °rees[], double &cc[]) const { ArrayResize(cc, N); ArrayInitialize(cc, 0.0); int neighbors[]; ArrayResize(neighbors, N); for(int i = 0; i < N; i++) { int k = degrees[i]; if(k < 2) continue; int nCnt = 0; int off = i * N; for(int j = 0; j < N; j++) if(A[off + j] != 0) neighbors[nCnt++] = j; int links = 0; for(int a = 0; a < nCnt; a++) for(int b = a + 1; b < nCnt; b++) if(A[neighbors[a] * N + neighbors[b]] != 0) links++; cc[i] = (2.0 * links) / ((double)k * (k - 1)); } }
Для каждого узла i со степенью k ≥ 2 данный метод сначала собирает всех k соседей в локальный массив. Затем он проверяет каждую пару соседей (a, b), чтобы определить, соединены ли они. Число таких связей, деленное на максимально возможное значение k*(k-1)/2, дает C(i). Коэффициент 2 в числителе компенсирует деление на k*(k-1) вместо k*(k-1)/2. Узлы, имеющие менее 2 соседей, получают коэффициент кластеризации, равный 0, поскольку вокруг них невозможно сформировать треугольник. Сложность для каждого узла составляет O(k²), поэтому общая сложность зависит от распределения степеней. Для плотных сетей эта сложность может приближаться к O(N^2) на каждый узел.
Транзитивность (глобальная кластеризация)
Транзитивность рассчитывается как общее число треугольников в сети, деленное на общее число связных троек. Связная тройка — это путь длины 2 (три узла, два ребра). Треугольник — это замкнутая тройка (все три ребра присутствуют).
//+------------------------------------------------------------------+ //| Transitivity (global clustering coefficient) | //| T = 3 * triangles / connected_triples | //+------------------------------------------------------------------+ double CRNAMetrics::ComputeTrans(const char &A[], int N, const int °rees[]) const { long triangles = 0; for(int i = 0; i < N; i++) for(int j = i + 1; j < N; j++) if(A[i * N + j] != 0) for(int k = j + 1; k < N; k++) if(A[i * N + k] != 0 && A[j * N + k] != 0) triangles++; long triples = 0; for(int i = 0; i < N; i++) triples += (long)degrees[i] * (degrees[i] - 1) / 2; if(triples == 0) return 0.0; return (double)(3 * triangles) / triples; }
При подсчете треугольников используется тройной вложенный цикл, проходящий по упорядоченным тройкам (i < j < k). Для каждой тройки, в которой присутствуют все три ребра (i-j, i-k, j-k), счетчик треугольников увеличивается на единицу. Число связных троек вычисляется по последовательности степеней узлов: на каждый узел степени k приходится k*(k-1)/2 связных троек с центром в этом узле. Множитель 3 в числителе объясняется тем, что каждый треугольник содержит ровно три связные тройки (по одной с центром в каждом узле), поэтому отношение 3 × количество треугольников / количество троек дает долю замкнутых троек. Сложность в худшем случае составляет O(N^3), но досрочный выход при проверке ребра i-j значительно ускоряет вычисления для разреженных сетей.
BFS (поиск в ширину)
BFS служит основой для вычисления метрик, основанных на путях. Он вычисляет расстояния по кратчайшим путям от одного исходного узла до всех достижимых узлов за время O(N + |E|), где |E| — количество ребер.
//+------------------------------------------------------------------+
//| BFS from a single source node on flat adjacency                  |
//+------------------------------------------------------------------+
void CRNAMetrics::BFSArr(const char &A[], int start, int N,
                        int &dist[]) const
  {
   ArrayInitialize(dist, -1);
   dist[start] = 0;
   int queue[];
   ArrayResize(queue, N);
   int qF = 0, qB = 0;
   queue[qB++] = start;
   while(qF < qB)
     {
      int u   = queue[qF++];
      int off = u * N;
      for(int v = 0; v < N; v++)
        {
         if(dist[v] != -1 || A[off + v] == 0) continue;
         dist[v] = dist[u] + 1;
         queue[qB++] = v;
        }
     }
  }
В данной реализации в качестве кольцевой очереди используется одномерный массив (qF — указатель на начало очереди, qB — указатель на конец очереди). Для недостижимых узлов расстояние сохраняет начальное значение -1, что позволяет вызывающему коду обнаруживать отдельные компоненты связности. Вызывающий код заранее выделяет массив dist[] размером N и повторно использует его при нескольких вызовах BFS, чтобы избежать повторного выделения памяти. Это стандартный алгоритм BFS, время выполнения которого в худшем случае составляет O(N²) за один вызов (поскольку при проверке смежности для каждого узла просматриваются все N соседей), что является ценой использования матрицы смежности вместо списка смежности.
Метрики путей и центральность по близости
Функция ComputePaths() запускает BFS из каждого узла, чтобы вычислить среднюю длину кратчайшего пути, диаметр и центральность по близости для каждого узла. Средняя длина пути — это среднее значение длин кратчайших путей по всем парам достижимых друг из друга узлов. Диаметр — это наибольшее из наблюдаемых расстояний. Центральность по близости вычисляется с использованием нормализации Вассермана — Фауста, которая учитывает несвязные графы: closeness(s) = (reachable^2) / ((N-1) * sumDist), где reachable — число узлов, достижимых из s, а sumDist — сумма расстояний до этих узлов. Такая нормализация гарантирует, что узлы в небольших компонентах связности будут иметь низкие значения центральности по близости, а не искусственно завышенные.
Центральность по посредничеству: алгоритм Брандеса
Центральность по посредничеству — наиболее затратная в вычислительном отношении метрика в данном наборе. Для каждого узла v подсчитывается, сколько кратчайших путей между другими парами узлов проходят через v. Наивный подход потребовал бы вычисления кратчайших путей между всеми парами узлов и последующей проверки каждого пути на наличие промежуточных узлов, однако Брандес (2001) показал, что для невзвешенных графов посредничество можно вычислить за время O(N^2), накапливая значения зависимости при обходах с помощью поиска в ширину (BFS).
//+------------------------------------------------------------------+
//| Betweenness centrality: Brandes algorithm (unweighted)           |
//+------------------------------------------------------------------+
void CRNAMetrics::ComputeBC(const char &A[], int N,
                            double &bc[]) const
  {
   ArrayResize(bc, N);
   ArrayInitialize(bc, 0.0);
   int    sigma[], dist[], stack[], queue[];
   double delta[];
   int    predStore[], predCnt[];
   ArrayResize(sigma, N);
   ArrayResize(dist, N);
   ArrayResize(delta, N);
   ArrayResize(stack, N);
   ArrayResize(queue, N);
   ArrayResize(predStore, N * N);
   ArrayResize(predCnt, N);
   for(int s = 0; s < N; s++)
     {
      ArrayInitialize(sigma, 0);    sigma[s] = 1;
      ArrayInitialize(dist, -1);    dist[s]  = 0;
      ArrayInitialize(delta, 0.0);
      ArrayInitialize(predCnt, 0);
      int sTop = 0, qF = 0, qB = 0;
      queue[qB++] = s;
      while(qF < qB)
        {
         int v   = queue[qF++];
         int off = v * N;
         stack[sTop++] = v;
         for(int w = 0; w < N; w++)
           {
            if(A[off + w] == 0) continue;
            if(dist[w] == -1)
              {
               dist[w] = dist[v] + 1;
               queue[qB++] = w;
              }
            if(dist[w] == dist[v] + 1)
              {
               sigma[w] += sigma[v];
               predStore[w * N + predCnt[w]] = v;
               predCnt[w]++;
              }
           }
        }
      while(sTop > 0)
        {
         int w = stack[--sTop];
         for(int p = 0; p < predCnt[w]; p++)
           {
            int v = predStore[w * N + p];
            delta[v] += ((double)sigma[v] / sigma[w])
                        * (1.0 + delta[w]);
           }
         if(w != s)
            bc[w] += delta[w];
        }
     }
   for(int i = 0; i < N; i++)
      bc[i] /= 2.0;
  }
Алгоритм состоит из двух этапов для каждого исходного узла s. Прямой проход представляет собой модифицированный поиск в ширину (BFS), который одновременно определяет расстояния по кратчайшим путям (dist[]), подсчитывает число кратчайших путей до каждого узла (sigma[]) и сохраняет предшественников на кратчайших путях (predStore[]). По мере обнаружения каждого узла v он помещается в стек. При обратном проходе узлы обрабатываются в порядке, обратном порядку обхода BFS, с извлечением из стека. Для каждого узла w его значение зависимости распределяется между его предшественниками: delta[v] += (sigma[v] / sigma[w]) * (1 + delta[w]). Эта формула вычисляет долю кратчайших путей от s через w, которые также проходят через v, суммированную по всем целевым узлам. После обработки всех исходных узлов итоговое деление на 2 устраняет двойной учет каждого пути в неориентированном графе (по одному разу от каждого из его концов).
Массив predStore — одномерный массив из N×N элементов: predStore[w*N + k] хранит k-го предшественника узла w. Это позволяет избежать динамического изменения размера во внутреннем цикле. Общий объем памяти, требуемый для predStore, составляет O(N²), что является приемлемым для размеров сетей, с которыми мы работаем (как правило, N < 200). Временная сложность составляет O(N^2) для каждого исходного узла и O(N^3) в целом, поэтому вычисление этой метрики требует наибольших затрат в цепочке расчета метрик.
Ассортативность по степени
Ассортативность измеряет корреляцию Пирсона между степенями узлов на обоих концах каждого ребра. Этот показатель был введен Ньюманом (2002) и вычисляется за один проход по всем ребрам.
//+------------------------------------------------------------------+ //| Degree assortativity coefficient (Newman 2002) | //| Pearson correlation of degrees at both ends of each edge. | //+------------------------------------------------------------------+ double CRNAMetrics::ComputeAssort(const char &A[], int N, const int °rees[]) const { double sumProd = 0; double sumSum = 0; double sumSqSum = 0; long M = 0; for(int i = 0; i < N; i++) for(int j = i + 1; j < N; j++) if(A[i * N + j] != 0) { double ki = (double)degrees[i]; double kj = (double)degrees[j]; sumProd += ki * kj; sumSum += ki + kj; sumSqSum += ki * ki + kj * kj; M++; } if(M == 0) return 0.0; double invM = 1.0 / M; double term1 = sumProd * invM; double half = sumSum * 0.5 * invM; double term2 = half * half; double term3 = sumSqSum * 0.5 * invM; double denom = term3 - term2; if(MathAbs(denom) < 1e-12) return 0.0; return (term1 - term2) / denom; }
Метод проходит по всем ребрам (i < j, чтобы избежать двойного подсчета), накапливая три суммы: сумму произведений степеней узлов на концах ребер, сумму степеней этих узлов и сумму квадратов их степеней. Эти накопители позволяют вычислить коэффициент корреляции Пирсона по явной формуле без повторного прохода. M — общее количество ребер. Результат находится в диапазоне от -1 (полная дисассортативность: узлы с высокой степенью соединяются только с узлами с низкой степенью) до +1 (полная ассортативность: узлы соединяются только с узлами с близкой степенью). Рекуррентные сети финансовых временных рядов, как правило, демонстрируют умеренную положительную ассортативность.
Основной конвейер: ComputeFromAdj
Функция ComputeFromAdj() является центральным координатором. Она последовательно выполняет все промежуточные вычисления и формирует итоговый результат.
//+------------------------------------------------------------------+
//| Core computation from flat adjacency char[N*N]                   |
//+------------------------------------------------------------------+
bool CRNAMetrics::ComputeFromAdj(const char &adj[], int N,
                                 SRNAResult &result) const
  {
   result.Reset();
   if(N < 3) return false;
   //--- Degrees
   int degrees[];
   ComputeDeg(adj, N, degrees);
   double sumDeg = 0, sumDeg2 = 0;
   int    maxDeg = 0;
   for(int i = 0; i < N; i++)
     {
      sumDeg  += degrees[i];
      sumDeg2 += (double)degrees[i] * degrees[i];
      if(degrees[i] > maxDeg) maxDeg = degrees[i];
     }
   result.AvgDegree = sumDeg / N;
   result.MaxDegree = (double)maxDeg;
   result.DegreeStd = MathSqrt(MathMax(0.0,
                     sumDeg2 / N - result.AvgDegree * result.AvgDegree));
   result.Density = sumDeg / ((double)N * (N - 1));
   //--- Clustering
   double cc[];
   ComputeClust(adj, N, degrees, cc);
   double sumClust = 0;
   for(int i = 0; i < N; i++) sumClust += cc[i];
   result.AvgClustering = sumClust / N;
   //--- Transitivity
   result.Transitivity = ComputeTrans(adj, N, degrees);
   //--- Path metrics + Closeness
   double closeness[];
   ComputePaths(adj, N,
                result.AvgPathLength, result.Diameter, closeness);
   double sumClose = 0;
   for(int i = 0; i < N; i++) sumClose += closeness[i];
   result.AvgCloseness = sumClose / N;
   //--- Betweenness (Brandes, then normalize)
   double betweenness[];
   ComputeBC(adj, N, betweenness);
   double bcNorm = (N > 2)
                 ? 2.0 / ((double)(N - 1) * (N - 2)) : 1.0;
   double sumBC = 0, maxBC = 0;
   for(int i = 0; i < N; i++)
     {
      double nbc = betweenness[i] * bcNorm;
      sumBC += nbc;
      if(nbc > maxBC) maxBC = nbc;
     }
   result.AvgBetweenness = sumBC / N;
   result.MaxBetweenness = maxBC;
   //--- Assortativity
   result.Assortativity = ComputeAssort(adj, N, degrees);
   return true;
  }
Конвейер включает пять этапов: вычисление степеней узлов, кластеризации, транзитивности, метрик путей (включая центральность по близости) и центральности по посредничеству. Ассортативность вычисляется в последнюю очередь, поскольку она зависит только от степеней узлов и матрицы смежности. Коэффициент нормировки посредничества 2/((N-1)*(N-2)) приводит исходное значение посредничества к диапазону [0, 1], где значение 1 означало бы, что каждый кратчайший путь в сети проходит через данный узел. Плотность рассчитывается по формуле sumDeg / (N*(N-1)), что эквивалентно выражению 2|E| / (N*(N-1)), поскольку для неориентированного графа sumDeg = 2|E| (каждое ребро увеличивает на 1 степень каждого из двух узлов на его концах).
CRNAWindow: анализ сети одного временного ряда в скользящем окне
CRNAWindow выполняет анализ рекуррентных сетей (RNA) в скользящем окне одного временного ряда. В каждом положении окна CRNAWindow выделяет соответствующий фрагмент ряда, строит матрицу рекуррентности с помощью CRQAMatrix, передает ее в CRNAMetrics и сохраняет результат. Эта реализация повторяет конструкцию CRQAWindow из первой статьи, при этом в качестве вычислительного модуля вместо CRQAMetrics используется CRNAMetrics.
Метод Run
//+------------------------------------------------------------------+
//| Slide window, build recurrence matrix, compute network metrics   |
//+------------------------------------------------------------------+
bool CRNAWindow::Run(const double &series[], int seriesLen,
                     SRNAWindowResult &results[])
  {
   if(seriesLen < m_windowSize)
     {
      Print("CRNAWindow::Run: series shorter than window");
      return false;
     }
   CRQAMatrix  mat;
   CRNAMetrics metrics;
   int numWindows = (seriesLen - m_windowSize) / m_step + 1;
   ArrayResize(results, numWindows);
   double slice[];
   ArrayResize(slice, m_windowSize);
   int idx = 0;
   for(int start = 0; start + m_windowSize <= seriesLen;
       start += m_step)
     {
      for(int k = 0; k < m_windowSize; k++)
         slice[k] = series[start + k];
      double eps = (m_epsilon > 0.0) ? m_epsilon : 0.1;
      results[idx].barIndex = start;
      if(mat.Build(slice, m_windowSize, eps,
                   m_embDim, m_delay, m_norm))
         metrics.Compute(mat, results[idx].metrics);
      else
         results[idx].metrics.Reset();
      idx++;
     }
   ArrayResize(results, idx);
   return true;
  }
На каждой итерации копируется фрагмент ряда, соответствующий окну, строится матрица рекуррентности и вычисляются все двенадцать сетевых метрик. Объекты CRQAMatrix и CRNAMetrics используются повторно в ходе всех итераций. Если построение матрицы для конкретного окна завершается с ошибкой, показатели обнуляются, и цикл продолжается. Вычислительные затраты на обработку каждого окна определяются главным образом расчетом сетевых метрик: O(N^3) для посредничества и длин путей, где N — число векторов вложения в каждом окне (обычно windowSize за вычетом числа отсчетов, теряемых при вложении).
CRNAWindow работает исключительно на процессоре. В отличие от CCRQAWindow, который переносит построение матриц на графический процессор, вычисления сетевых метрик в данном случае не дают существенного выигрыша от параллельной обработки на GPU. BFS, подсчет треугольников и алгоритм Брандеса по своей сути являются последовательными процессами в рамках каждого вызова. Само построение матрицы (O(N^2) на окно) составляет лишь небольшую долю общих вычислительных затрат по сравнению с расчетом сетевых метрик (O(N^3) на окно), поэтому ускорение только построения матрицы с помощью GPU не дало бы существенного ускорения обработки.
Статические методы извлечения
Статические методы извлечения реализованы по той же схеме, что и во всех предыдущих модулях обработки скользящих окон. Для каждой из часто используемых метрик предусмотрен отдельный метод: ExtractAvgClustering, ExtractTransitivity, ExtractAvgPathLength, ExtractAssortativity, ExtractAvgBetweenness и ExtractDensity.
void CRNAWindow::ExtractAvgClustering(const SRNAWindowResult &r[],
                                     double &out[])
  {
   int n = ArraySize(r);
   ArrayResize(out, n);
   for(int i = 0; i < n; i++)
      out[i] = r[i].metrics.AvgClustering;
  }
Каждый метод извлечения копирует значения одного поля метрики из массива результатов в обычный массив типа double. Благодаря этому извлечение данных осуществляется отдельно от вычислений, что позволяет индикатору или скрипту выбирать только те показатели, которые ему нужны.
CJRNAWindow: совместный анализ рекуррентных сетей в скользящем окне
CJRNAWindow распространяет анализ рекуррентных сетей на два временных ряда, используя совместную матрицу рекуррентности. В каждом положении окна он выделяет фрагменты обоих рядов, строит CJRQAMatrix (которая выполняет поэлементную операцию логического И над двумя отдельными матрицами рекуррентности), извлекает матрицу смежности (исключая петли) и передает ее в CRNAMetrics::ComputeFromAdj(). Для результата используется та же структура SRNAResult, что и в CRNAWindow, поскольку набор метрик графа не зависит от способа построения матрицы смежности.
Метод Run
//+------------------------------------------------------------------+
//| Slide window, build joint RP, extract adjacency, compute metrics |
//+------------------------------------------------------------------+
bool CJRNAWindow::Run(const double &seriesX[], int lenX,
                      const double &seriesY[], int lenY,
                      SRNAWindowResult &results[])
  {
   int minLen = MathMin(lenX, lenY);
   if(minLen < m_windowSize)
     {
      Print("CJRNAWindow::Run: series shorter than window");
      return false;
     }
   CJRQAMatrix mat;
   CRNAMetrics metrics;
   int numWindows = (minLen - m_windowSize) / m_step + 1;
   ArrayResize(results, numWindows);
   double sliceX[], sliceY[];
   ArrayResize(sliceX, m_windowSize);
   ArrayResize(sliceY, m_windowSize);
   int idx = 0;
   for(int start = 0; start + m_windowSize <= minLen;
       start += m_step)
     {
      for(int k = 0; k < m_windowSize; k++)
        {
         sliceX[k] = seriesX[start + k];
         sliceY[k] = seriesY[start + k];
        }
      results[idx].barIndex = start;
      if(!mat.Build(sliceX, sliceY, m_windowSize,
                   m_epsilonX, m_epsilonY,
                   m_embDim, m_delay, m_norm))
        {
         results[idx].metrics.Reset();
         idx++;
         continue;
        }
      //--- Extract adjacency matrix (no self-loops)
      int N = mat.Size();
      char adj[];
      ArrayResize(adj, N * N);
      for(int i = 0; i < N; i++)
         for(int j = 0; j < N; j++)
            adj[i * N + j] = (char)((i != j && mat.Get(i, j))
                             ? 1 : 0);
      metrics.ComputeFromAdj(adj, N, results[idx].metrics);
      idx++;
     }
   ArrayResize(results, idx);
   return true;
  }
Существует два основных отличия от CRNAWindow. Во-первых, метод принимает два ряда и использует MathMin(lenX, lenY) в качестве эффективной длины. Перед передачей в метод оба ряда должны быть выровнены по времени. Во-вторых, после построения CJRQAMatrix метод явно извлекает матрицу смежности в одномерный массив char[]. CJRQAMatrix::Get(i, j) возвращает значение элемента совместной матрицы рекуррентности, которая уже является бинарной и симметричной. Цикл извлечения устанавливает adj[i*N+j] = 1 только тогда, когда i != j и mat.Get(i, j) возвращает true, в точности повторяя извлечение матрицы смежности в фасаде CJRNA.
CJRNAWindow поддерживает отдельные значения эпсилон для двух рядов с помощью перегруженного метода SetEpsilon(): SetEpsilon(double eps) устанавливает для обоих рядов одинаковое значение, а SetEpsilon(double epsX, double epsY) позволяет задавать независимые пороговые значения. Это тот же подход, который использовался в CJRQAWindow в третьей статье.
Статические методы извлечения по своей структуре идентичны методам в CRNAWindow: ExtractAvgClustering, ExtractTransitivity, ExtractAvgPathLength, ExtractAssortativity, ExtractAvgBetweenness и ExtractDensity.
CRNA и CJRNA: фасады
Два фасада предоставляют интерфейсы к модулям анализа сетей, позволяя выполнять анализ одним вызовом. CRNA выполняет анализ рекуррентных сетей (RNA) для одного временного ряда. CJRNA выполняет совместный анализ рекуррентных сетей (JRNA) для двух временных рядов. Оба находятся в файле RQA.mqh наряду с существующими фасадами CRQA, CCRQA и CJRQA.
CRNA: анализ сети для одного временного ряда
Фасад CRNA объединяет CRQAMatrix и CRNAMetrics в один объект. Он поддерживает ту же настройку эпсилон, что и фасад CRQA: вы можете задать фиксированное значение эпсилон с помощью SetEpsilon() или воспользоваться автоматическим выбором с помощью SetEpsilonAuto().
CRNA rna;
rna.SetEmbedding(2, 1);
rna.SetNorm(RQA_NORM_EUCLIDEAN);
rna.SetEpsilonAuto(EPSILON_RR_TARGET, 0.05);
if(rna.Compute(close, copied))
   rna.PrintSummary();
Метод Compute() сначала выполняет автоматический выбор эпсилон, если он включен в настройках, затем строит матрицу рекуррентности и, наконец, вычисляет все двенадцать сетевых метрик. После того как метод Compute() вернет значение true, можно получить доступ к отдельным метрикам с помощью именованных методов доступа: AvgClustering(), Transitivity(), AvgPathLength(), AvgBetweenness(), Assortativity() и других. Метод PrintSummary() выводит все метрики в журнал "Эксперты".
//+------------------------------------------------------------------+
//| Build recurrence matrix and compute all network metrics          |
//+------------------------------------------------------------------+
bool CRNA::Compute(const double &series[], int N)
  {
   m_computed = false;
   m_result.Reset();
   if(N < 4)
     {
      Print("CRNA::Compute: series too short (min 4 bars)");
      return false;
     }
   double eps = m_epsilon;
   if(m_epsilonMethod != EPSILON_FIXED)
      eps = CRQAEpsilon::Select(series, N,
                 m_epsilonMethod, m_epsilonParam);
   m_epsilon = eps;
   if(!m_matrix.Build(series, N, eps, m_embDim, m_delay, m_norm))
      return false;
   if(!m_metrics.Compute(m_matrix, m_result))
      return false;
   m_computed = true;
   return true;
  }
Структура идентична структуре метода CRQA::Compute() из первой статьи, но вместо CRQAMetrics используется CRNAMetrics. Доступны те же стратегии CRQAEpsilon: EPSILON_FIXED, EPSILON_STD_FRACTION, EPSILON_RANGE_FRACTION и EPSILON_RR_TARGET.
CJRNA: совместный анализ сетей
Фасад CJRNA объединяет CJRQAMatrix и CRNAMetrics. Он принимает два временных ряда одинаковой длины и поддерживает отдельные значения эпсилон для каждого ряда.
CJRNA jrna;
jrna.SetEpsilon(0.05, 0.50);
jrna.SetEmbedding(2, 1);
if(jrna.Compute(closeX, closeY, len))
   jrna.PrintSummary();
Метод CJRNA::Compute() строит совместную матрицу рекуррентности, извлекает матрицу смежности без петель и передает ее методу CRNAMetrics::ComputeFromAdj(). Матрица смежности извлекается с помощью того же цикла, что и в CJRNAWindow: adj[i*N+j] = 1, если i != j и JR(i,j) = 1.
Индикатор RNA
Индикатор RNA_Indicator.mq5 отображает пять сетевых метрик в отдельном окне под ценовым графиком: средний коэффициент кластеризации (ACC), транзитивность, нормированную среднюю длину пути (NormAPL), ассортативность и среднюю центральность по посредничеству (AvgBetweenness). Эти пять показателей были выбраны, поскольку они отражают различные аспекты топологии сети: локальную кластеризацию, глобальную кластеризацию, связность, корреляцию степеней и центральность.
Настройка буферов и линий индикатора
#property indicator_separate_window
#property indicator_buffers 5
#property indicator_plots   5
#property indicator_label1  "ACC"
#property indicator_type1   DRAW_LINE
#property indicator_color1  clrDodgerBlue
#property indicator_width1  2
#property indicator_label2  "Transitivity"
#property indicator_type2   DRAW_LINE
#property indicator_color2  clrLimeGreen
#property indicator_width2  2
#property indicator_label3  "NormAPL"
#property indicator_type3   DRAW_LINE
#property indicator_color3  clrOrange
#property indicator_width3  2
#property indicator_label4  "Assortativity"
#property indicator_type4   DRAW_LINE
#property indicator_color4  clrViolet
#property indicator_width4  1
#property indicator_label5  "AvgBetweenness"
#property indicator_type5   DRAW_LINE
#property indicator_color5  clrRed
#property indicator_width5  1
Пять буферов, пять линий. Цветовая схема соответствует принятой в этой серии статей: синий и зеленый цвета используются для основных метрик (ACC и транзитивности), оранжевый — для метрики длины пути, фиолетовый и красный — для дополнительных метрик. Толщина линий равна 2 для трех наиболее важных метрик и 1 для дополнительных.
Входные параметры
#include <RQA\RQA.mqh>
input int    InpWindowSize   = 50;
input int    InpStep         = 1;
input int    InpEmbDim       = 1;
input int    InpDelay        = 1;
input double InpEpsilon      = 0.0;
input double InpEpsilonParam = 0.05;
input ENUM_EPSILON_METHOD InpEpsMethod = EPSILON_RR_TARGET;
input ENUM_RQA_NORM InpNorm  = RQA_NORM_EUCLIDEAN;
Параметры соответствуют стандартному индикатору RQA, описанному в первой статье. В конфигурации по умолчанию используется автоматический подбор эпсилон для достижения уровня рекуррентности 5%. Когда InpEpsilon равен 0.0 (значение по умолчанию), индикатор вызывает CRQAEpsilon::Select() для полного ценового ряда, чтобы определить порог. Если задано положительное значение, оно используется как фиксированное значение эпсилон.
Нормирование APL
Исходная средняя длина пути измеряется числом переходов (ребер). Для сети с N узлами максимально возможная длина кратчайшего пути равна N-1. Чтобы значения APL были сопоставимы при разных размерах окна, индикатор нормирует их делением на (N-1), где N — число векторов вложения в каждом окне. Таким образом, NormAPL принимает значения в диапазоне [0, 1], где 0 означал бы, что все узлы напрямую связаны друг с другом, а 1 — что сеть представляет собой линейную цепочку.
int    embN       = InpWindowSize - (InpEmbDim - 1) * InpDelay;
double normFactor = (embN > 1) ? 1.0 / (embN - 1) : 1.0;
//--- Inside the results loop:
BufferNormAPL[bar] = results[k].metrics.AvgPathLength * normFactor;
Это нормирование применяется только к буферу APL. Все остальные показатели отображаются в естественном масштабе. ACC и транзитивность по определению уже находятся в интервале [0, 1]. Ассортативность принимает значения в диапазоне [-1, 1]. Посредничество нормируется к диапазону [0, 1] в ходе вычислений.
Логика функции OnCalculate
В этом индикаторе используется инкрементальный метод вычисления. При полном пересчете (при первой загрузке) индикатор очищает все буферы, обрабатывает весь ценовой ряд с помощью CRNAWindow и сопоставляет результаты барам графика. При последующих тиках индикатор выполняет вычисления только для окон в конце ряда, охватывающих новые бары.
int OnCalculate(const int rates_total,
               const int prev_calculated, ...)
  {
   if(rates_total < InpWindowSize + 10) return 0;
   if(prev_calculated == rates_total) return rates_total;
   bool fullRecalc = (prev_calculated == 0);
   int  computeFrom;
   if(fullRecalc)
     {
      computeFrom = 0;
      ArrayInitialize(BufferACC,     EMPTY_VALUE);
      ArrayInitialize(BufferTrans,   EMPTY_VALUE);
      ArrayInitialize(BufferNormAPL, EMPTY_VALUE);
      ArrayInitialize(BufferAssort,  EMPTY_VALUE);
      ArrayInitialize(BufferBetween, EMPTY_VALUE);
     }
   else
      computeFrom = MathMax(0, prev_calculated - InpWindowSize);
   //--- Setup and run CRNAWindow
   CRNAWindow win;
   win.SetWindow(InpWindowSize, InpStep);
   win.SetEmbedding(InpEmbDim, InpDelay);
   win.SetNorm(InpNorm);
   //--- Auto-epsilon from full series
   if(InpEpsilon > 0.0)
      win.SetEpsilon(InpEpsilon);
   else
     {
      double fullSeries[];
      ArrayResize(fullSeries, rates_total);
      for(int i = 0; i < rates_total; i++)
         fullSeries[i] = close[i];
      double autoEps = CRQAEpsilon::Select(fullSeries, rates_total,
                                          InpEpsMethod, InpEpsilonParam);
      win.SetEpsilon(autoEps);
     }
   //--- Extract prices and run
   int computeLen = rates_total - computeFrom;
   double prices[];
   ArrayResize(prices, computeLen);
   for(int i = 0; i < computeLen; i++)
      prices[i] = close[computeFrom + i];
   SRNAWindowResult results[];
   if(!win.Run(prices, computeLen, results))
      return prev_calculated;
   //--- Map results to chart bars
   int nRes = ArraySize(results);
   for(int k = 0; k < nRes; k++)
     {
      int bar = results[k].barIndex + computeFrom
              + InpWindowSize - 1;
      if(bar >= 0 && bar < rates_total)
        {
         BufferACC[bar]     = results[k].metrics.AvgClustering;
         BufferTrans[bar]   = results[k].metrics.Transitivity;
         BufferNormAPL[bar] = results[k].metrics.AvgPathLength
                             * normFactor;
         BufferAssort[bar]  = results[k].metrics.Assortativity;
         BufferBetween[bar] = results[k].metrics.AvgBetweenness;
        }
     }
   return rates_total;
  }
Результаты присваиваются последнему бару каждого окна (barIndex + computeFrom + InpWindowSize - 1) в соответствии с правилом привязки результатов к барам, используемым во всех предыдущих индикаторах этой серии. Краткое название, отображаемое в окне индикатора, включает размер окна, размерность вложения и задержку: RNA(W=50, m=1, tau=1).
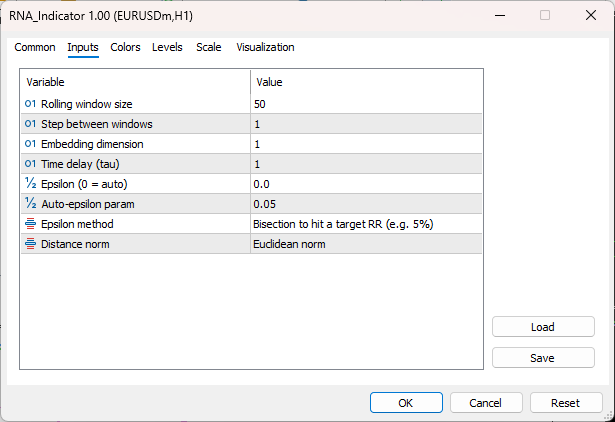
Рис. 5. Диалоговое окно настроек индикатора RNA с параметром эпсилон, размером окна, параметрами вложения и нормой расстояния
Индикатор JRNA
JRNA_Indicator.mq5 расширяет анализ рекуррентных сетей на два торговых инструмента. Он рассчитывает те же пять метрик (ACC, транзитивность, NormAPL, ассортативность, AvgBetweenness), но на основе совместной рекуррентной сети торгового инструмента текущего графика и второго торгового инструмента, заданного пользователем. Как и индикатор CRQA из второй статьи, он поддерживает выравнивание по временным меткам, встроенную нормализацию и инкрементальные вычисления.
Входные параметры и нормализация
enum ENUM_JRNA_NORMALIZE
  {
   JRNA_NORM_NONE    = 0,   // None (raw prices)
   JRNA_NORM_ZSCORE  = 1,   // Z-Score (recommended for cross-symbol)
   JRNA_NORM_RETURNS = 2    // Log Returns
  };
input string InpSymbolY      = "GBPUSD";
input int    InpWindowSize   = 50;
input int    InpStep         = 1;
input int    InpEmbDim       = 1;
input int    InpDelay        = 1;
input double InpEpsilon      = 0.5;
input ENUM_RQA_NORM InpNorm  = RQA_NORM_EUCLIDEAN;
input ENUM_JRNA_NORMALIZE InpNormalize = JRNA_NORM_RETURNS;
Перечисление режимов нормализации совпадает с используемым в индикаторе CRQA. Режим по умолчанию JRNA_NORM_RETURNS преобразует цены в логарифмическую доходность, а затем стандартизует полученный ряд с помощью z-оценок. Благодаря этому параметр "эпсилон" можно интерпретировать в единицах стандартного отклонения независимо от уровня цен на инструменты. Значение эпсилон, равное 0,5, означает "в пределах половины стандартного отклонения нормализованного ряда". Такое же значение по умолчанию используется в индикаторах CRQA и JRQA. Обратите внимание: в отличие от индикатора RNA для одного ряда, индикатор JRNA использует одно общее значение эпсилон для обоих рядов. Поскольку оба ряда нормализованы к одному и тому же масштабу (нулевое среднее, единичная дисперсия), использование одного значения эпсилон оправданно.
Выравнивание по временным меткам
Логика выравнивания идентична логике индикаторов CRQA и JRQA. Для получения данных второго торгового инструмента используются функции CopyTime и CopyClose, после чего оба массива datetime сопоставляются методом слияния, чтобы найти бары, для которых у обоих инструментов имеются данные с точно совпадающими временными метками. В анализ включаются только бары с совпадающими временными метками. Массив g_barMap сопоставляет индексы выровненных данных с позициями баров на графике для отображения результатов.
Логика функции OnCalculate
При полном пересчете индикатор выравнивает цены, выполняет нормализацию, очищает все буферы, создает объект CJRNAWindow, запускает его на выровненных и нормализованных данных и сопоставляет результаты с барами графика. При инкрементальном обновлении вся история данных заново выравнивается и нормализуется (поскольку нормализация зависит от глобальных статистик), но расчеты выполняются только для окон в конце ряда.
if(fullRecalc)
  {
   if(!AlignPrices(time, close, rates_total))
     { Print("JRNA_Indicator: alignment failed"); return 0; }
   ApplyNormalization();
   ArrayInitialize(BufferACC,     EMPTY_VALUE);
   ArrayInitialize(BufferTrans,   EMPTY_VALUE);
   ArrayInitialize(BufferNormAPL, EMPTY_VALUE);
   ArrayInitialize(BufferAssort,  EMPTY_VALUE);
   ArrayInitialize(BufferBetween, EMPTY_VALUE);
   CJRNAWindow win;
   SetupWindow(win);
   SRNAWindowResult results[];
   if(!win.Run(g_pricesX, g_validCount,
              g_pricesY, g_validCount, results))
     { Print("JRNA_Indicator: Run() failed"); return 0; }
   int    embN       = InpWindowSize - (InpEmbDim - 1) * InpDelay;
   double normFactor = (embN > 1) ? 1.0 / (embN - 1) : 1.0;
   int nRes = ArraySize(results);
   for(int k = 0; k < nRes; k++)
     {
      int lastValid = results[k].barIndex + InpWindowSize - 1;
      if(lastValid < g_validCount)
        {
         int bar = g_barMap[lastValid];
         BufferACC[bar]     = results[k].metrics.AvgClustering;
         BufferTrans[bar]   = results[k].metrics.Transitivity;
         BufferNormAPL[bar] = results[k].metrics.AvgPathLength
                             * normFactor;
         BufferAssort[bar]  = results[k].metrics.Assortativity;
         BufferBetween[bar] = results[k].metrics.AvgBetweenness;
        }
     }
  }
При сопоставлении баров используется элемент g_barMap[lastValid] для преобразования индекса выровненных данных обратно в фактическую позицию бара на графике, точно так же, как в индикаторах CRQA и JRQA. Результаты присваиваются последнему бару каждого окна. Краткое название содержит оба торговых инструмента: JRNA(EURUSD & GBPUSD, W=50).
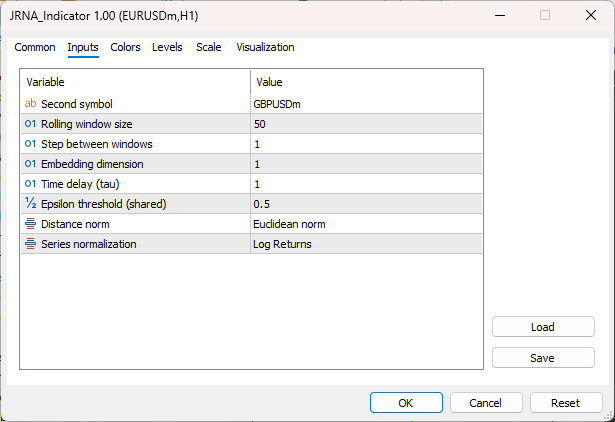
Рис. 6. Диалоговое окно настроек индикатора JRNA со вторым торговым инструментом, значением эпсилон, режимом нормализации и параметрами вложения
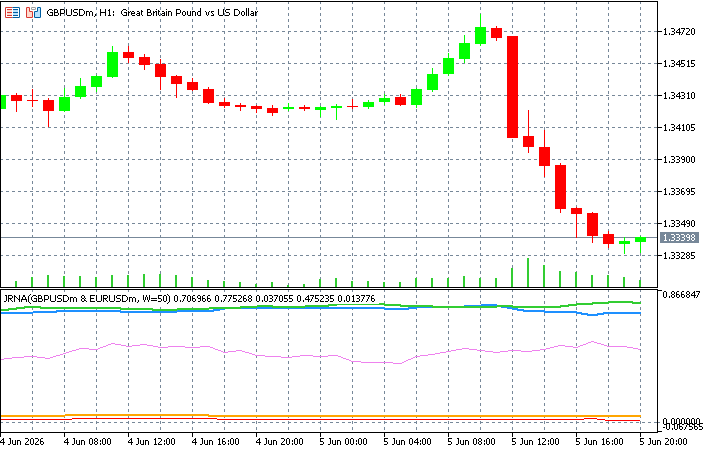
Рис. 7. Индикатор JRNA, сравнивающий GBPUSD и EURUSD и отображающий сетевые метрики, рассчитанные по совместным матрицам рекуррентности для скользящих окон
Что дальше?
Теперь библиотека охватывает четыре подхода к исследованию рекуррентности: количественный анализ рекуррентности (RQA) для одного ряда (подсчет линий), количественный анализ кросс-рекуррентности (CRQA) (сравнение двух рядов в пространстве состояний), количественный анализ совместной рекуррентности (JRQA) (одновременная саморекуррентность двух систем) и, наконец, анализ рекуррентных сетей (RNA) (топология графов, отражающих рекуррентные структуры). Каждый подход позволяет извлечь разную информацию из одних и тех же исходных данных.
Логичным следующим шагом станет применение этих инструментов в торговле. Среди возможных направлений можно выделить следующие:
- Использование сетевых метрик, вычисляемых в скользящем окне, в качестве признаков в модели классификации рыночных режимов. Характер поведения ACC и транзитивности различается в трендовом, боковом и волатильном режимах.
- Объединение метрик RQA (DET, LAM, ENTR) с метриками RNA (ACC, APL, Betweenness), полученными на основе одной и той же матрицы рекуррентности, для построения более полного набора признаков, отражающего как структуру линий, так и топологию графа.
- Сравнение метрик анализа рекуррентных сетей (RNA) для одного временного ряда с метриками совместного анализа рекуррентных сетей (JRNA) для выявления моментов, когда топологии сетей двух торговых инструментов начинают различаться, что сигнализирует о нарушении их общей динамики.
- Использование всплесков центральности по посредничеству для выявления моментов перехода между рыночными режимами, которые могут соответствовать сигналам входа в сделку или выхода из нее.
- Отслеживание изменений ассортативности для выявления сдвигов во внутренней корреляционной структуре рынка: положительная ассортативность (связи между узлами-концентраторами) и отрицательная ассортативность (связи между узлами-концентраторами и периферийными узлами) могут характеризовать различные фазы рынка.
Библиотека была разработана с учетом возможности расширения. Вычислительный модуль CRNAMetrics принимает любую квадратную матрицу смежности через метод ComputeFromAdj(), поэтому его можно без изменений использовать с новыми типами матриц рекуррентности, которые появятся в будущем. Добавление новых метрик графа (центральности по собственному вектору, модулярности, коэффициента клуба богатых) позволило бы расширить ComputeFromAdj() и SRNAResult без изменения интерфейсов существующих классов.
Заключение
Анализ рекуррентных сетей интерпретирует матрицу рекуррентности как сложную сеть и извлекает теоретико-графовые показатели, отражающие структурные свойства, которые не выявляются при традиционном подсчете линий в рамках количественного анализа рекуррентности (RQA). В данной статье представлена полная реализация на языке MQL5, состоящая из пяти новых файлов и одного обновленного существующего файла:
- CRNAMetrics вычисляет двенадцать графовых метрик на основе любой квадратной матрицы смежности: статистику степеней (AvgDegree, MaxDegree, DegreeStd), показатели кластеризации (ACC, Transitivity), метрики путей (APL, Diameter), показатели центральности (AvgBetweenness, MaxBetweenness, AvgCloseness), а также структурные показатели (Assortativity, Density). Для поиска кратчайших путей используется поиск в ширину (BFS), а для вычисления центральности по посредничеству — алгоритм Брандеса.
- CRNAWindow проводит сетевой анализ с помощью скользящего окна на одном временном ряду, строя матрицу рекуррентности для каждого окна и вычисляя все двенадцать метрик.
- CJRNAWindow распространяет сетевой анализ в скользящем окне на два временных ряда: строит совместную матрицу рекуррентности для каждого окна, извлекает из нее матрицу смежности и передает ее в CRNAMetrics.
- CRNA предоставляет высокоуровневый фасад для сетевого анализа одного временного ряда, последовательно связывая CRQAMatrix и CRNAMetrics и поддерживая автоматический выбор значения эпсилон.
- CJRNA предоставляет высокоуровневый фасад для совместного сетевого анализа, последовательно связывая CJRQAMatrix и CRNAMetrics и поддерживая отдельные значения эпсилон для каждого временного ряда.
Два индикатора (RNA_Indicator и JRNA_Indicator) отображают в режиме реального времени пять выбранных сетевых метрик: средний коэффициент кластеризации, транзитивность, нормированную среднюю длину пути, ассортативность и среднюю центральность по посредничеству. Индикатор JRNA поддерживает выравнивание по временным меткам и встроенную нормализацию для анализа разных торговых инструментов.
Все модули обратно совместимы с существующей библиотекой. Достаточно подключить один файл RQA.mqh, чтобы получить доступ ко всему: стандартному RQA, кросс-RQA, совместному RQA, а теперь и к анализу рекуррентных сетей. В предыдущих статьях этой серии были рассмотрены основы: в первой статье — RQA для одного временного ряда, во второй — CRQA, а в третьей — JRQA. ZIP-файл содержит полный код библиотеки из предыдущих статей.
| # | Имя файла | Тип | Описание |
|---|---|---|---|
| 1 | RQA.mqh | Подключаемый файл | Обновленный основной подключаемый файл с фасадами CRNA и CJRNA, добавленными наряду с существующими фасадами CRQA, CCRQA и CJRQA |
| 2 | RNAMetrics.mqh | Подключаемый файл | Модуль расчета метрик графа: степень узла, кластеризация, поиск в ширину (BFS), центральность по посредничеству (алгоритм Брандеса), центральность по близости, ассортативность |
| 3 | RNAWindow.mqh | Подключаемый файл | RNA в скользящем окне для одного временного ряда (только на CPU) |
| 4 | JRNAWindow.mqh | Подключаемый файл | JRNA в скользящем окне для двух временных рядов с использованием совместных матриц рекуррентности (только на CPU) |
| 5 | RNA_Indicator.mq5 | Индикатор | Индикатор рекуррентной сети для одного рынка, отображающий ACC, транзитивность, NormAPL, ассортативность и AvgBetweenness |
| 6 | JRNA_Indicator.mq5 | Индикатор | Индикатор рекуррентной сети для двух рынков с выравниванием по временным меткам, нормализацией и теми же пятью сетевыми метриками |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22652
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


