

Метаразметка классических стратегий (Часть 2): Фильтрация сделок по ADX и определение размера позиций
 43
 0

Содержание
- Введение
- Система ADX
- Почему пересечение линий DI не работает на боковом рынке
- Двухслойная гибридная модель
- Слой 1: оптимизация фильтра рыночного режима
- Слой 2: признаки и вторичный классификатор
- Пошаговая валидация (walk-forward)
- Результаты: три варианта стратегии
- Заключение
- Прикрепленные файлы
Введение
Пересечение линий DI формирует сигнал направления сделки всякий раз, когда +DI14 пересекает -DI14 снизу вверх или наоборот. При этом не учитывается, достаточно ли устойчиво направленное движение рынка в данный момент, чтобы позиция, открытая в рамках следования за трендом, успела окупить транзакционные издержки до разворота цены. На трендовом рынке пересечение линий DI часто дает четкий сигнал: доминирующая линия DI устойчиво растет, расстояние между линиями DI увеличивается, а цена движется в направлении открытой позиции. На боковом рынке две линии DI колеблются относительно друг друга, многократно пересекаясь в пределах одного и того же узкого ценового диапазона. Каждое такое пересечение по своей структуре выглядит точно так же, как пересечения, за которыми следовали четко выраженные трендовые движения. Логика входа в рынок не позволяет различить эти две ситуации.
Уэллс Уайлдер осознал это и встроил частичное решение проблемы непосредственно в саму систему. Рейтинг среднего индекса направленного движения (ADXR) — среднее значение ADX за p периодов — служит у Уайлдера фильтром рыночного режима: стратегию следования за трендом следует применять только тогда, когда ADXR превышает 25, и избегать её, когда ADXR опускается ниже 20. Точнее говоря, ADXR равен (текущее значение ADX + значение ADX n периодов назад)/2. Формула, приведённая в разделе 2, верна, однако данное словесное определение представляет собой упрощение. Это правило является необходимым, но не достаточным условием. Два пересечения линий DI с одинаковыми значениями ADXR могут привести к совершенно разным результатам в зависимости от того, растёт или падает ADX, каково расстояние между линиями DI в момент пересечения, как долго преобладает доминирующая линия DI и какова волатильность бара. Скалярный порог не позволяет учесть эту комбинаторную структуру.
В данной статье реализован двухслойный подход к преодолению этого ограничения. На первом уровне фиксированный порог ADXR, заданный Уайлдером, заменяется фильтром, настраиваемым на основе данных. С помощью Optuna выполняется байесовская оптимизация гиперпараметров (HPO): подбираются три параметра — порог ADXR, период расчета DI и минимальное расстояние между линиями DI — для максимизации точности (precision) сигналов на отложенном валидационном интервале. На втором уровне к каждому сигналу, прошедшему фильтр, применяется вторичный классификатор на основе алгоритма «случайный лес», использующий одиннадцать контекстных признаков, вычисленных на основе ADX на баре сигнала. Размер позиции масштабируется в зависимости от уверенности классификатора с помощью модуля afml.bet_sizing в соответствии с той же архитектурой определения размера позиции, которая была представлена в части 10 серии «Blueprint».
Конвейер обработки работает на данных EURUSD H1 из MetaTrader 5 за семь лет. В разделе 2 описывается построение индикатора ADX по методу Уайлдера в точном соответствии с исходным текстом. В разделе 3 даётся количественная оценка условий, в которых стратегия не работает. В разделах 4–6 описываются гибридная архитектура, этап оптимизации гиперпараметров (HPO) и вторичный классификатор. В разделах 7 и 8 рассматриваются вопросы валидации и результаты. Данная статья представляет собой аналитический материал с акцентом на Python; в сопутствующей статье серии, посвящённой MQL5, архитектура шины сигналов с двумя советниками из части 1 будет адаптирована для работы с ADX.
Это вторая часть серии «Метаразметка классических стратегий». В первой части тот же подход применялся к RSI, который не работает на трендовых рынках, — это структурно противоположная ситуация по отношению к рассматриваемой здесь. Конвейер использует методы из серий «MetaTrader 5 Machine Learning Blueprint» и «Конструирование признаков для машинного обучения»: разметка методом тройного барьера рассматривается в части 2 серии Blueprint; байесовская оптимизация гиперпараметров (HPO) — в части 8 серии Blueprint и части 9 серии Blueprint; определение размера позиции — в части 10 серии Blueprint; а используемые здесь признаки, кодирующие торговые сессии, — в части 3 серии «Конструирование признаков для машинного обучения».
Система ADX
Уэллс Уайлдер представил систему направленного движения в 1978 году в разделе IV книги «Новые концепции технических торговых систем». Расчет выполняется в шесть этапов: исходное направленное движение, истинный диапазон, сглаженное направленное движение, индикаторы направленности, индекс направленного движения и средний индекс направленного движения.
Направленное движение и истинный диапазон
Дневное направленное движение — это наибольшая часть сегодняшнего диапазона, выходящая за пределы вчерашнего диапазона. На каждом баре вычисляются две величины со знаком. Движение вверх — это разность между сегодняшним и вчерашним максимумами; движение вниз — разность между вчерашним и сегодняшним минимумами (оба значения положительны по построению). +DM равно величине движения вверх, если она превышает величину движения вниз и положительна; в противном случае оно равно нулю. -DM равно величине движения вниз, если она превышает величину движения вверх и положительна; в противном случае оно равно нулю. На любом баре не более одного из значений +DM и -DM отлично от нуля. Во внутренние дни, когда сегодняшний диапазон полностью находится внутри вчерашнего, направленное движение в обоих направлениях равно нулю.
Истинный диапазон — это наибольшее из трёх значений: разница между максимальной и минимальной ценами, расстояние от цены закрытия предыдущего дня до сегодняшнего максимума и расстояние от цены закрытия предыдущего дня до сегодняшнего минимума. Это всегда положительное число. Уайлдер использует истинный диапазон, а не разницу между максимальным и минимальным значениями, чтобы правильно учитывать открытия с гэпом.
Сглаженные индикаторы DI и ADX
Уайлдер сглаживает +DM, -DM и истинный диапазон в окне из 14 баров, используя метод накопления, который отличается от стандартного экспоненциального скользящего среднего. Пусть текущее сглаженное значение равно S, а новое исходное наблюдение — r:
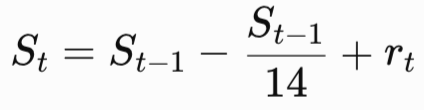
Первое сглаженное значение представляет собой сумму исходных значений за первые четырнадцать баров. Все последующие значения вычисляются по рекуррентной формуле. Ведутся три параллельных сглаженных ряда: +DM14, -DM14 и TR14. Положительный индикатор направленности рассчитывается по формуле +DI14 = 100 × +DM14 / TR14; отрицательный индикатор направленности — по формуле -DI14 = 100 × -DM14 / TR14. Оба показателя выражают в процентах долю истинного диапазона за 14 баров, приходящуюся на движение в каждом направлении.
Индекс направленного движения (DX) представляет собой разность между +DI14 и -DI14, деленную на их сумму и умноженную на 100. Он всегда находится в диапазоне [0, 100]: равен нулю, когда оба индикатора равны (направленность отсутствует), и равен 100, когда один из них равен нулю (движение только в одном направлении). Средний индекс направленного движения (ADX) представляет собой среднее значение DX за тот же период из 14 баров, рассчитанное с использованием сглаживания Уайлдера. Первое значение ADX представляет собой среднее первых четырнадцати значений DX; последующие значения рассчитываются по той же рекуррентной формуле, что и выше. Первое корректное значение ADX появляется на баре 2 × 14 − 1 = 27. ADXR представляет собой среднее текущего значения ADX и значения ADX 14 баров назад, давая более сглаженную оценку качества рыночного режима: ADXR = (ADXсегодня + ADX14 дней назад) / 2.
Вход по пересечению линий DI и правило экстремальной точки
Торговое правило Уайлдера просто: открывайте длинную позицию, когда +DI14 пересекает -DI14 снизу вверх; открывайте короткую позицию, когда -DI14 пересекает +DI14 снизу вверх. В день пересечения экстремум данного бара становится защитным стопом позиции. При открытии длинной позиции стоп-уровнем служит минимум бара пересечения; при открытии короткой позиции — максимум. Если происходит обратное пересечение, а цена при этом не достигает экстремальной точки, позиция не закрывается сразу — экстремум исходного бара входа остается стоп-уровнем до тех пор, пока линии DI снова не пересекутся в противоположном направлении.
Реализация на Python
Класс ADXSystem точно реализует описанную выше конструкцию, сохраняя рекуррентное соотношение сглаживания Уайлдера вместо использования стандартной экспоненциальной скользящей средней. Класс ADXSignalGenerator выявляет пересечения линий DI и применяет параметризованный фильтр рыночного режима.
import numpy as np
import pandas as pd

class ADXSystem:
    """
    Implements Wilder's Directional Movement System, Section IV of
    'New Concepts in Technical Trading Systems' (1978).

    Wilder's smoothing recurrence for period p:
        S_t = S_{t-1} - S_{t-1} / p + r_t
    where the first value S_p = sum(r[1] ... r[p]).
    Applied independently to +DM, -DM, and TR.
    ADX is first valid at bar 2*p - 1.
    """

    def __init__(self, period: int = 14) -> None:
        self.period = period

    def compute(
        self,
        high: pd.Series,
        low: pd.Series,
        close: pd.Series,
    ) -> pd.DataFrame:
        """
        Parameters
        ----------
        high, low, close : pd.Series
            OHLC series with a shared DatetimeIndex.

        Returns
        -------
        pd.DataFrame with columns:
            plus_di14, minus_di14, dx, adx, adxr
        """
        n = len(high)
        p = self.period

        # ── 1. Raw directional movement ─────────────────────────────────────
        up_move   = high.diff().values
        down_move = (-low.diff()).values

        plus_dm  = np.where(
            (up_move > down_move) & (up_move > 0), up_move, 0.0
        )
        minus_dm = np.where(
            (down_move > up_move) & (down_move > 0), down_move, 0.0
        )

        # ── 2. True range ───────────────────────────────────────────────────
        hl = (high - low).values
        hc = (high - close.shift(1)).abs().values
        lc = (low  - close.shift(1)).abs().values
        tr = np.maximum(hl, np.maximum(hc, lc))

        # ── 3. Wilder smoothing (not standard EMA) ──────────────────────────
        tr14  = np.full(n, np.nan)
        pdm14 = np.full(n, np.nan)
        mdm14 = np.full(n, np.nan)

        tr14[p]  = tr[1 : p + 1].sum()
        pdm14[p] = plus_dm[1 : p + 1].sum()
        mdm14[p] = minus_dm[1 : p + 1].sum()

        for i in range(p + 1, n):
            tr14[i]  = tr14[i - 1]  - tr14[i - 1]  / p + tr[i]
            pdm14[i] = pdm14[i - 1] - pdm14[i - 1] / p + plus_dm[i]
            mdm14[i] = mdm14[i - 1] - mdm14[i - 1] / p + minus_dm[i]

        # ── 4. Directional indicators ────────────────────────────────────────
        with np.errstate(divide="ignore", invalid="ignore"):
            plus_di14  = np.where(tr14 > 0, 100.0 * pdm14 / tr14, np.nan)
            minus_di14 = np.where(tr14 > 0, 100.0 * mdm14 / tr14, np.nan)

        # ── 5. DX: bounded [0, 100] ─────────────────────────────────────────
        di_sum  = plus_di14 + minus_di14
        di_diff = np.abs(plus_di14 - minus_di14)
        with np.errstate(divide="ignore", invalid="ignore"):
            dx = np.where(di_sum > 0, 100.0 * di_diff / di_sum, np.nan)

        # ── 6. ADX: mean of first p DX values; Wilder smoothing thereafter ──
        adx = np.full(n, np.nan)
        first_adx = 2 * p - 1
        adx[first_adx] = np.nanmean(dx[p : first_adx + 1])

        for i in range(first_adx + 1, n):
            adx[i] = (adx[i - 1] * (p - 1) + dx[i]) / p

        # ── 7. ADXR: average of ADX today and ADX p bars ago ────────────────
        adxr = np.full(n, np.nan)
        for i in range(first_adx + p, n):
            adxr[i] = (adx[i] + adx[i - p]) / 2.0

        return pd.DataFrame(
            {
                "plus_di14":  plus_di14,
                "minus_di14": minus_di14,
                "dx":         dx,
                "adx":        adx,
                "adxr":       adxr,
            },
            index=high.index,
        )

class ADXSignalGenerator:
    """
    Extracts DI crossover events from a precomputed ADX DataFrame.

    Long: +DI14 crosses above -DI14 while gate conditions are met.
    Short: -DI14 crosses above +DI14 while gate conditions are met.
    The extreme price from Wilder's Extreme Point Rule is recorded
    alongside each signal for stop-placement use in the MQL5 companion.

    Parameters
    ----------
    adxr_threshold : float
        Minimum ADXR value. Wilder's default is 25.
    min_di_separation : float
        Minimum |+DI14 - -DI14| at the crossover bar.
    """

    def __init__(
        self,
        adxr_threshold: float = 25.0,
        min_di_separation: float = 0.0,
    ) -> None:
        self.adxr_threshold    = adxr_threshold
        self.min_di_separation = min_di_separation

    def get_signals(
        self,
        adx_df: pd.DataFrame,
        high: pd.Series,
        low: pd.Series,
    ) -> pd.DataFrame:
        """
        Returns a DataFrame indexed by signal timestamp, with columns:
            side    (int8)  : +1 Long, -1 Short
            extreme (float) : Wilder Extreme Point for stop placement
        """
        pdi  = adx_df["plus_di14"]
        mdi  = adx_df["minus_di14"]
        adxr = adx_df["adxr"]

        long_cross  = (pdi > mdi) & (pdi.shift(1) <= mdi.shift(1))
        short_cross = (mdi > pdi) & (mdi.shift(1) <= pdi.shift(1))

        adxr_gate = adxr >= self.adxr_threshold
        sep_gate  = (pdi - mdi).abs() >= self.min_di_separation

        long_ok  = long_cross  & adxr_gate & sep_gate
        short_ok = short_cross & adxr_gate & sep_gate

        rows = []
        for ts in adx_df.index[long_ok]:
            rows.append({
                "t": ts,
                "side": np.int8(1),
                "extreme": float(low.loc[ts]),
            })
        for ts in adx_df.index[short_ok]:
            rows.append({
                "t": ts,
                "side": np.int8(-1),
                "extreme": float(high.loc[ts]),
            })

        if not rows:
            return pd.DataFrame(columns=["side", "extreme"])

        return (
            pd.DataFrame(rows)
            .set_index("t")
            .sort_index()
            .astype({"side": np.int8, "extreme": float})
        )
Почему пересечение линий DI не работает на боковом рынке
По своей структуре ADX/DI противоположен RSI. RSI — это инструмент, основанный на принципе возврата к среднему, который теряет эффективность при тренде: его предпосылка — после достижения экстремумов происходит возврат к среднему — перестает работать, когда каждый новый экстремум обусловлен структурными факторами. ADX/DI — это инструмент для следования за трендом, который теряет эффективность на боковом рынке: его предпосылка — пересечения линий DI отмечают начало устойчивого направленного движения — не выполняется, когда линии DI колеблются и ни одна из них не достигает устойчивого преобладания.
Наглядный пример — данные за 2023 календарный год в наборе EURUSD H1. После того как структурный тренд доллара США 2022 года исчерпал себя, пара EURUSD большую часть 2023 года находилась в диапазоне 1.05–1.10. Линии DI неоднократно пересекались в пределах этого диапазона. Каждое пересечение соответствовало правилу входа Уайлдера, но ни одно не приводило к движению, достаточному для покрытия спреда, комиссии и потерь из-за ошибок в определении направления. Пересечения не запаздывали — они происходили точно на баре смены режима. Проблема носит структурный характер: на боковом рынке по определению происходят частые смены режима, а система на основе пересечений линий DI не способна отличить настоящее начало тренда от вызванных шумом колебаний двух линий DI относительно друг друга.
На рисунке 1 наглядно показаны последствия этой проблемы для простой стратегии на основе пересечений линий DI за трехлетний тестовый период с января 2022 года по декабрь 2024 года.
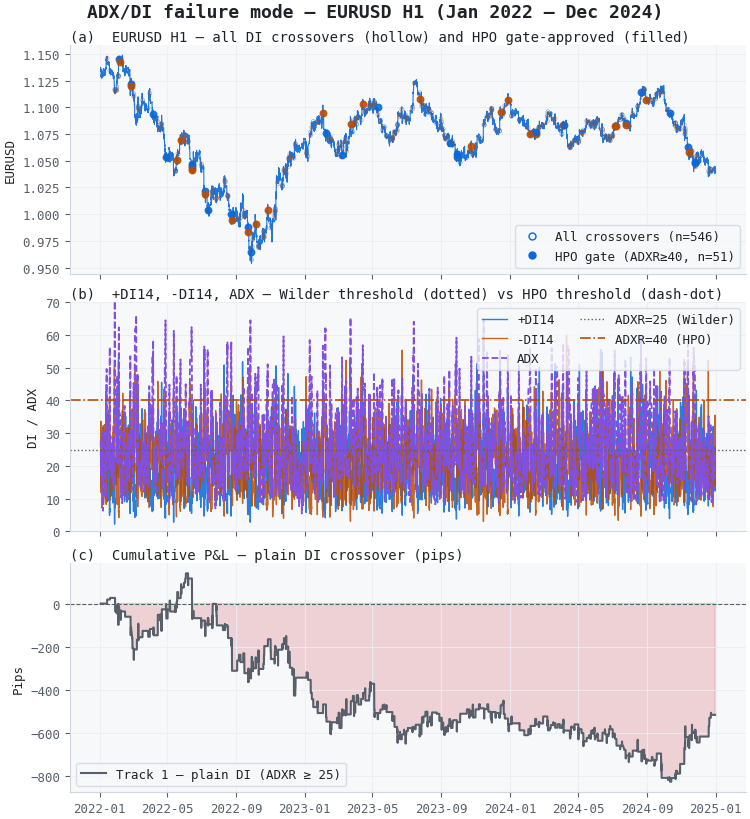
Рисунок 1. Иллюстрация сценария неэффективности ADX/DI на EURUSD H1 на трех графиках
- График (a): цена EURUSD H1 со всеми сигналами пересечения линий DI (незакрашенные маркеры) и подмножеством сигналов, прошедших фильтр рыночного режима (закрашенные маркеры). Пунктирная вертикальная линия обозначает границу между обучающей и тестовой выборками. На период бокового рынка в 2023 году приходится скопление незакрашенных маркеров, однако трендового движения, которое подтвердило бы эти сигналы, не возникает.
- График (b): +DI14, -DI14 и ADX за тестовый период. На боковом рынке две линии DI колеблются вблизи друг друга; ADX остается низким, подтверждая отсутствие направленной структуры, которую сигналы пересечения линий не позволяют распознать.
- График (c): накопленная прибыль/убыток простой стратегии на основе пересечений линий DI за тестовый период. Максимальная просадка приходится на период бокового рынка, когда плотность сигналов максимальна, а средняя доходность за период удержания позиции отрицательна.
Двухслойная гибридная модель
Подход к метаразметке, описанный в главе 3 книги Маркоса Лопеса де Прадо Advances in Financial Machine Learning, разделяет две разные задачи прогнозирования. Основная модель прогнозирует направление сделки: в какую сторону торговать при срабатывании ее сигнала. Вторичная модель прогнозирует целесообразность сделки: будет ли текущий сигнал основной модели с высокой вероятностью прибыльным с учетом контекста, который основная модель не учитывает. Точность (precision) основной модели — это верхний, а не нижний предел: вторичная модель может лишь отфильтровывать сигналы, но не добавлять новые, поэтому комбинированная стратегия занимает в пространстве сигналов область с более высокой точностью и более низкой полнотой, чем основная модель сама по себе.
В гибридной модели перед вторичным классификатором добавлен фильтр рыночного режима. В ней используется байесовская оптимизация гиперпараметров (HPO) для поиска параметров, позволяющих отделить сигналы, которые с высокой вероятностью возникают в трендовых режимах, от остальных. Фильтр и классификатор дополняют друг друга. Фильтр отвечает на общий вопрос: наблюдается ли на рынке направленное движение, при котором сигнал следования за трендом структурно обоснован? Классификатор отвечает на более детальный вопрос: если рыночный режим подходит, указывает ли контекст конкретного бара пересечения линий DI на то, что сигнал будет успешным?
Фильтр задается тремя параметрами, значения которых подбираются при поиске:
- adxr_threshold: минимальное значение ADXR, необходимое для допуска сигнала. В исходном варианте Уайлдера это значение равно 25; при HPO поиск ведется в диапазоне [15, 50].
- di_period: период расчета для сглаживания DM и TR. В исходном варианте Уайлдера это значение равно 14; при HPO поиск ведется в диапазоне [7, 28].
- min_di_separation: минимальное расстояние между линиями DI, |+DI14 − -DI14|, на баре пересечения; этот порог отфильтровывает пересечения, при которых значения двух линий почти равны. HPO выполняет поиск в диапазоне [0, 15].
Архитектура представлена на рисунке 2.
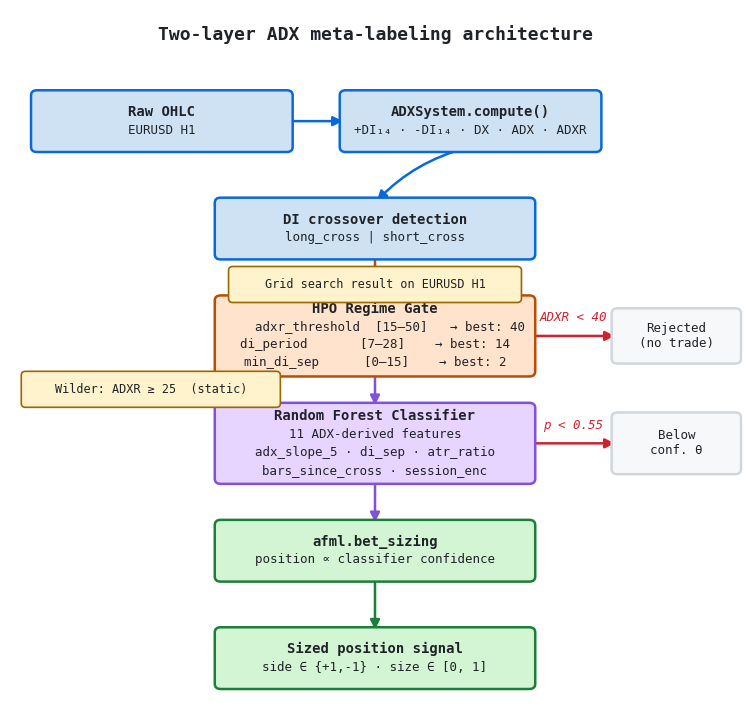
Рисунок 2. Блок-схема двухслойной архитектуры метаразметки на основе ADX
- Этап 1 — расчет ADX: исходные данные OHLC поступают в ADXSystem, где вычисляются +DI14, -DI14, ADX и ADXR.
- Этап 2 — фильтр HPO: каждый сигнал пересечения линий DI проверяется по трем параметрам, оптимизированным с помощью Optuna. Сигналы, отклоненные фильтром, отбрасываются. Сигналы, удовлетворяющие всем трём условиям, поступают на вторичный классификатор.
- Этап 3 — вторичный классификатор: вторичная модель на основе алгоритма «случайный лес» получает одиннадцать признаков, сформированных на основе ADX и вычисленных на сигнальном баре, и выдает оценку вероятности. Сигналы с уверенностью классификатора ниже порога отбрасываются; для одобренных сигналов размер позиции определяется в зависимости от уверенности классификатора с помощью afml.bet_sizing.
Уровень 1: Оптимизация фильтра рыночного режима
Правило Уайлдера «ADXR ≥ 25» было сформулировано на основе визуального анализа графиков цен на сырьевые товары 1970-х годов. Для современных данных валютного рынка с часовым разрешением по инструменту с существенно иным профилем волатильности нет априорных оснований ожидать, что этот порог будет оптимальным. Тот же аргумент применим и к периоду расчета DI: 14 баров были выбраны как приблизительная длительность половины цикла для сырьевых рынков, которые изучал Уайлдер, а не для EURUSD H1. Параметр минимального расстояния между линиями DI у Уайлдера вообще отсутствует; его введение — естественное расширение подхода, если сформулировать задачу как задачу поиска.
Целевая функция HPO вычисляет точность (precision) сигналов на отложенном валидационном интервале (последние 30 % обучающих данных) для каждой комбинации параметров фильтра. Точность — подходящая метрика для фильтра: его цель — отсеивать ложные входы в рынок, а не максимизировать число входов. В исследовании Optuna используется алгоритм выбора гиперпараметров TPE, который строит вероятностную модель пространства параметров на основе завершенных испытаний; это позволяет в последующих испытаниях сосредоточиться на областях параметров, обеспечивших высокую точность в предыдущих испытаниях, и найти подходящий порог за гораздо меньшее число оценок, чем потребовалось бы при поиске по сетке.
import optuna
from afml.cross_validation.cross_validation import PurgedKFold
from afml.labeling.triple_barrier import get_events, get_bins


def adx_hpo_objective(
    trial: optuna.Trial,
    ohlc: pd.DataFrame,
    close: pd.Series,
    val_fraction: float = 0.30,
) -> float:
    """
    Optuna objective for joint optimization of the ADX regime gate.

    Searched parameters
    -------------------
    adxr_threshold    : float in [15, 50]
    di_period         : int   in [7, 28]
    min_di_separation : float in [0, 15]

    Objective
    ---------
    Mean precision of gated signals against triple-barrier labels,
    evaluated on the held-out validation window (last val_fraction of data).
    Trials with fewer than 20 gated signals are pruned.
    """
    adxr_threshold    = trial.suggest_float("adxr_threshold",    15.0, 50.0)
    di_period         = trial.suggest_int  ("di_period",           7,   28)
    min_di_separation = trial.suggest_float("min_di_separation",   0.0, 15.0)

    adx_sys = ADXSystem(period=di_period)
    adx_df  = adx_sys.compute(ohlc["high"], ohlc["low"], ohlc["close"])
    sig_gen = ADXSignalGenerator(
        adxr_threshold=adxr_threshold,
        min_di_separation=min_di_separation,
    )
    signals = sig_gen.get_signals(adx_df, ohlc["high"], ohlc["low"])

    if len(signals) < 20:
        raise optuna.exceptions.TrialPruned()

    # Triple-barrier labeling — pass primary model's side predictions
    atr14 = close.pct_change().rolling(di_period).std()
    events = get_events(
        close=close,
        t_events=signals.index,
        pt_sl=[1.5, 1.5],
        target=atr14,
        min_ret=0.0005,
        num_threads=1,
        t1=None,
        side_prediction=signals["side"],
    )
    labels = get_bins(events, close).dropna()

    if len(labels) < 20:
        raise optuna.exceptions.TrialPruned()

    # Time-ordered hold-out: evaluate on last val_fraction
    split = int(len(labels) * (1.0 - val_fraction))
    labels_val = labels.iloc[split:]

    if len(labels_val) < 10:
        raise optuna.exceptions.TrialPruned()

    precision = float((labels_val["bin"] == 1).mean())
    return precision

def run_adx_hpo(
    ohlc: pd.DataFrame,
    close: pd.Series,
    n_trials: int = 200,
    study_name: str = "adx_gate_hpo",
    storage: str = "sqlite:///adx_hpo.db",
) -> optuna.Study:
    """Run the Bayesian gate search and return the completed study."""
    sampler = optuna.samplers.TPESampler(seed=42)
    study   = optuna.create_study(
        direction="maximize",
        sampler=sampler,
        study_name=study_name,
        storage=storage,
        load_if_exists=True,
    )
    study.optimize(
        lambda trial: adx_hpo_objective(trial, ohlc, close),
        n_trials=n_trials,
        catch=(ValueError,),
    )
    return study
Использование SQLite для хранения результатов позволяет возобновить прерванный запуск с последнего завершенного испытания — по той же схеме сохранения состояния исследования, что и в части 9 Blueprint. После завершения исследования лучшие параметры используются для формирования потока сигналов, прошедших фильтр, который подается на вход вторичному классификатору.
Уровень 2: Признаки и вторичный классификатор
Вторичный классификатор получает каждый сигнал, прошедший фильтр, и выдает вероятность того, что сигнал окажется прибыльным, то есть будет отнесен к классу 1 при разметке методом тройного барьера. В качестве классификатора используется случайный лес, что соответствует архитектуре из части 1. На сигнальном баре рассчитываются одиннадцать признаков, каждый из которых отражает отдельный аспект состояния системы ADX, не учитываемый скалярным порогом Уайлдера.
Набор признаков
Эти одиннадцать признаков делятся на три группы:
- Признаки силы тренда: adx_level — значение ADX на сигнальном баре; adxr_level — значение ADXR на сигнальном баре; adx_slope_5 — изменение ADX за пять баров, предшествующих сигналу, показывающее, нарастает или ослабевает сила тренда.
- Признаки качества пересечения: di_separation — |+DI14 − -DI14| на сигнальном баре, характеризующее выраженность пересечения; di_separation_delta — изменение расстояния между линиями DI за предыдущие три бара, показывающее, расходятся или сходятся линии в момент пересечения; adx_above_both_di — бинарный индикатор того, что ADX превышает значения обеих линий DI, что Уайлдер считает сигналом разворота; atr_ratio — истинный диапазон бара, деленный на ATR за 14 баров, показывающий, произошло ли пересечение на необычно активном или спокойном баре.
- Признаки устойчивости рыночного режима: bars_since_last_cross — число баров, прошедших с предыдущего пересечения линий DI, отражающее риск неустойчивых колебаний рынка (частые пересечения указывают на режим бокового рынка); dominant_di_duration — число последовательных баров до этого пересечения, на которых доминировала линия DI, теперь теряющая преимущество; этот признак отражает возраст завершающегося тренда; session_sin, session_cos — кодирование торговой сессии с помощью синуса и косинуса по схеме из части 3 «Конструирование признаков».
import numpy as np
import pandas as pd

def compute_adx_features(
    adx_df: pd.DataFrame,
    high: pd.Series,
    low: pd.Series,
    close: pd.Series,
    signals: pd.DataFrame,
) -> pd.DataFrame:
    """
    Compute eleven ADX-derived features at each signal bar.

    Parameters
    ----------
    adx_df  : pd.DataFrame  Output of ADXSystem.compute().
    high, low, close : pd.Series  Raw OHLC.
    signals : pd.DataFrame  Output of ADXSignalGenerator.get_signals().

    Returns
    -------
    pd.DataFrame indexed on signal timestamps with eleven feature columns.
    """
    pdi  = adx_df["plus_di14"]
    mdi  = adx_df["minus_di14"]
    adx  = adx_df["adx"]
    adxr = adx_df["adxr"]

    # ── True range and ATR ──────────────────────────────────────────────
    hl = (high - low)
    hc = (high - close.shift(1)).abs()
    lc = (low  - close.shift(1)).abs()
    tr  = pd.concat([hl, hc, lc], axis=1).max(axis=1)
    atr = tr.rolling(14).mean()

    # ── DI separation ───────────────────────────────────────────────────
    di_sep = (pdi - mdi).abs()

    # ── Session encoding (hours 0-23 → sine/cosine) ─────────────────────
    hour = pd.Series(signals.index.hour, index=signals.index)
    session_sin = np.sin(2 * np.pi * hour / 24.0)
    session_cos = np.cos(2 * np.pi * hour / 24.0)

    rows = []
    idx  = adx_df.index

    for ts in signals.index:
        pos = idx.get_loc(ts)

        # ── Trend strength ───────────────────────────────────────────────
        adx_lev  = float(adx.iloc[pos])
        adxr_lev = float(adxr.iloc[pos])
        adx_slp  = float(adx.iloc[pos] - adx.iloc[max(0, pos - 5)]) / 5.0

        # ── Crossover quality ────────────────────────────────────────────
        di_sep_now   = float(di_sep.iloc[pos])
        di_sep_delta = float(di_sep.iloc[pos] - di_sep.iloc[max(0, pos - 3)])
        adx_above    = float(
            adx.iloc[pos] > max(pdi.iloc[pos], mdi.iloc[pos])
        )
        atr_r = (float(tr.iloc[pos]) / float(atr.iloc[pos])
                 if float(atr.iloc[pos]) > 0 else np.nan)

        # ── Regime persistence ───────────────────────────────────────────
        # Bars since last crossover (look back up to 100 bars)
        look_back = min(pos, 100)
        pdi_hist = pdi.values[pos - look_back : pos]
        mdi_hist = mdi.values[pos - look_back : pos]
        prev_crosses = np.where(
            np.diff(np.sign(pdi_hist - mdi_hist)) != 0
        )[0]
        bars_since = look_back - int(prev_crosses[-1]) if len(prev_crosses) > 0 \
                     else look_back

        # Consecutive bars the reversing DI was dominant
        side = int(signals.loc[ts, "side"])
        dom  = pdi_hist if side == 1 else mdi_hist
        sub  = mdi_hist if side == 1 else pdi_hist
        dominant_run = 0
        for k in range(len(dom) - 1, -1, -1):
            if dom[k] > sub[k]:
                dominant_run += 1
            else:
                break

        rows.append({
            "adx_level":            adx_lev,
            "adxr_level":           adxr_lev,
            "adx_slope_5":          adx_slp,
            "di_separation":        di_sep_now,
            "di_separation_delta":  di_sep_delta,
            "adx_above_both_di":   adx_above,
            "atr_ratio":            atr_r,
            "bars_since_last_cross": bars_since,
            "dominant_di_duration": dominant_run,
            "session_sin":          float(session_sin.loc[ts]),
            "session_cos":          float(session_cos.loc[ts]),
        })

    return pd.DataFrame(rows, index=signals.index)
Обучение вторичного классификатора
Вторичный классификатор обучается с использованием конвейера из части 9 Blueprint, причем режим метаразметки включается передачей направлений сигналов, прошедших фильтр, в функцию get_events через параметр side_prediction. Полученные метки принимают значения bin ∈ {0, 1}: 1 — если сделка в направлении, заданном основной моделью, оказалась прибыльной в пределах окна метода тройного барьера, 0 — в противном случае. Классификатор получает только одиннадцать контекстных признаков; он никогда напрямую не учитывает исходную цену или направление базового сигнала.
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from afml.cross_validation.cross_validation import PurgedKFold

def train_secondary_classifier(
    X_train: pd.DataFrame,
    y_train: pd.Series,
    sample_weights: pd.Series,
) -> Pipeline:
    """
    Fit a Random Forest secondary classifier on the meta-labeled gate-approved signals.
    PurgedKFold cross-validation is used inside the HPO stage of Blueprint Part 9;
    here we fit the final model on the full training window.
    """
    clf = RandomForestClassifier(
        n_estimators=500,
        max_features="sqrt",
        min_samples_leaf=5,
        class_weight="balanced_subsample",
        random_state=42,
        n_jobs=-1,
    )
    clf.fit(X_train.values, y_train.values, sample_weight=sample_weights.values)
    return clf
Ранжирование важности признаков классификатором, обученным на внутривыборочных данных (рис. 3), показывает, что наибольшую предсказательную важность имеет adx_slope_5 (MDI = 0.17), за ним следуют atr_ratio (0.14) и di_separation (0.12). Бинарный индикатор adx_above_both_di — сигнал разворота, предложенный самим Уайлдером, — имеет нулевую важность; классификатор не находит в нем дополнительной предсказательной информации сверх той, которую уже содержат непрерывные признаки ADX и расстояния между линиями DI.
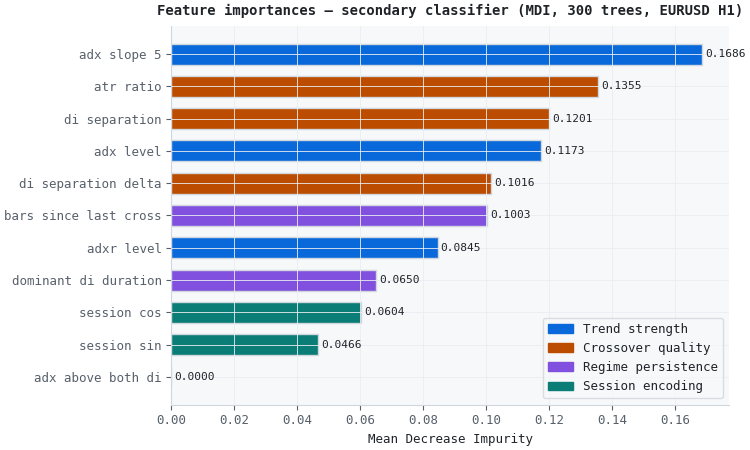
Рисунок 3. Важность признаков вторичного классификатора «случайный лес» (MDI, 300 деревьев, EURUSD H1, внутривыборочный период)
- Лидирующая группа: adx_slope_5 (сила тренда, синий) и atr_ratio (качество пересечения, оранжевый) занимают первые места и в совокупности обеспечивают 30 % общего уменьшения неоднородности. Признак наклона отражает, ускоряется ли рост ADX к моменту пересечения; отношение истинного диапазона к ATR показывает, был ли сам бар пересечения аномальным.
- Признак с нулевой важностью: adx_above_both_di (бинарный индикатор разворота Уайлдера) дает нулевой вклад в уменьшение неоднородности. Непрерывные признаки уже содержат всю информацию, которую несет этот индикатор.
Пошаговая валидация (walk-forward)
Семилетний набор данных EURUSD H1 (январь 2018 г. — декабрь 2024 г.) разделён на две части с границей в январе 2022 г. Первые 48 месяцев составляют внутривыборочный период (HPO и обучение вторичного классификатора). Следующие 36 месяцев составляют вневыборочный период (оценка трёх вариантов стратегии в разделе 8). Оптимизация гиперпараметров (HPO) проводится на последних 30 % внутривыборочного интервала для подбора параметров фильтра рыночного режима; вторичный классификатор обучается на всех внутривыборочных сигналах, прошедших фильтр с этими параметрами. И параметры фильтра, и веса классификатора фиксируются до обращения к каким-либо вневыборочным данным.
Веса обучающих примеров для вторичного классификатора рассчитываются по схеме на основе уникальности из части 5 «Blueprint»: каждой метке присваивается вес, равный её средней уникальности среди одновременно активных меток. Схема пошаговой валидации (walk-forward) использует один этап с расширяющимся окном вместо нескольких этапов со скользящими окнами; поскольку во внутривыборочном периоде фильтр проходят лишь несколько сотен сигналов, при многоэтапной схеме на каждом этапе оказалось бы слишком мало меток, чтобы вторичный классификатор мог обучиться устойчивой границе принятия решений.
Результаты: три варианта стратегии
На вневыборочном периоде проводится оценка трёх потоков сигналов. Вариант стратегии 1 предусматривает торговлю по всем пересечениям линий DI с исходным порогом Уайлдера ADXR ≥ 25 и без классификатора. Вариант стратегии 2 предусматривает торговлю только по сигналам, прошедшим фильтр, оптимизированный с помощью Optuna, без классификатора — это позволяет выделить вклад фильтра, настроенного с помощью HPO, по сравнению с фиксированным порогом Уайлдера. В варианте стратегии 3 добавляются вторичный классификатор и определение размера позиции: прошедшие фильтр сигналы с уверенностью классификатора ниже порога отбрасываются, а для сигналов с уверенностью выше порога размер позиции определяется по этой уверенности с помощью afml.bet_sizing.
Показатели в расчёте на сделку и кривые капитала для трёх вариантов стратегии представлены на рисунке 4.
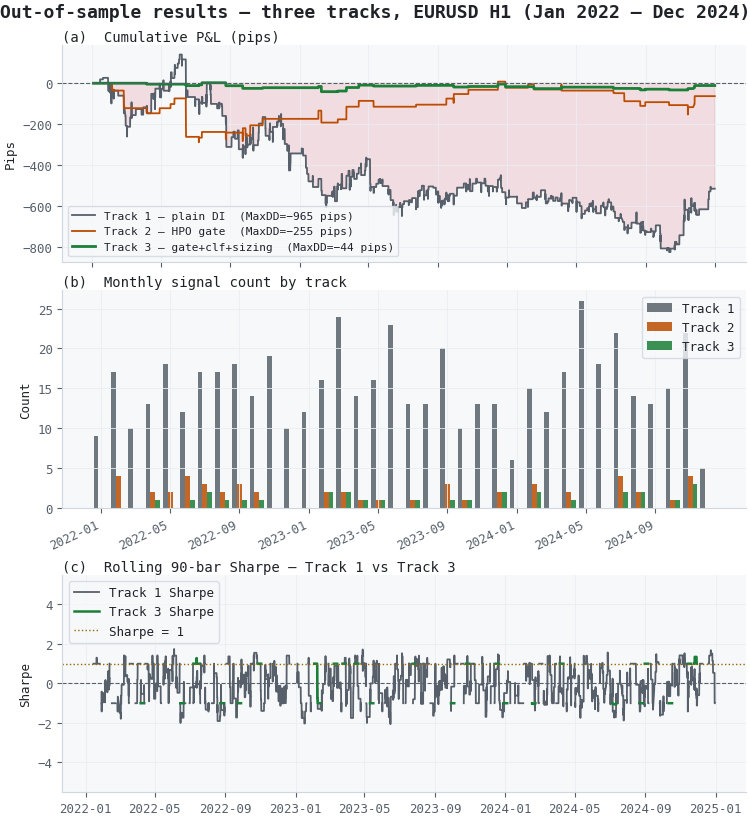
Рисунок 4. Иллюстрация из трёх панелей с вневыборочными результатами трёх вариантов стратегии на EURUSD H1
- Панель (a): накопленная прибыль/убыток по всем трём вариантам стратегии за 36-месячный вневыборочный период. Уже сам фильтр устраняет периоды наибольших просадок, отсеивая всплески сигналов на боковом рынке; классификатор дополнительно сосредоточивает результат на подмножестве сигналов с наибольшей уверенностью.
- Панель (b): количество сигналов в месяц по вариантам стратегии. Каждый последующий уровень фильтрации сокращает количество сигналов; таблица на этой панели содержит долю прибыльных сделок, среднюю прибыль/убыток на сделку и максимальную просадку для каждого варианта стратегии.
- Панель (c): скользящий коэффициент Шарпа за 6 месяцев для вариантов стратегии 1 и 3. Разность коэффициентов Шарпа количественно характеризует повышение стабильности благодаря двухслойному фильтру при разных подрежимах рынка в пределах тестового периода.
Сводные показатели в расчете на сделку
| Вариант стратегии | Сигналы | Процент выигрышных сделок | Средняя прибыль/убыток на сделку | Максимальная просадка |
|---|---|---|---|---|
| 1 — Простое пересечение линий DI (ADXR ≥ 25) | 546 | 48.9 % | −0.9 пипса | −965 пипсов |
| 2 — Фильтр рыночного режима, настроенный с помощью HPO (ADXR ≥ 40, период расчета = 14, расстояние между линиями DI ≥ 2) | 51 | 47.1 % | −1.2 пипса | −255 пипсов |
| 3 — Фильтр рыночного режима, настроенный с помощью HPO + классификатор + определение размера позиции | 29 | 51.7 % | −0.4 пипса | −44 пипса |
Вклад фильтра рыночного режима, настроенного с помощью HPO, в варианте стратегии 2 (по сравнению с вариантом стратегии 1) и дополнительный вклад вторичного классификатора в варианте стратегии 3 (по сравнению с вариантом стратегии 2) — это две величины, которые позволяют непосредственно оценить обоснованность использования гибридной архитектуры. Значительное улучшение результатов при переходе от варианта стратегии 1 к варианту стратегии 2 подтверждает, что порог Уайлдера плохо откалиброван для данного инструмента; значительное улучшение при переходе от варианта стратегии 2 к варианту стратегии 3 подтверждает, что контекстные признаки на уровне баров несут информацию, которую один лишь фильтр не способен учесть.
Заключение
Система на основе пересечения линий DI содержит внутреннее противоречие. Система ADX определяет, наблюдается ли на рынке тренд; правило входа срабатывает в момент пересечения линий, что по определению означает смену направления тренда. Пересечение линий на боковом рынке происходит в точке структурного равновесия, а не в начале нового тренда. Предложенное самим Уайлдером решение — пороговое значение ADXR — представляет собой статический фильтр, заданный без эмпирической калибровки под конкретный инструмент или таймфрейм. Замена этого порога байесовским поиском в пространстве трёх параметров фильтра рыночного режима с последующим добавлением вторичного классификатора, который использует состояние системы ADX на каждом баре для оценки каждого прошедшего фильтр сигнала, позволяет решить как общую проблему неточной калибровки порога, так и более тонкую задачу отделения сигнала от шума, недоступную пороговой фильтрации.
Этот вывод о структуре подхода применим не только к ADX. Любой порог, выбранный Уайлдером или другим автором классической системы на основе визуального анализа исторических графиков, можно обработать аналогичным образом: рассматривать порог как гиперпараметр, задать целевую функцию на основе точности (precision) на отложенном валидационном интервале с сохранением временного порядка, провести байесовский поиск, а затем оценить, достаточно ли качества сигналов, оставшихся после оптимальной фильтрации, чтобы оправдать применение вторичного классификатора. В следующей статье этой серии та же двухслойная архитектура применяется к другому классическому механизму входа в сделку.
Прикрепленные файлы
Три приведённых ниже файла из папки afml/ — это минимальная часть пакета Blueprint Quant afml: они содержат только функции, вызываемые кодом этой статьи, а не весь пакет. Поместите папку afml/ (с тремя вложенными папками и файлами __init__.py) рядом с приведёнными ниже скриптами или используйте уже установленный у вас полный пакет afml. Для работы этих трёх модулей, помимо стандартного стека numpy/pandas/scikit-learn, требуются библиотеки numba и scipy.
| Файл | Описание |
|---|---|
| adx_system.py | Классы ADXSystem и ADXSignalGenerator, точно реализующие рекуррентную формулу сглаживания Уайлдера. |
| adx_hpo.py | Целевая функция и код запуска исследования Optuna для оптимизации трёх параметров фильтра рыночного режима. |
| adx_features.py | compute_adx_features: одиннадцать столбцов признаков, вычисленных на основе ADX, для каждого бара, на котором возникает сигнал. |
| adx_pipeline.py | Полный скрипт конвейера: загрузка данных, оптимизация гиперпараметров (HPO) фильтра рыночного режима, конструирование признаков, обучение вторичного классификатора, оценка в рамках пошаговой валидации (walk-forward) и таблица результатов по трём вариантам стратегии. |
| afml/labeling/triple_barrier.py | Фрагмент кода подключаемого модуля: get_events, add_vertical_barrier, get_bins и их вспомогательные функции поиска барьеров, скомпилированные с помощью JIT-компилятора Numba. |
| afml/sample_weights/optimized_attribution.py | Фрагмент кода подключаемого модуля: get_weights_by_return_optimized, подсчёт одновременно активных событий и взвешивание по вкладу в доходность; используется JIT-компиляция Numba. |
| afml/bet_sizing/bet_sizing.py | Фрагмент кода подключаемого модуля: get_signal, преобразующая оценку вероятности классификатора в размер позиции со знаком. |
| data/EURUSD_H1_time_2018-01-01-2024-12-31.parq | Часовые бары EURUSD (H1), использованные в статье. |
| data/EURUSD_H1_tick-3000_2018-01-01-2024-12-31.parq | Бары EURUSD H1 по 3000 тиков, предоставленные для сравнения. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22754
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Индикатор скользящего коэффициента Шарпа с доверительными границами в MQL5
 Разработка динамического мультивалютного советника (Часть 9): Фильтрация шума исполнения с учетом микроструктуры рынка
 Фильтрация Вьеториса — Рипса в MQL5: Построение симплексов и граничной матрицы
 Конструирование признаков для машинного обучения (Часть 6): Признаки микроструктуры рынка в MQL5

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования