

Декомпозиция частичной информации: Когда два индикатора вместе информативнее, чем каждый по отдельности
 46
 0

Содержание
- Введение
- Четыре атома, три уравнения и одна недостающая аксиома
- Совместная таблица и логарифмы, которых в ней нет
- От избыточности к четырем атомам
- Специфическая информация, которую усредняет I_min
- Распределение, лежащее в основе I_ccs
- Подгонка со сходимостью при 1/n и ячейка, которую нужно исключить
- Оценки атомов не равны нулю даже при отсутствии связи
- Длина блока здесь — несущий параметр
- Нижняя граница p-значения, из-за которой значимость может быть недостижима при заданном alpha
- Сканирование всех пар и однократные затраты на нулевую модель
- Проверка — логические функции с аналитически известными результатами, внешний эталон и общий поток случайных чисел
- Что на самом деле говорит золото
- Три целевые переменные и два контрольных варианта
- Одни и те же бары при всех трех аксиомах
- Сохраняется ли оценка вне выборки
- Использование оценки
- Заключение
Введение
Отбор признаков в трейдинге почти всегда выполняется по одному признаку за раз. Вы вычисляете корреляцию, взаимную информацию или коэффициент вроде MIC между каждым индикатором и целевой переменной, сортируете столбец и оставляете несколько лучших признаков. Такая процедура может найти только признаки, которые несут информацию сами по себе.
Рассмотрим исключающее ИЛИ. Две монеты с равновероятными исходами и целевая переменная, равная 1, когда результаты бросков различаются, и 0, когда совпадают. Результат броска любой монеты по отдельности ничего не сообщает о целевой переменной — ровно ноль бит. Вместе они однозначно определяют целевую переменную — один бит информации. Любая когда-либо написанная процедура попарного отбора отвергает оба входных признака, хотя сама пара идеальна. На рынке это соответствует утверждению: "это движение имеет значение только в том случае, если его подтверждает объем".
Декомпозиция частичной информации (PID), предложенная Уильямсом и Биром в 2010 году, позволяет это измерить. Для двух источников X1 и X2 и целевой переменной T декомпозиция PID разделяет информацию, которую несет эта пара, на четыре части. Согласно определению, принятому в этой библиотеке по умолчанию, все четыре атома неотрицательны: информация только от X1 (уникальная информация U1); информация только от X2 (U2); одинаковая информация от обоих источников (избыточность R); информация, доступная только в паре (синергия S). Исключающее ИЛИ представляет собой один бит чистой синергии S. Две копии одного и того же индикатора — чистая избыточность R.
В этой статье мы с нуля реализуем такую декомпозицию для MQL5, а также механизм проверки того, отражает ли полученная оценка реальную связь. Оценка каждого из четырех атомов завышена из-за конечного размера выборки: для двух независимых столбцов шума выборка из 250 строк дает около 0,10 бита синергии, которой на самом деле нет. Интерпретировать оценку атома можно только в сравнении с нулевой моделью, построенной на тех же данных. Все, что приведено ниже, выполняется в рабочем терминале, а все указанные численные результаты получены с помощью скриптов, прилагаемых к статье.
Как выглядит итоговая оценка
Ниже приведены результаты сканирования XAUUSDm на таймфрейме D1 по 2435 строкам истории. Все 66 пар из 12 признаков оцениваются относительно волатильности следующих пяти баров, а результат каждой пары сравнивается с нулевой моделью на основе 99 перестановок. Вот главный результат, еще до перехода к теории:
[PID] [1] the real bars
[PID]       2435 rows from 2500 bars, horizon 5, target fwd volatility
[PID]       2435 rows over 75 cells, 32.5 per cell
[PID]       99 draws, p floor 0.0200, alpha 0.050 reachable; family-wise floor 0.0100, one-sided
[PID]       66 pairs from 12 live features, 99 draws, block 10
[PID]       scan took 157 ms
[PID]       pair                        R       U1       U2        S     null95        p
[PID]       ret1 + volZ             0.01664  0.00074  0.00882  0.04094    0.01650   0.0200
Важно не само значение в столбце S, а его сравнение с null95 — 95-м процентилем оценок той же пары при перемешивании целевой переменной. Лучшая пара — сегодняшняя доходность за один бар и z-оценка сегодняшнего объема — дает 0,04094 бита синергии, тогда как значение нулевой модели достигает 0,01650. Значение p равно 0,0200, потому что это нижняя граница, достижимая при 99 перестановочных прогонах, а не точная оценка для этой пары. В разделе 6 объясняются эта граница и связанные с ней ограничения.
Именно это и дает эта библиотека. Далее объясняется, как это работает и насколько результатам можно доверять.
Четыре атома, три уравнения и одна недостающая аксиома
Начнем с того, что уже дает информация Шеннона. Для целевой переменной T и источников X1 и X2 есть три величины взаимной информации, которые можно вычислить непосредственно по совместному распределению: I(T;X1), I(T;X2) и I(T;X1,X2), причем пара рассматривается как одна составная переменная. Через четыре атома они выражаются следующим образом:
I(T;X1) = U1 + R
I(T;X2) = U2 + R
I(T;X1,X2) = U1 + U2 + R + S
Три уравнения, четыре неизвестных — и никакие алгебраические ухищрения не устраняют эту неопределенность. Одна лишь информация Шеннона не определяет эту декомпозицию. Обычно дополнительно задают определение избыточности: достаточно определить R, а остальные атомы следуют из него, поскольку U1 = I(T;X1) - R, U2 = I(T;X2) - R и S = I(T;X1,X2) - I(T;X1) - I(T;X2) + R.
Сначала стоит зафиксировать одно следствие. Если вычесть третье уравнение из суммы первых двух, получим R - S = I(T;X1) + I(T;X2) - I(T;X1,X2) — коинформацию, которая определяется данными и остается неизменной при любой мере избыточности. При любой аксиоме избыточности разность R - S должна совпадать с коинформацией, вычисленной непосредственно по данным. Это самая сильная из доступных внутренних проверок; на логических функциях с аналитически известными результатами погрешность составляет 0,000e+00.
Канонический способ понять смысл четырех атомов — выполнить декомпозицию для логических функций, результаты которых известны аналитически: RDN (оба источника копируют целевую переменную), UNQ1 (целевая переменная — первый источник, второй — независимый бросок монеты), XOR, AND, OR и COPY (целевая переменная — пара).
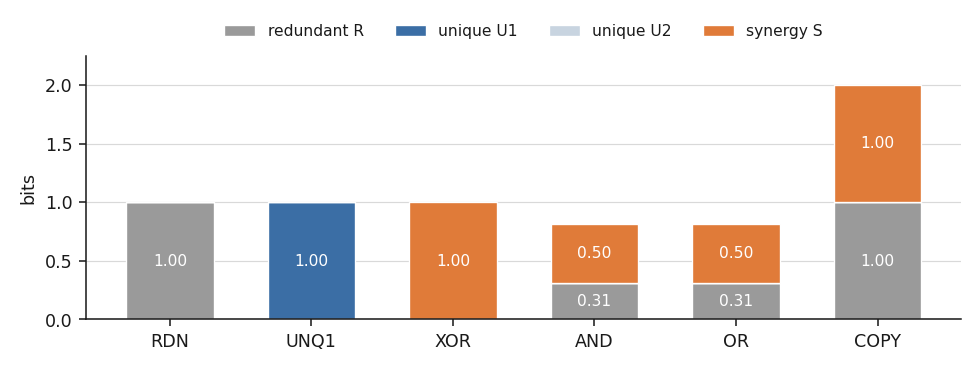
Рис. 1. Четыре атома при I_min для шести логических функций, декомпозиция которых известна аналитически. RDN — один бит чистой избыточности, UNQ1 — один бит уникальной информации первого источника, XOR — один бит чистой синергии. Логические элементы AND и OR одновременно содержат и R, и S. По построению U2 равна нулю во всех шести случаях.
Сравните столбец XOR со столбцом AND. XOR — один бит информации, доступный только в паре. AND более типичен для реальных данных: каждый вход по отдельности немного повышает шансы — 0,31 бита избыточности, — а для получения оставшейся половины бита нужны оба входа. Реальные рыночные пары выглядят как гораздо более слабый AND.
Три меры, реализованные в этой библиотеке
Поскольку определение избыточности задается аксиоматически, а не выводится, существуют конкурирующие определения, дающие разные результаты. Библиотека включает три таких варианта и позволяет вызывающему коду выбрать один из них:
//+------------------------------------------------------------------+
//| Which extra axiom fixes the fourth unknown                       |
//+------------------------------------------------------------------+
enum ENUM_PID_MEASURE
  {
   PID_IMIN,      // Williams and Beer 2010, the original
   PID_IMMI,      // Barrett 2015, the smaller of the two mutual informations
   PID_ICCS       // Ince 2017, pointwise common change in surprisal
  };
I_min — исходное предложение Уильямса и Бира: для каждого значения целевой переменной берется меньшая из двух величин специфической информации источников, а затем вычисляется среднее. Эта мера гарантирует неотрицательные атомы, поэтому используется по умолчанию и является единственной мерой, которую может отображать стековый индикатор (индикатор с накоплением). I_MMI берет меньшее из двух значений взаимной информации и всегда зануляет один уникальный атом. I_ccs — поточечная мера Инса, вычисляемая по распределению максимальной энтропии, а не по данным; она может давать отрицательные значения атомов.
Именно на логической функции COPY результаты этих мер расходятся. В целевую переменную копируются два независимых бита, поэтому интуитивно каждый источник несет один бит, которого нет у другого. I_min дает R = 1 и S = 1, то есть две независимые монеты оказываются полностью избыточными. Именно за это меру критикуют с 2010 года. I_ccs дает U1 = U2 = 1 при R = S = 0, причем оба результата получены одной и той же библиотекой по одной и той же таблице:
[PID] [4] COPY - the axiom decides, and the two disagree
[PID]   PASS  I_min: R and S both one bit                      I_min R 1.000000 U1 0.000000 U2 0.000000 S 1.000000
[PID]   PASS  I_ccs: one bit unique to each source             I_ccs R 0.000000 U1 1.000000 U2 1.000000 S 0.000000
Целый бит расхождения на таблице из четырех строк. Библиотека фиксирует обе оценки, не усредняя их: выбор аксиомы — решение при моделировании, которое принимает аналитик, а не деталь, скрытая в коде. В разделе 8 показано, как тот же выбор меняет вывод на реальных данных по золоту.
Совместная таблица и логарифмы, которых в ней нет
Все описанное выше определяется по совместному распределению вероятностей трех переменных, а рыночные данные поступают как непрерывные значения типа double. Поэтому первая задача — преобразовать тройку (целевая переменная, источник, источник) в трехмерную таблицу целочисленных частот. Эта таблица — единственная оценка, которую строит библиотека; на ее основе вычисляются все энтропии и атомы, а также выполняются все перестановочные прогоны нулевой модели.
Объем таблицы равен произведению числа бинов по трем переменным. По умолчанию намеренно используется грубое разбиение: три бина для целевой переменной и по пять для каждого источника, всего 75 ячеек: 2435 строк дневных данных по золоту дают примерно 32 строки на ячейку. При пяти бинах целевой переменной и семи бинах каждого источника получилось бы 10 строк на ячейку; в таком случае оценки атомов в основном отражают смещение оценивания. Фасадный слой выводит это отношение рядом с каждой оценкой, а если оно ниже 10, прямо сообщает об этом словами.
Равночастотные бины, формируемые по рангу
Используются равночастотные бины, а не бины равной ширины. При разбиении распределения доходностей с тяжелыми хвостами на бины одинаковой ширины почти все строки попадают в средний бин, а крайние ячейки остаются пустыми. Пустая ячейка не вносит вклада, но все равно увеличивает потребность в данных.
//+------------------------------------------------------------------+
//| Equal-frequency bins, assigned by rank                           |
//|                                                                  |
//|  The rank comes from a stable order on (value, index), so equal  |
//|  values resolve the same way on both sides of the cross-check.   |
//|  Equal frequencies also keep every marginal near uniform, which  |
//|  is what leaves the joint table populated.                       |
//+------------------------------------------------------------------+
bool CPIDJoint::QuantileBins(const double &x[], const int n, const int nbins,
                             int &out[])
  {
   if(n <= 0 || nbins < 2)
      return(false);

//--- sort the positions rather than the values, so the original row of
//--- every observation survives the sort and can be written back to
   int idx[], work[];
   ArrayResize(idx, n);
   ArrayResize(work, n);
   for(int i = 0; i < n; i++)
      idx[i] = i;
   MergeIndex(x, idx, work, 0, n - 1);

//--- the bin is a share of the rank order, so it depends on nothing but
//--- position: a fat tail moves a value, never the bin it lands in
   ArrayResize(out, n);
   for(int rank = 0; rank < n; rank++)
     {
      int b = (int)(((long)rank * (long)nbins) / (long)n);
      if(b >= nbins)
         b = nbins - 1;   // the last bin absorbs the rounding
      out[idx[rank]] = b;
     }
   return(true);
  }
Сортировка по паре (value, index) делает обработку одинаковых значений детерминированной. Это позволяет при перекрестной проверке на Python требовать точного равенства, а не приблизительного совпадения. Ранжирование также означает, что границы разбиения определяются квантилями самой выборки. Для непрерывного исключающего ИЛИ, заданного с порогом 0,5, граница двух бинов вместо этого проходит по медиане, а восстановленная синергия возрастает с 0,717 бита при 3000 строках лишь до 0,908 при 48 000 строках. Это занижение обусловлено разбиением на бины, а не оценивателем.
Каждый логарифм извлекается из таблицы один раз
Энтропия по таблице частот представляет собой сумму слагаемых вида klog2(k), причем каждое k — целое число, не превышающее количества строк. Поэтому внутри циклов не требуется вычислять логарифмы:
//+------------------------------------------------------------------+
//| Tabulate every value the counts can take                         |
//|                                                                  |
//|  Index zero holds zero for both tables: an empty cell adds       |
//|  nothing to an entropy and must not reach MathLog.               |
//+------------------------------------------------------------------+
void CPIDLogTable::Build(const int maxCount)
  {
   int need = (maxCount < 1 ? 1 : maxCount) + 1;
   if(need <= m_size)
      return;   // a null reuses one table across thousands of decompositions

   ArrayResize(m_log2, need);
   ArrayResize(m_xlog2x, need);
   m_log2[0] = 0.0;
   m_xlog2x[0] = 0.0;
//--- every entropy in this library is built from integer cell counts, so
//--- tabulating the integers removes MathLog from every sweep that follows
   for(int k = 1; k < need; k++)
     {
      m_log2[k] = MathLog((double)k) * PID_LOG2E;
      m_xlog2x[k] = (double)k * m_log2[k];
     }
   m_size = need;
  }
После построения таблицы частот каждая энтропия вычисляется как log2(N) минус сумма по ячейкам с использованием табличных значений. Перестановочная нулевая модель требует пересчета всех энтропий на каждом прогоне, поэтому при сканировании 66 пар с 99 прогонами выполняется около 6 500 полных декомпозиций.
От избыточности к четырем атомам
Когда таблица готова, расчет решетки сводится к арифметике. Вычисляем три значения взаимной информации, находим R по выбранной аксиоме и получаем остальные три атома:
//+------------------------------------------------------------------+
//| Redundancy first, then the other three in closed form            |
//+------------------------------------------------------------------+
bool CPIDLattice::Decompose(const CPIDJoint &j, const CPIDLogTable &tab,
                            const ENUM_PID_MEASURE m, CPIDMaxEnt &fit,
                            SPIDAtoms &out)
  {
   out.Reset();
   out.measure = m;
   if(j.Total() <= 0)
      return(false);

//--- the three mutual informations are the only quantities Shannon fixes
   out.i1 = CPIDInfo::MutualTX1(j, tab);
   out.i2 = CPIDInfo::MutualTX2(j, tab);
   out.i12 = CPIDInfo::MutualTPair(j, tab);

//--- the axiom supplies the fourth, and the other three then subtract out
   out.r = CPIDRedundancy::Of(m, j, tab, fit);
   out.u1 = out.i1 - out.r;
   out.u2 = out.i2 - out.r;
   out.s = out.i12 - out.i1 - out.i2 + out.r;

//--- only I_ccs runs a fit, so only I_ccs can come back unreliable
   out.fitError = (m == PID_ICCS ? fit.Error() : 0.0);
   out.reliable = (m != PID_ICCS || fit.Converged());
   return(true);
  }
Два поля результата ничего не говорят о рынке и служат защитой от неверной интерпретации вызывающим кодом. fitError показывает отклонение подгонки по принципу максимальной энтропии, лежащей в основе I_ccs, от целевых маргинальных распределений. reliable принимает значение false, если подгонка не сошлась: неудачная подгонка возвращает нулевую избыточность, которая может выглядеть как правдоподобный результат декомпозиции.
Специфическая информация, которую усредняет I_min
I_min определяется через величину, которую большинство программ для теории информации никогда не вычисляет: информацию источника об одном конкретном значении целевой переменной, а не о целевой переменной в целом.
//+------------------------------------------------------------------+
//| I(t; X) for one target value, the term I_min averages            |
//|                                                                  |
//|  A relative entropy between p(x|t) and p(x), so it is never      |
//|  negative, and averaging it over t returns I(T;X).               |
//+------------------------------------------------------------------+
double CPIDInfo::SpecificInfo(const CPIDJoint &j, const CPIDLogTable &tab,
                              const int source, const int t)
  {
   int n = j.Total();
   int ct = j.CountT(t);
   if(n <= 0 || ct <= 0)
      return(0.0);

   int nx = (source == 1 ? j.N1() : j.N2());
   double sJoint = 0.0, sMarg = 0.0;
//--- accumulate the two halves of sum p(x|t) log( p(x|t) / p(x) ) in raw
//--- counts, so every logarithm is a table lookup on an integer
   for(int x = 0; x < nx; x++)
     {
      int ctx = (source == 1 ? j.CountT1(t, x) : j.CountT2(t, x));
      if(ctx <= 0)
         continue;   // an empty cell contributes nothing
      int cx = (source == 1 ? j.Count1(x) : j.Count2(x));
      sJoint += tab.XLog2X(ctx);
      sMarg += (double)ctx * tab.Log2(cx);
     }
//--- the trailing terms undo the count scaling the two sums carry
   return((sJoint - sMarg) / (double)ct - tab.Log2(ct) + tab.Log2(n));
  }
Усреднение этой величины по t с весами p(t) дает ровно I(T;X). Набор тестов проверяет это тождество для всех шести логических функций, и оно выполняется с точностью до 1,1e-16. Избыточность в I_min — то же среднее, но для каждого t берется меньшее из слагаемых двух источников; отсюда и название.
Распределение, лежащее в основе I_ccs
I_ccs вычисляется не по данным. Вычисление выполняется по распределению максимальной энтропии, воспроизводящему три парных маргинальных распределения данных. Это модель со всеми парными взаимодействиями, но без члена взаимодействия трех переменных. Библиотека получает это распределение с помощью итеративной пропорциональной подгонки: масштабирует таблицу так, чтобы ее маргинальное распределение (T,X1) совпадало с распределением данных, затем делает то же для (T,X2) и (X1,X2) и повторяет цикл. Для этого распределения каждая ячейка вносит вклад в виде локальной коинформации, но только при совпадении знаков всех четырех локальных слагаемых. Это и есть "общее изменение неожиданности", которого требует данная мера.
Подгонка со скоростью сходимости 1/n и ячейка, которую нужно исключить
Простая версия этой подгонки не работает. В детерминированной таблице, например для функции AND, ограничения требуют нулевых значений в некоторых ячейках, а пропорциональная подгонка приближается к нулю лишь со скоростью 1/n. Для AND максимальная ошибка маргинального распределения составляет 8,065e-03 после 10 проходов и 8,333e-06 после 10 000, что в точности соответствует 0,083/n. При таком подходе для достижения 1e-12 понадобилось бы порядка 1e11 проходов.
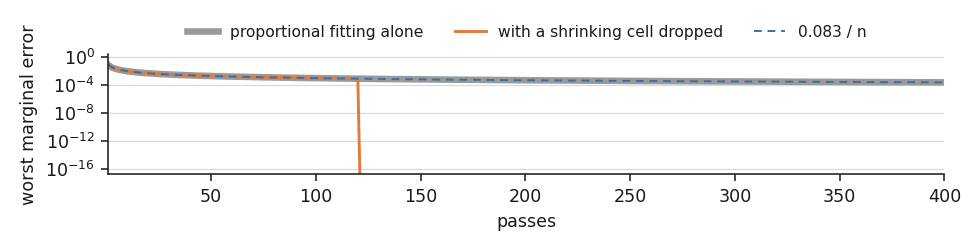
Рис. 2. Сама по себе пропорциональная подгонка все время следует кривой 0,083/n, показанной серым под пунктирной эталонной линией. Удаление ячейки, значение которой продолжает уменьшаться после целого блока проходов, позволяет вместо этого завершить подгонку с машинным нулем.
Это исправление состоит из двух частей, и нужны обе. Ячейки, которым соответствует нулевая строка в любом двумерном маргинальном распределении, удаляются перед первым проходом, поскольку их значения не могут быть ненулевыми. Затем, если после блока проходов подгонка все еще не сошлась, удаляется и любая ячейка, значение которой заметно уменьшалось на протяжении всего блока: оно стремится к нулю. Этап отсечения — фрагмент из середины Fit:
//--- fit in blocks of passes, so a cell can be watched over an interval
   m_passes = 0;
   double before[];
   ArrayResize(before, cells);
   for(int round = 0; round < PID_IPF_ROUNDS; round++)
     {
      if(RunBlock())
         break;
      ArrayCopy(before, m_q);   // the state one block back
      if(RunBlock())
         break;

//--- a cell still shrinking across a whole block is on its way to zero,
//--- and the fit reaches that boundary only if the cell is dropped outright
      bool pruned = false;
      double kept = 0.0;
      for(int i = 0; i < cells; i++)
        {
         if(m_q[i] > PID_EPS && before[i] > PID_IPF_DECAY * m_q[i])
           {
            m_q[i] = 0.0;
            pruned = true;
           }
         kept += m_q[i];
        }
      if(!pruned || kept <= 0.0)
         break;
      for(int i = 0; i < cells; i++)
         m_q[i] /= kept;   // dropping mass costs a renormalization
     }

   m_error = MarginalError();
   return(Converged());
  }
Порог по величине не решает эту задачу: значение ячейки, стремящейся к нулю в функции AND, после 200 проходов все еще равно 4e-04 — намного выше любого epsilon, который можно было бы считать нулем. Эту ячейку выявляет именно тенденция изменения, а не величина ее значения. После исправления подгонка воспроизводит каждое маргинальное распределение логических функций с ошибкой 0,000e+00, а для рыночных таблиц сходится с ошибкой около 1e-15 за 16-25 проходов. I_ccs не считает результат надежным, если подгонка не достигла требуемой точности.
Оценки атомов не равны нулю даже при отсутствии связи
Это самое важное свойство метода, и из него следуют все решения о значимости. Возьмите два столбца независимого равномерного шума и независимую целевую переменную, разбейте их на бины по предусмотренной сетке 3 x 5 x 5 и выполните декомпозицию. Здесь совершенно нечего обнаруживать. Тем не менее библиотека возвращает положительное число:
[PID] [4] the finite-sample floor on independent columns
[PID]       rows   250   R 0.009956  S 0.100330  total 0.113182
[PID]       rows   500   R 0.004370  S 0.056004  total 0.066346
[PID]       rows  1500   R 0.006509  S 0.021054  total 0.032671
[PID]       rows  6000   R 0.000296  S 0.005197  total 0.005712
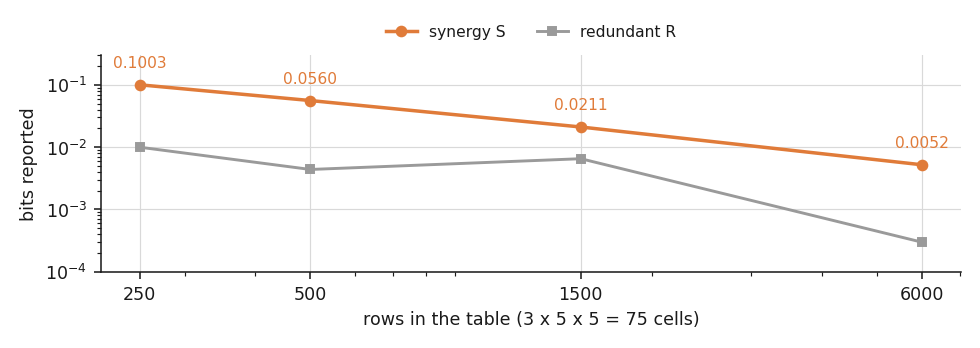
Рис. 3. Оценки синергии и избыточности для столбцов, между которыми вообще нет связи. Нижняя граница снижается по мере добавления строк и никогда не достигает нуля, поэтому никакой фиксированный порог не может ее заменить.
Причина проста: при 75 ячейках и 250 строках в большинстве ячеек содержится по два-три наблюдения, и случайная структура этой разреженной таблицы неотличима от реальной структуры. Необработанную оценку атома нельзя интерпретировать, сравнивать при разных настройках или проверять по порогу. Интерпретировать можно только положение атома относительно распределения, построенного на тех же данных после разрушения связи: перемешать целевую переменную, сохранить исходное попарное соответствие двух источников, снова выполнить декомпозицию и повторить.
Длина блока здесь — несущий параметр
Перемешивание отдельных строк — очевидный способ реализации, но здесь он неверен по причине, указанной в заголовке функции. Целевая переменная учитывает пять будущих баров, поэтому соседние строки используют большую часть одних и тех же баров, а метки образуют серии. Разрушение этих серий дает нулевую модель, порог которой данные преодолевают слишком легко.
//+------------------------------------------------------------------+
//| Permute whole blocks, never single rows                          |
//|                                                                  |
//|  Rows a horizon apart share most of the same forward bars, so a  |
//|  label sequence arrives in runs. Shuffling one row at a time     |
//|  destroys those runs and yields a null the data clears too       |
//|  easily. A block of about twice the run length preserves them.   |
//+------------------------------------------------------------------+
void CPIDRandom::BlockShuffle(const int &src[], int &dst[], const int n,
                              const int block)
  {
   int b = (block < 1 ? 1 : block);
   int nblocks = (n + b - 1) / b;

//--- Fisher-Yates over the block order, so the blocks move and the rows
//--- inside each one never do
   int order[];
   ArrayResize(order, nblocks);
   for(int i = 0; i < nblocks; i++)
      order[i] = i;
   for(int i = nblocks - 1; i > 0; i--)
     {
      int j = Below(i + 1);
      int tmp = order[i];
      order[i] = order[j];
      order[j] = tmp;
     }

//--- write the blocks out in their new order; the last one is short
//--- whenever the block length does not divide the row count
   ArrayResize(dst, n);
   int w = 0;
   for(int k = 0; k < nblocks; k++)
     {
      int start = order[k] * b;
      int stop = MathMin(start + b, n);
      for(int i = start; i < stop; i++)
         dst[w++] = src[i];
     }
  }
Длина блока определяется перебором вариантов с проверкой ложноположительных срабатываний, а не просто задается. Двадцать чистых случайных блужданий, по 12 признаков в каждом; все 66 пар оценивались относительно нулевой модели из 39 перестановочных прогонов при номинальном alpha = 0,05. Все срабатывания здесь ложные по построению:
[PID] [2] false positives on random walks, by block length
[PID]       nominal alpha 0.05, 20 walks, 39 draws
[PID]       block  1   per-pair 0.141   any pair fires 1.000   family-wise 0.700
[PID]       block  5   per-pair 0.065   any pair fires 1.000   family-wise 0.300
[PID]       block 10   per-pair 0.060   any pair fires 0.900   family-wise 0.250
[PID]       block 20   per-pair 0.070   any pair fires 1.000   family-wise 0.150
[PID]       block 40   per-pair 0.058   any pair fires 1.000   family-wise 0.150
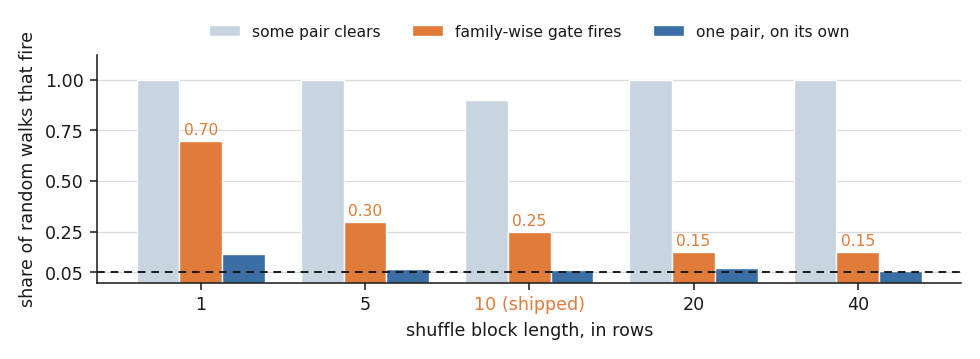
Рис. 4. Ложные срабатывания на двадцати случайных блужданиях. Пунктирная линия обозначает номинальное значение 0,05. При независимом перемешивании критерий значимости для семейства проверок срабатывает на 70% случайных блужданий; блоки длиной в два горизонта снижают эту долю до 0,25.
Из этой таблицы следуют две оценки. Доля срабатываний для отдельной пары близка к номинальной при любой длине блока, кроме одной, поэтому проверка одной пары дает примерно корректный результат. Столбец для семейства проверок, которому соответствует средний столбец каждой группы на рис. 4, показывает последствия независимого перемешивания: 70% чистых случайных блужданий при длине блока 1, 25% — при предусмотренной длине блока в два горизонта, 15% — при длине блока 20 и 40. Этот столбец позволяет отсеивать настройки, а не выбирать одну из них. Более длинный блок сохраняет большую часть последовательности, поэтому реальному эффекту сложнее превысить порог нулевой модели; эти издержки здесь не измеряются. Обратите также внимание: средний столбец ни разу не достигает пунктирной отметки 0,05. Фактический показатель для поиска по 12 признакам составляет 0,25 при предусмотренной настройке и 0,15 в лучшем случае.
Нижняя граница p-значения, из-за которой значимость может быть недостижима при заданном alpha
Перестановочное p-значение не может быть меньше 1/(число перестановочных прогонов + 1), а для двустороннего критерия — меньше удвоенного этого значения:
//+------------------------------------------------------------------+
//| A two-sided p-value, with ties counted as at least as extreme    |
//|                                                                  |
//|  Counting ties on both sides is the standard permutation-test    |
//|  treatment and errs toward refusing rather than reporting.       |
//+------------------------------------------------------------------+
double CPIDNull::PValue(const int atom, const double observed)
  {
   if(m_draws <= 0)
      return(1.0);
//--- count both tails, since an atom can be surprising by sitting below
//--- its null as well as above it
   int ge = 0, le = 0;
   for(int k = 0; k < m_draws; k++)
     {
      double v = m_draw[k][atom];
      if(v >= observed - PID_EPS)
         ge++;
      if(v <= observed + PID_EPS)
         le++;
     }
//--- the observation counts as its own draw, which is what puts the
//--- floor at 2/(draws+1) rather than at zero
   double up = (double)(ge + 1) / (double)(m_draws + 1);
   double lo = (double)(le + 1) / (double)(m_draws + 1);
   return(MathMin(1.0, 2.0 * MathMin(up, lo)));
  }

//+------------------------------------------------------------------+
//| The smallest p-value the draw count can produce                  |
//|                                                                  |
//|  A two-sided p is twice the one-sided tail, so the floor is      |
//|  2/(ndraw+1). Ask for a threshold below it and no result can     |
//|  ever clear, however strong the effect.                          |
//+------------------------------------------------------------------+
double CPIDNull::PFloor(const int ndraw, const bool twoSided = true)
  {
   if(ndraw <= 0)
      return(1.0);
   return((twoSided ? 2.0 : 1.0) / (double)(ndraw + 1));
  }
С этим ограничением легко столкнуться. При 19 перестановочных прогонах минимальное двустороннее p-значение составляет 0,10, поэтому критерий при alpha = 0,05 никогда не сработает, какой бы сильной ни была связь. Такое сканирование покажет ноль значимых пар на любом наборе данных. Библиотека указывает свою нижнюю границу рядом с каждой оценкой. Правило обработки равных значений в том же блоке важно для статистики, которую перемешивание почти не меняет: без него сравнение зависит от одного-двух последних битов числа, не несущих никакой информации.
Важно: нижняя граница для двустороннего критерия равна 2/(draws+1), а не 1/(draws+1). По умолчанию используются 39 перестановочных прогонов, что дает ровно 0,05. Поэтому индикатор может достичь порога 0,05, но не более низкого. Для alpha = 0,01 требуется не менее 199 перестановочных прогонов.
Сканирование всех пар и однократные затраты на нулевую модель
Рис. 4 уже показывает издержки самого поиска: на чистом шуме какая-нибудь из 66 пар проходит собственный порог в 90-100% случайных блужданий, поэтому лучшую пару нужно сравнивать с распределением лучших пар. Вычислительные затраты остаются приемлемыми, поскольку для одной перестановки целевой переменной оцениваются все пары до перехода к следующей перестановке. Ниже приведен фрагмент из ScanPairs:
   CPIDRandom rng;
   rng.Seed(m_seed);
   int shuffled[];
   SPIDAtoms a;

//--- one shuffle per draw, scored against every pair: that yields the
//--- per-pair nulls and the distribution of the winner for the same cost
   for(int k = 0; k < m_draws; k++)
     {
      rng.BlockShuffle(tbin, shuffled, rows, m_block);   // blocks keep the target's runs
      double best = -1.0e308;
      for(int p = 0; p < m_npairs; p++)
        {
         for(int i = 0; i < rows; i++)
           {
            ba[i] = bins1[c1[p] * rows + i];
            bb[i] = bins2[c2[p] * rows + i];
           }
         if(!j.Build(shuffled, ba, bb, rows, m_nt, m_n1, m_n2))
            return(false);
         if(!CPIDLattice::Decompose(j, m_tab, m_measure, fit, a))
            return(false);
         m_drawS[k * m_npairs + p] = a.s;
         drawR[k * m_npairs + p] = a.r;
         if(a.s > best)
            best = a.s;
        }
      m_familyBest[k] = best;   // the best-of-all-pairs this draw reached
     }
Каждый перестановочный прогон дает 66 декомпозиций — столько же требуется для нулевых моделей отдельных пар. Дополнительно сохраняется максимум по парам в m_familyBest, поэтому p-значение для семейства проверок получается без дополнительных затрат.
Проверка — логические функции с аналитически известными результатами, внешний эталон и общий поток случайных чисел
Библиотека проверяется на трех уровнях, которые намеренно различаются по характеру проверки.
Этим логическим функциям вообще не нужен эталон. Декомпозиции XOR, AND, OR, COPY, RDN и UNQ1 можно вывести аналитически, поэтому воспроизводящий их тест проверяет соответствие математическим результатам, а не другой реализации:
[PID] [1] XOR - neither source alone carries anything
[PID]   PASS  I(T;X1) is zero                                  0.000000000
[PID]   PASS  I(T;X2) is zero                                  0.000000000
[PID]   PASS  I(T;X1,X2) is one bit                            1.000000000
[PID]   PASS  S is one bit                                     1.000000000
Эталонная реализация на Python действительно существует и независима. dit 2.2 устанавливается и работает на текущей версии Python и реализует те же три меры, что и PID_WB, PID_MMI и PID_CCS. При перекрестной проверке каждая экспортированная таблица заново строится по ее меткам, выполняется ее декомпозиция по схеме, а результат сравнивается и с экспортом MQL5, и с dit.
Поток случайных чисел общий, поэтому нулевая модель проверяется на равенство, а не сопоставляется статистически. Тип ulong в MQL5 и целые числа с применением маски в Python одинаково ведут себя при переполнении, поэтому инициализация xorshift64* через splitmix64 порождает одинаковые 64-битные слова в обеих реализациях. Эти перестановки не просто статистически похожи на перестановки MQL5 — они идентичны, и обе нулевые модели должны совпадать в каждом перестановочном прогоне:
[6] the null, redrawn from the same stream
  PASS  39 draws reproduce exactly                           worst 4.460e-15
  PASS  the p-value for S is well formed                     p 0.2000, floor 0.0500
  PASS  the null mean for S sits above zero                  0.013087 against an observed 0.017743
23 PASS, 0 FAIL   [ALL PASS]
Полные результаты проверки цепочки на 25.08.2026:
| Уровень | Скрипт или команда | Результат |
|---|---|---|
| Схема | python pid_prototype.py | 29 PASS, 0 FAIL |
| Поток и таблица | PID_Test_Info.mq5 | 24 PASS, 0 FAIL (9 мс) |
| Логические функции с аналитически известными результатами | PID_Test_Gates.mq5 | 23 PASS, 0 FAIL (1,9 мс) |
| Решетка на данных | PID_Test_Lattice.mq5 | 26 PASS, 0 FAIL (0,08 с) |
| Нулевая модель и поиск | PID_Test_Null.mq5 | 10 PASS, 0 FAIL (2,4 с) |
| Перекрестная проверка | Экспортируйте, затем запустите python pid_crosscheck.py | 23 PASS, 0 FAIL |
| Рынок | PID_Scan_Market.mq5 | XAUUSDm D1, 2 435 строк, от 155 до 170 мс на одно сканирование |
Выполните экспорт перед перекрестной проверкой: программа на Python читает файл, записанный скриптом MQL5, а устаревшие экспортированные данные намеренно приводят к провалу проверок. Если файл окажется в другом месте, укажите этот путь в PID_EXPORT. Один из приведенных выше допусков намеренно отличается от остальных: Результаты I_ccs совпадают с dit с точностью до 6,137e-11, тогда как результаты I_min и I_MMI — примерно до 4e-15. Причина в том, что dit получает то же распределение с помощью универсального оптимизатора, собственная невязка которого составляет около 1e-10. Более широкий допуск — не наша ошибка.
Что на самом деле говорит золото
Слой данных преобразует бары в двенадцать признаков, рассчитанных без использования будущих данных, и одну из трех целевых переменных для будущих значений. Каждый признак вычисляется только по бару соответствующей строки и более ранним барам, а каждая целевая переменная — по будущим барам. Поэтому доступные строки заканчиваются за один горизонт до самого нового бара.
| # | Признак | Что это такое | # | Признак | Что это такое |
|---|---|---|---|---|---|
| 0 | ret1 | логарифмическая доходность за 1 бар | 6 | bbPos | положение внутри полосы Боллинджера |
| 1 | ret5 | логарифмическая доходность за 5 баров | 7 | atrRatio | отношение ATR(14) к ATR(50) |
| 2 | rsi14 | RSI по Уайлдеру | 8 | maDist | расстояние от SMA(20), выраженное в ATR |
| 3 | stoch14 | положение по стохастику в диапазоне за 14 баров | 9 | volZ | z-оценка тикового объема за 50 баров |
| 4 | cci20 | индекс товарного канала | 10 | rangeATR | диапазон бара, выраженный в ATR |
| 5 | macdHist | гистограмма MACD, масштабированная по ATR | 11 | streak | длина серии однонаправленных баров со знаком |
Параметры InpFeature1 и InpFeature2 в индикаторе и советнике задаются индексами из этой таблицы. В обоих случаях по умолчанию используются 0 и 9 — ret1 и volZ. Три целевые переменные — будущая доходность с учетом знака, ее абсолютное значение и будущая реализованная волатильность. Ответ полностью зависит от того, какую целевую переменную вы рассматриваете.
Три целевые переменные и два контрольных варианта
Контрольный вариант может опровергнуть результат только тогда, когда отвечает на тот же вопрос. Поэтому каждая целевая переменная оценивается тремя способами за один проход: на реальных барах, на тех же барах, переставленных во времени, и на случайном блуждании, согласованном с реальным рядом по дрейфу и разбросу. Изменение порядка — более чувствительный из двух контрольных вариантов: каждый бар сохраняет свою доходность, тени и объем, а разрушается только последовательность.
[PID] [2] three targets against two controls
[PID]       target            source        cleared  best S   pFam
[PID]       fwd return        real          7 of 66  0.02917  0.0700
[PID]       fwd return        shuffled      5 of 66  0.02496  0.1800
[PID]       fwd return        walk          1 of 66  0.02329  0.1100
[PID]       |fwd return|      real          9 of 66  0.02538  0.0900
[PID]       |fwd return|      shuffled      2 of 66  0.02220  0.2100
[PID]       |fwd return|      walk          8 of 66  0.02073  0.1700
[PID]       fwd volatility    real         11 of 66  0.04094  0.0100
[PID]       fwd volatility    shuffled      6 of 66  0.03629  0.0100
[PID]       fwd volatility    walk          3 of 66  0.02541  0.0600
Последние два столбца отвечают на разные вопросы. Столбец cleared подсчитывает пары, чье значение S превысило порог собственной нулевой модели, — это 66 отдельных тестов; pFam показывает, как часто лучшая из 66 пар на перемешанной целевой переменной достигает результата лучшей реальной пары. Поэтому в строке может быть больше пар, прошедших порог, но хуже p-значение для семейства проверок. Для доходности с учетом знака на реальных барах проходят порог 7 из 66 пар против 5 у перемешанного контрольного варианта, а pFam составляет 0,0700 и не проходит порог alpha: сигнала нет — к тому же выводу на этом инструменте пришел совершенно другой метод.
Будущая волатильность сильнее всего отличается от обоих контрольных вариантов, но это видно не по столбцу cleared: в нем доходность с учетом знака выглядит сильнее, хотя именно для этой целевой переменной только что не обнаружили сигнала. Различие видно в p-значении для семейства проверок: 0,0100 против 0,0600 у случайного блуждания. В строке с перемешиванием также указано 0,0100, но это нижняя граница p-значения при 99 перестановочных прогонах. Существенное различие показано на рис. 5: лучшая реальная пара дает 0,04094 бита против 0,03629 после изменения временного порядка. Различие реальное, но небольшое.
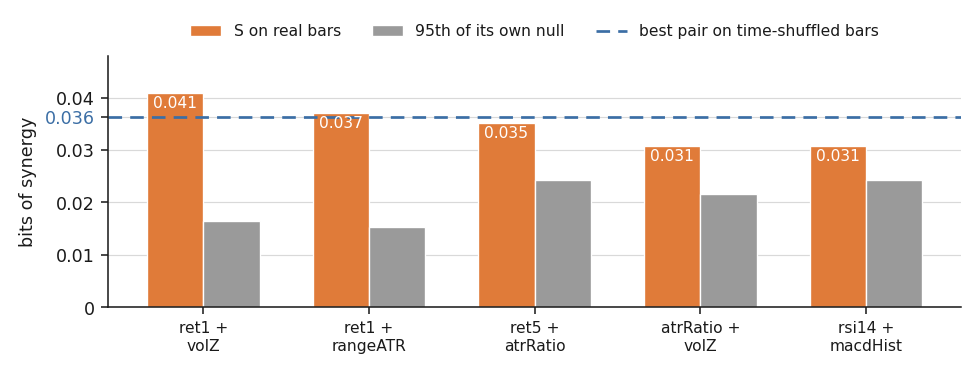
Рис. 5. Пять сильнейших пар для будущей волатильности, каждая сопоставлена с 95-м процентилем собственной нулевой модели. Пунктирная линия обозначает результат лучшей пары, найденной тем же сканированием после изменения временного порядка баров; он выше результатов трех из пяти реальных пар.
Важно: одно сканирование — одна реализация выборочного процесса. При запуске того же сканирования на следующий день, когда окно из 2 500 баров сдвинулось всего на один бар, p-значение для семейства проверок перемешанного контрольного варианта изменилось с 0,0700 до 0,0100, а результаты на реальных данных почти не изменились. Повторите расчет таблицы для нескольких дат окончания, прежде чем считать какие-либо из этих результатов свойством золота.
Одни и те же бары при всех трех аксиомах
В разделе 3 утверждалось, что выбор меры избыточности — решение при моделировании. Вот как это решение меняет вывод на реальных данных при одинаковых барах, бинах и нулевой модели для обеих рассмотренных выше целевых переменных:
| Целевая переменная | Аксиома | Пары, прошедшие порог alpha | Лучшая пара | Наибольшее S | p-значение для семейства проверок |
|---|---|---|---|---|---|
| будущая волатильность | I_min | 11 из 66 | ret1 + volZ | 0,04094 | 0,0100 |
| будущая волатильность | I_MMI | 13 из 66 | ret1 + volZ | 0,04167 | 0,0100 |
| будущая волатильность | I_ccs | 21 из 66 | ret1 + rangeATR | 0,03597 | 0,0100 |
| доходность с учетом знака | I_min | 7 из 66 | rsi14 + macdHist | 0,02917 | 0,0700 |
| доходность с учетом знака | I_MMI | 7 из 66 | rsi14 + macdHist | 0,03042 | 0,0500 |
| доходность с учетом знака | I_ccs | 4 из 66 | rsi14 + atrRatio | 0,02356 | 0,3200 |
Сопоставляйте эти два блока: каждый из них по отдельности может ввести в заблуждение. Для будущей волатильности при I_ccs порог проходит 21 из 66 пар, а при I_min — 11; эти две меры также расходятся в выборе самой сильной пары. Для доходности с учетом знака порядок меняется на противоположный: I_ccs становится самой консервативной мерой с p-значением для семейства проверок 0,3200, тогда как I_MMI достигает ровно порога alpha = 0,05 на тех же барах, где I_min не прошла порог при 0,0700. Таким образом, приведенное выше заключение о направлении касается I_min, а не золота. Всегда указывайте аксиому рядом с атомом.
Сохраняется ли оценка вне выборки
При сканировании история делится на отметке 70%, пары ранжируются по первой части выборки, а затем проверяются по второй. Во второй части выборки 685 строк против 1 685 в первой. Как видно из рис. 3, нижняя граница оценок повышается при уменьшении числа строк, поэтому необработанная оценка атома вне выборки несопоставима. Сопоставимы ранг среди 66 пар и отклонение от собственной нулевой модели второй части выборки:
[PID] [4] out-of-sample transfer of the chosen pairs
[PID]       head 1685 rows, tail 685 rows - the floor differs, so rank is the comparable column
[PID]       pair                   rank in  rank out   over null95
[PID]       atrRatio + volZ              1        18           no
[PID]       rsi14 + atrRatio             2         1           no
[PID]       mean out-of-sample rank 23.2 of 66, chance would give 33.5
[PID]       1 of 5 clear their own out-of-sample null
Пять самых сильных пар внутри выборки дают средний ранг вне выборки 23,2 из 66 против 33,5, ожидаемых при случайном выборе. Порядок сохраняется лишь частично: одна из пяти пар проходит порог собственной нулевой модели вне выборки, а самая сильная пара первой части выборки опускается на 18-е место.
Если объединить эти три результата, то вывод будет кратким. Для целевой переменной направления нет результата, который выдерживал бы сравнение с собственным контрольным вариантом при аксиоме по умолчанию; при самой мягкой из трех аксиом результат лишь достигает порога. Для целевой переменной волатильности информации немного больше, чем для сопоставимого случайного блуждания; преимущество над барами с измененным порядком невелико. p-значение для семейства проверок упирается в одностороннюю нижнюю границу разрешения, а ранжирование лишь частично сохраняется после разбиения с очисткой.
Использование оценки
Индикатор
Декомпозиция — четыре числа, сумма которых дает пятое, поэтому естественный способ отображения — представление с накоплением, а не линия. Индикатор отображает R, затем R+U1, затем R+U1+U2 и итоговое значение в виде четырех гистограмм в подокне; каждый атом образует слой между двумя соседними уровнями. Поверх них он строит одну пунктирную линию: тот же итог, но с заменой S на 95-й процентиль собственного нулевого распределения этого окна. Фрагмент цикла построения графика:
//--- a decomposition costs tens of milliseconds, so only every step-th bar
//--- recomputes and the bars between it hold the reading that came before
   for(int bar = firstBar; bar < rates_total; bar++)
     {
      bool due = (((bar - firstBar) % InpStep) == 0);
      if(due)
        {
         SPIDAtoms tmp;
         double tn = 0.0, tp = 1.0;
         int tr = 0;
         if(ReadAt(bar, tmp, tn, tp, tr))
           {
            a = tmp;
            n95 = tn;
            pv = tp;
            rows = tr;
            have = true;
            computed++;
           }
        }
      //--- nothing is drawn until the first window succeeds, so the line
      //--- never opens on a reading that was never computed
      if(!have)
         continue;

//--- cumulative sums, so the four atoms render as one stack; the null rides
//--- on the same base as S, and the stack top crossing it is the reading
      g_r[bar] = a.r;
      g_ru1[bar] = a.r + a.u1;
      g_ru1u2[bar] = a.r + a.u1 + a.u2;
      g_total[bar] = a.r + a.u1 + a.u2 + a.s;
      g_noise[bar] = a.r + a.u1 + a.u2 + n95;
      g_s[bar] = a.s;
      g_p[bar] = pv;
      g_null95[bar] = n95;
     }
Именно эта геометрия и составляет весь смысл визуализации. Верхний слой, поднимающийся над пунктирной линией, показывает, что синергия превышает порог своей нулевой модели. Не нужно считывать вторую ось или мысленно сравнивать два графика.
Перед подключением индикатора необходимо учесть три свойства. Линия ступенчатая: ее значение вычисляется каждые InpStep баров и сохраняется между обновлениями, поскольку для каждой оценки нужно рассчитывать перестановочную нулевую модель. Окно заканчивается на последнем закрытом баре. При этом InpWindow задает 600 строк против 2 435 при сканировании, поэтому, как видно из рис. 3, пунктирная линия здесь проходит в несколько раз выше. Именно поэтому нулевая модель пересчитывается для каждого окна, а не фиксируется один раз.
Время выполнения, измеренное внутри индикатора с помощью GetMicrosecondCount, составляет от 25 до 50 мс для 40 окон на 200 отображаемых барах по результатам шести запусков на терминале без нагрузки. Поэтому InpHistoryBars можно задавать с запасом. Рис. 6 получен не в одном из этих запусков: создание снимка экрана использует тот же поток графика. Для той же работы этот запуск показал 41 мс на панели и 53 мс в логе.
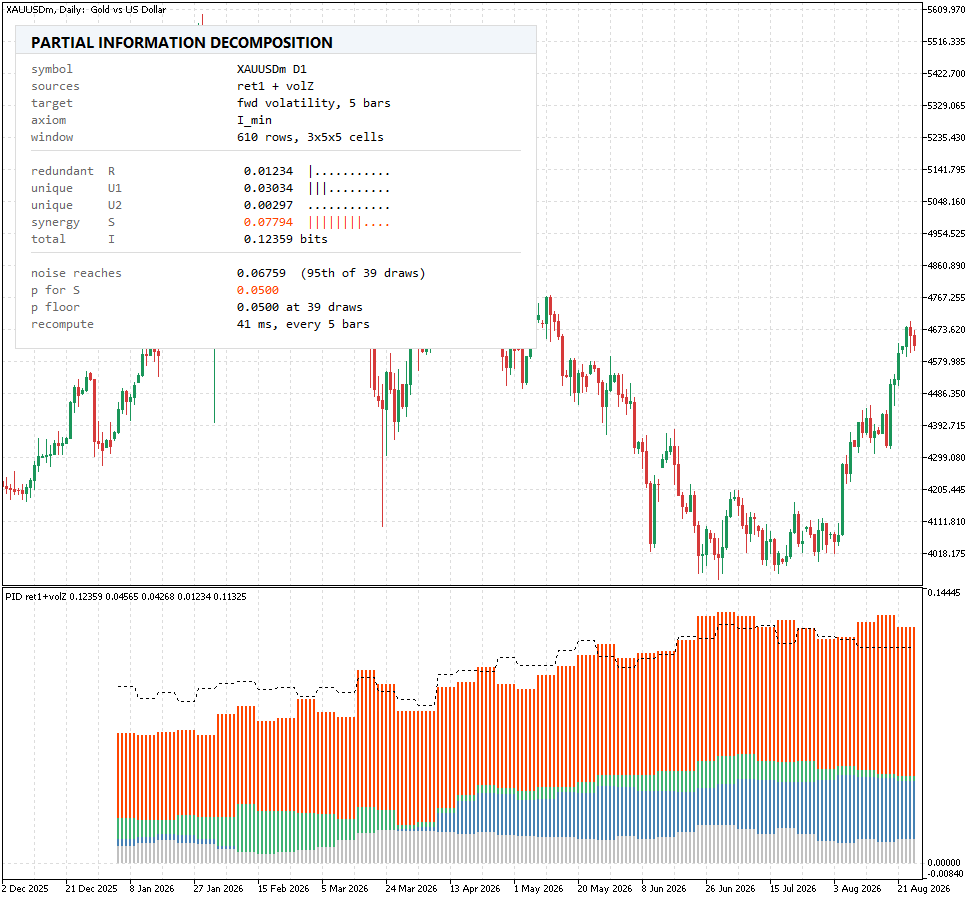
Рис. 6. Четыре атома показаны с накоплением в подокне; пунктирная линия обозначает уровень, которого достигает шум. Панель выводит ту же оценку в числовом виде, включая p-значение и нижнюю границу разрешения, которую допускает число перестановочных прогонов.
Эта оценка проходит порог с минимальным запасом, который может показать визуализация: синергия 0,07794 против уровня шума 0,06759; p-значение 0,0500 находится ровно на нижней границе, допускаемой 39 перестановочными прогонами. Если бы результат одного перестановочного прогона превысил наблюдаемое значение, проверка значимости уже не была бы пройдена, хотя изображение осталось бы тем же. Обратите также внимание: null95 соответствует односторонней проверке, тогда как при расчете p хвостовая вероятность удваивается. Поэтому слой может подняться над линией, но проверка значимости все еще не будет пройдена — здесь это обычная ситуация. Решение в обоих случаях — увеличить число перестановочных прогонов.
Советник и контрольный вариант, который его превзошел
Декомпозиция дает оценку силы связи, но не ее направления, поэтому она не может служить сигналом входа. С ее помощью можно определить, стоит ли доверять совместной оценке двух признаков; советник использует ее только для одной задачи — выбора расстояния до стоп-лосса. Во всех вариантах вход выполняется по простому пробою канала Дончиана; различается только показатель волатильности, по которому определяется стоп-лосс.
//+------------------------------------------------------------------+
//| The volatility this bar's stop is built from                     |
//|                                                                  |
//|  All three arms take the same entry and the same formula, so     |
//|  only this number differs between them. When the decomposition   |
//|  is not significant every arm falls back to the sample mean, so  |
//|  the three trade populations stay close without being equal.     |
//+------------------------------------------------------------------+
double VolatilityNow(const double v1, const double v2)
  {
//--- the control arm, and the fallback for every arm when the pair's
//--- synergy did not clear its own null
   double global = g_rule.GlobalMean();
   if(!g_significant || InpVolMode == PID_VOL_CONSTANT)
      return(global);

//--- the reading itself: the mean of the joint cell this bar lands in
   double cell = g_rule.PredictAt(v1, v2);
   if(InpVolMode == PID_VOL_INVERTED)
      cell = 2.0 * global - cell;   // the opposite control, reflected about the mean
//--- a thin cell can hold an extreme mean, so clamp before it sizes a stop
   if(cell < global * 0.20)
      cell = global * 0.20;
   if(cell > global * 5.00)
      cell = global * 5.00;
   return(cell);
  }
Эту функцию используют три варианта. Constant всегда использует среднее по выборке — контрольный вариант для случая, когда "декомпозиция ничего не вносит". Cell использует среднее значение целевой переменной в ячейке совместной таблицы, в которую попадает текущая пара; это и есть оценка. Inverted зеркально отражает оценку по ячейке относительно среднего по выборке — контрольный вариант для случая, когда "оценка направляет в неверную сторону". В последнем столбце указано стандартное отклонение расстояний до стоп-лосса по сделкам, выраженное в процентах от среднего расстояния.
| Вариант | Сделки | Чистая прибыль | Профит-фактор | На сделку | Просадка баланса | Разброс расстояний до стоп-лосса |
|---|---|---|---|---|---|---|
| Constant (контрольный вариант) | 142 | +347,03 | 1,01 | +2,44 | 9,80% | 55,6% |
| Cell (оценка) | 143 | +512,30 | 1,01 | +3,58 | 9,95% | 56,7% |
| Inverted (контрольный вариант) | 142 | +731,14 | 1,01 | +5,15 | 9,46% | 55,0% |
XAUUSDm D1, с 01.01.2018 по 01.08.2026, депозит 100 000, риск 1% на сделку, пара ret1 + volZ относительно будущей волатильности. Контрольный вариант Inverted оказывается лучшим по чистой прибыли, математическому ожиданию на сделку и просадке; при работающем прогнозе такого соотношения результатов не бывает. Впрочем, все три варианта фактически остаются около нуля: профит-фактор 1,01 в каждом, а результаты находятся в диапазоне от 0,35 до 0,73% за 8,5 года.
Цепочка причин, стоящая за этим результатом, интереснее самой таблицы. Значения в сетке различаются, поэтому прогноз мог варьироваться, а ограничитель так и не сработал. Главная проблема — критерий значимости: в одиннадцати или двенадцати из шестнадцати перестроений модели значимой синергии не обнаружилось. Поэтому в большинстве сделок во всех трех вариантах использовалась одна и та же постоянная величина, а разброс расстояний до стоп-лосса увеличился лишь с 55,6% у контрольного варианта до 56,7% у варианта с оценкой. Разброс значений в сетке, редко выполняемый критерий значимости и 142 сделки, которых недостаточно, чтобы различить варианты.
Важно: советник демонстрирует использование оценки; наличие торгового преимущества не заявляется. Советник прилагается к статье, поскольку контроль по трем вариантам — это корректный способ проверить прогноз, а также потому что победил вариант, который предполагался ошибочным. Тестирование на истории одного лишь варианта Cell, без контрольных вариантов, выглядело бы как небольшой успех.
Заключение
Библиотека выполняет поставленные перед ней задачи. Она разделяет информацию двух индикаторов о целевой переменной на уникальные, избыточные и синергетические части. Библиотека содержит три конкурирующих определения избыточности и показывает их расхождение на целый бит в таблице из четырех строк. Она проверяет вычисления по логическим функциям с аналитически известными результатами, независимой эталонной реализации на Python и перестановочной нулевой модели, побитово идентичной в обоих языках, а также сканирует все 66 пар примерно за 160 мс с поправкой на множественные проверки в рамках семейства.
Она не находит на золоте торгового преимущества, которое можно использовать на практике. Уверенно утверждать это позволяет строгость проверки численного результата, а не само число. Аргументация опиралась на три составляющие: нижний уровень оценок, измеренный на независимых столбцах и показывающий, что необработанная оценка атома сама по себе ничего не значит; нулевую модель на основе блочных перестановок, длина блоков которой обоснована проверкой ложноположительных срабатываний, а не просто задана; два контрольных варианта, оцененных по той же целевой переменной, что и опровергаемый ими результат. Уберите любую из них — и результат по волатильности будет выглядеть как открытие.
К статье прилагаются: одиннадцать подключаемых файлов с совместной таблицей, энтропиями, тремя аксиомами избыточности, решеткой, нулевой моделью на основе блочных перестановок, слоем признаков без использования будущих данных и правилом прогнозирования по сетке; четыре тестовых скрипта; скрипт экспорта и программа перекрестной проверки на Python, которая сверяет атомы с dit, а нулевую модель — в каждом перестановочном прогоне; скрипт рыночного сканирования; индикатор; советник. В таблице ниже они перечислены по отдельности.
| # | Имя файла | Тип | Описание |
|---|---|---|---|
| 1 | PID.mqh | Подключаемый файл | Фасадный слой: все пары, нулевая модель для семейства проверок, лучшая пара |
| 2 | PIDJoint.mqh | Подключаемый файл | Разбиение на бины с одинаковым числом наблюдений и трехмерная таблица частот |
| 3 | PIDLogTable.mqh | Подключаемый файл | log2(k) и klog2(k) табулируются один раз, поэтому при проходах нет вызовов MathLog |
| 4 | PIDInfo.mqh | Подключаемый файл | Энтропии, взаимная и специфическая информация по частотам |
| 5 | PIDRedundancy.mqh | Подключаемый файл | Аксиома: I_min, I_MMI, I_ccs и подгонка по принципу максимальной энтропии |
| 6 | PIDLattice.mqh | Подключаемый файл | Избыточность на входе, четыре атома на выходе, доступные уравнения согласованности |
| 7 | PIDRandom.mqh | Подключаемый файл | splitmix64 для инициализации xorshift64* и блочное перемешивание |
| 8 | PIDNull.mqh | Подключаемый файл | Перестановочная нулевая модель, ее процентили и нижняя граница p-значения |
| 9 | PIDData.mqh | Подключаемый файл | Преобразование баров в двенадцать признаков без использования будущих данных и три целевые переменные для будущих значений |
| 10 | PIDRule.mqh | Подключаемый файл | Прогноз по совместной сетке с сохранением границ бинов |
| 11 | PIDPanel.mqh | Подключаемый файл | Геометрия панели, используемая для отображения и его проверки |
| 12 | PID_Test_Info.mq5 | Скрипт | Проверка соответствия потока, таблица значений, двойная проверка взаимной информации |
| 13 | PID_Test_Gates.mq5 | Скрипт | Проверка шести логических функций по их аналитическим декомпозициям |
| 14 | PID_Test_Lattice.mq5 | Скрипт | Тождества, искусственно заданные связи, нижняя граница и вычислительные затраты |
| 15 | PID_Test_Null.mq5 | Скрипт | Ложные срабатывания в зависимости от длины блока и мощность критерия |
| 16 | PID_Export_ForCrosscheck.mq5 | Скрипт | Пайплайн вычислений с полной точностью для проверки на Python |
| 17 | PID_Scan_Market.mq5 | Скрипт | Реальные бары, оба контрольных варианта, три целевые переменные, аксиомы, проверка переноса вне выборки |
| 18 | PID_Synergy.mq5 | Индикатор | Четыре атома с накоплением ниже уровня, которого достигает шум |
| 19 | PID_Volatility_EA.mq5 | Советник | Демонстрация: стоп-лосс по оценке из ячейки совместной таблицы, два контрольных варианта |
| 20 | pid_prototype.py | Python | Схема и ее тестовые эталоны, проверенные по dit |
| 21 | pid_crosscheck.py | Python | Проверка экспортированных данных по dit, numpy и самим экспортированным данным |
| 22 | MQL5.zip | Архив | Все файлы проекта в соответствующих подпапках; распакуйте в каталог данных терминала |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24382
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 MQL5 Bootstrap (IV): Вспомогательные средства для трейлинг-стопов и переноса стоп-лосса в безубыток
 Рыночная микроструктура в MQL5 (Часть 8): Оценка силы микротренда

 MQL5 Bootstrap (III): Упрощенные средства работы с новостями

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования