

Нейронная сеть на практике: Градиент
 60
 0

Введение
В предыдущей статье мы реализовали приложение, предназначенное для изучения поведения производных и функций активации. Понимание того, что там объяснялось, поможет вам понять то, что мы рассмотрим здесь.
В этой статье я постараюсь объяснить, как и почему градиент начал использоваться при обучении сети перцептронов. Поначалу математика градиента может показаться несколько запутанной и трудной для понимания. Тем не менее я воспользуюсь гораздо более простой методикой, чтобы вы раз и навсегда поняли, как работает градиент на практике. Итак, оставим в стороне всё, что нас отвлекает, и сосредоточимся на том, что будет объяснено в этой статье, поскольку понимание того, как работает градиент, крайне важно для понимания других тем, которые мы рассмотрим позже.Почему градиент?
Поскольку я не знаю, насколько хорошо каждый из вас знаком с математической частью, я постараюсь излагать этот момент не спеша. Само программирование — это простая часть. Трудно понять и, прежде всего, объяснить математическую часть. Многие могли бы сказать, что математику, которая, по сути, составляет теоретическую часть того, что мы собираемся реализовать, можно вообще проигнорировать и сразу перейти к коду.
Лично я считаю, что если показывать только код, то в какой-то момент вы зайдёте в тупик. Я уже говорил об этом и повторю ещё раз: СТАНДАРТНОЙ МОДЕЛИ ДЛЯ СОЗДАНИЯ НЕЙРОННЫХ СЕТЕЙ НЕ СУЩЕСТВУЕТ. Каждый случай индивидуален. Понимание того, как работает каждая часть перцептрона, крайне важно, чтобы вы могли понять его и установить необходимые связи при решении, какие операции использовать. Не думайте ошибочно, что определённая реализация сможет решить любую задачу. Даже если вы попытаетесь обучить её так, чтобы создать модель, представляющую определённый набор данных, вы не всегда сможете использовать ту же реализацию с совершенно другим набором данных, поскольку она редко будет работать корректно.
В другой статье я уже затрагивал тему градиента. Однако я считаю, что там некоторые аспекты были объяснены очень плохо. Возможно, именно поэтому так много людей путаются в этом вопросе. Здесь я объясню это гораздо проще, потому что скоро мы перейдём к куда более сложной теме. Пока мы не будем добавлять функции активации в класс C_Neuron. Дело в том, что я не хочу преждевременно и без необходимости всё усложнять.
Итак, градиент — это гораздо более простой и удобный способ представить производную. Или, точнее, способ действительно использовать касательную прямую, когда мы работаем с несколькими переменными. Таким образом, во многих случаях мы можем использовать более эффективный метод вычисления, чтобы добиться сходимости.
Прежде всего нужно понять, что любой градиент — это, по сути, вектор. И что это означает на практике? Первое следствие состоит в том, что, будучи вектором, он указывает в определённом направлении. В данном случае он указывает в направлении наибольшего увеличения. Однако, если использовать его в противоположном направлении, мы сможем двигаться в сторону наименьшего возрастания или, в нашем случае, к меньшей функции потерь. Именно поэтому при движении в направлении, противоположном градиенту, мы говорим о градиентном спуске.
Второй момент — и именно здесь у многих начинается путаница — заключается в том, что градиент является ортогональным вектором. По этой причине он буквально перпендикулярен другой прямой, проходящей через начальную точку вектора. Именно эта прямая и является касательной. Обратите на это внимание, потому что это будет важно позже. Это отличается от того, что происходит в случае метода наименьших квадратов, где фактически строится секущая прямая. Многие ошибочно утверждают, что перцептрон использует касательную прямую. Однако, если проанализировать выполняемые вычисления, становится ясно, что на самом деле речь идёт о секущей прямой. Поэтому будьте внимательны, указывая, какой тип прямой вы используете в тригонометрических вычислениях. Есть и другие аспекты, связанные с векторами, но для целей этих статей того, что мы только что упомянули, более чем достаточно, чтобы объяснить весь материал.
Поэтому, поскольку градиент является вектором, во многих ситуациях работать с ним значительно удобнее. Здесь, однако, мы сосредоточимся на самом базовом аспекте, по крайней мере пока. В противном случае мы начнём обсуждать темы, не связанные с основным вопросом.
Итак, код, который мы собираемся изменить, точнее, дополнить новой функциональностью, был рассмотрен в статье . Там мы лишь добавили код метода наименьших квадратов. Для этого используется функция, приведённая ниже. 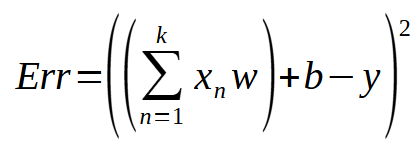
Именно это выражение мы используем для вычисления ошибки для каждой строки обучающих данных методом наименьших квадратов. Здесь < t > обозначает количество входов перцептрона. < w > обозначает каждый из весов. < b > обозначает смещение, а < y > — оценённое значение, получаемое в процессе обучения. Хорошо. Вопрос в том, как мы можем преобразовать это выражение в градиент. Ответ таков: используя математическое понятие — производные.
Если вы посмотрите на это математическое выражение и обладаете минимальными знаниями по математике, то заметите, что существует другое, очень похожее выражение, известное в дифференцировании как правило цепочки. Это выражение приведено ниже. 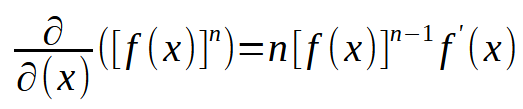
Глядя на это выражение, вы, вероятно, испытываете лёгкую дрожь, потому что оно кажется довольно сложным. На самом деле всё довольно просто и точно показывает, что нам нужно делать. Значение x — это выражение, которое мы хотим дифференцировать. n — это показатель степени, который в данном случае равен двум. Следовательно, двойка становится множителем. Новый показатель степени равен предыдущему минус один. И это новое выражение умножается на производную первого порядка исходного выражения. Вот так просто. Однако, поскольку наше исходное выражение содержит как минимум две переменные — вес и смещение, — мы запишем новое выражение, уже используя обозначения градиента. Таким образом, выражение принимает следующий вид.
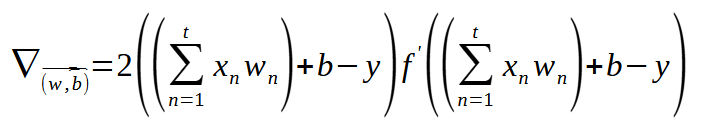
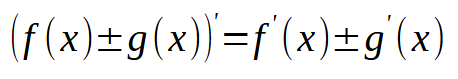
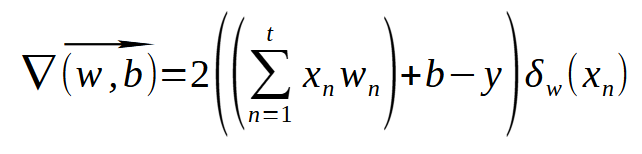
Именно это выражение нам придётся использовать. Возможно, оно записано не совсем корректно с математической точки зрения. Но я здесь не для того, чтобы объяснять математику или рассказывать, как следует записывать математические выражения. Я здесь, чтобы показать, как преобразовать математические выражения в пригодный для использования код. И хотя приведённое выше выражение не совсем корректно с точки зрения математической нотации, его вполне достаточно, чтобы объяснить, что именно нам предстоит реализовать.
Это связано с тем, что здесь я показываю как вычисление смещения, так и вычисление весов, когда у перцептрона несколько входов. Возможно, было бы лучше записать большую часть этого выражения в матричной форме и использовать немного иную нотацию для частной производной в конце. Однако, как я только что упомянул, меня не слишком интересует абсолютная строгость в записи математического выражения, если код написан правильно. В конце концов, мы не хотим получить что-то, что будет вести себя странно или непредсказуемо.
Хорошо, мы подошли к ключевому моменту. Теперь мы можем бегло взглянуть на то, каким получился класс C_Neuron, с правильно вычисленным градиентом, готовым к использованию. Приведённый ниже код показывает, как предыдущее выражение выглядит после реализации в коде. Разумеется, здесь мы показываем полный код. Но не волнуйтесь, я сосредоточусь в объяснении только на части, связанной с градиентом. Об этом мы поговорим в следующем разделе.//+------------------------------------------------------------------+ #property copyright "Daniel Jose" //+------------------------------------------------------------------+ #define macroRandom (rand() / (double)SHORT_MAX) //+------------------------------------------------------------------+ class C_Neuron { private: //+------------------------------------------------------------------+ struct stInfos { bool IsFx; uint nInputs; double Bias, Weight[]; }m_Infos; //+------------------------------------------------------------------+ struct stErr { double weight[], eMaxWeight, bias; }m_Error; //+------------------------------------------------------------------+ inline double Cost_FX(const double &train[]) { double x, err; err = 0; for (uint c0 = 0; c0 < train.Size(); c0++) { x = 0; for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++) x += (train[c0] * m_Infos.Weight[c1]); err += MathPow((x + m_Infos.Bias) - train[c0], 2); } return err; } //+------------------------------------------------------------------+ inline double Learning_FX(const double &train[], const double epsilon, const double LearningRate, const ulong limit) { double err, memT, err_w[]; ulong count; Print("Cost being calculated by the Minimum Square..."); ArrayResize(err_w, m_Infos.nInputs); for (count = 0; (count < limit) && ((err = Cost_FX(train)) > epsilon); count++) { for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) { memT = m_Infos.Weight[c]; m_Infos.Weight[c] += LearningRate; err_w[c] = Cost_FX(train) - err; m_Infos.Weight[c] = memT; } memT = m_Infos.Bias; m_Infos.Bias += LearningRate; m_Infos.Bias = memT - (Cost_FX(train) - err); for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) m_Infos.Weight[c] -= err_w[c]; } PrintFormat("Total interactions: %I64u", count); ArrayFree(err_w); return err; } //+------------------------------------------------------------------+ inline double Cost_DX(const double &train[]) { double x1, t; ZeroMemory(m_Error); for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0) { x1 = 0; for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++) x1 += (train[c0] * m_Infos.Weight[c1]); t = 2 * ((x1 + m_Infos.Bias) - train[c0]); for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++) { m_Error.weight[c1] += (t * train[cw]); m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) > MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight); } m_Error.bias += t; } return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight); } //+------------------------------------------------------------------+ inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit) { ulong count; double eRet; Print("Cost being calculated by the Gradient..."); for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++) { m_Infos.Bias -= (m_Error.bias * LearningRate); for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate); } PrintFormat("Total interactions: %I64u", count); return eRet; } //+------------------------------------------------------------------+ public : //+------------------------------------------------------------------+ C_Neuron(const uint nInputs = 1, const bool isFx = false, double H = 1.0, double L = 0.0) { MathSrand(512); ZeroMemory(m_Infos); m_Infos.IsFx = isFx; m_Infos.Bias = (double)macroRandom; ArrayResize(m_Infos.Weight, m_Infos.nInputs = nInputs); ArrayResize(m_Error.weight, m_Infos.nInputs); for(uint c = 0; c < m_Infos.nInputs; c++) m_Infos.Weight[c] = ((double)macroRandom * (H - L)) + L; } //+------------------------------------------------------------------+ ~C_Neuron() { ArrayFree(m_Infos.Weight); ArrayFree(m_Error.weight); } //+------------------------------------------------------------------+ void View_Variables(void) { Print("Bias: ", m_Infos.Bias); for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) PrintFormat("Weight[%d]: %.16f", c, m_Infos.Weight[c]); } //+------------------------------------------------------------------+ inline double Learning(const double &train[], const double epsilon = 1e-3, const double LearningRate = 1e-2, const ulong limit = ULONG_MAX) { return (m_Infos.IsFx ? Learning_FX(train, epsilon, LearningRate, limit) : Learning_DX(train, epsilon, LearningRate, limit)); } //+------------------------------------------------------------------+ }; //+------------------------------------------------------------------+ #undef macroRandom //+------------------------------------------------------------------+
Обратите внимание, насколько этот код отличается от того, который мы видели в статье, где он впервые появился. Дело в том, что теперь у нас есть совершенно новая реализация, основная цель которой — реализовать градиент и при этом сохранить функцию потерь, основанную на методе наименьших квадратов. Оба варианта можно выбрать в перцептроне во время выполнения конструктора. Имейте в виду, что после того, как выбор будет сделан в конструкторе, больше не потребуется повторно указывать перцептрону, следует ли ему использовать градиент или метод наименьших квадратов для вычисления функции потерь.
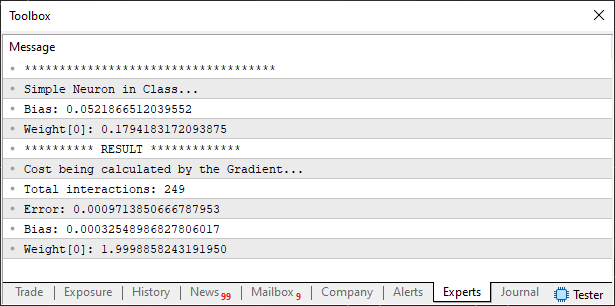
Обратите также внимание на то, что в функцию Learning была добавлена новая переменная. Эта новая переменная пригодится нам позже. А пока давайте посмотрим, правильно ли работает этот перцептрон. Для этого мы используем приведённый ниже код скрипта.//+------------------------------------------------------------------+ #property copyright "Daniel Jose" //+------------------------------------------------------------------+ #include <Neural Network\C_Neuron.mqh> //+------------------------------------------------------------------+ double Train[] { 0, 0, 1, 2, 2, 4, 3, 6, 4, 8 }; //+------------------------------------------------------------------+ void OnStart() { C_Neuron *neuron; Print("************************************"); Print("Simple Neuron in Class..."); neuron = new C_Neuron(1); (*neuron).View_Variables(); Print("********** RESULT *************"); Print("Error: ", (*neuron).Learning(Train)); (*neuron).View_Variables(); delete neuron; } //+------------------------------------------------------------------+
При запуске этого скрипта в MetaTrader 5 вы увидите именно то, что показано на следующем изображении:
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
//+------------------------------------------------------------------+
#include <Neural Network\C_Neuron.mqh>
//+------------------------------------------------------------------+
double Train[] {
                  1,    3,  10.35,
                1.5,  3.25, 11.7875,
                1.75, 3.94, 13.721,
                2.85, 3.46, 14.669
               };
//+------------------------------------------------------------------+
void OnStart()
{
    C_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");

    neuron = new C_Neuron(2);

    (*neuron).View_Variables();
    Print("********** RESULT *************");
    Print("Error: ", (*neuron).Learning(Train));
    (*neuron).View_Variables();

    delete neuron;
}
//+------------------------------------------------------------------+
Теперь у нас есть два входа, чтобы нейрон мог подобрать решение. Результат, который отобразится в MetaTrader 5, можно увидеть на следующем изображении.
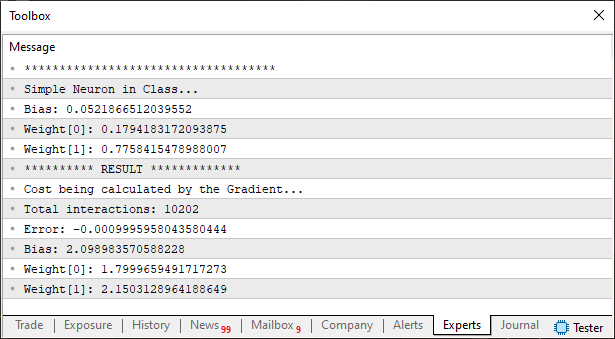
И, как и раньше, результат оказывается чрезвычайно близок к правильным значениям. Это свидетельствует о том, что наш градиент работает правильно и позволяет перцептрону сходиться к правильному ответу.
Не беспокойтесь о создании этого кода. В приложенном файле вы найдёте его полностью. Вы даже сможете создавать новые данные для использования во время обучения. Однако, хотя до сих пор всё кажется идеальным, я всё ещё не объяснил, как работает этот код, несмотря на то, что уже показал выражения, из которых он был получен. Поскольку я хочу спокойно объяснить код градиента, давайте перейдём к новой теме, чтобы сделать это как следует.
Разбираемся в коде градиента
Чтобы не быть скучными и не повторяться, мы приведём здесь только ту часть кода, которая нам действительно нужна. Таким образом, мы сосредоточимся на фрагменте, показанном ниже. Нумерация строк используется исключительно для пояснения этого фрагмента и, следовательно, не соответствует реальной нумерации в файле. 01. //+------------------------------------------------------------------+ 02. inline double Cost_DX(const double &train[]) 03. { 04. double x1, t; 05. 06. ZeroMemory(m_Error); 07. for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0) 08. { 09. x1 = 0; 10. for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++) 11. x1 += (train[c0] * m_Infos.Weight[c1]); 12. t = 2 * ((x1 + m_Infos.Bias) - train[c0]); 13. for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++) 14. { 15. m_Error.weight[c1] += (t * train[cw]); 16. m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) > MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight); 17. } 18. m_Error.bias += t; 19. } 20. return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight); 21. } 22. //+------------------------------------------------------------------+ 23. inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit) 24. { 25. ulong count; 26. double eRet; 27. 28. Print("Cost being calculated by the Gradient..."); 29. for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++) 30. { 31. m_Infos.Bias -= (m_Error.bias * LearningRate); 32. for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) 33. m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate); 34. } 35. PrintFormat("Total interactions: %I64u", count); 36. 37. return eRet; 38. } 39. //+------------------------------------------------------------------+
Этот фрагмент содержит всё, что выражено в последней математической формуле, которую мы рассматривали в предыдущем разделе. Эта формула предназначена для описания градиента, который нам нужно реализовать в коде. То, что мы здесь делаем, может показаться абсурдным. Однако, каким бы сложным ни казалось это математическое выражение, написать код гораздо проще, чем кажется, если в точности придерживаться того, что выражает эта формула.
По сути, вычисление градиента начинается на двадцать третьей строке. После вызова мы попадаем в цикл на двадцать девятой строке, цель которого — выполнить ряд итераций с функцией из второй строки. В каждой итерации мы проверяем, меньше ли ошибка функции потерь, чем заданное значение. Если это так, мы завершаем работу и возвращаем итоговую ошибку на тридцать седьмой строке. Если ошибка по-прежнему больше заданного значения, мы переходим к этапу корректировки значений — как весов, так и смещения. Для этого мы используем коэффициент корректировки, который здесь называем LearningRate. Эти корректировки, выполняемые на строке 31 для смещения и с помощью цикла на строке 32 для весов, фактически реализуют обратное распространение внутри перцептрона. Позже мы более подробно рассмотрим обратное распространение. Пока остановимся на этом.
Хорошо, а как перцептрон узнаёт, насколько ему нужно сместиться в зависимости от LearningRate? Чтобы определить это, перцептрон использует функцию потерь, определённую во второй строке. Давайте рассмотрим эту функцию, чтобы понять, как перцептрон определяет, насколько ему нужно сместиться. Первым делом мы обнуляем всё содержимое памяти, где находится структура, хранящая внутренние ошибки перцептрона. Это делается в шестой строке. После этого мы входим в цикл в седьмой строке, цель которого — пройти по всем строкам массива обучающих данных.
При изучении кода вы заметите, что там есть переменная с именем cw. Её назначение — сохранить начальную позицию для другого внутреннего цикла. На самом деле в этом первом цикле мы вычисляем ошибку между выходным сигналом, рассчитанным перцептроном, и ожидаемым выходным значением. Обратите на это внимание, потому что позже мы вернёмся к этому вопросу в другой статье. Там нам понадобится, чтобы вы поняли, что на данном этапе мы оцениваем ошибку перцептрона. Так что не забывайте эту деталь.
Итак, в десятой строке мы входим в цикл, который пройдет по всем входам одной строки массива обучающих данных. На этом первом этапе мы вычисляем значение x1, которое служит нашей переменной накопления. После вычисления суммы произведений каждого входного значения на соответствующий вес в двенадцатой строке мы выполняем первую часть вычисления градиента. Обратите внимание на следующую деталь, которую можно увидеть в выражении градиента. Вычисление градиента для смещения и весов включает общий этап.
Именно этот этап выполняется в двенадцатой строке. После этого мы можем перейти ко второму и последнему этапу вычисления градиента, который заключается в вычислении частной производной. Поскольку значение смещения является постоянной величиной, его производная равна единице. Таким образом, в данном случае нам не нужно ничего делать со значением, рассчитанным в двенадцатой строке. Мы можем просто прибавить значение, вычисленное для ошибки строки обучающих данных, к значению, уже накопленному для смещения. Это делается в строке восемнадцать. Однако, хотя производная смещения постоянна, с весом дело обстоит иначе. Если мы рассмотрим частную производную по весу, то увидим, что она точно соответствует входному значению, связанному с этим конкретным весом.
По этой причине нам нужно выполнить новый расчёт, снова пройдя по всей строке обучающих данных. На этот раз мы умножим результат, полученный в строке двенадцать, на соответствующее входное значение из строки обучающих данных. Это делается с помощью цикла в строке тринадцать. Поскольку мы уже продвинулись на определённое количество позиций внутри массива, нам нужна вспомогательная переменная, созданная в строке семь, чтобы снова корректно пройти по нему. Ошибка, соответствующая каждому весу, сохраняется в другом массиве. Это будет важно позже, когда в строке тридцать три мы скорректируем значения весов с учётом сохранённой для каждого из них ошибки.
Здесь есть одна важная деталь. Вы можете заметить, что внутри цикла в строке тринадцать выполняются две операции. Первая — та, о которой мы только что упомянули: отдельно накапливать ошибку, соответствующую каждому весу. Вторая заключается в поиске наибольшей ошибки среди всех вычисляемых значений. Смысл разделения этих двух задач, то есть независимого хранения ошибки для каждого веса и одновременного поиска наибольшей вычисленной ошибки, состоит в том, чтобы предотвратить преждевременное завершение обучения, а также не допустить, чтобы все веса корректировались на одну и ту же величину. Если не проводить это различие, вы будете изменять уравнение, используемое для вычисления градиента.
Это изменение может оказаться полезным в очень специфических ситуациях, поскольку позволит вычислять градиент быстрее. Однако, как уже упоминалось, это применимо лишь к весьма конкретным случаям. А поскольку мы здесь не разрабатываем конкретное решение, нам нужно, чтобы градиент вычислялся и корректировался как можно более универсальным образом. Отсюда и разделение между наибольшей ошибкой и ошибками, соответствующими каждому из весов.
Хорошо, после всего этого нам осталось выполнить ещё одну проверку, прежде чем вернуть результат вызывающему коду. Эта проверка, выполняемая в строке 20, гарантирует, что ошибка смещения, если она больше ошибки весов, будет тем значением, которое вернётся вызывающему коду. Во многих случаях ошибка смещения будет меньше, чем ошибка весов. Однако, когда это не так, мы хотим избежать завершения обучения. По этой причине и выполняется проверка в строке 20.
Именно так строится градиент в перцептроне, чтобы он мог принимать любое число входов, используя то же математическое выражение, которое мы рассматривали в предыдущей теме. Хотя это может показаться довольно запутанным и сложным, при реализации в коде всё оказывается гораздо проще и понятнее, чем можно было бы представить. Всё это позволяет нашему перцептрону решать задачи независимо от того, какого типа проблема перед ним поставлена. Вот это действительно приятно и увлекательно программировать. Однако мы ещё не закончили. Нам ещё предстоит добавить функцию активации и в градиент, и в функцию потерь метода наименьших квадратов. Это действительно самая интересная часть реализации. Но сначала нам нужно понять, как будут выполняться вычисления, потому что написание кода может оказаться даже немного скучным. А вот математическая часть... Ах, вот она действительно интересна. Итак, чтобы разделить эти две вещи, перейдём к новой теме.
Немного математики никому не повредит
Вся соль не в том, чтобы придумать способ по отдельности добавлять каждую функцию активации. Это уж точно совсем не интересно. Это становится утомительным именно из-за своей простоты и повторяемости. Здесь мы займемся чем-то немного более сложным. Давайте разработаем способ использовать любую нужную нам функцию активации, просто добавив её в библиотеку функций активации. Разрабатывать это и правда будет интересно.
Прежде чем начать, позвольте мне немного пояснить, что мы уже создали и что собираемся создать. Класс C_Neuron ни в коем случае не предназначен для использования метода наименьших квадратов в качестве окончательной функции потерь. Это объясняется тем, что после правильной реализации функций активации в градиенте этот метод в целом окажется гораздо более подходящим, поскольку с ростом числа входов перцептрона он работает значительно быстрее. То есть, если вам нужно использовать десять тысяч входов в перцептроне, могу гарантировать, что во время обучения градиент будет работать гораздо быстрее, чем метод наименьших квадратов. По завершении обучения в окончательной реализации нам больше не понадобится никакая функция потерь. Нам понадобятся только функции активации, веса и смещение каждого из задействованных перцептронов, а также способ их соединения. Но этот вопрос будет более подробно рассмотрен в другой статье.
То, как мы будем добавлять функцию активации в перцептрон, заставит нас использовать несколько разные вычисления в зависимости от того, применяем ли мы метод наименьших квадратов или градиент. На это есть конкретная причина: обратное распространение. Когда мы будем реализовывать это обратное распространение в сети, я не хочу, чтобы возникли проблемы при передаче данных между перцептронами. Поэтому подход, который мы будем использовать, будет довольно сильно отличаться от того, чего многие, возможно, ожидают. Пока что сосредоточимся на обратном распространении внутри самого перцептрона и оставим в стороне связи между перцептронами в сети. Чтобы это понять, взгляните на следующее изображение. 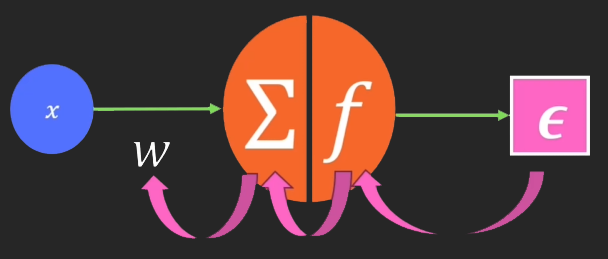
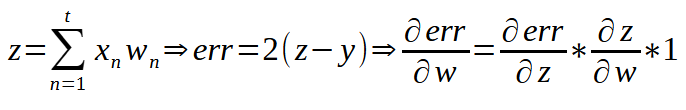
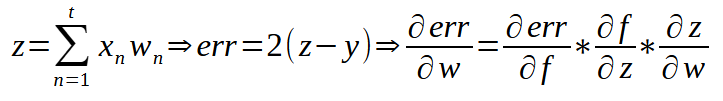
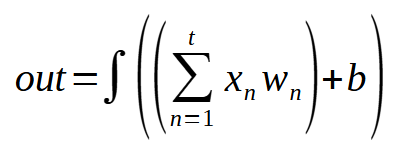
Именно это выражение мы действительно используем — как когда у нас уже есть обученная модель, так и во время её обучения. Одно уточнение: знак интеграла, который вы видите в этом выражении, не означает, что мы будем вычислять интеграл. Он нужен исключительно для представления функции активации. Если присмотреться к этому выражению, становится ясно, что в нём не выполняется никаких сложных вычислений. Всё сводится к сложению и умножению, а также, конечно, к одной из функций активации, описанных в предыдущей статье. Эту функцию необходимо определить при создании перцептрона, чтобы всё работало правильно.
А теперь самое интересное. Вероятно, вы уже думаете: "Значит, у перцептрона два выхода вместо одного? Это то, что мы только что создали?". Да, именно это и произойдёт. Однако мы ещё не создали эти два выхода. Действительно, обратное распространение уже можно считать одним из выходов, но в нынешнем виде оно пока не считается. Один из выходов известен как FORWARD PROPAGATION, а другой — как BACK PROPAGATION. Оба должны существовать, чтобы перцептрон был для нас действительно полезен.
Поскольку эта концепция очень проста и, казалось бы, очевидна, о FORWARD PROPAGATION говорят редко. Зато о BACK PROPAGATION говорят очень много, даже если объяснение при этом остаётся несколько неполным.
Заключительные замечания
В этой статье я более подробно объяснил, как и почему в сетях перцептронов стали использовать градиент. Мы также начали изучать ещё один вопрос: FORWARD PROPAGATION и BACK PROPAGATION, хотя пока ещё не добавили в перцептрон функции активации, чтобы увидеть этот механизм в действии. Изложенное здесь облегчит изложение материала в следующих статьях и, следовательно, их понимание.
Хотя всё это пока может казаться немного далёким, мы движемся в правильном направлении. Поэтому я прошу вас внимательно изучить этот материал, так как понимание изложенного здесь крайне важно для понимания того, что мы рассмотрим далее.| Файл MQ5 | Описание |
|---|---|
| Скрипты\Пример A | Базовая демонстрация |
| Скрипты\Пример B | Базовая демонстрация |
Перевод с португальского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/pt/articles/13936
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Адаптивный индикатор Malaysian Engulfing (Часть 2): Оптимизированный диапазон баров ретеста
 Создание пользовательского тикового графика в MQL5
 Нейронная сеть на практике: Перцептрон
 От начального к среднему уровню: Объекты и подокна (I)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования