

Нейронная сеть на практике: Рождение C_Neuron
 68
 0

Введение
В предыдущей статье «Нейронная сеть на практике: Когда использовать искусственный нейрон и как понять его функцию в MQL5» я упомянул и наглядно показал, что нейрон не всегда способен справиться с определёнными ситуациями. Вы тоже можете проверить это с помощью кода из приложенного файла. Хотя широко распространённое мнение утверждает прямо противоположное тому, что мы можем наблюдать, эксперименты не оставляют места для сомнений. Использование нейронов или даже нейронной сети не всегда будет лучшим вариантом.
Тем не менее существует огромное количество ситуаций, в которых нейрон или даже нейронная сеть являются идеальным решением для быстрого и эффективного получения адекватного представления набора данных или записей. Часто достаточно просто использовать базу данных, в которой уже содержатся все нужные нам данные или данные, с которыми мы хотим работать. В других случаях данные будут поступать в режиме реального времени. Эту вторую модель, в которой данные подаются в нейронную сеть в режиме реального времени, мы пока оставим на потом.
Дело в том, что я хочу показать довольно интересное применение, которое позволит вам, уважаемый читатель, понять, как система, или нейронная сеть, научится справляться с вполне конкретной ситуацией. Без сомнения, это пробудит ваше любопытство и интерес к всё более глубокому изучению темы. А пока давайте сосредоточимся на том, что перед нами сейчас.
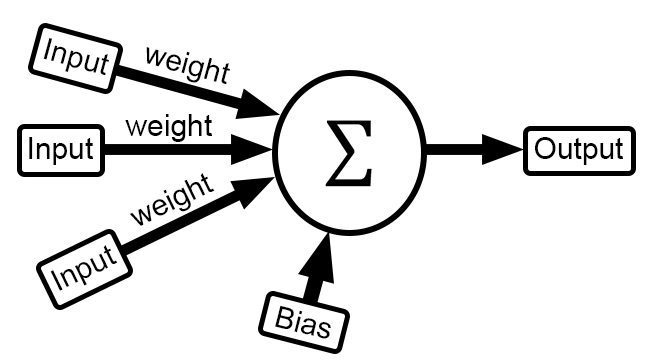
Итак, если вы следите за этой серией статей о нейронных сетях, то наверняка заметили, что мы часто использовали только один вход, чтобы упростить программирование и объяснение кода. В реальных приложениях мы редко используем только один вход. Как правило, у нейрона как минимум два входа, особенно если мы хотим реализовать небольшую нейронную сеть. Даже на начальном этапе, уважаемый читатель, вы, наверное, заметили, что при создании нейрона для представления логических элементов потребовалось использовать более одного входа. В ходе этого процесса нам пришлось использовать небольшую нейронную сеть, чтобы представить логический элемент XOR и его инверсию.
Хорошо, на этом этапе вы, наверное, уже думаете: добавлять новые входы относительно просто. Нам нужно лишь сообщить об этом нейрону, добавить вес для этого входа — и всё готово. Конечно, не стоит забывать о том, что нужно изменить функцию потерь. В противном случае новый вход не даст никакой пользы. В этом вы правы, уважаемый читатель. Однако здесь есть небольшая сложность. Добавить несколько входов очень просто, как и удалить их.
Стоит продумать некоторые детали, связанные с этим. Вы же не хотите постоянно писать или изменять код только для того, чтобы добавлять или удалять входы нейрона. И, что ещё хуже, если вам понадобится нейронная сеть, вы наверняка не захотите программировать её вручную. Гораздо проще и правильнее указать, какой должна быть её архитектура, и позволить коду реализовать её за нас. Позже мы рассмотрим, как это сделать. Вернёмся к вопросу о входах.
Ещё один вопрос: предположим, что для решения задачи требуется тысяча входов. Вы начинаете добавлять код для создания тысячи таких входов. В какой-то момент кто-то подходит и говорит вам: «Слушай, мы только что поняли, что понадобится десять тысяч входов». Вам хочется плакать, но вы соглашаетесь выполнить эту задачу. Когда у вас уже почти созданы десять тысяч входов, появляется кто-то ещё и говорит: «Мы поняли, что десять тысяч входов не нужны; нам хватит всего двух тысяч». Тогда вам так и хочется схватить дубинку и преподать кому-нибудь урок.
Нередко над новичком так подшучивают. Если бы он не был таким новичком, у него было бы чуть больше смекалки, и он знал бы, как выйти из этой ситуации, чтобы уменьшить свои усилия. Именно в этом и состоит первоначальный замысел этой статьи: показать, как создать реализацию, которая позволит нам очень-очень просто управлять количеством входов. Итак, давайте засучим рукава и перейдём к коду.
Рождение класса C_Neuron
Прежде чем начать, нам нужно уточнить одну деталь, уважаемый читатель: класс, который мы создадим для представления нейрона, пока что будет очень простым и прямолинейным. Мы не будем включать ничего, кроме того, что строго необходимо. Код будет максимально простым и наглядным, хотя и неэффективным с точки зрения времени вычислений. Под временем вычислений здесь следует понимать время выполнения.
Цель здесь не в том, чтобы создать эффективный код, а в том, чтобы создать функциональный код, который любой сможет без труда понять. Даже тот, кто только начинает программировать на MQL5 и интересуется нейронными сетями, сможет это понять, поскольку мы будем использовать чистый MQL5. Возможно, в будущем я добавлю немного SQL, но постараюсь как можно строже придерживаться простого и чистого MQL5.
Прояснив это и объяснив, что именно мы будем рассматривать, можем начинать. Начнём с самой простой реализации — той, где в качестве функции потерь используется метод наименьших квадратов. Опять же, наша цель — объяснять, а не добиваться эффективности. Прежде чем перейти к коду, обратим внимание на следующее:

Возможно, мы немного повторяемся, но таковы нейронные сети. Оставив это в стороне, обратите внимание на одну любопытную деталь в предыдущем уравнении. Рассмотрев её и поняв, что она делает, вы сразу заметите, что нужно умножить каждый вход на вес, всё это сложить и вычесть полученную сумму из целевого значения. Если возвести результат в квадрат, мы получим итоговую ошибку для оцениваемой позиции. Одно уточнение: есть и другие функции для вычисления ошибки, но мы будем использовать эту, потому что её проще всего дифференцировать.
Хорошо, теперь выделим вход, обозначенный как < X >, и вес, обозначенный как < W >. Так мы получаем то, что показано ниже.

Хм, интересно. Что это значит? Уважаемый читатель, делая так, мы указываем, что значение < k > — это количество входов, которое будет у нейрона. Если для какого-либо обучения требуется тысяча входов, нам нужно просто присвоить k значение тысяча. Вот так просто. Таким образом, у нас получится нечто эквивалентное следующему.
А теперь начинается действительно интересная часть, напрямую связанная с тем, что нам нужно сделать в коде. Глядя на сумму произведений каждого входа x на его вес w, вы, возможно, не заметите, что это матричная операция. "Как? Я не понимаю". Не волнуйтесь, уважаемый читатель, давайте преобразуем запись суммы в более понятную форму, чтобы вы смогли это понять. Посмотрим на это на следующем изображении.

Теперь перед нами нечто действительно прекрасное. Хотя реализовать в коде то, что находится слева, сложно, реализовать то, что справа, очень легко. Это связано с тем, что мы можем использовать массивы. Так мы можем очень просто и быстро изменить количество входов у нейрона. "Это просто замечательно! Как это перевести в код?" Уважаемый читатель, ниже вы можете увидеть, как это выглядит в коде класса.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define macroRandom (rand() / (double)SHORT_MAX)
05. //+------------------------------------------------------------------+
06. class C_Neuron
07. {
08.     private:
09.         uint    m_Inputs;
10.         double  m_bias,
11.                 m_weight[];
12. //+------------------------------------------------------------------+
13.         inline double Cost(const double &train[])
14.         {
15.             double x, err;
16.
17.             err = 0;
18.             for (uint c0 = 0; c0 < train.Size(); c0++)
19.             {
20.                 x = 0;
21.                 for(uint c1 = 0; c1 < m_Inputs; c1++, c0++)
22.                    x += (train[c0] * m_weight[c1]);
23.                 err += MathPow((x + m_bias) - train[c0], 2);
24.             }
25.
26.             return err;
27.         }
28. //+------------------------------------------------------------------+
29.     public :
30. //+------------------------------------------------------------------+
31.         C_Neuron(const uint nInputs = 1, double H = 1.0, double L = 0.0)
32.         {
33.             MathSrand(512);
34.             m_Inputs = nInputs;
35.             ArrayResize(m_weight, m_Inputs);
36.             for(uint c = 0; c < m_Inputs; c++)
37.                 m_weight[c] = ((double)macroRandom * (H - L)) + L;
38.             m_bias = (double)macroRandom;
39.         }
40. //+------------------------------------------------------------------+
41.         ~C_Neuron()
42.         {
43.             ArrayFree(m_weight);
44.         }
45. //+------------------------------------------------------------------+
46.         void View_Variables(void)
47.         {
48.             Print("Bias: ", m_bias);
49.             for (uint c = 0, m = m_weight.Size(); c < m; c++)
50.                 PrintFormat("Weight[%d]: %.16f", c, m_weight[c]);
51.         }
52. //+------------------------------------------------------------------+
53.         inline double Learning(const double &train[], const double epsilon = 1e-3, const ulong limit = ULONG_MAX)
54.         {
55.             double  err,
56.                     mem_b,
57.                     err_w[],
58.                     mem_w[];
59.
60.             ArrayResize(err_w, m_Inputs);
61.             ArrayResize(mem_w, m_Inputs);
62.             for (ulong count = 0; (count < limit) && ((err = Cost(train)) > epsilon); count++)
63.             {
64.                 ArrayCopy(mem_w, m_weight);
65.                 for (uint c = 0, m = m_weight.Size(); c < m; c++)
66.                 {
67.                     m_weight[c] += epsilon;
68.                     err_w[c] = Cost(train) - err;
69.                     m_weight[c] = mem_w[c];
70.                 }
71.                 mem_b = m_bias;
72.                 m_bias += epsilon;
73.                 m_bias = mem_b - (Cost(train) - err);
74.                 for (uint c = 0, m = m_weight.Size(); c < m; c++)
75.                     m_weight[c] -= err_w[c];
76.             }
77.             ArrayFree(err_w);
78.             ArrayFree(mem_w);
79.
80.             return err;
81.         }
82. //+------------------------------------------------------------------+
83. };
84. //+------------------------------------------------------------------+
85. #undef macroRandom
86. //+------------------------------------------------------------------+
Из-за некоторых различий между C/C++ и MQL5 код получился несколько иным, чем версия, которая, на мой взгляд, была бы более удобочитаемой. Тем не менее, понять это несложно. Здесь мы реализовали самое базовое: этот нейрон будет использовать метод наименьших квадратов в качестве функции потерь и сможет иметь столько входов, сколько потребуется. Есть одна небольшая деталь, которая существенно повлияет на то, как вы будете работать с этим классом. Мы увидим это чуть позже.
Давайте для начала разберём код, который мы реализовали. Сначала рассмотрим конструктор класса, который находится в строке 31. Обратите внимание: он прост, понятен и прямолинеен. С помощью его аргументов мы можем указать классу, сколько входов будет у нейрона. Кроме того, мы можем указать верхнюю и нижнюю границы псевдослучайных значений, которые будут присваиваться при инициализации.
Как видите, теперь мы начинаем разбирать этот вопрос более подробно. В строке 33 мы указываем, как будет инициализирован генератор псевдослучайных чисел. Поскольку наша цель — учебная, мы будем использовать фиксированное значение. В реальных условиях строка 33 была бы немного другой. Фактически, это была бы единственная строка во всём коде класса, которую пришлось бы изменить.
Итак, в следующих шагах мы инициализируем внутренние значения класса. Сначала сохраним количество входов в строке 34. Затем, в строке 35, мы выделяем достаточно памяти для массива весов — по одному весу на каждый вход. Для инициализации этих весов мы используем цикл в строке 36. Наконец, в строке 38 мы инициализируем сдвиг. На этом наш нейрон будет готов к обучению.
Хорошо, в строке 41 у нас есть деструктор, единственная цель которого — освободить память, зарезервированную для хранения весов. Поскольку у нашего нейрона может быть несколько входов и нам, возможно, захочется посмотреть их содержимое, в строке 46 у нас есть очень простая, но очень полезная процедура. Её единственная цель — вывести значения всех переменных нейрона в терминал MetaTrader 5. В строке 48 мы указываем, что нужно вывести значение сдвига. В строке 49 выводятся все веса. То есть нам не нужно заново указывать, сколько входов должен показать нейрон. Поскольку он знает, сколько у него входов, он покажет нам их все. Нечто прямое, простое и практичное.
А теперь переходим к долгожданной части: функциям, которые используются для обучения нейрона. Сначала мы воспользуемся квадратичной функцией потерь. Поскольку она требует большей вычислительной мощности, вскоре мы заменим её другим типом, скорее всего каким-нибудь методом на основе градиентов. Оставим это на потом. Сначала давайте посмотрим, как работает метод наименьших квадратов.
Прежде всего, уважаемый читатель, вам нужно понять следующее: неважно, где вы будете использовать этот нейрон. Если нейрон может интерпретировать обучающие данные, вы сможете использовать его, не понимая, какой именно тип функции применяется для обучения. Возможно, это прозвучит несколько абстрактно. Поскольку мы используем класс, мы можем изменять в нём всё что угодно, не сообщая об этих внутренних изменениях коду, который его использует. Таким образом, мы можем использовать более эффективную функцию потерь, при этом приложению, использующему этот класс, не нужно об этом знать. Это очень удобно, так как мы можем перейти к методу обучения на основе градиента, ничего не сообщая приложению, использующему этот класс.
Для этого нам нужен подходящий интерфейс. По этой причине единственной функцией, которую мы будем использовать для обучения, будет та, что объявлена в строке 53. Обратите внимание, что она довольно проста и требует всего нескольких аргументов. Первый содержит обучающие данные. Второй указывает целевое значение ошибки, при достижении которого обучение считается завершённым. Последний аргумент указывает, сколько итераций допускается. Этот аргумент позволяет нам проверить обучение и понять, сходится ли оно к решению. Как было показано в предыдущих статьях, может случиться так, что нейрон — или, точнее, функция, которую мы ищем, — не сможет сойтись к решению.
Внутри этой функции, объявленной в строке 53, мы объявляем несколько внутренних переменных в строке 55. В строках 60 и 61 мы выделяем память для временного использования. В строке 62 мы входим в цикл, который будет повторяться заданное число раз. Мы уже объясняли этот цикл в других статьях, хотя его содержимое несколько отличается. Обратите внимание, что в строке 64 мы копируем веса во временную область памяти. Это не очень эффективно, но пока что подойдет для наших целей.
В строке 65 мы входим в новый внутренний цикл, цель которого — пройти по входам один за другим и вычислить для каждого значения ошибки. Новые значения ошибки для каждого входа временно сохраняются в памяти, как показано в строке 68. После вычисления ошибок для всех входов на основе желаемого изменения мы должны скорректировать значение ошибки сдвига. Это делается в строке 73. Наконец, мы можем скорректировать каждый вес с учетом рассчитанной ранее ошибки с помощью цикла в строке 74.
После выполнения всего этого код возвращается к строке 62, где начинается новая итерация. Цикл будет продолжаться до тех пор, пока не будет достигнут указанный предел итераций или ожидаемое значение ошибки. Как только будет выполнено любое из этих двух условий, цикл завершится, и будут выполнены строки 77 и 78, чтобы освободить выделенную память. Поскольку это иногда бывает полезно, в строке 80 мы вернём значение ошибки, достигнутое в ходе обучения. Так мы сможем проверить, укладывается ли оно в ожидаемые пределы, когда будем тестировать обучение с небольшим количеством итераций.
Хорошо, перейдём к строке 13. Как вы можете видеть, в этой функции обучения мы несколько раз вызываем функцию, вычисляющую ошибку. Эта функция, как видно из строки 13, принимает один аргумент. Поскольку это массив, мы можем передать гораздо больше информации, чем с помощью структуры другого типа. Здесь нам нужно проявить небольшую осторожность. Будьте внимательны, уважаемый читатель, потому что, если вы не поймёте того, что я собираюсь объяснить, у вас возникнут проблемы при попытке обучить нейрон с большим или меньшим количеством входов.
Давайте не торопиться. В строке 18 мы запускаем цикл, который пройдёт по всему массиву. Как вы можете заметить, этот проход выполняется без различения данных. То есть функция ни в какой момент не будет проверять, соответствует ли значение входу или ожидаемому значению. Впрочем, если вы всё сделаете правильно, у вас не будет проблем. Давайте посмотрим, как их избежать при работе с этим массивом.
При создании нейрона мы указываем, сколько входов он должен иметь. При выполнении цикла в строке 21 функция потерь возьмёт каждое значение из массива обучения и умножит его на вес соответствующего входа. Это часть матричных вычислений. Мы умножаем значения и прибавляем каждое произведение к предыдущему результату. И массив обучения, и массив весов являются одномерными. Скалярное произведение входов и их весов даёт скалярную величину. К этому значению затем прибавляется сдвиг, а полученный результат вычитается из ожидаемого значения.
После вычисления этого результата мы возводим его в квадрат и прибавляем к предыдущим значениям. Таким образом, мы получаем сумму квадратов ошибок. То, что я только что объяснил, выполняется в строке 23. По завершении прохода по обучающим значениям мы возвращаем общую ошибку, вычисленную в строке 26.
Если вы посмотрите на эту функцию потерь и обратите внимание на то, что происходит в циклах, она, возможно, покажется вам немного странной, и вы подумаете, что она не сработает. Давайте проверим это с помощью приведённого ниже кода.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #include <Neural Network\C_Neuron.mqh>
05. //+------------------------------------------------------------------+
06. double Train[] {
07.                 0, 0,
08.                 1, 2,
09.                 2, 4,
10.                 3, 6,
11.                 4, 8
12.                };
13. //+------------------------------------------------------------------+
14. void OnStart()
15. {
16.     C_Neuron *neuron;
17.
18.     Print("************************************");
19.     Print("Simple Neuron in Class...");
20.
21.     neuron = new C_Neuron(1);
22.
23.     (*neuron).View_Variables();
24.     Print("********** RESULT *************");
25.     Print("Error: ", (*neuron).Learning(Train));
26.     (*neuron).View_Variables();
27.
28.     delete neuron;
29. }
30. //+------------------------------------------------------------------+
Результат выполнения показан на следующем изображении.
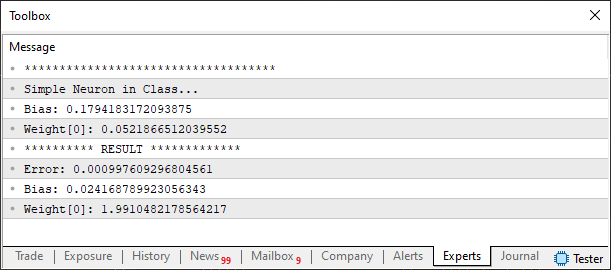
Обратите внимание, что результат находится в пределах ожидаемого, и это показывает, что нейрон работает корректно. Погодите-ка: как работает код, который мы только что рассмотрели? Это выглядит немного странно. Уважаемый читатель, как я уже упоминал, всё, что мы будем здесь делать, будет изложено в максимально понятной форме. В этом коде есть два момента, на которые вам следует обратить внимание при использовании класса нейрона. Во-первых, это обучающие данные, которые необходимо подготовить с учётом количества входов нейрона. Обе эти вещи тесно связаны между собой. Если вы измените одно, не учитывая другое, то допустите ошибку или получите полностью дезориентированный нейрон, который не будет знать, что делать с данными.
Обратите внимание. В шестой строке задаются обучающие данные. Здесь они подготовлены для нейрона с одним входом. По этой причине в строке 21 мы указываем, что у нейрона будет один вход. Вернёмся к обучающим данным. Обратите внимание, что я организовал массив так, чтобы он выглядел как матрица из двух столбцов и нескольких строк. Чтобы данные были упорядочены, советую вам расположить данные в массиве таким образом.
То есть нужно задать столько столбцов, сколько входов у нейрона, плюс последний столбец, соответствующий ожидаемому значению или оценочному значению, если точное значение неизвестно. Чтобы было понятнее: если вы хотите, чтобы у нейрона было два входа, вам нужно организовать массив в три столбца. Третий будет содержать значение, которое позволит нейрону оценить, насколько он ошибается. Так он сможет корректировать значение функции потерь и, таким образом, обучаться.
Пока что лучше работать с этим нейроном не спеша, так как он может дойти до точки застоя, которая помешает ему продвигаться в обучении. Это связано с тем, что у него отсутствует функция активации.
Вы можете увидеть, как это происходит, в статье "Нейронная сеть на практике: Практика ведёт к совершенству", где я показал, что можно использовать нейрон для представления логического элемента. Поскольку у нейрона не было функции активации, время от времени он доходил до состояния застоя, при котором скорость обучения сильно снижалась или он просто переставал учиться.
Помните, что мы только начинаем новый этап, на котором я объясню вам разные вещи. Пока что у нас уже есть отправная точка для изучения. Тем не менее, с помощью этого нейрона можно решать некоторые простые полиномиальные задачи. Например, если вы измените код, чтобы использовать другой набор данных обучения, то увидите, что он по-прежнему генерирует вполне приемлемые данные, хотя и не точные. Всё будет зависеть от того, можно ли уравнение, использованное для генерации данных, представить в виде прямой или аффинной функции. Например, давайте изменим код, как показано ниже.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #include <Neural Network\C_Neuron.mqh>
05. //+------------------------------------------------------------------+
06. double Train[] {
07.                   1,    3,  10.35  ,
08.                 1.5,  3.25, 11.7875,
09.                 1.75, 3.94, 13.721 ,
10.                 2.85, 3.46, 14.669 ,
11.                };
12. //+------------------------------------------------------------------+
13. void OnStart()
14. {
15.     C_Neuron *neuron;
16.
17.     Print("************************************");
18.     Print("Simple Neuron in Class...");
19.
20.     neuron = new C_Neuron(2);
21.
22.     (*neuron).View_Variables();
23.     Print("********** RESULT *************");
24.     Print("Error: ", (*neuron).Learning(Train));
25.     (*neuron).View_Variables();
26.
27.     delete neuron;
28. }
29. //+------------------------------------------------------------------+
Теперь мы видим нечто немного иное. В шестой строке приведены новые данные для обучения, подготовленные для использования двух входов в нейроне вместо одного. При выполнении этого нового кода мы получаем результат, показанный на следующем изображении.
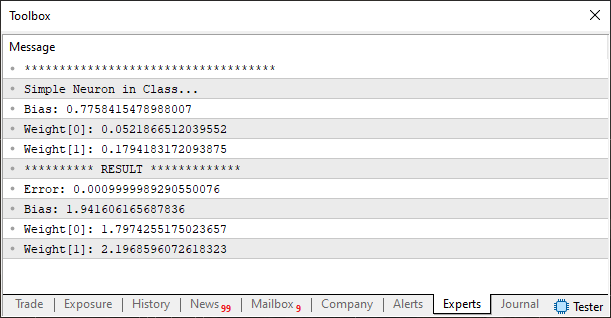
Просто, правда? Уважаемый читатель, вспомните, о чём мы говорили ранее: мы должны подготовить и проверить массив для обучения, учитывая, что каждый столбец представляет собой один вход. Последний столбец будет содержать значения, которые позволят нейрону оценить свою ошибку на основе значений его внутренних параметров — весов и сдвига, инициализированных псевдослучайным образом. Поэтому в этом втором примере обучения данные распределены по трём столбцам. Следовательно, нам нужно изменить значение в строке 20 с «1» на «2». Таким образом, нейрон сможет интерпретировать два значения как входы и использовать третье как ожидаемый результат для корректировки ошибки на каждой итерации.
Поскольку весь код спроектирован так, чтобы нам не приходилось его изменять, нейрон автоматически выделит достаточно места для анализа двух входов. Таким образом, у нас наконец-то появилась реализация, которая избавляет нас от необходимости писать или изменять код каждый раз, когда нужно изменить количество входов нейрона.
Заключительные замечания
В этой статье мы начинаем отходить от прежнего подхода к программированию, при котором каждое изменение, настройка или новое требование к нейрону вынуждало нас менять код. Теперь мы начинаем инкапсулировать реализацию, чтобы можно было использовать, улучшать и изменять её без особых затруднений. По мере добавления новых функций в нейрон любой код, использующий этот класс, будет выигрывать от этих изменений.
На данный момент мы создали самую простую из всех реализаций: нейрон по-прежнему использует функцию потерь, основанную на методе наименьших квадратов, и пока не имеет функции активации. Кроме того, нам не хватает ещё одного элемента, который мы реализуем позже: механизма обратного распространения, позволяющего передавать ошибку между несколькими соединёнными нейронами. Текущий механизм ограничен одним-единственным нейроном. Для более сложного обучения нам необходимо усовершенствовать его так, чтобы мы могли соединять нейроны в каскад. Другими словами, уважаемый читатель, нам нужно создать механизм обратного распространения, способный передавать ошибку, когда нейроны соединяются друг за другом. При нынешнем механизме, если вы попытаетесь это сделать и создадите небольшую нейронную сеть, в какой-то момент она застрянет и не сможет продолжать обучение.
Как я уже говорил, позже мы рассмотрим, как это сделать. А пока начните изучать код этой статьи и экспериментировать с ним. В приложенном файле вы найдёте два нейрона, которые мы здесь рассмотрели, а также исходный класс. До встречи в следующей статье.
| Файл MQ5 | Описание |
|---|---|
| Скрипты\Пример A | Базовая демонстрация |
| Скрипты\Пример B | Базовая демонстрация |
Перевод с португальского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/pt/articles/13873
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Особенности написания Пользовательских Индикаторов
 Мультитаймфреймовый движок без утечек дескрипторов с чтением закрытых баров в MQL5

 От начального к среднему уровню: Подокна (II)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования