

Нейронная сеть на практике: Перцептрон
 38
 0

Введение
В предыдущей статье «Нейронная сеть на практике: Градиент» мы немного рассказали о том, как градиент возникает из использования производной функции потерь.
Хотя разбить этот материал на части — задача не из простых, поскольку речь идёт о теме, требующей знакомства с огромным количеством элементов и понятий, многие из которых совершенно абстрактны, а другие довольно сложны из-за использования одних и тех же терминов в разных контекстах, я постарался изложить материал как можно более понятно.
Среди этих понятий — термины «BACK PROPAGATION» и «FORWARD PROPAGATION», которые обычно используются вперемешку, как правило без должного объяснения. Чтобы правильно понять всё, что происходит в коде сети перцептронов, нам нужно понять, как появились эти концепции.
Пока мы не будем вдаваться в некоторые детали. Однако нам необходимо понять, как появился термин «нейронная сеть». Для этого нам нужно понять основу, известную как перцептрон, — именно он и является основной темой этой статьи.
Перцептрон
Когда речь заходит о перцептроне, многие сразу начинают думать об искусственном интеллекте. Сам термин предложили Маккаллох и Питтс, а в 1958 году Фрэнк Розенблатт реализовал эту идею на практике, когда работал в Авиационной лаборатории Корнелла. Розенблатт черпал вдохновение в биологическом нейроне и в том, на что тот способен. По сути, перцептрон состоит из одного или нескольких входов, системы обработки и выхода как результата этой обработки.
Однако первая практическая реализация была выполнена на IBM 704, где Розенблатт попытался создать с помощью программного обеспечения систему, способную распознавать лица. Любопытно, что при описании того перцептрона использовалась следующая фраза: «Перцептрон — это зародыш электронного компьютера, который, как надеются ВМС, сможет ходить, говорить, видеть, писать, размножаться и осознавать собственное существование». Эти люди — просто посмешище. Представляю, сколько денег они, должно быть, получили на исследования после той демонстрации.
Из-за технических трудностей система работала не так, как ожидалось, и оказалась способна обрабатывать только линейные шаблоны. По этой причине система не могла распознавать другие шаблоны, как предполагалось. Это привело к тому, что интерес к исследованиям в области искусственного интеллекта на некоторое время сошёл на нет.
Перцептрон использует несколько входных значений. С помощью весов и смещения он может выполнять взвешенные сложения и умножения. Название оказалось довольно интересным, поскольку создаваемая функция была способна выполнять именно такого рода задачу. То есть, если мы подадим на вход функции несколько значений, а она обладает ранее приобретёнными знаниями, то сможет выполнять задачи того же типа.
Эта же функция могла выполнять все необходимые сложения и умножения, формируя тем самым своего рода шаблон идентичности. Таким образом, пропуская выходной сигнал через функцию, которая стала определяться как функция активации, именно чтобы отличать функцию выхода от внутреннего преобразования перцептрона, мы в итоге получали выходной сигнал, который можно было передавать новым перцептронам или показывать нам, людям.
В одной из будущих статей я покажу, как пришли к тому, что стало первоначальной идеей функции перцептрона, которая как раз и заключается в этой цепочке взвешенных сложений и умножений. Но к этому мы вернёмся позже, так как для этого нужно понять некоторые понятия, которые многим, возможно, будет неинтересно разбирать здесь и сейчас.
Итак, вернёмся к теме и рассмотрим перцептрон с более современной точки зрения. Для простоты пока сосредоточимся на одном перцептроне. Хотя в предыдущих статьях мы уже начали соединять перцептроны в цепочку, чтобы моделировать логические вентили, здесь цель — подвести вас к несколько более сложному моделированию.
По сути, перцептрон использует математическое выражение, которое мы рассмотрели в предыдущей статье. Его можно ещё раз увидеть ниже.
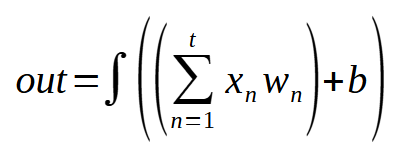
 //+------------------------------------------------------------------+
        inline double Perceptron(const double &inputs[])
        {
            double value = m_Infos.Bias;

            for (uint c = 0; c < m_Infos.nInputs; c++)
                value += (inputs[c] * m_Infos.Weight[c]);

            return fnActivation(true, value);
        }
//+------------------------------------------------------------------+
Этот фрагмент содержит практически всё, что на данный момент реализовано в классе C_Neuron, за единственным исключением: функция fnActivation, которая пока ещё не реализована окончательно. Помимо этой детали, ясно видно, что мы просто выполняем сложение и умножение. И всё.
В отличие от того, что могло показаться из предыдущей статьи, перцептрон — это не что иное, как последовательность простых сложений и умножений. Однако, как только мы зададим константы в математическом выражении, мы сможем получить результат, который может оказаться интересным. Эти константы, соответствующие значениям весов и смещения, настраиваются в процессе так называемого обучения. Таким образом, основная цель любой сети заключается именно в настройке этих констант, и именно в этом состоит назначение функции, которую мы называем перцептроном.
Итак, теперь, когда мы это поняли, мы можем рассмотреть функцию, которой пока не хватает в коде, а именно fnActivation, приведённую ниже.
//+------------------------------------------------------------------+
        inline double fnActivation(const bool isFx, const double value)
        {
            switch (m_Infos.Activate)
            {
                case Sigmoid:
                        return (isFx ? 1 / (1 + MathExp(-value)) : MathExp(-value) / MathPow(1 + MathExp(-value), 2));
                case Tangh:
                        return (isFx ? (2 / (1 + MathExp(-2 * value))) - 1 : (4 / MathPow(MathExp(-value) + MathExp(value), 2)));
                case ReLU:
                        return (isFx ? MathMax(0, value) : (value <= 0 ? 0 : 1));
                case eLU:
                        return (isFx ? (value <= 0 ? (m_Infos.Alpha * (MathExp(value) - 1)) : value) : (value <= 0 ? (m_Infos.Alpha * MathExp(value)) : 1));
                case SoftSign:
                        return (isFx ? value / (1 + MathAbs(value)) : value / MathPow(1 + MathAbs(value), 2));
                case SoftPlus:
                        return (isFx ? MathLog(1 + MathExp(value)) : 1 / (1 + MathExp(-value)));
                case Identity:
                default:
                        return (isFx ? value : 1);
            }
        }
//+------------------------------------------------------------------+
Теперь у нас сложилось общее представление о том, как устроен полный перцептрон и что он может делать. Это связано с тем, что представленные здесь функции активации — те же самые, что были приведены и прокомментированы в статье, где мы объяснили их с помощью графиков. Но обратите внимание на одно: хотя у нас есть все те функции, которые были показаны выше, вы можете заметить, что перцептрон не использует производные. Это связано с тем, что параметр isFx ни разу не принимает значение false. Тогда почему мы здесь берём производную? Итак, причина — в градиенте. Но прежде чем говорить об этом, я хочу, чтобы вы поняли одну вещь.
Функция активации в методе наименьших квадратов
Чтобы понять, как всё действительно работает, нам нужно рассмотреть это в самом простом виде. Поскольку наш класс C_Neuron уже содержит определённую функциональность, мы сосредоточим внимание на полном коде класса. Так будет проще объяснить и, главное, понять, что происходит. Сам код приведён ниже.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
//+------------------------------------------------------------------+
#define macroRandom (rand() / (double)SHORT_MAX)
//+------------------------------------------------------------------+
class C_Neuron
{
    protected:
//+------------------------------------------------------------------+
        enum eFnActivate {
                            Identity,
                            Sigmoid,
                            Tangh,
                            SoftSign,
                            ReLU,
                            eLU,
                            SoftPlus,
                        };
//+------------------------------------------------------------------+
    private:
//+------------------------------------------------------------------+
        struct  stInfos
        {
            bool    IsFx;
            uint    nInputs;
            double  Bias,
                    Weight[],
                    Alpha;
            eFnActivate Activate;
        }m_Infos;
//+------------------------------------------------------------------+
        struct stErr
        {
            double  weight[],
                    eMaxWeight,
                    bias;
        }m_Error;
//+------------------------------------------------------------------+
        inline double fnActivation(const bool isFx, const double value)
        {
            switch (m_Infos.Activate)
            {
                case Sigmoid:
                        return (isFx ? 1 / (1 + MathExp(-value)) : MathExp(-value) / MathPow(1 + MathExp(-value), 2));
                case Tangh:
                        return (isFx ? (2 / (1 + MathExp(-2 * value))) - 1 : (4 / MathPow(MathExp(-value) + MathExp(value), 2)));
                case ReLU:
                        return (isFx ? MathMax(0, value) : (value <= 0 ? 0 : 1));
                case eLU:
                        return (isFx ? (value <= 0 ? (m_Infos.Alpha * (MathExp(value) - 1)) : value) : (value <= 0 ? (m_Infos.Alpha * MathExp(value)) : 1));
                case SoftSign:
                        return (isFx ? value / (1 + MathAbs(value)) : value / MathPow(1 + MathAbs(value), 2));
                case SoftPlus:
                        return (isFx ? MathLog(1 + MathExp(value)) : 1 / (1 + MathExp(-value)));
                case Identity:
                default:
                        return (isFx ? value : 1);
            }
        }
//+------------------------------------------------------------------+
        inline double Cost_FX(const double &train[])
        {
            double x, err;

            err = 0;
            for (uint c0 = 0; c0 < train.Size(); c0++)
            {
                x = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x += (train[c0] * m_Infos.Weight[c1]);
                err += MathPow((x + m_Infos.Bias) - train[c0], 2);
            }

            return err;
        }
//+------------------------------------------------------------------+
        inline double Learning_FX(const double &train[], const double epsilon,  const double LearningRate, const ulong limit)
        {
            double  err,
                    memT,
                    err_w[];
            ulong   count;

            Print("Cost being calculated by the Minimum Square...");
            ArrayResize(err_w, m_Infos.nInputs);
            for (count = 0; (count < limit) && ((err = Cost_FX(train)) > epsilon); count++)
            {
                for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                {
                    memT = m_Infos.Weight[c];
                    m_Infos.Weight[c] += LearningRate;
                    err_w[c] = Cost_FX(train) - err;
                    m_Infos.Weight[c] = memT;
                }
                memT = m_Infos.Bias;
                m_Infos.Bias += LearningRate;
                m_Infos.Bias = memT - (Cost_FX(train) - err);
                for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                    m_Infos.Weight[c] -= err_w[c];
            }
            PrintFormat("Total interactions: %I64u", count);
            ArrayFree(err_w);

            return err;
        }
//+------------------------------------------------------------------+
        inline double Cost_DX(const double &train[])
        {
            double  x1, t;

            ZeroMemory(m_Error);
            for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0)
            {
                x1 = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x1 += (train[c0] * m_Infos.Weight[c1]);
                t = 2 * ((x1 + m_Infos.Bias) - train[c0]);
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++)
                {
                    m_Error.weight[c1] += (t * train[cw]);
                    m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) >  MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight);
                }
                m_Error.bias += t;
            }
            return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight);
        }
//+------------------------------------------------------------------+
        inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit)
        {
            ulong   count;
            double  eRet;

            Print("Cost being calculated by the Gradient...");
            for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++)
            {
                m_Infos.Bias -= (m_Error.bias * LearningRate);
                for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                    m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate);
            }
            PrintFormat("Total interactions: %I64u", count);

            return eRet;
        }
//+------------------------------------------------------------------+
    public :
//+------------------------------------------------------------------+
        C_Neuron(uint nInputs = 1, eFnActivate fn = Identity, bool isFx = false, double alpha = 0.75, double H = 1.0, double L = 0.0)
        {
            MathSrand(512);
            ZeroMemory(m_Infos);
            m_Infos.Activate = fn;
            m_Infos.IsFx = isFx;
            m_Infos.Alpha = alpha;
            m_Infos.Bias = (double)macroRandom;
            ArrayResize(m_Infos.Weight, m_Infos.nInputs = nInputs);
            ArrayResize(m_Error.weight, m_Infos.nInputs);
            for(uint c = 0; c < m_Infos.nInputs; c++)
                m_Infos.Weight[c] = ((double)macroRandom * (H - L)) + L;
        }
//+------------------------------------------------------------------+
        ~C_Neuron()
        {
            ArrayFree(m_Infos.Weight);
            ArrayFree(m_Error.weight);
        }
//+------------------------------------------------------------------+
        void View_Variables(void)
        {
            Print("Bias: ", m_Infos.Bias);
            for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                PrintFormat("Weight[%d]: %.16f", c, m_Infos.Weight[c]);
        }
//+------------------------------------------------------------------+
        inline double Learning(const double &train[], const double epsilon = 1e-3, const double LearningRate = 1e-2, const ulong limit = ULONG_MAX)
        {
           return (m_Infos.IsFx ? Learning_FX(train, epsilon, LearningRate, limit) : Learning_DX(train, epsilon, LearningRate, limit));
        }
 //+------------------------------------------------------------------+
        inline double Perceptron(const double &inputs[])
        {
            double value = m_Infos.Bias;

            for (uint c = 0; c < m_Infos.nInputs; c++)
                value += (inputs[c] * m_Infos.Weight[c]);

            return fnActivation(true, value);
        }
//+------------------------------------------------------------------+
};
//+------------------------------------------------------------------+
#undef macroRandom
//+------------------------------------------------------------------+
Я знаю, что показывать весь код может показаться ерундой, но я хочу вам кое-что продемонстрировать. В приложенном файле вы найдёте уже готовый код. Однако увидеть, как всё выглядело раньше, не менее важно, а в некоторых случаях даже важнее, чем увидеть итоговый код. Обратите на это внимание, чтобы понять, как его нужно будет изменить. Это поможет вам понять, почему впоследствии он будет вести себя именно так.
Здесь только перцептрон использует функцию активации. Ни функция потерь, использующая метод наименьших квадратов, ни функция, использующая градиент, здесь не вызываются.
А теперь внимание: прежде чем вносить изменения в этот класс C_Neuron, давайте создадим ещё один класс. Он позволит сократить объём кода во время тестирования, сосредоточив всё в одном заголовочном файле. Класс, который мы собираемся создать, полностью приведён ниже.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
//+------------------------------------------------------------------+
#include <Neural Network\C_Neuron.mqh>
//+------------------------------------------------------------------+
class C_Check_Neuron : private C_Neuron
{
//+------------------------------------------------------------------+
    private :
//+------------------------------------------------------------------+
    public  :
//+------------------------------------------------------------------+
        C_Check_Neuron(uint nInputs = 1, eFnActivate fn = Identity, bool isFx = false)
            :C_Neuron(nInputs, fn, isFx)
        {}
//+------------------------------------------------------------------+
        void View_Training_Data(const double &arr[], uint nColumns)
        {
            string sz0;
            uint nLines = arr.Size() / nColumns;

            Print("Training matrix.");
            Print("--------------------");
            for (uchar i = 0; i < nLines; i++)
            {
                sz0 = "";
                for (uchar j = 0; j < nColumns; j++)
                    sz0 += StringFormat("%f  ", arr[(i * nColumns) + j]);
                Print(sz0);
            }
            Print("--------------------");
        }
//+------------------------------------------------------------------+
        void Performs_Training(const double &arr[], double epsilon, double LearningRate, ulong limit)
        {
            ulong it0, it1;

            it0 = GetTickCount();
            Print("Margin of error achieved: ", Learning(arr, epsilon, LearningRate, limit));
            it1 = GetTickCount();
            Print("Total time(in Seconds): ", (it1 - it0) / 1000.0);
        }
//+------------------------------------------------------------------+
        void Check_Training(const double &arr[], uint nColumns)
        {
            string  sz0;
            double  mem[];
            uint    nLines = arr.Size() / nColumns;

            Print("********** RESULT *************");
            ArrayResize(mem, nColumns);
            for (uchar i = 0; i < nLines; i++)
            {
                sz0 = "";
                for (uchar j = 0; j < nColumns - 1; j++)
                    sz0 += StringFormat("%f  ", mem[j] = arr[(i * nColumns) + j]);
                sz0 += StringFormat("%f", Perceptron(mem));
                Print(sz0);
            }
            Print("--------------------");
            ArrayFree(mem);
            View_Variables();
        }
//+------------------------------------------------------------------+
};
//+------------------------------------------------------------------+
Этот класс C_Check_Neuron позволит нам выводить данные, запускать обучение и проверять результаты. Поскольку здесь содержится только самое необходимое, что нам понадобится позже, разобраться будет проще, не теряясь по ходу объяснения. Теперь давайте рассмотрим первый из кодов, которые мы будем использовать для проверки перцептрона. Код приведён ниже.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
#property script_show_inputs
#property description   "Script to compare execution speed\n" \
                        "Here we are using only the CPU.\n" \
                        "However, the results are still very interesting."
//+------------------------------------------------------------------+
#include <Neural Network\C_Check_Neuron.mqh>
//+------------------------------------------------------------------+
enum eFactorization {
                        Minimum_Square,
                        Gradient_Descent,
                    };
//+------------------------------------------------------------------+
input eFactorization        user00 = Minimum_Square;        //Тип вычисления
input double                user01 = 1e-3;                  //Целевая ошибка
input double                user02 = 1e-3;                  //Скорость обучения
input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Функция активации
//+------------------------------------------------------------------+
double Train[] {
                0, 0,
                1, 2,
                2, 4,
                3, 6,
                4, 8
               };
//+------------------------------------------------------------------+
#define nColumns    2
#define nLines      Train.Size() / nColumns
//+------------------------------------------------------------------+
void OnStart()
{
    C_Check_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");
    Print("************************************");
    Print("Parameters:");
    Print("Type of factorization: ", EnumToString(user00));
    Print("Estimated error: ", user01);
    Print("Learning Rate:", user02);
    Print("Activation function: ", EnumToString(user03));
    Print("************************************");


    neuron = new C_Check_Neuron(nColumns - 1, user03, user00 == Minimum_Square);

    (*neuron).View_Training_Data(Train, nColumns);
    (*neuron).Performs_Training(Train, user01, user02, ULONG_MAX);
    (*neuron).Check_Training(Train, nColumns);

    delete neuron;
}
//+------------------------------------------------------------------+
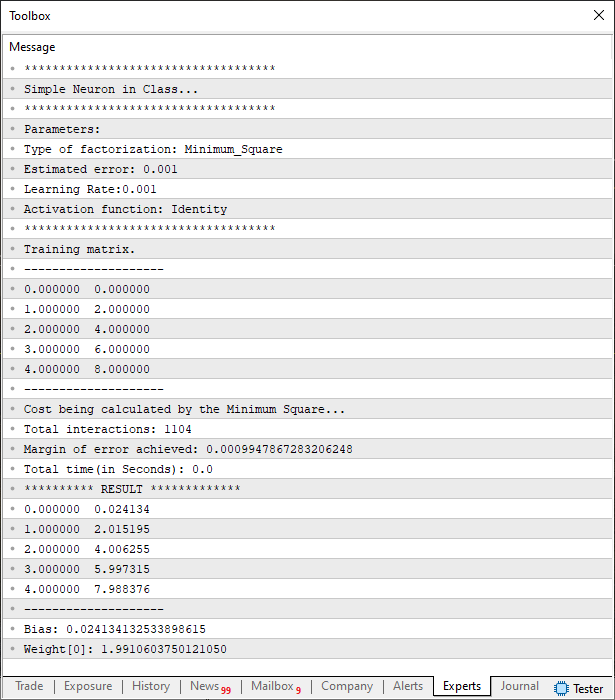
Поскольку большая часть сложности была перенесена внутрь класса C_Check_Neuron, приведённый выше код позволяет выполнять все тесты и одновременно выводить различные данные, необходимые для понимания того, что делает перцептрон. Настолько, что мы можем проанализировать, действительно ли произошла сходимость к точке, известной как точка минимума функции потерь. Если выполнить в точности приведённый выше код, вы увидите нечто похожее на то, что показано на следующем изображении.
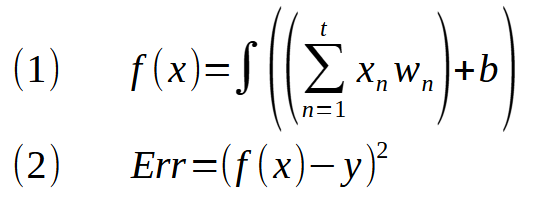
И здесь у нас есть функция активации, применённая к методу наименьших квадратов. Помните, что знак интеграла на самом деле обозначает функцию активации, включённую в выражение в качестве множителя. Теперь я хочу, чтобы вы сравнили это выражение (1) с выражением перцептрона. Обратите внимание, что они идентичны. Тогда вы, наверное, спросите: «Как это возможно?» Есть ли какая-то особая причина, по которой это происходит? Да, мой друг. Система, основанная на сетях перцептронов, была разработана в первую очередь для решения задач линейной регрессии и по-прежнему ориентирована именно на это. Если вы не знаете, о чём я говорю, ознакомьтесь с моими первыми статьями на эту тему.
Там я объяснил, как возникла эта идея. Но речь здесь идёт не об уравнении (1), а об уравнении (2). Выражение (1) представляет собой FORWARD PROPAGATION (прямое распространение). В свою очередь, выражение (2) как раз соответствует BACK PROPAGATION (обратному распространению), которое будет применяться к перцептрону. Обратите внимание, что здесь нет большой разницы по сравнению с тем, что было показано ранее. Однако, если вы посмотрите на код, особенно на то, как я его пишу, может сложиться впечатление, что всё работает иначе, чем я показываю в математических выражениях. По этой причине я привожу эти выражения, чтобы вы могли правильно понять, откуда берётся каждый фрагмент кода. Теперь, перенося это в код, мы добавляем следующий фрагмент в код класса C_Neuron.
//+------------------------------------------------------------------+
        inline double Cost_FX(const double &train[])
        {
            double x, err;

            err = 0;
            for (uint c0 = 0; c0 < train.Size(); c0++)
            {
                x = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x += (train[c0] * m_Infos.Weight[c1]);
                err += MathPow(fnActivation(true, x + m_Infos.Bias) - train[c0], 2);
            }

            return err;
        }
//+------------------------------------------------------------------+
Разница очень тонкая, поэтому нужно быть внимательным, чтобы уловить момент, когда начинается вызов функции активации. Действительно, если снова запустить тестовый код, вы увидите изображение, показанное ниже.
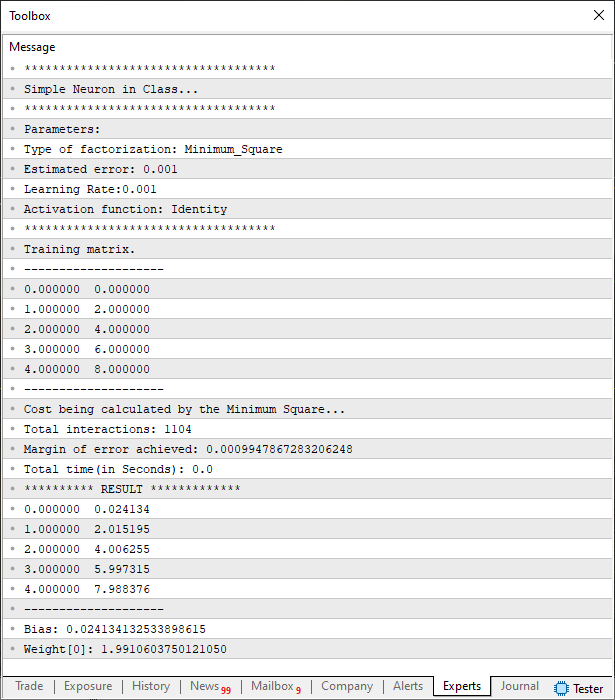
Это похоже на повторение того, что делалось раньше, но на самом деле это не так: это разные моменты выполнения одного и того же кода. Один раз — с функцией активации, а другой — без неё. Но обратите ещё больше внимания на то, что мы используем тождественную функцию активации. Это связано с тем, что в данном случае мы действительно работаем с линейной регрессией. Использовать какую-либо другую функцию активации не имело бы никакого смысла.
Хорошо, но может ли этот же перцептрон обрабатывать другое число входов? В этом легко убедиться. Для этого мы воспользуемся приведённым ниже кодом.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
#property script_show_inputs
#property description   "Script to compare execution speed\n" \
                        "Here we are using only the CPU.\n" \
                        "However, the results are still very interesting."
//+------------------------------------------------------------------+
#include <Neural Network\C_Check_Neuron.mqh>
//+------------------------------------------------------------------+
enum eFactorization {
                        Minimum_Square,
                        Gradient_Descent,
                    };
//+------------------------------------------------------------------+
input eFactorization        user00 = Minimum_Square;        //Тип вычисления
input double                user01 = 1e-3;                  //Целевая ошибка
input double                user02 = 1e-3;                  //Скорость обучения
input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Функция активации
//+------------------------------------------------------------------+
//Выражение для обучения: f(x) = (w0 * 1.8) + (w1 * 2.15) + 2.1
//+------------------------------------------------------------------+
double Train[] {
                  1,    3,  10.35,
                1.5,  3.25, 11.7875,
                1.75, 3.94, 13.721,
                2.85, 3.46, 14.669
               };
//+------------------------------------------------------------------+
#define nColumns    3
#define nLines      Train.Size() / nColumns
//+------------------------------------------------------------------+
void OnStart()
{
    C_Check_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");
    Print("************************************");
    Print("Parameters:");
    Print("Type of factorization: ", EnumToString(user00));
    Print("Estimated error: ", user01);
    Print("Learning Rate:", user02);
    Print("Activation function: ", EnumToString(user03));
    Print("************************************");


    neuron = new C_Check_Neuron(nColumns - 1, user03, user00 == Minimum_Square);

    (*neuron).View_Training_Data(Train, nColumns);
    (*neuron).Performs_Training(Train, user01, user02, ULONG_MAX);
    (*neuron).Check_Training(Train, nColumns);

    delete neuron;
}
//+------------------------------------------------------------------+
При выполнении этого кода в терминале отобразится следующий результат.
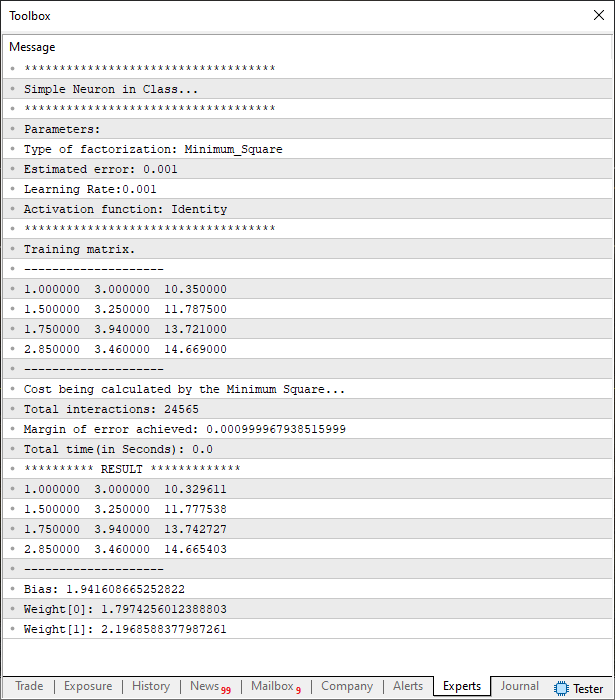
Не знаю, хорошо ли вы следите за ходом рассуждений. Но обратите внимание, что между этим и предыдущим кодом, оба из которых предназначены для тестирования перцептрона, потребовалось внести лишь несколько изменений. В частности, изменения были внесены в определение, указывающее, сколько столбцов у нас в обучающем массиве, а также в данные, используемые при обучении. Поэтому, если вы хотите использовать совершенно другие данные, у вас не возникнет трудностей при экспериментах с этим перцептроном. Однако, как уже упоминалось, мы должны принять некоторые меры предосторожности. Пожалуй, самое важное — это значение, указанное в поле скорости обучения.
Не следует использовать слишком высокие значения, так как это в конечном итоге немного сводит перцептрон с ума. Не следует также использовать слишком малые значения, поскольку в этом случае перцептрону потребуется много времени, чтобы сойтись и снизить ошибку ниже значения, заданного в качестве целевого. Иными словами, ключ к успеху — умеренность.
Когда я говорю, что перцептрон немного сходит с ума, я имею в виду математический эффект. Дело не в том, что в программе есть какая-то ошибка, из-за которой она попадает в слишком длинный цикл, а в математической проблеме, связанной со сходимостью значений. Чтобы это понять, посмотрите на следующее изображение.
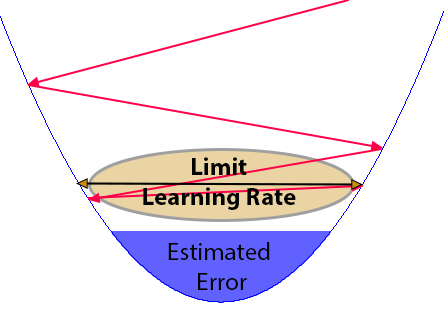
Это изображение, которое на первый взгляд может показаться непонятным, как раз и показывает проблему использования неподходящего значения скорости обучения. Обычно я предпочитаю задавать это значение так, чтобы оно было равно целевой ошибке или немного меньше неё, именно для того, чтобы избежать ситуации, показанной на предыдущем изображении.
По мере того, как перцептрон сходится, чтобы достичь целевой ошибки, как показано красными линиями, в какой-то момент он может попасть в долину, расстояние между склонами которой будет очень близко к значению скорости обучения. Несмотря на то что значение целевой ошибки определено правильно, расстояние между склонами долины приводит к тому, что перцептрон перестаёт сходиться, в результате чего он не достигает ранее заданной ошибки и процесс никогда не завершается. Это происходит потому, что скорость обучения может заставить перцептрон метаться из стороны в сторону, не позволяя ему даже продолжать спуск. Возможно, это худший сценарий, с которым мы можем столкнуться, поскольку у вас может сложиться впечатление, что приложение зависло. Отсюда и необходимость в каком-то механизме, который позволил бы выйти из столь неприятной ситуации.
Один из используемых механизмов заключается в настройке максимального числа взаимодействий с обучающими данными. Лично я предпочитаю оставлять его равным ULONG_MAX. Однако это может привести к тому, что обучение займёт слишком много времени. Поэтому при настройке скорости обучения следует учитывать целевую ошибку и, возможно, даже максимальное количество взаимодействий перцептрона с обучающими данными. Эти настройки можно выполнить без необходимости что-либо изменять в приведённом здесь коде; достаточно лишь настроить код конечного приложения.
Если всё это показалось вам интересным и вы смогли понять, как используется функция активации, когда мы выбираем метод наименьших квадратов, то пришло время рассмотреть нечто ещё более интересное. Теперь посмотрим, что происходит, когда мы выбираем градиент. Но, чтобы разделить эти две темы, давайте рассмотрим это в новом разделе.
Функция активации в градиенте
Теперь будет гораздо интереснее. То, что мы рассмотрели в предыдущей теме, — просто детские игрушки. Но то, что мы здесь увидим, можно резюмировать так: вот теперь-то всё и начнётся. Вот тут дети и начинают плакать, потому что не знают, как выбраться из затруднительного положения, и ждут, когда придёт взрослый и спасёт их.
Шутки в сторону: применить функцию активации к градиенту не так просто, как применить её к функции потерь при методе наименьших квадратов. Это объясняется именно тем, что градиент является производной функции наименьших квадратов. Однако есть одна деталь, и именно из-за неё многие путаются, когда пытаются понять градиент. Особенно когда они исходят из ошибочного представления, не разобравшись предварительно в том, как работает метод наименьших квадратов.
В отличие от метода наименьших квадратов, выражения которого практически совпадают с тем, что мы видели в перцептроне, в случае градиента у нас есть два выражения. Одно — для выходных данных, а другое — для обратного распространения. Поэтому многие в итоге путаются. Но нет причин тревожиться или впадать в панику. Постарайтесь понять то, что я сейчас объясню. Вы увидите, что на практике всё гораздо проще, чем кажется. В предыдущей статье я привёл следующее выражение:
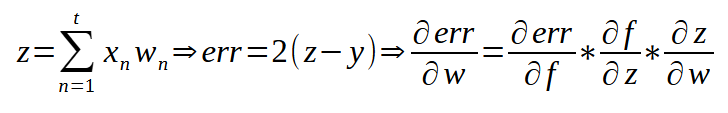
То есть ошибка — это, по сути, набор производных, когда наша цель — использовать градиент. Таким образом, чтобы начать корректировать ошибку, нам нужно лишь умножить величину градиента на производную функции активации. Вот так просто. В следующем фрагменте вы можете увидеть, как это применяется в коде.
//+------------------------------------------------------------------+
        inline double Cost_DX(const double &train[])
        {
            double  x1, t;

            ZeroMemory(m_Error);
            for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0)
            {
                x1 = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x1 += (train[c0] * m_Infos.Weight[c1]);
                t = 2 * ((x1 + m_Infos.Bias) - train[c0]) * fnActivation(false, x1 + m_Infos.Bias);
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++)
                {
                    m_Error.weight[c1] += (t * train[cw]);
                    m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) >  MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight);
                }
                m_Error.bias += t;
            }
            return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight);
        }
//+------------------------------------------------------------------+
"Но это всё?". Да, уважаемый читатель, это всё, что нам нужно сделать. Теперь у нас есть перцептрон, который использует градиент и также способен использовать метод наименьших квадратов. В общих чертах можно сказать, что перцептрон завершён. То есть у нас есть входы, функция потерь, функция активации, обратное распространение и выход. Всё это уже реализовано в нашем перцептроне с помощью класса C_Neuron. Всё это излишнее усложнение, которым многие окружают эту тему, лишь заставляет её казаться сложнее, чем она есть на самом деле.
Итоги
Возможно, вы всё ещё несколько скептически относитесь к тому, действительно ли нам нужно использовать производную функции активации, когда мы используем градиент. Чтобы понять, почему она необходима, нам придётся обратиться к математическим аспектам. Поэтому остальная часть этой статьи будет посвящена объяснению того, как мы пришли к этому выводу и почему нам нужно использовать производные. Если хотите, можете пропустить остальную часть статьи. Но я уверяю вас, что это будет хорошим повторением всего, что мы прошли до сих пор. И это поможет вам понять следующие шаги.
Хорошо, первое, что нам нужно сделать, — это немного вернуться назад и снова обратиться к истокам градиента. Я уже объяснял это ранее, но здесь мы закрепим пройденное и немного углубимся в тему. Всё начинается с аффинной функции. Её выражение показано на следующем изображении.

<a> — это наклон, а <b> — точка пересечения. Значение <x>, в свою очередь, является входным значением. И <a>, и <b> являются константами. Это выражение, записанное в виде многочлена, даёт другое, очень похожее выражение. И, при работе с полученным полиномиальным выражением, мы получаем то, что называется линейной регрессией. Дело в том, что зачастую используемые значения не лежат точно на прямой, определяемой аффинной функцией. Эта разница между целевым значением и значением, полученным с помощью аффинной функции, называется ошибкой. Итак, проявив немного математической изобретательности, мы можем создать несколько функций, которые будут стремиться свести эту ошибку к нулю. Это приводит нас к следующему выражению.
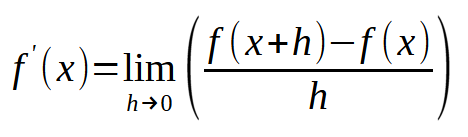
Данное выражение служит общей основой для построения линейной регрессии, когда у нас есть набор данных с различными значениями и мы хотим, чтобы полученная аффинная функция имела как можно меньшую ошибку. Для этого мы делаем так, чтобы значение <h> стремилось к нулю. Однако здесь есть одна деталь. Данное выражение не позволяет нам скорректировать значения <a> и <b> аффинной функции на основе возникающей ошибки. Для этого мы выполняем несколько математических преобразований и получаем следующее выражение.
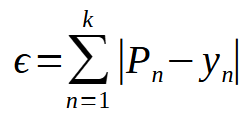
Вот исходное выражение для вычисления ошибки. Величина <P> — это величина, которую мы вычисляем на основе аффинной функции. В свою очередь, <y> — это оценённое значение или ожидаемый результат. Обратите внимание, что мы используем абсолютное значение. Это не даёт отрицательным значениям взаимно компенсироваться с положительными, создавая тем самым ложное впечатление, что значения <a> и <b> верны, хотя на самом деле они по-прежнему ошибочны. Однако приведённое выше выражение не позволяет нам достаточно быстро приближаться к минимально возможной ошибке. Чтобы этого добиться, мы заменяем абсолютное значение второй степенью, в результате чего получаем следующее выражение.
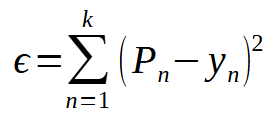
Обратите внимание, что оно практически совпадает с предыдущим выражением. Однако использование степени вместо абсолютного значения приводит к тому, что график этой ошибки меняется с такого:
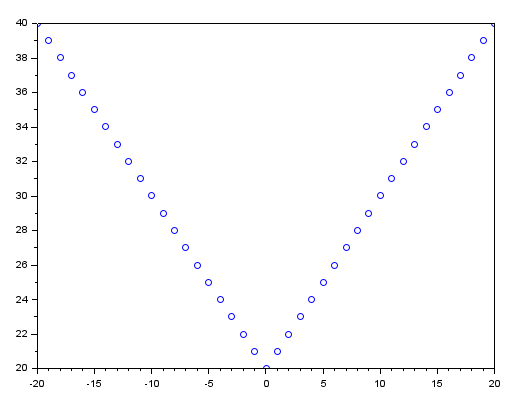
На такой:
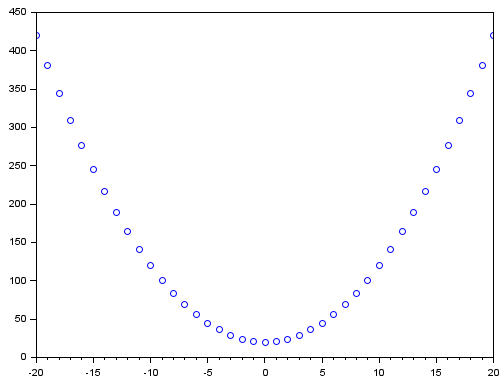
Хотя это может быть и неочевидно, разница в скорости уменьшения оказывается очень существенной. Настолько, что, если вы возьмёте ещё большую степень, то увидите, что скорость возрастёт ещё сильнее. Нужно лишь следить за тем, чтобы использовать чётные степени, поскольку нечётные степени могут давать на выходе отрицательные значения. И это возвращает нас к проблеме невозможности сложить положительные и отрицательные значения в итоговой ошибке.
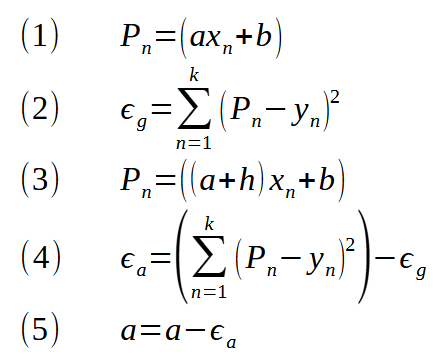
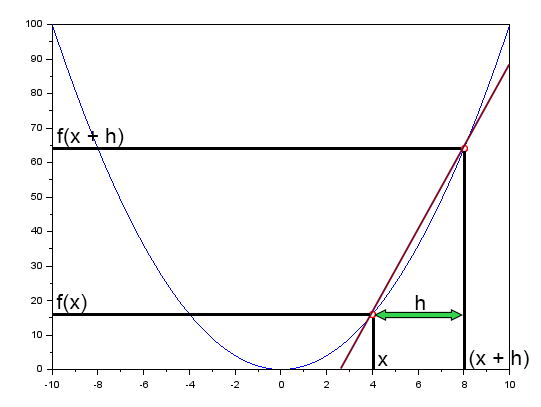
Эта красная прямая не является касательной; это секущая, и по мере того как h приближается к нулю, эта же прямая стремится стать касательной, когда <h> будет равно нулю. Итак, откуда же берётся идея касательной прямой? Именно из градиента, а не из чего-то другого. Но не волнуйтесь: если вы только что к нам присоединились, вы увидите, как это происходит. Возвращаясь к теме, приведённое выше выражение задаёт прямую, представляющую линейную регрессию; поэтому мы не можем представить другие типы распределения данных. Отсюда и возникает необходимость использовать так называемую функцию активации. Это станет понятнее позже. Пока что вам достаточно понять, что без функции активации мы бы строили линейную регрессию, а это весьма ограничивает возможности.
Однако по мере увеличения количества входов также очень быстро растёт число попыток, за которые нам нужно выполнить шаги с третьего по пятый. Чтобы решить эту задачу, мы берём выражение метода наименьших квадратов и дифференцируем его, получая таким образом новое выражение. Это выражение приведено ниже.
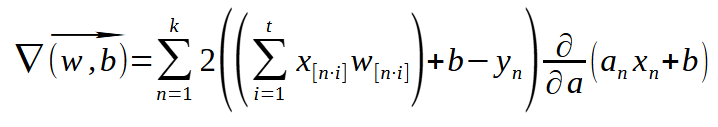
Я знаю, что предыдущее выражение может показаться пугающим. Но оно представляет собой совокупность всех действий, направленных на определение значения, необходимого для исправления ошибки. Как вы можете заметить, градиент — это, по сути, вектор. Этот вектор ортогонален касательной в заданной точке кривой. В отличие от того, что мы использовали раньше, этот градиент уже может использовать касательную прямую для поиска минимального значения ошибки. Таким образом, поскольку мы дифференцируем выражение метода наименьших квадратов, а в это выражение включена функция активации, при вычислении значения градиента нам также придётся дифференцировать функцию активации. По этой причине мы используем производные функций активации. Но только на этапе обратного распространения, поскольку на этом этапе мы пытаемся сделать так, чтобы выход перцептрона рассматривался как вход.
И последнее замечание. Возможно, вы заметили, что здесь я использовал не привычные значения <w> и <b>, а <a> и <b>. Я сделал это намеренно, чтобы показать, что в конечном счёте всё сводится к исходному выражению — аффинной функции, подвергнутой лишь ряду преобразований, пока она не превратится в градиентную форму.
Заключительные замечания
В этой статье вы узнали, как и почему перцептрон постепенно перестал использовать метод наименьших квадратов для корректировки ошибки своих внутренних констант и стал использовать для этого градиент. Мы сделали это посредством относительно плавного и простого перехода, в ходе которого вы начали понимать, что перцептрон — это не что иное, как набор математических функций и выражений, цель которых — позволить нам построить линейную регрессию, наилучшим образом подходящую для данной базы данных.
Поэтому внимательно изучите код в приложенном файле, так как это поможет вам понять, что мы будем делать в следующих статьях. Мы подходим к решающему моменту, когда вы начнёте замечать, что при обучении системы перцептронов необходимо учитывать определённые детали.
| Файл MQ5 | Описание |
|---|---|
| Скрипты\Пример A | Базовая демонстрация |
| Скрипты\Пример B | Базовая демонстрация |
Перевод с португальского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/pt/articles/13884
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Нейросети в трейдинге: Диффузионная генерация торговых планов (Вычислительная основа)
 Адаптивный индикатор Malaysian Engulfing (Часть 2): Оптимизированный диапазон баров ретеста

 Нейронная сеть на практике: Градиент

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования