

Нейронная сеть на практике: Когда использовать искусственный нейрон и как он работает в MQL5
 49
 0

Введение
В предыдущей статье «Нейронная сеть на практике: стохастический градиентный спуск» мы внесли изменения, чтобы создать небольшой нейрон, использующий градиентный спуск. В него были внесены некоторые изменения, цель которых состояла в том, чтобы облегчить объяснение некоторых аспектов работы нейрона. Основная цель заключалась в том, чтобы прояснить понятие, которое вызывает много путаницы и о котором часто говорят, не понимая его сути. Теперь мы начнём понимать, почему в одних случаях функции активации необходимы, а в других — нет. Мы также увидим, почему нейронная сеть не всегда является лучшим выбором. Но, прежде всего, мы поймём, почему существуют разные архитектуры нейронных сетей и как правильно определить размер и конфигурацию нейронной сети. И, конечно же, в следующих статьях мы рассмотрим и другие вопросы.
Я понимаю, что это введение может показаться довольно интересным и в то же время несколько амбициозным для одной статьи. Объяснить столько всего в одной статье было бы непрактично, так как она получилась бы слишком большой. Давайте же разберёмся, почему, после того как ранее было показано так много, только сейчас я говорю, что мы начнём анализировать эти детали, связанные с нейронными сетями. Причина проста: раньше нужно было изложить целый ряд понятий, чтобы вы, мой дорогой читатель, наконец смогли понять, о чём на самом деле пойдёт речь.
По сути, я бы сказал, что это и есть статья ноль — точка, с которой мы действительно начнём серьёзно говорить на эту тему. Это связано с тем, что к этому моменту, если вы прочитали предыдущие статьи, опробовали приведённый в них код, попытались изменить обучающую выборку или сравнили первые статьи с последними, то, вероятно, уже уловили логику того, что я объясню далее.
Если вы сразу перешли к этой статье, не знакомы с нейронными сетями и у вас много вопросов по этой теме, я рекомендую вам сначала ознакомиться с предыдущими статьями, чтобы понять то, что будет объясняться дальше. Итак, можем начинать.
Мне действительно нужно строить нейрон?
Судя по тому, о чём уже некоторое время говорят СМИ, инфлюенсеры и т. д., создаётся впечатление, что нам не обойтись без нейронных сетей. Как будто это восьмое чудо современного мира. На самом деле всё не совсем так. Изучение нейронных сетей, как вы, наверное, заметили из предыдущих статей, представляет собой довольно интересную область исследований. Однако в целом у них есть ограничения, и они могут давать сбои. Они не справляются с определёнными типами задач и не так универсальны, как утверждают многие.
Во многих случаях программа, разработанная для решения конкретной задачи, будет значительно эффективнее любой нейронной сети, которую мы сможем построить. Это обусловлено рядом факторов. Если вы, мой дорогой читатель, решите использовать нейронную сеть для какой-либо задачи, вам придётся обучить её, чтобы она могла её выполнять. Кроме того, может случиться так, что она даже не сможет интерпретировать данные, с помощью которых вы пытаетесь её обучить.
До сих пор я не упоминал об этом. Хотя это не всегда необходимо, в большинстве случаев вам придётся нормализовать значения, которые будет использовать нейронная сеть. Позже мы разберёмся почему, но вам стоит помнить об этом. Иногда вам придётся нормализовать входные значения или привести их к определённому диапазону. Если этого не сделать, нейронная сеть не сможет достичь сходимости и сформировать адекватное представление обучающих данных.
Даже если вам удастся заставить нейронную сеть работать, вам придётся учитывать ещё один аспект: вычислительные затраты. Объяснить этот вопрос нелегко, поскольку здесь играют роль несколько аспектов, которые я пока ещё не объяснял в этих статьях. Тем не менее, исходя из того, что мы уже рассмотрели, можно выделить несколько факторов, которые помогут вам, мой дорогой читатель, понять, почему нейронная сеть не всегда является лучшим выбором.
Чтобы убедиться в этом, давайте проведём следующий тест. Возьмём нейрон из предыдущей статьи и подадим ему некоторые данные, которые мы использовали в начале этой серии. Новый код нейрона будет выглядеть так:
001. //+------------------------------------------------------------------+
002. #property copyright "Daniel Jose"
003. //+------------------------------------------------------------------+
004. #include <Canvas\Canvas.mqh>
005. //+------------------------------------------------------------------+
006. #define PrintEx(A)  Print(#A, " => ", A)
007. #define macroRandom (rand() / (double)SHORT_MAX)
008. #define _SizeLine   300
009. #define nColuns     2
010. //+------------------------------------------------------------------+
011. CCanvas canvas;
012. //+------------------------------------------------------------------+
013. double Train[][nColuns] {
014.                             {-100, -150},
015.                             { -80,  -50},
016.                             {  30,   80},
017.                             { 100,  120},
018.                   };
019. //+------------------------------------------------------------------+
020. const double epsilon = 1e-3;
021. //+------------------------------------------------------------------+
022. struct stErr
023. {
024.     double  Weight,
025.             Bias;
026. };
027. //+------------------------------------------------------------------+
028. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = Train.Size() / nColuns)
029. {
030.     double x, y, t;
031.     stErr err;
032.
033.     ZeroMemory(err);
034.     for (uint c = p1; c < p2; c++)
035.     {
036.         x = Train[c][0];
037.         y = Train[c][1];
038.         t = 2 * ((x * w + b) - y);
039.         err.Weight += (t * x);
040.         err.Bias += t;
041.     }
042.
043.     return err;
044. }
045. //+------------------------------------------------------------------+
046. void PlotText(const int x, const int y, const uchar line, const string sz0)
047. {
048.     uint w, h;
049.
050.     TextGetSize(sz0, w, h);
051.     canvas.TextOut(x - (w / 2), y + _SizeLine + (line * h) + 5, sz0, ColorToARGB(clrBlack));
052. }
053. //+------------------------------------------------------------------+
054. inline double CallZoom(void)
055. {
056.     double d1 = 0;
057.
058.     for (uint c = 0; c < Train.Size() / nColuns; c++)
059.     {
060.         d1 = MathMax(d1, MathAbs(Train[c][0]));
061.         d1 = MathMax(d1, MathAbs(Train[c][1]));
062.     }
063.
064.     return _SizeLine / d1;
065. }
066. //+------------------------------------------------------------------+
067. void Plot_Train2D(const int x, const int y, const double weight, double bias)
068. {
069.     int vx, vy;
070.     double zoom;
071.     uint n = Train.Size() / nColuns;
072.
073.     zoom = CallZoom();
074.     canvas.LineVertical(x, y - _SizeLine, y + _SizeLine, ColorToARGB(clrRoyalBlue, 255));
075.     canvas.LineHorizontal(x - _SizeLine, x + _SizeLine, y, ColorToARGB(clrRoyalBlue, 255));
076.     for (uint c = 0; c < n; c++)
077.     {
078.         vx = (int)(Train[c][0] * zoom);
079.         vy = (int)(Train[c][1] * zoom);
080.        canvas.FillCircle(x + vx, y - vy, 5, ColorToARGB(clrRed, 255));
081.     }
082.     canvas.LineAA(
083.                 x + (int)(Train[0][0] * zoom),
084.                 y - (int)((Train[0][0] * weight + bias) * zoom),
085.                 x + (int)(Train[n - 1][0] * zoom),
086.                 y - (int)((Train[n - 1][0] * weight + bias) * zoom),
087.                 ColorToARGB(clrForestGreen));
088.     PlotText(x, y, 1, StringFormat("Zoom: %.2fx", zoom));
089.     PlotText(x, y, 2, StringFormat("f(x) = %.4fx %c %.4f", weight, (bias < 0 ? '-' : '+'), MathAbs(bias)));
090. }
091. //+------------------------------------------------------------------+
092. void OnStart()
093. {
094.     double weight, bias;
095.     int    x, y;
096.     ulong  it0, it1, count;
097.     stErr  err;
098.
099.     Print("************************************");
100.     Print("Stochastic Gradient Descent Neuron...");
101.     Print("************************************");
102.     MathSrand(512);
103.     weight = (double)macroRandom;
104.     bias = (double)macroRandom;
105.
106.     it0 = GetTickCount();
107.     for(count = 0; count < 5; count++)
108.     {
109.         err = Cost(weight, bias);
110.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
111.             break;
112.         weight -= (err.Weight * epsilon);
113.         bias -= (err.Bias * epsilon);
114.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
115.     }
116.     it1 = GetTickCount();
117.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
118.     PrintEx(count);
119.     PrintEx(weight);
120.     PrintEx(bias);
121.     PrintEx(err.Weight);
122.     PrintEx(err.Bias);
123.     Print("Press ESC to close....");
124.     Print("************************************");
125.
126.    x = (int)ChartGetInteger(0, CHART_WIDTH_IN_PIXELS, 0);
127.    y = (int)ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS, 0);
128.    canvas.CreateBitmapLabel("BL", 0, 0, x, y, COLOR_FORMAT_ARGB_NORMALIZE);
129.    canvas.Erase(ColorToARGB(clrWhite, 255));
130.     x /= 2;
131.     y /= 2;
132.
133.     Plot_Train2D(x, y, weight, bias);
134.
135.    canvas.Update(true);
136.
137.     while(!IsStopped())
138.         if (TerminalInfoInteger(TERMINAL_KEYSTATE_ESCAPE) !=0)
139.             break;
140.
141.     canvas.Destroy();
142. }
143. //+------------------------------------------------------------------+
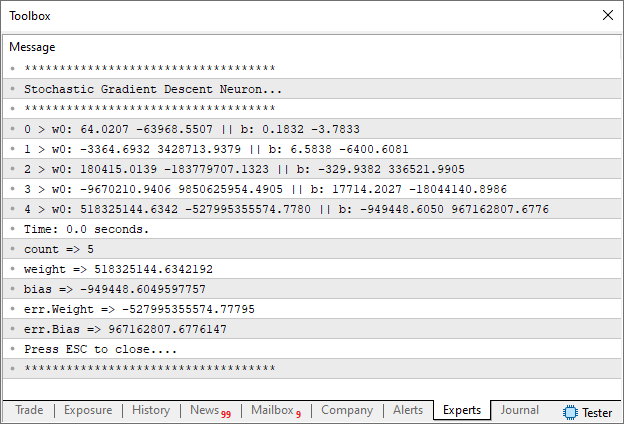
Скомпилировав и запустив этот код, вы увидите в терминале следующее:
На графике, где вы запустите скрипт, вы увидите такое изображение:
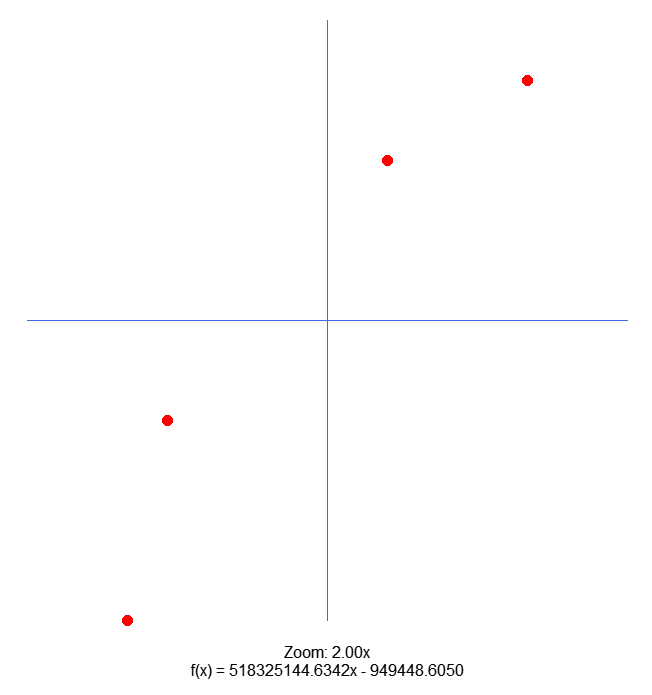
Что ж, возможно, сейчас вы задаётесь вопросом: «Что здесь произошло? Я абсолютно ничего не понимаю». Что ж, мой дорогой читатель, ни вы не понимаете, что произошло, ни искусственный нейрон не может интерпретировать данные: нейрону не удалось сойтись к решению. Возможно, вы подумаете: «Постойте-ка, вы жульничаете. Это наверняка какой-то подвох. Как так получилось, что нейрон не смог интерпретировать обучающие данные?». И вы правы, что ставите это под сомнение. Мы не должны верить во что-то только потому, что кто-то нам это показал или рассказал. Мы должны сами это проверить, чтобы убедиться, что это правда, хотя всегда следует сохранять осторожность. Итак, давайте разберёмся, что произошло, чтобы появились результаты, показанные на предыдущих изображениях.
Для начала давайте рассмотрим код. Обратите внимание, что в строке 13 я изменил обучающие значения. Позже я вернусь к этому вопросу. Перейдём теперь к следующему изменению: в строке 107 мы уменьшили количество итераций цикла for с ULONG_MAX до пяти. Это было разумное решение, как и добавление строки 114, чтобы проверить, что нейрон делает внутри. И, как бы некоторые ни утверждали обратное, НЕТ, НИКОГДА НЕ СЛЕДУЕТ ПОЗВОЛЯТЬ КОДУ ГЕНЕРИРОВАТЬ РЕЗУЛЬТАТЫ, НЕ ПОНИМАЯ, ЧТО ИМЕННО ОН ГЕНЕРИРУЕТ. Некоторое время назад я слышал, как кто-то сказал, что скоро мы уже не будем понимать, чему учится сеть. Это самая большая чепуха, которую я когда-либо слышал. Без сомнения, этот человек не программист: он лишь набирает код.
Но вернёмся к теме. Мы ограничили цикл всего пятью итерациями, чтобы проверить, начнёт ли нейрон сходиться к решению. Если посмотреть на результаты, становится ясно, что этого не произойдёт. Фактически, значения ошибки растут экспоненциально, что свидетельствует о том, что нейрон не понимает, что он делает и что ему следует делать с данными. Помните, что это были единственные изменения в коде. Вы можете взять код, приложенный к предыдущей статье, и попробовать его. Вы увидите, что исходный вариант находит решение, но после внесения этих изменений нейрон теряется сильнее, чем таракан после удара тапком. Почему это произошло? Разве эти данные не имеют смысла? Давайте посмотрим, откуда взялись эти обучающие данные.
Если вы обратитесь к статье «Нейронная сеть на практике: метод наименьших квадратов», то увидите, что в ней используются именно эти данные. Там, как и в других статьях, в которых мы не использовали нейроны, нам удавалось найти решение. Здесь же нейрон не справляется. Прежде чем объяснить почему, давайте рассмотрим уравнение, полученное другими методами:

Вам не нужно верить мне на слово — вы можете это проверить. В двух статьях я показал, как использовать псевдообратную матрицу; вторая из них — «Нейронная сеть на практике: псевдообратная матрица (II)». Вы можете проверить это сами и убедитесь, что это работает. Так в чём же здесь проблема? Столкнулись ли мы с той же проблемой, что и при использовании нейрона для представления логических элементов? Или это случай, похожий на ситуацию с элементом XOR? Речь не идёт ни о том, ни о другом. Чтобы прояснить это, перейдём к новой теме.
Суть искусственного нейрона
С тех пор как мы начали разбирать устройство нейрона, я показывал, как он работает и почему делает именно то, что делает. Если вы всё ещё этого не понимаете, спокойно перечитайте предыдущие статьи, потому что здесь мы углубимся в тему немного подробнее.
Я повторю то, о чём уже говорил: ОБУЧЕНИЕ ЛЮБОГО НЕЙРОНА ОСНОВАНО НА СЕКУЩЕЙ. Многие любят говорить о касательной прямой, когда речь заходит о машинном обучении. Но, на мой взгляд, тут возможны только два варианта: либо они путают понятия, либо не знают, о чём говорят. Исходный нейрон, от которого произошли все остальные, был построен на основе следующей функции:

Эта функция как раз и представляет собой функцию потерь. Независимо от используемого метода всё сводится именно к ней. Однако она представляет не касательную, а секущую. Если помнить об этом и вспомнить, что прямая может быть выражена следующим уравнением:

Мы можем начать понимать, почему нейронная сеть или даже отдельный нейрон устроены именно так. Возможно, некоторые подумают: «Этот парень не знает, о чём говорит. Конечно, нейрон не мог интерпретировать обучающие данные: ему не хватает функции активации, чтобы научиться их представлять. Кроме того, он не входит ни в какую сеть и не использует обратное распространение». Что ж, если вы так подумали или задали себе этот вопрос, то я, при всём уважении, советую вам прекратить читать эту статью и любые другие мои материалы на эту тему. Ни один из них не принесёт вам пользы, если у вас уже сложилось предвзятое мнение по этому поводу. До скорого и всего наилучшего.
Ну что ж, продолжим. Цель любого нейрона — провести секущую со значением h, как можно более близким к нулю. Это значение h и есть ошибка, которую мы считаем допустимой. В моих программах это же значение ошибки также используется в качестве скорости обучения: оно определяет, какую долю ошибки нейрон будет использовать для вычисления следующего шага и попытки её уменьшить. В нейроне, использующем линейную регрессию или производную от неё функцию, угловой коэффициент уравнения считается весом, а значение, в котором прямая пересекает вертикальную ось, — сдвигом. Если вы ищете изображение нейрона, то, как правило, найдёте что-то похожее на следующий рисунок.
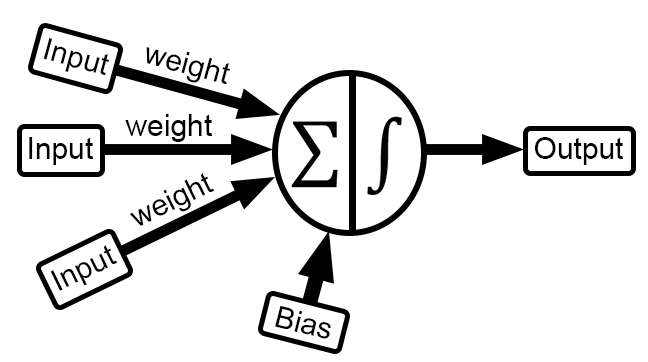
Но что представляет собой эта картинка? Для одних — нечто магическое; для других — краткое изложение того, что нужно реализовать; а для третьих — абсолютно ничего. Давайте посмотрим, что мы реализовали в нашем коде. Для этого нам нужно изменить предыдущее изображение так, чтобы получить следующее.
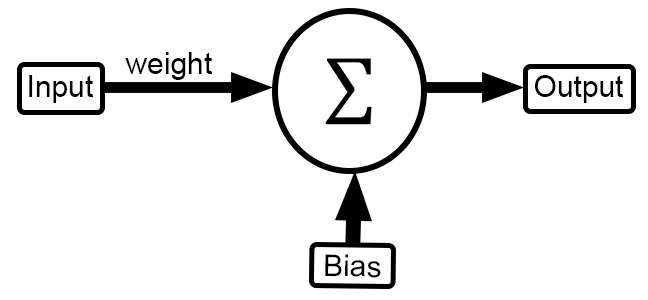
Ну да, оно довольно похоже на предыдущее изображение. Но как мы можем понять, действительно ли это сходство реально или здесь кроется какой-то подвох? Чтобы это проверить, нужно изучить код и, в частности, то, что происходит в следующем фрагменте.
                                   .
                                   .
                                   .
012. //+------------------------------------------------------------------+
013. double Train[][nColuns] {
014.                             {-100, -150},
015.                             { -80,  -50},
016.                             {  30,   80},
017.                             { 100,  120},
018.                   };
019. //+------------------------------------------------------------------+
020. const double epsilon = 1e-3;
021. //+------------------------------------------------------------------+
022. struct stErr
023. {
024.     double  Weight,
025.             Bias;
026. };
027. //+------------------------------------------------------------------+
028. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = Train.Size() / nColuns)
029. {
030.     double x, y, t;
031.     stErr err;
032.
033.     ZeroMemory(err);
034.     for (uint c = p1; c < p2; c++)
035.     {
036.         x = Train[c][0];
037.         y = Train[c][1];
038.         t = 2 * ((x * w + b) - y);
039.         err.Weight += (t * x);
040.         err.Bias += t;
041.     }
042.
043.     return err;
044. }
045. //+------------------------------------------------------------------+
                                   .
                                   .
                                   .
091. //+------------------------------------------------------------------+
092. void OnStart()
093. {
094.     double weight, bias;
095.     int    x, y;
096.     ulong  it0, it1, count;
097.     stErr  err;
098.
099.     Print("************************************");
100.     Print("Stochastic Gradient Descent Neuron...");
101.     Print("************************************");
102.     MathSrand(512);
103.     weight = (double)macroRandom;
104.     bias = (double)macroRandom;
105.
106.     it0 = GetTickCount();
107.     for(count = 0; count < 5; count++)
108.     {
109.         err = Cost(weight, bias);
110.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
111.             break;
112.         weight -= (err.Weight * epsilon);
113.         bias -= (err.Bias * epsilon);
114.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
115.     }
116.     it1 = GetTickCount();
Действительно, наша функция потерь может показаться несколько необычной, поскольку на самом деле это первая производная исходной функции. Поэтому она не похожа на уравнение прямой. Однако, если вы посмотрите на код, то увидите, что в строке 13 у нас находятся входные данные, а в строке 94 — weight и bias. Последним в строках 103 и 104 соответственно присваиваются произвольные значения. Тем не менее эти значения не являются полностью случайными, поскольку в строке 102 мы задаём их начальный уровень. Это связано с учебной целью данного кода.
В реальной реализации код в строке 102 выглядел бы немного иначе: в качестве основы он использовал бы системные часы или счётчик компьютера, чтобы значения при каждом запуске были случайными. К моменту выполнения строки 116 мы уже имели бы результат работы. Однако это может сбить с толку, поскольку функция потерь не соответствует линейной регрессии, как можно было бы ожидать, если бы мы действительно использовали секущую.
Если это так, мы можем вернуться к статье Нейронная сеть на практике: Первый нейрон. Там в коде реализована линейная регрессия, как вы можете убедиться из приведённого ниже фрагмента, который воспроизводит код из той статьи.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define macroRandom (rand() / (double)SHORT_MAX)
05. //+------------------------------------------------------------------+
06. double Train[][2] {
07.                     {0, 0},
08.                     {1, 2},
09.                     {2, 4},
10.                     {3, 6},
11.                     {4, 8},
12.                   };
13. //+------------------------------------------------------------------+
14. const uint nTrain = Train.Size() / 2;
15. const double eps = 1e-3;
16. //+------------------------------------------------------------------+
17. double Cost(const double w, const double b)
18. {
19.     double err, fx, a;
20.
21.     err = 0;
22.     for (uint c = 0; c < nTrain; c++)
23.     {
24.         a = Train[c][0];
25.         fx =  a * w + b;
26.         err += MathPow(fx - Train[c][1], 2);
27.     }
28.
29.     return err / nTrain;
30. }
31. //+------------------------------------------------------------------+
32. void OnStart()
33. {
34.     double weight, ew, eb, e1, bias;
35.     int f = FileOpen("Cost.csv", FILE_COMMON | FILE_WRITE | FILE_CSV);
36.
37.     Print("The first neuron...");
38.     MathSrand(512);
39.     weight = (double)macroRandom;
40.     bias = (double)macroRandom;
41.
42.     for(ulong c = 0; (c < ULONG_MAX) && ((e1 = Cost(weight, bias)) > eps); c++)
43.     {
44.         ew = (Cost(weight + eps, bias) - e1) / eps;
45.         eb = (Cost(weight, bias + eps) - e1) / eps;
46.         weight -= (ew * eps);
47.         bias -= (eb * eps);
48.         if (f != INVALID_HANDLE)
49.             FileWriteString(f, StringFormat("%I64u;%f;%f;%f;%f;%f\n", c, weight, ew, bias, eb, e1));
50.     }
51.     if (f != INVALID_HANDLE)
52.         FileClose(f);
53.     Print("Weight: ", weight, "  Bias: ", bias);
54.     Print("Error Weight: ", ew);
55.     Print("Error Bias: ", eb);
56.     Print("Error: ", e1);
57. }
58. //+------------------------------------------------------------------+
Действительно, в приведённом выше коде реализована линейная регрессия, и на этот раз функция потерь представляет собой прямую. Вы можете убедиться в этом в строке 25: это то же уравнение, которое я привёл в начале этого раздела. Однако, несмотря на то что в данном случае линейная регрессия очевидна, этот нейрон также не способен смоделировать данные, использовавшиеся в предыдущих программах. Почему? Из-за функции потерь. Вот в чём проблема. «Постойте! «Вы хотите сказать, что функция потерь мешает нейрону научиться представлять данные?» Да, именно так, мой дорогой читатель. Функция потерь мешает нейрону научиться представлять определённые типы данных и, следовательно, прийти к решению. Возможно, это покажется совершенно абсурдным утверждением, но мой опыт позволяет мне так говорить.
Возможно, сейчас вы думаете: «Но эти нейроны же не используют обратное распространение. Они выполняют только прямое распространение. Вот почему им не удаётся научиться представлять данные». Что ж, мой дорогой читатель, теперь вы и правда меня поймали. Перейдём к другой теме, чтобы лучше это понять.
Обратное распространение: что это такое?
Одна из вещей, которые больше всего меня смешат, — это термины, используемые в нейронных сетях. Большинство из них появились сравнительно недавно. Когда я начал изучать эту тему, во время своих первых занятий по C/C++, этих терминов либо не существовало, либо, если они и существовали, ими пользовались очень немногие. В любом случае многие термины, используемые при обсуждении нейронных сетей, — не более чем чепуха: слова, придуманные для того, чтобы запутать тех, кто только начинает, и создать впечатление, будто тема гораздо сложнее, чем она есть на самом деле.
Так называемое «обратное распространение», для которого у нас пока нет термина на португальском, — это не что иное, как то, что происходит внутри цикла for в функции OnStart. Возможно, это прозвучало немного абстрактно. Давайте рассмотрим это на примере кода из предыдущего раздела. Для наглядности приведу фрагмент кода, в котором происходит это обратное распространение. В коде нейрона, основанного на градиентном спуске, это можно увидеть в следующем фрагменте.
107.     for(count = 0; count < 5; count++)
108.     {
109.         err = Cost(weight, bias);
110.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
111.             break;
112.         weight -= (err.Weight * epsilon);
113.         bias -= (err.Bias * epsilon);
114.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
115.     }
«Но где же? «Я этого не вижу». Обратите внимание на строки 112 и 113: именно там происходит обратное распространение в нейроне, основанном на градиентном спуске. В регрессионном нейроне это происходит в следующем фрагменте.
42.     for(ulong c = 0; (c < ULONG_MAX) && ((e1 = Cost(weight, bias)) > eps); c++)
43.     {
44.         ew = (Cost(weight + eps, bias) - e1) / eps;
45.         eb = (Cost(weight, bias + eps) - e1) / eps;
46.         weight -= (ew * eps);
47.         bias -= (eb * eps);
48.         if (f != INVALID_HANDLE)
49.             FileWriteString(f, StringFormat("%I64u;%f;%f;%f;%f;%f\n", c, weight, ew, bias, eb, e1));
50.     }
В этом случае обратите внимание на строки 46 и 47. Видите, мой дорогой читатель? Мы используем обратное распространение. Как бы некоторые ни усложняли этот термин, речь идёт о довольно простой вещи: она помогает коду стремиться к сходимости. В этом нет ничего волшебного. Без неё нейрон не смог бы и дальше пытаться уменьшить наблюдаемую ошибку.
Таким образом, обратное распространение не является причиной того, что нейрон не может научиться представлять данные. Ограничение в том, что он не может охватить все возможные сценарии. Возможно, к этому моменту вы уже немного встревожены: кажется, я разрушаю ваши мечты и иллюзии, показывая, что каждый из элементов, которые многие считают необходимыми для обучения нейрона, на самом деле работает не так, как о нём говорят. Но надежда ещё остаётся: функция активации. Поскольку у нейронов, которые мы здесь рассмотрели, её нет, возможно, именно этого им и не хватает, чтобы прийти к ответу.
Вот это, мой дорогой читатель, и правда цепляться за надежду: думать, что всё ещё может стать лучше и что ваша мечта, возможно, сбудется. В конце концов, существуют программы, способные, помимо прочего, распознавать рукописный текст, речь и изображения. Но теперь я задаюсь вопросом: как я могу быть настолько жестоким? Мне не нравится быть злодеем в этой истории, но я и не хочу создавать ложное впечатление. Если уж говорить, то лучше сразу. Если уж я собираюсь разрушить ваши мечты, пусть это случится прямо сейчас.
Мне жаль говорить вам, мой дорогой читатель, что функция активации тоже не обладает магией. Она не поможет нейрону покорить мир и не сделает ваши мечты реальностью. У неё другое назначение, но объяснять это сейчас было бы сложно. Сначала нам нужно создать несколько элементов и реализовать несколько фрагментов кода, чтобы вы могли на практике понять, что делает функция активации.
И, в отличие от тех, кто ограничивается советами вроде «используйте ту или иную функцию», функции активации нужно подбирать тщательно, чтобы нейрон или нейронная сеть работали правильно. На самом деле функции активации приобретают большее значение только тогда, когда мы используем нейронную сеть или определённые типы данных для обучения. Впервые мы увидели это, когда я показал, как использовать нейрон для представления логических элементов. Даже если бы мы попробовали систему регрессии или любую другую реализацию, в конечном итоге без функции активации нейрон застопорился бы. Оказавшись в таком состоянии, он перестал бы учиться и, следовательно, не смог бы прийти к более адекватному представлению обучающих данных.
В любом случае, вам не о чем беспокоиться, мой дорогой читатель. Скоро мы на практике увидим, как работает функция активации, и вы лучше поймёте, как её выбирать. Возможно, вам потребуется немного времени, чтобы освоить эту тему, но я ищу дидактичный способ её объяснить. Я не хочу ограничиваться простым изложением вычислений или формул: я хочу, чтобы вы поняли, почему и когда следует использовать функцию активации. Есть ещё один аспект, требующий внимания, хотя во многих случаях он не становится проблемой: входные данные. Иногда нейрон просто не может сформировать адекватное представление о данных обучения. Это не тот случай, который мы рассматривали в этой статье; я имею в виду проблему иного рода. Я кратко объясню её, хотя позже это станет понятнее.
Предположим, вы хотите обучить нейронную сеть распознаванию лиц. Вы хотите, чтобы она могла определять, идёт ли речь о мужчине, женщине, пожилом человеке, ребёнке, животном или о чём-то ещё; например, какое выражение лица у человека в данный момент. Главное здесь то, что сеть должна распознать что-то в лице человека. Как это делается? Теоретически это просто: вы указываете программе определённую область изображения, которую нужно найти, а затем анализируете некоторые точки внутри неё.
Важно, чтобы расстояния между этими точками передавались в нейронную сеть. Сеть не знает, что именно анализируется: это может быть что угодно. Единственное, что она получает, — это расстояния между точками, предоставленные другой программой. После обработки этих данных она возвращает результат, выраженный в процентах. Этот результат никогда не будет равен 100 %, поскольку сеть не стремится к тому, чтобы значения точно совпадали с теми, которые выдаёт уравнение; она лишь показывает, насколько эти значения приближаются к тем, которые она распознаёт, или отклоняются от них, используя в качестве эталона предварительно вычисленное уравнение.
Здесь многие заблуждаются и полагают, что нейронная сеть распознаёт человека или его мимику. Но нет: на самом деле она использует уравнение или заранее заданный многочлен. Затем вычисляется ошибка между входными значениями и значениями, которые получились бы при вычислении этого многочлена.
Заключительные замечания
То, что мы рассмотрели в этой статье, может показаться запутанным, разрозненным и лишённым внутренней логики. Но я хочу напомнить вам, мой дорогой читатель, что цель этих статей — изложить эту тему как можно понятнее. Без уловок, без «чёрных ящиков» и тёмных методов. Любой программист может воспроизвести всё, что я здесь показываю. Здесь нет никаких секретов. И, несмотря на то что утверждают многие инфлюенсеры, нейронные сети — тема непростая и не допускает единого подхода: каждый случай индивидуален. Во многих случаях используют более прямой подход к программированию, чтобы получить многочлен. Сделав это, можно сказать, что любой прогноз, основанный на этом многочлене, может рассматриваться как форма взаимодействия с искусственным интеллектом. Но так бывает не всегда. Вспомните статьи, в которых я рассказывал об искусственном интеллекте и о том, как некоторые вещи могут казаться умными или создавать впечатление, будто в них есть какой-то интеллектуальный механизм.
В любом случае, к этому моменту вы уже должны немного осторожнее относиться к тому, что говорят на эту тему, и готовы понять некоторые аспекты нейронных сетей и искусственного интеллекта. Нам ещё многое предстоит исследовать: пока что мы лишь мельком увидели некоторые возможности реализации. В следующих статьях мы рассмотрим и другие аспекты, которые помогут вам лучше понять эту тему. Мы также рассмотрим реализации, которые, как ни странно, не похожи ни на нейрон, ни на какую-либо архитектуру нейронной сети. Тем не менее они могут вести себя подобным образом и создавать впечатление, что обучаются или формируют представление, которое можно использовать в искусственном интеллекте или в нейронной сети.
Если вас заинтересовало то, что я объяснил в предыдущем разделе о распознавании изображений, в частности то, как изображение можно представить в виде многочлена, я оставлю две ссылки в списке литературы. Это материалы, опубликованные в 2013 году, которые, несмотря на прошедшее время, по-прежнему актуальны. Я также приведу ссылку на сайт для тех, кто хочет изучать математику более углублённо: его материалы организованы так, чтобы облегчить поиск конкретных тем.
Справочный материал
Перевод с португальского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/pt/articles/13865
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Рыночная микроструктура в MQL5 (Часть 5): Микроструктурный шум
 За пределами GARCH (Часть V): Подгонка мультифрактального спектра в MQL5
 За пределами GARCH (Часть VI): Фракционное броуновское движение и мультипликативный каскад в MQL5
 Рыночная микроструктура в MQL5 (Часть 4): Волатильность с эффектом памяти

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования