

Нейронная сеть на практике: Стохастический градиентный спуск
 83
 0

Введение
В предыдущей статье «Нейронная сеть на практике: градиентный спуск» я показал кое-что, что, возможно, осталось не совсем понятным. Итак, я начну именно с этого места. Важно, чтобы у вас, мой дорогой читатель, не оставалось сомнений в том, что я объясняю в рамках этой темы. Ниже показано, о чём именно идёт речь:
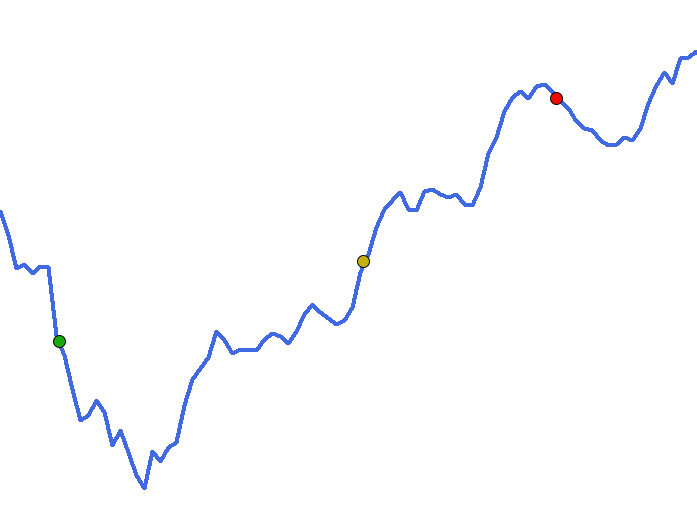
Суть в следующем: в предыдущей статье я упомянул, что в какой-то момент у вас может быть набор данных, который можно аппроксимировать синей линией. То есть у нас есть довольно сложный многочлен. Этот многочлен подаётся на вход нейронной сети, чтобы она попыталась найти уравнение, способное описать данные, содержащиеся в наборе. Пока что, думаю, здесь нет ничего особенно сложного для понимания. В ходе объяснения я упоминаю, что точки, показанные на изображении, представляют величину ошибки, возникающей при инициализации нейронной сети. И именно эта часть, возможно, осталась несколько непонятной. Я хотел бы лучше прояснить этот вопрос.
Дело в том, что, когда мы что-то изображаем на графике, как многие, вероятно, видели в объяснениях, связанных с ошибкой, этот график обычно представляет собой поверхность. Проблема в том, что для построения графика поверхности нужны две переменные: одна для оси X, а другая — для оси Y. Значения, соответствующие комбинации этих переменных, отображаются по оси Z. Нечто похожее на то, что показано в следующей анимации.
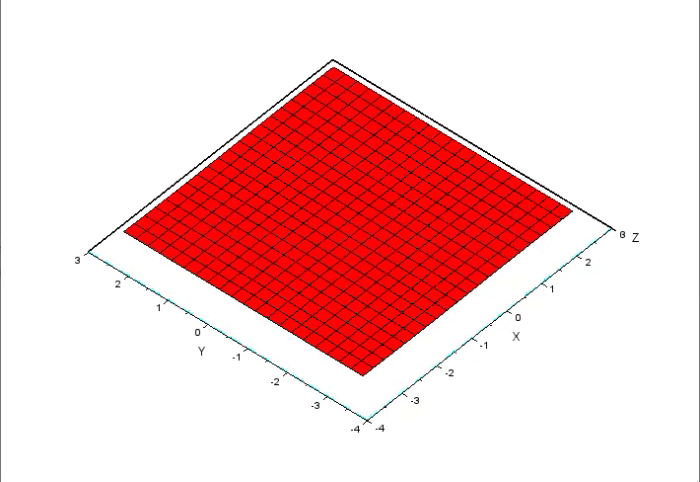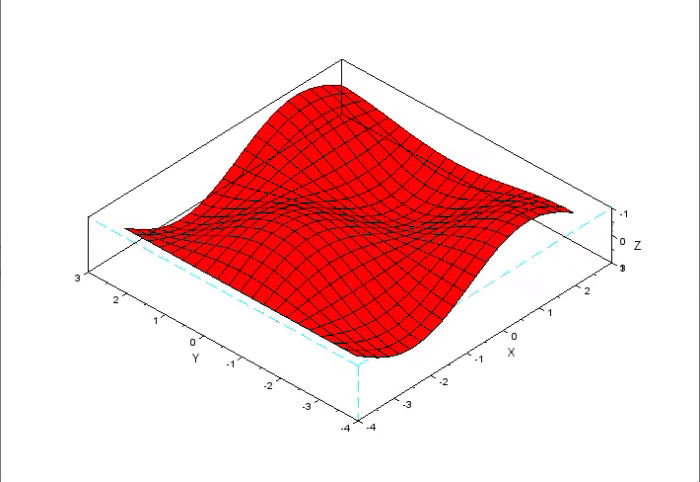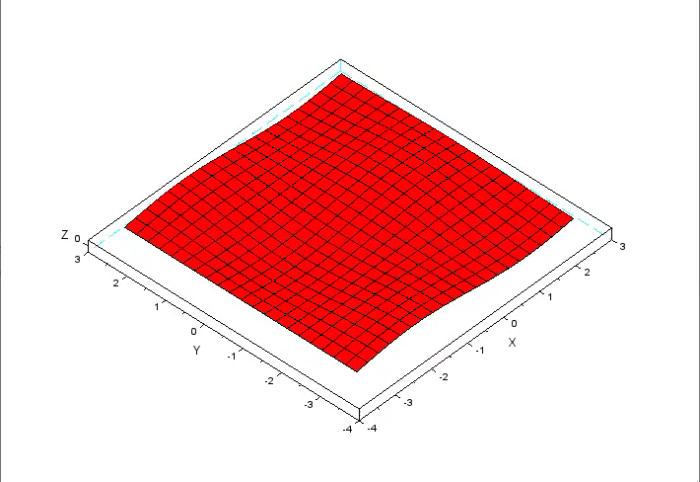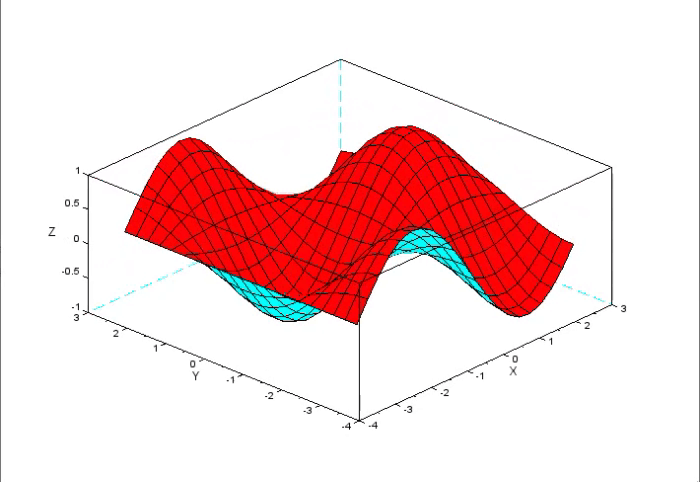
В этой анимации видно, что при изменении значений по оси Z каждому значению по оси Z соответствует комбинация одного значения по оси X и другого — по оси Y. Однако кривую, показанную на изображении в начале статьи, нельзя представить в виде графика поверхности; невозможно даже вообразить, как бы выглядел такой график. Это объясняется тем, что для ее построения, очевидно, понадобилось бы гораздо больше двух переменных.
По этой причине при взгляде на кривую, возможно, было несколько трудно понять, в чем состоит ошибка. Многие могут вообразить, что график, представляющий набор данных, сам по себе содержит точку минимума ошибки. Это неверно. Прошу прощения, если именно это можно было так понять, потому что на самом деле всё работает не так. Я лишь использовал двумерный график, чтобы передать идею долин и пиков. Часто мы пытаемся представить себе, как выглядела бы идеальная долина. Однако в зависимости от того, с какой точки мы начнем, мы, возможно, так и не сможем достичь точки с наименьшим значением ошибки.
Я знаю, что это кажется чрезвычайно сложным. И, честно говоря, это действительно сложно объяснить, особенно потому, что я не знаю, насколько каждый из вас знаком с математикой, используемой в нейронной сети. Я стараюсь сделать материал как можно более простым и понятным. Было бы гораздо проще объяснить это по-другому. Неважно. Надеюсь, мне удалось прояснить этот вопрос, который, на мой взгляд, оставался несколько неясным и мог привести к неверному пониманию темы.
Ниже показан код, использованный для создания предыдущей анимации. Это код, написанный для SCILAB, — на случай, если кому-то станет любопытно и он захочет рассмотреть данные подробнее.
 t=-%pi:0.3:%pi;
 plot3d(t,t,sin(t)'*cos(t),80,50,'X@Y@Z',[5,2,4]);
Если вам интересно рассмотреть это подробнее, можете попробовать запустить приведенный выше код, чтобы лучше понять концепции долины и пика. Чтобы переместить 3D-график, щёлкните правой кнопкой мыши, удерживайте её нажатой и перетаскивайте указатель мыши. Хорошо, теперь, когда, как мне кажется, я прояснил момент, который меня беспокоил, мы можем перейти к тому, что рассмотрим в этой статье.
Добавление смещения в градиентный спуск
Поскольку с самого начала я придерживался определённой методологии, я намерен сохранять её во всех статьях о нейронных сетях, хотя порой может показаться, что мы ходим по кругу, возвращаясь к одному и тому же. Хочу напомнить вам, мой дорогой читатель, что нейронные сети — не та тема, у которой есть чётко определённые отправная точка и конечная цель. Когда речь заходит о нейронных сетях, всё оказывается куда более своеобразным. Иногда вам кажется, что мы только в начале, хотя на самом деле уже в конце. А иногда вам кажется, что мы уже в конце, хотя на самом деле только в начале. Это довольно странно и немного сбивает с толку, особенно тех, кто предпочитает начинать и заканчивать каждую тему в чётко определённых точках. В итоге такие люди бросают изучать эту тему.
То, что происходит так, что у нас нет ни начальной, ни конечной точки, объясняется просто: у нейронных сетей нет единственного решения. Каждый класс задач предполагает или может предполагать совершенно иное решение. Прежде чем перейти к этим вопросам, давайте посмотрим, чего не хватало, чтобы завершить искусственный нейрон, который мы рассматривали в предыдущей статье, там использовался градиентный спуск. Исходный код из предыдущей статьи полностью приведён ниже.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define PrintEx(A) Print(#A, " => ", A)
05. #define macroRandom (rand() / (double)SHORT_MAX)
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, 0},
09.                     {1, 3},
10.                     {2, 6},
11.                     {3, 9},
12.                     {4, 12},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. double Cost(const double w)
19. {
20.     double err, x, y;
21.
22.     err = 0;
23.     for (uint c = 0; c < nTrain; c++)
24.     {
25.         x = Train[c][0];
26.         y = Train[c][1];
27.         err += 2 *(x * w - y) * x;
28.     }
29.
30.     return err;
31. }
32. //+------------------------------------------------------------------+
33. void OnStart()
34. {
35.     double weight, err;
36.     ulong it0, it1, count;
37.
38.     Print("************************************");
39.     Print("Linear gradient neuron...");
40.     MathSrand(512);
41.     weight = (double)macroRandom;
42.
43.     it0 = GetTickCount();
44.     for(count = 0; (count < ULONG_MAX) && (MathAbs(err = Cost(weight)) > epsilon); count++)
45.         weight -= (err * epsilon);
46.     it1 = GetTickCount();
47.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
48.     PrintEx(count);
49.     PrintEx(weight);
50.     PrintEx(err);
51. }
52. //+------------------------------------------------------------------+
Обратите внимание, что в строке 18, где мы определяем функцию потерь, нам передаётся только параметр, соответствующий весу. И в строке 27, где выполняется вычисление, мы не используем ни смещение (свободный член), ни соответствующий ему параметр. Хочу ещё раз напомнить читателю, что градиентный спуск — это всего лишь более интересный способ реализовать линейную регрессию. И не более того. Чтобы лучше это понять, обратитесь к предыдущим статьям.
Тем не менее у него есть свои преимущества по сравнению с нейроном, реализующим линейную регрессию. Однако само по себе добавление параметра для учёта смещения в строках 18 и 27 не делает расчёт правильным. Это связано с тем, что способ расчёта ошибки будет немного отличаться от того, который используется для расчёта ошибки для смещения. Это можно увидеть на следующих изображениях.


На первом изображении показан расчёт ошибки, соответствующей весу; на втором — расчёт ошибки, соответствующей смещению. Обратите внимание, что они немного различаются, поскольку в одном используется значение, которого нет в другом. Но здесь возникает ещё одна проблема, связанная с кодом, который нам нужно написать. Обратите внимание, что функция возвращает значение типа double, но нам нужно вернуть два значения типа double: одно для смещения, а другое — для веса. Что ж, если вы уже уверенно владеете программированием на MQL5, то не увидите в этом проблемы. На самом деле существует несколько способов решить эту небольшую проблему. Некоторые из них проще, а другие — несколько сложнее. В любом случае, меня не интересует, как именно будет решена эта проблема.
Нас интересуют полученные результаты. Вероятно, позже вы заметите, что со временем я, вероятно, буду решать эту задачу иначе. Но я хочу ещё раз чётко сказать, что нас интересует именно результат, а не способ его получения. Итак, первый способ решить эту задачу можно увидеть в следующем коде.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define PrintEx(A) Print(#A, " => ", A)
05. #define macroRandom (rand() / (double)SHORT_MAX)
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, 0},
09.                     {1, 3},
10.                     {2, 6},
11.                     {3, 9},
12.                     {4, 12},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. struct stErr
19. {
20.     double  Weight,
21.             Bias;
22. };
23. //+------------------------------------------------------------------+
24. stErr Cost(const double w, const double b)
25. {
26.     double x, y, t;
27.     stErr err;
28.
29.     ZeroMemory(err);
30.     for (uint c = 0; c < nTrain; c++)
31.     {
32.         x = Train[c][0];
33.         y = Train[c][1];
34.         t = 2 * ((x * w + b) - y);
35.         err.Weight += (t * x);
36.         err.Bias += t;
37.     }
38.
39.     return err;
40. }
41. //+------------------------------------------------------------------+
42. void OnStart()
43. {
44.     double weight, bias;
45.     ulong it0, it1, count;
46.     stErr err;
47.
48.     Print("************************************");
49.     Print("Gradient Descent Neuron...");
50.     MathSrand(512);
51.     weight = (double)macroRandom;
52.     bias = (double)macroRandom;
53.
54.     it0 = GetTickCount();
55.     for(count = 0; count < ULONG_MAX; count++)
56.     {
57.         err = Cost(weight, bias);
58.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
59.             break;
60.         weight -= (err.Weight * epsilon);
61.         bias -= (err.Bias * epsilon);
62.     }
63.     it1 = GetTickCount();
64.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
65.     PrintEx(count);
66.     PrintEx(weight);
67.     PrintEx(bias);
68.     PrintEx(err.Weight);
69.     PrintEx(err.Bias);
70. }
71. //+------------------------------------------------------------------+
Глядя на этот код, вы, возможно, думаете: «Ого, как всё сложно». Разве нет более простого способа это сделать? Как я уже недавно говорил, меня не интересует, как это делается. Меня интересуют результаты. Настолько, что при запуске этого кода в терминале MetaTrader 5 вы увидите следующий результат:
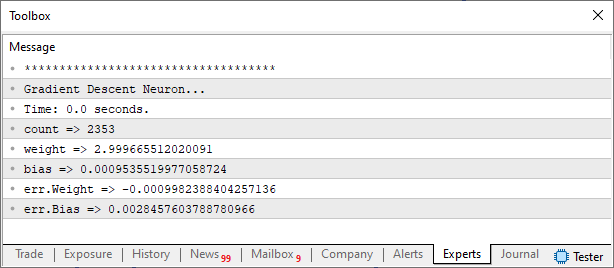
Хорошо, тогда я дам краткое объяснение для тех, кто только что присоединился. В строке 18 я объявляю структуру. Мы будем использовать её для возврата вычисленной ошибки. Обратите внимание, как теперь выглядит объявление функции потерь в строке 24. Далее, в строке 27, мы объявляем внутреннюю переменную функции. Она будет использоваться для хранения значений, которые будут возвращены. В строке 34 мы выполняем вычисления. Однако там мы вычисляем только часть. В строке 35 мы корректируем вычисление, чтобы включить недостающую часть в ошибку, соответствующую весу. В итоге мы правильно вычисляем ошибку как для веса, так и для смещения в соответствии с формулой.
Остался ещё один небольшой вопрос: функция активации. Бывают случаи, когда функция активации на самом деле не нужна, а в других случаях она имеет решающее значение. Мы уже рассматривали это в статье, где я показал, как обучить нейрон представлять логический элемент. Здесь, однако, поскольку мы используем значения, описываемые функцией, которая явно соответствует следующему уравнению:

функция активации не нужна. Скоро мы лучше поймём этот вопрос, связанный с функцией активации. Единственное, что вам нужно понять сейчас, мой дорогой читатель, — это то, что не существует единой формулы для создания нейронной сети. Каждый случай индивидуален. И существует множество ситуаций, в которых нейронная сеть скорее мешает, чем помогает. Это мы тоже увидим совсем скоро. Давайте не торопиться, нет причин ставить телегу впереди лошади. Всему своё время.
Итак, вернёмся к нашему основному вопросу — нейрону, использующему градиентный спуск. Вы можете скомпилировать его и запустить в терминале. Вы заметите, что результаты не изменятся по сравнению с тем, что было показано в предыдущей статье. На самом деле один из фрагментов кода, включённых в приложение к этой статье, — это как раз код этого нейрона, который мы только что рассмотрели. Что произойдёт, если мы изменим уравнение так, что получим немного другое уравнение? Что произойдёт с нейроном, учитывая, что в его коде нет функции активации? Я хочу, чтобы вы, мой дорогой читатель, провели этот эксперимент. И, чтобы помочь вам, давайте поэкспериментируем с несколькими значениями, чтобы получить следующее уравнение:

Для этого нам нужно изменить некоторые части кода.
. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, -0.8},
09.                     {1, 0.85},
10.                     {2, 2.5},
11.                     {3, 4.15},
12.                     {4, 5.8},
13.                   };
14. //+------------------------------------------------------------------+
                                   .
                                   .
                                   .
41. //+------------------------------------------------------------------+
42. void OnStart()
43. {
                                   .
                                   .
                                   .
55.     for(count = 0; count < 10; count++)
56.     {
57.         err = Cost(weight, bias);
58.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
59.             break;
60.         weight -= (err.Weight * epsilon);
61.         bias -= (err.Bias * epsilon);
62.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
63.     }
Эти изменения можно увидеть в следующем фрагменте: обратите внимание на места, где код изменился. Первое относится к данным, использованным для обучения. Следующее находится в коде процедуры OnStart. Хорошо, прежде чем смотреть на результат, хочу предупредить вас, мой дорогой читатель и энтузиаст: мы используем нейрон, который вполне может просто сказать: «Я НЕ СМОГУ ДОСТИЧЬ СХОДИМОСТИ».
И если это произойдёт, цикл в строке 55 может привести к тому, что программа будет завершаться довольно долго. Поскольку мы не можем быть уверены, что нейрон будет сходиться, нам нужно ограничить цикл небольшим числом итераций. В данном случае я задаю десять итераций. В каждой из них мы будем выводить на экран информацию о том, что делает нейрон. За это отвечает строка 62. Так мы сможем увидеть, удаётся нейрону сходиться или нет. Хорошо, с учётом этого предупреждения мы можем скомпилировать и запустить изменённый код.
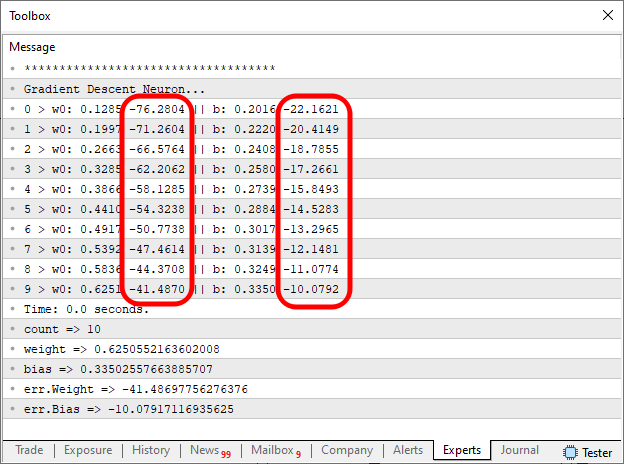
В результате вы увидите в терминале MetaTrader 5 следующее изображение. Нас интересуют именно области, отмеченные на изображении. Мы хотим, чтобы их значения стремились к нулю. На самом деле они никогда не достигнут ровно нуля. Это связано с тем, что строка 58 приведёт к завершению цикла итераций, как только значение ошибки станет ниже заранее заданного порога. Это условие должно выполняться одновременно и для ошибки веса, и для ошибки смещения. В противном случае цикл будет продолжать выполняться, пока не будет достигнут установленный предел числа итераций.
Отлично, мы уже знаем, что нейрон сходится. Поэтому давайте позволим ему продолжать попытки, пока не будет достигнут предел, заданный в строке 58, или максимальное число итераций. Для этого мы изменим значение в строке 55, которое задано как десять, и заменим его на ULONG_MAX. Или на любое другое значение, которое вы предпочитаете. В результате мы получим то, что показано на следующем изображении:
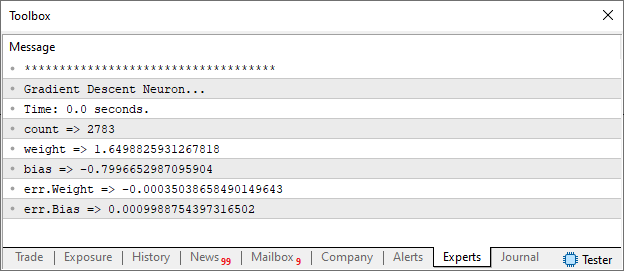
Обратите внимание, что полученный результат очень близок к тому, который мы ожидали. И даже не потребовалось добавлять функцию активации, чтобы нейрон смог сойтись. Хорошо, а что, если нейрон не сможет сойтись к результату, который позволил бы представить данные, использованные при обучении, в виде уравнения? Как нам следует поступить? Каждый случай индивидуален. Нет никакого правила, которому вы должны следовать. Или, точнее, не существует единой формулы, которая позволила бы добиться того, чтобы обучение сошлось к математическому уравнению, описывающему данные. Пытаться следовать какому-то правилу при обучении нейрона или нейронной сети — ошибка. Потому что ТАКОГО ПРАВИЛА НЕ СУЩЕСТВУЕТ.
И это как раз одна из ошибок, которые часто допускают многие из тех, кто только начинает изучать нейронные сети. Они хотят любой ценой следовать жёстким правилам, тогда как на самом деле нам нужно понимать, что именно мы создаём, а не пытаться следовать заранее заданной формуле или использовать что-то готовое. Именно поэтому я и пишу эти статьи на эту тему. Я пытаюсь передать вам, мой дорогой читатель, часть своего опыта в этой области. Возможно, кому-то удастся усвоить хотя бы часть того, что я показываю.
Итак, прежде чем перейти к следующей теме, я хочу вкратце коснуться одной вещи, о которой вы, возможно, ещё услышите. Возможно, вы уже слышали об этом, но, скорее всего, так и не поняли, о чём именно шла речь. Я говорю о так называемом стохастическом градиентном спуске. Да уж, словечко и правда внушительное. От одного только этого термина уже могут пойти мурашки по коже. По крайней мере, многие, возможно, воспринимают это именно так. Но если это ваш случай или если вы никогда об этом не слышали, вам не о чем тревожиться и не нужно сломя голову бежать выяснять, о чём идёт речь. Стохастический градиентный спуск — это всего лишь разновидность градиентного спуска. Разница в том, что эта разновидность как раз и призвана немного ускорить градиентный спуск в процессе его выполнения.
Хорошо, а как мы можем этого добиться? Возможно, это будет интересно использовать. Действительно, стохастический градиентный спуск — метод действительно интересный и помогает ускорить градиентный спуск. Но у этого есть своя цена. Бесплатного обеда не бывает. Чтобы ускорить градиентный спуск, стохастический метод — я буду называть его так, чтобы не повторять постоянно полное название, — использует следующий приём. Давайте посмотрим на созданный нами фрагмент кода, чтобы разобраться в этом. Он показан ниже.
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, -0.8},
09.                     {1, 0.85},
10.                     {2, 2.5},
11.                     {3, 4.15},
12.                     {4, 5.8},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. struct stErr
19. {
20.     double  Weight,
21.             Bias;
22. };
23. //+------------------------------------------------------------------+
24. stErr Cost(const double w, const double b)
25. {
26.     double x, y, t;
27.     stErr err;
28.
29.     ZeroMemory(err);
30.     for (uint c = 0; c < nTrain; c++)
31.     {
32.         x = Train[c][0];
33.         y = Train[c][1];
34.         t = 2 * ((x * w + b) - y);
35.         err.Weight += (t * x);
36.         err.Bias += t;
37.     }
38.
39.     return err;
40. }
41. //+------------------------------------------------------------------+
Наш обучающий набор довольно небольшой, но представьте, что в нём были бы тысячи, миллионы, а может, даже миллиарды записей. Если бы вы использовали приведённый выше фрагмент кода, обучение всего одного нейрона могло бы занять часы или даже дни. И это при условии, что набор данных позволял бы обучить хотя бы один нейрон. Если бы потребовалось использовать нейронную сеть, время могло бы очень быстро возрасти. Хорошо, теперь, когда мы это поняли, давайте посмотрим, как стохастический метод решает эту проблему со временем.
Волшебство происходит, когда выполняется строка 30. При обычном градиентном спуске при каждом вызове функции потерь используется весь набор данных. То есть каждый раз, когда выполняется вызов в строке 24, цикл в строке 30 проходит по всему набору данных, чтобы обучить сеть или даже всего один нейрон. Однако в ходе исследований было замечено, что это лишь пустая трата времени. Мы можем получить тот же результат — или, по крайней мере, вполне удовлетворительный, — внеся небольшое изменение в эту схему. Вместо того, чтобы использовать весь набор данных на каждой итерации, то есть при каждом выполнении вызова в строке 24, мы будем использовать только его часть. В этот момент вы, возможно, думаете: «Но это не кажется очень разумным, ведь обучение окажется незавершённым». Однако такое впечатление возникает именно потому, что вы, мой дорогой читатель, ещё не до конца поняли идею, лежащую в основе этой реализации. Давайте посмотрим, как будет выглядеть приведённый выше фрагмент, если мы воспользуемся стохастическим градиентным спуском. Он показан ниже.
23. //+------------------------------------------------------------------+
24. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = nTrain)
25. {
26.     double x, y, t;
27.     stErr err;
28.
29.     ZeroMemory(err);
30.     for (uint c = p1; c < p2; c++)
31.     {
32.         x = Train[c][0];
33.         y = Train[c][1];
34.         t = 2 * ((x * w + b) - y);
35.         err.Weight += (t * x);
36.         err.Bias += t;
37.     }
38.
39.     return err;
40. }
41. //+------------------------------------------------------------------+
Поскольку нам нужно изменить только ту часть, которая отвечает за вычисление ошибки, я привожу лишь тот фрагмент, который действительно необходим. Теперь, возможно, станет понятнее, как работает стохастический метод. Обратите внимание, что изменения внесены только в строках 24 и 30. Весь остальной код остаётся неизменным. Нужно учитывать только две вещи: во-первых, значение p1 должно отличаться от p2 и быть меньше него. Во-вторых, значение p2 должно быть равно или меньше количества данных в обучающей выборке. Учитывая эти условия, давайте посмотрим, как это можно использовать.
Вызывающий код может выполнить определённое количество вызовов, чтобы обучить систему на наборе из X элементов. Как только сеть будет обучена на этих X данных, вы переходите к следующему пакету. Таким образом, вы обучаете модель на объёме данных Y, который может быть равен предыдущему или больше него. Поскольку сеть уже будет находиться на несколько более продвинутом этапе с точки зрения снижения ошибки, этот второй этап обучения во многих случаях будет значительно быстрее. И так далее.
Вы делите данные, которые будут использоваться для обучения, на более мелкие блоки, которые гораздо быстрее проходят через функцию потерь. Например, предположим, что в нашем наборе данных содержится миллион записей, которые будут использоваться при обучении. Если бы нам пришлось пропустить этот миллион записей через функцию потерь сто тысяч раз, на это ушло бы огромное количество времени. Вместо этого, если бы мы пропускали по десять тысяч записей сто тысяч раз, чтобы снизить ошибку, связанную с весами и смещением, то следующему пакету из десяти тысяч, возможно, уже не понадобилось бы проходить через это сто тысяч раз. Возможно, перед завершением хватило бы примерно восьмидесяти тысяч итераций. А следующему пакету потребовалось бы ещё меньше попыток, чтобы ещё сильнее снизить ошибку. В итоге вы используете все обучающие данные, но не тратите столько времени, сколько потребовалось бы, если бы вы обрабатывали весь набор при каждой итерации.
В этом и заключается суть стохастического градиентного спуска: попытаться снизить ошибку как можно быстрее. Поскольку, скорее всего, вам не повезёт и псевдослучайный генератор не присвоит весам и смещению значения, близкие к оптимальным, применение этого подхода к большому набору данных — разумное решение. Однако для небольших наборов данных, или даже для того набора, который я использую, чтобы показать, как всё работает, реализация стохастического градиентного спуска совершенно не нужна и только отнимает огромное количество времени. Поэтому нет особого смысла использовать его, если более простые и, на первый взгляд, более медленные методы позволяют добиться хороших результатов.
Хорошо. Считаю, что тему стохастического градиентного спуска мы уже разобрали, так как больше по этому поводу сказать особо нечего. Поскольку у нас ещё есть немного времени, я могу начать показывать кое-что, что станет понятнее в следующей статье. Так что давайте немного забежим вперёд. Для этого перейдём к новой теме.
Разве нет другого пути?
Хорошо, мой дорогой читатель. До сих пор всё развивалось постепенно и без особых затруднений, что позволило относительно легко объяснить многие вещи. Правда, мы пока находимся лишь в самом начале всего того, что можем рассмотреть. Однако, поскольку некоторые из вопросов, которые мы рассмотрим, довольно сложно изложить простым языком, я постарался продвигаться как можно медленнее и последовательно. Идея в том, чтобы изложить эту тему в доступной форме, чтобы каждый мог её понять. Хотя у нас и были некоторые взлёты и падения, я думаю, что вы смогли следить за объяснениями и понять материал.
Прежде чем перейти к другим, несколько более глубоким вопросам, я хотел бы кое-что пояснить. Для этого нам нужно будет немного изменить код нейрона, который мы рассмотрели в этой статье. Не стоит ни пугаться, ни задаваться вопросом почему. Как говорил ЭН САБАХ НУР: «Всё прояснится в своё время, дитя моё». Итак, раз мы это поняли, давайте посмотрим на изменения, внесённые в код, чтобы я мог кое-что объяснить. Опять же, не беспокойтесь о том, чтобы пока понять причину; просто посмотрите на код, приведённый ниже.
001. //+------------------------------------------------------------------+
002. #property copyright "Daniel Jose"
003. //+------------------------------------------------------------------+
004. #include <Canvas\Canvas.mqh>
005. //+------------------------------------------------------------------+
006. #define PrintEx(A)  Print(#A, " => ", A)
007. #define macroRandom (rand() / (double)SHORT_MAX)
008. #define _SizeLine   300
009. #define nColuns     2
010. //+------------------------------------------------------------------+
011. CCanvas canvas;
012. //+------------------------------------------------------------------+
013. double Train[][nColuns] {
014.                     {0, -0.8},
015.                     {1, 0.85},
016.                     {2, 2.5},
017.                     {3, 4.15},
018.                     {4, 5.8},
019.                   };
020. //+------------------------------------------------------------------+
021. const double epsilon = 1e-3;
022. //+------------------------------------------------------------------+
023. struct stErr
024. {
025.     double  Weight,
026.             Bias;
027. };
028. //+------------------------------------------------------------------+
029. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = Train.Size() / nColuns)
030. {
031.     double x, y, t;
032.     stErr err;
033.
034.     ZeroMemory(err);
035.     for (uint c = p1; c < p2; c++)
036.     {
037.         x = Train[c][0];
038.         y = Train[c][1];
039.         t = 2 * ((x * w + b) - y);
040.         err.Weight += (t * x);
041.         err.Bias += t;
042.     }
043.
044.     return err;
045. }
046. //+------------------------------------------------------------------+
047. void PlotText(const int x, const int y, const uchar line, const string sz0)
048. {
049.     uint w, h;
050.
051.     TextGetSize(sz0, w, h);
052.     canvas.TextOut(x - (w / 2), y + _SizeLine + (line * h) + 5, sz0, ColorToARGB(clrBlack));
053. }
054. //+------------------------------------------------------------------+
055. inline double CallZoom(void)
056. {
057.     double d1 = 0;
058.
059.     for (uint c = 0; c < Train.Size() / nColuns; c++)
060.     {
061.         d1 = MathMax(d1, MathAbs(Train[c][0]));
062.         d1 = MathMax(d1, MathAbs(Train[c][1]));
063.     }
064.
065.     return _SizeLine / d1;
066. }
067. //+------------------------------------------------------------------+
068. void Plot_Train2D(const int x, const int y, const double weight, double bias)
069. {
070.     int vx, vy;
071.     double zoom;
072.     uint n = Train.Size() / nColuns;
073.
074.     zoom = CallZoom();
075.     canvas.LineVertical(x, y - _SizeLine, y + _SizeLine, ColorToARGB(clrRoyalBlue, 255));
076.     canvas.LineHorizontal(x - _SizeLine, x + _SizeLine, y, ColorToARGB(clrRoyalBlue, 255));
077.     for (uint c = 0; c < n; c++)
078.     {
079.         vx = (int)(Train[c][0] * zoom);
080.         vy = (int)(Train[c][1] * zoom);
081.        canvas.FillCircle(x + vx, y - vy, 5, ColorToARGB(clrRed, 255));
082.     }
083.     canvas.LineAA(
084.                 x + (int)(Train[0][0] * zoom),
085.                 y - (int)((Train[0][0] * weight + bias) * zoom),
086.                 x + (int)(Train[n - 1][0] * zoom),
087.                 y - (int)((Train[n - 1][0] * weight + bias) * zoom),
088.                 ColorToARGB(clrForestGreen));
089.     PlotText(x, y, 1, StringFormat("Zoom: %.2fx", zoom));
090.     PlotText(x, y, 2, StringFormat("f(x) = %.4fx %c %.4f", weight, (bias < 0 ? '-' : '+'), MathAbs(bias)));
091. }
092. //+------------------------------------------------------------------+
093. void OnStart()
094. {
095.     double weight, bias;
096.     int    x, y;
097.     ulong  it0, it1, count;
098.     stErr  err;
099.
100.     Print("************************************");
101.     Print("Stochastic Gradient Descent Neuron...");
102.     Print("************************************");
103.     MathSrand(512);
104.     weight = (double)macroRandom;
105.     bias = (double)macroRandom;
106.
107.     it0 = GetTickCount();
108.     for(count = 0; count < ULONG_MAX; count++)
109.     {
110.         err = Cost(weight, bias);
111.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
112.             break;
113.         weight -= (err.Weight * epsilon);
114.         bias -= (err.Bias * epsilon);
115.     }
116.     it1 = GetTickCount();
117.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
118.     PrintEx(count);
119.     PrintEx(weight);
120.     PrintEx(bias);
121.     PrintEx(err.Weight);
122.     PrintEx(err.Bias);
123.     Print("Press ESC to close....");
124.     Print("************************************");
125.
126.    x = (int)ChartGetInteger(0, CHART_WIDTH_IN_PIXELS, 0);
127.    y = (int)ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS, 0);
128.    canvas.CreateBitmapLabel("BL", 0, 0, x, y, COLOR_FORMAT_ARGB_NORMALIZE);
129.    canvas.Erase(ColorToARGB(clrWhite, 255));
130.     x /= 2;
131.     y /= 2;
132.
133.     Plot_Train2D(x, y, weight, bias);
134.
135.    canvas.Update(true);
136.
137.     while(!IsStopped())
138.         if (TerminalInfoInteger(TERMINAL_KEYSTATE_ESCAPE) !=0)
139.             break;
140.
141.     canvas.Destroy();
142. }
143. //+------------------------------------------------------------------+
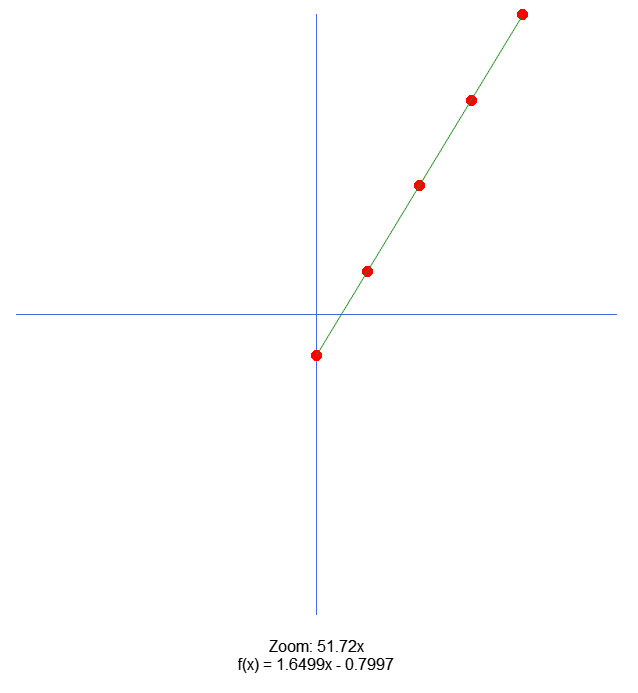
Этот код будет доступен в приложенном файле. Возможно, к следующей статье я внесу некоторые изменения, чтобы сделать её более наглядной. Хотя мне ещё нужно подумать, действительно ли это будет необходимо. В любом случае, при его выполнении мы получим результат, показанный на следующем изображении.
И в терминале вы увидите следующую информацию:
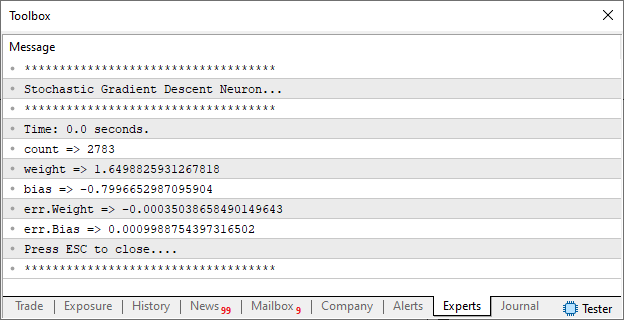
Хорошо, давайте посмотрим, что здесь происходит. На основе обучающих данных, заданных в строке 13, в процедуре OnStart мы используем нейрон для построения уравнения. Это уравнение будет описывать прямую. Нейрон найдёт это уравнение с помощью градиентного спуска. Однако, поскольку набор данных очень мал, мы воспользуемся самым простым методом, а именно — градиентным спуском. Как только нейрон сообщит, что завершил работу, мы выведем в терминал некоторую информацию. Это делается в строках 117–124. Далее мы воспользуемся стандартной библиотекой CCanvas для построения простого графика на экране MetaTrader 5. Этот график будет создан при выполнении строки 133, которая, в свою очередь, передаст поток выполнения строке 68.
В процедуре Plot_Train2D в строке 74 мы попросим приложение определить оптимальный уровень масштабирования для отображения данных, поскольку можем иметь дело с очень маленькими или очень большими значениями. Мы хотим, чтобы все они находились в пределах области, в которой разместим декартову систему координат. Линии Y и X, представляющие систему координат, рисуются в строках 75 и 76 соответственно. Далее в строке 77 мы входим в цикл for. Цель этого цикла — отобразить все точки, использованные во время обучения. Разумеется, они будут правильно расположены в соответствующих позициях в соответствии с масштабом, установленным на основе найденных значений. Хорошо, после этого в строке 83 мы нарисуем линию на основе уравнения прямой, найденного нейроном. Далее, в строках 89 и 90, мы выводим некоторые данные о том, что показывает график, а также об уровне масштабирования изображения.
Цель состоит в том, чтобы данные отображались как можно лучше. Так вы сможете начать понимать то, что мы рассмотрим в следующей статье.
Заключительные замечания
В этой статье мы в основном сосредоточились на создании нейрона, способного использовать градиентный спуск. Мы также рассмотрели вариант этой модели, называемый стохастическим градиентным спуском. Однако не всё так просто. Но здесь есть некоторые проблемы.
И здесь я хочу, чтобы вы, мой дорогой читатель, попробовали проанализировать и поэкспериментировать с этим последним фрагментом кода, приведённым в статье. Но делайте это осторожно, так как нейрон не имеет функции активации. Это может привести к тому, что он просто достигнет точки застоя. Мы уже видели ранее, что такое может произойти. Однако пока мы не будем затрагивать вопрос о функциях активации и их истинной важности. Но сначала я хочу объяснить кое-что другое. И для этого мне нужно, чтобы нейрон оставался в своей самой простой и базовой форме. Ведь если вы поймёте то, о чём пойдёт речь в следующей статье, то убедитесь, что нейронные сети не всегда являются лучшим выбором, что бы вам ни говорили.
А до этого попробуйте изменить обучающие значения этого последнего нейрона, код которого будет включён в приложенный файл. Ничего больше не меняйте, только обучающие значения. Делайте это, стараясь понять, что происходит. Это поможет легче понять то, о чём пойдёт речь в следующих статьях. Тем не менее, в этой статье не затронуты некоторые вопросы, что, возможно, несколько затруднит понимание математической части. Не беспокойтесь; мы вернёмся к этому вопросу в другой статье.
Перевод с португальского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/pt/articles/13841
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 За пределами GARCH (Часть II): Оценка фрактальной размерности рынков
 За пределами GARCH (Часть I): Сравнение моделей MMAR Мандельброта и GARCH Энгла
 GoertzelBrain: Адаптивное спектральное обнаружение циклов с помощью ансамбля нейронных сетей в MQL5
 Рыночная микроструктура в MQL5 (Часть 1): Надежный базовый слой

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования