

За пределами GARCH (Часть II): Оценка фрактальной размерности рынков
 141
 0

Введение
В первой части мы рассмотрели теоретические основы GARCH и мультифрактальной модели доходности активов (MMAR), загрузили пятиминутные данные EURUSD через Python API для MetaTrader 5 и проанализировали функцию разбиения, чтобы проверить наличие мультифрактального масштабирования. Результат был однозначным: при разных временных интервалах моменты доходностей масштабируются по степенному закону, что подтверждает наличие фрактальной структуры в данных.
Однако подтвердить наличие фрактальности — лишь первый шаг. Теперь нужно определить ее характеристики. В этой статье мы определим функцию масштабирования tau(q) по наклонам регрессий для функции разбиения, полученным в первой части. Затем оценим показатель Херста H методом R/S, проведем трехкомпонентную проверку на мультифрактальность и с помощью преобразования Лежандра получим из tau(q) мультифрактальный спектр f(alpha). Наконец, подгоним эмпирический спектр к четырем теоретическим распределениям — логнормальному, биномиальному, пуассоновскому и гамма-распределению — и выберем тип мультипликативного каскада, лучше всего соответствующий наблюдаемой структуре. К концу статьи у нас будут три компонента для построения процесса MMAR: показатель Херста, наиболее подходящий тип распределения и оцененные параметры этого распределения.
Перед реализацией разберем два ключевых понятия: показатель Херста и мультифрактальный спектр. В первой части мы кратко ввели оба понятия в рамках теории MMAR. Здесь они играют ключевую роль: чтобы понимать дальнейший код, важно знать не только их определения, но и их смысл.
Мы рассмотрим:
- Показатель Херста — память рынков
- Шаг 2 — извлечение функции масштабирования и показателя Херста
- Мультифрактальный спектр — как читать f(alpha)
- Шаг 3 — подгонка мультифрактального спектра
- Заключение
Показатель Херста — память рынков
В первой части мы ввели показатель Херста H как параметр памяти фракционного броуновского движения (FBM): при H = 0,5 получаем случайное блуждание, при H > 0,5 — персистентность, а при H < 0,5 — антиперсистентность. Этого было достаточно, чтобы понять роль H в уравнении мультифрактальной модели доходности активов (MMAR). Теперь мы оцениваем H по реальным данным и используем при построении модели. Поэтому важно разобраться, что означает этот показатель, как он возник и какова цена ошибки при его оценке.
Истоки — Херст и Нил
Показатель Херста назван в честь британского гидролога Гарольда Эдвина Херста, десятилетиями изучавшего Нил. В начале 1950-х годов Херст решал практическую инженерную задачу: какой должна быть вместимость водохранилища, чтобы обеспечить стабильное водоснабжение при непредсказуемых ежегодных разливах Нила? Традиционный статистический подход предполагал, что уровень паводка в каждом году не зависит от уровней прошлых лет и меняется по модели случайного блуждания. При таком допущении необходимую вместимость водохранилища можно было рассчитать методами теории вероятностей.
Однако Херст заметил закономерность, которую стандартная теория объяснить не могла. Изучая многовековые записи о разливах Нила, включая измерения нилометром на острове Рода, восходящие к VII веку, Херст обнаружил: размах накопленных отклонений от долгосрочного среднего рос быстрее квадратного корня из времени. Для независимых наблюдений отношение размаха R к стандартному отклонению S должно масштабироваться как n^0,5, где n — число наблюдений. Херст обнаружил, что R/S масштабируется как n^H, причем H составляет примерно 0,73 — существенно больше 0,5. Иными словами, влажные годы следовали за влажными, а засушливые — за засушливыми, чаще, чем можно было бы ожидать при случайном чередовании. У реки была долгая память.
Затем Херст проверил метод на десятках других геофизических временных рядов: данных о годичных кольцах деревьев, числе солнечных пятен, уровнях воды в озерах и осадках. Почти во всех случаях он получал значения H от 0,6 до 0,9. Явление встречалось настолько часто, что его назвали "феноменом Херста", а измеряющий его показатель получил имя ученого. Позднее Мандельброт дал этому теоретическое объяснение: фракционное броуновское движение (FBM) с параметром H естественным образом порождает такую дальнюю зависимость.
Геометрический смысл H
Показатель Херста определяет степень неровности траектории. Рассмотрим три траектории фракционного броуновского движения (FBM) длиной по 1 000 шагов, но с разными значениями H. При H = 0,3, в антиперсистентном случае, траектория сильно изрезана. За движением вверх с высокой вероятностью следует движение вниз. Поэтому траектория часто меняет направление и выглядит резко изрезанной. При H = 0,5, в случае обычного случайного блуждания, траектория умеренно неровная — как при последовательности подбрасываний монеты. При H = 0,7, в персистентном случае, траектория заметно более плавная. Движение вверх чаще продолжается в том же направлении, поэтому участки роста становятся длиннее, а колебания — плавнее. Траектория по-прежнему случайна, но ее движения становятся более протяженными и согласованными.
С математической точки зрения неровность траектории описывается ее регулярностью по Гельдеру. Траектория FBM с показателем Херста H почти наверное непрерывна по Гельдеру с показателем H: приращения за шаг delta_t масштабируются как delta_t^H. При большем H с увеличением шага приращения растут быстрее, и траектория охватывает большие участки более плавными движениями. При меньшем H приращения растут медленнее, траектория чаще меняет направление, а ее полная вариация выше. Геометрическая интерпретация важна для торговли: на персистентном рынке (H > 0,5) преимущество получают трендовые стратегии, а на антиперсистентном (H < 0,5) — стратегии возврата к среднему. При случайном блуждании (H = 0,5) ни один из этих подходов не получает преимущества, а кажущиеся закономерности представляют собой шум.
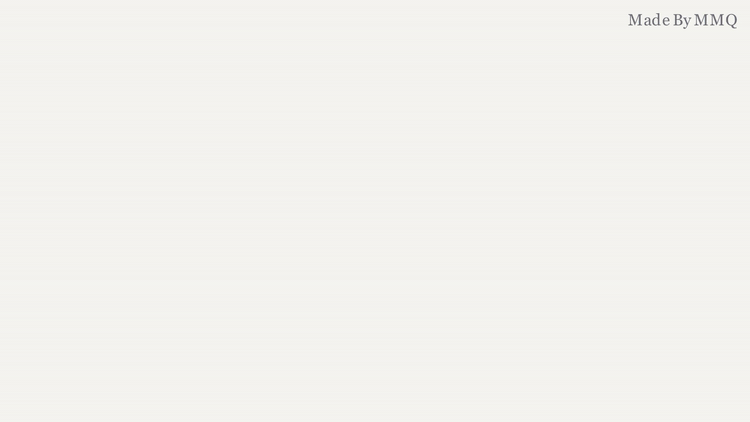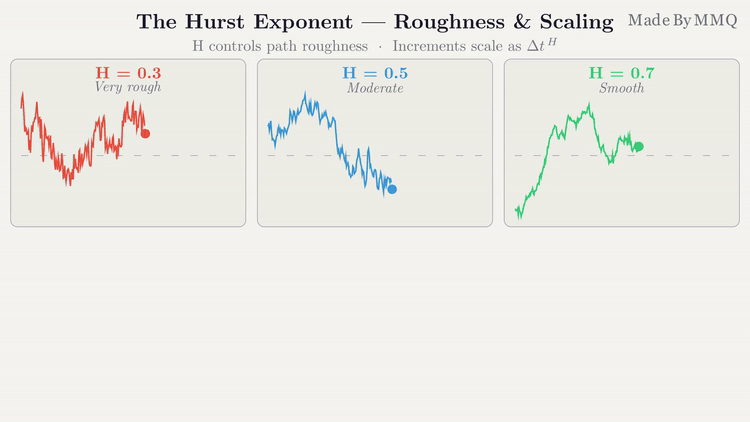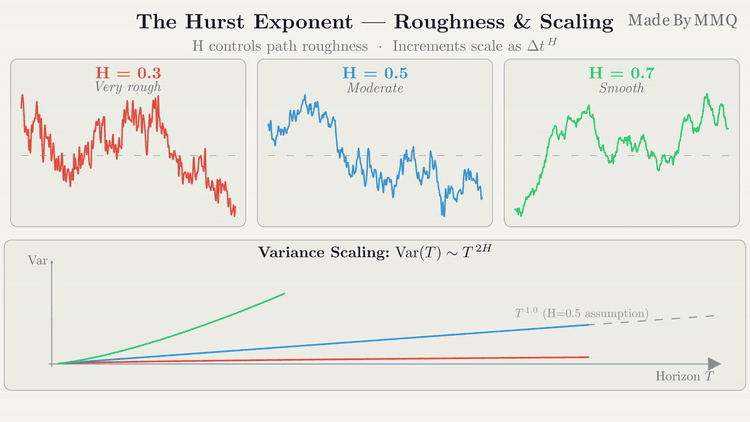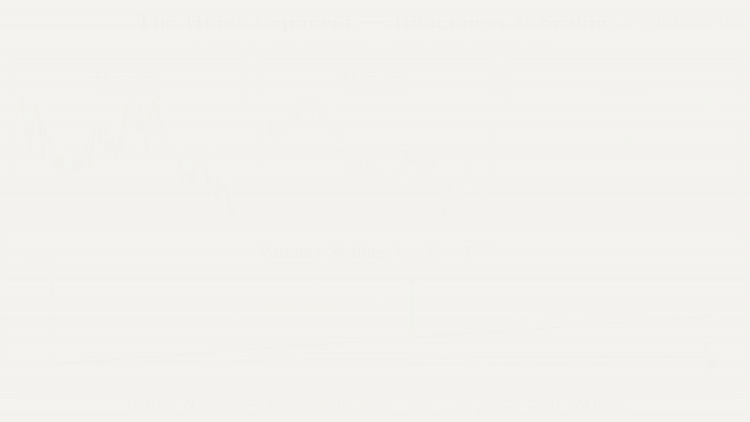
Рис. 1. Траектории FBM для H = 0,3 (антиперсистентный случай), H = 0,5 (случайное блуждание) и H = 0,7 (персистентный случай). Неровность траектории уменьшается по мере увеличения H.
Допущение H = 0,5 и его цена
Вся система классических количественных финансов опирается на допущение H = 0,5. Модель ценообразования опционов Блэка — Шоулза, гипотеза эффективного рынка в ее сильной форме и стандартные расчеты Value-at-Risk (VaR) исходят из независимости и одинакового распределения доходностей. Это эквивалентно стандартному броуновскому движению — FBM при H = 0,5. При таком допущении изменения цен не обладают памятью. Вчерашняя волатильность ничего не говорит о завтрашней. Так называемый "флэш-крэш" может произойти с одинаковой вероятностью и после спокойной, и после турбулентной недели.
Когда H отклоняется от 0,5, ошибки этих моделей становятся определенными и поддаются количественной оценке. При H > 0,5 (персистентность) дисперсия накопленной доходности на горизонте T масштабируется как T^(2H), а не как T. Даже при H = 0,55 за 100 периодов она составляет 100^1,1 = 158 против 100^1,0 = 100 при допущении о случайном блуждании. Это означает занижение оценки риска на 58% всего за 100 периодов. На более длинных горизонтах разрыв становится еще больше, поскольку влияние степенного показателя накапливается. Следовательно, модели риска с допущением H = 0,5 систематически занижают вероятность крупных просадок на средне- и долгосрочных горизонтах — именно там, где управление рисками особенно важно.
Напротив, при H < 0,5 (антиперсистентность) дисперсия растет медленнее T. Модели с допущением H = 0,5 завышают риск, из-за чего размер позиции выбирают чрезмерно осторожно и недополучают доходность. В обоих случаях неверная оценка H приводит к неправильной калибровке модели риска, причем ошибка растет вместе с горизонтом прогноза.
Локальный и глобальный H
Здесь есть важная тонкость, которая связывает показатель Херста с нашим мультифрактальным анализом. Оценивая H по временному ряду, мы получаем одно число — глобальный показатель Херста, отражающий среднее масштабирование на всем наборе данных. Однако мультифрактальному процессу нельзя приписать один показатель масштабирования для всех его участков. Участки временного ряда различаются по локальной регулярности: одни более гладкие (локально высокий H), другие более неровные (локально низкий H). Глобальный показатель H — это взвешенное среднее локальных показателей: он полезен, но не описывает всю картину.
Поэтому вводится мультифрактальный спектр f(alpha). Глобальный H дает одно число, а спектр показывает все разнообразие локальных показателей масштабирования. Если H одинаков во всех точках процесса, он монофрактален, а его спектр сводится к одной точке. Если H меняется от точки к точке, процесс мультифрактален, а его спектр выглядит как широкая кривая. Ширина кривой показывает разброс локальных показателей масштабирования — степень мультифрактальности. Так показатель Херста из раздела 2 связан с мультифрактальным спектром из раздела 4: глобальный H отражает среднюю структуру памяти, а спектр показывает, насколько она различается между участками данных. Для построения MMAR нужны оба показателя.
Шаг 2 — извлечение масштабной функции и показателя Херста
Подтвердив фрактальность и разобрав смысл показателя Херста, перейдем к определению двух ключевых величин: функции масштабирования tau(q) и самого H. Именно они определяют особенности мультифрактальной структуры наших данных. Функция масштабирования позволяет отличить мультифрактальные данные от монофрактальных, а показатель Херста определяет структуру долгой памяти компонента FBM.
Выделение tau(q)
Функция масштабирования определяется непосредственно по наклонам регрессий, полученным на первом этапе. Функция разбиения подчиняется степенному закону: S_q пропорциональна delta_t^(tau(q) + 1). Поскольку наклон регрессии в логарифмических координатах равен tau(q) + 1, функцию масштабирования можно получить так:
tau(q) = slope - 1
Класс ScalingExtractor получает готовый объект FractalityChecker из первого этапа и вычисляет tau(q) для всех значений q:
# step2_extract_scaling.py

class ScalingExtractor:
    def __init__(self, checker, verbose=config.VERBOSE):
        self.checker = checker
        self.verbose = verbose

        # Extract from checker
        self.q_values = np.array(sorted(checker.slopes.keys()))
        self.slopes = np.array([checker.slopes[q] for q in self.q_values])
        self.r_squared = np.array([checker.r_squared_values[q]
                                    for q in self.q_values])

        # Calculate tau(q) = slope - 1
        self.tau_q = self.slopes - 1

        self.H = None
        self.tau_q_func = None
Форма tau(q) показывает, с каким типом фрактального процесса мы имеем дело. Для монофрактального процесса, например случайного блуждания с дрейфом, функция tau(q) строго линейна: tau(q) = qH - 1. Это означает, что все моменты распределения масштабируются одинаково. Для мультифрактального процесса tau(q) вогнута: ее график изгибается вниз. Разные моменты масштабируются по-разному — это определяющий признак мультифрактального процесса. Если данные монофрактальны, мультифрактальная модель доходности активов (MMAR) не дает преимуществ перед более простыми моделями.
Проверка на мультифрактальность
Это один из важнейших этапов пайплайна: строгая проверка по трем критериям определяет, стоит ли применять MMAR. В нашей реализации выполняются три независимых теста, а их результаты объединяются в итоговую оценку от 0 до 9:
def check_multifractality(self):
    # Test 1: Concavity (second derivative of tau(q))
    d2_tau = np.diff(self.tau_q, 2)
    concave_pct = 100 * np.sum(d2_tau < 0) / len(d2_tau)
    mean_d2 = np.mean(d2_tau)

    if concave_pct >= 80:
        concavity_score = 3  # STRONGLY CONCAVE
    elif concave_pct >= 60:
        concavity_score = 2  # MODERATELY CONCAVE
    elif concave_pct >= 40:
        concavity_score = 1  # WEAKLY CONCAVE
    else:
        concavity_score = 0  # NOT CONCAVE
Тест 1 — вогнутость. Мы вычисляем вторые разности tau(q) — дискретное приближение второй производной. Для мультифрактального процесса большинство этих разностей должно быть отрицательным: это признак вогнутости. Мы определяем долю отрицательных вторых разностей. Если отрицательных вторых разностей 80% или больше, вогнутость выражена сильно (оценка 3). Если отрицательных вторых разностей меньше 40%, вогнутость не выявлена (оценка 0). Этот тест проверяет ключевое теоретическое предсказание: график tau(q) для мультифрактального процесса изгибается вниз.
    # Test 2: Compare with theoretical random walk
    q_range = self.q_values[self.q_values > 0]
    tau_range = self.tau_q[self.q_values > 0]

    from scipy.stats import linregress
    slope_linear, intercept_linear, r_value_linear, _, _ = linregress(
        q_range, tau_range
    )
    r2_linear = r_value_linear ** 2

    tau_linear_fit = slope_linear * q_range + intercept_linear
    rmse_from_linear = np.sqrt(np.mean((tau_range - tau_linear_fit)**2))

    if r2_linear > 0.99 and rmse_from_linear < 0.05:
        linearity_score = 0  # HIGHLY LINEAR (like random walk)
    elif r2_linear > 0.95:
        linearity_score = 1  # MOSTLY LINEAR (weakly multifractal)
    elif r2_linear > 0.90:
        linearity_score = 2  # MODERATELY NONLINEAR
    else:
        linearity_score = 3  # STRONGLY NONLINEAR
Тест 2 — отклонение от линейности. Мы аппроксимируем tau(q) прямой и оцениваем качество такой аппроксимации. Для случайного блуждания tau(q) = 0,5q - 1 — строго линейная функция (R² = 1,0). Чем сильнее tau(q) отклоняется от прямой, тем убедительнее признаки мультифрактальности. Если R² выше 0,99, а RMSE ниже 0,05, данные практически неотличимы от случайного блуждания по этому критерию (оценка 0). R² ниже 0,90 указывает на выраженную нелинейность (оценка 3).
    # Test 3: Range of local slopes (should vary for multifractals)
    d_tau = np.diff(self.tau_q)
    slope_range = np.ptp(d_tau)  # Peak-to-peak
    slope_std = np.std(d_tau)

    if slope_range > 0.5:
        variation_score = 3  # HIGH VARIATION
    elif slope_range > 0.3:
        variation_score = 2  # MODERATE VARIATION
    elif slope_range > 0.1:
        variation_score = 1  # LOW VARIATION
    else:
        variation_score = 0  # MINIMAL VARIATION (monofractal)

    total_score = concavity_score + linearity_score + variation_score
Тест 3 — вариация наклона. Мы вычисляем первые разности tau(q), характеризующие локальный наклон, и определяем их размах. Для монофрактального процесса функция линейна: локальные наклоны одинаковы, поэтому их размах равен нулю. Для мультифрактального процесса локальный наклон меняется вместе с q, поэтому размах ненулевой. Размах выше 0,5 означает сильное изменение наклона (оценка 3), а ниже 0,1 — поведение, близкое к монофрактальному (оценка 0).
Сводный балл интерпретируется следующим образом:
- Оценка 7-9 — выраженная мультифрактальность. MMAR настоятельно рекомендуется; можно уверенно продолжать.
- Оценка 5-6 — умеренная мультифрактальность. MMAR стоит попробовать; модель может превзойти GARCH.
- Оценка 3-4 — слабая мультифрактальность. Целесообразность MMAR неясна; GARCH может оказаться лучше.
- Оценка 0-2 — мультифрактальность отсутствует. MMAR не рекомендуется, поскольку данные слишком близки к случайному блужданию.
Так определяется строгий порог применимости MMAR. Модель MMAR не является универсальным инструментом: на немультифрактальных данных она дала бы прогнозы хуже GARCH и потребовала бы больше вычислительных ресурсов.
Оценка показателя Херста H
Показатель Херста H оценивается методом нормированного размаха (R/S) с помощью библиотеки nolds. В основе лежит метод, который Херст разработал для данных по Нилу; в современной реализации добавлены поправки на смещение из-за конечного размера выборки. Мы используем метод R/S, а не численный поиск точки, где tau(1/H) = 0: при зашумленных оценках tau(q) такой поиск может быть нестабильным. Метод R/S измеряет, как масштабируется размах накопленных отклонений от среднего, нормированный на стандартное отклонение:
def estimate_H_nolds(self):
    if not NOLDS_AVAILABLE:
        return None

    returns = self.checker.returns

    # corrected=True applies Anis-Lloyd-Peters correction
    # fit='RANSAC' is robust to outliers in R/S statistics
    H_nolds = nolds.hurst_rs(returns, fit='RANSAC', corrected=True)
    return H_nolds
Флаг corrected=True включает поправку Аниса — Ллойда — Питерса, устраняющую смещение статистики R/S, связанное с конечным размером выборки. Без этой поправки на коротких временных рядах оценка H обычно завышается. Флаг fit='RANSAC' применяет Random Sample Consensus вместо обычного метода наименьших квадратов, повышая устойчивость оценки к выбросам статистики R/S при отдельных размерах подвыборок.
Если библиотека nolds недоступна, резервный метод ищет точку, где tau(q) пересекает ноль. Теоретически tau(1/H) = 0, поэтому H = 1/q_zero, где q_zero — значение q в точке пересечения. Резервный вариант находит корень методом Брента по кубической сплайновой интерполяции tau(q). Если на рассчитанном диапазоне tau(q) не меняет знак и не пересекает ноль, для приближения берется ближайшая к нулю точка:
# Fallback: find where tau(q) = 0
self.tau_q_func = interp1d(self.q_values, self.tau_q,
                            kind='cubic',
                            fill_value='extrapolate',
                            bounds_error=False)

tau_min = self.tau_q_func(self.q_values.min())
tau_max = self.tau_q_func(self.q_values.max())

if tau_min * tau_max > 0:
    # No sign change - use closest point
    idx_closest = np.argmin(np.abs(self.tau_q))
    q_zero = self.q_values[idx_closest]
    self.H = 1.0 / q_zero
else:
    # Brent's method for root finding
    q_zero = brentq(self.tau_q_func, self.q_values.min(), self.q_values.max())
    self.H = 1.0 / q_zero
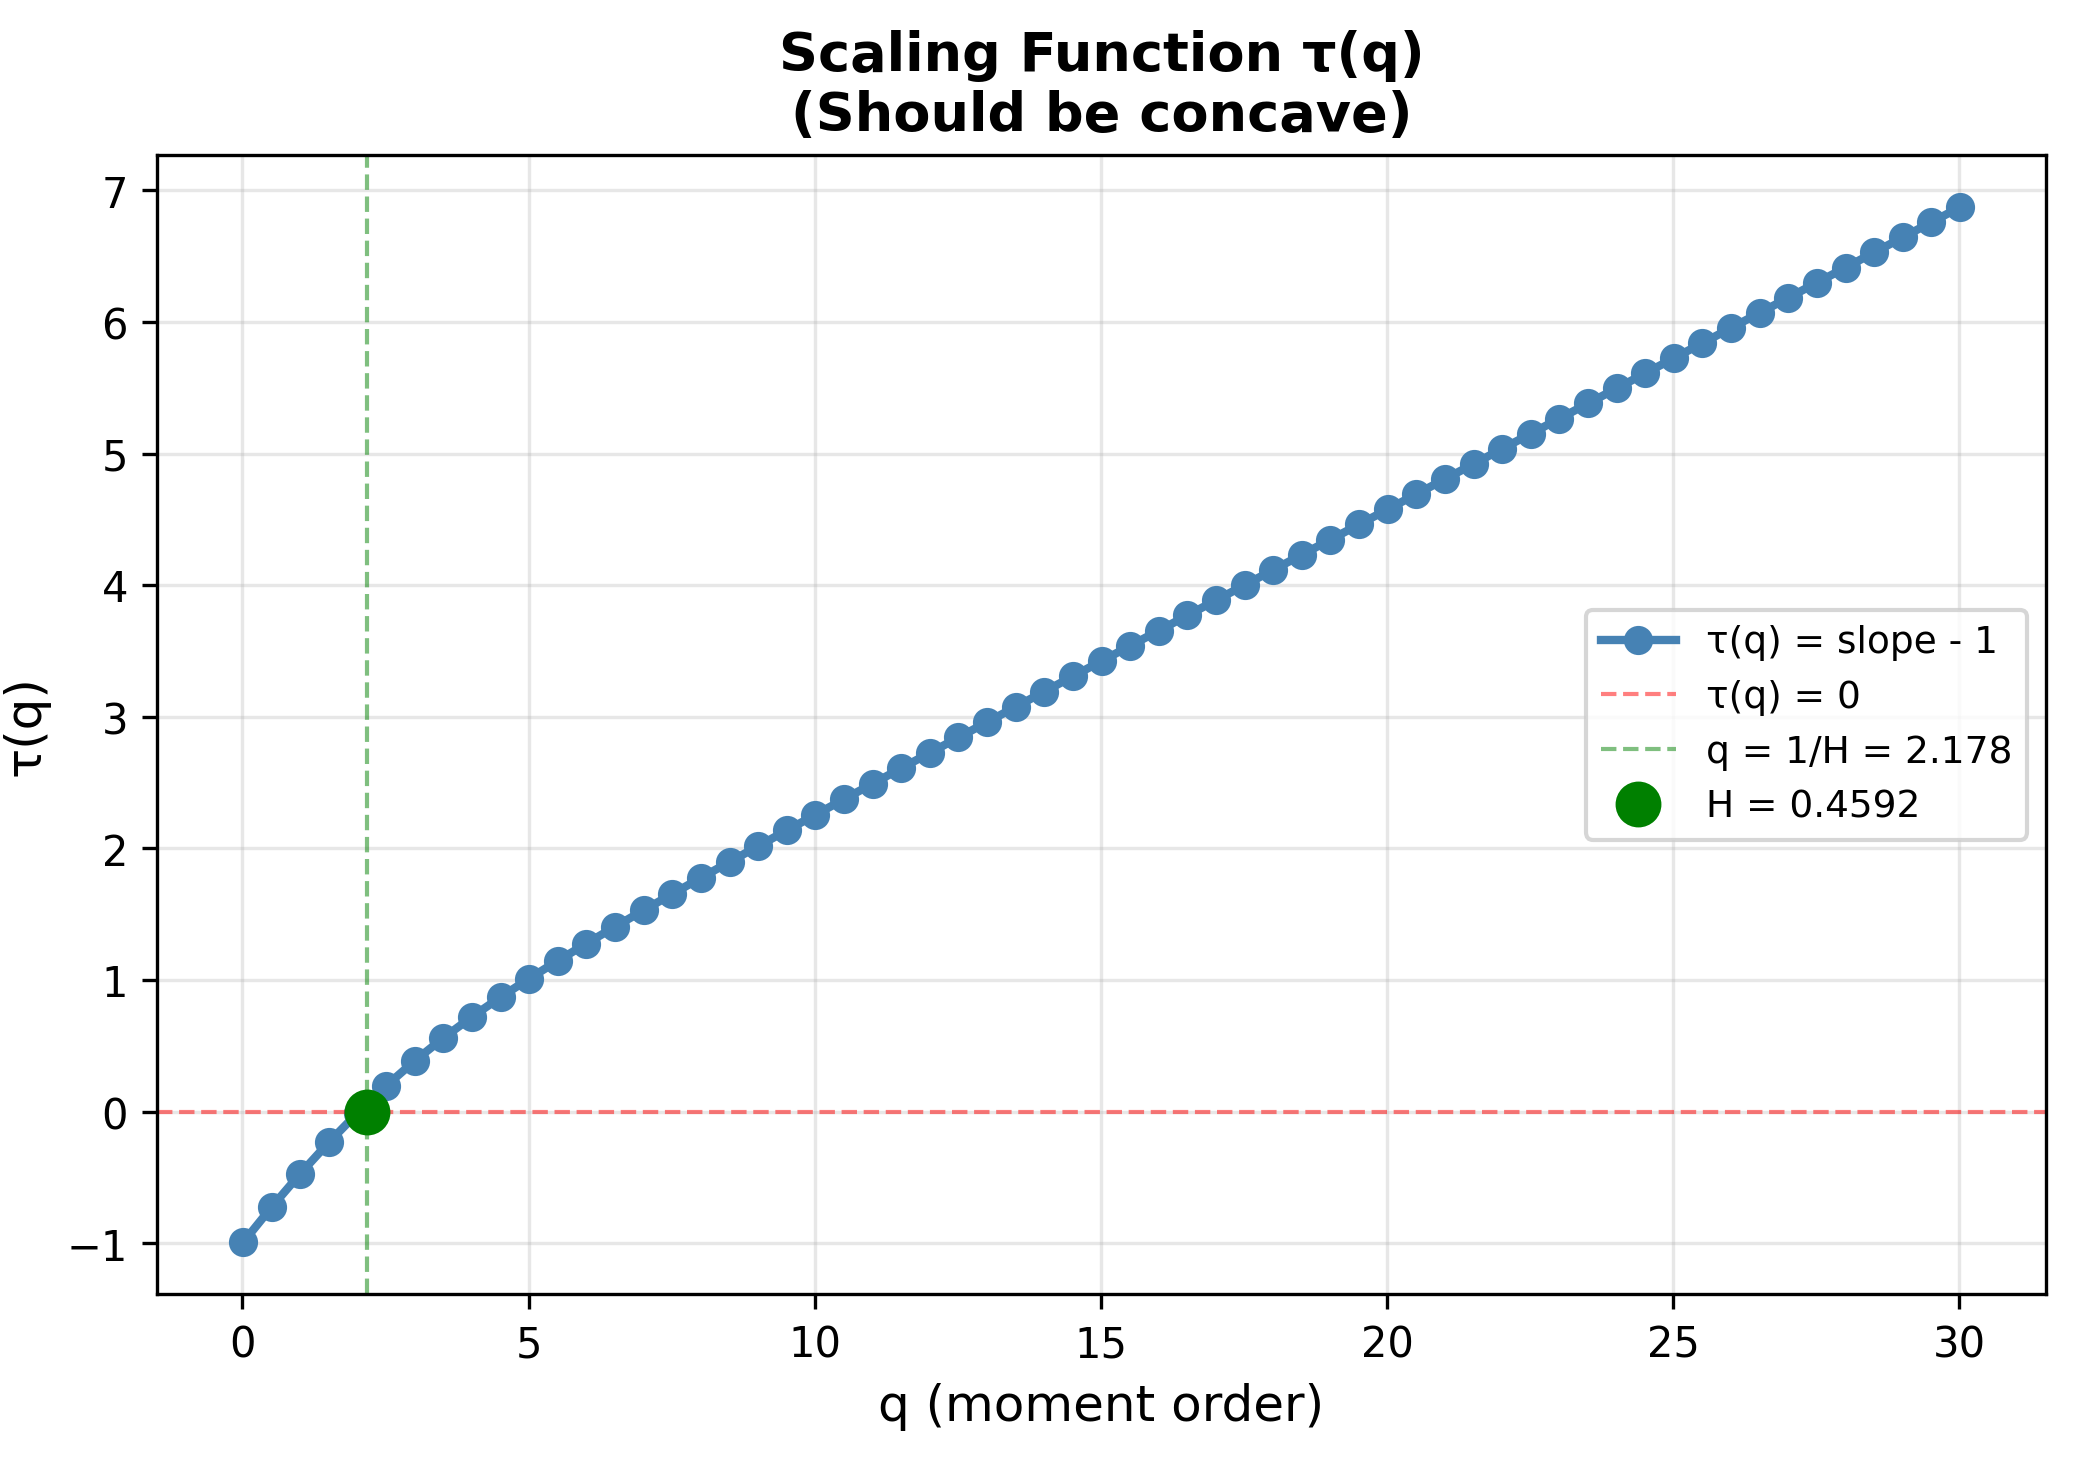
Рис. 2. Функция масштабирования tau(q) с отмеченным показателем Херста
Мультифрактальный спектр — как читать f(alpha)
Далее преобразуем функцию масштабирования tau(q) в мультифрактальный спектр f(alpha) и подгоним его к теоретическим распределениям. Но сначала разберемся, какую информацию дает спектр, а уже затем напишем код. В первой части мы упоминали преобразование Лежандра и кривую f(alpha) лишь как математический этап пайплайна MMAR. Теперь разберем смысл спектра: что его форма говорит о данных, почему важна его ширина и как применять спектр для диагностики.
Альфа — локальная регулярность в точке
Основа мультифрактального спектра — показатель Гельдера alpha, характеризующий локальную регулярность, или гладкость, функции в данной точке. Рассмотрим ряд цен. Иногда цена меняется постепенно и предсказуемо, поэтому график выглядит гладким. В другие моменты цена резко скачет, и график выглядит неровным, почти скачкообразным. Показатель Гельдера выражает это численно: большое alpha соответствует небольшим плавным изменениям цены в данной точке, а малое alpha — резким скачкам.
Точнее, alpha в точке t_0 характеризует масштабирование приращения цены на малом интервале delta_t вокруг этой точки: приращение масштабируется как delta_t^alpha. При alpha = 1 ценовая траектория локально непрерывна по Липшицу — столь же гладкая, как дифференцируемая функция. При alpha = 0,5 приращения цены масштабируются как при броуновском движении. При alpha < 0,5 ценовая траектория в данной точке будет более неровной, чем траектория броуновского движения: резкие изменения происходят особенно быстро для данного временного масштаба. В реальном финансовом ряду alpha меняется от точки к точке: для спокойных ночных периодов характерны высокие значения alpha и плавное движение, а для минут после выхода новостей — низкие значения и резкие колебания.
f(alpha) — фрактальная размерность множеств регулярности
Если alpha характеризует локальную регулярность в одной точке, то f(alpha) показывает, насколько широко такой уровень регулярности представлен во всем временном ряду. Точнее, f(alpha) — это размерность Хаусдорфа для множества точек t, в которых локальный показатель Гельдера равен alpha. Представьте, что мы собрали все точки ряда с локальной регулярностью alpha. Фрактальная размерность позволяет оценить "размер" полученного множества. Размерность Хаусдорфа, равная 1, означает, что множество заполняет одномерный интервал: соответствующее значение alpha встречается повсюду. Размерность 0 соответствует россыпи отдельных точек: такое значение alpha встречается крайне редко. Промежуточные значения от 0 до 1 соответствуют множествам разной степени разреженности.
Поэтому вершина спектра достигает уровня f = 1 или приближается к нему. Значение alpha на вершине спектра соответствует наиболее распространенному в данных уровню локальной регулярности — тому, который заполняет одномерный интервал времени. Другие значения alpha встречаются реже (f < 1). Чем дальше значение от вершины спектра, тем реже оно встречается и тем более разреженную фрактальное множество образует на временной оси.
Форма спектра — монофрактальность и мультифрактальность
Форма и ширина кривой f(alpha) показывают, насколько сложна структура масштабирования. У монофрактального процесса показатель масштабирования одинаков во всех точках. Во всех точках ряда локальный показатель Гельдера одинаков: alpha = H. Спектр сводится к точке (H, 1), поскольку этому значению alpha соответствует вся временная ось (f = 1). Стандартное броуновское движение монофрактально: alpha = H = 0,5. Обычное фракционное броуновское движение (FBM) без мультифрактального торгового времени тоже монофрактально.
Мультифрактальному процессу соответствует целый диапазон локальных показателей масштабирования. Значения alpha различаются от точки к точке, поэтому спектр выглядит как перевернутая парабола или, точнее, вогнутая кривая. Ширина кривой, равная alpha_max - alpha_min, непосредственно характеризует степень мультифрактальности. Узкий спектр с шириной, близкой к нулю, указывает на почти монофрактальные данные: участки масштабируются сходным образом, а волатильность относительно однородна. Широкий спектр охватывает и очень гладкие участки с высоким alpha, и очень неровные с низким alpha. Такая неоднородность масштабирования характерна для сложной кластеризации волатильности.
Для финансовых данных типичная ширина спектра составляет от 0,2 до 0,8. Ширина 0,2 указывает на слабую мультифрактальность и небольшую неоднородность волатильности. При ширине 0,8 мультифрактальность сильна: локальное поведение данных в разные моменты существенно различается. Для валютных инструментов, таких как EURUSD, ширина спектра обычно умеренная — от 0,3 до 0,5. В ней отражается сочетание спокойных азиатских сессий, волатильного открытия лондонской сессии и резких движений после выхода новостей.
Асимметрия спектра — левосторонняя и правосторонняя
Спектр не всегда симметричен. При левосторонней асимметрии левый хвост спектра, направленный к малым alpha, длиннее правого: резкие события разнообразнее спокойных периодов. На рынке это означает широкий разброс интенсивности обвалов при относительно однотипном поведении в спокойные периоды. Правосторонняя асимметрия с более длинным правым хвостом означает обратное: спокойные периоды разнообразнее, а экстремальные события более однотипны. Для большинства финансовых временных рядов характерна небольшая левосторонняя асимметрия: интенсивность всплесков волатильности различается сильнее, чем поведение в спокойные периоды.
Асимметрия также помогает понять, какой режим преобладает в мультифрактальной структуре данных. Если левая ветвь спектра, связанная с большими положительными q в преобразовании Лежандра, развита сильнее, масштабирование при экстремальных доходностях оказывается более разнообразным. Если сильнее развита правая ветвь, связанная с малыми значениями q около нуля, разнообразие масштабирования проявляется в небольших колебаниях.
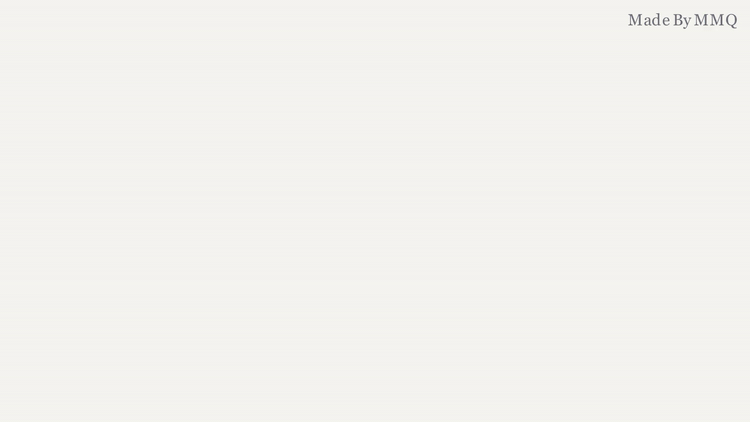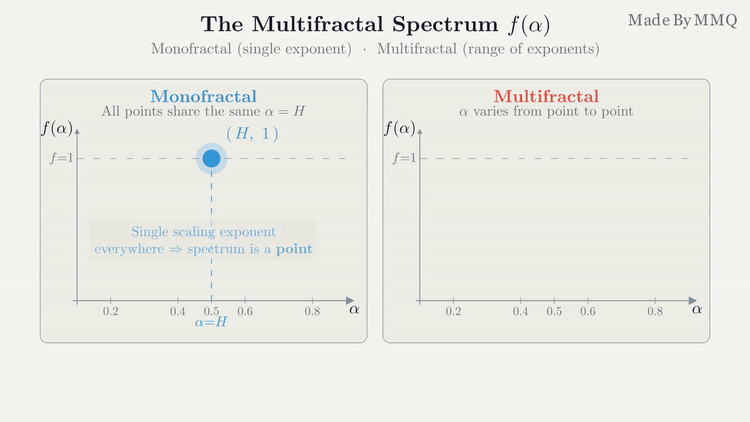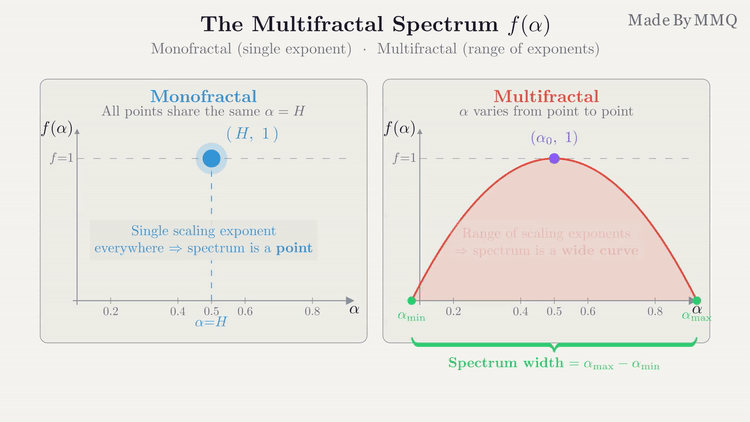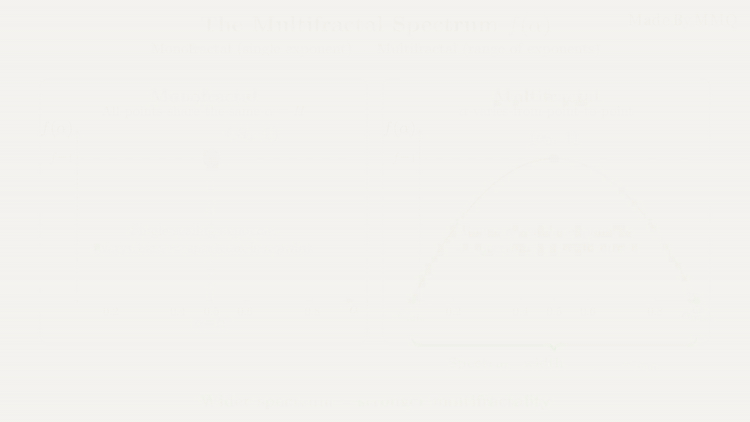
Рис. 3. Монофрактальный спектр — одна точка, мультифрактальный — широкая парабола с ветвями вниз. Ширина характеризует степень мультифрактальности.
В четвертом разделе эта интерпретация поможет подобрать теоретический каскад по эмпирическому спектру. Мы подгоняем кривую не ради самой подгонки. Мы выясняем, какая теоретическая модель каскада воспроизводит наблюдаемую форму f(alpha): ширину спектра, положение пика и асимметрию. Эта форма — своего рода отпечаток того, как волатильность организуется между масштабами.
Шаг 3 — подгонка мультифрактального спектра
Теперь нужно определить, к какому типу мультифракталов относятся наши данные. Не все мультифракталы одинаковы. Они различаются распределением локальных сингулярностей. От него зависит, как мы будем выбирать множители при построении каскада на четвертом этапе. С помощью преобразования Лежандра мы получаем из функции масштабирования tau(q) мультифрактальный спектр f(alpha), а затем подгоняем эмпирический спектр к четырем теоретическим распределениям.
Преобразование Лежандра — от tau(q) к f(alpha)
Преобразование Лежандра переводит описание из пространства q — порядков моментов — в пространство alpha — показателей сингулярности. Преобразование задается следующим образом:
alpha(q) = d(tau)/dq
f(alpha) = alpha * q - tau(q)
Здесь alpha — локальный показатель Гельдера, описанный в третьем разделе. Он характеризует регулярность функции в точке: малое alpha соответствует неровному поведению, большое — гладкому. Функция f(alpha) задает размерность Хаусдорфа множества точек с данным уровнем регулярности. Производная tau(q) по q дает локальный показатель масштабирования alpha: он указывает, какая степень сингулярности преобладает при данном порядке момента. Соотношение f(alpha) = alpha * q - tau(q) дает размерность соответствующего множества сингулярностей.
В реализации alpha вычисляется численно по центральным разностям соседних значений tau(q):
# step3_fit_spectrum.py

def compute_multifractal_spectrum(self):
    alpha_values = []
    f_alpha_values = []
    q_for_spectrum = []

    q_values = self.extractor.q_values
    tau_q = self.extractor.tau_q

    for i, q in enumerate(q_values):
        if q < 0.5:  # Skip very small q (numerical issues)
            continue
        if i == 0 or i == len(q_values) - 1:  # Skip edge points
            continue

        # Central difference: d(tau)/dq
        q_prev = q_values[i-1]
        q_next = q_values[i+1]
        tau_prev = tau_q[i-1]
        tau_next = tau_q[i+1]

        alpha = (tau_next - tau_prev) / (q_next - q_prev)
        f_alpha = alpha * q - tau_q[i]

        if np.isfinite(alpha) and np.isfinite(f_alpha):
            alpha_values.append(alpha)
            f_alpha_values.append(f_alpha)

    self.alpha_values = np.array(alpha_values)
    self.f_alpha_values = np.array(f_alpha_values)
Обратите внимание на две важные детали. Во-первых, мы исключаем значения q ниже 0,5: вблизи q = 0 численная оценка производной tau(q) нестабильна, поскольку малые знаменатели усиливают шум. Во-вторых, мы пропускаем граничные точки, для которых нельзя вычислить центральную разность. Эти проверки не дают значениям NaN и Inf попасть в расчет спектра.
Подгонка к четырем теоретическим распределениям
По методике из приложения B к работе Чжана мы подгоняем эмпирический спектр к четырем теоретическим распределениям; каждому соответствует свой тип мультипликативного каскада. Для каждого распределения есть формула f(alpha) в замкнутом виде. Лучший вариант выбираем по минимальной сумме квадратов ошибок. Давайте рассмотрим каждое распределение и разберемся, что оно означает для мультифрактальной структуры рынка.
1. Логнормальное распределение
def normal_spectrum(self, alpha, alpha_0, H):
    denominator = 4 * H * (alpha_0 - H)
    if denominator <= 0:
        return np.full_like(alpha, -np.inf)
    return 1 - (alpha - alpha_0)**2 / denominator
В результате получается параболический спектр с центром в alpha_0 — наиболее распространенном показателе сингулярности. Единственный параметр alpha_0 определяет и центр, и ширину параболы. Ограничение alpha_0 > H нужно для положительности знаменателя: при alpha_0, равном H или меньшем него, спектр вырождается. В логнормальном каскаде величины множителей выбираются из логнормального распределения. Торговая активность при этом представляется произведением множества независимых случайных факторов на каждом уровне каскада — следствием применения центральной предельной теоремы к логарифмам множителей.
2. Биномиальное распределение
def binomial_spectrum(self, alpha, alpha_min, alpha_max):
    if alpha_max <= alpha_min:
        return np.full_like(alpha, -np.inf)

    alpha = np.clip(alpha, alpha_min + 1e-10, alpha_max - 1e-10)

    term1_ratio = (alpha_max - alpha) / (alpha_max - alpha_min)
    term2_ratio = (alpha - alpha_min) / (alpha_max - alpha_min)

    term1_ratio = np.maximum(term1_ratio, 1e-10)
    term2_ratio = np.maximum(term2_ratio, 1e-10)

    f = -(term1_ratio * np.log2(term1_ratio)
          + term2_ratio * np.log2(term2_ratio))
    return f
Биномиальный спектр задают два параметра: alpha_min и alpha_max. Это простейший каскад: на каждом уровне множитель с равной вероятностью принимает одно из двух значений. Так получается симметричный спектр в пределах от alpha_min до alpha_max. Проверки с np.clip и epsilon предотвращают вычисление log(0) на границах. Биномиальный каскад описывает переключение рыночной активности между двумя режимами — высоким и низким. Модель груба, но иногда эффективна.
3. Распределение Пуассона
def poisson_spectrum(self, alpha, alpha_0, H, b=2):
    if alpha_0 <= 0:
        return np.full_like(alpha, -np.inf)

    alpha = np.maximum(alpha, 1e-10)

    term1 = 1 - alpha_0 / (H * np.log(b))
    term2 = (alpha / H) * (np.log(alpha_0 * np.e / alpha) / np.log(b))
    return term1 + term2
Спектр Пуассона задается одним параметром, alpha_0, и асимметричен: с одной стороны он резко обрывается. Такой каскад допускает редкое появление экстремальных множителей по процессу Пуассона. Такой каскад может описывать рынки, где всплески волатильности связаны с отдельными различимыми событиями — публикациями отчетности или изменениями политики, — а не с непрерывными колебаниями.
4. Гамма-распределение
def gamma_spectrum(self, alpha, alpha_0, gamma, b=2):
    if alpha_0 <= 0 or gamma <= 0:
        return np.full_like(alpha, -np.inf)

    alpha = np.maximum(alpha, 1e-10)

    term1 = gamma * np.log(alpha / alpha_0) / np.log(b)
    term2 = gamma * (alpha_0 - alpha) / (alpha_0 * np.log(b))
    return 1 + term1 + term2
У спектра гамма-распределения два параметра — alpha_0 и gamma; среди четырех вариантов он наиболее гибкий. Параметр gamma меняет форму спектра независимо от положения его центра, позволяя получать и симметричные, и асимметричные кривые. Благодаря гибкости гамма-распределение нередко дает лучшую подгонку, но для надежной оценки двух параметров требуется больше данных.
Выбор распределения
Все четыре распределения подгоняются методом L-BFGS-B с ограничениями на параметры: минимизируется сумма квадратов расхождений между теоретическим и эмпирическим спектрами. Выбирается распределение с минимальной SSE:
def fit_all_distributions(self):
    distributions = {
        'Normal': self.fit_normal_distribution,
        'Binomial': self.fit_binomial_distribution,
        'Poisson': self.fit_poisson_distribution,
        'Gamma': self.fit_gamma_distribution
    }

    for name, fit_func in distributions.items():
        try:
            params, sse = fit_func()
            self.fitted_distributions[name] = {
                'params': params,
                'sse': sse,
                'rmse': np.sqrt(sse / len(self.alpha_values))
            }
        except Exception as e:
            self.fitted_distributions[name] = None

    valid_dists = {k: v for k, v in self.fitted_distributions.items()
                   if v is not None}
    self.best_distribution = min(
        valid_dists.keys(), key=lambda k: valid_dists[k]['sse']
    )
    self.best_params = valid_dists[self.best_distribution]['params']
Каждая функция подгонки заключена в блок try/except. Если распределение не удается подогнать, его исключают из сравнения. Например, подгонка логнормального распределения невозможна при alpha_0 ниже H: знаменатель становится отрицательным. Благодаря обработке ошибки пайплайн не прерывается, если одно из распределений плохо поддается подгонке.
Выбранное распределение и его параметры сохраняются в объекте SpectrumFitter. На четвертом этапе по ним выбирают множители каскада.
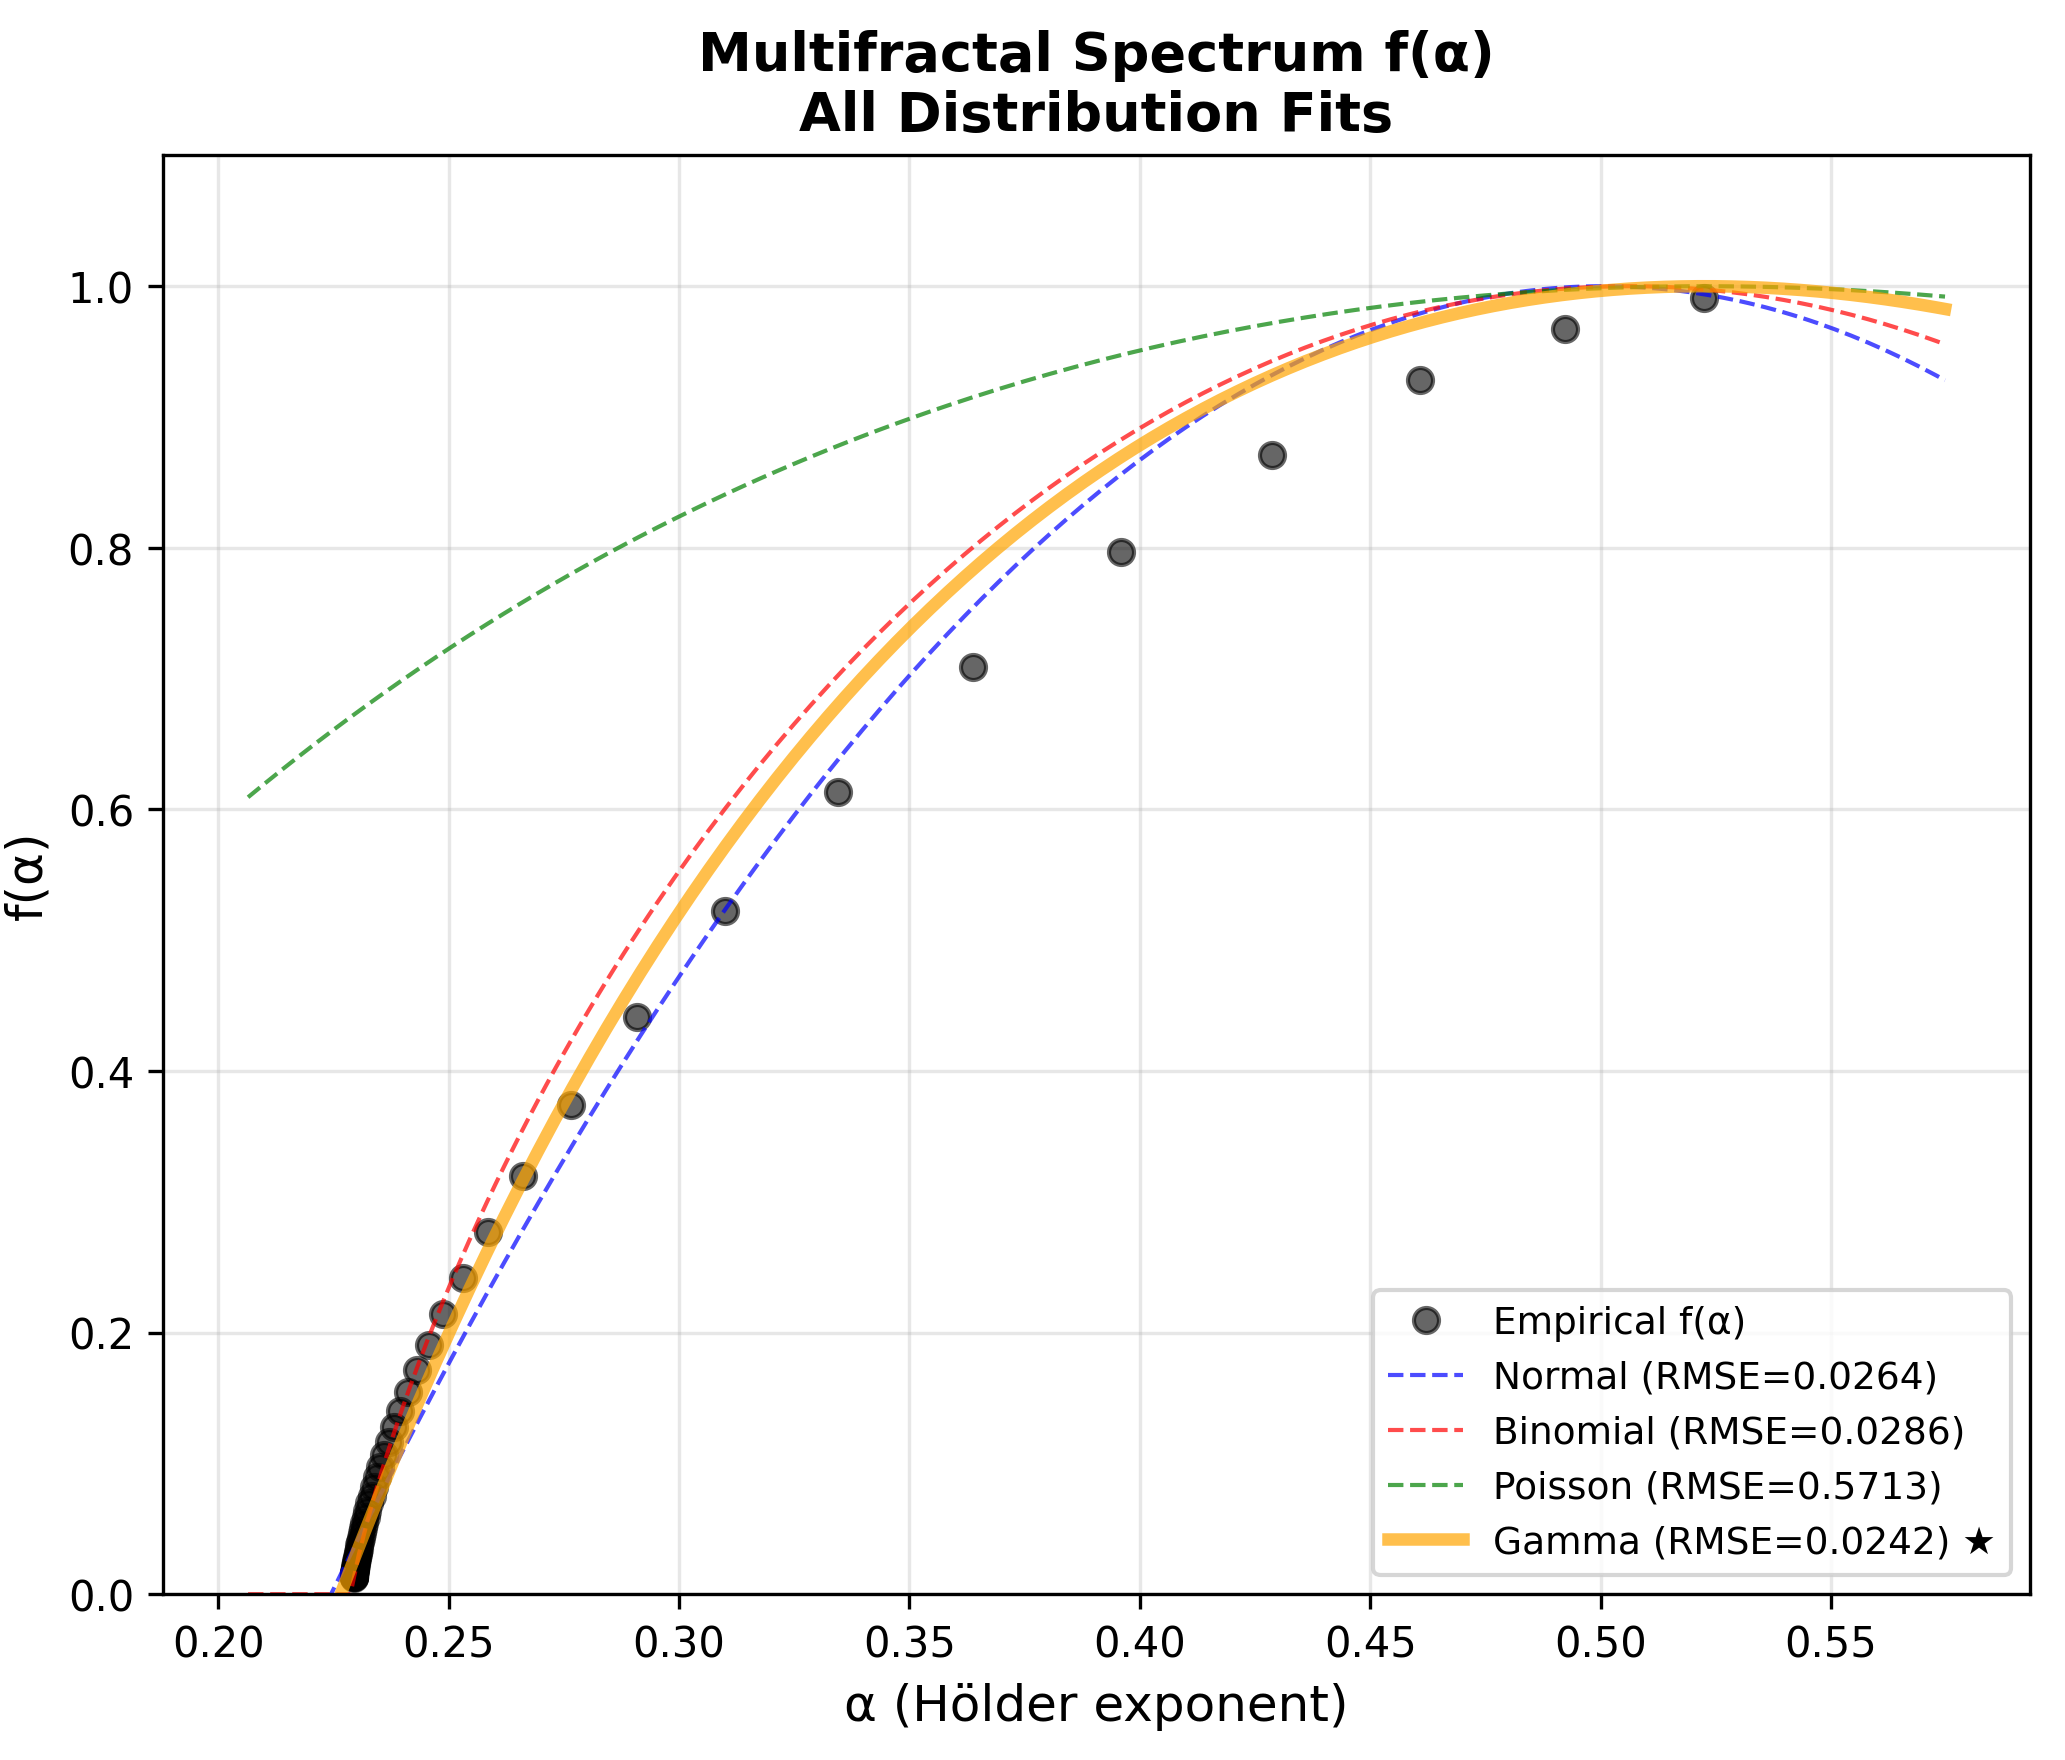
Рис. 4. Эмпирический мультифрактальный спектр f(alpha) с наложенными кривыми подгонки для четырех теоретических распределений
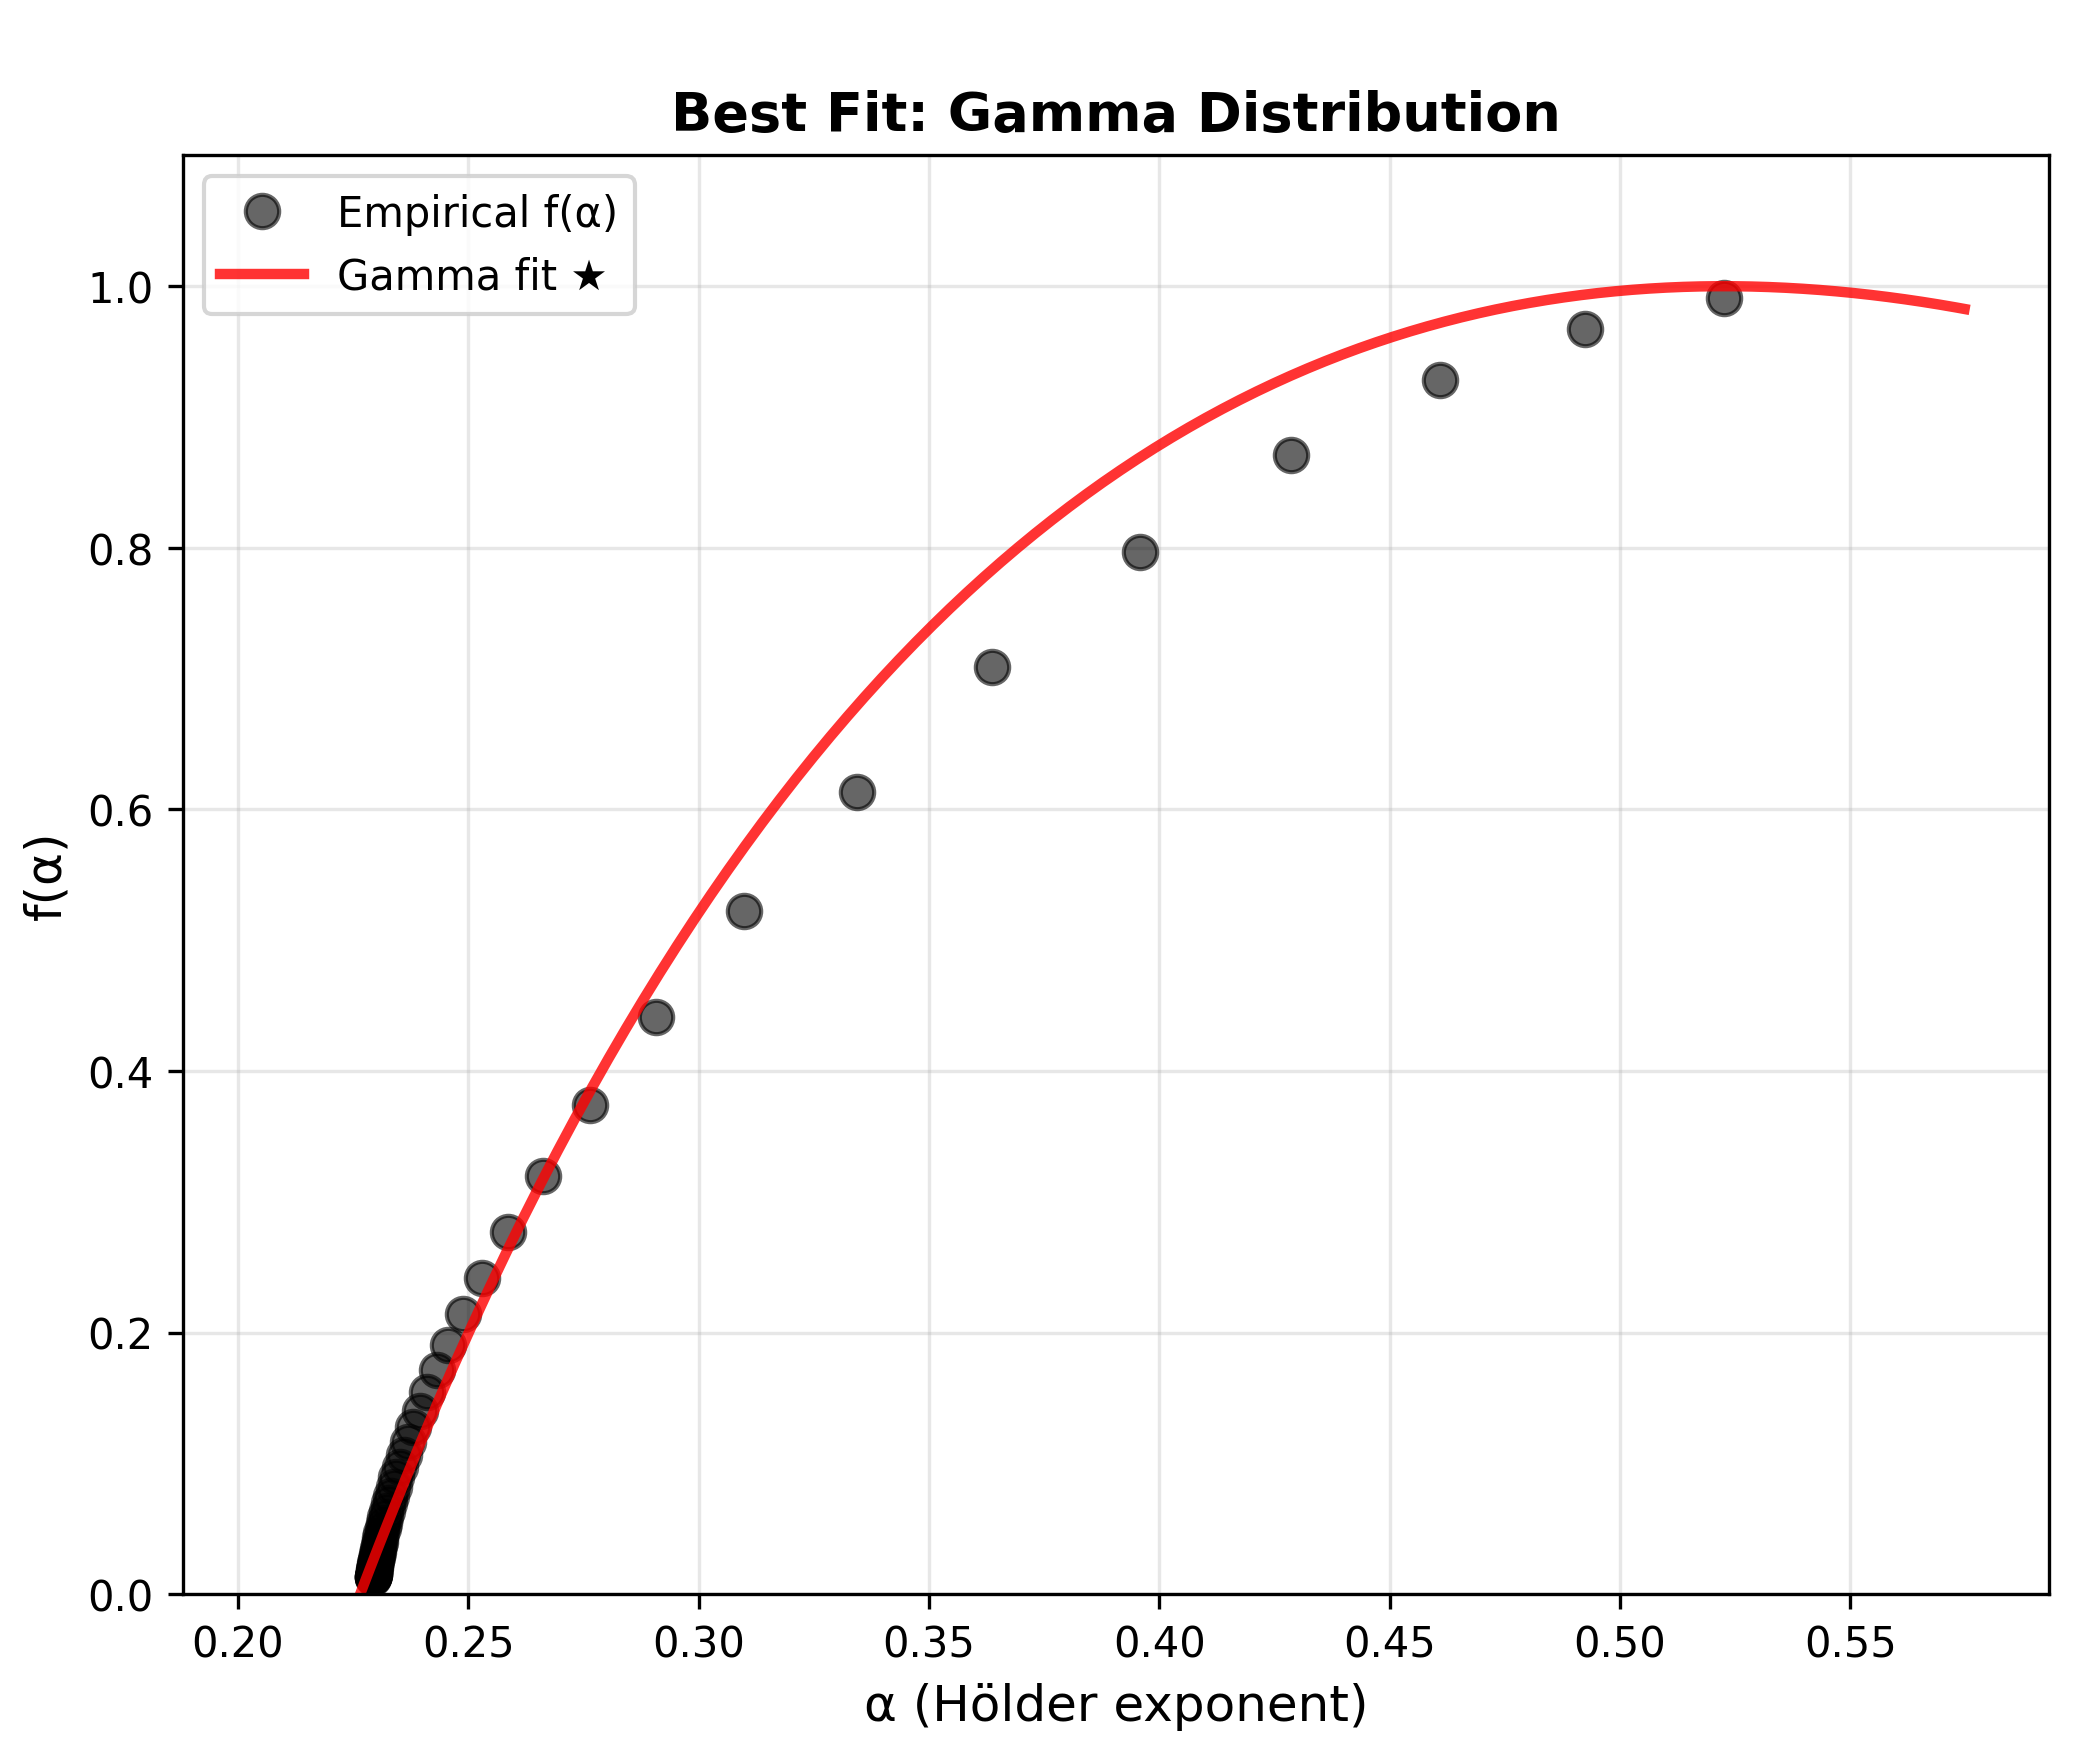
Рис. 5. Распределение с наилучшей подгонкой, выбранное по минимальной сумме квадратов ошибок
Заключение
В этой статье мы взяли результаты анализа функции разбиения из первой части и определили величины, характеризующие мультифрактальную структуру наших данных. Вот что мы установили:
- Показатель Херста — больше, чем просто параметр. Он описывает структуру памяти рынка — от исходных исследований Херста на данных Нила до роли показателя, определяющего неровность траектории во фракционном броуновском движении (FBM). Допущение H = 0,5 в классических финансовых моделях — в том числе модели Блэка — Шоулза и гипотезе эффективного рынка (EMH) — систематически искажает оценку риска, если фактическое H иное. Ошибка растет с горизонтом прогноза.
- Мультифрактальность бывает разной степени. Трехкомпонентная оценка на втором этапе — по вогнутости, отклонению от линейности и вариации наклона — дает больше, чем ответ "да" или "нет". Она показывает степень мультифрактальности данных и помогает обоснованно выбрать модель.
- Спектр — это отпечаток, а не просто кривая. Мультифрактальный спектр f(alpha) показывает распределение локальных показателей масштабирования: ширина характеризует степень мультифрактальности, пик соответствует преобладающей регулярности, а асимметрия показывает, где разнообразие сильнее — при экстремальных событиях или в спокойные периоды. Подгонка к четырем теоретическим распределениям — логнормальному, биномиальному, пуассоновскому и гамма-распределению — помогает выбрать тип каскада, который лучше всего воспроизводит этот отпечаток.
- Теперь у нас есть все необходимое. Показатель Херста H, тип наиболее подходящего распределения и его параметры — три компонента для построения процесса MMAR. Эти параметры не выбираются произвольно: они определяются по данным в аналитическом пайплайне, построенном в первой и второй частях.
Анализ, проведенный в первой и второй частях, не факультативен. Этот анализ служит строгим порогом применимости: еще до затратных вычислений можно определить, стоит ли строить MMAR и, если да, какие именно параметры для этого нужны.
В третьей части серии мы применим найденные параметры на практике. Мы построим мультипликативный каскад для формирования мультифрактального торгового времени, сгенерируем фракционное броуновское движение (FBM) алгоритмом Дэвиса — Харта, объединим их в составной процесс MMAR и проведем 1 000 прогонов методом Монте-Карло для прогноза волатильности. Затем построим GARCH(1,1) на тех же обучающих данных и напрямую сравним прогнозы обеих моделей с реализованной волатильностью. Наконец мы получим ответ на поставленный здесь вопрос: превосходят ли фракталы эконометрику в прогнозировании волатильности.
Отказ от ответственности: эта статья предназначена исключительно для образовательных и исследовательских целей. Представленные здесь модели и программный код основаны на научных исследованиях и не должны рассматриваться как финансовые рекомендации. Прогнозирование волатильности по своей природе сопряжено с неопределенностью. Прежде чем рисковать реальными деньгами, всегда проверяйте модели на вневыборочных данных и тестируйте их на демо-счетах.
Как получить исходный код через MQL5 Algo Forge
Все исходные файлы приложены к статье ниже. Полный репозиторий также доступен на MQL5 Algo Forge — платформе сообщества на базе Git для обмена торговыми проектами и совместной работы над ними. Algo Forge хранит историю версий локально и в облаке, поэтому вам будет доступна актуальная версия кода, в том числе обновления и исправления, внесенные после публикации статьи.
Чтобы клонировать репозиторий, откройте командную строку, PowerShell или терминал, встроенный в ваш редактор кода, и выполните команду:
git clone https://forge.mql5.io/ayantrader/MMAR.git
Для этого на вашем компьютере должен быть установлен Git. Если вы работаете в Visual Studio Code, откройте встроенный терминал сочетанием клавиш Ctrl+` и выполните команду прямо в нем. Репозиторий будет клонирован в папку MMAR в текущем каталоге.
Кроме того, проект можно просматривать по адресу forge.mql5.io/ayantrader/MMAR: исходные файлы, историю коммитов и обновления можно открыть прямо в браузере. В отличие от приложенных файлов, Algo Forge дает доступ ко всей истории Git и позволяет загружать будущие обновления одной командой:
git pull
| Имя файла | Описание |
|---|---|
| config.py | Параметры конфигурации, вспомогательные функции и проверка данных для всего пайплайна |
| data_loader.py | Загрузка данных из MetaTrader 5 с резервной загрузкой из CSV, расчет доходностей и проверка качества данных |
| utils.py | Общие служебные функции: скользящие окна, расчет волатильности и автокорреляции, таймер, экспорт в JSON |
| step1_check_fractality.py | Анализ функции разбиения на неперекрывающихся интервалах, оценка коэффициента детерминации R², поиск кроссовера |
| step2_extract_scaling.py | Извлечение функции масштабирования, оценка показателя Херста (метод R/S через nolds и резервный метод Брента), трехкомпонентная проверка на мультифрактальность |
| step3_fit_spectrum.py | Преобразование Лежандра, подгонка к четырем распределениям — логнормальному, биномиальному, пуассоновскому и гамма-распределению, оптимизация методом L-BFGS-B |
| run_step1.py | Скрипт запуска: загружает данные, проверяет их на фрактальность и сохраняет FractalityChecker для второго этапа |
| run_step2.py | Скрипт запуска: загружает результаты первого этапа, определяет функцию масштабирования и показатель Херста, проводит проверку на мультифрактальность |
| run_step3.py | Скрипт запуска: загружает результаты второго этапа, вычисляет мультифрактальный спектр и подгоняет его к четырем распределениям |
| requirements.txt | Зависимости Python |
Дополнительная литература:
- A Multifractal Model of Asset Returns — Benoit Mandelbrot, Adlai Fisher, Laurent Calvet, 1997
- Generalized autoregressive conditional heteroskedasticity — Tim Bollerslev, 1986
- Volatility Forecasting with the Multifractal Model of Asset Returns — Terrence Y. Zhang, 2017
- Dynamic Conditional Correlation - a Simple Class of Multivariate GARCH Models — Robert F. Engle, 2000
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22484
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


