

За пределами GARCH (Часть III): Построение MMAR и вердикт
 28
 0

Введение
В первой части серии мы рассмотрели теоретические основы GARCH и MMAR, загрузили данные EURUSD на пятиминутном таймфрейме и с помощью анализа функции разбиения подтвердили наличие мультифрактального масштабирования. Во второй части мы определили функцию масштабирования tau(q), оценили показатель Херста H, провели строгую проверку на мультифрактальность и подогнали мультифрактальный спектр к четырем теоретическим распределениям. Результат: данные действительно мультифрактальны, и у нас есть параметры для построения полного процесса MMAR — показатель Херста, лучший по результатам подгонки тип распределения и оцененные коэффициенты этого распределения.
В этой статье мы применяем эти параметры на практике. Мы строим два компонента MMAR: мультипликативный каскад, создающий мультифрактальное торговое время — "деформированные часы", преобразующие равномерное время в рыночное, — и фракционное броуновское движение, задающее структуру с долгой памятью. Мы объединяем их в составной процесс X(t) = B_H[theta(t)]. Затем проводим 1 000 прогонов моделирования методом Монте-Карло, чтобы получить прогноз волатильности. На тех же обучающих данных мы затем оцениваем модель GARCH(1,1). Наконец, напрямую сравниваем прогнозы обеих моделей с реализованной волатильностью. Никаких уловок и выборочной демонстрации удобных результатов — только честное сравнение.
Мы рассмотрим следующие темы:
- Шаг 4 — построение мультифрактального торгового времени
- Шаг 5 — генерация фракционного броуновского движения
- Шаг 6 — уравнение MMAR оживает
- Шаг 7 — прогнозирование методом Монте-Карло
- Реализация модели GARCH
- Решающее сравнение — результаты
- Заключение
Шаг 4 — построение мультифрактального торгового времени
Подогнав мультифрактальный спектр и выбрав тип распределения, мы строим первый компонент MMAR — мультифрактальное торговое время theta(t). Это и есть "деформированные часы": они меняют ход времени для FBM, создавая кластеризацию волатильности и тяжелые хвосты распределения.
Алгоритм мультипликативного каскада
Мультипликативный каскад — итеративный процесс построения мультифрактальной меры: распределения "массы" по интервалам с самоподобной кластеризацией. Алгоритм работает следующим образом:
- Инициализация — начинаем с одного интервала [0, 1], для которого масса равна 1.
- Для каждого уровня каскада (k от 1 до 10):
- каждый существующий интервал делится на b = 2 подинтервала;
- для каждой пары дочерних интервалов случайным образом выбираем b = 2 множителя из распределения, выбранного на третьем этапе;
- нормализуем множители так, чтобы сумма каждой пары равнялась b = 2 и при разбиении сохранялась общая масса;
- каждому дочернему интервалу присваиваем массу родительского интервала, умноженную на соответствующий множитель.
- Нормализуем итоговую меру до единичной массы.
- Интеграция — накопленная сумма дает theta(t).
После k = 10 уровней получаем 2^10 = 1 024 интервала. Масса распределена крайне неравномерно: в одних интервалах ее много — это периоды высокой волатильности, — а в других почти нет — это спокойные периоды. Неоднородность возникает из-за мультипликативной структуры каскада: большая масса, полученная на раннем уровне, может далее умножаться на крупные множители, усиливая первоначальную асимметрию.
# step4_generate_cascade.py

class CascadeGenerator:
    def __init__(self, fitter, b=2, k=10, verbose=config.VERBOSE):
        self.fitter = fitter
        self.b = b
        self.k = k
        self.H = fitter.H
        self.best_distribution = fitter.best_distribution
        self.best_params = fitter.best_params
        self.measure = None
        self.trading_time = None
        self.n_points = b**k

    def generate_cascade(self):
        measure = np.array([1.0])

        for level in range(self.k):
            n_intervals = len(measure)
            new_measure = np.zeros(n_intervals * self.b)
            multipliers = self.sample_multipliers(n_intervals * self.b)

            for i in range(n_intervals):
                parent_mass = measure[i]
                for j in range(self.b):
                    child_idx = i * self.b + j
                    new_measure[child_idx] = parent_mass * multipliers[child_idx]
            measure = new_measure

        self.measure = measure
        self.measure = self.measure / self.measure.sum()
        return self.measure
Выборка множителей
При выборке множителей распределение, выбранное на третьем этапе, используется для построения каскада. Каждый множитель M вычисляется по случайной величине V: M = b^(-V), где V выбирается из подобранного распределения. При преобразовании V в M положительной случайной величине сопоставляется множитель от 0 до бесконечности. Чем больше V, тем меньше M и тем меньшая масса достается дочернему интервалу.
def sample_multipliers(self, n_samples):
    params = self.best_params

    if self.best_distribution == 'Normal':
        alpha_0 = params['alpha_0']
        mu = alpha_0 / self.H
        variance = 2 * (alpha_0 / self.H - 1) * np.log(self.b)
        if variance <= 0:
            variance = 0.01
        sigma = np.sqrt(variance)
        V = np.random.normal(mu, sigma, n_samples)

    elif self.best_distribution == 'Binomial':
        alpha_min = params['alpha_min']
        alpha_max = params['alpha_max']
        V = np.random.choice([alpha_min, alpha_max],
                             size=n_samples, p=[0.5, 0.5])

    elif self.best_distribution == 'Poisson':
        alpha_0 = params['alpha_0']
        lam = alpha_0 / self.H
        V = np.random.poisson(lam, n_samples)

    elif self.best_distribution == 'Gamma':
        alpha_0 = params['alpha_0']
        gamma = params['gamma']
        beta = np.log(self.b) / (self.b**(1/gamma) - 1)
        V = np.random.gamma(gamma, 1/beta, n_samples)

    # Convert V to multipliers: M = b^(-V)
    M = self.b ** (-V)
    M = np.clip(M, 1e-10, 1e10)

    # Normalize: each group of b multipliers sums to b
    M = M.reshape(-1, self.b)
    M = M / M.sum(axis=1, keepdims=True) * self.b
    M = M.flatten()

    return M
Нормализация в конце кода выборки множителей имеет решающее значение. После преобразования V в M мы группируем множители попарно, поскольку b = 2, и нормализуем каждую пару до суммы b = 2. Так на каждом уровне каскада сохраняется полная масса. Без нормализации общая масса случайно менялась бы, и торговое время перестало бы быть корректной функцией распределения (CDF). Значение np.clip ограничивает экстремальные значения: при нормальном или гамма-распределении V может оказаться очень большим либо очень отрицательным, что дает почти нулевые или чрезвычайно большие множители.
От меры к торговому времени
Торговое время theta(t) — накопленная сумма нормированной меры, приведенная к диапазону [0, 1]:
def integrate_measure(self):
    if self.measure is None:
        raise ValueError("Must run generate_cascade() first")

    self.trading_time = np.cumsum(self.measure)
    self.trading_time = self.trading_time / self.trading_time[-1]
    return self.trading_time
Полученная функция theta(t) монотонно возрастает от 0 до 1. В отличие от прямой, соответствующей равномерному ходу времени, ее график имеет крутые участки там, где сосредоточена масса, и почти плоские там, где массы мало. На шестом этапе на крутых участках значения FBM будут выбираться быстрее, что даст большие по модулю доходности. На почти плоских участках будут выбираться близкие значения FBM, поэтому доходности окажутся малыми по модулю.
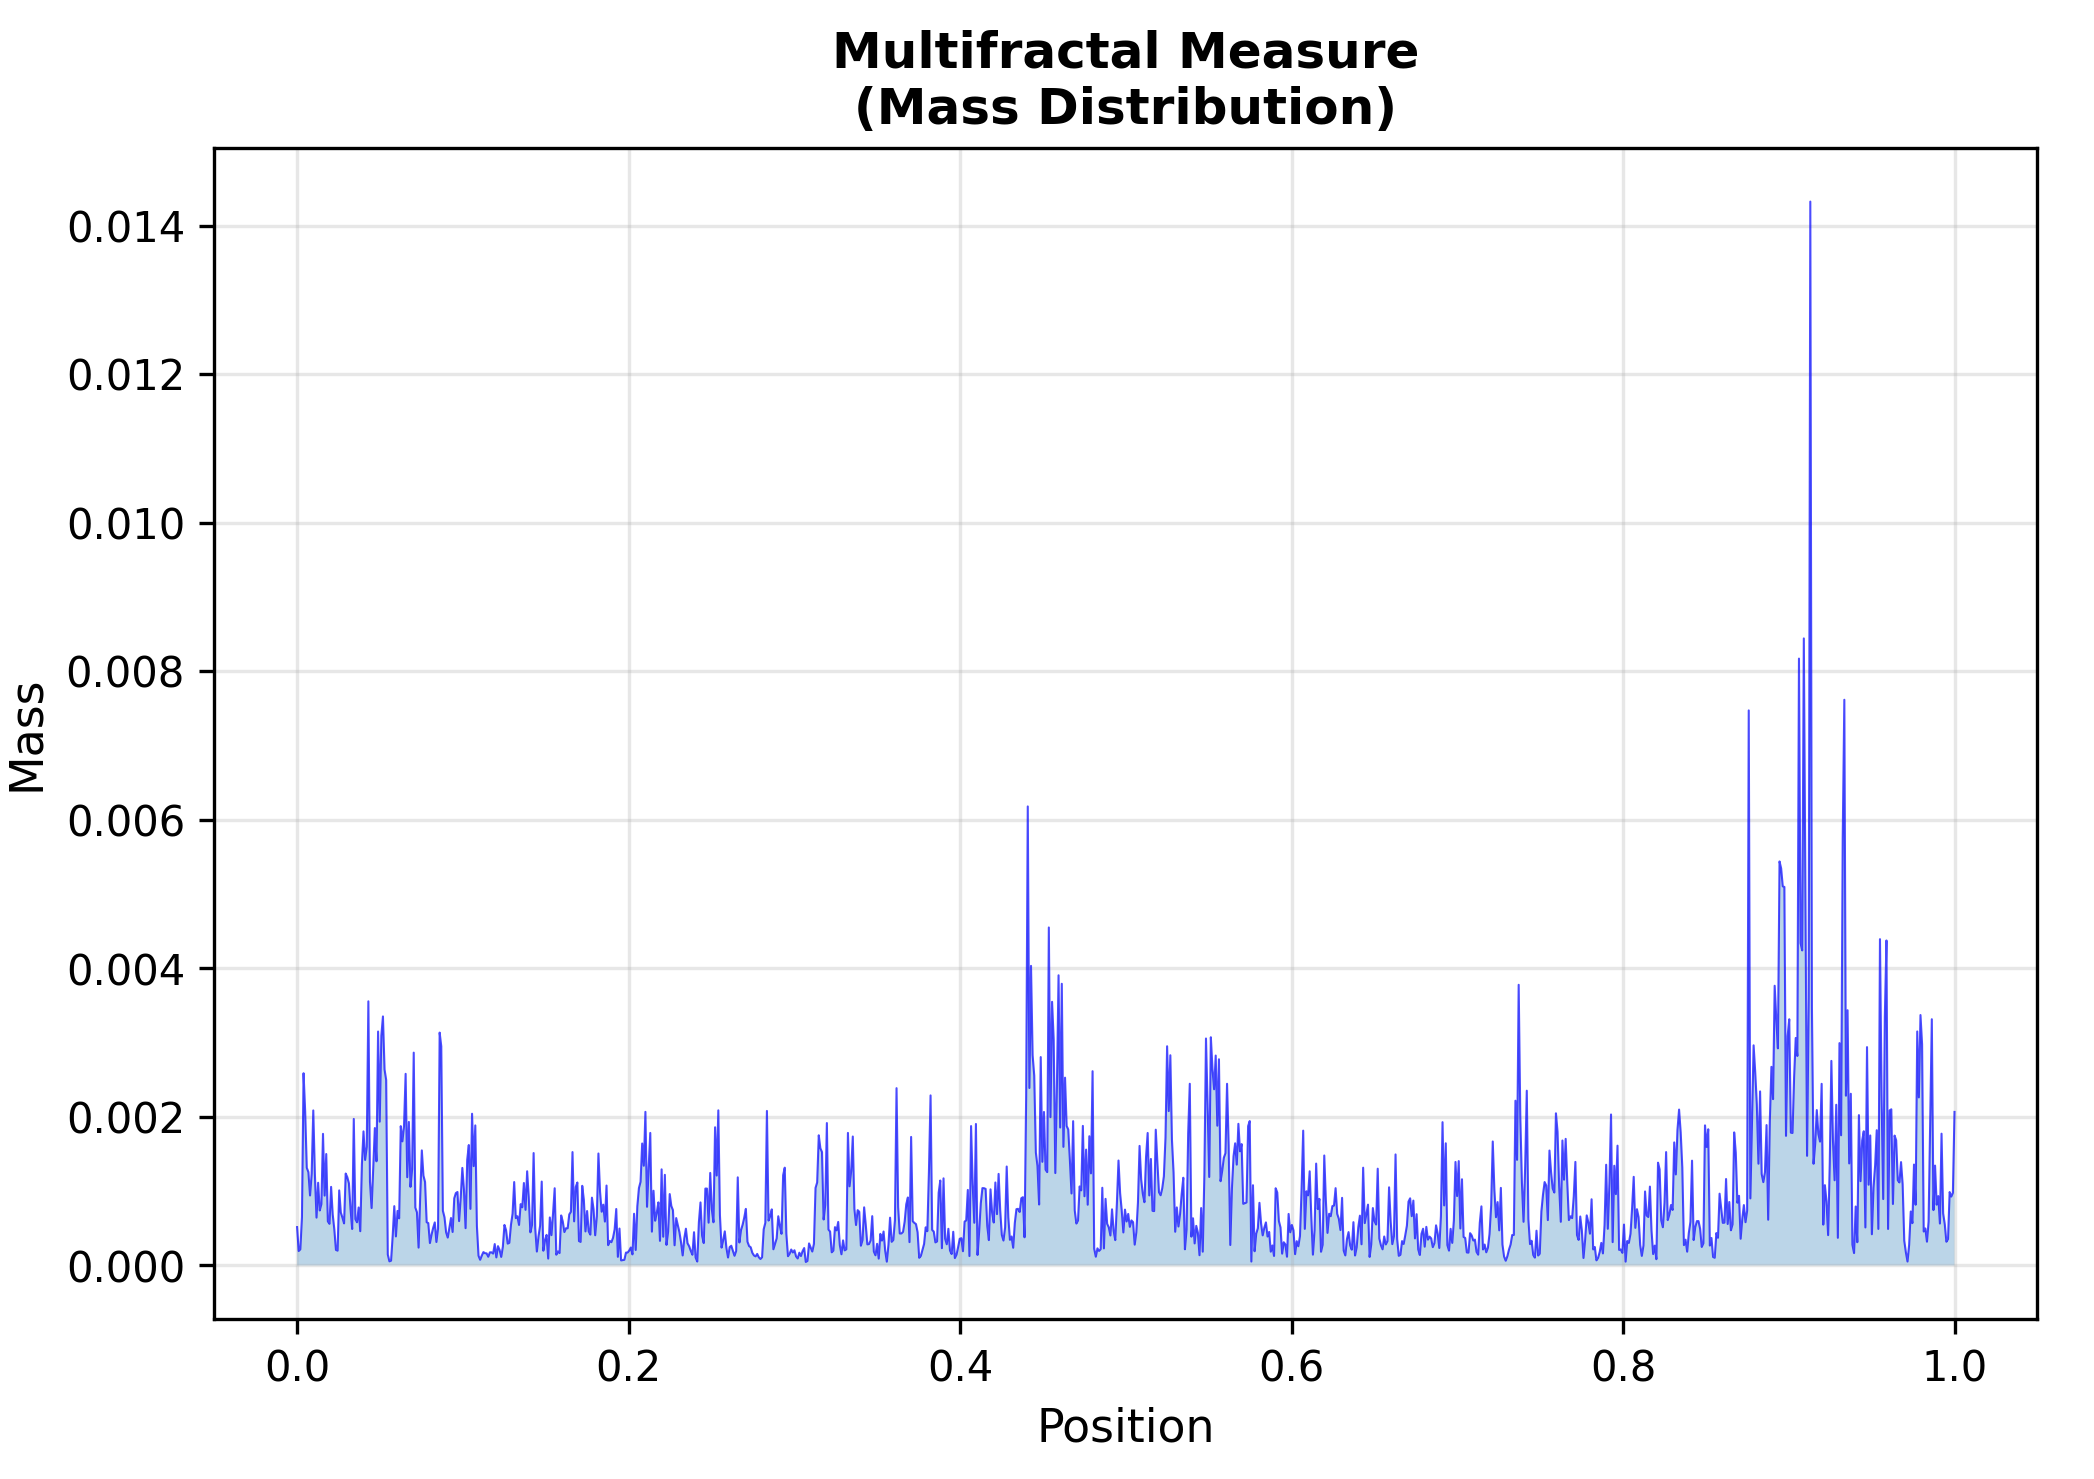
Рис. 1. Исходная каскадная мера — масса сосредоточена в острых пиках, разделенных широкими промежутками
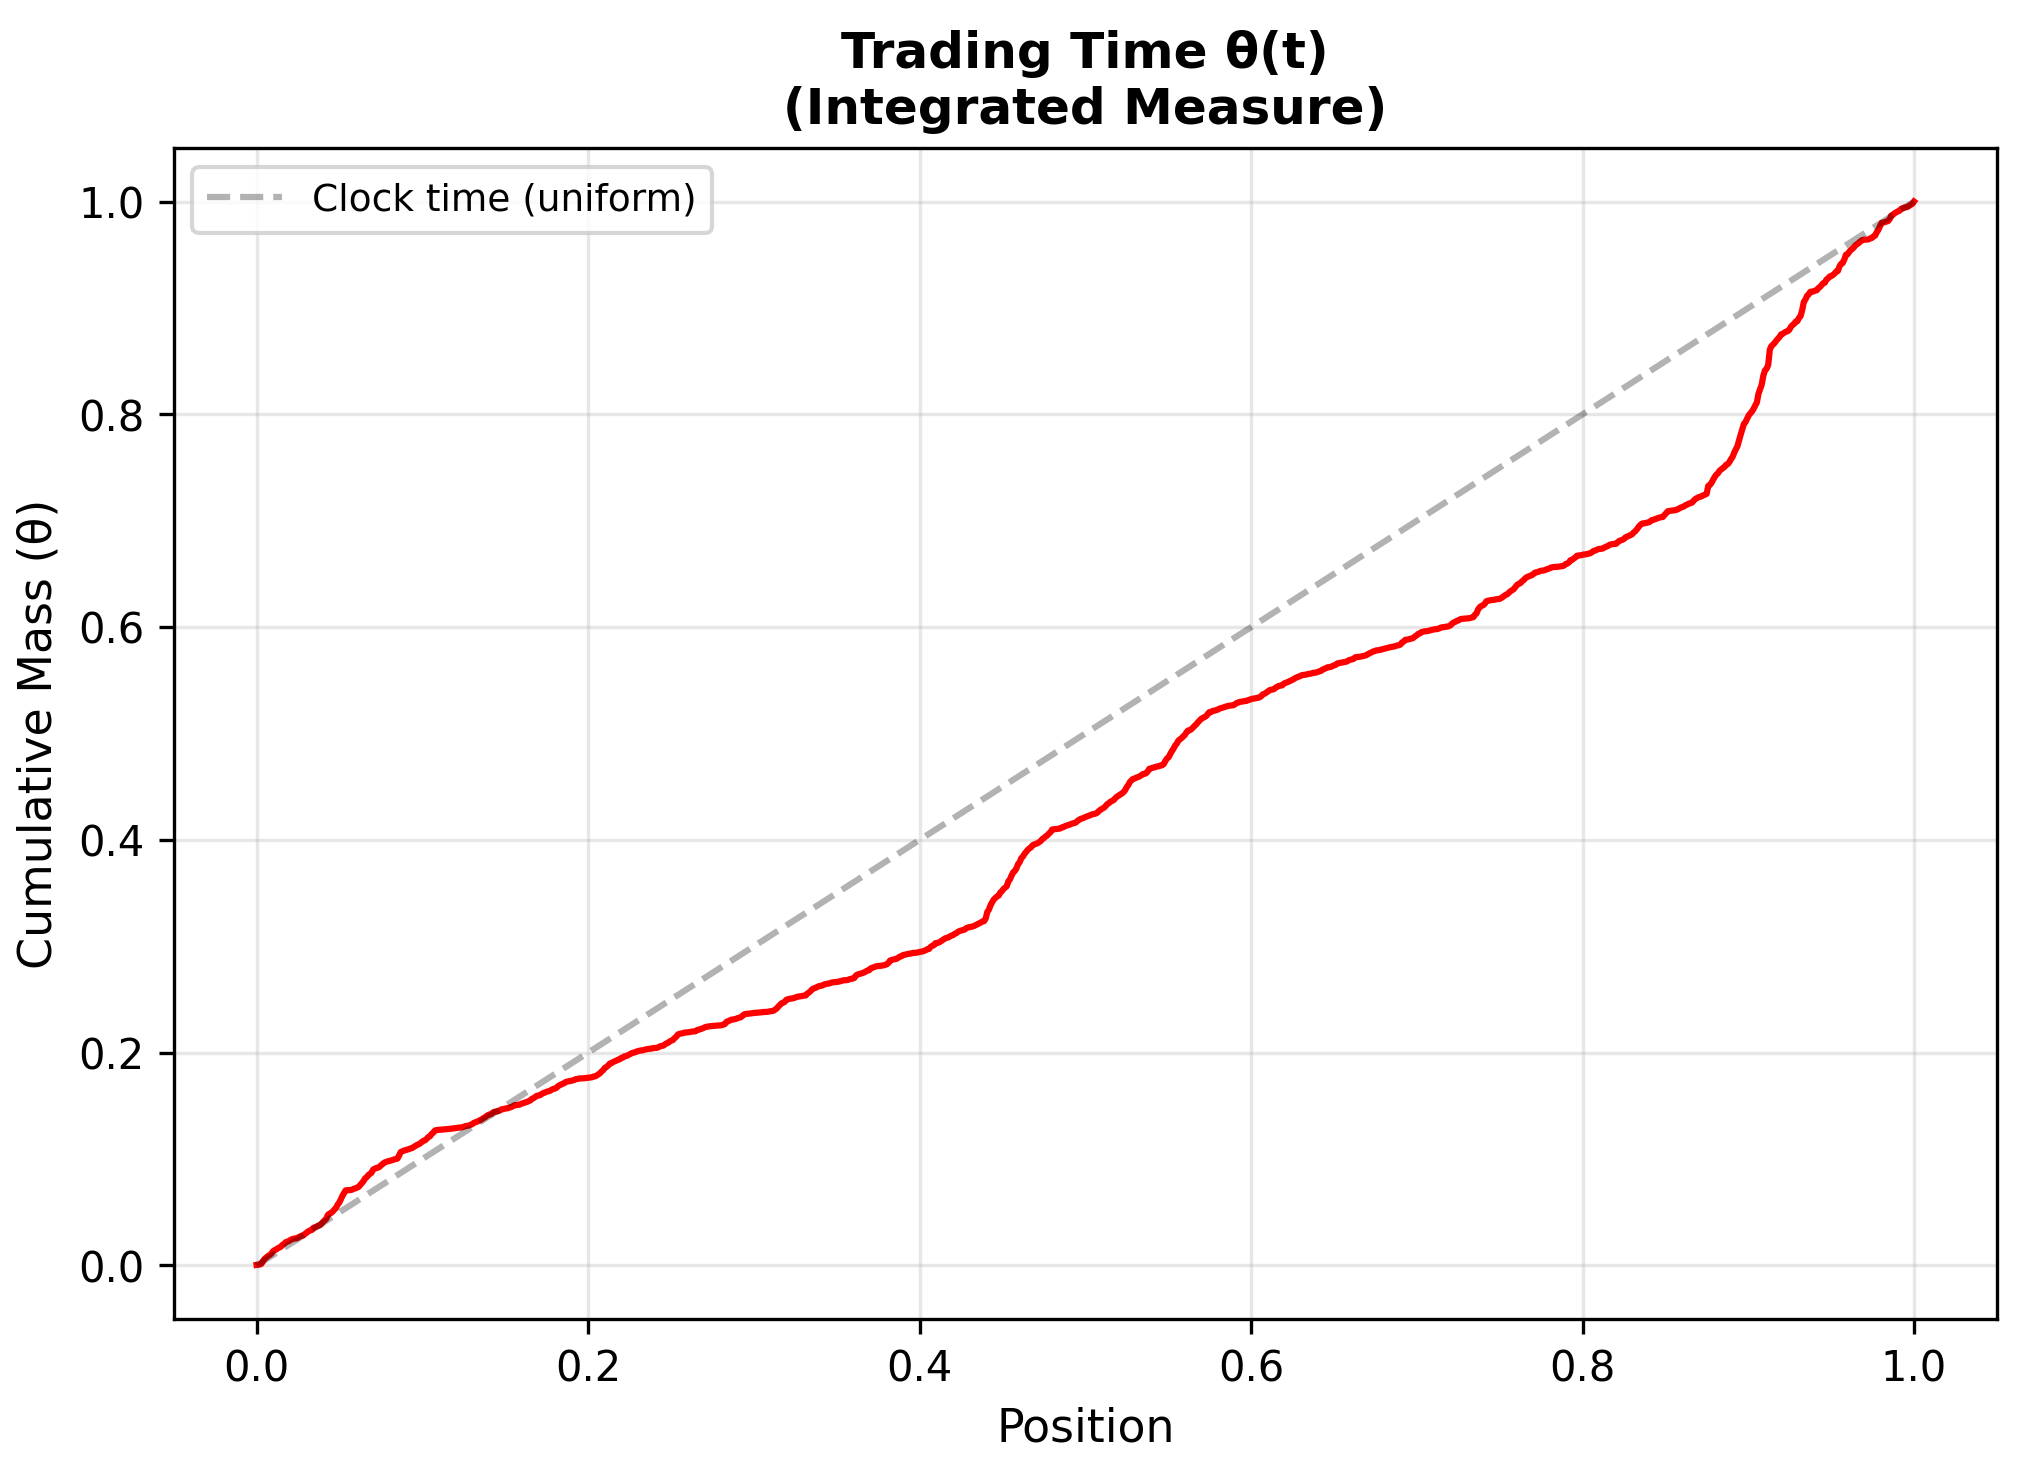
Рис. 2. Торговое время theta(t) в сравнении с равномерным временем по часам (диагональ) — крутые участки соответствуют периодам высокой активности
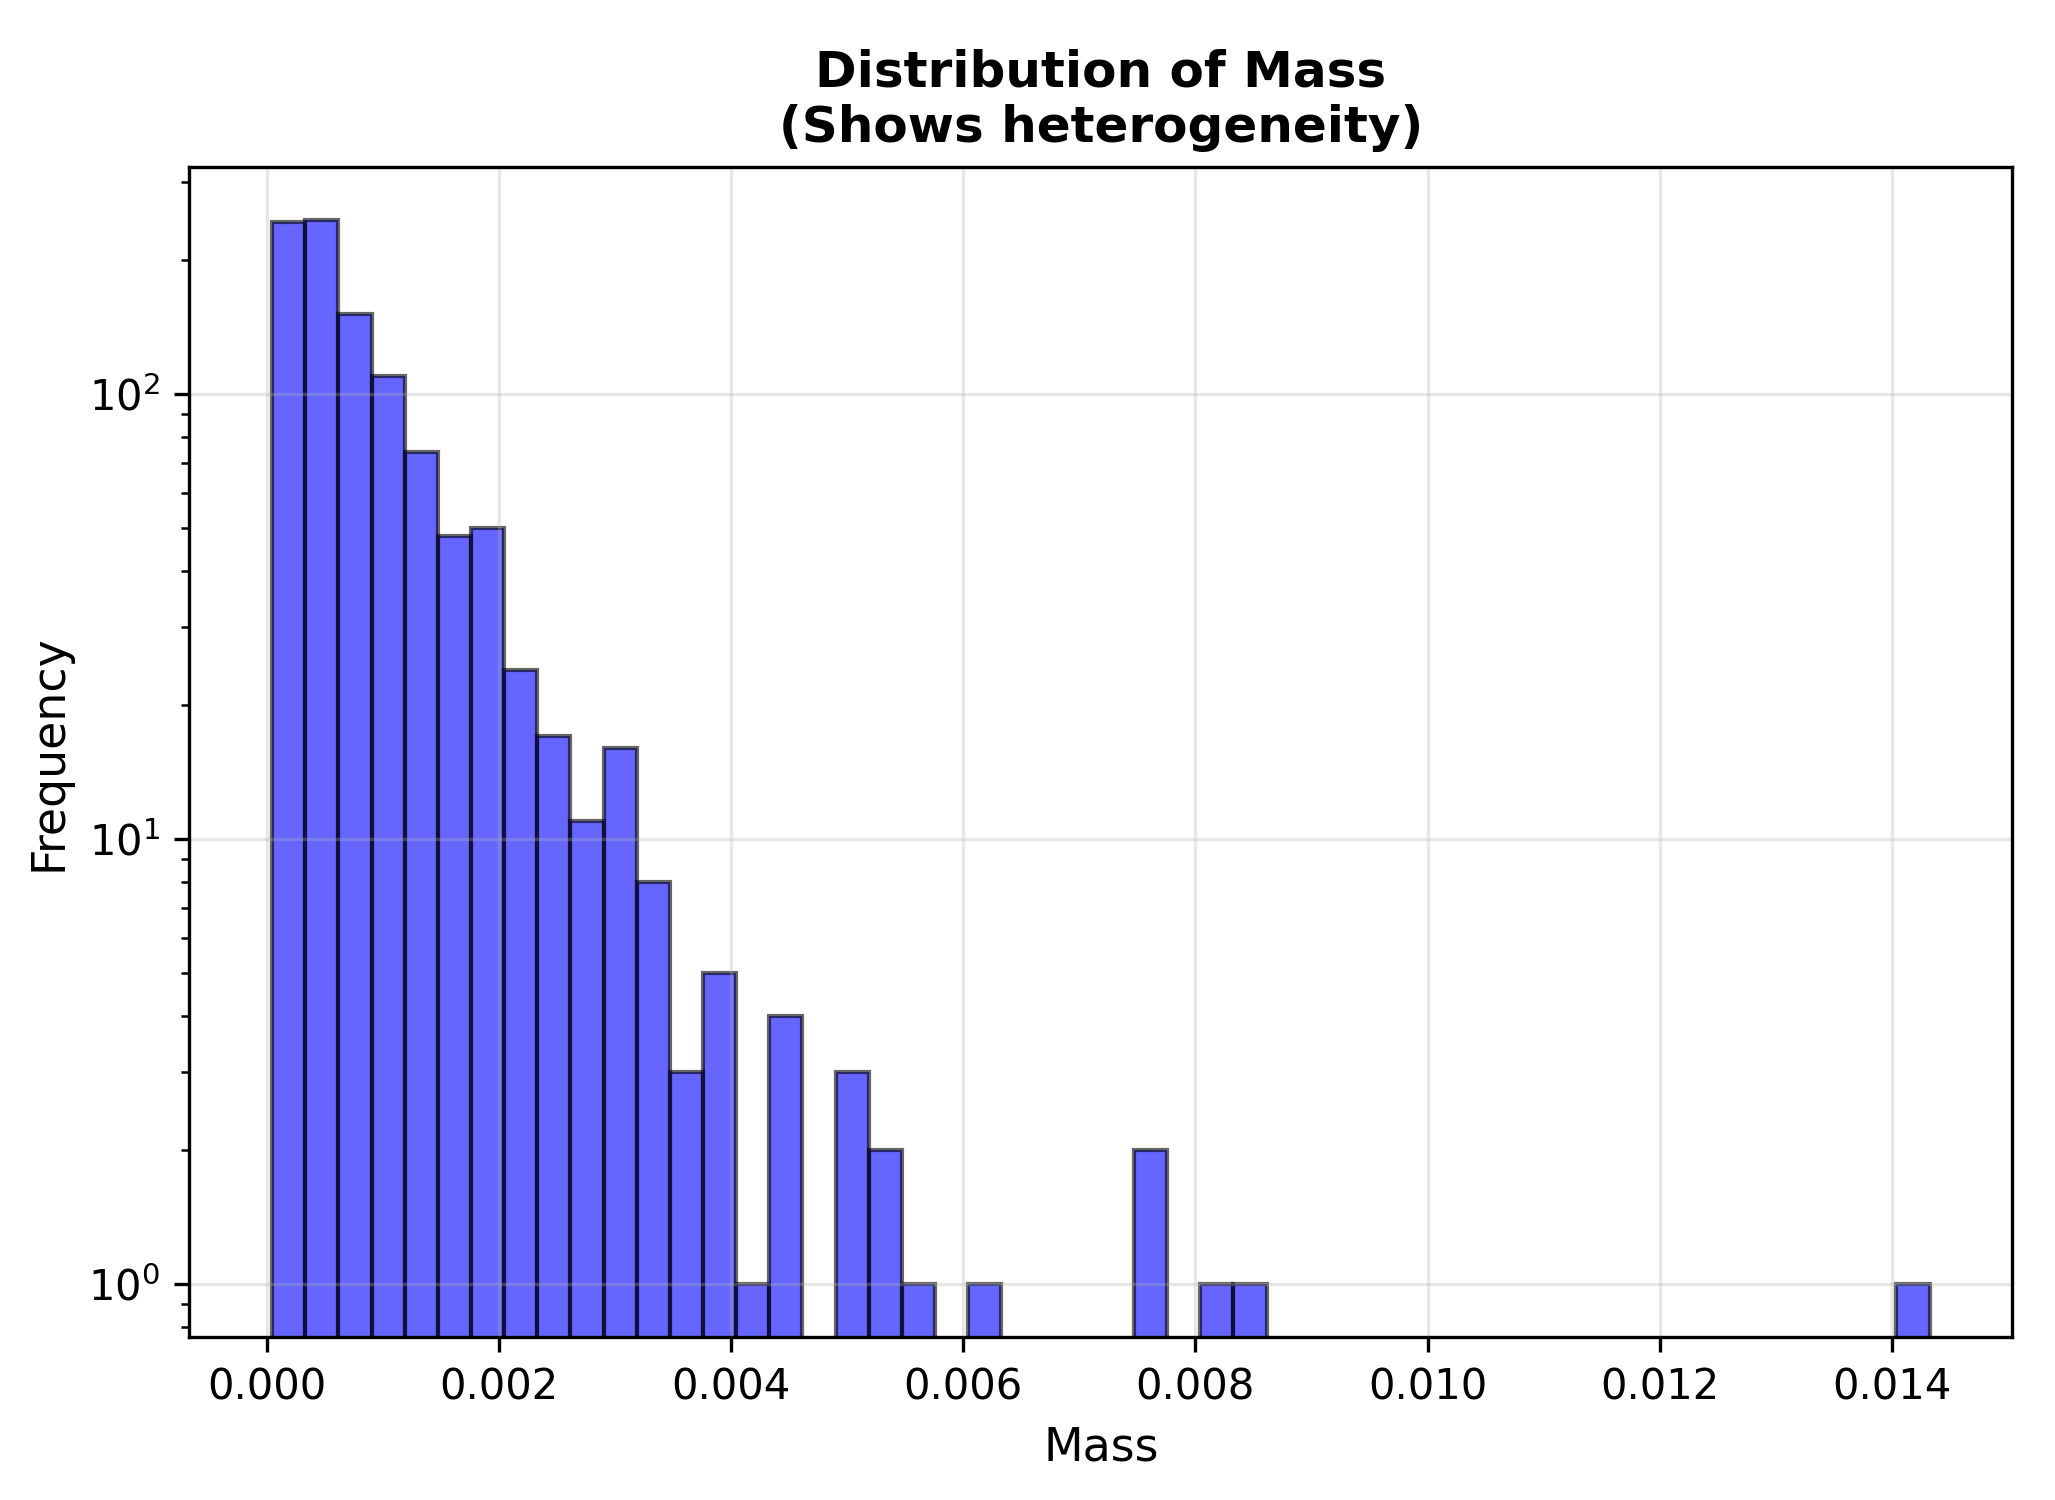
Рис. 3. Гистограмма каскадной массы в логарифмическом масштабе — распределение весов интервалов имеет тяжелые хвосты
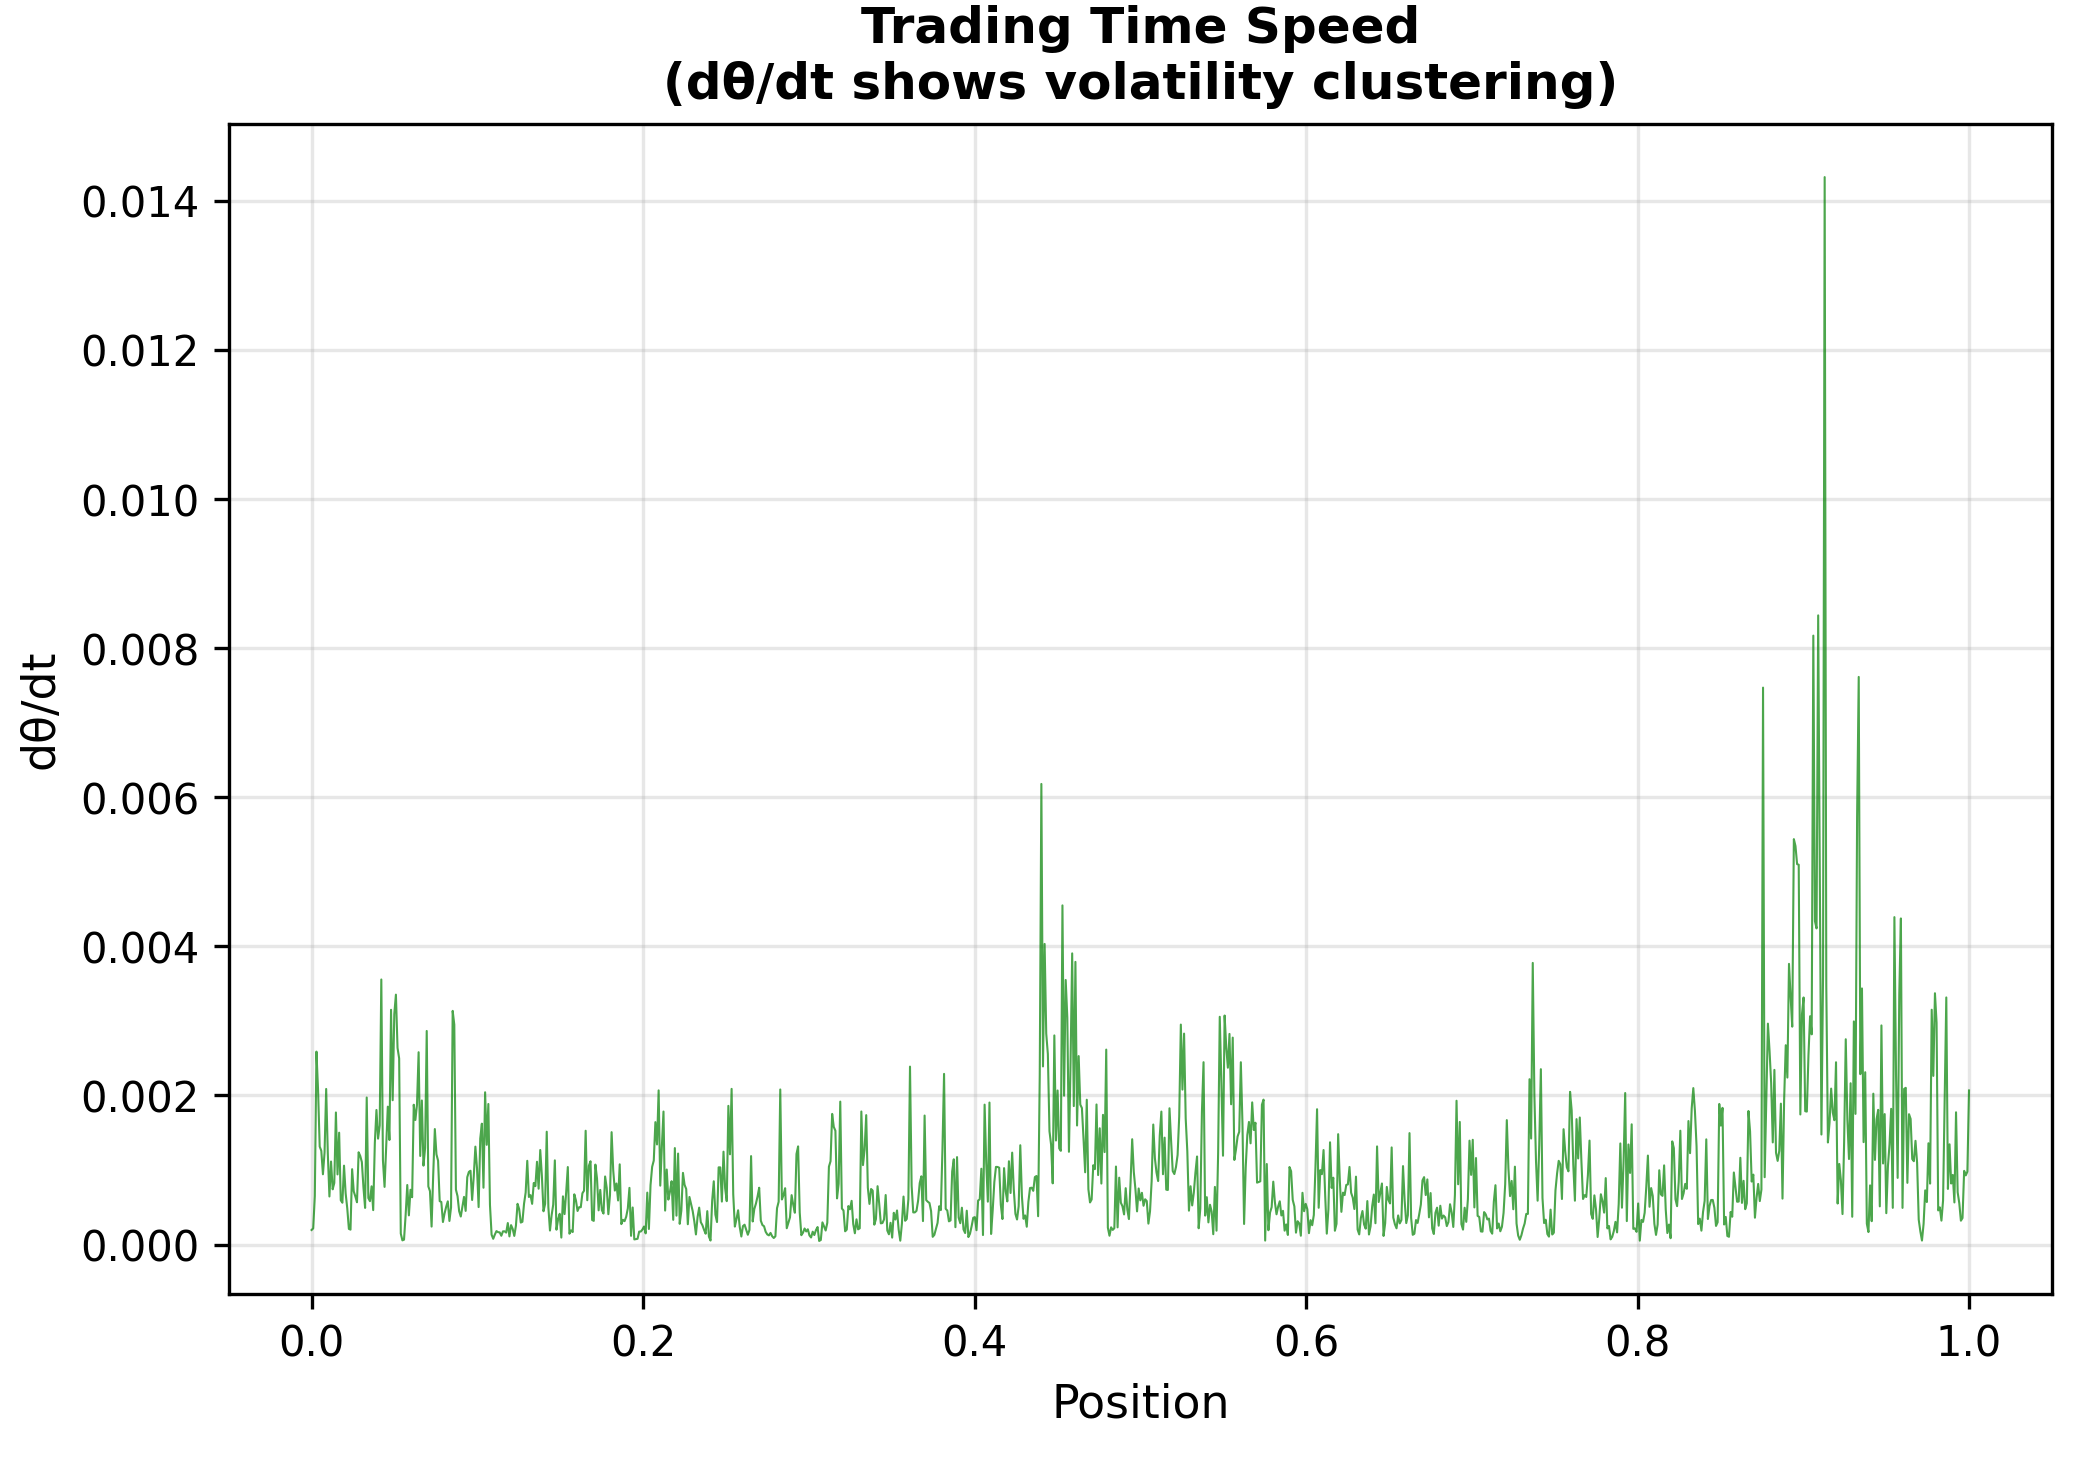
Рис. 4. Скорость торгового времени (производная theta) — группы всплесков отражают кластеризацию волатильности на реальном рынке
Шаг 5 — генерация фракционного броуновского движения
Второй компонент MMAR — фракционное броуновское движение (FBM), задающее структуру с долгой памятью. FBM генерируется методом Дэвиса — Харта. Он эффективен благодаря БПФ — сложность O(n log n) — и, в отличие от усеченных методов, дает статистически точную симуляцию без ошибок аппроксимации.
Автоковариационная функция
Отправной точкой служит автоковариационная функция приращений FBM. Для приращений, разделенных k шагами:
gamma(k) = (1/2) * [|k+1|^(2H) - 2|k|^(2H) + |k-1|^(2H)]
# step5_generate_fbm.py

class FBMGenerator:
    def __init__(self, H, n_points, verbose=config.VERBOSE):
        self.H = H
        self.n_points = n_points
        self.fbm = None
        self.fbm_increments = None

    def fbm_autocovariance(self, k):
        k = np.abs(k)
        return 0.5 * (np.abs(k + 1)**(2*self.H)
                    - 2*np.abs(k)**(2*self.H)
                    + np.abs(k - 1)**(2*self.H))
При k = 0 получаем gamma(0) = 1 — единичную дисперсию каждого приращения. При H = 0,5 значение gamma(k) = 0 для всех k > 0: приращения стандартного броуновского движения независимы. При H, отличном от 0,5, корреляции ненулевые: положительные при H > 0,5 (персистентность) и отрицательные при H < 0,5 (антиперсистентность).
Алгоритм Дэвиса—Харта
Коррелированные гауссовские приращения генерируются в четыре этапа:
Этап 1 — построение циркулянтного ковариационного вектора. Мы вычисляем автоковариацию при лагах 0, 1, 2, ..., n-1, а затем зеркально отражаем последовательность, получая симметричный вектор длины 2n. Этот вектор служит первой строкой циркулянтной матрицы, которую можно диагонализировать дискретным преобразованием Фурье.
Этап 2 — вычисление собственных значений с помощью БПФ. Собственные значения циркулянтной матрицы получают с помощью БПФ ее первой строки. Для корректной ковариационной матрицы все собственные значения должны быть неотрицательными. Если хотя бы одно значение отрицательно — при некоторых H и n такое возможно, — мы переходим к разложению Холецкого.
Этап 3 — генерирование масштабированных комплексных гауссовских случайных величин. Мы генерируем 2n независимых комплексных гауссовских случайных величин; действительная и мнимая части каждой имеют распределение N(0,1). Затем масштабируем каждую величину на квадратный корень из соответствующего собственного значения, деленного на 2n.
Этап 4 — применение обратного БПФ. Обратное БПФ дает коррелированные приращения. Берем действительные части первых n значений — это приращения FBM. Накопленная сумма дает траекторию FBM.
def generate_fbm_davies_harte(self):
    n = self.n_points

    # Stage 1: Circulant covariance vector
    r = np.zeros(2 * n)
    for k in range(n):
        r[k] = self.fbm_autocovariance(k)
    for k in range(1, n):
        r[2*n - k] = r[k]

    # Stage 2: Eigenvalues via FFT
    lam = np.fft.fft(r).real

    if np.any(lam < -1e-10):
        return self.generate_fbm_cholesky()

    lam = np.maximum(lam, 0)

    # Stage 3: Scaled complex Gaussians
    Z_real = np.random.randn(2*n)
    Z_imag = np.random.randn(2*n)
    Z = Z_real + 1j * Z_imag
    W = np.sqrt(lam / (2*n)) * Z

    # Stage 4: Inverse FFT to get correlated increments
    w = np.fft.ifft(W)
    self.fbm_increments = w[:n].real

    # Cumulative sum gives FBM path
    self.fbm = np.cumsum(self.fbm_increments)
    self.fbm = self.fbm - self.fbm[0]
    return self.fbm
Условие np.any(lam < -1e-10) проверяет корректность собственных значений. Отрицательные собственные значения означают, что циркулянтное вложение не дает корректной ковариационной матрицы. Такое возможно, если n мало по сравнению с корреляционной длиной либо H близок к 0 или 1. Порог -1e-10 вместо точного нуля учитывает погрешности вычислений с плавающей точкой.
Резервный переход на разложение Холецкого
Если при выполнении метода Дэвиса — Харта обнаружены отрицательные собственные значения, используется разложение Холецкого. Сначала по автоковариационной функции строится ковариационная матрица размером n x n и вычисляется ее разложение Холецкого: C = L * L^T. Затем L умножается на вектор независимых стандартных гауссовских случайных величин, чтобы получить коррелированные приращения. Этот вариант медленнее — O(n^3) против O(n log n), — но работает всегда:
def generate_fbm_cholesky(self):
    n = self.n_points

    cov_matrix = np.zeros((n, n))
    for i in range(n):
        for j in range(n):
            cov_matrix[i, j] = self.fbm_autocovariance(i - j)

    try:
        L = np.linalg.cholesky(cov_matrix)
    except np.linalg.LinAlgError:
        cov_matrix += 1e-10 * np.eye(n)
        L = np.linalg.cholesky(cov_matrix)

    Z = np.random.randn(n)
    increments = L @ Z

    self.fbm_increments = increments
    self.fbm = np.cumsum(increments)
    self.fbm = self.fbm - self.fbm[0]
    return self.fbm
Небольшая добавка к диагонали 1e-10 * np.eye(n) помогает, когда ковариационная матрица положительно полуопределена, но не положительно определена: из-за нулевых собственных значений разложение Холецкого не выполняется. Добавление малой величины к диагонали делает все собственные значения строго положительными.
Масштабирование волатильности
После генерации FBM масштабируется так, чтобы стандартное отклонение его приращений соответствовало наблюдаемой рыночной волатильности:
def scale_fbm(self, volatility):
    current_std = np.std(self.fbm_increments)
    scale_factor = volatility / current_std if current_std > 0 else 1.0

    self.fbm = self.fbm * scale_factor
    self.fbm_increments = self.fbm_increments * scale_factor
Это важно, поскольку без масштабирования FBM генерирует приращения с единичной дисперсией, не связанные с фактической рыночной волатильностью. scale_factor — это отношение целевой волатильности (стандартного отклонения исторических доходностей из этапа 1) к текущему стандартному отклонению приращений FBM.
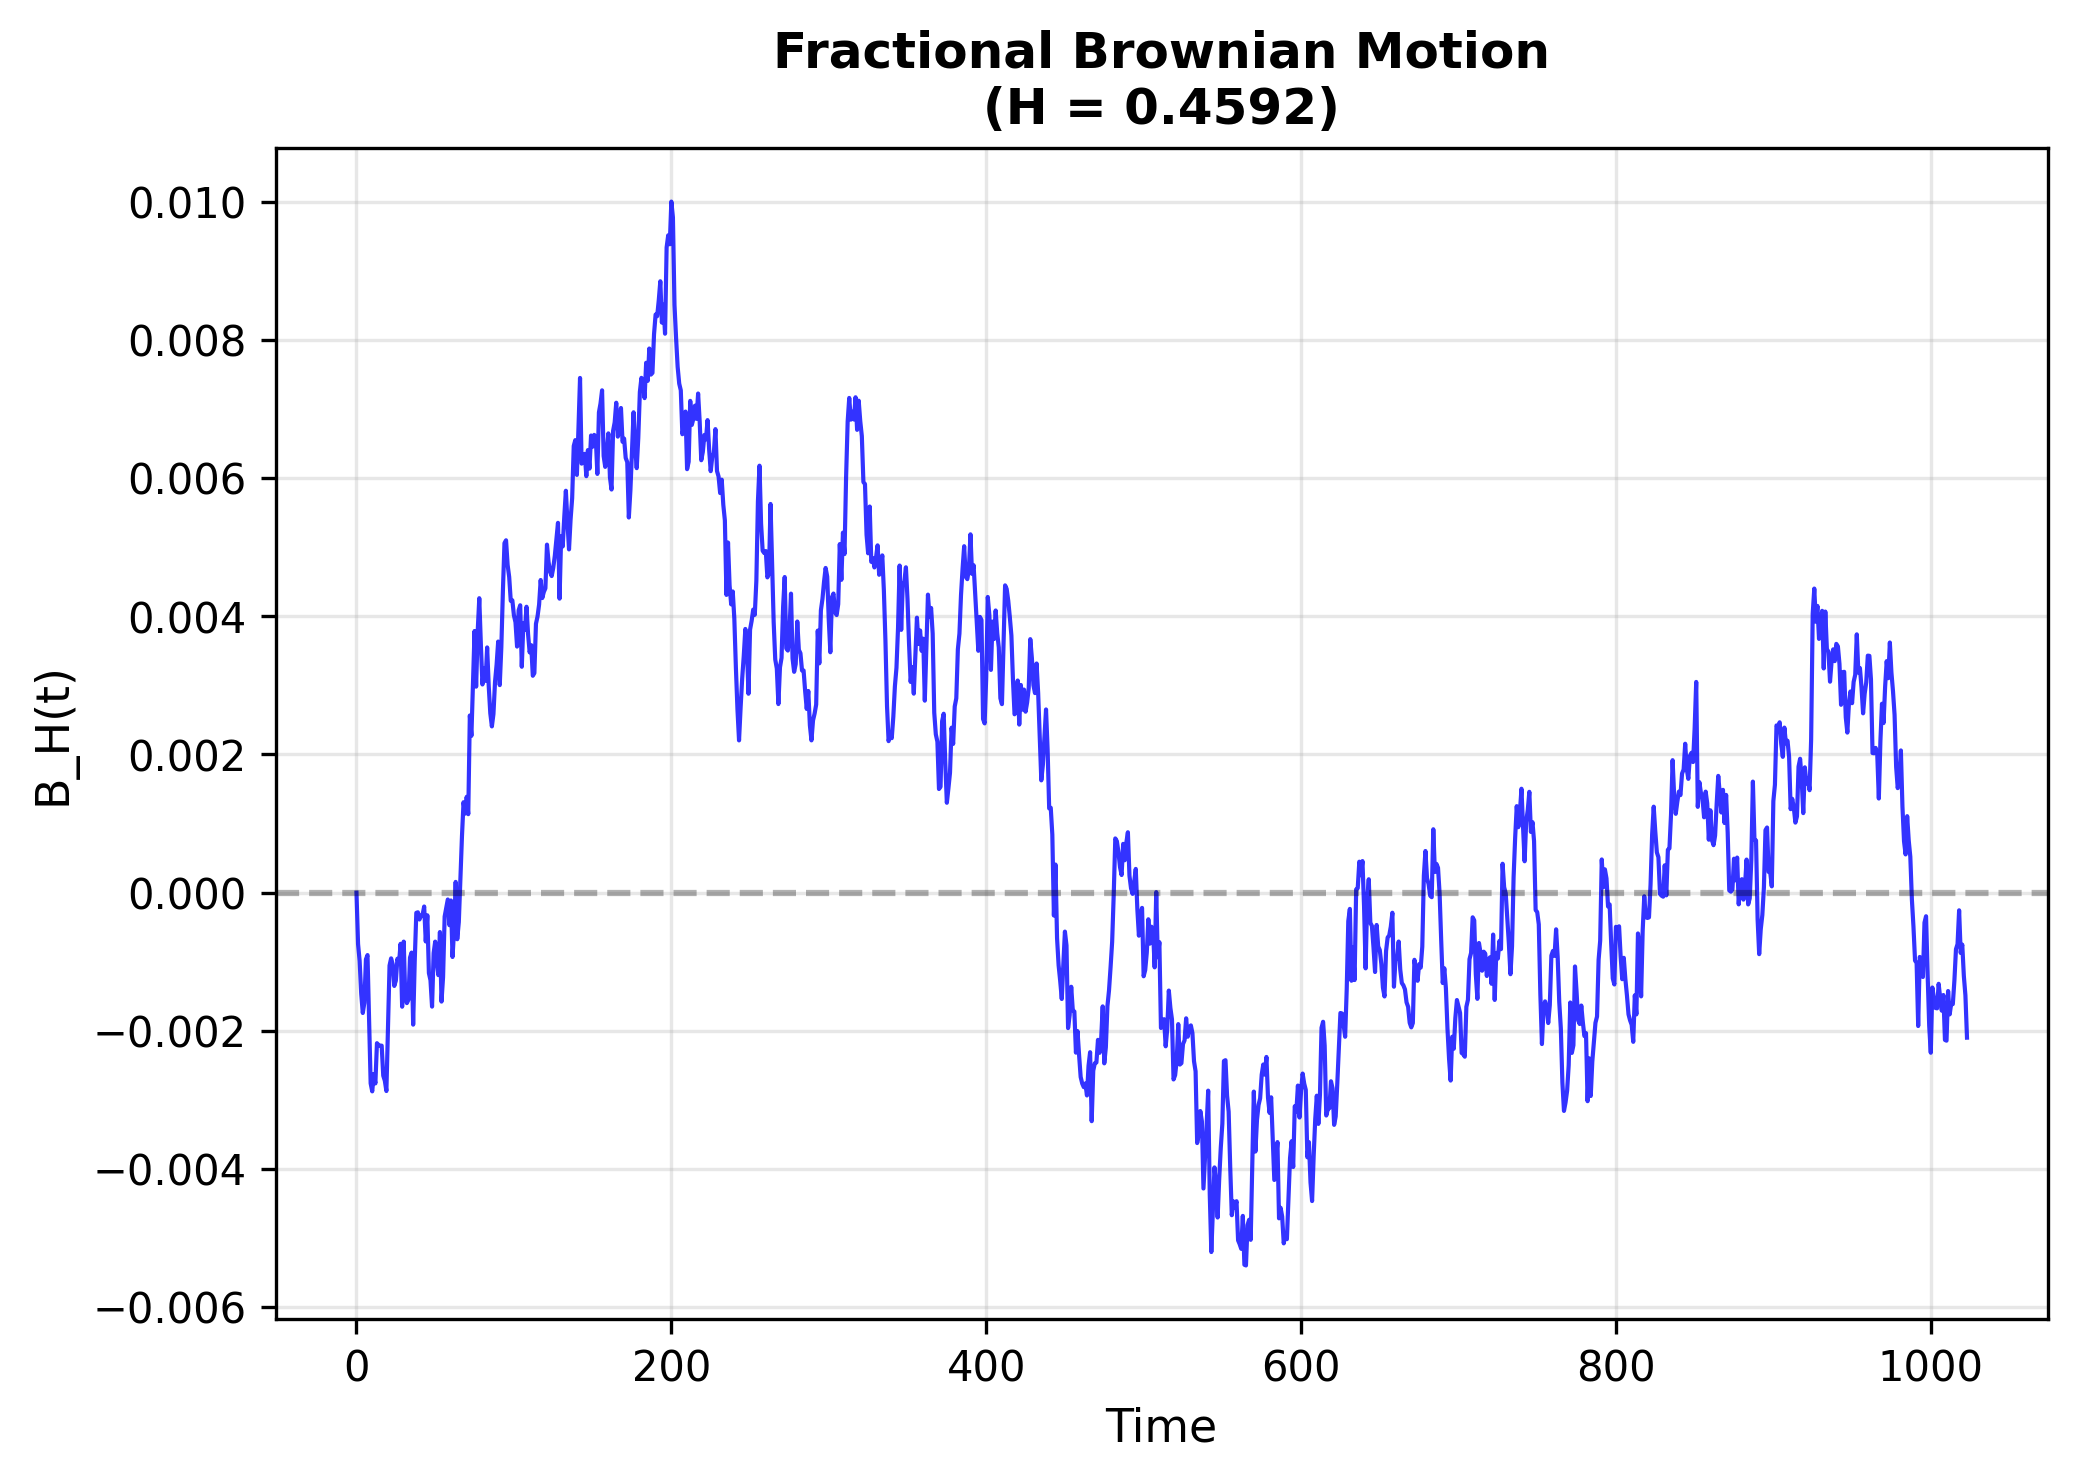
Рис. 5. Сгенерированная траектория FBM, масштабированная в соответствии с исторической волатильностью
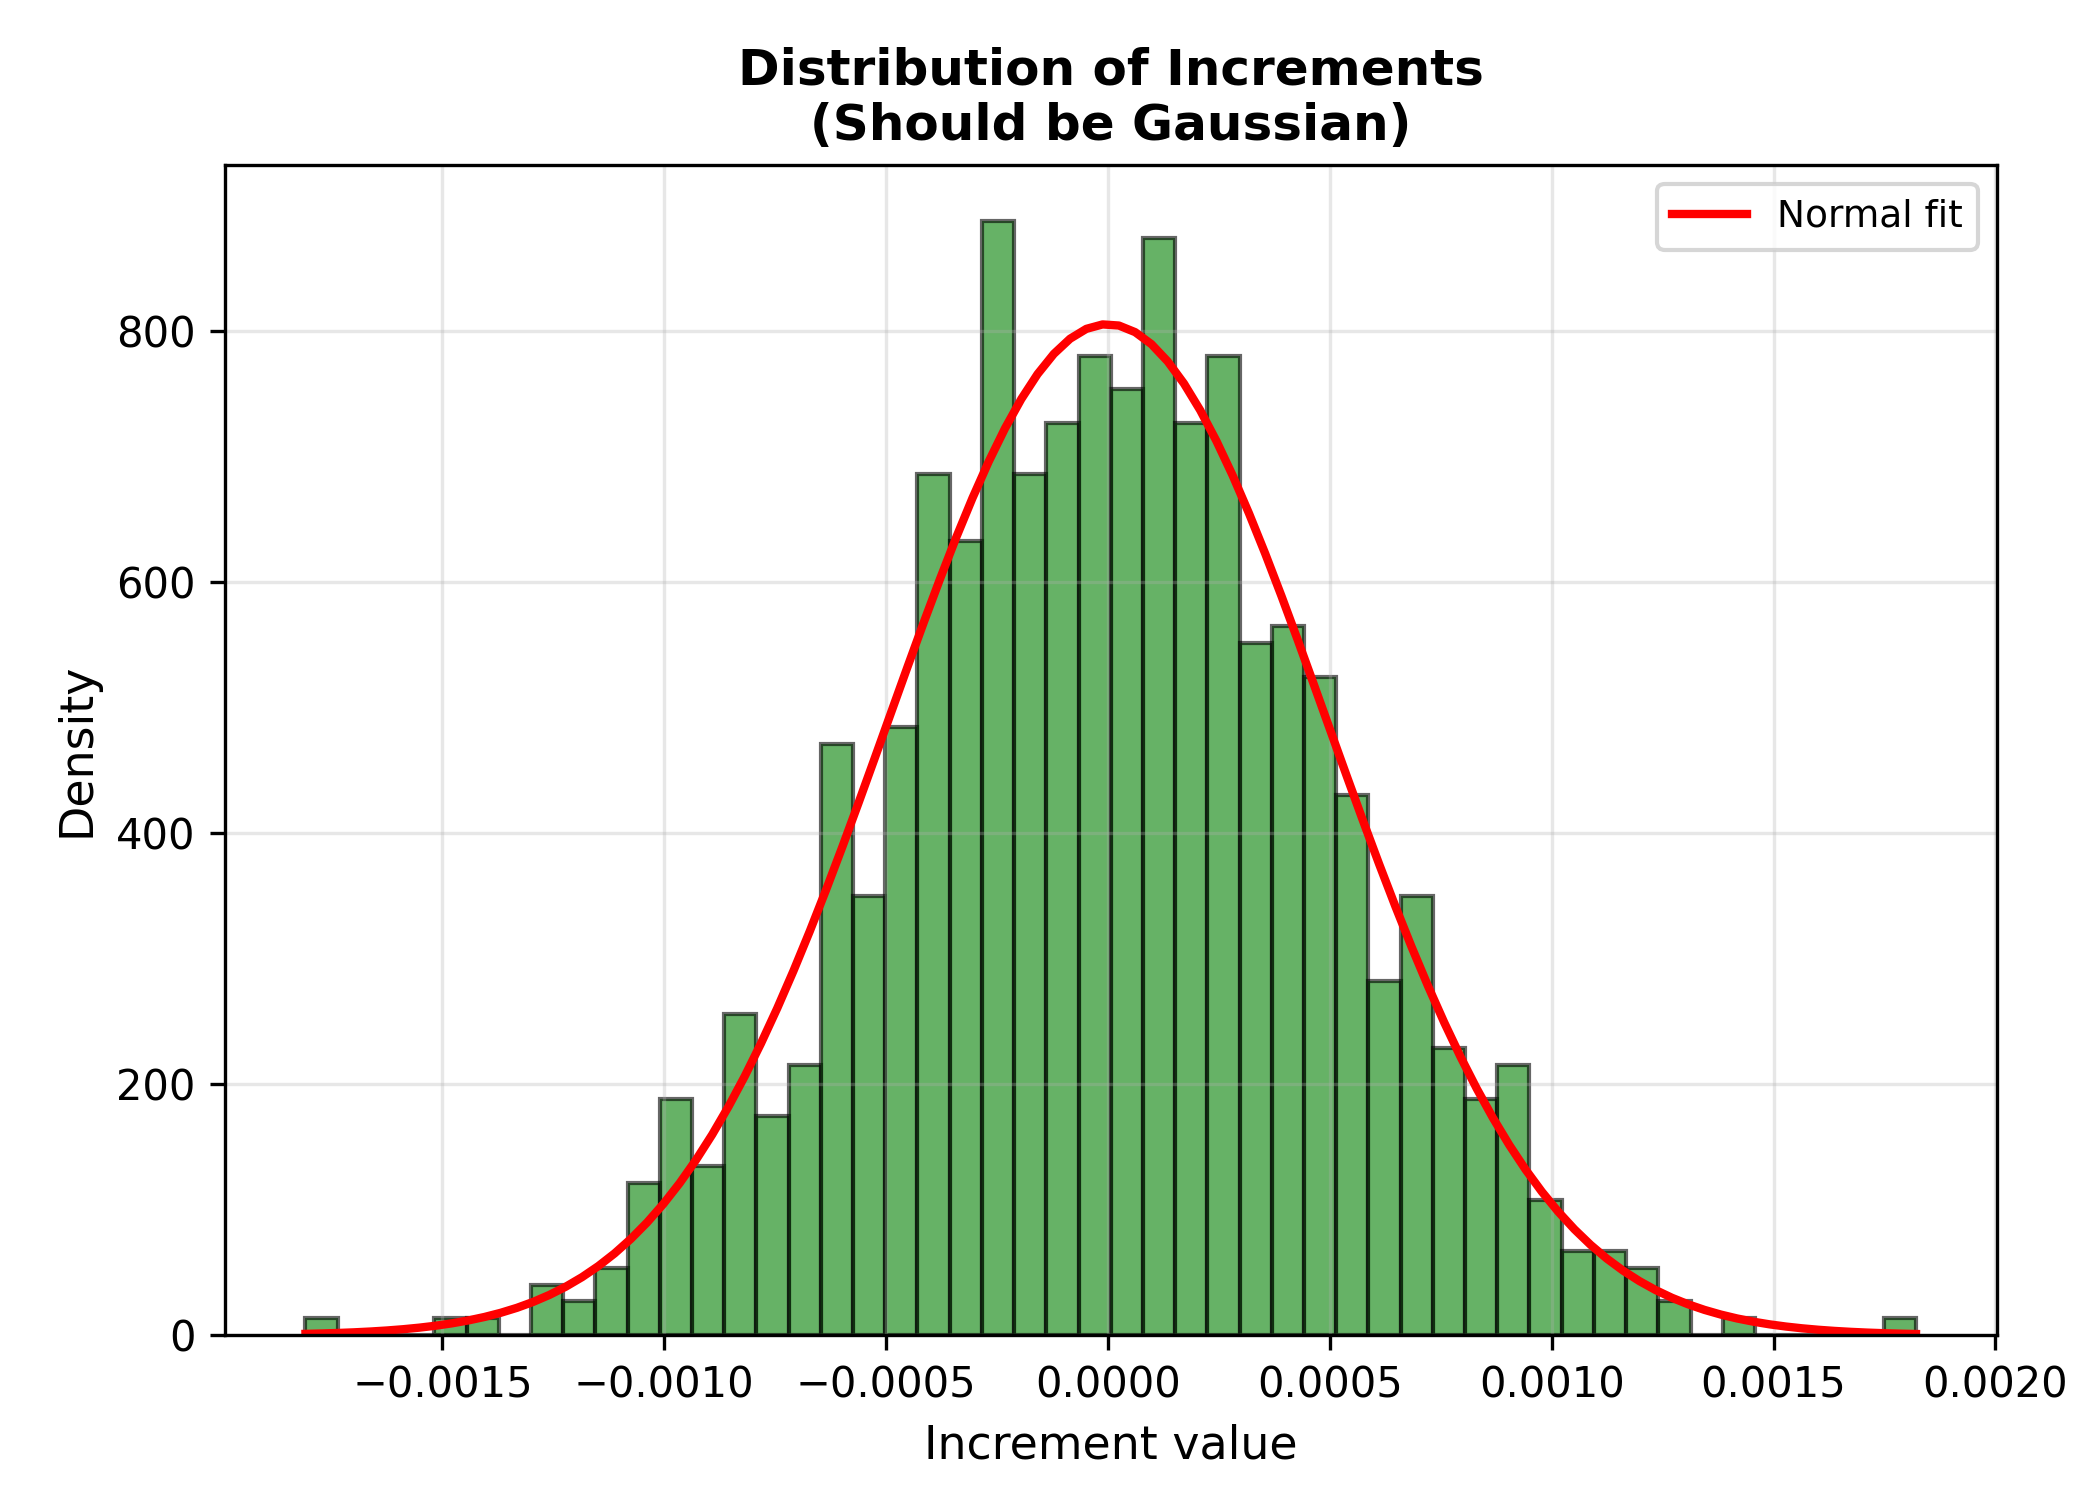
Рис. 6. Распределение приращений FBM — как и ожидалось, гауссовское; для сравнения наложена кривая нормального распределения
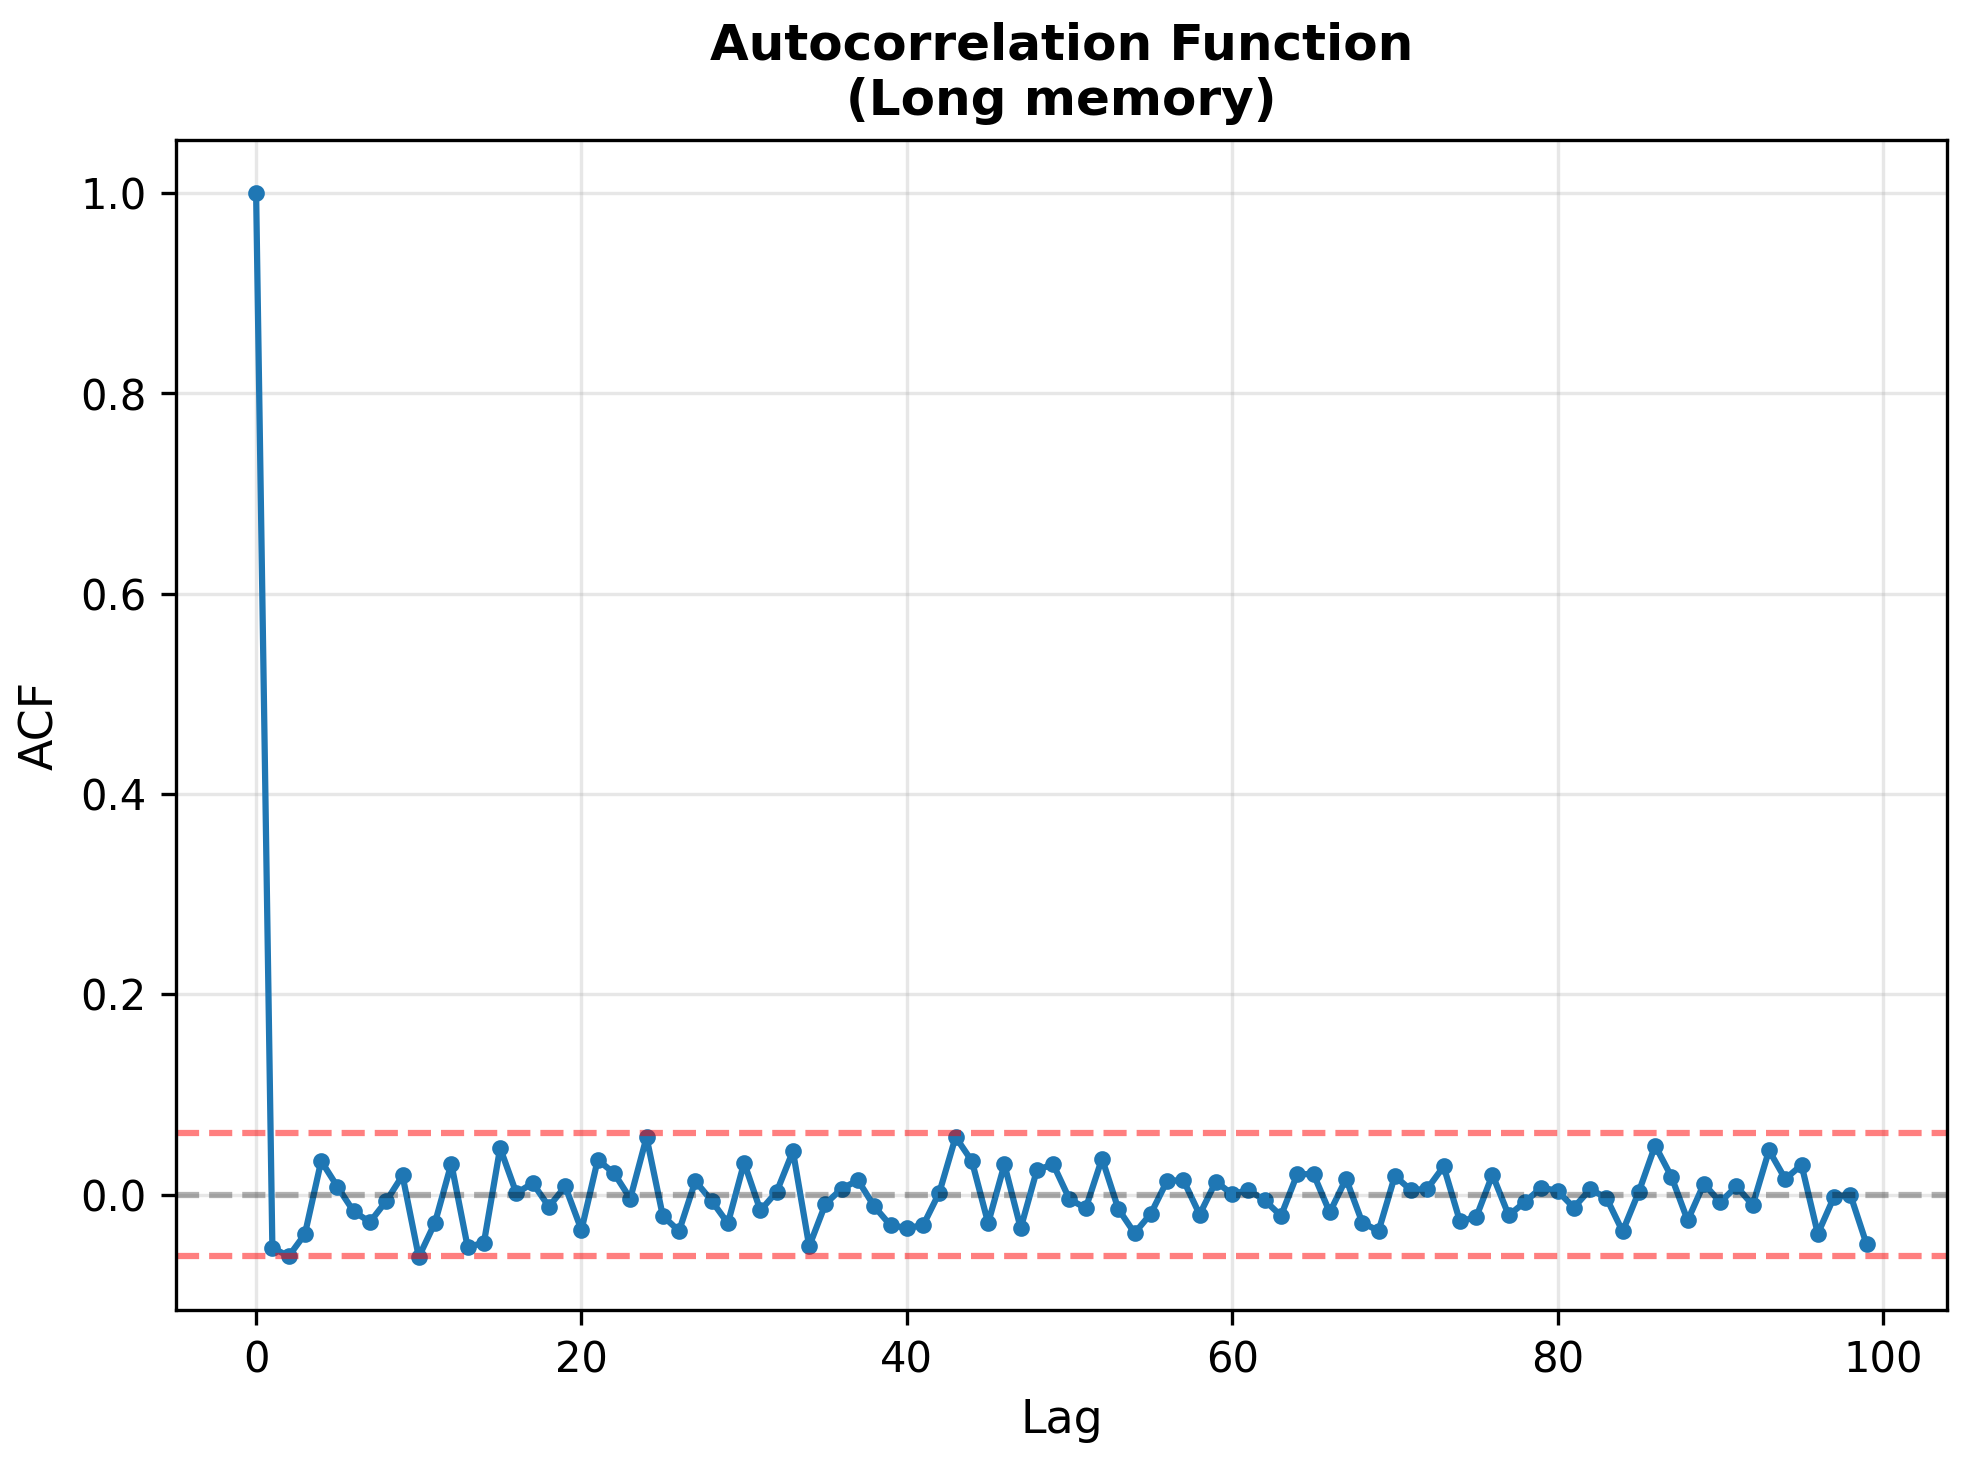
Рис. 7. Автокорреляционная функция приращений FBM — медленное степенное затухание, характерное для долгой памяти
Шаг 6 — уравнение MMAR оживает
Именно на этом этапе все складывается воедино. Мы берем фракционное броуновское движение, полученное на пятом этапе, и вычисляем его в точках торгового времени с четвертого этапа. В результате получаем процесс MMAR — синтетический ценовой ряд с долгой памятью, тяжелыми хвостами распределения, кластеризацией волатильности и масштабной согласованностью.
Основное уравнение имеет следующий вид:
X(j) = B_H[theta(j)]
Используется линейная интерполяция, поскольку значения торгового времени theta(j) соответствуют дробным индексам массива FBM. Как объясняет Чжан: "если значение равно 23.45, для FBM нужны 24-й и 25-й элементы. Цена в j-м элементе ряда находится линейной интерполяцией между значениями FBM в 24-м и 25-м элементах".
# step6_combine_model.py

class MMARCombiner:
    def __init__(self, fbm_generator, cascade_generator, verbose=config.VERBOSE):
        self.fbm = fbm_generator.fbm
        self.trading_time = cascade_generator.trading_time
        self.mmar_process = None
        self.mmar_returns = None

    def combine_fbm_and_trading_time(self):
        n_points = len(self.trading_time)

        # Create interpolation function mapping [0,1] to FBM values
        fbm_grid = np.linspace(0, 1, len(self.fbm))
        fbm_interp = interp1d(fbm_grid, self.fbm,
                                 kind='linear',
                                 bounds_error=False,
                                 fill_value=(self.fbm[0], self.fbm[-1]))

        self.mmar_process = np.zeros(n_points)
        for j in range(n_points):
            theta_j = self.trading_time[j]
            self.mmar_process[j] = fbm_interp(theta_j)

        self.mmar_returns = np.diff(self.mmar_process)
        return self.mmar_process, self.mmar_returns
Давайте на примере разберем, что дает такая деформация времени.
Рассмотрим две соседние позиции j и j+1 в каскаде. Если между ними сосредоточена большая масса, разность theta(j+1) - theta(j) велика: мы делаем большой шаг вдоль траектории FBM. Интерполированные значения FBM в точках theta(j) и theta(j+1) сильно различаются, давая большую по модулю доходность. Если между ними почти нет массы, разность theta(j+1) - theta(j) мала: мы дважды выбираем почти одну и ту же точку FBM и получаем доходность, близкую к нулю. Масса в каскаде распределена самоподобно и образует кластеры. Поэтому участки с большой массой часто соседствуют друг с другом, порождая кластеризацию волатильности. А экстремальные скопления массы приводят к тяжелым хвостам распределения доходностей.
FBM, в свою очередь, обеспечивает долгую память благодаря коррелированным приращениям. Сочетание X(t) = B_H[theta(t)] сохраняет структуру памяти FBM и неоднородность каскада. Полученный процесс одновременно отражает все четыре стилизованных факта.
Линейная интерполяция kind='linear' выбрана сознательно вместо методов более высокого порядка, например кубического сплайна. Линейная интерполяция точно реализует описанное Чжаном отображение и не создает осцилляционных артефактов, которые кубические сплайны могут давать при резких изменениях торгового времени. Параметры bounds_error=False и fill_value обрабатывают граничный случай, когда theta(j) равно 0 или 1: из-за округления значение может слегка выйти за пределы [0,1].

Рис. 8. Составной процесс MMAR — синтетическая ценовая траектория, полученная при вычислении FBM в точках мультифрактального торгового времени
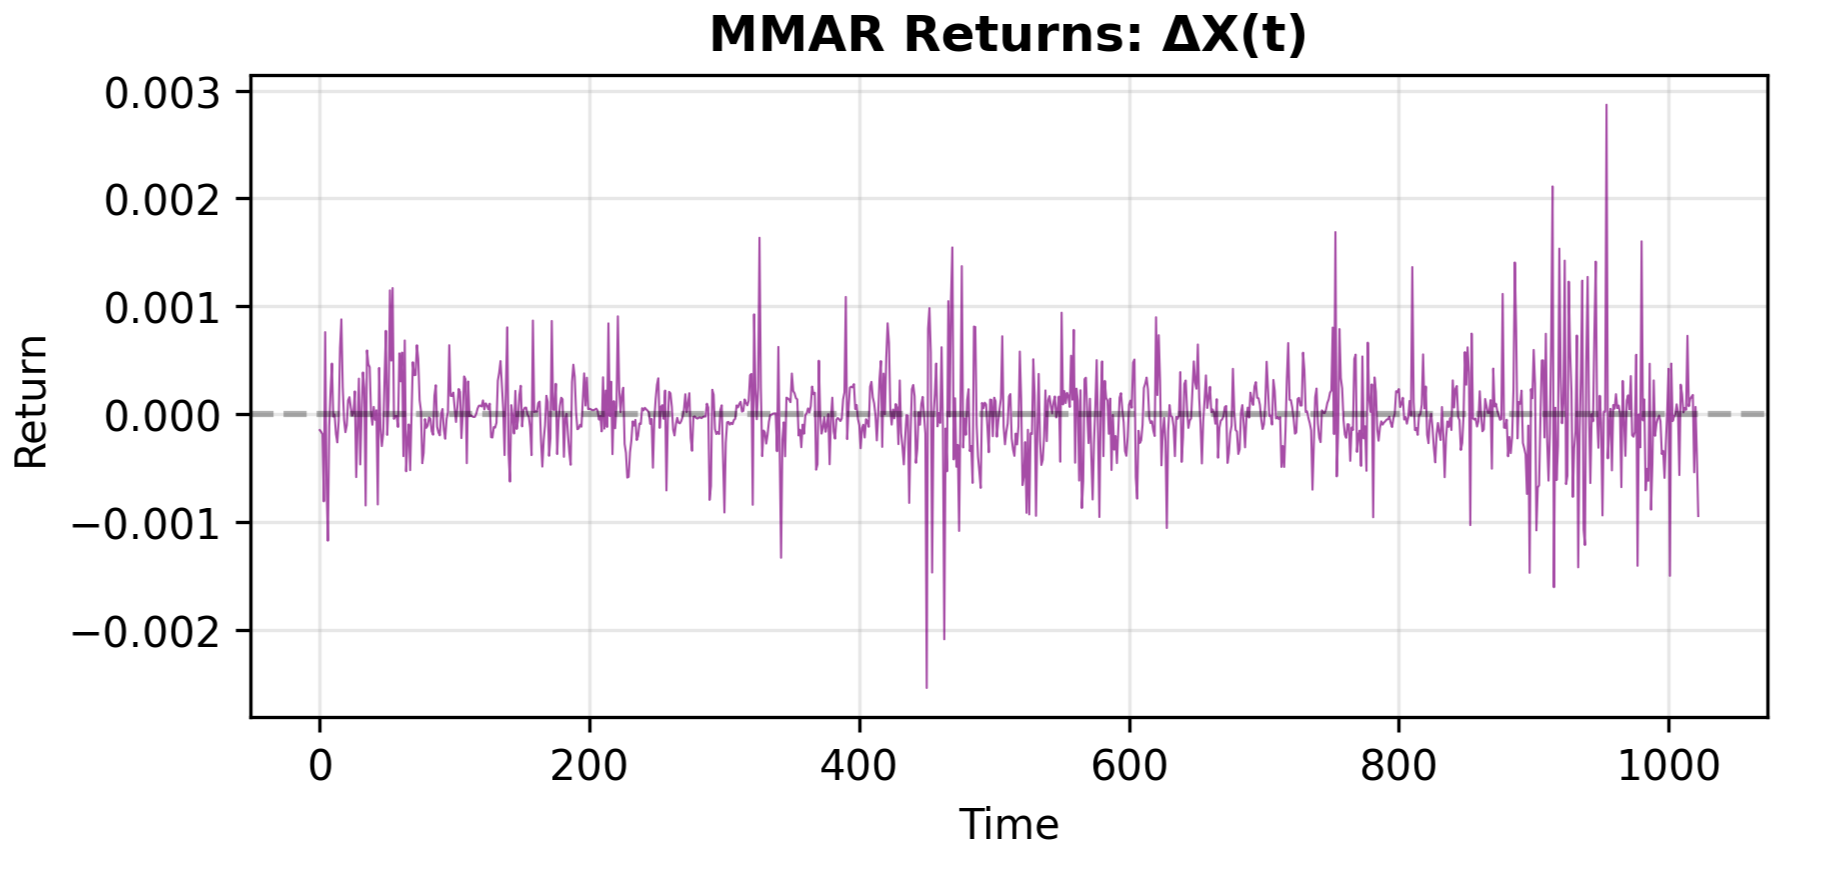
Рис. 9. Доходности MMAR. Хорошо видна кластеризация волатильности — за всплесками сильных движений следуют спокойные периоды
Шаг 7 — прогнозирование методом Монте-Карло
Один прогон моделирования MMAR дает одну реализацию процесса — один из возможных вариантов будущего. В каждом прогоне выбираются новые множители каскада и новые гауссовские случайные величины для FBM, поэтому оценки волатильности различаются. Чтобы получить устойчивый прогноз, мы проводим 1 000 независимых прогонов, каждый с новым каскадом и новой траекторией FBM. Прогноз волатильности — среднее из полученных 1 000 оценок.
Цикл моделирования
В каждом прогоне заново выполняются этапы 4-6 с новыми случайными значениями:
# step7_monte_carlo.py

class MonteCarloForecaster:
    def __init__(self, fitter, n_simulations=None,
                 forecast_length=None,
                 sample_volatility=None,
                 random_seed=config.RANDOM_SEED,
                 verbose=config.VERBOSE):
        self.fitter = fitter
        self.n_simulations = n_simulations or config.NUM_SIMULATIONS
        self.forecast_length = forecast_length or config.FORECAST_LENGTH
        self.sample_volatility = sample_volatility or 1.0
        self.cascade_b = config.CASCADE_B
        self.cascade_levels = self._calculate_cascade_levels(
            self.forecast_length
        )
        self.n_points = self.cascade_b ** self.cascade_levels

    def _calculate_cascade_levels(self, forecast_length):
        required_points = forecast_length + 1
        levels = int(np.ceil(np.log(required_points) / np.log(self.cascade_b)))
        return max(1, levels)
Метод _calculate_cascade_levels() определяет необходимое число уровней каскада в зависимости от длины прогноза. Поскольку каскад дает 2^k точек, необходимое число уровней вычисляется как k = ceil(log2(forecast_length + 1)). При forecast_length = 7 200 — 25 днях пятиминутных баров — получаем k = 13, поскольку 2^13 = 8 192 > 7 201. Лишние точки за пределами длины прогноза отбрасываются.
В каждом прогоне полностью выполняется последовательность этапов 4-6:
def run_single_simulation(self):
    # Step 4: Fresh trading time
    cascade_gen = CascadeGenerator(
        self.fitter, b=self.cascade_b,
        k=self.cascade_levels, verbose=False
    )
    cascade_gen.generate_cascade()
    cascade_gen.integrate_measure()

    # Step 5: Fresh FBM
    fbm_gen = FBMGenerator(
        H=self.fitter.H, n_points=self.n_points, verbose=False
    )
    fbm_gen.generate_fbm_davies_harte()
    fbm_gen.scale_fbm(self.sample_volatility)

    # Step 6: Combine
    combiner = MMARCombiner(fbm_gen, cascade_gen, verbose=False)
    _, returns = combiner.combine_fbm_and_trading_time()
    returns = returns[:self.forecast_length]

    return np.std(returns)
Для всех компонентов задано verbose=False, чтобы не получить 1 000 повторов сообщений о ходе выполнения. Ряд доходностей обрезается до forecast_length: при выбранном k каскад дает больше точек, чем нужно (2^k > forecast_length).
Основной цикл Монте-Карло выполняет все прогоны и собирает оценки волатильности:
def run_monte_carlo(self):
    if self.random_seed is not None:
        np.random.seed(self.random_seed)

    self.volatility_forecasts = []

    for i in range(self.n_simulations):
        volatility = self.run_single_simulation()
        self.volatility_forecasts.append(volatility)

        if self.verbose and (i + 1) % max(1, self.n_simulations // 10) == 0:
            progress = 100 * (i + 1) / self.n_simulations
            mean_so_far = np.mean(self.volatility_forecasts)
            print(f"  Progress: {progress:.1f}% - Mean vol: {mean_so_far:.6f}")

    self.mean_forecast = np.mean(self.volatility_forecasts)
    self.std_forecast = np.std(self.volatility_forecasts)
На выходе получаем точечную оценку — среднюю волатильность по всем прогонам, меру неопределенности — стандартное отклонение оценок волатильности, — и 95%-ный доверительный интервал (mean +/- 1.96 * std). Скрипт запуска берет оценку выборочной волатильности из обучающих данных, чтобы масштабирование FBM соответствовало наблюдаемым рыночным условиям:
# run_step7.py

# Load historical returns from Step 1 to get actual sample volatility
with open(step1_path, 'rb') as f:
    checker = pickle.load(f)

sample_volatility = np.std(checker.returns)

forecaster = run_monte_carlo_forecast(fitter,
    sample_volatility=sample_volatility,
    n_simulations=config.NUM_SIMULATIONS,
    forecast_length=config.FORECAST_LENGTH)
Сходимость
График сходимости показывает, стабилизируется ли накопленное среднее по мере добавления прогонов. Так проверяется достаточность 1 000 моделирований. Если после 1 000 прогонов накопленное среднее все еще заметно меняется, потребуется больше моделирований. На практике среднее обычно стабилизируется в первые 500-800 прогонов; последующие лишь уточняют оценку. Q-Q-график позволяет проверить, близко ли распределение прогнозов к нормальному, как предполагает центральная предельная теорема. Каждый прогноз — агрегированный показатель: стандартное отклонение, рассчитанное по тысячам значений доходности.
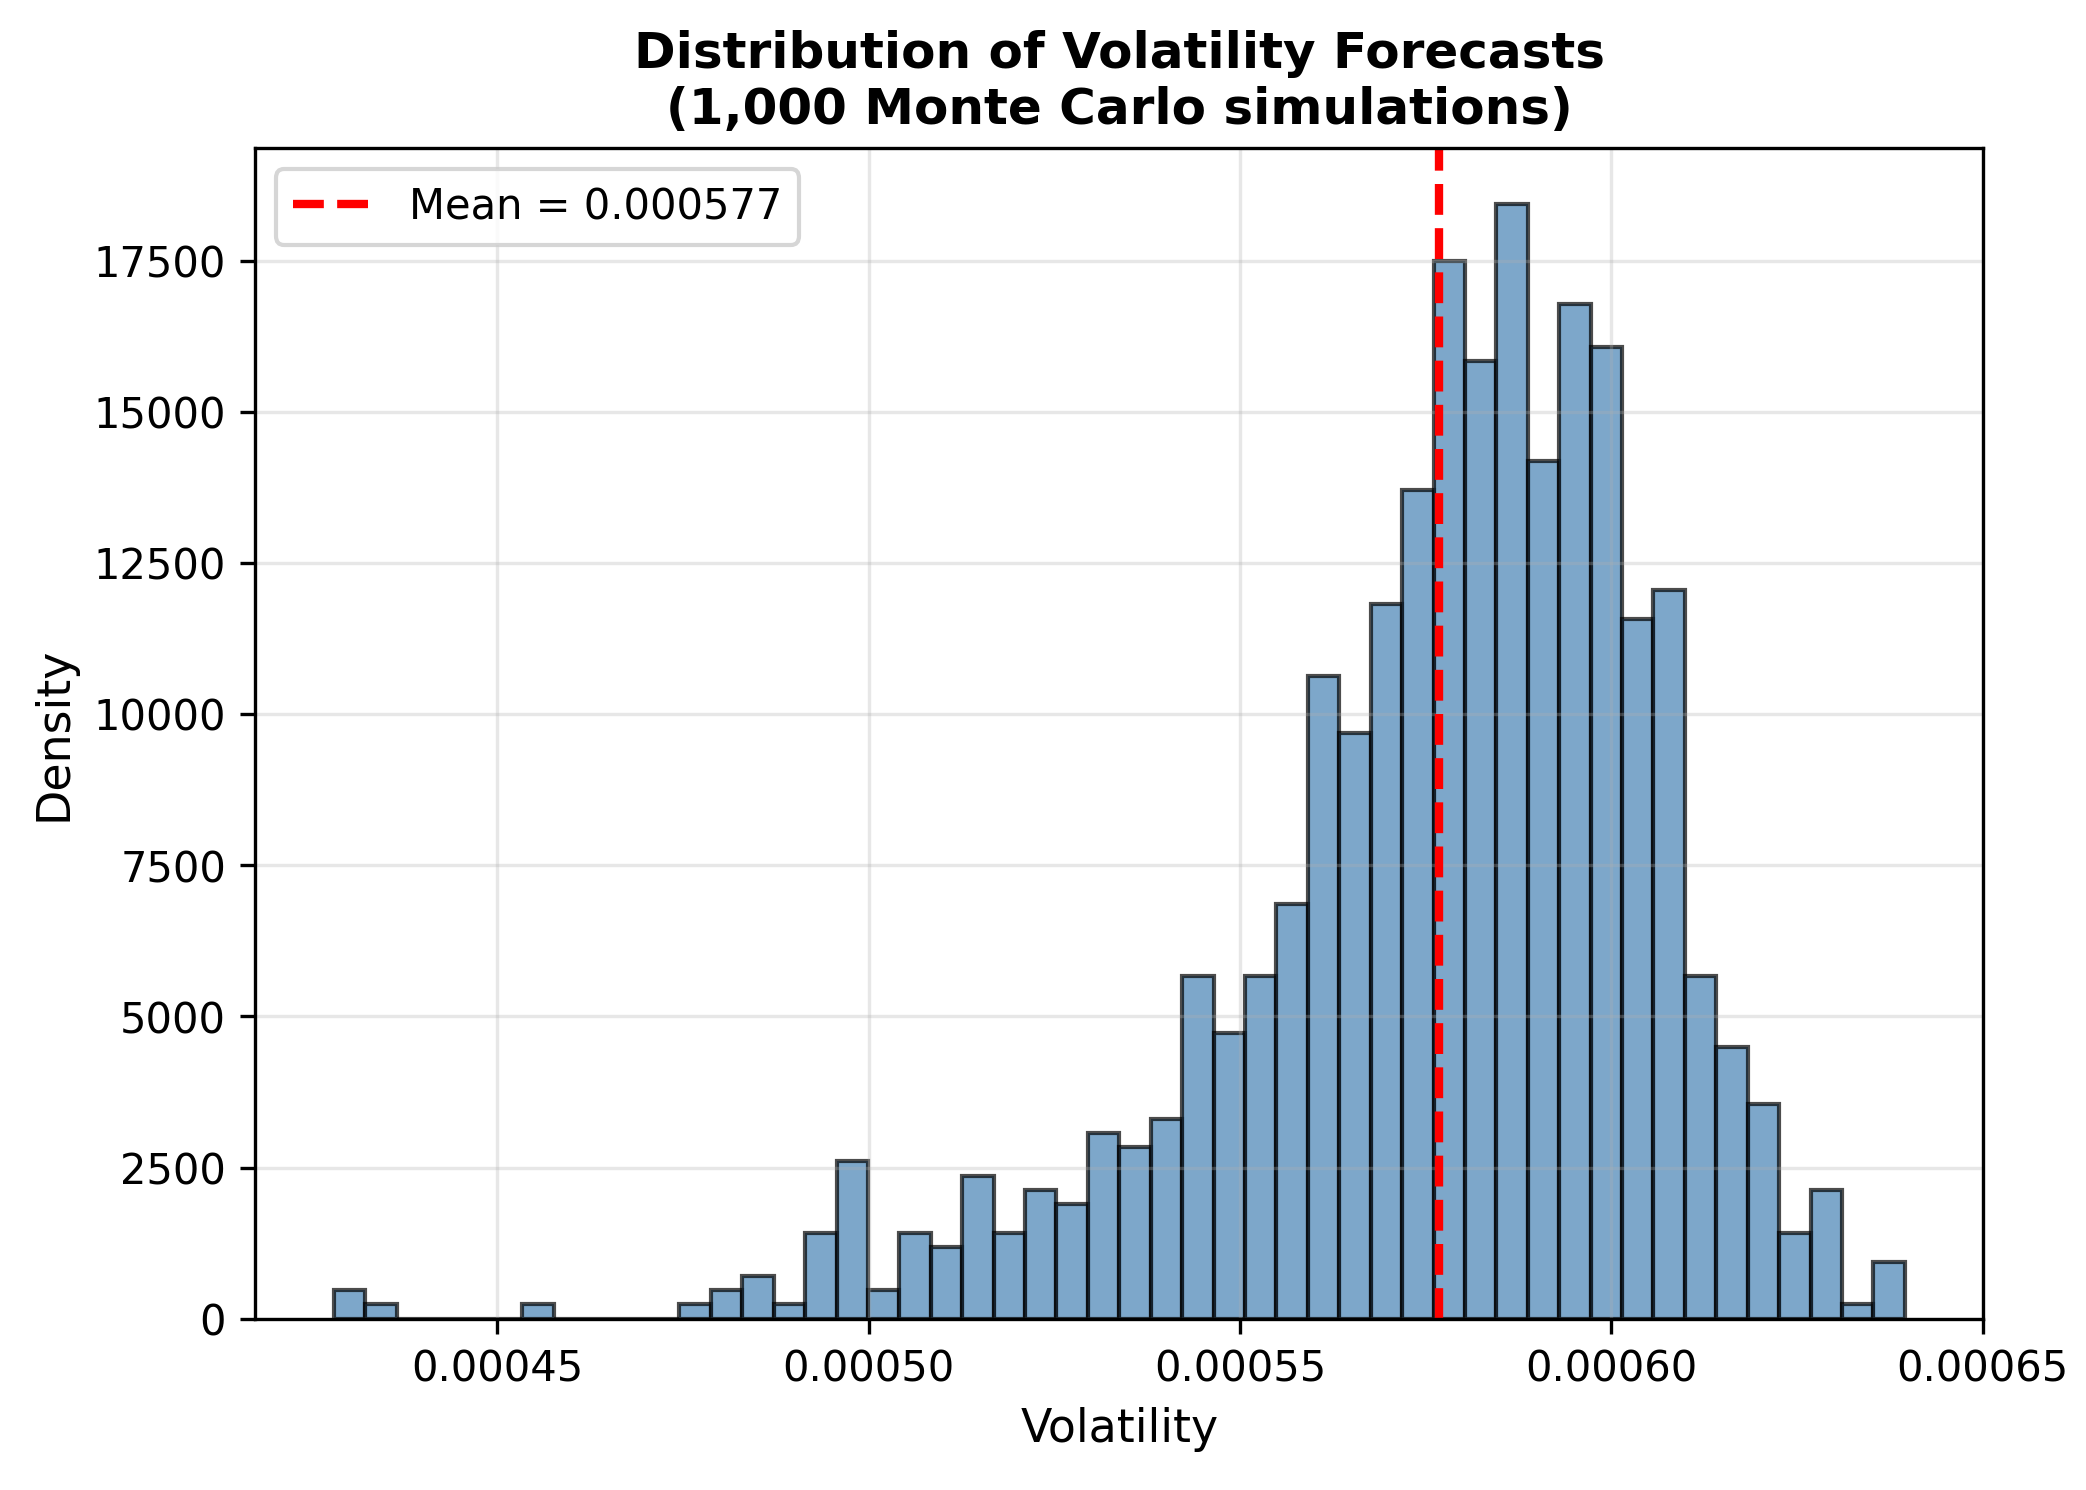
Рис. 10. Распределение 1 000 прогнозов волатильности методом Монте-Карло — как и ожидалось, приблизительно гауссовское
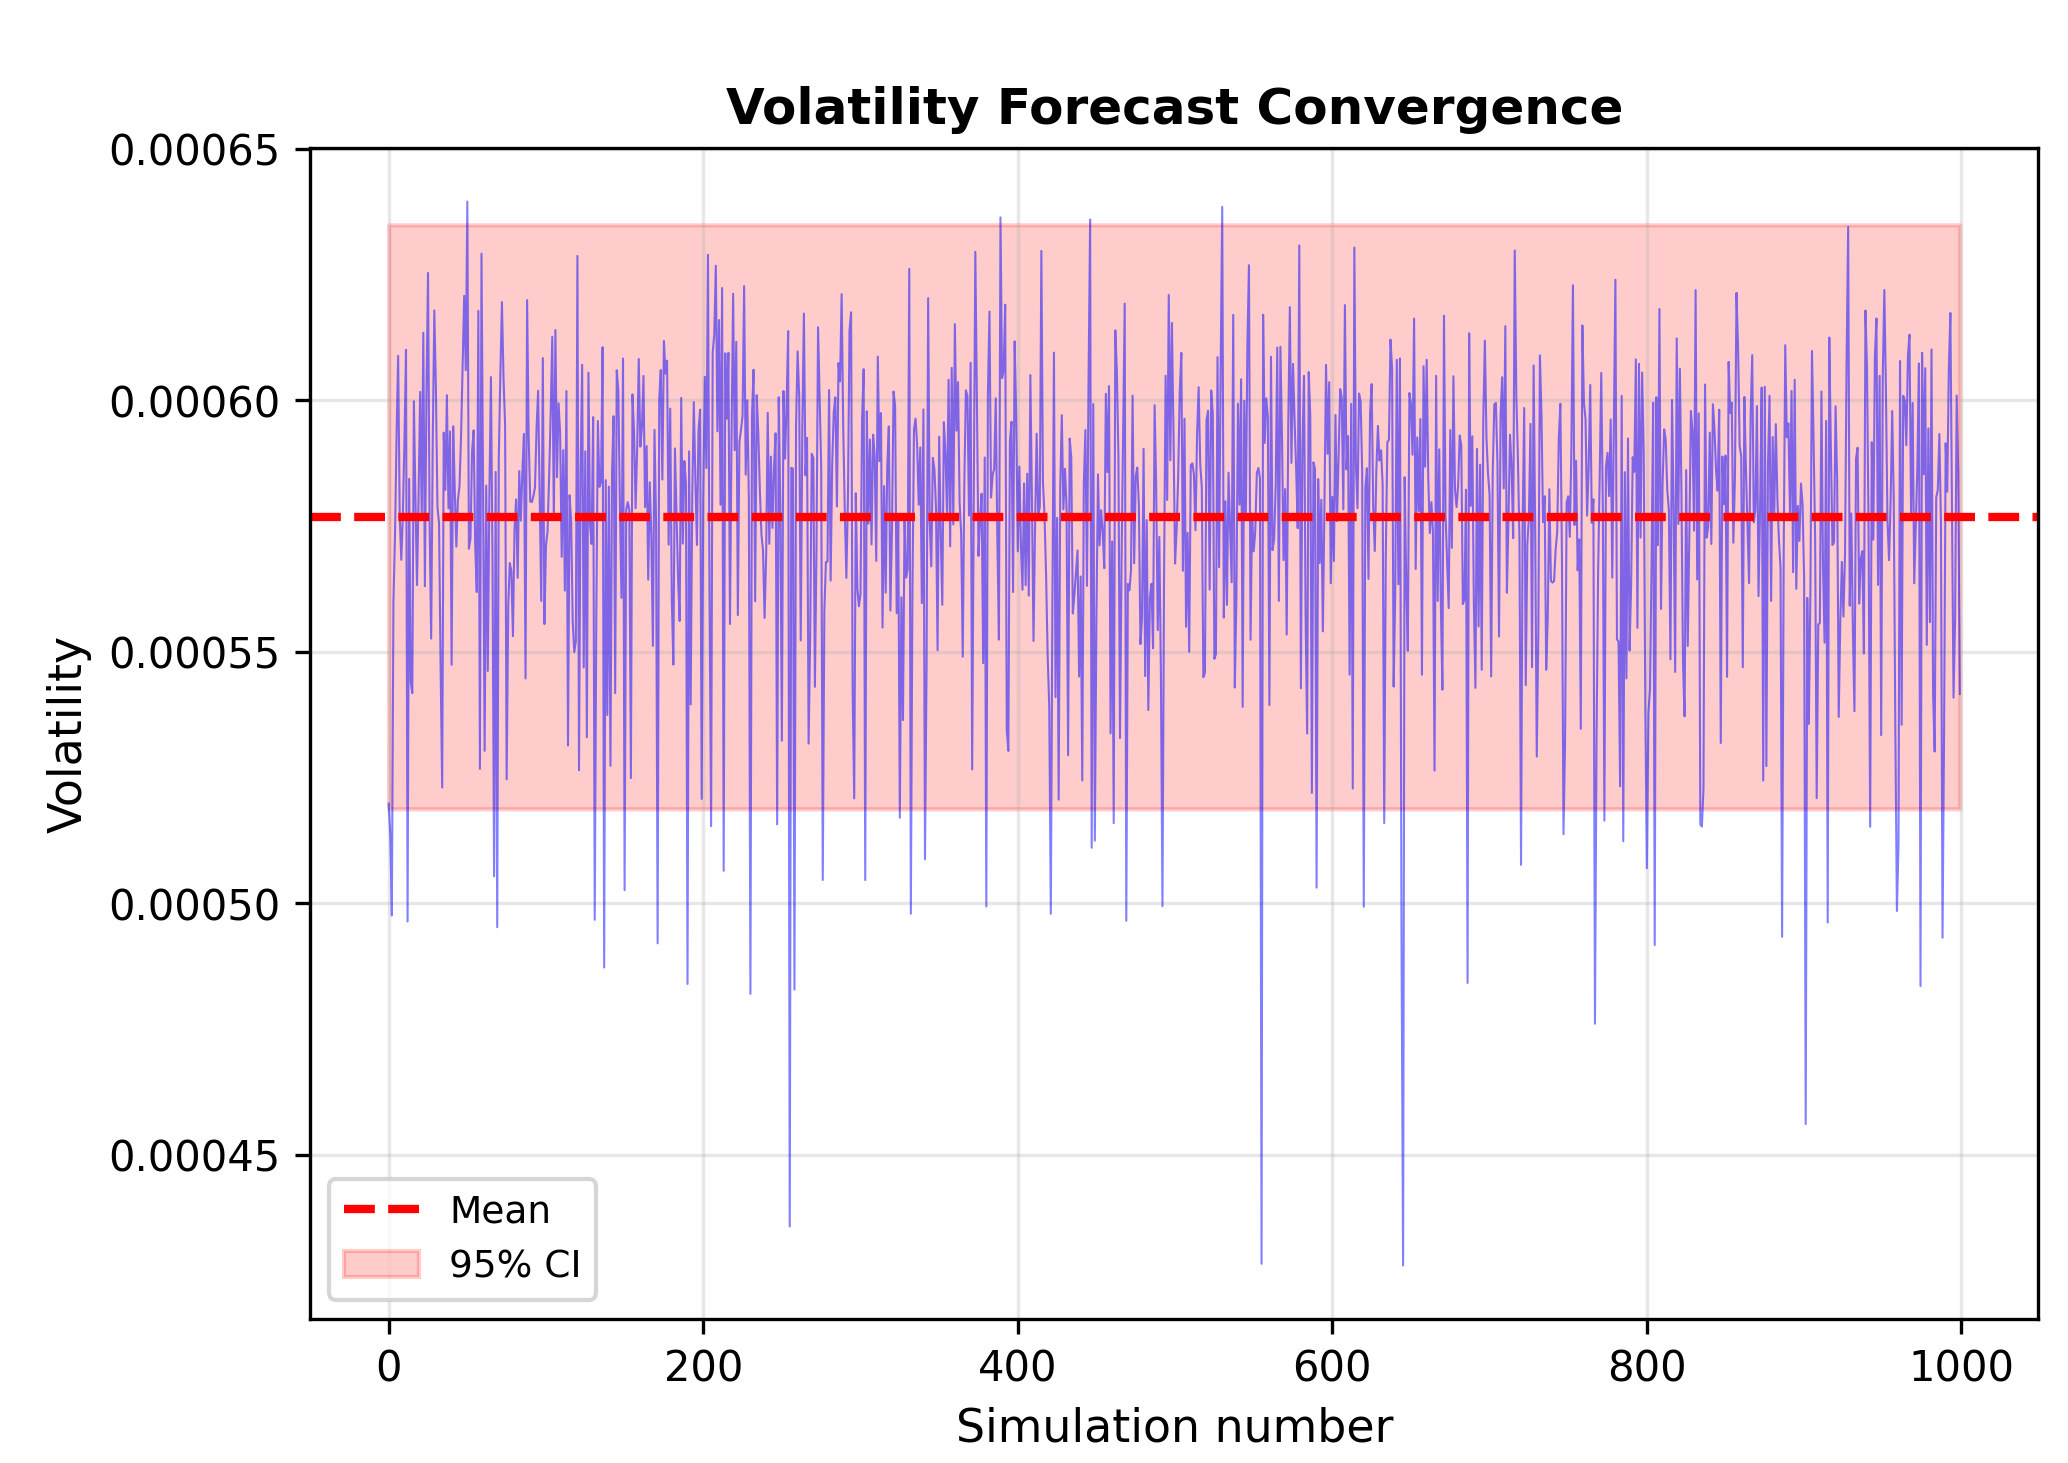
Рис. 11. Сходимость накопленного среднего — оценка стабилизируется задолго до 1 000 прогонов
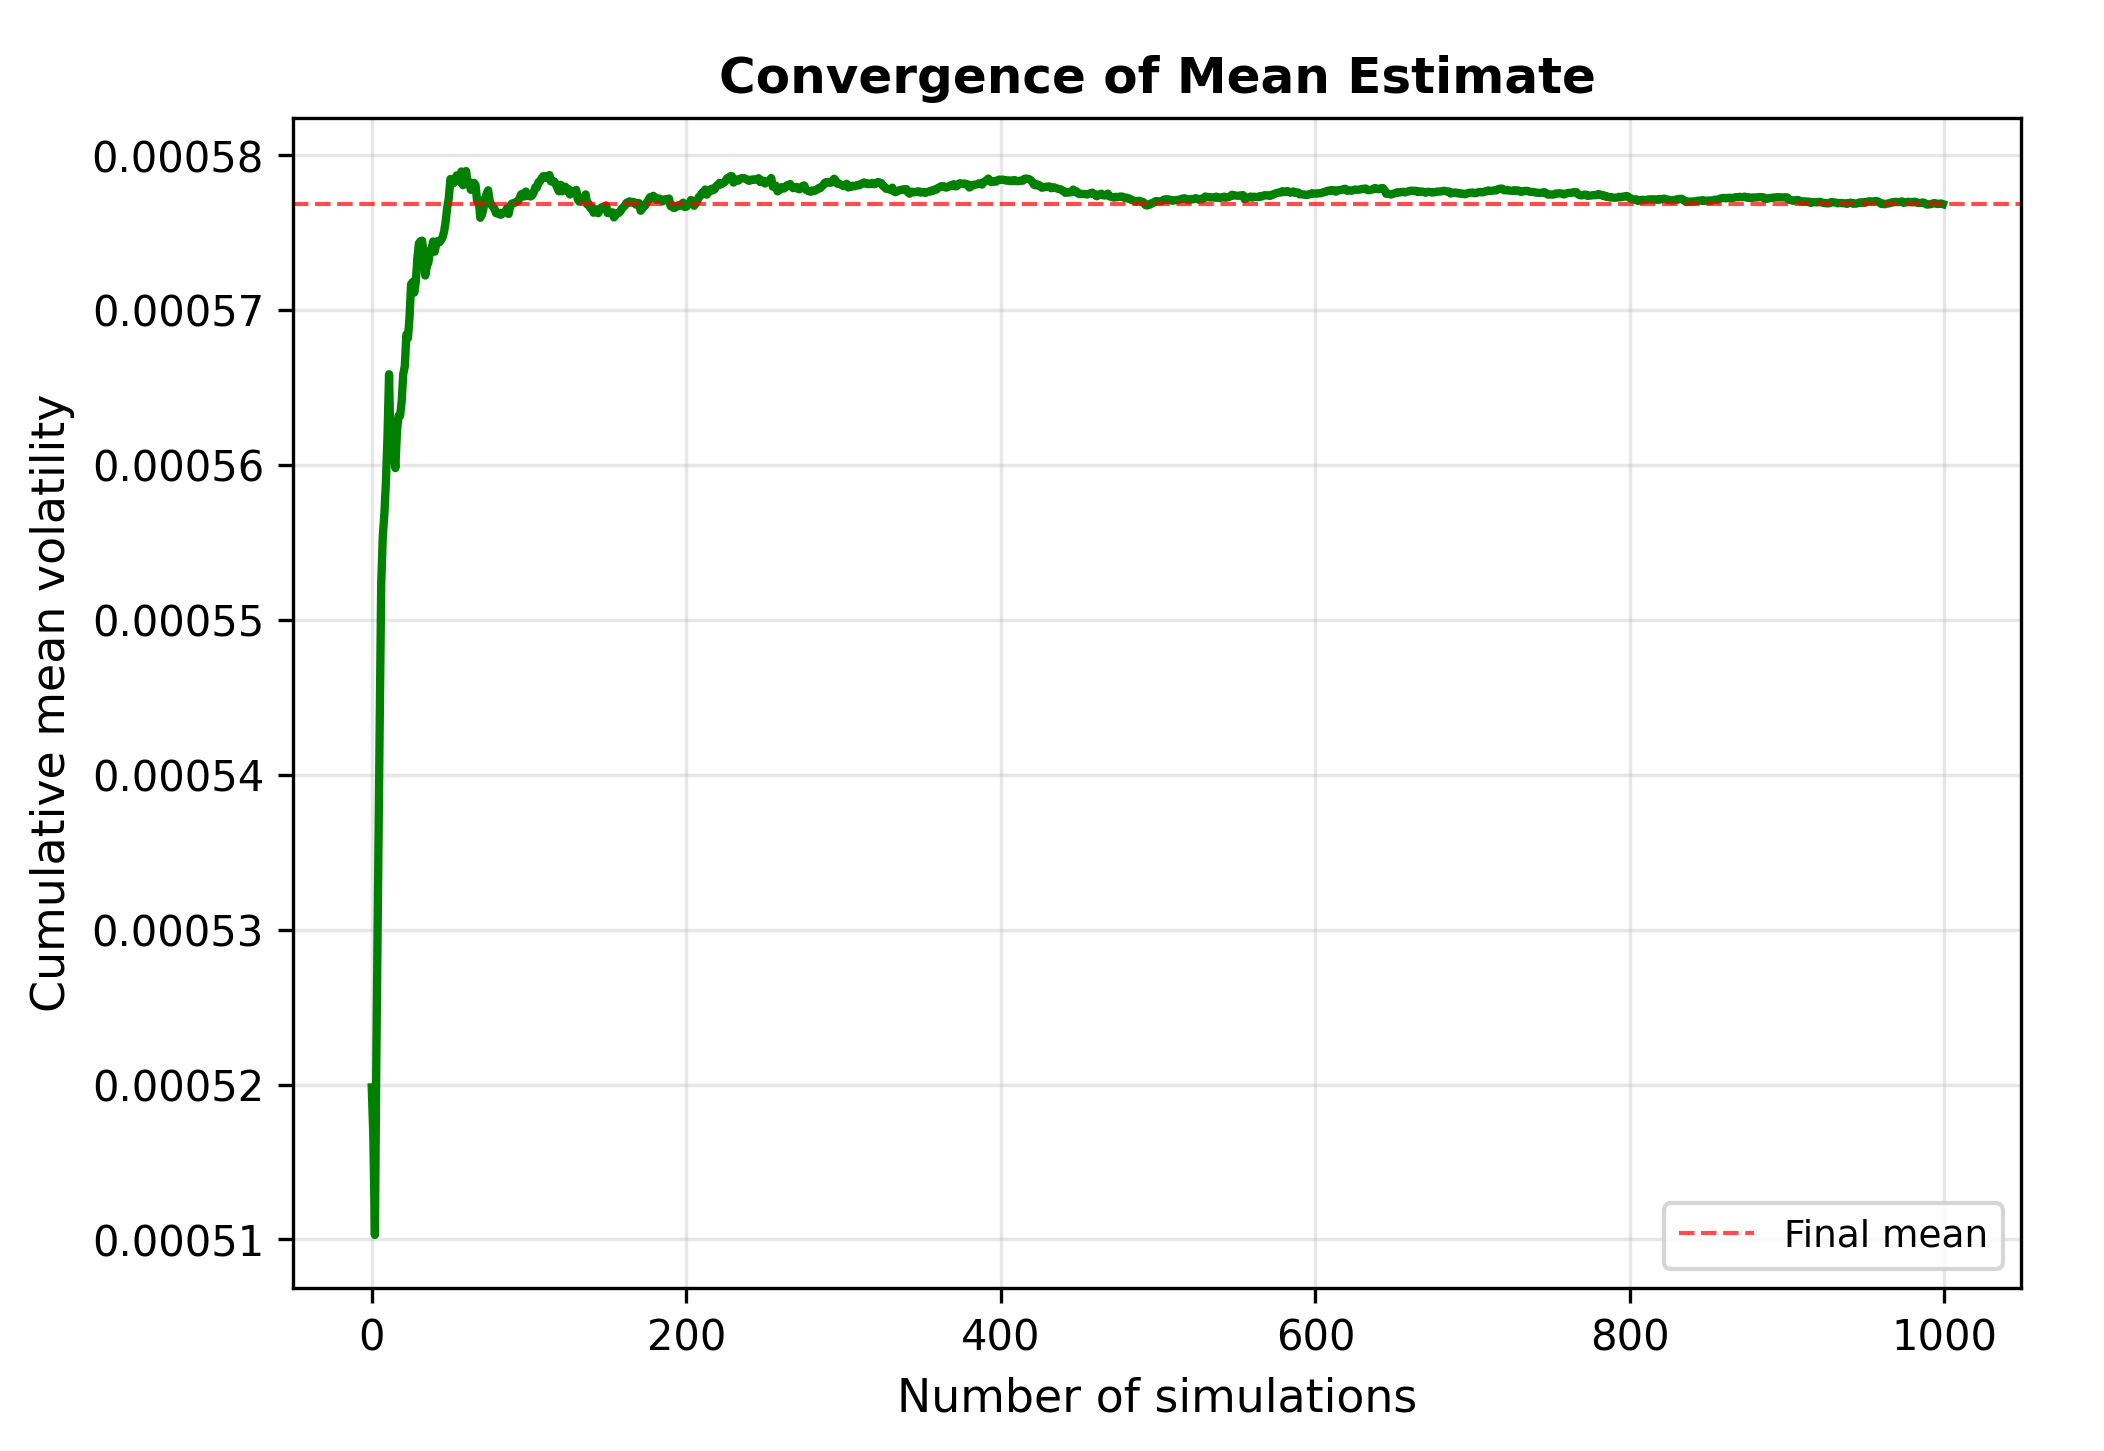
Рис. 12. Отдельные реализации прогноза с полосой 95%-ного доверительного интервала
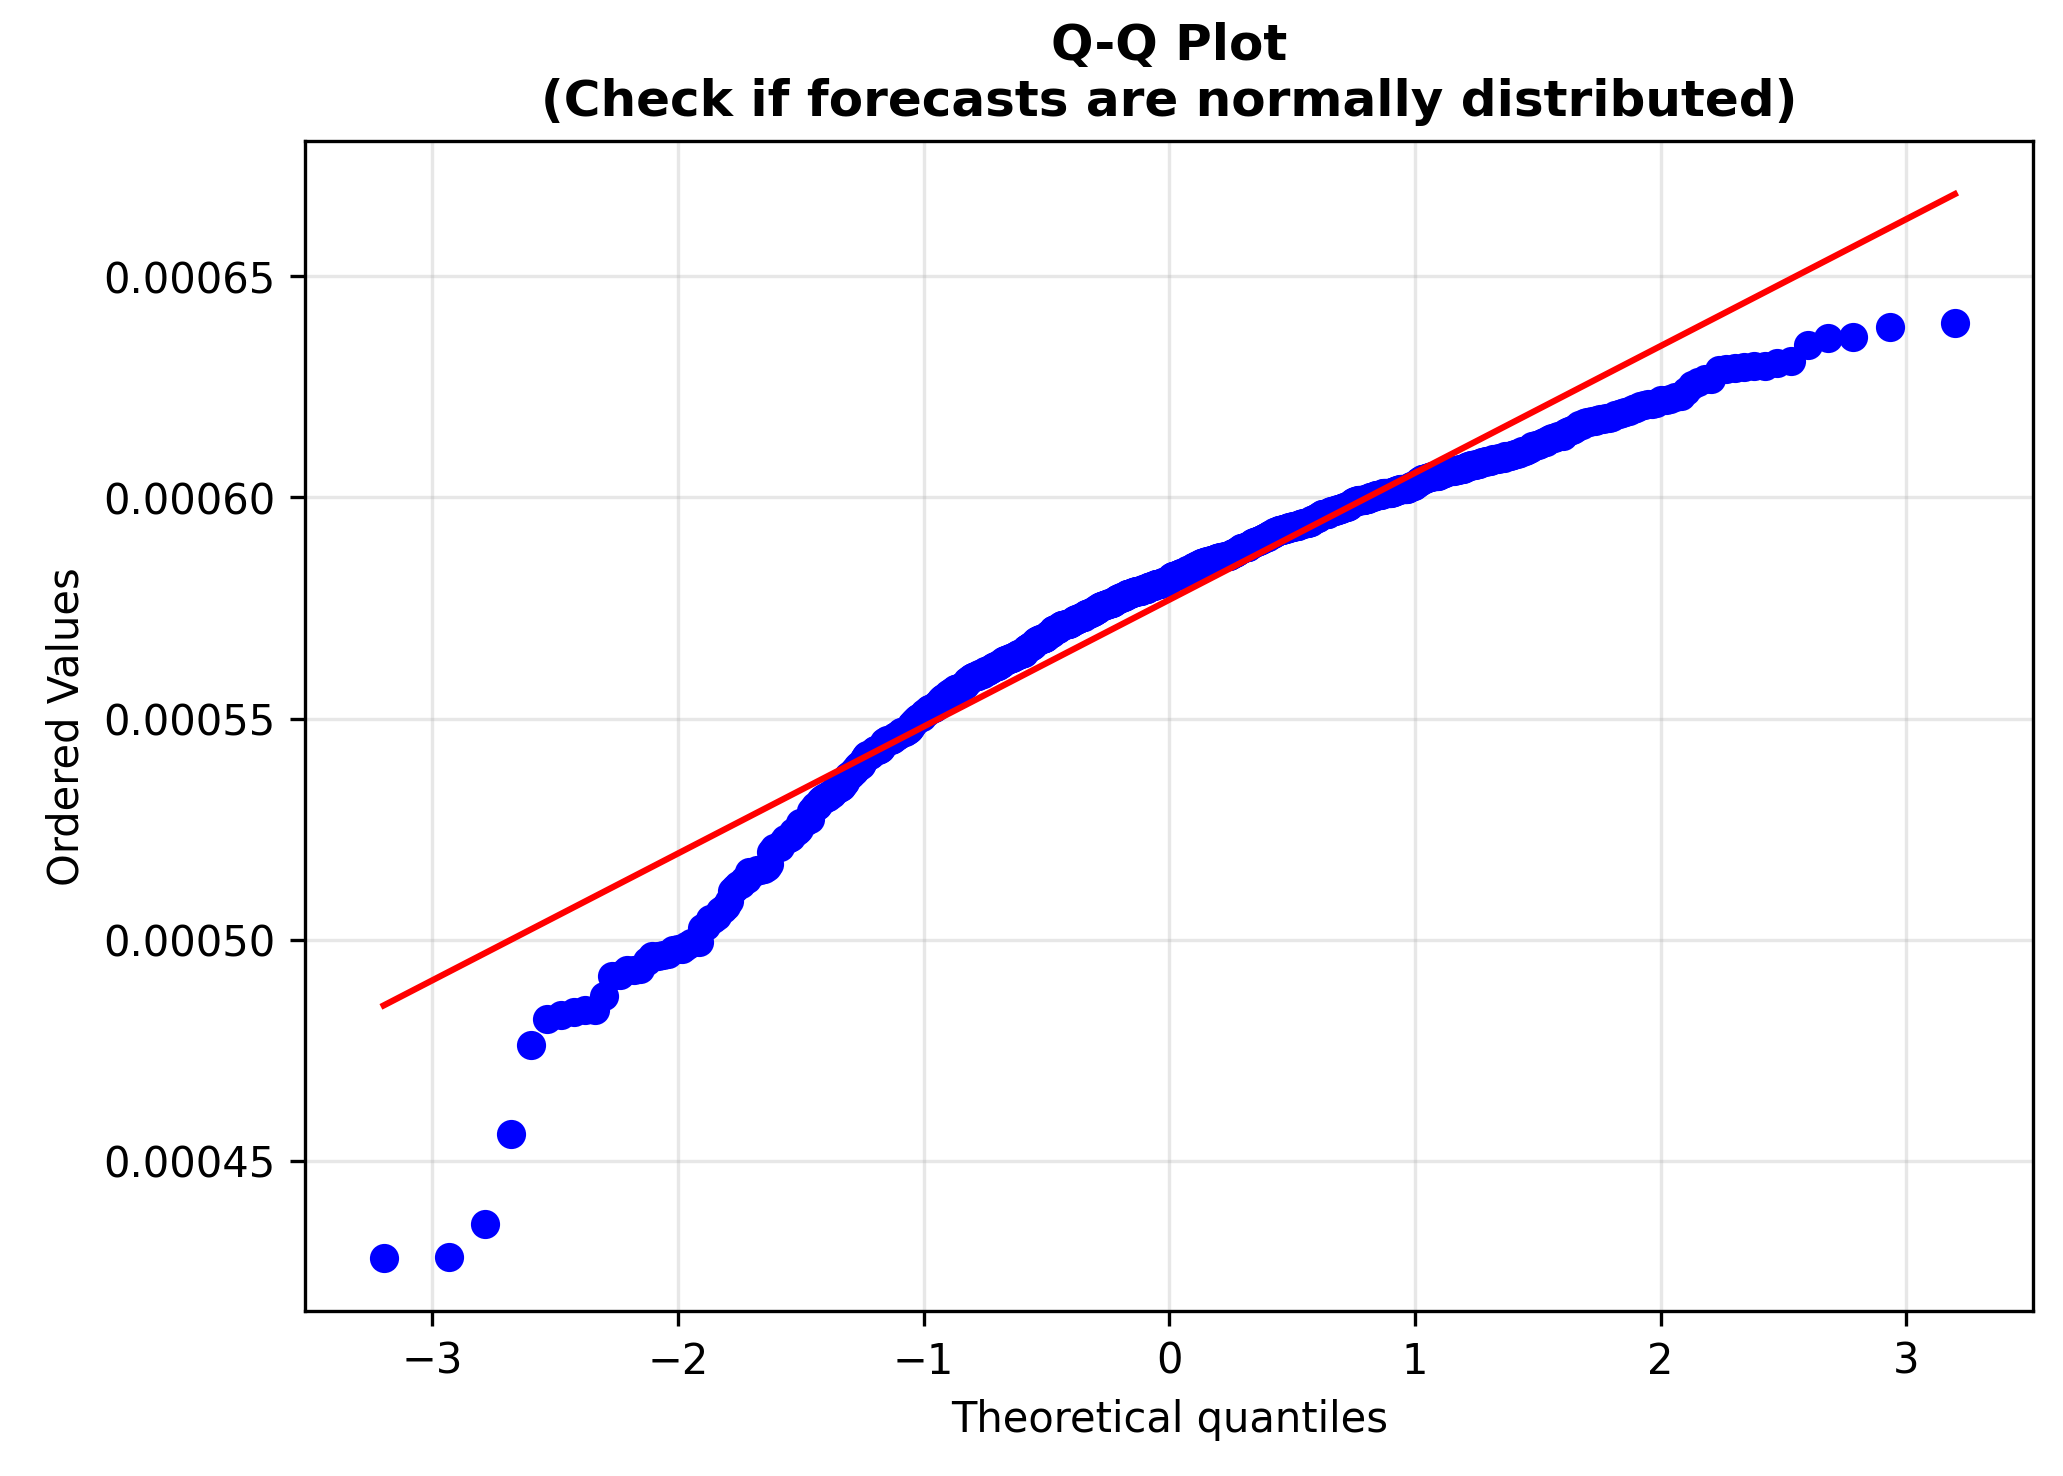
Рис. 13. Q-Q-график, подтверждающий нормальность распределения прогнозов
Реализация GARCH
Для объективного сравнения мы оцениваем модели GARCH на тех же обучающих данных, что и MMAR. Это необходимое условие, а не просто хорошая практика: если обучающие данные различаются, сравнение искажается и уже нельзя приписать разницу в результатах самим моделям.
В нашей реализации используется библиотека Python arch — пакет для моделирования ARCH/GARCH. Мы оцениваем стандартную модель GARCH(1,1) с нормально распределенными инновациями:
# garch_model.py

class GARCHForecaster:
    def __init__(self, returns, p=1, q=1,
                 dist='normal', random_seed=config.RANDOM_SEED,
                 verbose=True):
        self.returns = returns * 100  # arch expects percentage returns
        self.p = p
        self.q = q
        self.dist = dist
Доходности в первой строке умножаются на 100: библиотека arch работает с процентными значениями, а не с исходными десятичными дробями. После построения прогноза масштабирование отменяется, чтобы результат был выражен в тех же единицах, что и прогноз MMAR.
При оценке модели используется rescale=True — параметр, важный для численной устойчивости. Доходности EURUSD на пятиминутном таймфрейме малы — порядка 0,0001. Даже после умножения на 100 условная дисперсия может оставаться очень малой. Функция rescale библиотеки arch автоматически масштабирует данные для численной устойчивости при оптимизации, а затем возвращает результаты к исходному масштабу. Без этого оптимизация может не сойтись или дать бессмысленные значения параметров.
def fit(self):
    self.model = arch_model(
        self.returns,
        vol='GARCH',
        p=self.p,
        q=self.q,
        dist=self.dist,
        rescale=True,
    )
    self.fit_result = self.model.fit(
        disp='off',
        options={'ftol': 1e-6, 'maxiter': 1000}
    )
Методика прогнозирования
Без этого оптимизация может не сойтись или дать бессмысленные значения параметров. Чжан не использует стандартный аналитический многошаговый прогноз GARCH, результатом которого была бы траектория дисперсии. Вместо этого он моделирует по оцененной модели одну траекторию из FORECAST_LENGTH значений доходности и вычисляет ее стандартное отклонение. Так же работает функция ugarchsim в R. При таком подходе прогнозы GARCH и MMAR относятся к одному горизонту и выражены в одних единицах:
def forecast(self, n_sim=None):
    if n_sim is None:
        n_sim = config.FORECAST_LENGTH

    if self.random_seed is not None:
        np.random.seed(self.random_seed)

    # Simulate ONE path of n_sim returns
    sim = self.fit_result.forecast(
        horizon=n_sim, method='simulation', simulations=1
    )
    sim_returns = sim.simulations.values[0, 0, :]

    # Unscale if model was rescaled
    if hasattr(self.model, 'scale') and self.model.scale is not None:
        sim_returns = sim_returns / self.model.scale

    # Convert from percentage back to decimal
    self.forecast_volatility = np.std(sim_returns) / 100
    return self.forecast_volatility
Здесь выполняются две операции обратного масштабирования. Во-первых, если применялось внутреннее масштабирование rescale=True, смоделированные доходности нужно разделить на self.model.scale, чтобы вновь выразить их в процентах. Во-вторых, делим результат на 100 и возвращаемся от процентной доходности к десятичной, отменяя умножение на 100 в конструкторе.
Почему методика различается?
Это не ошибка согласования методик MMAR и GARCH: именно так Чжан (2017) сравнивал модели. Для MMAR требуется много прогонов — 1 000 у нас и 10 000 у Чжана. Каждая реализация каскада случайна: новые множители дают иное распределение массы, а значит, и иную оценку волатильности. Усреднение результатов множества прогонов сглаживает эту случайную изменчивость. Для GARCH достаточно одного прогона: динамика модели определяется оцененными параметрами omega, alpha и beta. При неизменных параметрах модели траектория условной дисперсии детерминирована; случайны лишь выбранные инновации. В одном достаточно длинном прогоне усредняется множество инноваций, и получается устойчивая оценка волатильности.
Скрипт сравнения загружает те же обучающие данные, что использовались на первом этапе:
# garch_model.py

def run_garch_comparison(p=1, q=1, dist='normal',
                         output_dir=None, verbose=True):
    # Load training data from Step 1 (same as MMAR uses)
    step1_path = Path(config.OUTPUT_DIR) / "step1_checker.pkl"
    with open(step1_path, 'rb') as f:
        checker = pickle.load(f)

    returns = checker.returns

    forecaster = GARCHForecaster(
        returns=returns, p=p, q=q, dist=dist, verbose=verbose
    )
    forecaster.fit()
    forecast_vol = forecaster.forecast(n_sim=config.FORECAST_LENGTH)

    return {'GARCH': {
        'forecaster': forecaster,
        'forecast_volatility': forecast_vol,
        'aic': forecaster.fit_result.aic,
        'bic': forecaster.fit_result.bic,
        'loglik': forecaster.fit_result.loglikelihood
    }}
Решающее сравнение — результаты
После оценки моделей и построения прогнозов мы загружаем вневыборочные данные за 25 дней после обучающего периода и рассчитываем реализованную волатильность как стандартное отклонение фактических доходностей. Это наше эталонное значение для сравнения. Сравнение организует скрипт run_garch_comparison.py. Скрипт загружает прогноз MMAR с седьмого этапа, оценивает модель GARCH, вычисляет реализованную волатильность через ForecastComparison и сравнивает модели по процентной погрешности:
# run_garch_comparison.py

# Step 1: Fit GARCH model
garch_results = run_garch_comparison(p=1, q=1, dist='normal', verbose=True)

# Step 2: Load MMAR forecast from Step 7
mmar_path = Path(config.OUTPUT_DIR) / "step7_forecaster.pkl"
with open(mmar_path, 'rb') as f:
    mmar_forecaster = pickle.load(f)
mmar_forecast = mmar_forecaster.mean_forecast

# Step 3: Get realized volatility via ForecastComparison
comparison = run_forecast_comparison(save_plots=False)
realized_vol = comparison.realized_volatility
Класс ForecastComparison загружает данные начиная со дня после окончания обучения и вычисляет реализованную волатильность как выборочное стандартное отклонение с поправкой Бесселя (ddof=1) — несмещенную оценку:
# compare_forecast.py

class ForecastComparison:
    def load_forecast_period_data(self, start_date=None, end_date=None,
                                 days_ahead=None):
        if start_date is None:
            training_end = pd.to_datetime(config.END_DATE)
            start_date = (training_end + timedelta(days=1)).strftime("%Y-%m-%d")

        if days_ahead is None:
            days_ahead = config.FORECAST_DAYS

        loader = DataLoader(
            symbol=config.SYMBOL,
            start_date=start_date,
            end_date=end_date
        )
        loader.load_from_mt5()
        loader.calculate_returns(price_column='close', method='log')
        self.realized_returns = loader.get_returns_array()

    def calculate_realized_volatility(self):
        self.realized_volatility = np.std(self.realized_returns, ddof=1)
Рассчитываются абсолютная и процентная погрешности, MAPE, RMSE и границы доверительного интервала. Также проверяется, попадает ли реализованная волатильность в 95%-ный доверительный интервал MMAR:
def compute_error_metrics(self):
    self.error = self.forecast_volatility - self.realized_volatility
    self.percent_error = 100 * self.error / self.realized_volatility
    self.rmse = np.sqrt((self.error)**2)
    mape = np.abs(self.percent_error)

    lower_bound = self.forecast_volatility - 1.96 * self.forecast_std
    upper_bound = self.forecast_volatility + 1.96 * self.forecast_std
    within_ci = lower_bound <= self.realized_volatility <= upper_bound

    return {
        'forecast': self.forecast_volatility,
        'realized': self.realized_volatility,
        'error': self.error,
        'percent_error': self.percent_error,
        'abs_percent_error': mape,
        'rmse': self.rmse,
        'forecast_std': self.forecast_std,
        'forecast_95ci_lower': lower_bound,
        'forecast_95ci_upper': upper_bound,
        'within_95ci': within_ci
    }
При сравнении по правилу квадратного корня из времени также рассчитывается аннуализированная волатильность для пятиминутного, часового, дневного и годового интервалов. Так результаты можно представить в показателях, привычных практикующим специалистам:
# run_comparison.py

periods_per_year = config.periods_per_year()
ann_forecast = comparison.forecast_volatility * (periods_per_year ** 0.5) * 100
ann_realized = comparison.realized_volatility * (periods_per_year ** 0.5) * 100
Итоговая таблица сопоставляет MMAR и GARCH по процентной погрешности прогноза относительно реализованной волатильности:
# terminal output
======================================================================
FULL COMPARISON: MMAR vs GARCH vs REALIZED
======================================================================
Model Forecast Error Error % AIC BIC
-------------------------------------------------------------------------------------
MMAR 0.0005768527 0.0002260410 64.43% N/A N/A
GARCH 0.0010309505 0.0006801388 193.88% 36880.79 36912.30
-------------------------------------------------------------------------------------
REALIZED 0.0003508117
=====================================================================================
BEST MODEL: MMAR (Error: 64.43%)
======================================================================
MMAR vs GARCH
======================================================================
MMAR снижает процентную погрешность на 129,44 процентных пункта
Результаты согласуются с исследованием Чжана (2017): на данных 20 американских акций MMAR дала меньшую среднеквадратичную ошибку прогноза, чем все протестированные варианты GARCH. Главная причина связана со структурой моделей: GARCH представляет условную дисперсию одним процессом временного ряда и поэтому учитывает лишь один тип масштабирования. MMAR соединяет компонент долгой памяти (FBM) и компонент мультифрактального торгового времени. Благодаря этому модель отражает весь спектр типов масштабирования, наблюдаемых в рыночных данных. Там, где GARCH описывает один процесс волатильности, MMAR выявляет многомасштабную структуру.
Заключение
В первой, второй и этой, третьей, частях мы построили и протестировали полный пайплайн MMAR по методике Чжана (2017). В первой и второй частях мы подтвердили мультифрактальность данных EURUSD на пятиминутном таймфрейме и определили параметры для построения модели. Здесь мы применили параметры на практике и напрямую сравнили модели в одинаковых условиях. Общая картина такова:
- MMAR учитывает больше особенностей рынка. Объединяя фракционное броуновское движение (долгая память) и мультифрактальное торговое время (тяжелые хвосты и кластеризация), MMAR воспроизводит четыре стилизованных факта финансовых доходностей за счет самой структуры модели, а не отдельных поправок к параметрам. Долгая память связана со степенным затуханием автоковариации FBM. Тяжелые хвосты возникают из-за неравномерного хода торгового времени. Кластеризация волатильности обусловлена самоподобным распределением массы в каскаде. Масштабная согласованность обусловлена самой мультифрактальной структурой.
- GARCH не ошибочна, но ограничена. Модели GARCH быстро рассчитываются, хорошо изучены и эффективны в пределах своих допущений. Но реальные рыночные данные систематически не соответствуют этим допущениям: тонким хвостам, короткой памяти и равномерному ходу времени. Расширения GARCH учитывают отдельные ограничения: EGARCH — асимметрию, FIGARCH — долгую память, t-распределение Стьюдента — тяжелые хвосты. Остальные ограничения при этом сохраняются. MMAR учитывает их в рамках одного архитектурного решения — составного процесса X(t) = B_H[theta(t)].
- Сравнение корректно. Обе модели использовали одинаковые обучающие данные и горизонт прогноза; прогнозы строились по методике Чжана.
Тем не менее MMAR не лишена ограничений. MMAR требует больше вычислений: 1 000 прогонов методом Монте-Карло, каждый с полным пайплайном "каскад + FBM + объединение", занимают заметно больше времени, чем оценка GARCH в ходе одной оптимизации. Построение каскада вносит случайную изменчивость, для усреднения которой нужно много прогонов. Результат MMAR зависит и от мультифрактальности данных. Если инструмент или таймфрейм не проходит проверку на шаге 2 второй части, GARCH вполне может оказаться лучше.
Вычислительные затраты ощутимы, но остаются вполне управляемыми. На современном компьютере 1 000 прогонов занимают менее минуты. Основные вычислительные затраты приходятся на этап Монте-Карло; анализ и подгонка из первой и второй частей выполняются быстро. При практическом использовании анализ выполняют один раз, сохраняют параметры — H, тип распределения и его параметры, — а прогнозы методом Монте-Карло запускают по мере необходимости.
В четвертой части серии мы начнем перенос MMAR в код MQL5 с анализа функции разбиения: функции масштабирования, показателя Херста и проверки мультифрактальности, составляющих основу оценки параметров. В пятой части рассмотрим подгонку мультифрактального спектра к теоретическим распределениям методом оптимизации с ограничениями. В шестой части создадим движок моделирования: фракционное броуновское движение по алгоритму Дэвиса — Харта и мультипликативный каскад для формирования мультифрактального торгового времени. В седьмой части поместим движок моделирования в цикл Монте-Карло, чтобы получать прогнозы волатильности с доверительными интервалами. Наконец, в восьмой части соберем полную библиотеку MMAR и применим ее в советнике.
Отказ от ответственности: эта статья предназначена исключительно для образовательных и исследовательских целей. Представленные здесь модели и программный код основаны на научных исследованиях и не должны рассматриваться как финансовые рекомендации. Прогнозирование волатильности по своей природе сопряжено с неопределенностью. Прежде чем рисковать реальными деньгами, всегда проверяйте модели на вневыборочных данных и тестируйте их на демо-счетах.
Как получить исходный код через MQL5 Algo Forge
Все исходные файлы приложены к статье ниже. Полный репозиторий также доступен на MQL5 Algo Forge — платформе сообщества на базе Git для обмена торговыми проектами и совместной работы над ними. Algo Forge хранит историю версий локально и в облаке, поэтому вам будет доступна актуальная версия кода, в том числе обновления и исправления, внесенные после публикации статьи.
Чтобы клонировать репозиторий, откройте командную строку, PowerShell или встроенный терминал редактора и выполните команду:
git clone https://forge.mql5.io/ayantrader/MMAR.git
Для этого на вашем компьютере должен быть установлен Git. Если вы работаете в Visual Studio Code, откройте встроенный терминал сочетанием клавиш Ctrl+` и выполните команду прямо в нем. Репозиторий будет клонирован в папку MMAR в текущем каталоге.
Кроме того, проект можно просматривать по адресу forge.mql5.io/ayantrader/MMAR: исходные файлы, историю коммитов и обновления можно открыть прямо в браузере. В отличие от приложенных файлов, Algo Forge дает доступ ко всей истории Git и позволяет загружать будущие обновления одной командой:
git pull
| Имя файла | Описание |
|---|---|
| config.py | Параметры конфигурации, вспомогательные функции и проверка данных для всего пайплайна |
| data_loader.py | Загрузка данных из MetaTrader 5 с резервной загрузкой из CSV, расчет доходностей и проверка качества данных |
| utils.py | Общие служебные функции: скользящие окна, расчет волатильности и автокорреляции, таймер, экспорт в JSON |
| step1_check_fractality.py | Анализ функции разбиения на неперекрывающихся интервалах, оценка коэффициента детерминации R², поиск кроссовера |
| step2_extract_scaling.py | Извлечение функции масштабирования, оценка показателя Херста (метод R/S через nolds и резервный метод Брента), трехкомпонентная проверка на мультифрактальность |
| step3_fit_spectrum.py | Преобразование Лежандра, подгонка к четырем распределениям — логнормальному, биномиальному, пуассоновскому и гамма-распределению, оптимизация методом L-BFGS-B |
| step4_generate_cascade.py | Мультипликативный каскад: выбор множителей по распределению, нормализация массы и интеграция меры для получения торгового времени |
| step5_generate_fbm.py | Генерация фракционного броуновского движения (FBM) методом Дэвиса — Харта с БПФ, резервным переходом к разложению Холецкого и масштабированием волатильности |
| step6_combine_model.py | Составной процесс MMAR: X(t) = B_H[theta(t)] с использованием линейной интерполяции |
| step7_monte_carlo.py | Прогнозирование волатильности методом Монте-Карло: динамический выбор числа уровней каскада, контроль сходимости, 1 000 прогонов |
| garch_model.py | Реализация GARCH(1,1) с библиотекой arch по методике моделирования Чжана |
| compare_forecast.py | Проверка прогноза MMAR: показатели погрешности, реализованная волатильность в скользящем окне и графики сравнения аннуализированной волатильности |
| run_step[1-7].py | Скрипты запуска для каждого этапа |
| run_comparison.py | Скрипт запуска: проверка прогноза MMAR по реализованной волатильности, аннуализированные показатели и анализ направления движения |
| run_garch_comparison.py | Скрипт запуска: оценивает модель GARCH, загружает прогноз MMAR, формирует сравнительную таблицу и рейтинг моделей |
| requirements.txt | Зависимости Python |
Дополнительная литература:
- A Multifractal Model of Asset Returns — Benoit Mandelbrot, Adlai Fisher, Laurent Calvet, 1997
- Generalized autoregressive conditional heteroskedasticity — Tim Bollerslev, 1986
- Volatility Forecasting with the Multifractal Model of Asset Returns — Terrence Y. Zhang, 2017
- Dynamic Conditional Correlation - a Simple Class of Multivariate GARCH Models — Robert F. Engle, 2000
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22476
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Рыночная микроструктура в MQL5 (Часть 2): Измерение долгой памяти с помощью оценщиков Херста
 GoertzelBrain: Адаптивное спектральное обнаружение циклов с помощью ансамбля нейронных сетей в MQL5
 От начального к среднему уровню: Подокна (I)
 За пределами GARCH (Часть II): Оценка фрактальной размерности рынков

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования