

Нейросети в трейдинге: Управление риском через распределение результатов (Окончание)
 22
 1

Введение
На финансовом рынке средняя прибыль ещё не описывает характер стратегии. Две системы могут показать близкую доходность и совсем по-разному прийти к этому результату. Одна чаще приносит умеренную прибыль. Другая покрывает глубокие убытки редкими крупными выигрышами. Для трейдера за этим стоят размер необходимого капитала и способность пережить неудачную серию. Поэтому доходность приходится оценивать вместе с возможными потерями.
В обычной архитектуре Actor–Critic политика часто ориентируется на ожидаемое вознаграждение. Критик объединяет возможные исходы в одну оценку, а Актёр учится её увеличивать. Отдельного акцента на неблагоприятных исходах в такой цели нет. Крупные прибыли могут компенсировать убытки в среднем значении. Однако сами убытки от этого не исчезают.
Подобную задачу Mehrdad Moghimi и Hyejin Ku рассматривают в работе Risk-sensitive actor-critic with static spectral risk measures for online and offline reinforcement learning. Их фреймворк AC-SRM оптимизирует статическую спектральную меру полного возврата — накопленного результата с учётом дисконтирования. Спектр задаёт вес разных областей распределения. Так неблагоприятные исходы могут сильнее влиять на обучение политики.
В первой части мы разобрали авторскую постановку и подготовили примитив распределительного обучения. Во второй статье реализовали OpenCL-операции выборки, спектральной оценки и расчёта градиентов. В третьей части объединили их в слой CNeuronACSRM на основе FQF. Теперь включим эти операции в обучение торговой политики.
Соберём модель из подготовленного энкодера рынка, Актёра и двух распределительных Критиков. Сначала обучим её на завершённых результатах торговых действий из исторической выборки. Затем перейдём к последовательной работе в тестере. Здесь результат будет появляться после исполнения действия, а неизвестное продолжение траектории придётся оценивать с помощью целевых моделей.
В этой работе мы используем отдельные идеи AC-SRM для собственной Actor–Critic-адаптации. Спектральную меру применяем к распределению текущего Критика. Исходную двухуровневую оптимизацию статической меры полного возврата здесь не воспроизводим. На онлайн-этапе каждый Критик получает оценку продолжения от целевой модели второго. После обучения фиксируем веса и проверяем систему в тестере стратегий MetaTrader 5.

Схема исходного фреймворка AC-SRM. В торговой адаптации внешний контур функции h не воспроизводится.
Архитектура модели
Основой модели служит подготовленный энкодер рыночного состояния. Он включает RankTCM, адаптер OMPB и прогнозный блок ScenarioForecast. На этапе обучения политики его параметры фиксируем. Слой OMPB переводим в OMPB_INFERENCE. Дальше энкодер обрабатывает новые данные без изменения весов. Исходники доступны в репозитории NN_in_Trading.
Энкодер формирует описание рынка. Актёр сопоставляет его с состоянием счёта и выбирает действие. Два Критика оценивают возможные последствия этого выбора. Рыночный контекст поступает через перекрёстное внимание к сценариям. Оно связывает компактный вектор счёта с более подробным описанием рынка.
Рыночные сценарии + Account → Актёр → действие.
Рыночные сценарии + Account + действие → Критик → распределение → SRM.
Перед выбором действия на истории вызывается функция SkillForwardForecast. По умолчанию shift_bars равен единице. Окно наблюдений заканчивается перед баром исполнения. Значит, будущие максимум, минимум и закрытие этого бара не участвуют в прогнозе. После прямого прохода функция проверяет размеры сценарных буферов и наличие их OpenCL-индексов.
bool SkillForwardForecast(const int position, CBufferFloat *state, CBufferFloat *time,
                          const int shift_bars = 1)
  {
//--- Causality: the decision state window ends one bar BEFORE the execution
//--- bar, so close/high/low of the entry bar are realized when its open is
//--- chosen as the post-decision execution price.
   if(!SkillForecast || !CreateBuffers(position + shift_bars, state, time, NULL) ||
      !SkillMarket.feedForward(state, 1, false, (CBufferFloat*)NULL))
      ReturnFalse;
   CBufferFloat *z = SkillForecast.GetZ(), *u = SkillForecast.GetU(), *pi = SkillForecast.GetPi();
   return (z != NULL && u != NULL && pi != NULL && z.Total() == NScenarios * BarDescr * NForecast * EmbeddingSize &&
           u.Total() == NScenarios * BarDescr * NForecast &&
           pi.Total() == NScenarios && z.GetIndex() >= 0 && u.GetIndex() >= 0 && pi.GetIndex() >= 0);
  }
Методы GetZ, GetU и GetPi возвращают сценарные тензоры — многомерные массивы прогнозного блока. В общем OpenCL-контексте к ним обращается слой CNeuronScenarioCrossAttention. Фиксация энкодера сохраняет способ преобразования рыночных данных. Сами сценарии меняются с каждым входным окном.
Решение зависит от текущей позиции и состояния капитала. Их описывает вектор Account из 13 признаков: нормированные баланс и средства (Equity), их относительные изменения, объёмы покупок и продаж, текущий результат по обоим направлениям. Ещё один компонент связан с длительностью удержания. Последние четыре задают циклические временные признаки.
Показатель position_discount зависит от возраста позиции и модуля её текущего финансового результата. После нормирования на предыдущий баланс он поступает на вход модели, но из награды не вычитается. При одинаковом времени удержания значения могут различаться из-за разного результата позиции. Это совмещённая характеристика, а не отдельный счётчик времени или авторский коэффициент дисконтирования.
Базовый вход Актёра имеет размерность AccountDescr. После перекрёстного внимания свёрточное преобразование уменьшает представление с 48 до 16. Выходной слой с активацией SIGMOID формирует шесть компонентов. Первая тройка задаёт объём, Take Profit и Stop Loss для покупки. Вторая содержит те же параметры для продажи. Относительные уровни переводятся в ценовые расстояния при исполнении.
Модель управляет одной позицией: покупкой либо продажей. Для её открытия или изменения используется разность объёмов покупки и продажи. Знак задаёт направление, модуль — объём. Одновременных встречных позиций нет. SIGMOID ограничивает компоненты диапазоном от 0 до 1. Допустимость объёмов и уровней проверяется при исполнении.
Вход Критика объединяет 13 признаков счёта и шесть компонентов действия. После собственного перекрёстного внимания выполняются преобразование 80→16 и проекция в 32 признака. На выходе располагается CNeuronACSRM. Обе архитектуры задаём функцией CreateActorCriticDescriptions в советнике Study.mq5.
bool CreateActorCriticDescriptions(CArrayObj *&actor_descr, CArrayObj *&critic_descr)
  {
   actor_descr = new CArrayObj();
   critic_descr = new CArrayObj();
   if(!actor_descr || !critic_descr)
     {
      DeleteObj(actor_descr);
      DeleteObjAndFalse(critic_descr);
     }
   actor_descr.FreeMode(true);
   critic_descr.FreeMode(true);
//--- Actor: plain scenario trunk without the D2Skill bank layer.
   if(!SkillAddBase(actor_descr, AccountDescr) ||
      !SkillAddCross(actor_descr, false) ||
      !SkillAddConv(actor_descr, 1, (3 * EmbeddingSize), EmbeddingSize, 1, GELU) ||
      !SkillAddConv(actor_descr, 1, EmbeddingSize, NActions / 2, 2, SIGMOID))
     {
      DeleteObj(actor_descr);
      DeleteObjAndFalse(critic_descr);
     }
//--- Critic: Base(19) feeds the Cross(5) trunk; the last plain Base(32,None)
//--- presents exactly 32 inputs to the factory-fixed ACSRM head.
   if(!SkillAddBase(critic_descr, AccountDescr + NActions) ||
      !SkillAddCross(critic_descr, true) ||
      !SkillAddConv(critic_descr, 1, (5 * EmbeddingSize), EmbeddingSize, 1, GELU) ||
      !SkillAddBase(critic_descr, 32))
     {
      DeleteObj(actor_descr);
      DeleteObjAndFalse(critic_descr);
     }
   CLayerDescription *head = new CLayerDescription();
   if(!head)
     {
      DeleteObj(actor_descr);
      DeleteObjAndFalse(critic_descr);
     }
   head.type = defNeuronACSRM;
   head.count = 1;
   head.window_out = InpQuantiles;
   head.activation = None;
   head.optimization = ADAM;
   head.batch = BatchSize;
   if(!critic_descr.Add(head))
     {
      DeleteObjAndFalse(head);
      DeleteObj(actor_descr);
      DeleteObjAndFalse(critic_descr);
     }
   return(true);
  }
Перед CNeuronACSRM находятся 32 скрытых признака, а не прогнозируемые финансовые результаты. Число представителей распределения передаётся отдельно: через InpQuantiles в поле window_out. В приведённой конфигурации оно тоже равно 32. Числа совпадают, но относятся к разным частям вычисления.
По одному описанию создаём Q1 и Q2 с разными весами. Основные офлайн-метки распределяем между ними детерминированно. В онлайн-режиме сети обмениваются оценками через целевые модели. Общие энкодер и политика, а также корреляция рыночных состояний не позволяют считать ошибки независимыми.
Функция BuildCriticInput соединяет состояние счёта с действием. Метод Join2 выполняет объединение на устройстве. Затем BufferRead переносит результат в оперативную память для входного слоя сети. Соединение буферов выполняется в OpenCL, но передача входа включает обмен с CPU.
bool BuildCriticInput(CBufferFloat *account, CBufferFloat *action, CBufferFloat *combined)
  {
   if(!account || !action || !combined || account.Total() != AccountDescr || action.Total() != NActions ||
      account.GetIndex() < 0 || action.GetIndex() < 0)
      ReturnFalse;
//--- GPU Join/Copy transfer: both sources bind the Market context and the
//--- concatenation is assembled on device from the CURRENT tensors, so the
//--- target-action can never arrive from a stale host snapshot. The final
//--- read-back refreshes the host copy that the first CNet layer consumes.
   if(!combined.BufferInit(AccountDescr + NActions, 0))
      ReturnFalse;
   if(combined.GetIndex() < 0 && !combined.BufferCreate(SkillMarket.GetOpenCL()))
      ReturnFalse;
   if(!combined.BufferWrite() || !account.BufferWrite())
      ReturnFalse;
   if(!SkillDevice.Bind(SkillMarket.GetOpenCL()))
      ReturnFalse;
   if(!SkillDevice.Join2(account, AccountDescr, action, NActions, combined))
      ReturnFalse;
   return(combined.BufferRead());
  }
В буфере первые 13 элементов описывают счёт, последние шесть — действие. Рыночные сценарии поступают отдельно. При обратном проходе отделяем градиент по действию от градиента по признакам счёта. Первый показывает, как изменение управляющих параметров влияет на оценку результата.
Здесь нужно разграничить нашу цель и исходный метод. Авторы строят функцию h по распределению возврата начального состояния и фиксируют её во внутреннем цикле. Мы применяем SRM непосредственно к распределению текущего Критика. Спектральная часть цели принимает вид:
JSRM(x, θ) = SRMφ(Zψ(x, πθ(x)))
В состоянии x Актёр с параметрами θ выбирает действие. Критик с параметрами ψ оценивает распределение, а спектр φ задаёт веса его областей. Формула описывает только спектральный компонент обучения. Офлайн к нему добавляются вспомогательные сигналы. Это оценка при текущем состоянии рынка и счёта, а не статическая цель всей траектории. Поэтому гарантии авторской двухуровневой схемы нельзя автоматически переносить на эту адаптацию.
Офлайн-обучение
Полное обучение начинается с энкодера окружающей среды. Этот этап заимствуем из OMPB без изменения его схемы. Подготовку прогнозной модели мы подробно разобрали в статье Нейросети в трейдинге: Адаптация прогноза при смене рыночного режима (Окончание). Поэтому здесь не будем повторять весь процесс работы советника StudyForecast.mq5.
Сначала базовая прогнозная модель обучается в OMPB_BYPASS. После фиксации её параметров отдельно калибруется OMPB. Затем слой переводится в OMPB_INFERENCE. К обучению торговой политики переходим с готовым источником рыночных сценариев. Его параметры дальше не изменяются.
Обучение Актёра и двух Критиков организуем в советнике Study.mq5. Рыночный ряд продолжается за пределами любой сделки. На первом этапе каждую завершённую торговую операцию рассматриваем как локальный эпизод поведения Актёра. Её исход служит наблюдением для обучения распределения. Целевые модели пока не нужны. Это первый этап подготовки торговой политики, а не воспроизведение авторского OAC-SRM.
Параметры Start и End задают границы обучающего диапазона: 01.01.2024 и 01.01.2026. В эксперименте используем данные 2024–2025 годов. Число итераций ограничивает Iterations, длину учебного прохода — EpisodeBars. InpDealHorizon ограничивает оценку отдельной операции после условного исполнения. Это граница исторической разметки, а не конец рыночного ряда. В листингах показаны значения по умолчанию. Настройки конкретного эксперимента могут отличаться.
input group                       "---- AC-SRM training ----"
input datetime                    Start          = D'2024.01.01'; //Training period start
input datetime                    End            = D'2026.01.01'; //Training period end
input int                         Iterations     = 200000;        //Training iterations
input int                         EpisodeBars    = 2 * StackSize; //Bars per episode
input int                         InpDealHorizon = 24;            //Deal evaluation horizon (bars)
input double                      MinBalance     = 50.0;          //Minimum account balance
input int                         UpdatePolicy   = 2;             //Actor update interval (PolicyUpdatePeriod)
input int                         InpSeed        = 20260921;      //Replay seed base (per-owner)
input int                         InpUpdateTargets = 20;          //Target update interval (manifest metadata)
input float                       InpTauT          = 1.0f;        //Target copy tau (1.0 = full copy)
Следующая группа параметров задаёт профиль риска и веса обучающих сигналов. В листинге выбран Mean-CVaR, но InpMeanWeight равен нулю. Поэтому вклад среднего исключён, и оценка сводится к CVaR. Значение InpRiskParameter 0,1 выделяет худшую десятую долю распределения по вероятности. Модель учится учитывать эту область результата. Число 0,1 здесь не означает ограничение просадки счёта десятью процентами.
input group                       "---- SRM critic head ----"
input int                         InpRiskType    = defSRM_MEAN_CVAR; //Risk measure (defSRM_*)
input float                       InpRiskParameter = 0.1f;           //Risk parameter (alpha/lambda/nu)
input float                       InpMeanWeight  = 0.0f;             //Mean-CVaR omega
input float                       InpProbWeight  = 1.0f;             //Distribution probability weight
input float                       InpValueWeight = 1.0f;             //Distribution value weight
input int                         InpQuantiles   = 32;               //Head quantiles (factory-fixed)
input int                         InpSelector    = 0;                //Policy SRM gradient source (0=owner 1=Q1 2=Q2)
Функция PrepareHistory оставляет позиции с полным горизонтом оценки внутри обучающего диапазона. SkillForwardForecast строит признаки из предшествующих баров. Это причинность входа при выборе действия, а не отсутствие будущего во всей процедуре обучения. Исторический горизонт используется для меток и TeacherAction.
Рассмотрим одну итерацию функции TrainTransition. Сначала обновляем рыночный контекст. Затем Актёр получает вектор Account и формирует CurrentAction. Функция AdvanceAccount рассчитывает следующее состояние счёта и проверяет условие завершения эпизода.
if(!SkillForwardForecast(position, GetPointer(State), GetPointer(TimeState)))
  {
   Print("TrainTransition stage=current_forecast");
   ReturnFalse;
  }
double reward = 0;
if(!Actor.feedForward(GetPointer(Account), 1, false, GetPointer(SkillMarket), -1) ||
   !ReadAction(Actor, GetPointer(CurrentAction)) ||
   !AdvanceAccount(GetPointer(Account), GetPointer(CurrentAction), position, MinBalance,
                   GetPointer(NextAccount), reward, terminal))
  {
   Print("TrainTransition stage=account_transition");
   ReturnFalse;
  }
Величина reward описывает изменение средств за один бар при переходе в NextAccount. Для распределительного Критика нужна другая метка — результат действия на всём заданном горизонте. Поэтому движение учебного счёта и обучение распределения используют разные оценки одного решения.
Текущее состояние счёта и выход Актёра объединяем в CriticInput. Обе сети выполняют прямой проход с одним рыночным контекстом. Каждая получает возможность оценить выбранное действие. Обновление по его основной метке далее будет назначено только одному Критику.
CNeuronBaseOCL *context_layer = Actor.Layer(0);
CNeuronBaseOCL *actor_layer = Actor.Layer(3);
if(!context_layer || !actor_layer ||
   !BuildCriticInput(context_layer.getOutput(), actor_layer.getOutput(), GetPointer(CriticInput)))
  {
   Print("TrainTransition stage=critic_input");
   ReturnFalse;
  }
if(!Q1.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1) ||
   !Q2.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1))
  {
   Print("TrainTransition stage=critic_forward");
   ReturnFalse;
  }
Для расчёта метки EvaluateAction передаёт действие в CheckAction. Исход определяется Take Profit, Stop Loss либо окончанием горизонта. При касании обоих уровней внутри бара выбирается Stop Loss. Это консервативное правило разметки, а не восстановление тиков. Оно может смещать метки относительно фактического исполнения.
int deal_tag = 0;
const double deal_y = EvaluateAction(GetPointer(CurrentAction),
                                     MathMax(0.0, double(Account[0]) * EtalonBalance),
                                     (uint)position, InpDealHorizon, deal_tag);
if(!MathIsValidNumber(deal_y))
  {
   Print("TrainTransition stage=deal_label");
   ReturnFalse;
  }
Обычный завершённый исход записывается как финансовый результат с учётом времени его получения:
y = δn Rdeal.
Здесь Rdeal — результат действия, а δ соответствует DiscFactor. Множитель δn уменьшает вес отдалённого исхода. Степень n задаётся временем и ветвью расчёта. При завершении по горизонту используется его полная длина. Потеря капитала учитывается с дополнительной поправкой. Метка берётся из исторической оценки, без прогноза целевой сети.
Пригодность метки проверяем по deal_tag. Нулевое значение увеличивает счётчик UnresolvedLabels и пропускает основное распределительное обновление. Это отсутствие допустимой цели, а не сделка с нулевой прибылью. Остальные ветви итерации продолжают проверять собственные условия выполнения.
Функция SkillObservationOwner распределяет примеры между сетями по position, slot и seed. При неизменных аргументах получатель метки сохраняется. Формула сводится к разделению по чётности. Здесь применяется детерминированное чередование, а не случайная разбивка.
int SkillObservationOwner(const int position, const int slot, const int seed)
  {
   return(int((ulong(MathMax(position, 0)) * ulong(2654435761u) +
               ulong(MathMax(slot, 0)) * ulong(40503u) +
               ulong(MathMax(seed, 0))) & 1));
  }
Так Q1 и Q2 получают разные последовательности примеров. Соседние рыночные наблюдения могут оставаться близкими, поэтому ошибки сетей способны совпадать. Назначение закрепляет получателя метки в текущей выборке. Выбранную сеть передаём через owner_critic.
const int owner = SkillObservationOwner(position, 0, InpSeed);
if(deal_tag == 0)
   UnresolvedLabels++;
else
  {
   CNet *owner_critic = (owner == 0 ? GetPointer(Q1) : GetPointer(Q2));
   if(!owner_critic.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1) ||
      !UpdateCriticDistribution(owner_critic, deal_y))
     {
      if(IsStopped())
        {
         LogStage03StopRequested("critic_distribution_backward");
         return(false);
        }
      Print("TrainTransition stage=critic_distribution_backward");
      ReturnFalse;
     }
   CriticTransitions++;
  }
Функция UpdateCriticDistribution проверяет выходной слой и вызывает calcDistributionTargetGradients. Наблюдаемый результат задаёт коррекцию представителей распределения и их вероятностей. Затем backPropGradient распространяет сигнал по сети и обновляет веса Критика. Механизм локальной коррекции рассмотрен в предыдущих частях.
bool UpdateCriticDistribution(CNet &critic, const double reward)
  {
   CNeuronBaseOCL *base = critic.Layer(3);
   CNeuronBaseOCL *head = critic.Layer(4);
   if(!base || !head || head.Type() != defNeuronACSRM || !MathIsValidNumber(reward) ||
      base.getOutput().Total() != 32)
      ReturnFalse;
   CNeuronACSRM *acsrm = (CNeuronACSRM*)head;
   if(!acsrm.calcDistributionTargetGradients(base, float(reward),
                                             InpProbWeight, InpValueWeight))
      ReturnFalse;
   return(critic.backPropGradient(GetPointer(SkillMarket), -1, -1, true));
  }
В аргумент reward этой функции передаётся deal_y — оценка действия на историческом горизонте. Однобаровое изменение средств из AdvanceAccount сюда не входит. Критик учится по результату выбранного действия, а не по первому движению цены после входа.
Одна метка уточняет лишь часть распределения. Следующие наблюдения дают материал для других его областей. Спектральная оценка объединяет представителей с учётом вероятностей и профиля риска. Для политики становится важен не только средний итог, но и характер неудачных решений.
Частоту спектрального сигнала политике задаёт UpdatePolicy. Два блока выполняются через итерацию. Перед расчётом градиента оба Критика повторяют прямой проход. Их внутренние значения должны соответствовать новым весам. Затем SelectPolicyCritic выбирает источник сигнала.
if(!Q1.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1) ||
   !Q2.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1))
  {
   Print("TrainTransition stage=policy_critic_forward");
   ReturnFalse;
  }
const int pick = SelectPolicyCritic(int(PolicyEvents++));
CNet *policy_critic = (pick == 0 ? GetPointer(Q1) : GetPointer(Q2));
По умолчанию источник чередуется по счётчику PolicyEvents и не зависит от владельца метки. Поэтому обновления политики не закрепляются за одной сетью. На каждом событии используется распределение одного Критика без усреднения градиентов двух сетей.
Функция PolicyOutputGradientACSRM проводит сигнал от оценки результата к торговому действию. Сначала SRMForward рассчитывает спектральное значение. Затем SRMGradient определяет его чувствительность к значениям и вероятностям представителей. На последующем обратном проходе веса Критика заморожены. Сейчас он нужен для расчёта влияния действия на оценку, а не для собственного обучения.
bool PolicyOutputGradientACSRM(CNet &actor, CNet &critic, const float upstream = 1.0f)
  {
   CNeuronBaseOCL *critic_head = critic.Layer(4);
   CNeuronBaseOCL *critic_base = critic.Layer(0);
   CNeuronBaseOCL *actor_output = actor.Layer(3);
   if(!critic_head || critic_head.Type() != defNeuronACSRM || !critic_base || !actor_output ||
      critic_base.getGradient().Total() != (int)(AccountDescr + NActions) ||
      actor_output.getGradient().Total() != (int)NActions)
      ReturnFalse;
   CNeuronACSRM *acsrm = (CNeuronACSRM*)critic_head;
   if(!SRMValue.BufferInit(1, 0) || !SRMValue.BufferCreate(SkillMarket.GetOpenCL()) ||
      !SRMValue.BufferWrite())
      ReturnFalse;
   if(!acsrm.SRMForward(GetPointer(SRMValue), 1, InpRiskType, InpRiskParameter, InpMeanWeight))
      ReturnFalse;
   if(!SRMGrad.BufferInit(1, upstream) || !SRMGrad.BufferCreate(SkillMarket.GetOpenCL()) ||
      !SRMGrad.BufferWrite())
      ReturnFalse;
   if(!acsrm.SRMGradient(GetPointer(SRMGrad), 1, InpRiskType, InpRiskParameter, InpMeanWeight))
      ReturnFalse;
//--- Freeze critic weights while propagating the policy gradient.
   if(!critic.SetWeightsUpdate(false))
      ReturnFalse;
   bool result = critic.backPropGradient(GetPointer(SkillMarket), -1, -1, true);
   if(!critic.SetWeightsUpdate(true))
      result = false;
   CBufferFloat account_gradient;
   if(!(result &&
        account_gradient.BufferInit(AccountDescr, 0) &&
        (account_gradient.GetIndex() >= 0 || account_gradient.BufferCreate(SkillMarket.GetOpenCL())) &&
        SkillDevice.Split2(GetPointer(account_gradient), actor_output.getGradient(),
                           critic_base.getGradient(), AccountDescr, NActions) &&
        ApplyActorSigmoidDerivative(actor_output)))
      result = false;
   return(result);
  }
Градиент относится ко всем 19 компонентам CriticInput. Split2 выделяет шесть параметров действия, а ApplyActorSigmoidDerivative учитывает выходную активацию Актёра. Это чувствительность оценки Критика, а не фактического исполнения. Торговые ограничения и проверки TP/SL в этот вычислительный путь не входят. Путь сигнала:
SRM → градиенты значений и вероятностей → градиент действия → градиент Актёра.
Пока функция только записывает градиент выхода Актёра. Его веса ещё не изменены. К спектральному сигналу добавляются два вспомогательных обучающих направления. Поэтому полное обновление политики не сводится к одной спектральной цели.
Первый источник — TeacherAction. По известному будущему движению формируем обучающее действие и проверяем его через EvaluateAction. Так задаём Актёру направляющий пример, а не полагаемся только на случайный поиск. Положительный завершённый исход разрешает дополнительный сигнал политике. Допустимый убыток также передаётся Критику, чтобы сохранить сведения о неблагоприятных исходах.
Второй источник — RandomAction. Случайные действия разнообразят выборку и показывают альтернативные возможности и риски того же состояния рынка. Прибыльный вариант может дополнить сигнал политике. Любой пригодный исход, включая убыток, передаётся назначенному Критику. Будущее используется для разметки, а не как входной признак Актёра.
Все вклады собираются до общего обратного прохода. Между их расчётами параметры Актёра остаются прежними. Вспомогательные сигналы могут вызвать обновление и между событиями UpdatePolicy. Этот параметр ограничивает частоту спектрального вклада, а не всех изменений политики.
if(actor_update_needed && !actor_update_blocked &&
   !Actor.backPropGradient(GetPointer(SkillMarket), -1, -1, true))
  {
   if(IsStopped())
     {
      LogStage03StopRequested("actor_combined_backward");
      return(false);
     }
   Print("TrainTransition stage=actor_combined_backward");
   ReturnFalse;
  }
Флаг actor_update_needed разрешает общий проход при наличии сигнала. actor_update_blocked блокирует его при отмеченной проблеме спектрального расчёта. Затем модель продолжает эпизод с новым состоянием счёта до ограничения длины, границы истории или условия завершения по состоянию счёта.
В офлайн-счёте AdvanceAccount записывает ноль в компонент длительности удержания. При онлайн-обучении и итоговом тестировании position_discount меняется вместе с позицией. Сдвиг этого признака возникает уже на втором этапе обучения, а не впервые в итоговом тесте. Его влияние отдельно не измерялось.
После заданного числа итераций сохраняем Actor, Q1 и Q2. Модель уже связывает рыночные сценарии, состояние счёта и результаты действий. Следующий этап — последовательное обучение. Вместо просмотра будущего горизонта для разметки используем оценку продолжения от целевых сетей.
Онлайн-адаптация
Онлайн-обучение проводим в тестере стратегий MetaTrader 5 с помощью советника StudyOnline.mq5. Тестер последовательно воспроизводит котировки. Советник выполняет действия, наблюдает изменения счёта и обновляет модели. Для каждого решения доступны только данные, уже поступившие к этому моменту. Будущие бары не используются для расчёта текущей цели.
Слово онлайн здесь описывает порядок работы, а не источник котировок. Сначала принимается решение, затем становится известен его результат. Модель уже не получает завершённый исход из просмотренного вперёд горизонта. К наблюдаемому вознаграждению добавляется оценка будущего продолжения. Такой способ построения цели называется бутстрепом. Тестер позволяет организовать его на истории. Условия исполнения задаются настройками теста.
Онлайн-обучение также проводим на данных 2024–2025 годов. Период задаём в тестере. UpdatePolicy определяет период обновления политики, InpUpdateTargets — синхронизации целевых сетей. Вес продолжения задаёт InpGamma. Ниже приведены настройки советника по умолчанию.
input group                       "---- AC-SRM online training ----"
input int                         InpDealHorizon = 24;            //Offline pretraining horizon; checkpoint compatibility
input double                      MinBalance     = 50.0;          //Minimum account balance
input int                         UpdatePolicy   = 2;             //Actor update interval at deal-open states
input int                         InpUpdateTargets = 2;           //Target-network update interval
input float                       InpTauT        = 0.05f;         //Cross-Polyak target smoothing tauT
input float                       InpGamma       = 0.5f;          //TD discount per resolved bar (gamma)
input int                         InpSelector    = 0;             //Policy SRM gradient source (0=event-hash 1=Q1 2=Q2)
input int                         InpSeed        = 20260921;      //Replay seed base (per-owner)
Советник загружает Actor, Q1 и Q2 без изменения архитектур. Энкодер остаётся в OMPB_INFERENCE. Для оценки продолжения создаём TargetActor, TargetQ1 и TargetQ2. Их заморозка запрещает градиентное обучение, но не явную синхронизацию: сначала веса копируются полностью, затем обновляются через WeightsUpdate с коэффициентом InpTauT.
Начальные параметры задаёт функция LoadOnlineTargets. TargetActor получает полную копию весов Actor. Для Критиков копирование устроено перекрёстно: TargetQ1 получает веса Q2, а TargetQ2 — веса Q1. Получаем следующую схему передачи весов:
TargetActor ← Actor; TargetQ1 ← Q2; TargetQ2 ← Q1.
bool LoadOnlineTargets(void)
  {
   if(!SkillLoadPolicyNet(TargetActor, Skill_ACTOR_FILE) ||
      !SkillLoadPolicyNet(TargetQ1, Skill_Q1_FILE) ||
      !SkillLoadPolicyNet(TargetQ2, Skill_Q2_FILE) ||
      !SkillBindPolicyOpenCLChecked(TargetActor, TargetQ1, TargetQ2) ||
      !ValidatePolicyShapeACSRM(TargetActor, TargetQ1, TargetQ2))
      ReturnFalse;
//--- Crossed hard initialization: TargetActor <- Actor, TargetQ1 <- Q2,
//--- TargetQ2 <- Q1 (deliberate divergence from direct mirroring).
   if(!TargetActor.WeightsUpdate(GetPointer(Actor), 1.0f) ||
      !TargetQ1.WeightsUpdate(GetPointer(Q2), 1.0f) ||
      !TargetQ2.WeightsUpdate(GetPointer(Q1), 1.0f))
      ReturnFalse;
   TargetActor.TrainMode(false);
   TargetQ1.TrainMode(false);
   TargetQ2.TrainMode(false);
   if(!TargetActor.SetWeightsUpdate(false) || !TargetQ1.SetWeightsUpdate(false) ||
      !TargetQ2.SetWeightsUpdate(false))
      ReturnFalse;
   return(true);
  }
Перекрёстное соединение введено нами для этой торговой адаптации. Оно не перенесено из исходной схемы AC-SRM. Первый основной Критик будет учиться по продолжению из целевой модели второго. Второй получит продолжение от целевой модели первого. Поэтому индекс целевой сети обозначает получателя её оценки, а не источник скопированных весов.
Перекрёстная схема даёт каждому Критику оценку продолжения от целевой модели второй сети. При прямом копировании смещение могло бы возвращаться через собственную целевую модель. Мы рассчитываем ослабить зависимость обновления от собственной прошлой оценки, но не гарантируем снижение ошибки.
Для спектрального обучения имеет значение и форма этой ошибки. Слишком оптимистичная оценка плохих исходов изменит нижнюю часть распределения, а затем и сигнал Актёру. Перекрёстная связь даёт альтернативную оценку продолжения, но может переносить смещение между сетями. Поэтому она не делает их ошибки независимыми. Отдельный эффект такого обмена нужно проверять сравнением вариантов обучения.
Обработчик OnTick вызывает LiveOnlineStep после появления нового бара. На первом шаге ещё нет предыдущего действия для обучения. Советник принимает решение и сохраняет его контекст. При следующем обновлении состояния появится результат для обработки этого перехода.
void OnTick(void)
  {
   if(!IsNewBar())
      return;
   if(!LiveOnlineStep())
     {
      PrintFormat("ACSRM_ONLINE_FAIL reason=live_step_failed steps=%d", LiveSteps);
      ExpertRemove();
      return;
     }
   if(LiveStopRequested)
      ExpertRemove();
  }
Обозначим состояние рынка и счёта через xt, действие — через at. После исполнения советник записывает средства счёта в LivePrevEquity. На следующем баре ApplyLiveTransition сравнивает новое значение средств с этим снимком. Разность становится наблюдаемым вознаграждением за прошедший интервал.
const double reward = equity_now - LivePrevEquity;
if(!MathIsValidNumber(reward) || !MathIsValidNumber(balance_now) ||
   !MathIsValidNumber(equity_now))
   ReturnFalse;
RewardSum += reward;
reward отражает изменение средств при управлении одной однонаправленной позицией. Это результат её удержания или изменения между снимками, а не обязательно итог закрытой операции. LivePrevEquity записывается после исполнения, поэтому уже отражённые в нём изменения не входят в разность. position_discount из награды не вычитается.
Следующее состояние записываем в NextState, NextTimeState и NextAccount. В исходных State и Account оставляем данные прошлого решения. Новая точка нужна для оценки продолжения, предыдущая — для обучения выполненного действия.
В новом рыночном контексте TargetActor формирует следующее действие. Функция BuildCriticInput соединяет его с NextAccount. После прямого прохода двух целевых Критиков вызывается SampleTargetHead. Она выбирает по одному значению из каждого распределения. Поэтому в обучающую цель входит отдельный возможный исход, а не среднее всех будущих результатов.
double y1 = reward;
double y2 = reward;
float z1 = 0.0f, z2 = 0.0f;
if(!TargetActor.feedForward(GetPointer(NextAccount), 1, false, GetPointer(SkillMarket), -1))
  {
   Print("LiveTrain stage=target_actor_forward");
   ReturnFalse;
  }
CNeuronBaseOCL *target_context = TargetActor.Layer(0);
CNeuronBaseOCL *target_actor_layer = TargetActor.Layer(3);
if(!target_context || !target_actor_layer ||
   !BuildCriticInput(target_context.getOutput(), target_actor_layer.getOutput(),
                     GetPointer(TargetCriticInput)) ||
   !TargetQ1.feedForward(GetPointer(TargetCriticInput), 1, false, GetPointer(SkillMarket), -1) ||
   !TargetQ2.feedForward(GetPointer(TargetCriticInput), 1, false, GetPointer(SkillMarket), -1) ||
   !SampleTargetHead(TargetQ1, TargetSample, TargetRandom, z1) ||
   !SampleTargetHead(TargetQ2, TargetSample, TargetRandom, z2))
  {
   Print("LiveTrain stage=target_bootstrap");
   ReturnFalse;
  }
y1 = reward + double(InpGamma) * double(z1);
y2 = reward + double(InpGamma) * double(z2);
if(!MathIsValidNumber(y1) || !MathIsValidNumber(y2))
  {
   Print("LiveTrain stage=target_scalar");
   ReturnFalse;
  }
К одному наблюдаемому вознаграждению добавляем две оценки продолжения. С учётом дисконтирования получаем:
y1 = rt + γ z1; y2 = rt + γ z2.
Значение z1 выбрано из TargetQ1, получающей веса Q2. Выборка z2 поступает из TargetQ2, связанной с Q1. Первую метку y1 используем для обучения Q1, вторую y2 — для Q2. Следовательно, каждый основной Критик действительно получает будущую часть цели от модели второго.
Одна выборка даёт стохастическую TD-метку. При следующих шагах могут выбираться другие представители с учётом их вероятностей. Такая выборка добавляет разброс цели. Её преимущество перед другими способами обновления здесь не проверялось. y1 и y2 могут совпадать: различаются источники, а не обязательно значения.
После расчёта целей возвращаем SkillMarket сохранённый State — рыночный контекст прошлого решения. В CriticInput остаются соответствующие счёт и действие. Обучаем обе основные сети именно на этом переходе, а не следующем действии.
if(!Q1.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1) ||
   !Q2.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1))
  {
   Print("LiveTrain stage=critic_forward");
   ReturnFalse;
  }
double nv1 = 0, np1 = 0, nv2 = 0, np2 = 0;
if(!UpdateCriticDistributionDiag(Q1, y1, nv1, np1) ||
   !UpdateCriticDistributionDiag(Q2, y2, nv2, np2))
  {
   Print("LiveTrain stage=critic_backward");
   ReturnFalse;
  }
CriticTransitions++;
CriticQ1Total++;
CriticQ2Total++;
Офлайн- и онлайн-этапы решают общую задачу обучения торговой политики. Сначала рассматриваем завершённые операции. Затем связываем решения через текущую награду и оценку продолжения. По мере обучения Критиков TD-обновления передают сведения о последующих результатах к более ранним состояниям. Это позволяет учитывать последствия за пределами отдельной операции. Каждый допустимый онлайн-переход обучает обе сети.
DiscFactor дисконтирует исход отдельной операции, а InpGamma — продолжение в последовательном обучении. Меняется способ формирования обучающей оценки, а не общая задача политики. Рекурсивный учёт будущего не отменяет дисконтирование. При InpGamma = 0,5 вес награды через пять баров равен (0,5)5 = 0,03125. Поэтому дальние последствия влияют слабее ближайших.
Периодически корректируем и политику. Перед этим Q1 и Q2 повторяют прямой проход с обновлёнными весами. Функция SelectPolicyCritic выбирает источник сигнала. После проверки спектральной оценки PolicyOutputGradientACSRM формирует градиент действия. Отдельный обратный проход затем изменяет веса Актёра.
if(iteration > 0 && UpdatePolicy > 0 && iteration % UpdatePolicy == 0)
  {
   if(!Q1.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1) ||
      !Q2.feedForward(GetPointer(CriticInput), 1, false, GetPointer(SkillMarket), -1))
     {
      Print("LiveTrain stage=policy_critic_forward");
      ReturnFalse;
     }
   const int pick = SelectPolicyCritic(int(PolicyEvents++));
   CNet *policy_critic = (pick == 0 ? GetPointer(Q1) : GetPointer(Q2));
   float policy_srm = 0.0f;
   if(!CriticSRMValue(*policy_critic, policy_srm))
     {
      if(CriticLastSRMInvalid(*policy_critic))
         PolicySkippedInvalid++;
      else
        {
         Print("LiveTrain stage=policy_critic_srm");
         ReturnFalse;
        }
     }
   else
     {
      const bool policy_ok = PolicyOutputGradientACSRM(Actor, *policy_critic, 1.0f);
      if(!policy_ok)
        {
         if(!CriticLastSRMInvalid(*policy_critic))
           {
            Print("LiveTrain stage=policy_backward");
            ReturnFalse;
           }
         PolicySkippedInvalid++;
        }
      else
        {
         if(!Actor.backPropGradient(GetPointer(SkillMarket), -1, -1, true))
           {
            Print("LiveTrain stage=actor_backward");
            ReturnFalse;
           }
         PolicyTransitions++;
        }
     }
  }
При неуспехе расчёта советник проверяет флаг CriticLastSRMInvalid. Если он установлен, обновление политики пропускается, а PolicySkippedInvalid увеличивается. В другой ветви ошибка прерывает шаг. Счётчик помогает заметить пропущенные обновления, но не устанавливает причину сбоя. Это диагностика обучения, а не признак отсутствия торгового сигнала.
Здесь уже нет обучающего действия из заранее известного будущего. Политика получает спектральный сигнал от основного Критика. Во время его распространения веса Критика заморожены. Целевые сети в этом градиентном проходе не участвуют. Их задача выполнена раньше — при расчёте меток для распределительного обучения.
После обучающих проходов синхронизируем целевые модели с периодом InpUpdateTargets. Обновляем TargetActor и одного целевого Критика. В WeightsUpdate передаём InpTauT: значение 1 означает полное копирование, а значение между 0 и 1 — Polyak-сглаживание. Веса целевых сетей меняются при синхронизации, но не через обратное распространение градиента.
if(iteration > 0 && InpUpdateTargets > 0 && iteration % InpUpdateTargets == 0)
  {
   if(!TargetActor.WeightsUpdate(GetPointer(Actor), InpTauT))
     {
      Print("LiveTrain stage=target_actor_update");
      ReturnFalse;
     }
   if((TargetUpdates & 1) == 0)
      TargetQ1First = ((MathRand() & 1) == 0);
   const bool update_q1 = (TargetQ1First ? (TargetUpdates & 1) == 0 : (TargetUpdates & 1) != 0);
   if(update_q1)
     {
      if(!TargetQ1.WeightsUpdate(GetPointer(Q2), InpTauT))
        {
         Print("LiveTrain stage=target_q1_update");
         ReturnFalse;
        }
     }
   else
     {
      if(!TargetQ2.WeightsUpdate(GetPointer(Q1), InpTauT))
        {
         Print("LiveTrain stage=target_q2_update");
         ReturnFalse;
        }
     }
   TargetUpdates++;
  }
За пару событий по одному разу обновляются TargetQ1 и TargetQ2. Первый участник пары выбирается случайно. Направление копирования остаётся прежним: от Q2 к TargetQ1 и от Q1 к TargetQ2. Поэтому каждый целевой Критик синхронизируется вдвое реже TargetActor. Между этими событиями его параметры сохраняются.
Завершив обновления, переносим следующее состояние в рабочие буферы. Прогнозный блок снова выполняет прямой проход, и Актёр выбирает новое действие. Порядок получается последовательным: сначала наблюдаем результат, затем оцениваем продолжение и обучаем сети, после чего возвращаемся к торговому решению.
Исполнение организовано в LiveActForBar. Функция сохраняет вход Критика и передаёт действие в SkillExecuteAction. Ниже показан соответствующий участок. Он использует actor_output, buy_value и sell_value. Их определения в этот фрагмент не включены. Торговый исполнитель обрабатывает команду с учётом текущей позиции.
if(!Actor.feedForward(GetPointer(Account), 1, false, GetPointer(SkillMarket), -1) ||
   !ReadAction(Actor, GetPointer(CurrentAction)))
   ReturnFalse;
CNeuronBaseOCL *context_layer = Actor.Layer(0);
if(!context_layer)
   ReturnFalse;
const double buy_lot = MathMax(0.0, double(CurrentAction[0] - CurrentAction[3]));
const double sell_lot = MathMax(0.0, double(CurrentAction[3] - CurrentAction[0]));
if(!BuildCriticInput(context_layer.getOutput(), actor_output.getOutput(),
                     GetPointer(CriticInput)))
   ReturnFalse;
double margin_penalty = 0;
bool market_closed = false;
if(!SkillExecuteAction(GetPointer(CurrentAction), buy_value, sell_value,
                       margin_penalty, market_closed))
   ReturnFalse;
После исполнения сохраняем баланс и средства. На следующем баре этот снимок станет базой измерения награды. Она характеризует управление текущей позицией, а не только вход в рынок. Будущие бары при принятии решения не используются. Значение награды зависит от условий исполнения и момента снимка.
Тестер позволяет повторять поток котировок при разных настройках. Для сопоставления нужны одинаковые начальные веса и состояние генератора случайных чисел. Повторный обучающий проход остаётся обучением, а не тестом. После онлайн-этапа сохраняем сети и проверяем политику без обновления весов.
Тестирование
Итоговый прогон выполнили в тестере стратегий MetaTrader 5 с помощью советника Test.mq5. Офлайн- и онлайн-обучение проводились на данных 2024–2025 годов. EURUSD H1 за январь–июнь 2026 года использовали для проверки вне обучающего диапазона. Веса энкодера, Актёра и Критиков оставались фиксированными.
Начальный депозит составил 1000 USD. Чистая прибыль достигла 2045,38 USD. С учётом начального депозита конечный баланс составил 3045,38 USD, прирост капитала — 204,54%. На графике периоды роста сменяются продолжительными снижениями. Максимальная просадка баланса достигла 1085,50 USD, или 38,69%. По средствам она составила 1100,42 USD, или 39,22%. Такая глубина снижения для трейдера не менее существенна, чем итоговая прибыль.
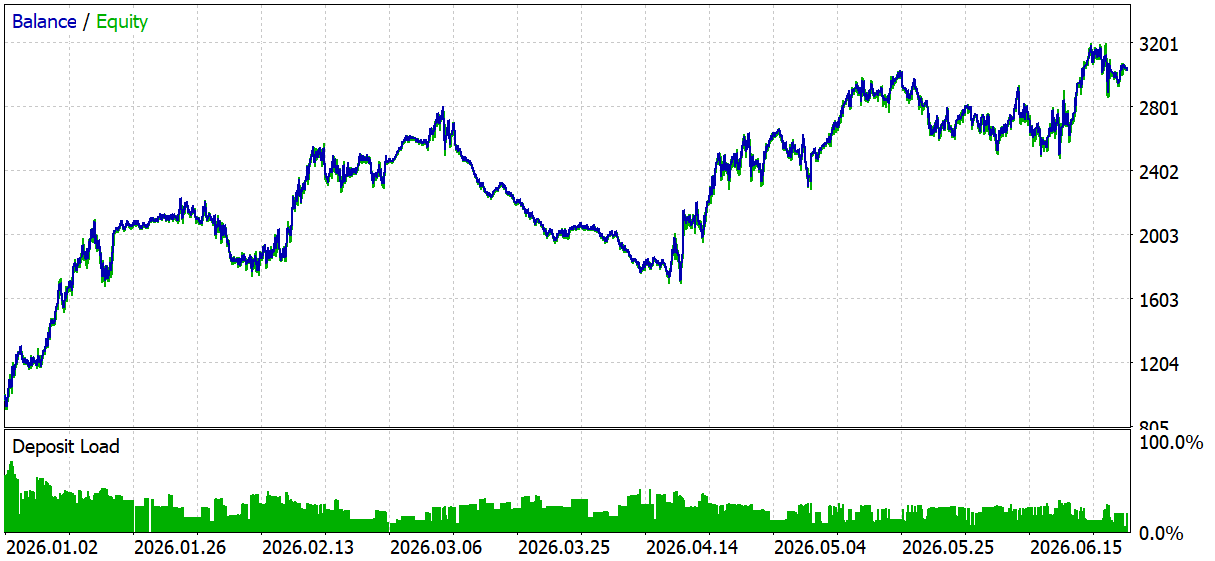
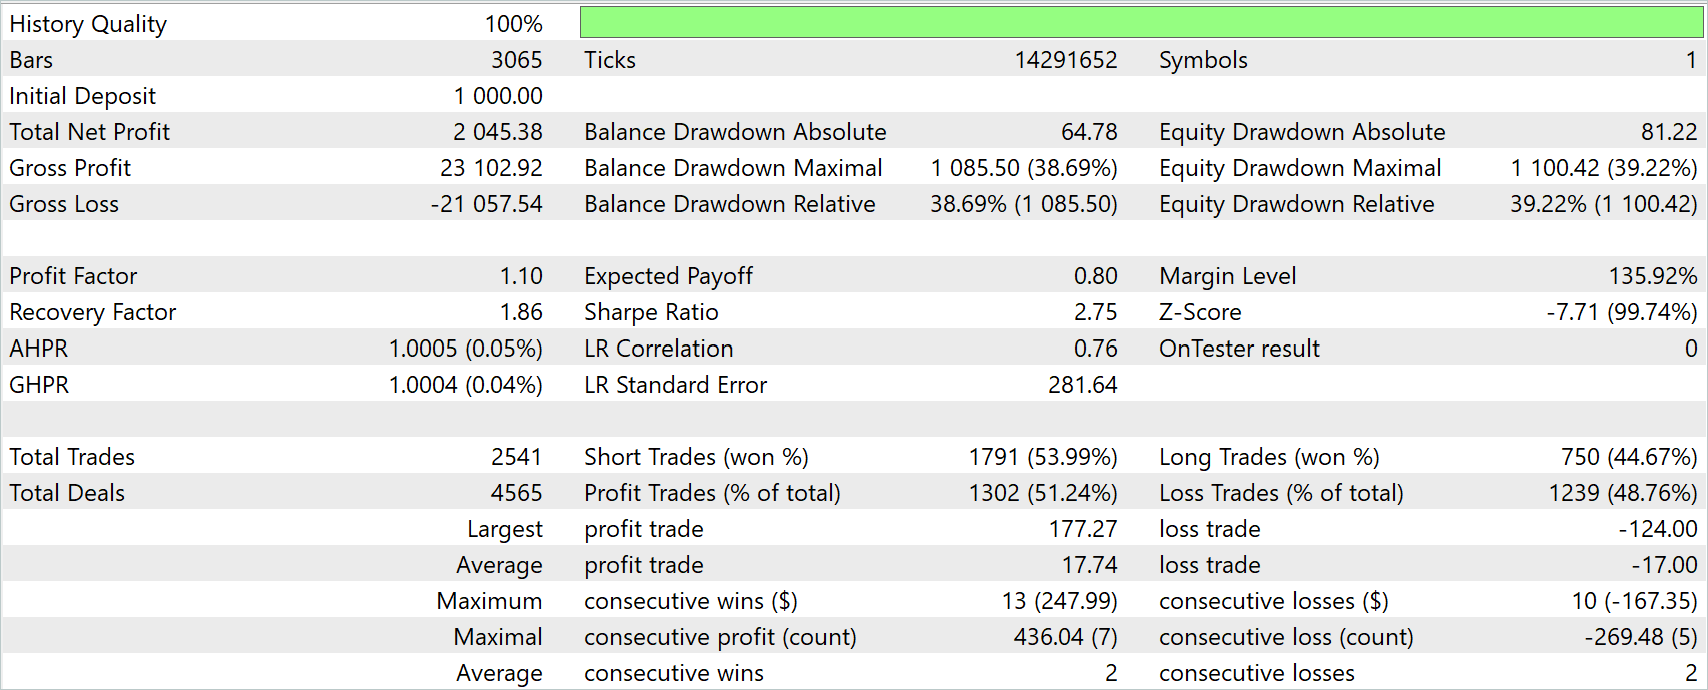
Отчёт тестера стратегий для торговой адаптации AC-SRM.
За период тестирования модель совершила 2541 сделку. Прибыльными стали 1302, или 51,24%, убыточными — 1239. Средняя прибыльная сделка принесла 17,74 USD, средний убыток составил 17,00 USD. Валовая прибыль достигла 23 102,92 USD при валовом убытке 21 057,54 USD. Profit Factor равен 1,10, средний результат сделки по Expected Payoff — 0,80 USD. Продажи преобладали: 1791 сделка против 750 покупок. Доля прибыльных продаж составила 53,99%, покупок — 44,67%.
Recovery Factor составил 1,86, Sharpe Ratio в отчёте — 2,75. При Profit Factor 1,10 и среднем результате 0,80 USD запас по дополнительным издержкам невелик. CVaR не задаёт лимит просадки счёта. Представлен один прогон EURUSD H1. Сравнение вариантов, серии запусков и проверка калибровки распределений отсутствуют. Вклад SRM, вспомогательных сигналов и перекрёстных целевых сетей отдельно не измерен. Переносимость результата требует проверки в других условиях исполнения.
Заключение
В заключительной части серии мы связали энкодер рынка с Актёром и двумя распределительными Критиками. Слой CNeuronACSRM рассчитывает спектральную оценку. Её градиент проходит через выбранного Критика к действию и используется для изменения политики. Так компоненты предыдущих статей включены в общий цикл обучения торговой модели.
Обучение построено в два этапа: от завершённых операций к последовательному управлению позицией. Офлайн-разметка даёт Актёру направляющие примеры, а случайные действия расширяют выборку. Затем TD-обучение связывает текущие решения с оценкой продолжения. Для этого каждый Критик получает будущую часть метки от целевой модели второго. Прямое применение SRM и перекрёстный обмен определяют нашу адаптацию.
Итоговый прогон принёс 2045,38 USD при депозите 1000 USD. Profit Factor составил 1,10, максимальная просадка средств — 39,22%. Это результат одного эксперимента, а не доказательство преимущества отдельных компонентов или устойчивости стратегии. Для использования предложенных подходов в реальной торговле необходимо дополнительное всестороннее тестирование. Оно должно охватывать другие периоды, рыночные условия и издержки исполнения.
Ссылки
- Risk-sensitive actor-critic with static spectral risk measures for online and offline reinforcement learning
- Другие статьи серии
Программы, используемые в статье
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | Trajectory.mqh | Общий модуль | Построение моделей и вспомогательные функции обучения |
| 2 | StudyForecast.mq5 | Советник | Обучение прогнозной модели |
| 3 | Study.mq5 | Советник | Офлайн-обучение Актёра и распределительных Критиков |
| 4 | StudyOnline.mq5 | Советник | Онлайн-обучение в тестере стратегий |
| 5 | Test.mq5 | Советник | Итоговый тест с фиксированными весами |
| 6 | NeuroNet.mqh | Библиотека классов | Библиотека классов нейронных сетей |
| 7 | NeuroNet.cl | OpenCL-программа | OpenCL-ядра библиотеки нейронных сетей |
Проект представлен на forge.mql5.io/dng.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Особенности написания Пользовательских Индикаторов
 От начального к среднему уровню: Подокна (I)

 Рыночная микроструктура в MQL5 (Часть 2): Измерение долгой памяти с помощью оценщиков Херста

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Опубликована статья Нейросети в трейдинге: Управление риском через распределение результатов (Окончание):
Автор: Dmitriy Gizlyk