

За пределами GARCH (часть I): Сравнение моделей MMAR Мандельброта и GARCH Энгла
 12
 0

Введение
Прогнозирование волатильности лежит в основе управления рисками в алгоритмической торговле. Если прогноз волатильности точен, размер позиции адаптируется к рыночным условиям, стоп-лоссы "дышат" вместе с ценой, а просадка остается под контролем. Если нет, одна смена рыночного режима сведет на нет прибыль за несколько месяцев. На протяжении десятилетий основным инструментом для этой задачи была GARCH — модель обобщенной авторегрессионной условной гетероскедастичности. Изначальная модель была предложена Робертом Энглом в 1982 году, а в 1986 году Тим Боллерслев представил ее обобщенную версию. Модель GARCH принесла Энглу Нобелевскую премию, и не зря: она отражает кластеризацию волатильности — тенденцию, при которой за сильными движениями цены следуют сильные, а за небольшими — небольшие.
Однако у GARCH есть и "слепые зоны". Модель предполагает нормальное распределение доходностей или, в лучшем случае, t-распределение Стьюдента. Однако у реальных доходностей хвосты значительно тяжелее, чем предсказывает такая модель распределения. В ней нет механизма долгой памяти, при которой влияние прошлой волатильности сохраняется неделями и месяцами, а не только несколько периодов. Кроме того, модель считает течение времени равномерным, хотя любой трейдер знает: десять минут во время выхода новости несут больше информации, чем десять минут в три часа ночи. Это не мелкие придирки. Структурные ограничения заложены в самих допущениях модели.
Здесь уместно обратиться к работам Бенуа Мандельброта — отца фрактальной геометрии. Еще в 1963 году Мандельброт заметил самоподобие финансовых доходностей — повторение одних и тех же структурных закономерностей на разных временных масштабах. Пятиминутный свечной график EURUSD структурно почти неотличим от дневного. На обоих видны схожее чередование волатильных и спокойных периодов, распределения доходностей с тяжелыми хвостами и постепенное затухание автокорреляций. Это не случайно. Это характерный признак лежащего в основе фрактального процесса. В 1997 году Мандельброт совместно с Кальве и Фишером формализовал эту идею в виде мультифрактальной модели доходностей активов (MMAR).
MMAR не устраняет слабые места GARCH за счет точечных расширений. Вместо этого MMAR исходит из иной предпосылки: финансовые доходности порождаются фракционным броуновским движением, протекающим в мультифрактальном торговом времени. Такое торговое время — словно часы, которые идут быстрее в волатильные периоды и медленнее в спокойные. Это архитектурное решение одновременно порождает долгую память, тяжелые хвосты распределения, кластеризацию волатильности и масштабную согласованность. Эти свойства возникают благодаря одному механизму порождения данных, а не отдельным дополнениям к базовой модели.
В этой статье мы начинаем построение MMAR по методике Чжана (2017). В работе Volatility Forecasting with the Multifractal Model of Asset Returns Чжан показал, что на выборке из 20 акций MMAR значительно превосходит GARCH. С помощью Python и Python API для MetaTrader5 мы загрузим и подготовим данные, а затем проверим по функции разбиения, проявляется ли в них мультифрактальное масштабирование. К концу статьи мы ответим на исходный вопрос: обладают ли наши данные фрактальными свойствами?
Мы рассмотрим следующие темы:
- GARCH — наследие Энгла
- MMAR — фрактальная альтернатива Мандельброта
- Подготовка — данные и конфигурация
- Шаг 1 — проверка на фрактальность
- Заключение
GARCH — наследие Энгла
Прежде чем оценивать возможности MMAR, нужно разобраться в модели, с которой мы ее сравниваем. GARCH по-прежнему широко применяют для прогнозирования волатильности и в исследованиях, и на практике. Причины понятны: модель изящна, хорошо изучена и вычислительно эффективна. Мы разберем основную идею, упомянем важнейшие расширения и затем подробно объясним ограничения GARCH. Именно эти ограничения объясняют, почему далее мы обратимся к MMAR.
Основная идея
GARCH моделирует условную дисперсию доходностей — дисперсию в момент t с учетом информации, доступной до момента t-1 включительно. Стандартная модель GARCH(1,1) состоит из двух уравнений. Согласно уравнению среднего, доходность в момент t складывается из константы и шумового члена:
r_t = mu + epsilon_t
где epsilon_t = sigma_t * z_t, а z_t — случайная величина со стандартным нормальным распределением. Ключевую роль играет уравнение дисперсии:
sigma_t^2 = omega + alpha * epsilon_(t-1)^2 + beta * sigma_(t-1)^2
Это означает, что текущая дисперсия складывается из трех взвешенных составляющих: долгосрочного базового уровня (omega), квадрата шока предыдущего периода (член с alpha) и дисперсии предыдущего периода (член с beta). Член с alpha отражает, насколько быстро дисперсия реагирует на новую информацию. Член с beta отражает, как долго сохраняется повышенная волатильность. Вместе эти два члена уравнения приводят к кластеризации волатильности. После большого изменения доходности sigma_t^2 возрастает за счет члена с alpha. Условная дисперсия следующего периода повышается, и вероятность еще одного большого изменения увеличивается. Когда большие изменения доходности прекращаются, член с beta постепенно возвращает дисперсию к долгосрочному уровню, связанному с omega.
Параметры omega, alpha и beta оценивают методом максимального правдоподобия (MLE). Функция правдоподобия показывает, насколько вероятны наблюдаемые доходности при выбранных значениях параметров. Начиная с начального приближения, оптимизатор меняет omega, alpha и beta так, чтобы максимизировать правдоподобие. Все три параметра должны быть неотрицательными; для стационарности процесса сумма alpha + beta должна быть меньше 1. При таком условии стационарности безусловная дисперсия сходится к конечному значению: omega / (1 - alpha - beta). Метод MLE хорошо подходит для GARCH: условное распределение доходности полностью задается прошлой информацией, поэтому функцию правдоподобия сравнительно просто вычислить.
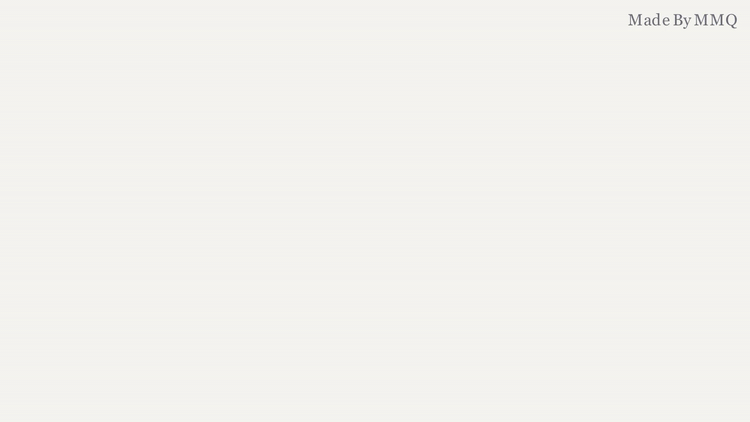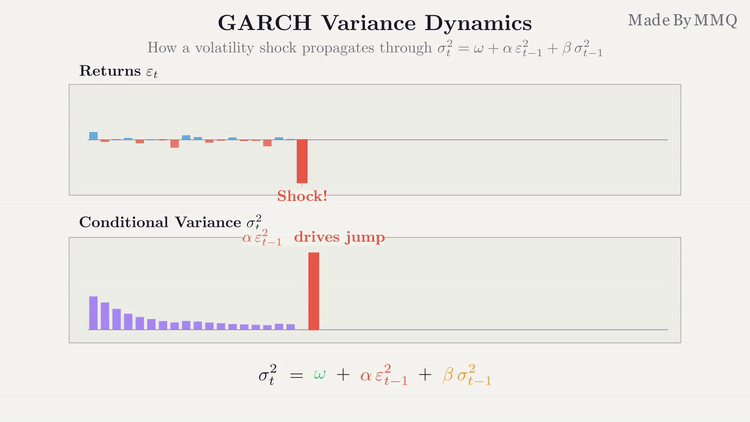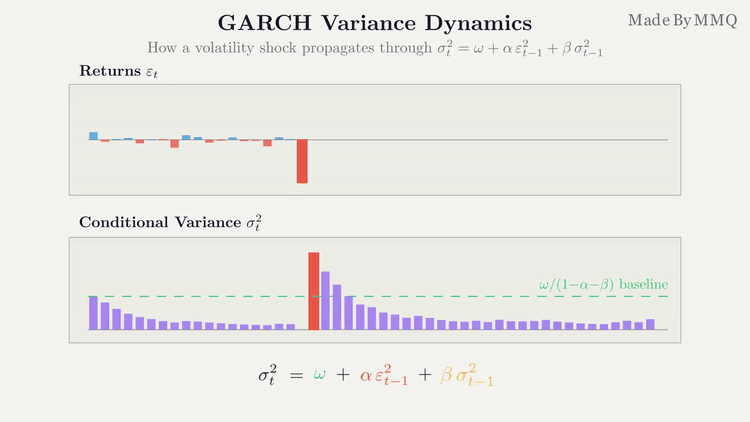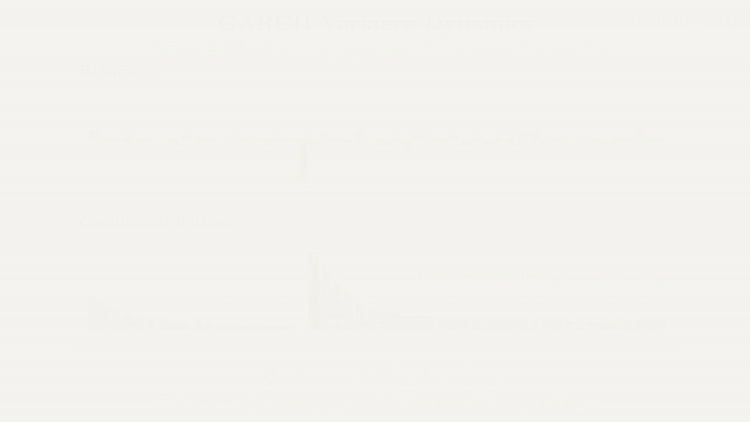
Рис. 1. Динамика дисперсии GARCH — сильный шок вызывает резкий скачок sigma, после чего sigma постепенно возвращается к базовому уровню
Расширения
Стандартная модель GARCH(1,1) симметрично трактует положительные и отрицательные шоки: падение на 2% влияет на будущую волатильность так же, как рост на 2%. На практике наблюдается эффект левериджа: отрицательные доходности обычно повышают волатильность сильнее, чем равные им по модулю положительные. Эта асимметрия хорошо изучена, особенно на рынках акций. Ее связывают с механизмом левериджа: когда цены акций падают, финансовый рычаг компаний растет, вслед за ним повышаются риск и волатильность.
Расширенные модели EGARCH (Нельсон, 1991) и GJR-GARCH (Глостен, Джаганнатан и Ранкл, 1993) учитывают эффект левериджа: отрицательная доходность повышает волатильность сильнее равной ей по модулю положительной. Это хорошо задокументированные улучшения, которые, тем не менее, не устраняют более глубокие структурные ограничения GARCH. Для сравнения мы берем стандартную GARCH(1,1): это самый распространенный и хорошо изученный вариант модели.
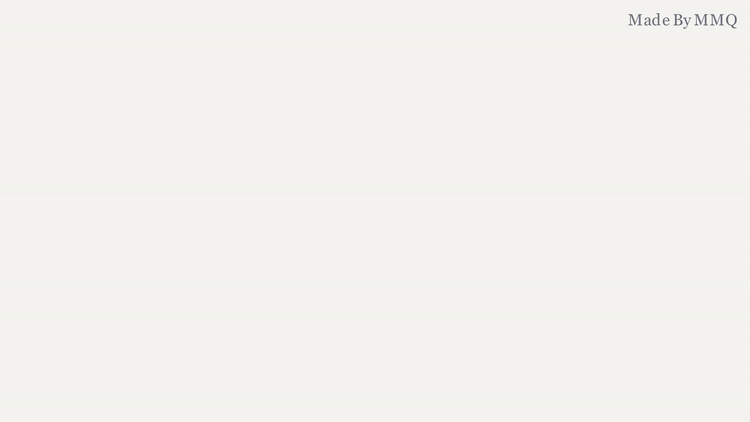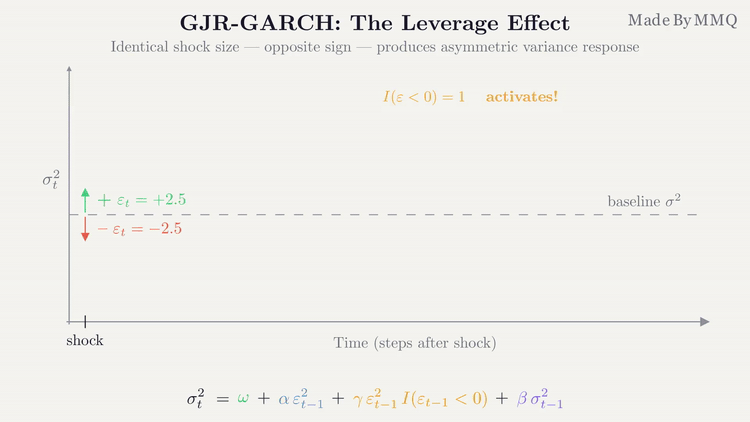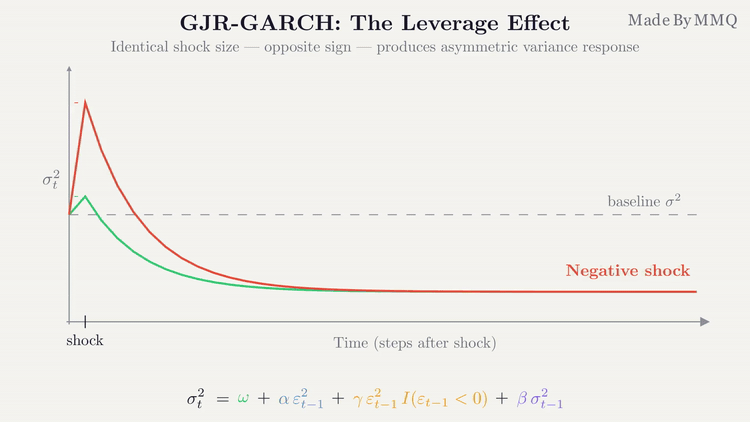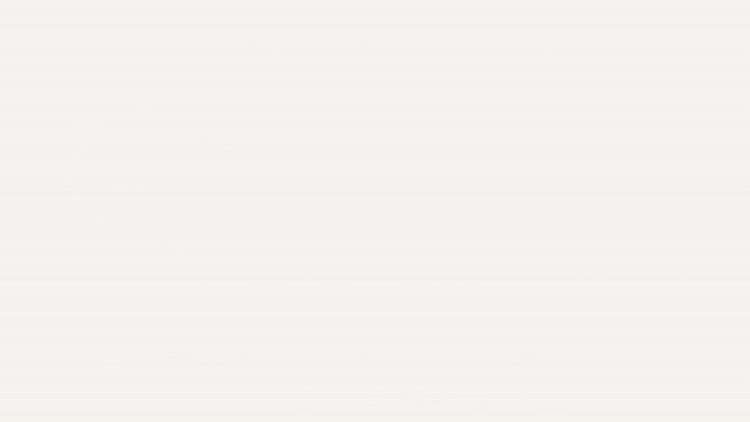
Рис. 2. Эффект левериджа — положительные и отрицательные шоки одинаковой величины по-разному влияют на дисперсию
Чего не может GARCH
При всех достоинствах GARCH опирается на допущения, которым финансовые данные систематически не соответствуют. Эти ограничения важно понять: MMAR отвечает на каждое из них не отдельными дополнениями, а самой структурой модели.
Ограничение 1 — тонкие хвосты. Даже если инновации подчиняются t-распределению Стьюдента, GARCH занижает частоту экстремальных событий. Проблема в параметрическом условном распределении GARCH: оно задает определенную форму хвостов распределения. Хвосты реальных распределений доходностей тяжелее, чем позволяет описать одно параметрическое семейство. На практике это важно: если модель занижает вероятность движения на 5 сигм, она занизит и показатели стоимости под риском (Value-at-Risk) и ожидаемых потерь (Expected Shortfall). В результате резервы капитала могут оказаться недостаточными.
Ограничение 2 — короткая память. В модели GARCH влияние прошлых событий затухает экспоненциально. В процессе GARCH(1,1) автокорреляция квадратов доходностей затухает по закону (alpha + beta)^k, где k — величина лага. При типичных значениях суммы alpha + beta около 0,95-0,99 корреляции становятся пренебрежимо малыми за несколько десятков периодов. Однако эмпирические исследования выявляют гиперболическое затухание автокорреляции квадратов доходностей: при лаге k она затухает как k^(2d-1), где d — параметр долгой памяти, обычно принимающий значения от 0,3 до 0,5. Это значительно медленнее экспоненциального затухания. Кластер волатильности, возникший три месяца назад, все еще влияет на текущую волатильность, но GARCH его фактически "забыла". Расширенная модель FIGARCH частично решает эту проблему, но остается расширением GARCH, а не моделью, построенной с нуля на иных принципах.
Ограничение 3 — отсутствие масштабной согласованности. GARCH работает на одном временном масштабе. Модель GARCH, оцененная на дневных доходностях, не описывает динамику часовых или недельных доходностей. Однако эмпирические данные показывают, что на пятиминутных, часовых и дневных доходностях проявляются одни и те же закономерности: тяжелые хвосты, кластеризация волатильности и долгая память. Это свойство называют масштабированием моментов или масштабной согласованностью. Масштабирование моментов должно следовать из самой структуры модели, без повторной оценки ее параметров на каждом масштабе. GARCH этим свойством не обладает.
Именно эти пробелы и призвана восполнить модель MMAR.
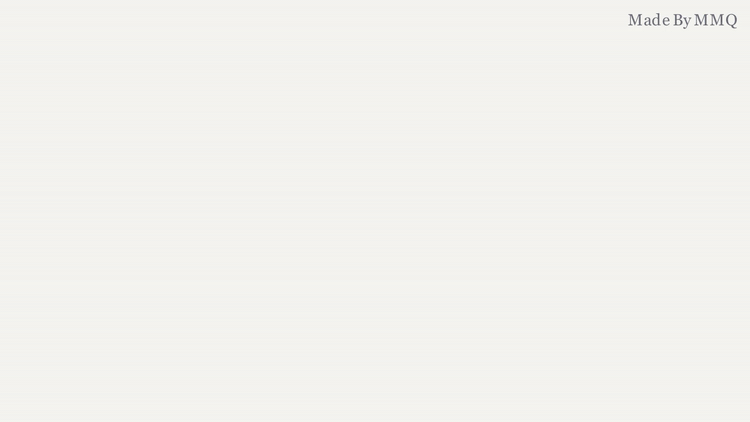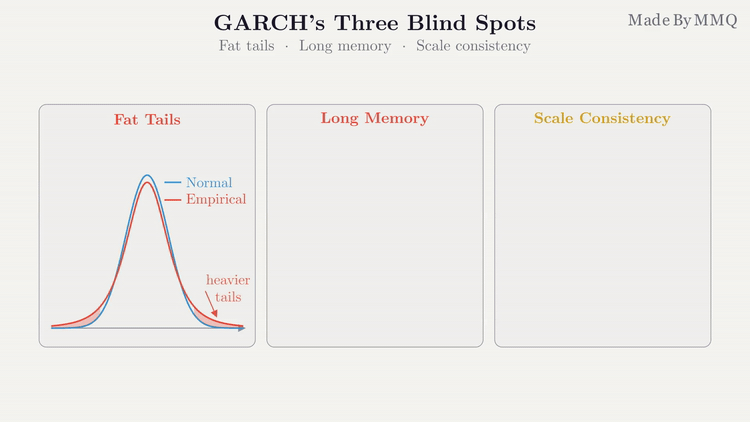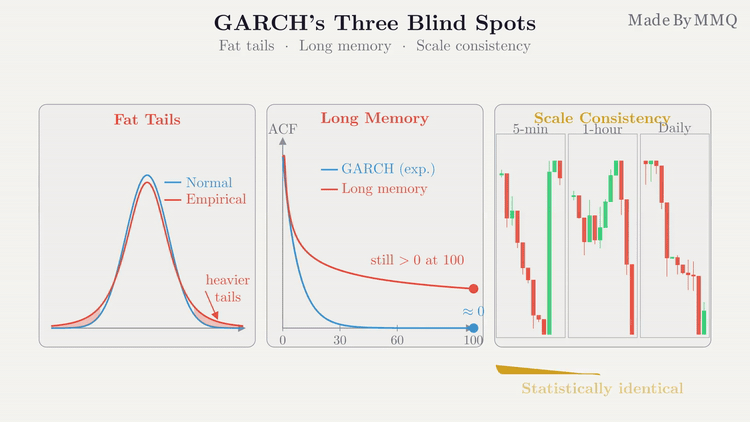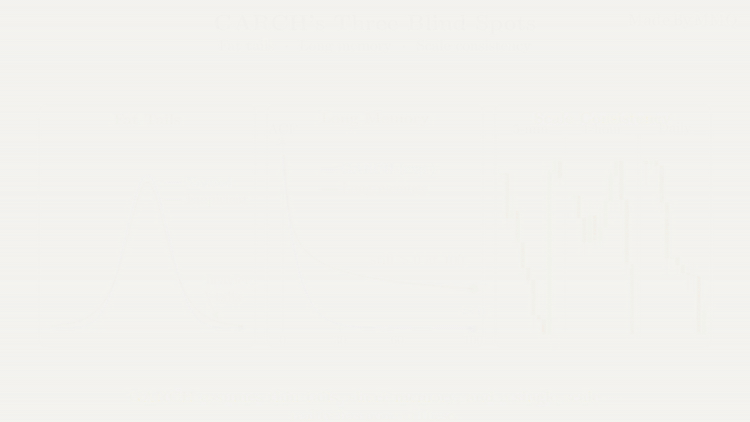
Рис. 3. Три "слепых пятна" модели GARCH — тонкие хвосты, короткая память и отсутствие масштабной согласованности
MMAR — фрактальная альтернатива Мандельброта
Мультифрактальная модель доходностей активов использует принципиально иной подход к описанию финансовых доходностей. GARCH моделирует дисперсию как временной ряд, а MMAR описывает доходности как стохастический процесс, протекающий на деформированной временной шкале. Основное уравнение по Чжану (2017) обманчиво просто:
X(t) = B_H[theta(t)]
Это означает, что процесс логарифма цены X(t) задается как фракционное броуновское движение B_H, взятое в момент мультифрактального торгового времени theta(t). У модели два компонента, каждый из которых отвечает за свои свойства финансовых доходностей. Рассмотрим оба компонента подробно: без них трудно понять весь процесс построения модели.
Компонент 1 — фракционное броуновское движение (FBM)
Фракционное броуновское движение обобщает обычное броуновское движение. Его параметр — показатель Херста H, число от 0 до 1, определяющее характер памяти процесса. При H = 0,5 FBM становится обычным броуновским движением с независимыми приращениями и без памяти — случайным блужданием. При H > 0,5 процесс обладает положительной зависимостью приращений: после движения вверх следующее движение вверх становится вероятнее, что проявляется как тренд. При H < 0,5 процесс антиперсистентен: движения чаще сменяют направление, что проявляется в возврате к среднему.
Математический признак FBM — функция автоковариации его приращений. Для приращений FBM с расстоянием в k временных шагов автоковариация равна:
gamma(k) = (1/2) * [|k+1|^(2H) - 2|k|^(2H) + |k-1|^(2H)]
Эта формула показывает принципиальное отличие FBM от обычного броуновского движения. При H = 0,5 значение gamma(k) равно нулю для всех k > 0: приращения не коррелируют, как в случайном блуждании. При H, отличном от 0,5, значение gamma(k) убывает по степенному закону: при больших k оно пропорционально H(2H-1) * k^(2H-2). При H > 0,5 корреляции положительны и затухают гиперболически. Это принципиально отличается от экспоненциального затухания в GARCH. В GARCH корреляции на лаге 50 экспоненциально малы. В FBM корреляции на таком лаге еще заметны: они медленно убывают по степенному закону. Это и есть долгая память, которую эмпирические исследования обнаруживают в финансовых данных.
На финансовых рынках типичные значения показателя Херста находятся в диапазоне 0,48-0,58. Значения около 0,5 соответствуют поведению, близкому к случайному блужданию; заметно выше 0,5 — устойчивой трендовой направленности; ниже 0,5 — антиперсистентности и возврату к среднему. На валютных рынках значения H обычно сосредоточены в диапазоне 0,48-0,55, а для фондовых индексов иногда наблюдаются несколько более высокие значения — 0,52-0,58.
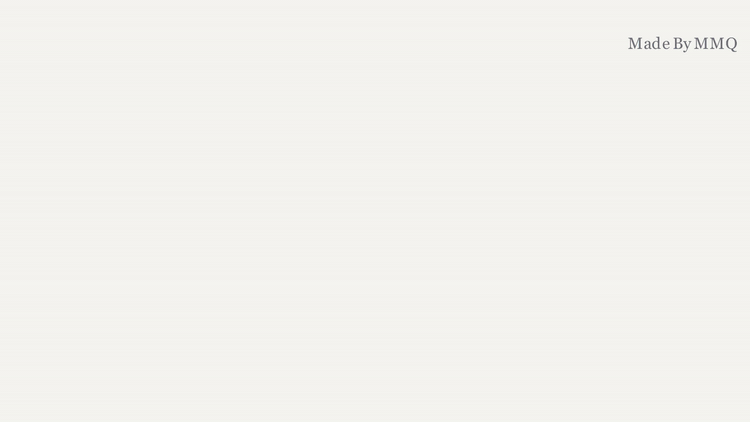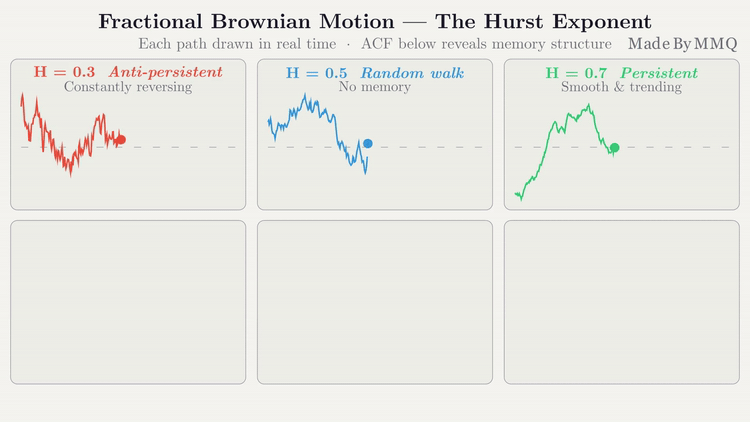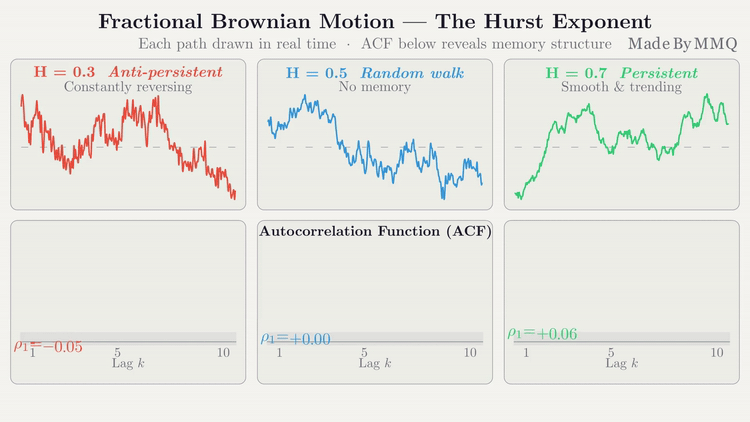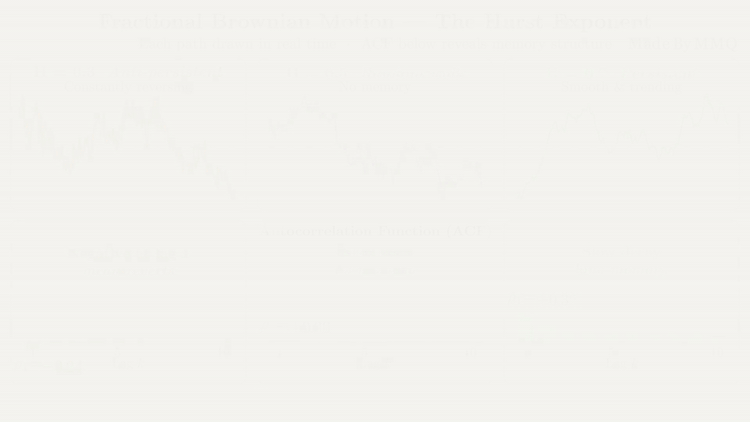
Рис. 4. Траектории FBM при H = 0,3 (антиперсистентный процесс), H = 0,5 (случайное блуждание) и H = 0,7 (персистентный процесс) — под каждой показано затухание автокорреляции
Компонент 2 — мультифрактальное торговое время
Торговое время theta(t) представляет собой кумулятивную функцию распределения мультифрактальной меры, построенной с помощью мультипликативного каскада. Чтобы понять эту идею, задумайтесь, что означает "время" на финансовых рынках.
Время по часам идет равномерно. Каждая минута длится столько же, сколько любая другая. Но активность рынка распределена по времени неравномерно. Во время событий с высокой волатильностью — например, заявления центрального банка или неожиданного геополитического события — за короткое время по часам поступает огромный объем информации. В спокойные часы азиатской сессии почти не происходит значимого процесса формирования цены. Понятие "торгового времени" отражает эту неравномерность: это как часы, которые идут быстрее в периоды высокой активности и медленнее в периоды затишья.
Формально торговое время theta(t) — монотонно возрастающая функция со значениями от 0 до 1. Время по часам можно отобразить в виде прямой линии, но у графика этой функции, напротив, есть крутые и почти плоские участки. На крутых участках небольшому промежутку времени по часам соответствует большое приращение торгового времени. В результате значения FBM берутся в точках, положение которых быстро меняется, и возникают большие по модулю доходности. На почти плоских участках время по часам идет, а торговое время почти не меняется. Значения FBM берутся почти в одной точке, поэтому доходности малы. Такой механизм естественным образом порождает тяжелые хвосты и кластеризацию волатильности, не требуя заранее задавать распределение самих доходностей. Крутые участки порождают экстремальные доходности, а благодаря самоподобной структуре каскада крутые и плоские участки образуют кластеры.
Построение каскада, из которого получают торговое время, начинается с одного интервала [0, 1] с массой 1. На каждом уровне каждый интервал делится на b = 2 подинтервала — так строится бинарный каскад. Массу родительского интервала умножают на случайный множитель и присваивают дочернему. Множители генерируются из распределения, которое подбирают на третьем этапе: нормального, биномиального, распределения Пуассона или гамма-распределения. Затем множители нормализуют так, чтобы сумма каждой пары равнялась 2 и общая масса сохранялась. После k = 10 уровней получается 2^10 = 1 024 интервала с разнообразным распределением массы. Накопленная сумма масс этих интервалов дает theta(t).
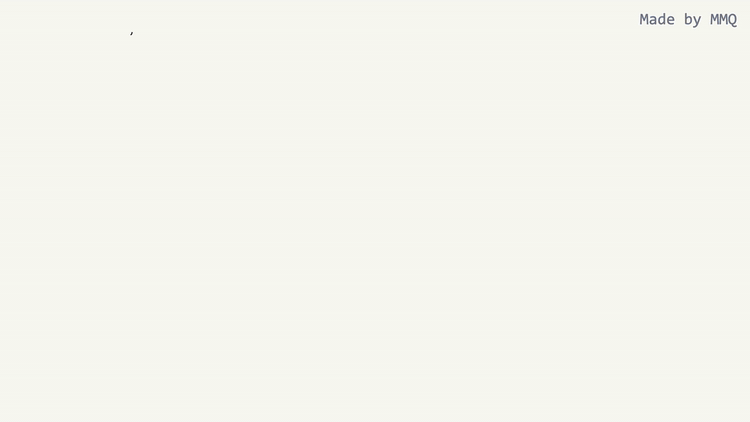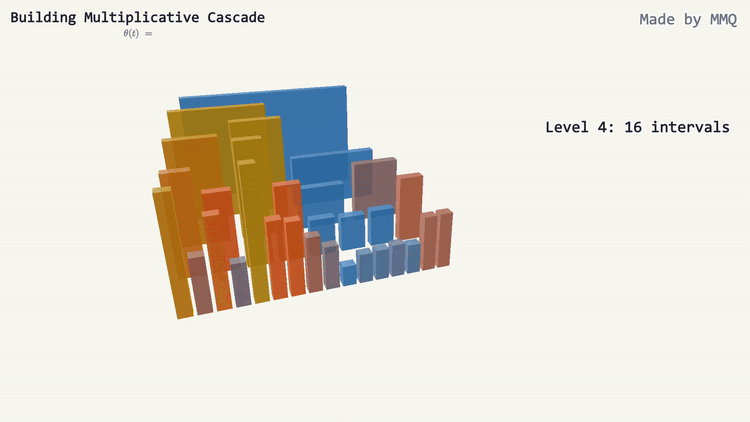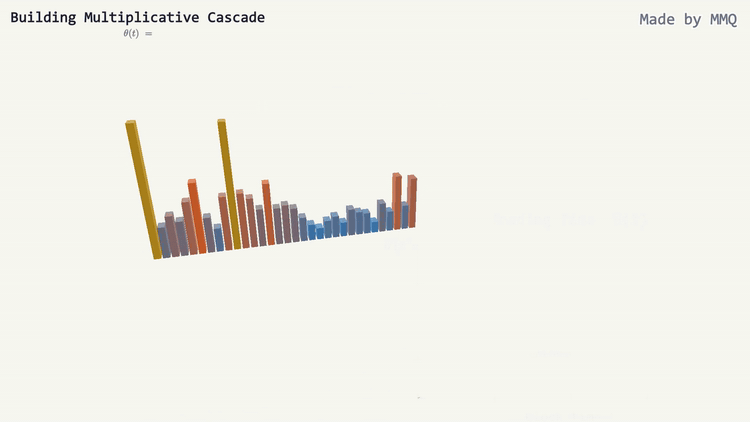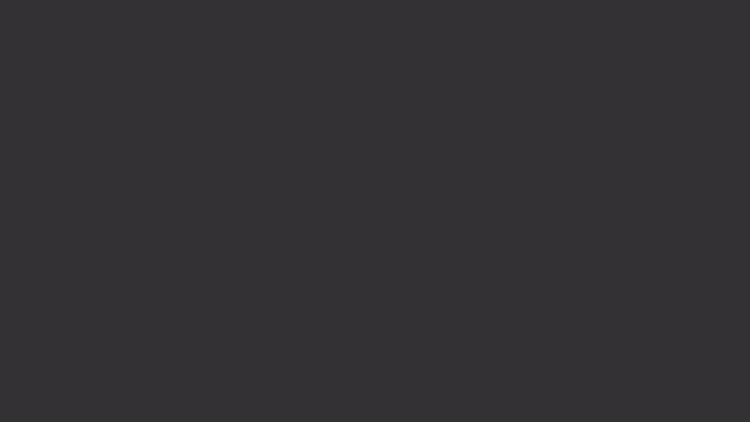
Рис. 5. Построение мультипликативного каскада — масса последовательно перераспределяется при бинарном делении на 10 уровнях
Почему нужны оба компонента?
Ни один из компонентов по отдельности не воспроизводит все стилизованные факты, характерные для финансовых доходностей. Само по себе FBM дает долгую память, но доходности остаются гауссовыми, без тяжелых хвостов. Сама по себе мультифрактальная мера дает тяжелые хвосты и кластеризацию, но не создает долгую память в ряду доходностей. Составной процесс X(t) = B_H[theta(t)] порождает все четыре свойства одновременно:
- долгая память — благодаря гиперболическому затуханию автоковариации приращений FBM;
- тяжелые хвосты — благодаря выборке значений FBM через неравномерное торговое время;
- кластеризация волатильности — благодаря самоподобному распределению массы в каскаде;
- масштабная согласованность (масштабирование моментов) — благодаря мультифрактальной структуре, которая по построению самоподобна на разных масштабах.
В этом состоит ключевая идея Мандельброта, Кальве и Фишера (1997). Благодаря ей MMAR архитектурно выигрывает у расширений GARCH, в которых по одному добавляются точечные исправления. Эффект левериджа в семействе GARCH учитывают с помощью EGARCH/GJR. Долгую память учитывают с помощью FIGARCH. Тяжелые хвосты учитывают с помощью инноваций с t-распределением Стьюдента. Каждое такое дополнение увеличивает число параметров и сложность модели, но не устраняет первопричину: доходности порождаются многомасштабным процессом. Любая модель, игнорирующая эту структуру, всегда будет отставать.

Рис. 6. Составной процесс MMAR — FBM, значение которого берется в мультифрактальном торговом времени, одновременно воспроизводит все четыре стилизованных факта
Подготовка — данные и конфигурация
Вся реализация следует методике Чжана (2017) и состоит из семи этапов на Python. Результаты каждого этапа передаются на следующий. Все параметры процесса собраны в одном конфигурационном файле — config.py. Такой подход делает эксперименты воспроизводимыми и упрощает перебор параметров.
Подробно разберем файл конфигурации: каждый параметр выбран по определенной причине.
# config.py

# =============================================================================
# DATA PARAMETERS
# =============================================================================

SYMBOL = "EURUSD"
TIMEFRAME_MT5 = "M5"
TIMEFRAME_MINUTES = 5

START_DATE = "2024-08-03"
END_DATE = "2026-03-01"

FORECAST_DAYS = 25
FORECAST_INTERVAL_MINUTES = TIMEFRAME_MINUTES
FORECAST_LENGTH = int(FORECAST_DAYS * (24 * 60) / TIMEFRAME_MINUTES)
TRADING_DAYS_PER_YEAR = 252
Мы анализируем EURUSD на пятиминутном таймфрейме; период обучения — с августа 2024 года по март 2026 года. Это значительный объем данных — примерно 18 месяцев пятиминутных баров и десятки тысяч значений доходности для анализа. Горизонт прогнозирования — 25 календарных дней. Значение FORECAST_LENGTH рассчитывается динамически как число пятиминутных интервалов за этот срок — 7 200 значений доходности. Параметру FORECAST_INTERVAL_MINUTES присваивается значение TIMEFRAME_MINUTES, чтобы прогноз, реализованная волатильность и коэффициент приведения к годовому выражению рассчитывались для одного интервала доходности. Если бы эти интервалы различались, мы сравнивали бы несопоставимые значения волатильности.
# =============================================================================
# STEP 1: PARTITION FUNCTION PARAMETERS
# =============================================================================

DELTA_T_MIN = 1
DELTA_T_MAX = 150
DELTA_T_SPACING_FACTOR = 1.1
NUM_DELTA_T_VALUES = 30

Q_MIN = 0.01
Q_MAX = 30.0
Q_STEP = 0.5

MIN_R_SQUARED = 0.60
Параметры функции разбиения требуют пояснения. Значения Delta_t охватывают от 1 до 150 наблюдений и располагаются с логарифмическим шагом при коэффициенте 1,1. Логарифмический шаг важен: мы проверяем степенной закон масштабирования, который на графике с логарифмическими осями выглядит как прямая. При равномерном шаге короткие масштабы были бы представлены избыточно, а длинные — недостаточно; это исказило бы результат регрессии. Порядок момента q изменяется от 0,01 до 30,0 с шагом 0,5; получается около 60 значений q. Чжан использовал этот диапазон: он охватывает моменты низкого порядка (q < 2), характеризующие центр распределения, и высокого порядка (q > 5), характеризующие хвосты. Порог R-квадрата 0,60 — наш минимальный критерий подтверждения фрактальности; у Чжана среднее значение по 20 акциям составило 0,66.
Функция generate_delta_t_values() формирует сетку с логарифмическим шагом:
def generate_delta_t_values():
    delta_t_values = []
    current = DELTA_T_MIN
    while current <= DELTA_T_MAX:
        delta_t_values.append(int(current))
        current *= DELTA_T_SPACING_FACTOR

    # Remove duplicates and sort
    return np.unique(np.array(delta_t_values))
Начиная с 1, каждое следующее значение получают умножением предыдущего на 1,1. Так образуется геометрическая последовательность. При малых масштабах соседние значения после преобразования int() могут совпасть. Вызов np.unique() удаляет такие повторы. Здесь также задаются параметры каскада и метода Монте-Карло:
# =============================================================================
# STEP 4-6: CASCADE AND FBM PARAMETERS
# =============================================================================

CASCADE_B = 2    # Binary cascade (divide into 2 intervals at each step)
CASCADE_K_MAX = 10 # Standalone cascade depth (2^10 = 1024 intervals)

# =============================================================================
# STEP 7: MONTE CARLO SIMULATION PARAMETERS
# =============================================================================

NUM_SIMULATIONS = 1000  # Paper used 10,000
RANDOM_SEED = 42
В каскаде применяется бинарное деление (b=2) на k=10 уровнях; каждый каскад формирует сетку из 2^10 = 1 024 узлов. Для метода Монте-Карло проводят 1 000 симуляций с фиксированным начальным значением генератора случайных чисел, чтобы результаты можно было воспроизвести. Чжан использовал 10 000 симуляций, а мы ограничимся 1 000. Это практический компромисс: этого достаточно для устойчивой сходимости, при этом время вычислений остается приемлемым.
В конфигурации также предусмотрена функция проверки, выявляющая ошибки параметров при загрузке:
def validate_config():
    assert DELTA_T_MIN > 0, "DELTA_T_MIN must be positive"
    assert DELTA_T_MAX > DELTA_T_MIN, "DELTA_T_MAX must be greater than DELTA_T_MIN"
    assert Q_MIN > 0, "Q_MIN must be positive"
    assert Q_MAX > Q_MIN, "Q_MAX must be greater than Q_MIN"
    assert 0 <= MIN_R_SQUARED <= 1, "MIN_R_SQUARED must be between 0 and 1"
    assert FORECAST_INTERVAL_MINUTES == TIMEFRAME_MINUTES, (
        "FORECAST_INTERVAL_MINUTES should match TIMEFRAME_MINUTES so forecasts, "
        "realized volatility, and annualization use the same return interval"
    )
    assert CASCADE_B >= 2, "CASCADE_B must be at least 2"
    assert CASCADE_K_MAX > 0, "CASCADE_K_MAX must be positive"
Важно проверить равенство FORECAST_INTERVAL_MINUTES и TIMEFRAME_MINUTES. Если модель обучается на пятиминутных барах, а прогноз строится для другого интервала, единицы волатильности не совпадут. Сравнивать такой прогноз с реализованной волатильностью будет бессмысленно.
Загрузка данных из MetaTrader 5
Данные загружаются через класс DataLoader — оболочку Python-пакета MetaTrader5. Класс поддерживает два источника данных: подключение к MetaTrader 5 и резервный CSV-файл на случай, если MetaTrader 5 недоступен. При инициализации подключение к MetaTrader 5 обрабатывается с проверкой ошибок; при успешном подключении выводятся сведения о терминале, счете и сервере:
# data_loader.py

try:
    import MetaTrader5 as mt5
    MT5_AVAILABLE = True
except ImportError:
    MT5_AVAILABLE = False
    print("Warning: MetaTrader5 module not installed. Only CSV loading available.")

class DataLoader:
    def _initialize_mt5(self):
        if not MT5_AVAILABLE:
            return False

        if not mt5.initialize():
            if self.verbose:
                print(f"MT5 initialization failed: {mt5.last_error()}")
            return False

        self.mt5_initialized = True
        return True
После подключения load_from_mt5() получает через mt5.copy_rates_range() бары OHLCV для заданного символа и диапазона дат, затем преобразует их в DataFrame библиотеки pandas со стандартными именами столбцов:
def load_from_mt5(self, symbol=None, timeframe=None,
                 start_date=None, end_date=None):
    symbol = symbol or self.symbol
    timeframe = timeframe or config.TIMEFRAME_MT5

    if not self._initialize_mt5():
        raise RuntimeError("Failed to initialize MetaTrader 5.")

    mt5_tf = self._get_mt5_timeframe(timeframe)
    rates = mt5.copy_rates_range(symbol, mt5_tf, start_date, end_date)

    if rates is None or len(rates) == 0:
        raise ValueError(f"Failed to fetch data: {mt5.last_error()}")

    df = pd.DataFrame(rates)
    df['time'] = pd.to_datetime(df['time'], unit='s')
    df.set_index('time', inplace=True)
    df.columns = ['open', 'high', 'low', 'close',
                 'tick_volume', 'spread', 'real_volume']
    self.data = df
    return df
Загрузчик CSV поддерживает разные варианты столбцов даты и времени: отдельные столбцы для даты и времени либо один общий столбец datetime:
def load_csv(self, filepath):
    df = pd.read_csv(filepath)
    df.columns = df.columns.str.lower()

    if 'date' in df.columns and 'time' in df.columns:
        df['datetime'] = pd.to_datetime(
            df['date'].astype(str) + ' ' + df['time'].astype(str)
        )
    elif 'datetime' in df.columns:
        df['datetime'] = pd.to_datetime(df['datetime'])
    elif 'time' in df.columns:
        df['datetime'] = pd.to_datetime(df['time'])

    df.set_index('datetime', inplace=True)
    df.sort_index(inplace=True)
    df = df.loc[self.start_date:self.end_date]
    self.data = df
    return df
Расчет логарифмических доходностей
Загрузив исходные данные OHLCV, мы рассчитываем логарифмические доходности — стандартную форму данных для мультифрактального анализа:
def calculate_returns(self, price_column='close', method='log'):
    if self.data is None:
        raise ValueError("No data loaded. Call load_from_mt5() or load_csv() first.")

    prices = self.data[price_column].values
    self.prices = prices

    if method == 'log':
        # Log returns: ln(P_t / P_{t-1}) = ln(P_t) - ln(P_{t-1})
        returns = np.diff(np.log(prices))
    elif method == 'simple':
        # Simple returns: (P_t - P_{t-1}) / P_{t-1}
        returns = np.diff(prices) / prices[:-1]

    returns_series = pd.Series(returns, index=self.data.index[1:])
    self.returns = returns_series
    return returns_series
Логарифмические доходности удобны для мультифрактального анализа благодаря аддитивности при переходе между временными масштабами. Логарифмическая доходность за 30 минут в точности равна сумме логарифмических доходностей за шесть пятиминутных интервалов внутри этого периода. У простых доходностей такого свойства нет: они перемножаются, а не складываются. Благодаря аддитивности на первом этапе с помощью функции разбиения можно проверить масштабирование моментов на разных уровнях агрегации. Выражение np.diff(np.log(prices)) численно эквивалентно np.log(prices[1:] / prices[:-1]), но не требует создавать временный массив отношений.
Класс DataLoader также проверяет качество данных с помощью summary_statistics(). Проверка выявляет значения NaN и высокую долю нулевых доходностей, которые могут указывать на пробелы в данных или низкую ликвидность. Кроме того, рассчитываются асимметрия и эксцесс. Положительный эксцесс указывает на тяжелые хвосты распределения — именно их мы ожидаем обнаружить:
def summary_statistics(self):
    nan_count = self.returns.isna().sum()
    zero_count = (self.returns == 0).sum()
    zero_pct = 100 * zero_count / len(self.returns)

    print(f"  NaN values: {nan_count}")
    print(f"  Zero returns: {zero_count} ({zero_pct:.2f}%)")

    if nan_count > 0:
        print("  WARNING: Data contains NaN values!")
    if zero_pct > 5:
        print(f"  WARNING: High percentage of zero returns ({zero_pct:.1f}%)")
Доля нулевых доходностей выше 5% часто указывает на проблемы с качеством данных: разрывы за выходные отфильтрованы неправильно либо ликвидность инструмента настолько низка, что цена не меняется между тиками.
Оркестрация пайплайна
Каждый этап выполняется отдельным скриптом запуска — run_step1.py, run_step2.py и т.д. Скрипт загружает результат предыдущего этапа из pickle-файла, выполняет текущий этап и сохраняет результат для следующего. Благодаря этому можно повторить отдельный этап, не запуская заново весь пайплайн. Например, run_step1.py загружает данные, проверяет их на фрактальность и сохраняет объект FractalityChecker:
# run_step1.py

def main():
    # Load data
    loader = DataLoader(
        symbol=config.SYMBOL,
        start_date=config.START_DATE,
        end_date=config.END_DATE,
        verbose=True
    )

    if config.MT5_ENABLED:
        loader.load_from_mt5()
    else:
        csv_path = Path(config.DATA_DIR) / f"{config.SYMBOL}_{config.START_DATE}_{config.END_DATE}.csv"
        loader.load_csv(csv_path)

    loader.calculate_returns(price_column='close', method='log')
    loader.summary_statistics()

    returns = loader.get_returns_array()
    checker = run_fractality_check(returns, save_plots=True)

    # Save for Step 2
    checker_path = Path(config.OUTPUT_DIR) / "step1_checker.pkl"
    with open(checker_path, 'wb') as f:
        pickle.dump(checker, f)
Шаг 1 — проверка на фрактальность
Прежде чем строить MMAR, нужно ответить на исходный вопрос: есть ли в наших данных признаки мультифрактальности? Если ответ отрицательный, вся конструкция теряет смысл. Применять MMAR к нефрактальным данным — все равно что подгонять полином к прямой: сложность возрастет, а пользы не будет. Для проверки используется функция разбиения — инструмент статистической физики, который позволяет оценить масштабирование моментов доходностей на разных временных интервалах.
Функция разбиения
В соответствии с уравнением Чжана (4.1) функция разбиения определяется так:
S_q(T, delta_t) = (1/N) * sum |r(i * delta_t, delta_t)|^q
где r(i * delta_t, delta_t) — доходность за неперекрывающийся интервал длиной delta_t, q — порядок момента, а N — число полных неперекрывающихся интервалов. Давайте разберемся, что именно измеряет этот показатель.
При заданном масштабе delta_t мы делим ряд на неперекрывающиеся блоки по delta_t последовательных значений доходности. Затем суммируем логарифмические доходности внутри каждого блока и получаем для него одну агрегированную доходность. Затем мы берем модуль каждой агрегированной доходности, возводим его в степень q и вычисляем среднее. Так для каждой пары значений q и delta_t мы получаем одно число S_q. Затем перебираем значения delta_t от 1 до 150 наблюдений и значения q от 0,01 до 30,0.
Фрактальная гипотеза состоит в следующем: если данные обладают фрактальной структурой, то при каждом q значение log(S_q) должно линейно зависеть от log(delta_t). Иначе говоря, зависимость S_q от delta_t должна быть степенной. Наклон прямой на графике в логарифмических координатах равен tau(q) + 1, где tau(q) — функция масштабирования, которую мы определим на втором этапе.
Почему именно неперекрывающиеся интервалы?
Неперекрывающиеся интервалы принципиально важны; Чжан подчеркивает это отдельно. Перекрывающиеся окна создавали бы искусственную автокорреляцию: смежные окна содержат в основном одни и те же наблюдения, поэтому рассчитанные по ним агрегированные доходности коррелируют уже из-за перекрытия. Это завышает коэффициент детерминации R² при регрессии в логарифмических координатах, из-за чего данные могут выглядеть более фрактальными, чем они есть. Неперекрывающиеся окна обеспечивают статистическую независимость наблюдений и позволяют провести объективную проверку.
Почему среднее, а не сумма?
Еще одно неочевидное, но важное решение — вычислять среднее |r|^q, а не сумму. Чем больше delta_t, тем меньше N — число полных интервалов, помещающихся в ряд. При использовании суммы S_q уменьшалась бы уже потому, что число слагаемых сокращается. Тогда масштабная зависимость смешивалась бы с влиянием размера выборки. Среднее значение позволяет отделить масштабирование моментов от влияния числа интервалов.
Вот полная реализация:
# step1_check_fractality.py

class FractalityChecker:
    def __init__(self, returns, delta_t_values=None, q_values=None,
                 verbose=config.VERBOSE):
        self.returns = returns
        self.verbose = verbose

        self._validate_returns()

        if delta_t_values is None:
            self.delta_t_values = config.generate_delta_t_values()
        else:
            self.delta_t_values = delta_t_values

        if q_values is None:
            self.q_values = config.generate_q_values()
        else:
            self.q_values = q_values

        # Storage for results
        self.partition_values = {}  # {q: {delta_t: S_q value}}
        self.r_squared_values = {}  # {q: R-squared}
        self.slopes = {}  # {q: slope (which equals tau(q) + 1)}
        self.intercepts = {}  # {q: intercept}
Конструктор принимает ряд доходностей, а при необходимости — заданные пользователем сетки значений delta_t и q. Метод _validate_returns() проверяет наличие NaN/Inf, отмечает ряды короче 1 000 наблюдений и предупреждает о высокой доле нулевых доходностей. Если в данных есть NaN или бесконечные значения, метод вызывает исключение ValueError: иначе такие значения незаметно исказили бы все последующие вычисления.
Сам расчет функции разбиения векторизован для повышения производительности:
def calculate_partition_function(self, q, delta_t):
    # Number of complete NON-overlapping intervals (floor division)
    N = len(self.returns) // delta_t

    if N <= 0:
        return np.nan

    # Trim returns to fit complete intervals
    trimmed_returns = self.returns[:N * delta_t]

    # Reshape into (N, delta_t) and sum along axis 1
    # This gives us N non-overlapping interval returns
    interval_returns = trimmed_returns.reshape(N, delta_t).sum(axis=1)

    # MEAN of |r|^q (removes N-dependency as delta_t changes)
    S_q = np.mean(np.abs(interval_returns) ** q)

    return S_q
Ключевой прием векторизации — последовательность операций reshape(N, delta_t).sum(axis=1). Вместо цикла с ручным суммированием доходностей по интервалам мы преобразуем укороченный массив в двумерную матрицу: каждая строка соответствует одному неперекрывающемуся интервалу. Затем одной операцией NumPy суммируем значения в каждой строке. Для больших наборов данных такой код лаконичнее и на несколько порядков быстрее явных циклов.
Давайте рассмотрим это на конкретном примере. Предположим, что у нас есть 1 000 значений доходности, а delta_t = 50. Тогда N = 1000 // 50 = 20. Берем первые 1 000 значений доходности и преобразуем их в матрицу размером 20 x 50. Суммируем значения в каждой строке, получаем 20 агрегированных доходностей, берем их модули, возводим в степень q и вычисляем среднее. Полученное среднее и есть S_q(T, 50) для выбранного q.
Вычислив S_q для всех пар q и delta_t — около 60 x 30 = 1 800 комбинаций, — мы для каждого q строим линейную регрессию в логарифмических координатах:
def fit_partition_plots(self):
    for q in self.q_values:
        delta_t_list = []
        S_q_list = []

        for delta_t in sorted(self.partition_values[q].keys()):
            S_q = self.partition_values[q][delta_t]
            if not np.isnan(S_q) and S_q > 0:
                delta_t_list.append(delta_t)
                S_q_list.append(S_q)

        log_delta_t = np.log10(delta_t_list)
        log_S_q = np.log10(S_q_list)

        # OLS regression
        slope, intercept, r_value, p_value, std_err = stats.linregress(
            log_delta_t, log_S_q
        )

        # slope = tau(q) + 1
        self.slopes[q] = slope
        self.intercepts[q] = intercept
        self.r_squared_values[q] = r_value ** 2
Наклон каждой линии регрессии равен tau(q) + 1, где tau(q) — функция масштабирования, которую мы определим на втором этапе. Коэффициент детерминации R² показывает, насколько хорошо степенная зависимость описывает данные при данном порядке момента q. Главный результат этого этапа — значения коэффициента детерминации R² для всех q. На данных по акциям Чжан получил среднее значение R² 0,66; наш порог — 0,60. Среднее значение R² выше 0,60 подтверждает наличие масштабирования моментов — характерного признака фрактального процесса.
В модуле проверки также есть метод поиска кроссовера — масштаба времени, ниже которого нарушается высокочастотное масштабирование. На очень коротких временных масштабах зависимость могут искажать эффекты микроструктуры: колебания цены между Bid и Ask и дискретный шаг цены. Для поиска кроссовера последовательно проверяются диапазоны масштабов, начинающиеся с каждого значения delta_t. Для каждого такого диапазона вычисляется среднее R² по всем q:
def detect_crossover_point(self, r_squared_threshold=0.85):
    self.crossover_scores = {}
    sorted_dt = sorted(self.delta_t_values)

    for start_idx, candidate_dt in enumerate(sorted_dt):
        candidate_dts = sorted_dt[start_idx:]
        if len(candidate_dts) < 3:
            break

        r2_values = []
        for q in self.q_values:
            # Re-fit regression using only delta_t >= candidate_dt
            # ...
            _, _, r_value, _, _ = stats.linregress(log_delta_t, log_S_q)
            r2_values.append(r_value ** 2)

        if r2_values:
            self.crossover_scores[candidate_dt] = np.mean(r2_values)

    # Find first delta_t where truncated R-squared exceeds threshold
    for dt, mean_r2 in self.crossover_scores.items():
        if mean_r2 >= r_squared_threshold:
            return dt

    return None
Если кроссовер найден, например, при delta_t = 5, зависимость масштабирования наиболее выражена при delta_t >= 5 и нарушается при меньших значениях. Это помогает понять фрактальную структуру данных в разных масштабах.
Заключение
В этой статье мы заложили основу для мультифрактальной модели доходностей активов. Мы рассмотрели теоретические основы GARCH и MMAR, загрузили данные EURUSD на пятиминутном таймфрейме через MetaTrader5 Python API и провели первую важную проверку: проявляется ли в данных мультифрактальное масштабирование? Вот что мы установили:
- У GARCH есть структурные "слепые зоны". Несмотря на изящество и широкое применение, GARCH предполагает тонкие хвосты распределения, обладает короткой памятью с экспоненциальным затуханием и работает в одном временном масштабе. Это не мелкие придирки, а фундаментальные ограничения модели: реальные рыночные данные систематически не соответствуют ее допущениям.
- MMAR устраняет все эти ограничения сразу. Составной процесс X(t) = B_H[theta(t)] объединяет фракционное броуновское движение, отвечающее за долгую память, и мультифрактальное торговое время, связанное с тяжелыми хвостами и кластеризацией волатильности. Благодаря одному архитектурному решению модель воспроизводит все четыре стилизованных факта, характерных для финансовых доходностей, без отдельных поправок к параметрам.
- Фрактальность поддается проверке, а не является допущением. Анализ функции разбиения на первом этапе позволяет количественно проверить наличие мультифрактального масштабирования. Если данные не проходят эту проверку, MMAR использовать не следует. Это необходимая предварительная проверка, которой нет в подходах на основе GARCH, хотя, возможно, она нужна и там.
Главный вывод: эту проверку нельзя считать необязательной тратой времени и вычислительных ресурсов. На нефрактальных данных MMAR дала бы прогнозы хуже GARCH и при этом потребовала бы больше вычислительных ресурсов. Анализ функции разбиения служит честным пороговым критерием: прежде чем вкладывать усилия в модель, можно проверить, есть ли в данных фрактальная структура, которую стоит описывать.
Во второй части серии по результатам анализа функции разбиения мы определим функцию масштабирования tau(q), оценим показатель Херста H, проведем строгую проверку на мультифрактальность и аппроксимируем мультифрактальный спектр четырьмя теоретическими распределениями. Эти оцененные параметры станут связующим звеном между начатым здесь анализом и построением MMAR в третьей части.
Отказ от ответственности: эта статья предназначена исключительно для образовательных и исследовательских целей. Представленные здесь модели и программный код основаны на научных исследованиях и не должны рассматриваться как финансовые рекомендации. Прогнозирование волатильности неизбежно связано с неопределенностью. Прежде чем рисковать реальными деньгами, всегда проверяйте модели на вневыборочных данных и тестируйте их на демо-счетах.
Как получить исходный код через MQL5 Algo Forge
Все исходные файлы приложены к статье ниже. Полный репозиторий также доступен на MQL5 Algo Forge — платформе сообщества на базе Git для обмена торговыми проектами и совместной работы над ними. Algo Forge хранит историю версий локально и в облаке, поэтому вам будет доступна актуальная версия кода, в том числе обновления и исправления, внесенные после публикации статьи.
Чтобы клонировать репозиторий, откройте командную строку, PowerShell или встроенный терминал редактора и выполните команду:
git clone https://forge.mql5.io/ayantrader/MMAR.git
Для этого на вашем компьютере должен быть установлен Git. Если вы работаете в Visual Studio Code, откройте встроенный терминал сочетанием клавиш Ctrl+` и выполните команду прямо в нем. Репозиторий будет клонирован в папку MMAR в текущем каталоге.
Кроме того, проект можно просматривать по адресу forge.mql5.io/ayantrader/MMAR: исходные файлы, историю коммитов и обновления можно открыть прямо в браузере. В отличие от приложенных файлов, Algo Forge дает доступ ко всей истории Git и позволяет загружать будущие обновления одной командой:
git pull
| Имя файла | Описание |
|---|---|
| config.py | Параметры конфигурации, вспомогательные функции и проверка данных для всего пайплайна |
| data_loader.py | Загрузка данных из MetaTrader 5 с резервной загрузкой из CSV, расчет доходностей и проверка качества данных |
| utils.py | Общие служебные функции: скользящие окна, расчет волатильности и автокорреляции, таймер, экспорт в JSON |
| step1_check_fractality.py | Анализ функции разбиения на неперекрывающихся интервалах, оценка коэффициента детерминации R², поиск кроссовера |
| run_step1.py | Скрипт запуска: загружает данные, проверяет их на фрактальность и сохраняет FractalityChecker для второго этапа |
| requirements.txt | Зависимости Python |
Дополнительная литература:
- A Multifractal Model of Asset Returns — Benoit Mandelbrot, Adlai Fisher, Laurent Calvet, 1997
- Generalized autoregressive conditional heteroskedasticity — Tim Bollerslev, 1986
- Volatility Forecasting with the Multifractal Model of Asset Returns — Terrence Y. Zhang, 2017
- Dynamic Conditional Correlation - a Simple Class of Multivariate GARCH Models — Robert F. Engle, 2000
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22438
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Особенности написания Пользовательских Индикаторов
 Рыночная микроструктура в MQL5 (Часть 1): Надежный базовый слой

 Нейроструктурный торговый движок — NSTE (Часть II): Шестиступенчатый квантовый фильтр "Врата Джардина"

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования