

Redes neuronales en el trading: Modelos de refinamiento iterativo de previsiones (Final)
 6
 0

Introducción
El mercado no tiene prisa por revelar sus intenciones. Vive en constante movimiento: flexible, fluido y, a menudo, impredecible. Cada variación en el precio no es una fluctuación aleatoria, sino el reflejo de una multitud de interacciones que tienen lugar entre los participantes en el mercado y los flujos de información. Y mientras que los modelos clásicos intentan captar ese instante en una única imagen, el enfoque moderno RAFT (Recurrent All-Pairs Field Transforms) va más allá. Este no se limita a hacer una única previsión, sino que la va refinando una y otra vez, entablando un diálogo con los datos.
Esta idea parece casi filosófica. Estamos acostumbrados a que el modelo genere un resultado y se haga a un lado. RAFT, por su parte, sigue involucrado en el proceso, como un analista experimentado que comprueba paso a paso sus hipótesis, cotejando cada nueva observación con el panorama general de lo que está sucediendo. En lugar de una función directa de entrada-salida, aquí se crea un campo de interrelaciones en el que cada elemento influye en los demás. Este enfoque no solo mejora la precisión, sino que cambia la propia concepción de la predicción. El resultado no es un número, sino un estado del modelo, un reflejo de su coherencia interna con el mercado.
En la versión original, RAFT se usaba para calcular el flujo óptico, es decir, para estimar el movimiento entre dos fotogramas. Sin embargo, si dejamos de lado los detalles técnicos, la lógica misma del método concuerda sorprendentemente con las tareas del análisis financiero. Porque aquí también tenemos dos estados: el pasado y el presente. Estamos tratando de entender hacia dónde se dirige el movimiento. Los píxeles se sustituyen por cotizaciones. En lugar de estructuras ópticas, tenemos patrones de precios. Y, en lugar de fotogramas, cortes temporales del mercado. De este modo, la adaptación de RAFT a las tareas de trading se convierte en un paso lógico en el desarrollo de las ideas sobre el refinamiento repetido de las previsiones.
En trabajos anteriores ya habíamos sentado las bases. El primer artículo se centró en el concepto de iteraciones múltiples y en la descripción de la arquitectura general del framework. El segundo, en el análisis de los componentes clave, desde la construcción del campo de correlaciones hasta los bloques recurrentes que controlan el proceso de refinamiento. Hemos visto cómo el modelo puede mejorar gradualmente sus predicciones, volviendo a los datos originales y comprobando cada hipótesis de nuevo.
Antes de continuar con el trabajo, conviene reflexionar una vez más sobre por qué precisamente RAFT supuso un avance tan notable. Su principal punto fuerte radica en su capacidad para modelar el campo completo de interacciones por pares. En lugar de buscar correlaciones locales, compara todos los elementos entre sí, creando una especie de mapa de atracciones y repulsiones recíprocas. En el contexto financiero, esto significa que cada barra, cada característica o indicador no se analiza de forma aislada, sino en el contexto de toda la historia y de todas las posibles relaciones. Esto aporta solidez a la previsión y un enfoque sistémico al modelo.
El siguiente elemento fundamental es el refinamiento iterativo. A diferencia de las redes neuronales de un solo paso, RAFT actualiza repetidamente la estimación del movimiento o, en nuestro caso, la predicción. Tras cada iteración, la nueva información se compara con el mapa general de interrelaciones y el modelo ajusta la dirección. Esta estrategia se asemeja al proceso del razonamiento analítico: primero, una hipótesis; después, su comprobación, su refinamiento y, de nuevo, su comprobación. Gracias a ello, RAFT es capaz de centrarse en las regularidades clave sin perder el contexto y sin caer en el sobreajuste.
El bloque recurrente desempeña un papel especial. Su función consiste en conservar el estado interno, es decir, la memoria del modelo, y controlar la velocidad de adaptación. En las aplicaciones financieras, esto puede interpretarse como un mecanismo interno de gestión de la confianza: el grado de confianza que tiene el modelo en la estimación actual. ¿Conviene revisarla? ¿Y cómo reaccionar ante los cambios en el régimen de mercado? De este modo, el componente recurrente se convierte en algo más que un simple elemento técnico. Es un regulador de la intuición, que mantiene el equilibrio entre los nuevos datos y la experiencia acumulada.
El principio multiescala es igualmente importante. En la arquitectura original de RAFT se aplica una compresión piramidal de la correlación de características. En cada nivel se agrega y se refina la información a distintas resoluciones. Este principio resulta especialmente relevante para el mercado. Y es que las fluctuaciones a corto plazo y las tendencias a largo plazo se desarrollan en horizontes temporales distintos, pero se influyen mutuamente. Un modelo capaz de tener en cuenta esta interacción se acerca más a la realidad. Percibe tanto los movimientos individuales como el ritmo general del mercado.
La puesta en práctica de estas ideas mediante MQL5 confiere al proyecto un valor especial. MQL5 ofrece potentes herramientas para trabajar con series temporales y acceso directo a los datos de negociación, mientras que OpenCL abre nuevas posibilidades para el cálculo paralelo. Al combinar ambos, obtenemos un laboratorio para comprobar conceptos fundamentales con datos reales, sin alejarnos de la práctica del trading. Cada iteración del modelo se puede probar en tiempo real.
El framework RAFT también resulta interesante por su carácter universal. Sus principios —la construcción de un campo de interacciones, el refinamiento iterativo y la memoria recurrente— no dependen de ningún ámbito concreto. En el mundo del trading, estas ideas permiten crear un sistema que no solo realiza previsiones, sino que aprende a refinarlas. Un sistema que no se precipita a la hora de tomar decisiones, sino que comprueba cada uno de sus pasos. En una época en la que la rapidez y la precisión determinan el éxito en el mercado, esta cualidad se convierte en una ventaja poco común.
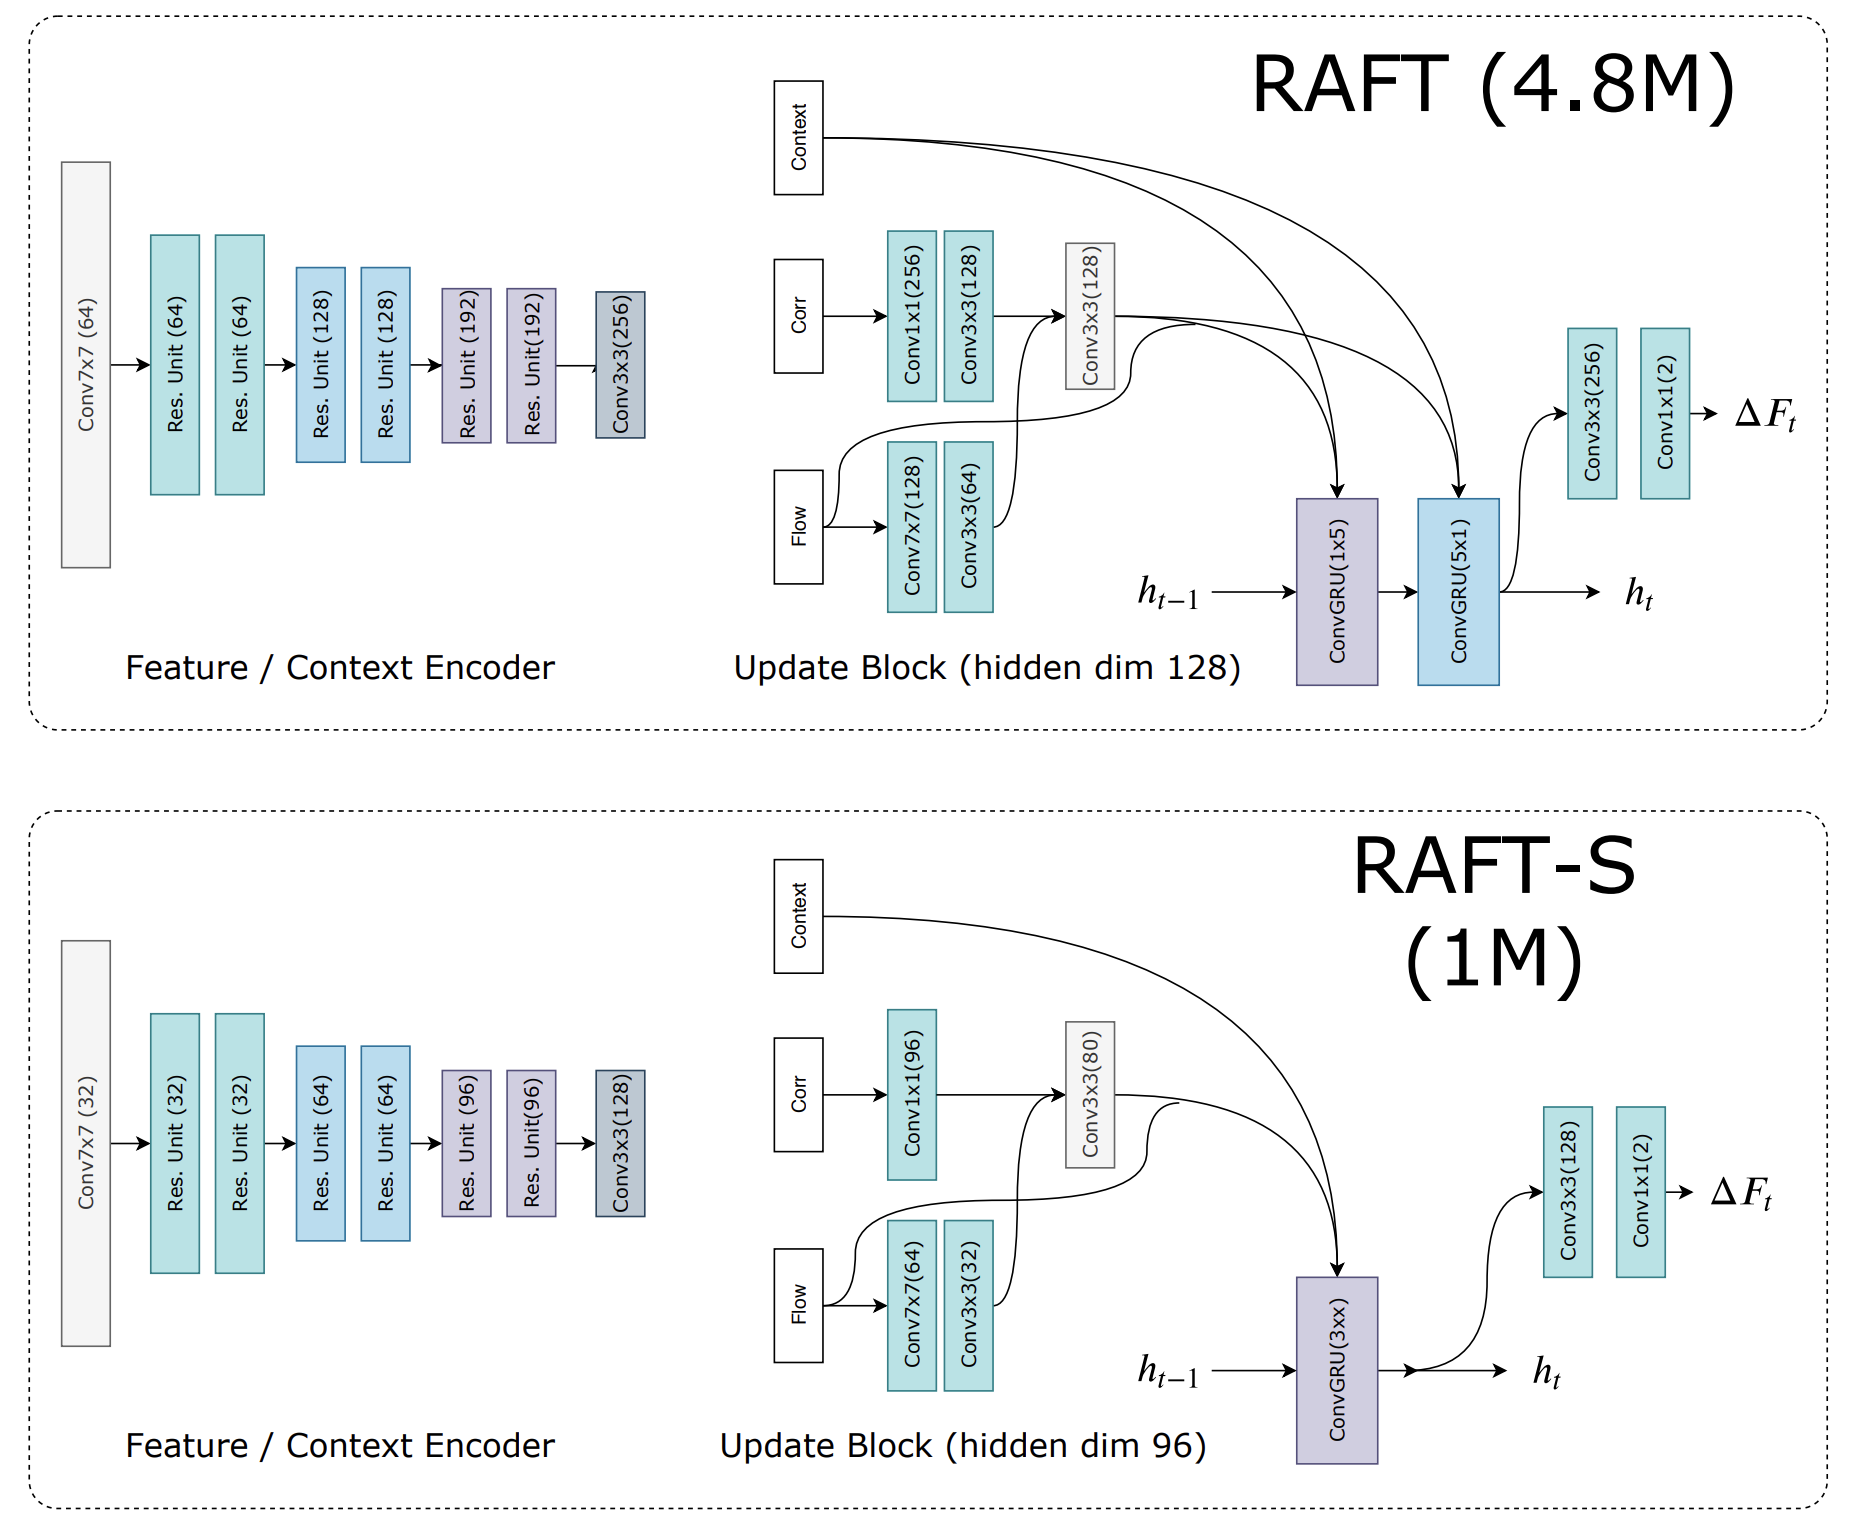
A continuación se muestra una visualización del framework RAFT elaborada por el autor.
El objeto de nivel superior
En el artículo anterior concluimos la implementación de los componentes clave del framework RAFT. Ha llegado el momento de pasar a la fase final: integrar todo en una estructura única y coherente, en la que cada componente no solo cumpla su función, sino que interactúe con los demás, formando un mecanismo integral. No obstante, antes de ponernos manos a la obra, conviene detenernos un momento para reflexionar sobre lo que ya hemos construido y qué cuestiones siguen sin resolverse.
La arquitectura original de RAFT se caracteriza por una elegante simetría. La misma arquitectura de codificador de características se usa para los dos flujos: el principal y el contextual. El codificador del flujo principal analiza un par de imágenes, extrae sus mapas de características y, a continuación, determina las correlaciones entre esos mapas. El codificador contextual trabaja únicamente con una imagen —la original—, creando una especie de base a partir de la cual se inicia la predicción. Precisamente esta división fundamental de funciones hace que la arquitectura RAFT sea tan robusta: un flujo se encarga de observar los cambios, mientras que el otro mantiene el punto de referencia.
Pero en el mundo de las finanzas todo es mucho más voluble. Si en la visión artificial los fotogramas captan una secuencia de acontecimientos con límites bien definidos, el mercado, por su parte, no conoce pausas. Este no espera a que el modelo tenga tiempo de tomar una instantánea, sino que fluye continuamente. Pasa de un estado a otro, como un río después de la lluvia, cambiando de cauce bajo la influencia de nuevas corrientes de información. Y aquí es donde la idea del contexto fijo empieza a fallar. No es posible congelar el estado del mercado para elaborar un pronóstico a partir de él. Lo que hace un minuto era relevante, dentro de una hora puede haber perdido todo su sentido.
Ya nos enfrentamos a un problema similar cuando hablamos del uso de un estado inicial fijo en las tareas de predicción de series temporales. Entonces, la solución surgió de forma natural: introdujimos una pila de estados históricos, lo cual permitió que el modelo no se basara en un único momento, sino en toda una secuencia, creando así una matriz dinámica de correlaciones. Este enfoque nos permitió ver el mercado no como una imagen fija, sino en movimiento, observando cómo el pasado interactúa con el presente.
Sin embargo, cuando se trabaja con el flujo contextual, la situación se vuelve aún más interesante. El contexto no es simplemente información complementaria. Es la comprensión misma del régimen de mercado actual. Y los regímenes, como es sabido, son cambiantes. La volatilidad aumenta, la liquidez se desplaza y las correlaciones entre activos a veces se intensifican y otras desaparecen. Fijar el contexto en tales circunstancias equivale a condenar al modelo a la ceguera. Por otra parte, intentar hacer un seguimiento del contexto mediante una pila de historiales conlleva una complejidad excesiva y una disminución del rendimiento. Obtendríamos una estructura pesada que perdería la principal ventaja de RAFT: la rapidez y la eficiencia de las iteraciones.
Así pues, hay que buscar otra vía: más natural y más flexible. Un enfoque en el que el propio modelo es capaz de comprender cómo cambia el contexto y actualizarlo sin intervención externa. La idea es sencilla, pero profunda: complementar el codificador contextual con un bloque recurrente que supervise el estado del mercado en tiempo real. Este bloque podrá recordar los cambios recientes, detectar patrones recurrentes y ajustar el contexto a medida que se reciban nuevos datos.
Esta solución, en esencia, hace que el modelo se ajuste automáticamente. El contexto deja de ser un parámetro externo: se convierte en un estado interno del sistema, que vive y respira al unísono con el mercado. El modelo adquiere la capacidad no solo de reaccionar ante los datos de entrada, sino también de adaptarse, es decir, de reestructurar de forma reflexiva su percepción de lo que está ocurriendo.
Por así decirlo, el bloque recurrente es el equivalente a la memoria a corto plazo de un analista: recuerda lo que ha ocurrido recientemente, pero no está sobrecargado con toda la historia. Se centra en la información actual, lo que permite que la previsión siga siendo precisa incluso cuando la dinámica cambia rápidamente.
Esto supone un importante paso adelante. Estamos pasando de la construcción mecánica de la arquitectura a la modelización reflexiva del comportamiento adaptativo. Y es que, en el trading, lo importante no es solo predecir el movimiento, sino comprender por qué cambia y saber adaptarse al nuevo régimen de mercado. El codificador contextual recurrente permitirá que el framework RAFT se acerque a este objetivo.
Las ideas propuestas las plasmamos en el objeto CNeuronRAFT, que se convierte en el elemento central de nuestra implementación. Precisamente aquí todos los componentes clave del framework —los codificadores, el bloque de correlación, el mecanismo recurrente y las conexiones residuales— convergen en una estructura única, formando el núcleo dinámico del modelo.
class CNeuronRAFT :  public CNeuronSpikeActivation
  {
protected:
   CLayer                              cEncoder;
   CLayer                              cContext;
   CLayer                              cCorrelation;
   CNeuronBaseOCL                      cConcatenated;
   CNeuronSpikeConvGRU2D               cGRU;
   CNeuronSpikeResNeXtResidual         cResidual;
   CLayer                              cG;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronRAFT(void) {};
                    ~CNeuronRAFT(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint &units[], uint &chanels[], uint group_size,
                          uint groups, uint stack_size, uint levels,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronRAFT;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
  };
La estructura que se presenta no es simplemente un conjunto de objetos. Se trata de un ecosistema arquitectónico en el que cada componente desempeña un papel en la dinámica general.
cEncoder se encarga de la extracción inicial de características a partir de los datos originales. Se trata de un equivalente al codificador visual del RAFT original, adaptado a las series temporales financieras. Convierte el flujo de precios y los valores de los indicadores en una representación multidimensional compacta, en la que cada coordenada no es un número, sino un componente semántico del movimiento del mercado.
cContext genera un flujo contextual. Su arquitectura se complementa con un módulo recurrente diseñado para seguir la evolución del estado del mercado a lo largo del tiempo. Gracias a él, el contexto deja de ser estático, cobra vida al reaccionar ante nuevos acontecimientos y se adapta gradualmente al mercado, lo que permite al modelo mantener una memoria a corto plazo de la dinámica.
A continuación viene cCorrelation, en el que se construye una matriz de relaciones recíprocas entre las características. Ese mismo campo de interacciones en el que se basa toda la filosofía de RAFT. Aquí se comparan las características del estado actual con la pila de datos históricos acumulados en períodos anteriores. Luego se construye un campo de correlación, la base que permite a RAFT detectar los desplazamientos locales y la dinámica global de los procesos.
El componente cConcatenated combina los resultados del codificador y del módulo de correlación con el contexto actualizado, preparándolos para su envío al bloque recurrente cGRU. Este módulo se encarga del refinamiento iterativo de la previsión. Evalúa la diferencia entre los estados anteriores y los actuales, realiza ajustes y, de este modo, acerca el modelo a una solución más precisa.
El módulo cResidual actúa como elemento estabilizador. No transmite el gradiente, como ocurre en las redes residuales clásicas, sino que garantiza la coherencia entre las iteraciones y evita la deriva de las características tras múltiples actualizaciones. En este punto, es importante comprender la diferencia fundamental entre RAFT y los modelos de predicción tradicionales. El algoritmo no predice el nuevo estado directamente, sino que genera un delta de características: un refinamiento que describe la variación del estado actual. Al sumar este delta predictivo a los datos iniciales, obtenemos el resultado deseado.
Los autores del framework RAFT han decidido deliberadamente no propagar el gradiente del error a través de las conexiones residuales. El estado inicial se considera un hecho consumado y no está sujeto a ajustes. La optimización se aplica únicamente a los flujos que se actualizan, a través de bloques de correlación y recurrentes. Este enfoque hace que el entrenamiento sea estable, evita la distorsión inversa de los datos de entrada y permite que el modelo se centre en la propia dinámica de los cambios.
El componente cG es el bloque final del procesamiento de datos, que genera el mapa final de valores previstos. Aquí convergen todas las trayectorias del modelo, y el resultado de cada iteración se convierte en la entrada para el siguiente paso de refinamiento.
La inicialización de todos los componentes internos del nuevo objeto se realiza en el método Init. Esta etapa se puede comparar con el momento en que una orquesta se reúne antes de una actuación: cada instrumento debe estar afinado y el director, listo para marcar el ritmo. Es precisamente aquí donde se crea y se coordina todo el conjunto de bloques neuronales, de los que posteriormente surge la dinámica coordinada del modelo.
bool CNeuronRAFT::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint &units[], uint &chanels[], uint group_size,
                       uint groups, uint stack_size, uint levels,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(units.Size() != chanels.Size())
      return false;
   uint layers = units.Size() - 1;
   if(!CNeuronSpikeActivation::Init(numOutputs, myIndex, open_cl,
                units[layers]*chanels[layers], optimization_type, batch))
      return false;
El procedimiento comienza con la comprobación de que los parámetros recibidos sean correctos y la llamada a la inicialización de la clase padre. A continuación, se crean todos los componentes fundamentales del framework: los codificadores, el módulo de correlación, el nodo recurrente y el bloque estabilizador de conexiones residuales.
La estructura de doble flujo —cEncoder y cContext— se crea en primer lugar. En un bucle se crean capas CNeuronSpikeResNeXtBlock, encargadas de la extracción secuencial de características.
   int index = 0;
   CNeuronSpikeResNeXtBlock*           resblock = NULL;
   CNeuronSpikeConvGRU2D*              gru = NULL;
   CNeuronMultiScaleStackCorrelation*  correlation = NULL;
   CNeuronBaseOCL*                     neuron = NULL;
   CNeuronBatchNormOCL*                norm = NULL;
//---
   cEncoder.Clear();
   cContext.Clear();
   cCorrelation.Clear();
   cG.Clear();
   cEncoder.SetOpenCL(OpenCL);
   cContext.SetOpenCL(OpenCL);
   cCorrelation.SetOpenCL(OpenCL);
   cG.SetOpenCL(OpenCL);
//---
   for(uint i = 0; i < layers; i++)
     {
      resblock = new CNeuronSpikeResNeXtBlock();
      if(!resblock ||
         !resblock.Init(0, index, OpenCL, chanels[i], chanels[i + 1], units[i], units[i + 1],
                                                 group_size, groups, optimization, iBatch) ||
         !cEncoder.Add(resblock))
        {
         DeleteObj(resblock)
         return false;
        }
      index++;
      resblock = new CNeuronSpikeResNeXtBlock();
      if(!resblock ||
         !resblock.Init(0, index, OpenCL, chanels[i], chanels[i + 1], units[i], units[i + 1],
                                                 group_size, groups, optimization, iBatch) ||
         !cContext.Add(resblock))
        {
         DeleteObj(resblock)
         return false;
        }
      index++;
     }
El flujo cEncoder analiza las características del estado actual, mientras que cContext genera un espacio contextual adaptativo, que se complementa con el bloque recurrente CNeuronSpikeConvGRU2D. Este módulo GRU dota al framework de la capacidad de seguir la dinámica temporal y ajustar el contexto sin un estado fijo, una propiedad fundamental a la hora de trabajar con datos de mercado continuos.
   gru = new CNeuronSpikeConvGRU2D();
   if(!gru ||
      !gru.Init(0, index, OpenCL, units[layers], chanels[layers], chanels[layers], optimization, iBatch) ||
      !cContext.Add(gru))
     {
      DeleteObj(gru)
      return false;
     }
   index++;
Después se crea el módulo CNeuronMultiScaleStackCorrelation, que genera una matriz de correlaciones entre las características del estado actual y la pila de datos históricos. Este es el elemento central de la arquitectura, análogo a un campo de fuerzas computacional, en el que se manifiesta la interrelación entre el pasado y el presente.
   correlation = new CNeuronMultiScaleStackCorrelation();
   if(!correlation ||
      !correlation.Init(0, index, OpenCL, stack_size, chanels[layers], units[layers], levels,
                                                                     optimization, iBatch) ||
      !cCorrelation.Add(correlation))
     {
      DeleteObj(correlation)
      return false;
     }
   index++;
   resblock = new CNeuronSpikeResNeXtBlock();
   if(!resblock ||
      !resblock.Init(0, index, OpenCL, correlation.Neurons() / units[layers], chanels[layers],
                    units[layers], units[layers], group_size, groups, optimization, iBatch) ||
      !cCorrelation.Add(resblock))
     {
      DeleteObj(resblock)
      return false;
     }
   index++;
A la salida del bloque se añade una capa CNeuronSpikeResNeXtBlock, que refuerza la selectividad del modelo hacia las características más significativas.
Tras el bloque de generación del campo de correlación, se crea el nodo de unión cConcatenated, que combina los resultados de los tres flujos —características, contexto y correlaciones— en un único tensor.
   if(!cConcatenated.Init(0, index, OpenCL, 3 * chanels[layers]*units[layers], optimization, iBatch))
      return false;
   index++;
Luego los datos se transmiten a cGRU, donde se lleva a cabo un refinamiento iterativo del delta de predicción.
   if(!cGRU.Init(0, index, OpenCL, units[layers], 3 * chanels[layers], chanels[layers], optimization, iBatch))
      return false;
   index++;
A continuación, se inicializa el módulo estabilizador cResidual. Su objetivo es mantener la estructura del espacio de características en un estado estable durante múltiples iteraciones. A diferencia de las conexiones residuales clásicas, aquí no se produce una propagación inversa del gradiente: el estado base no se corrige, sino que se utiliza como punto de referencia al que se suma el delta de características calculado por el modelo.
   if(!cResidual.Init(0, index, OpenCL, chanels[0], chanels[layers], units[0], units[layers], optimization, iBatch))
      return false;
   index++;
El bloque final cG integra todo en un sistema coherente, normalizando el flujo de salida y preparándolo para su transmisión al siguiente nivel. Aquí también se crean los objetos auxiliares: la neurona básica y la capa de normalización CNeuronBatchNormOCL, encargada de estabilizar la distribución de salida.
   neuron = new CNeuronBaseOCL();
   if(!neuron ||
      !neuron.Init(0, index, OpenCL, Neurons(), optimization, iBatch) ||
      !cG.Add(neuron))
     {
      DeleteObj(neuron)
      return false;
     }
   neuron.SetActivationFunction(None);
   if(!neuron.SetGradient(cGRU.getGradient(), true) ||
      !cResidual.SetGradient(cGRU.getGradient(), true))
      return false;
//---
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, Neurons(), iBatch, optimization) ||
      !cG.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
//---
   return true;
  }
De esta forma, el método de inicialización establece una secuencia lógica de pasos de cálculo. Cada módulo tiene una función bien definida: la extracción de características, el establecimiento de correlaciones, el refinamiento recurrente del contexto y la generación del delta predictivo. Todos estos elementos se integran en una estructura única, preparada para el entrenamiento en condiciones reales de mercado.
El algoritmo de pasada directa se ha implementado en el método feedForward. No se trata simplemente de un ciclo de cálculo, sino de un proceso vivo. Aquí es donde el modelo cobra vida y empieza a sentir el mercado. Cada bloque desempeña su propio papel y, en conjunto, crean una imagen dinámica de los cambios futuros.
bool CNeuronRAFT::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cResidual.FeedForward(NeuronOCL))
      return false;
El proceso comienza con el bloque cResidual. Se puede considerar como una base sólida o un ancla. Registra el estado actual de las características, creando un punto de referencia para todos los cambios posteriores.
El siguiente paso es el flujo principal de características, cEncoder. Cada bloque ResNeXt es aquí como un investigador meticuloso que analiza el mercado capa por capa, identificando patrones y relaciones importantes. El resultado es una instantánea de la situación actual: completa y detallada, como si fuera un mapa panorámico del mercado en este preciso momento.
   CNeuronBaseOCL* current = NULL;
   CNeuronBaseOCL* prev = NeuronOCL;
   for(int i = 0; i < cEncoder.Total(); i++)
     {
      current = cEncoder[i];
      if(!current ||
         !current. Feedforward(prev))
         return false;
      prev = current;
     }
El flujo de contexto cContext funciona en paralelo. Si el codificador registra un momento, el contexto es el observador que recuerda el pasado y percibe las tendencias. Su bloque GRU recurrente analiza cómo ha evolucionado el mercado en los últimos pasos y adapta la previsión a dichos cambios. El contexto vive y respira al ritmo del mercado, lo que garantiza una adaptación continua del modelo.
   prev = NeuronOCL;
   for(int i = 0; i < cContext.Total(); i++)
     {
      current = cContext[i];
      if(!current ||
         !current. Feedforward(prev))
         return false;
      prev = current;
     }
A continuación, los resultados del codificador se transmiten al bloque cCorrelation. Aquí se añaden a la pila de historial de estados del mercado y se genera una matriz de correlaciones multiescala entre las características. Se puede imaginar como un mapa estratégico en el que cada punto muestra cómo los acontecimientos de ayer influyen en los de hoy. Precisamente aquí el modelo capta las regularidades ocultas y determina la fuerza y la dirección del movimiento.
   prev = cEncoder[-1];
   for(int i = 0; i < cCorrelation.Total(); i++)
     {
      current = cCorrelation[i];
      if(!current ||
         !current. Feedforward(prev))
         return false;
      prev = current;
     }
Los tres flujos —el codificador, el contexto y las correlaciones— se combinan en el nodo cConcatenated. Es como un cuartel general donde se recopila toda la información de inteligencia. Aquí, la señal se consolida antes de pasar a la fase de refinamiento.
   uint units = cGRU.GetUnits();
   if(!Concat(cEncoder[-1].getOutput(), cContext[-1].getOutput(), cCorrelation[-1].getOutput(),
              cConcatenated.getOutput(), cEncoder[-1].Neurons() / units, cContext[-1].Neurons() / units,
              cCorrelation[-1].Neurons() / units, units))
      return false;
El bloque recurrente cGRU actúa como comandante en esta etapa. Analiza la señal combinada y calcula el delta de características —el cambio previsto que se suma al estado inicial, dando lugar a la previsión final—.
   if(!cGRU.FeedForward(cConcatenated.AsObject()))
      return false;
//---
   current = cG[0];
   if(!current ||
      !SumAndNormilize(cGRU.getOutput(), cResidual.getOutput(), current.getOutput(),
                       cGRU.GetChanels(), false, 0, 0, 0, 1))
      return false;
A continuación, la señal llega al bloque cG, donde se realiza la suma con la salida de la conexión residual y la normalización. Puede compararse con el ajuste preciso de una balanza: todos los flujos se sincronizan y se eliminan los sesgos y el ruido, lo que garantiza la estabilidad de la previsión. El recorrido secuencial de todas las capas de cG culmina el proceso de generación de resultados, que ahora reflejan no un estado estático, sino una imagen del mercado refinada dinámicamente.
   prev = current;
   for(int i = 1; i < cG.Total(); i++)
     {
      current = cG[i];
      if(!current ||
         !current. Feedforward(prev))
         return false;
      prev = current;
     }
//---
   return CNeuronSpikeActivation::feedforward(prev);
  }
En definitiva, feedForward convierte los datos analizados en una proyección viva de los cambios, en la que cada bloque funciona como un analista independiente. Pero juntos forman un equipo capaz de detectar tendencias, anticipar movimientos y adaptarse a un entorno de mercado cambiante. El modelo no intenta predecir el futuro de forma directa: calcula el delta y, paso a paso, refina la imagen del mercado, lo que permite que la previsión sea realista y estable.
Una vez elaborada la predicción, llega la siguiente etapa clave: la distribución del gradiente de error. Esta etapa se ha implementado en el método calcInputGradients. Si la pasada directa se puede comparar con una orquesta que interpreta una obra, la retropropagación es como un director de orquesta que evalúa cada instrumento y corrige su sonido para que todo el conjunto toque con precisión.
bool CNeuronRAFT::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronSpikeActivation::calcInputGradients(cG[-1]))
      return false;
El método comienza comprobando la validez del puntero al objeto de datos de origen NeuronOCL. Sin él, el modelo no podrá distribuir correctamente los gradientes y todo el proceso se detendrá, como si una orquesta se quedara sin partitura.
A continuación, se invoca el método homónimo de la clase padre, que establece el punto inicial de la retropropagación. Se podría decir que este es el primer golpe del metrónomo: los gradientes comienzan a fluir a lo largo de la cadena de componentes cG, desde el último hasta el primero.
   CNeuronBaseOCL* current = NULL;
   CNeuronBaseOCL* next = cG[-1];
   for(int i = cG.Total() - 2; i >= 0; i--)
     {
      current = cG[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
      next = current;
     }
El ciclo recorre los elementos del módulo cG en orden inverso. Cada capa recibe la señal de la siguiente, distribuyendo el error de forma precisa. Este proceso se asemeja a los pasos que sigue un analista experimentado al evaluar cada nivel del modelo, comparando la previsión con los resultados reales.
Tras las capas de cG, el gradiente se transmite al bloque cResidual. Aquí, el error se distribuye con respecto al estado inicial, que se mantiene como un hecho inmutable. Este es un punto clave: las características básicas no se modifican, sino que sirven de base para calcular los ajustes.
   if(!NeuronOCL.CalcHiddenGradients(cResidual.AsObject()))
      return false;
A continuación, los gradientes pasan al nodo de concatenación cConcatenated. A partir de aquí se dividen en tres flujos: cEncoder, cContext y cCorrelation. Este paso puede compararse con un equipo que distribuye las tareas entre tres analistas: a cada uno se le asigna una parte de los datos para que la procese.
   if(!cConcatenated.CalcHiddenGradients(cGRU.AsObject()))
      return false;
   uint units = cGRU.GetChanels();
   if(!DeConcat(cEncoder[-1].getGradient(), cContext[-1].getGradient(), cCorrelation[-1].getGradient(),
                cConcatenated.getGradient(), cEncoder[-1].Neurons() / units, cContext[-1].Neurons() / units,
                cCorrelation[-1].Neurons() / units, units))
      return false;
El siguiente bloque es cCorrelation. El ciclo recorre las capas en orden inverso; cada capa ajusta su gradiente en función de la señal de la siguiente. En esta parte, el modelo analiza cómo la interacción entre las características actuales y las históricas ha influido en la previsión final.
   next = cCorrelation[-1];
   for(int i = cCorrelation.Total() - 2; i >= 0; i--)
     {
      current = cCorrelation[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
      next = current;
     }
Luego el gradiente se envía al codificador cEncoder. Aquí hay un detalle interesante. El codificador recibe los gradientes de error a través de dos flujos de información. Anteriormente ya había recibido parte de la información durante la desconcatenación de los gradientes de error del bloque recurrente y, para no perder los valores ya almacenados, la última capa del codificador guarda temporalmente un puntero al búfer de gradientes en una variable local (temp), y su lugar lo ocupa un búfer libre. A continuación, calculamos los gradientes a lo largo de la ruta principal del módulo de correlación y los sumamos a los valores guardados.
   current = cEncoder[-1];
   if(!current)
      return false;
   CBufferFloat* temp = current.getGradient();
   if(!current.SetGradient(current.getPrevOutput(), false) ||
      !current.CalcHiddenGradients(next) ||
      !SumAndNormilize(temp, current.getGradient(), temp, temp.Total() / units, false, 0, 0, 0, 1) ||
      !current.SetGradient(temp, false))
      return false;
Después devolvemos los punteros a los búferes a su estado inicial y los gradientes pasan por todas las demás capas del codificador.
   next = current;
   for(int i = cEncoder.Total() - 2; i >= 0; i--)
     {
      current = cEncoder[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
      next = current;
     }
   if(!NeuronOCL.CalcHiddenGradients(next))
      return false;
Tras procesar el codificador, pasamos al flujo contextual cContext. El ciclo recorre los componentes en orden inverso.
   next = cContext[-1];
   for(int i = cContext.Total() - 2; i >= 0; i--)
     {
      current = cContext[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
      next = current;
     }
La operación final consiste en transferir los gradientes al nivel del objeto de datos de origen NeuronOCL, donde también se suman cuidadosamente los gradientes procedentes de los dos flujos de información.
   temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false) ||
      !NeuronOCL.CalcHiddenGradients(next) ||
      !SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
Como resultado, el método calcInputGradients distribuye con precisión el error por toda la arquitectura del objeto —desde el nivel de resultados hasta el codificador, el contexto y las correlaciones—, ajustando únicamente las partes que se entrenan. Cada bloque cumple una función: los codificadores analizan las características locales, el contexto tiene en cuenta el historial, las correlaciones registran las relaciones entre los elementos y los bloques residuales garantizan la estabilidad de toda la estructura. Este enfoque garantiza que el entrenamiento se lleve a cabo de forma eficaz y sin distorsionar los estados iniciales, conservando la dinámica activa del modelo que observamos en la pasada directa.
La última etapa es la optimización de parámetros: es precisamente aquí donde el modelo ajusta sus pesos internos para que la predicción sea más precisa. El algoritmo se ha implementado en el método updateInputWeights, que se podría comparar con la puesta a punto de todos los instrumentos tras un ensayo.
bool CNeuronRAFT::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cResidual.UpdateInputWeights(NeuronOCL))
      return false;
El proceso comienza con la optimización del bloque residual cResidual. Ajusta sus parámetros, manteniendo un punto de referencia estable para toda la arquitectura.
A continuación, los coeficientes de ponderación se ajustan en el flujo principal del codificador cEncoder. Cada capa recibe sucesivamente la señal del bloque anterior y actualiza sus parámetros. Se puede imaginar como un equipo de investigadores que, tras recibir retroalimentación, perfeccionan sus herramientas, mejorando así la calidad de la extracción de características en la siguiente pasada.
   CNeuronBaseOCL* current = NULL;
   CNeuronBaseOCL* prev = NeuronOCL;
   for(int i = 0; i < cEncoder.Total(); i++)
     {
      current = cEncoder[i];
      if(!current ||
         !current.UpdateInputWeights(prev))
         return false;
      prev = current;
     }
El flujo contextual cContext se actualiza de forma similar. En este caso, la red recurrente GRU utiliza los gradientes acumulados para ajustar los pesos, teniendo en cuenta la dinámica temporal. Cada capa de contexto ajusta la influencia de los estados anteriores en las predicciones actuales, lo que permite que el modelo reaccione con mayor flexibilidad ante la variabilidad del mercado.
   prev = NeuronOCL;
   for(int i = 0; i < cContext.Total(); i++)
     {
      current = cContext[i];
      if(!current ||
         !current.UpdateInputWeights(prev))
         return false;
      prev = current;
     }
En el siguiente paso, la optimización continúa en el bloque de correlaciones cCorrelation. Cada capa ajusta sus parámetros en función de las señales, mejorando la precisión de la matriz de interacciones entre las características actuales y las históricas. De este modo, el modelo aprende a identificar las relaciones más significativas y a tener en cuenta con mayor precisión las tendencias pasadas.
   prev = cEncoder[-1];
   for(int i = 0; i < cCorrelation.Total(); i++)
     {
      current = cCorrelation[i];
      if(!current ||
         !current.UpdateInputWeights(prev))
         return false;
      prev = current;
     }
El nodo recurrente cGRU también actualiza sus pesos basándose en el tensor concatenado cConcatenated. Aquí se produce un refinamiento clave: los parámetros de la GRU se ajustan de tal forma que el delta de características calculado refleje con la mayor precisión posible los cambios en el estado actual.
   if(!cGRU.UpdateInputWeights(cConcatenated.AsObject()))
      return false;
Por último, el bloque cG realiza una actualización secuencial de todas las capas, sumando el efecto de las correlaciones, el contexto y el flujo directo de características, y normaliza la señal de salida. Esta etapa final garantiza que todos los componentes del modelo estén sincronizados y listos para la siguiente pasada directa.
   prev = cG[0];
   for(int i = 1; i < cG.Total(); i++)
     {
      current = cG[i];
      if(!current ||
         !current.UpdateInputWeights(prev))
         return false;
      prev = current;
     }
//---
   return CNeuronSpikeActivation::updateInputWeights(prev);
  }
Para finalizar, se invoca el método homónimo de la clase padre, que cierra correctamente el ciclo de optimización. Como resultado, se han actualizado los pesos de todos los componentes y el modelo está listo para el siguiente paso del entrenamiento o para realizar predicciones con nuevos datos.
En el archivo adjunto se incluye el código fuente completo del objeto, con una implementación detallada de todos sus métodos, que muestra el funcionamiento interno de RAFT.
Arquitectura de modelos
Hemos finalizado el desarrollo de los componentes clave del framework RAFT y ahora pasamos a diseñar la arquitectura de los modelos que vamos a entrenar. Al igual que antes, nuestro objetivo es crear un sistema de negociación capaz de diseñar estrategias y realizar operaciones de trading en el mercado de forma autónoma.
Para el entrenamiento de los modelos, utilizamos enfoques de tipo actor-crítico, integrando las capacidades de RAFT directamente en el codificador del estado del entorno. Este enfoque permite que el modelo no se limite a reaccionar ante las características actuales, sino que tenga en cuenta su dinámica y sus interrelaciones, identificadas por el framework. Al mismo tiempo, utilizamos el módulo STFS para seleccionar las características más relevantes, lo que permite que el modelo se centre en aquellos aspectos que realmente influyen en el resultado.
Es precisamente aquí donde se aprecia el primer efecto tangible de la implementación de los enfoques de RAFT en un objeto de alto nivel. Para integrarlo en las soluciones arquitectónicas existentes, basta con conectar el nuevo objeto, y el modelo queda listo para el entrenamiento prácticamente sin necesidad de modificaciones adicionales.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRAFT;
     {
      uint temp[] = {prev_out,            // Chanels In
                     32,
                     64,
                     128            // Chanels Out
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,          // Units In
                     128,
                     64,
                     32          // Units Out
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.window = EmbeddingSize / 2;         // Group size
   descr.step = NHeads;                      // Groups
   descr.count = StackSize;                  // Stack size
   descr.layers = 4;                         // Correlation's Levels
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
//---
   uint window = descr.windows[descr.windows.Size()-1];
   uint count = descr.units[descr.units.Size()-1];
Todos los demás componentes de la arquitectura permanecen inalterados, lo que simplifica considerablemente el proceso y agiliza la transición del desarrollo a las pruebas.
El resultado es un sistema modular, flexible y capaz de aprender, en el que RAFT actúa como núcleo central para el análisis de características y la predicción de la dinámica del mercado, mientras que el resto de elementos de la arquitectura siguen desempeñando sus funciones habituales, garantizando la estabilidad y la previsibilidad del funcionamiento del modelo.
En el archivo adjunto se incluye una descripción completa de la arquitectura de los modelos que se van a entrenar.
Pruebas
Una vez definida la arquitectura del modelo que se va a entrenar e integrado el framework RAFT en el codificador de estado, comienza la fase de entrenamiento y pruebas. Aquí comprobamos hasta qué punto nuestro sistema es capaz de adaptarse a las condiciones reales del mercado y de diseñar una estrategia por sí mismo.
La primera fase del entrenamiento del modelo puede compararse con el ensayo de un principiante en el escenario histórico del mercado. Utilizamos los datos del par de divisas EURUSD con un marco temporal de H1, correspondientes al periodo comprendido entre enero de 2024 y junio de 2025. Durante este intervalo de tiempo, el modelo obtiene un historial del mercado y aprende a reconocer patrones: la dinámica de los precios, los volúmenes de las operaciones y las relaciones ocultas entre las características clave. RAFT actúa aquí como un mentor experimentado: crea un estado informativo para el Actor y el Crítico, ayuda al modelo a desarrollar su propia intuición como operador y a acumular gradualmente experiencia estratégica, lo que le permite predecir el comportamiento del mercado y evaluar el riesgo de cada operación potencial.
La siguiente etapa es el ajuste en línea en el probador de estrategias de MetaTrader 5. Trasladamos el entrenamiento a un entorno dinámico, casi real. El modelo procesa los datos vela a vela, reaccionando a cada movimiento del precio. RAFT le permite mantener la estabilidad ante las fluctuaciones debidas al ruido, adaptarse a los movimientos bruscos y ajustar su comportamiento en situaciones de baja liquidez. La estructura básica, basada en datos históricos, sigue siendo el pilar fundamental, pero el modelo aprende a reaccionar con flexibilidad ante la situación actual del mercado, evitando el sobreajuste y mejorando la precisión de las previsiones incluso en un entorno inestable.
La fase final, la de pruebas, se lleva a cabo con datos totalmente nuevos correspondientes al periodo comprendido entre julio y septiembre de 2025. Todos los parámetros obtenidos en las etapas anteriores se cargan sin modificaciones, lo que garantiza una evaluación imparcial de la capacidad de generalización del modelo. A continuación se presentan los resultados de las pruebas.
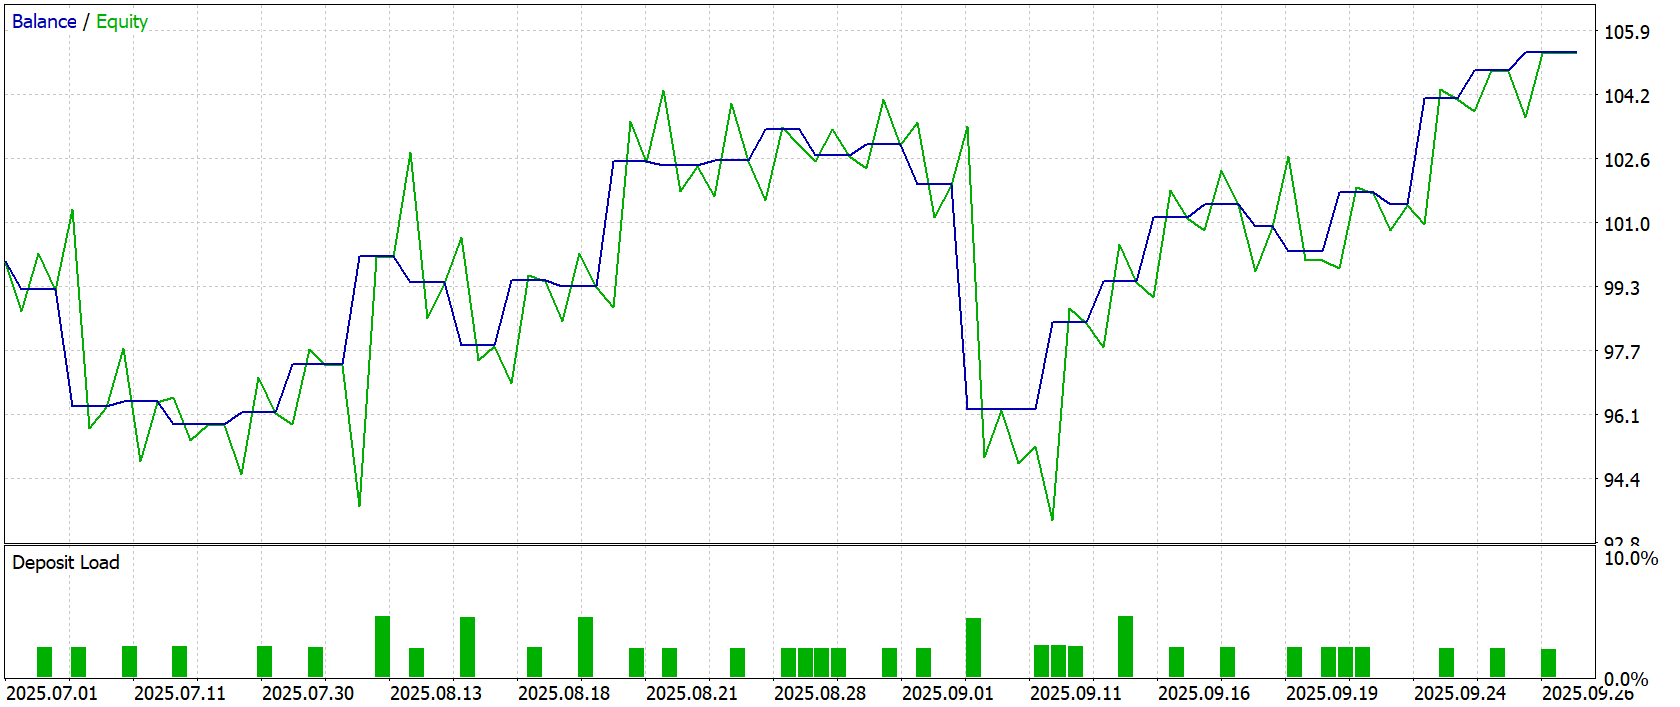
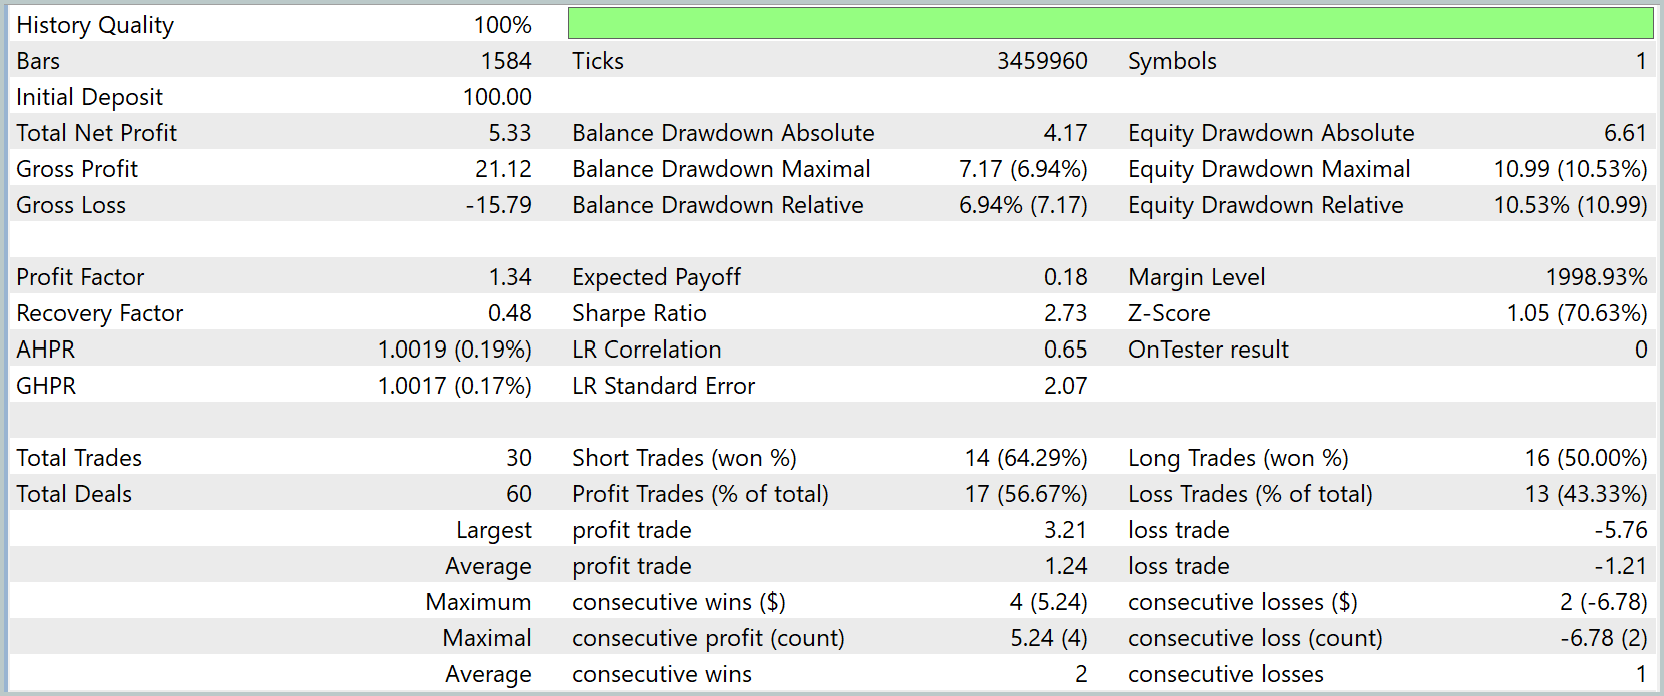
Los resultados de las pruebas demuestran la estabilidad y la adaptabilidad del modelo, desarrollado utilizando el framework RAFT. En el gráfico de Balance/Equity se aprecia que el modelo mantiene con éxito una evolución positiva del capital, a pesar de las fluctuaciones periódicas del mercado. Ambos indicadores evolucionan de forma coordinada, lo que pone de manifiesto el funcionamiento equilibrado del modelo y una gestión adecuada del riesgo.
En la fase de pruebas, con un depósito inicial de 100,0 USD, el modelo generó un beneficio neto de 5,33 USD, mientras que la reducción máxima del saldo fue del 7,17 % y la del capital propio, del 10,53 %, lo que pone de manifiesto una estrategia prudente y conservadora y un riesgo bajo en relación con el volumen de capital. El coeficiente global de ganancias/pérdidas (Profit Factor) es de 1,34, lo que confirma una relación positiva entre las ganancias obtenidas y las pérdidas sufridas.
El análisis de las operaciones de trading muestra que, de las 30 operaciones realizadas, 17 resultaron rentables (56,67 %), si bien las posiciones cortas obtuvieron mejores resultados, con un 64,29 % de operaciones rentables, mientras que las largas registraron un 50,0 %. El beneficio medio por operación asciende a 1,24 USD, y la pérdida media, a 1,21 USD. Esto pone de manifiesto el carácter equilibrado de la estrategia. La ganancia máxima en una racha de operaciones ganadoras alcanzó los 5,24 USD en 4 operaciones, mientras que la pérdida máxima en una racha de operaciones perdedoras fue de 6,78 USD en 2 operaciones.
En general, el modelo muestra una dinámica positiva y estable del capital, capacidad para reaccionar con flexibilidad ante los cambios en la coyuntura del mercado y una gestión eficaz de los riesgos. RAFT, integrado en el Codificador de estado, ofrece una representación informativa de las características del mercado y permite al sistema tomar decisiones fundamentadas incluso en condiciones de inestabilidad del mercado. Sin embargo, antes de utilizar el modelo en los mercados reales, es necesario llevar a cabo una serie adicional de pruebas exhaustivas de la estrategia utilizando una muestra más representativa.
Conclusión
El framework RAFT ha demostrado ser una potente herramienta para el análisis y la predicción de series temporales financieras. Su arquitectura flexible y optimizada garantiza una precisión adecuada en las previsiones, un funcionamiento estable y una fácil escalabilidad para nuevas tareas. RAFT integra los componentes clave en un único sistema, lo que agiliza el procesamiento de datos, reduce el riesgo de errores y facilita la creación de estrategias de negociación eficaces. Estas ventajas lo convierten en una herramienta indispensable para los operadores e investigadores que buscan soluciones fiables y rápidas.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor de entrenamiento offline para modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor de entrenamiento en línea para modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/20153
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.



