Von den Grundlagen zur Mittelstufe: Warteschlangen, Listen und Bäume (III)
 11
 0

Einleitung
Im vorherigen Artikel „Von den Grundlagen bis zur Mittelstufe: Warteschlangen, Listen und Bäume (II)“ haben wir erläutert, was als Ausgangspunkt für die Erstellung einer verketteten Liste diente. Die im vorherigen Artikel dargestellten Informationen waren jedoch nicht vollständig. Wir müssen noch etwas umsetzen, das verkettete Listen sowohl aus praktischer als auch aus theoretischer Sicht wirklich interessant macht.
Anders als bei der Erklärung von verketteten Listen im Rahmen eines akademischen Studiums werden wir uns hier auf die praktischen Aspekte ihrer Umsetzung und Anwendung konzentrieren. Um den Inhalt dieses Artikels vollständig zu verstehen, müssen Sie sich gründlich mit den im vorherigen Artikel behandelten Themen auseinandersetzen. Außerdem sollten Sie natürlich über fundierte Kenntnisse der grundlegenden Prinzipien und Konzepte verfügen, die den Arrays zugrunde liegen. Das ist wichtig, weil viele Anfänger das, worüber wir hier sprechen, oft mit einer speziellen Art der Array-Implementierung verwechseln. Das gilt besonders dann, wenn wir anfangen, eine weitere in MQL5 verfügbare Ressource zu nutzen, die ich bisher noch nicht erwähnt habe und auf die ich erst ein anderes Mal eingehen werde.
Da dieses Thema für das Verständnis von Listen und ihrer Verwendung besonders wichtig ist und größtmögliche Klarheit erfordert, wollen wir es nicht weiter verkomplizieren und kommen nun zum Hauptteil dieses Artikels.
Warteschlangen, Listen und Bäume (III)
Lassen Sie uns zunächst kurz noch einmal zusammenfassen, was wir im vorherigen Artikel behandelt haben. Es ist sehr wichtig, dass Sie sich den dort behandelten Stoff genau einprägen, damit Sie unsere nächsten Schritte nachvollziehen können. Nehmen wir also den endgültigen Code aus dem vorherigen Artikel. Der Code ist unten aufgeführt:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> class stList
05. {
06.     private:
07. //+----------------+
08.         T info;
09.         stList <T> *prev;
10. //+----------------+
11.     public:
12. //+----------------+
13.         stList(void)
14.             :prev(NULL)
15.         {}
16. //+----------------+
17.         void Push(T arg)
18.         {
19.             stList <T> *loc;
20.
21.             loc = new stList <T>;
22.             (*loc).info = arg;
23.             (*loc).prev = prev;
24.             prev = loc;
25.         }
26. //+----------------+
27.         bool Pop(T &arg)
28.         {
29.             stList <T> *loc;
30.
31.             if (prev == NULL)
32.                 return false;
33.
34.             loc = prev;
35.             arg = (*loc).info;
36.             prev = (*loc).prev;
37.
38.             delete loc;
39.
40.             return true;
41.         }
42. //+----------------+
43. };
44. //+------------------------------------------------------------------+
45. void OnStart(void)
46. {
47.     stList <char> list;
48.
49.     list.Push(10);
50.     list.Push(84);
51.     list.Push(-6);
52.
53.     for (char info; list.Pop(info);)
54.         Print(info);
55. };
56. //+------------------------------------------------------------------+
Code 01
Dieser Code 01 dient dazu, das Äquivalent eines Stapels zu erstellen, also einer Art von Warteschlange, bei der die zuletzt hinzugefügten Werte zuerst abgerufen werden. Im Gegensatz zur Warteschlangen-Implementierung verwendet dieser Code 01 jedoch kein internes Array mehr. Gerade dieses kleine Detail ist ausschlaggebend für eine andere Einstufung dieser Umsetzung. Daher wird Code 01 als VERKETTETE LISTE klassifiziert. Dennoch kann sie noch nicht als verkettete Liste im eigentlichen Sinne betrachtet werden.
Das liegt daran, dass noch etwas fehlt, was eine verkettete Liste leisten kann, Code 01 jedoch noch nicht: das Hinzufügen oder Entfernen von Elementen an einer beliebigen Position innerhalb der Liste. Mit anderen Worten: Code, der eine verkettete Liste implementiert, würde es uns im Allgemeinen ermöglichen, so etwas wie ein dynamisches Array zu erstellen, ohne jedoch die Operationen verwenden zu müssen, die normalerweise bei der Arbeit mit Arrays erforderlich sind, da die Verarbeitung in vielen Situationen deutlich schneller sein kann als bei Array-basierten Implementierungen.
„Aber Moment mal. Lassen Sie mich kurz prüfen, ob ich das Gelesene richtig verstanden habe. Meinen Sie damit, dass der Zweck einer verketteten Liste darin besteht, etwas Array-Ähnliches zu schaffen, ohne tatsächlich ein Array zu verwenden? Aber was soll das überhaupt?“ Um das zu verstehen, lieber Leser, müssen Sie zunächst etwas anderes verstehen. Ich gehe davon aus, dass Sie nur über minimale Programmierkenntnisse verfügen, das heißt, Sie wissen nicht wirklich, wie bestimmte Vorgänge im Prozessor ablaufen.
Die Funktion ArrayInsert aus der MQL5-Bibliothek dient dazu, neue Daten in ein bestehendes Array einzufügen. So weit, so gut. Diese Funktion weist jedoch eine Besonderheit auf: Wenn wir neue Daten am Ende eines bestehenden Arrays einfügen, werden diese Daten einfach in das Array kopiert. Im Grunde entspricht dies der Verwendung der Funktion ArrayCopy.
Wenn wir jedoch Elemente in der Mitte eines bestehenden Arrays oder am Anfang desselben Arrays hinzufügen möchten, läuft es anders ab. In diesem Fall reserviert die Funktion ArrayInsert einen neuen Speicherblock und kopiert anschließend einige Elemente in diesen neuen Block. Als Nächstes werden die einzufügenden Elemente diesem neuen Block hinzugefügt. Erst dann kopiert die Funktion den Rest des ursprünglichen Arrays in den reservierten Block. Daher kann die Ausführungszeit bei der Arbeit mit einem sehr großen Array recht lang sein. Angesichts der Eigenschaften moderner Hauptplatinen und des von ihnen verwendeten Datenbusses müssten die zu verschiebenden Blöcke jedoch ziemlich groß sein, damit Sie einen Unterschied bemerken würden. Oder zumindest müssen wir mehrere Einfügungen durchführen, damit die Verarbeitungszeit spürbar wird.
In den Anfängen der Computertechnik verlief die Datenverarbeitung jedoch wesentlich langsamer. Der Datenbus war langsam, und diese Speicherübertragungen dauerten selbst bei einer geringen Anzahl von Elementen sehr lange. Daher entwickelten Ingenieure und Wissenschaftler eine Lösung für dieses Problem. Und diese Lösung besteht genau darin, Listen zu verwenden. Kommen wir nun zurück zu Code 01. Sobald die Liste vollständig aufgebaut ist, ergibt sich im Speicher eine Struktur, die der folgenden Darstellung ähnelt:
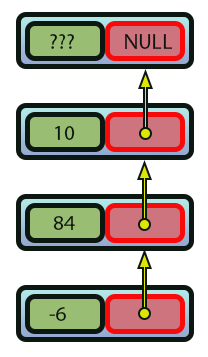
Abbildung 01
Die Methode, mit der wir zu dem in Abbildung 01 gezeigten Ergebnis gelangt sind, wurde bereits im vorherigen Artikel erläutert. Hier wollen wir jedoch noch einen Schritt weiter gehen: Wir werden die verkettete Liste wirklich funktionsfähig machen. Damit die von uns implementierten Operationen wirklich verständlich sind, wollen wir zunächst klären, wie man dasselbe mit einem Array umsetzen würde. Infolgedessen wird Abbildung 01 ähnlich wie Abbildung 02 aussehen:
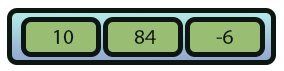
Abbildung 02
Nehmen wir nun an, wir möchten dem in Abbildung 02 gezeigten Array ein neues Element hinzufügen, wie in Abbildung 03 dargestellt:
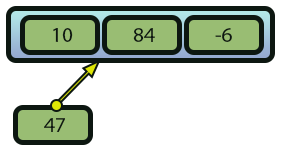
Abbildung 03
Wie lässt sich das ohne die Funktion „ArrayInsert“ bewerkstelligen? Also gut, wenn Sie die Erklärung weiter oben in diesem Artikel verstanden haben, müssen Sie als Erstes einen neuen Speicherblock reservieren. Das Ergebnis ist das unten gezeigte Bild:
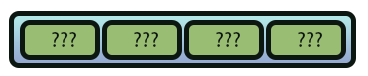
Abbildung 04
Bitte beachten Sie, dass wir noch nichts in diesen neuen Block kopiert haben. Wir haben einfach Speicher dafür reserviert. Der nächste Schritt besteht darin, die Elemente zu kopieren, die vor der Stelle liegen, an der das neue Element eingefügt werden soll. Nehmen wir an, das neue Element wird an der Position mit Index 1 eingefügt. In diesem Fall führt der erste Kopiervorgang zu dem unten dargestellten Zustand:
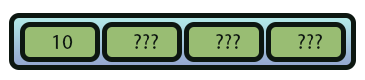
Abbildung 05
Jetzt können wir ein neues Element in das Array einfügen. Daraus ergibt sich Folgendes:
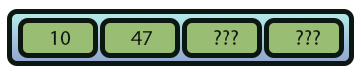
Abbildung 06
Sobald das neue Element in das endgültige Array eingefügt wurde, können wir die übrigen Elemente aus dem ursprünglichen Array kopieren. Das Endergebnis ist somit in Abbildung 07 dargestellt:
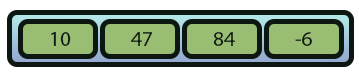
Abbildung 07
Beachten Sie, dass sich dieses schrittweise Vorgehen selbst von Programmieranfängern sehr einfach umsetzen lässt. Etwas sehr Ähnliches passiert, wenn Sie ein Element aus einem Array entfernen müssen. In diesem Fall müssen Sie die hier gezeigten Schritte jedoch in umgekehrter Reihenfolge ausführen. Zunächst reservieren wir einen Speicherblock für weniger Elemente, kopieren die Elemente, die erhalten bleiben sollen, überspringen die zu löschenden Elemente und kopieren schließlich die restlichen Elemente in das Array.
Aber kommen wir zurück zum Thema Verarbeitungszeit. Stellen Sie sich vor, Sie würden dies mit einem Array tun, das Tausende von Elementen enthält, und Sie müssten Tausende weiterer Elemente an nicht aufeinanderfolgenden Positionen einfügen oder löschen – das heißt, Sie würden beispielsweise ein Element an Position zwei einfügen, das nächste an Position vier und so weiter. In diesem Fall müssen die in den vorherigen Abbildungen dargestellten Schritte tausende Male wiederholt werden, wodurch erhebliche Datenmengen verschoben werden. Dies führt letztendlich dazu, dass selbst bei einem modernen Datenbus viel CPU-Zeit verbraucht wird. Genau hier kommt jedoch der Zauber der verketteten Listen ins Spiel. Um dasselbe zu erreichen wie in den vorherigen Abbildungen, benötigen wir weitaus weniger Schritte, wie unten gezeigt:
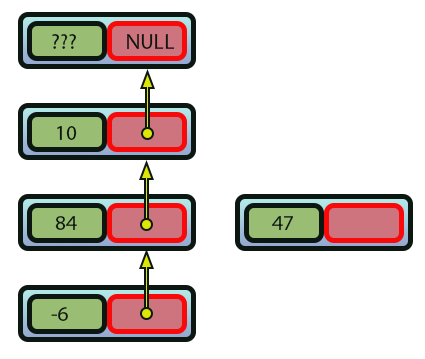
Abbildung 08
Beachten Sie, dass Abbildung 08 der Abbildung 01 sehr ähnlich ist. An dieser Stelle müssen wir jedoch ein neues Element hinzufügen. Und dieses Element ist noch nicht Teil der verketteten Liste. In diesem Fall müssen wir, um dieses neue Element hinzuzufügen, lediglich angeben, wo es eingefügt werden soll. Die Implementierung selbst wandelt Abbildung 08 in die unten gezeigte Abbildung 09 um:
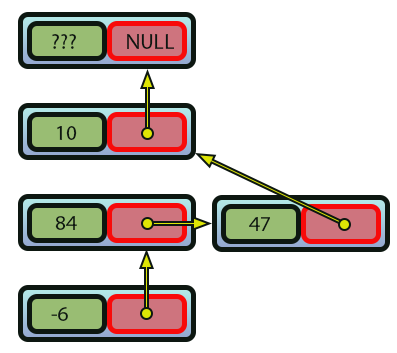
Abbildung 09
Beachten Sie, wie viel einfacher es geworden ist, ein neues Element hinzuzufügen. Außerdem ist es viel einfacher, ein Element zu entfernen. Es reicht aus, die Verknüpfung zu entfernen, die das Element mit der Liste verbindet, und die Zeiger zu aktualisieren, die die Struktur der Liste aufrechterhalten. So wird aus einem ehemals langsamen System nun ein wesentlich schnelleres, indem lediglich die Art und Weise geändert wird, wie die Implementierung ihre Operationen intern ausführt.
Da Sie nun die zugrunde liegende Idee verstanden haben, können wir uns ansehen, wie sie im Code umgesetzt wird. Und hier kommt der interessanteste Teil des Artikels.
Kommen wir noch einmal auf Code 01 zurück, den wir zu Beginn dieses Artikels gesehen haben. Nun werden wir diesen Code jedoch wie unten gezeigt anpassen:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> class stList
05. {
06.     private:
07. //+----------------+
08.         T info;
09.         stList <T>  *prev,
10.                     *start;
11. //+----------------+
12.     public:
13. //+----------------+
14.         stList(void)
15.             :prev(NULL),
16.             start(NULL)
17.         {}
18. //+----------------+
19.         void Store(T arg)
20.         {
21.             stList <T> *loc;
22.
23.             loc = new stList <T>;
24.             (*loc).info = arg;
25.             (*loc).prev = prev;
26.             prev = loc;
27.         }
28. //+----------------+
29.         bool Restore(T &arg)
30.         {
31.             stList <T> *loc;
32.
33.             if (prev == NULL)
34.                 return false;
35.
36.             loc = prev;
37.             arg = (*loc).info;
38.             prev = (*loc).prev;
39.
40.             delete loc;
41.
42.             return true;
43.         }
44. //+----------------+
45. };
46. //+------------------------------------------------------------------+
47. void OnStart(void)
48. {
49.     stList <char> list;
50.
51.     list.Store(10);
52.     list.Store(84);
53.     list.Store(-6);
54.
55.     for (char info; list.Restore(info);)
56.         Print(info);
57. };
58. //+------------------------------------------------------------------+
Code 02
Nun, lieber Leser, passen Sie bitte gut auf. In Code 02 beginnen wir mit der Implementierung einer Struktur, die im Wesentlichen eine einfach verkettete Liste ist. Sie können für die definierten Funktionen und Prozeduren beliebige Namen verwenden. Das spielt keine Rolle. Allerdings – und das ist sehr wichtig – müssen Sie die Implementierung des Codes sorgfältig planen, um sicherzustellen, dass die Liste korrekt erstellt und verwaltet wird. In der aktuellen Version von Code 02 haben wir immer noch so etwas wie einen Stapel, der als Liste implementiert ist. Dies zu verstehen ist wichtig, um zu begreifen, was wir als Nächstes sehen werden.
Nun können wir diese Funktionen und Prozeduren nach und nach implementieren. Aber bevor wir das tun, wie wäre es, wenn wir uns erst einmal das Ergebnis der Ausführung von Code 02 ansehen? Diejenigen, die den vorherigen Artikel gelesen haben, kennen dieses Ergebnis allerdings bereits. Das Ergebnis sehen Sie jedenfalls unten:
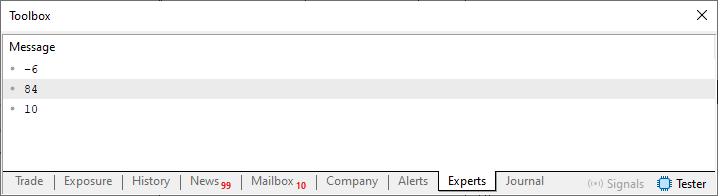
Abbildung 10
Super, nun nehmen wir die erste Änderung an eben diesem Code 02 vor, damit wir einen Wert am Anfang unserer zukünftigen Liste hinzufügen können. Die erste Änderung ist unten zu sehen:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> class stList
05. {
06.     private:
07. //+----------------+
08.         T info;
09.         stList <T>  *prev,
10.                     *start;
11. //+----------------+
12.     public:
13. //+----------------+
14.         stList(void)
15.             :prev(NULL),
16.             start(NULL)
17.         {}
18. //+----------------+
19.         void Store(T arg, const ENUM_FILE_POSITION pos = SEEK_END)
20.         {
21.             stList <T> *loc;
22.
23.             loc = new stList <T>;
24.             switch(pos)
25.             {
26.                 case SEEK_SET:
27.                     (*loc).info = arg;
28.                     (*loc).prev = NULL;
29.                     (*start).prev = loc;
30.                     start = loc;
31.                     break;
32.                 case SEEK_END:
33.                     (*loc).info = arg;
34.                     (*loc).prev = prev;
35.                     prev = loc;
36.                     start = (start == NULL ? loc : start);
37.                     break;
38.             }
39.         }
40. //+----------------+
41.         bool Restore(T &arg)
42.         {
43.             stList <T> *loc;
44.
45.             if (prev == NULL)
46.                 return false;
47.
48.             loc = prev;
49.             arg = (*loc).info;
50.             prev = (*loc).prev;
51.
52.             delete loc;
53.
54.             return true;
55.         }
56. //+----------------+
57. };
58. //+------------------------------------------------------------------+
59. void OnStart(void)
60. {
61.     stList <char> list;
62.
63.     list.Store(10);
64.     list.Store(84);
65.     list.Store(-6);
66.     list.Store(47, SEEK_SET);
67.
68.     for (char info; list.Restore(info);)
69.         Print(info);
70. };
71. //+------------------------------------------------------------------+
Code 03
Und nun, lieber Leser, schenken Sie bitte der folgenden Erklärung Ihre volle Aufmerksamkeit. Auch wenn das, was hier in Code 03 gemacht wird, für mich und für erfahrene Programmierer sehr leicht zu verstehen ist, ist es für viele von Ihnen extrem schwierig. Und das ist erst der Anfang der Umsetzung der Liste selbst. Um nicht zu viele zusätzliche Elemente zu erstellen, verwende ich hier in Code 03 einen Aufzählungstyp zur Dateipositionierung. Das können Sie in Zeile 19 sehen.
Bitte beachten Sie, dass es genau in dieser Prozedur einen Unterschied zwischen Code 02 und Code 03 gibt. Code 03 funktioniert weiterhin wie ein Stapel, allerdings wie ein Stapel, der nun flexibler aufgebaut werden kann. Kommen wir nun zur Sache. SEEK_END fügt Elemente immer ausgehend vom Ende der bestehenden Liste ein. Und SEEK_SET fügt Elemente immer ausgehend vom Anfang der bestehenden Liste ein. Das gleiche Prinzip gilt auch bei der Arbeit mit Binärdateien.
Verwirrung entsteht jedoch gerade dann, wenn wir etwas an den Anfang der Liste setzen müssen. Das passiert, wenn wir bereits eine Liste haben, die zuvor erstellt wurde. Ich sage das, weil man bei genauerer Betrachtung feststellen kann, dass der Teil, der für das Einfügen von Daten am Ende der Liste zuständig ist, dem zuvor Gezeigten sehr ähnlich ist. Zeile 36 musste jedoch eigens hinzugefügt werden, um sicherzustellen, dass der Zeiger auf den Anfang der Liste korrekt gesetzt wurde. Genau das wird es uns ermöglichen, später neue Elemente am Anfang der Liste hinzuzufügen.
Wenn also der Prozeduraufruf in Zeile 19 „SEEK_SET“ als zweites Argument hat – wie es in Zeile 66 der Fall ist –, wird der Code zwischen den Zeilen 26 und 31 ausgeführt. Schauen wir uns doch einmal Zeile für Zeile an, was hier vor sich geht. In Zeile 27 wird der Wert des Elements gespeichert, genau wie in Zeile 33. Zeile 28 setzt den prev-Zeiger des neuen Knotens auf NULL. Das ist wichtig, damit die Überprüfung in Zeile 45 erfolgreich ist, falls die Liste keine Elemente enthält. In Zeile 29 wird der prev-Zeiger des bisherigen ersten Knotens auf den neuen Knoten gesetzt., dass er auf das Element zeigt, das zum neuen ersten Element der Liste wird. Schließlich wird in Zeile 30 der Zeiger auf das erste Element korrekt gesetzt.
Ich weiß, dass man bei dieser Betrachtungsweise angesichts solcher scheinbar einfachen Dinge leicht unachtsam wird und meint, dieser Code sei ganz leicht zu verstehen. Ich muss Sie jedoch warnen, lieber Leser: Ohne zu verstehen, was in Code 03 geschieht, werden Sie wahrscheinlich nicht verstehen, was Sie gleich sehen werden. In jedem Fall führt die Ausführung von Code 03 zu folgendem Ergebnis:
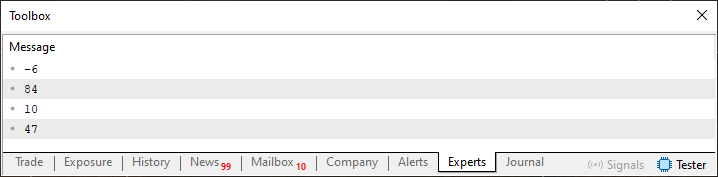
Abbildung 11
Okay, aber vielleicht fragen Sie sich: Könnten wir den Inhalt von Zeile 66 nicht vor die bisherige Zeile 63 setzen? Dies würde dazu beitragen, mögliche Unklarheiten im Code zu vermeiden. Das ist hier aber nicht ganz der Punkt, lieber Leser. Die Sache ist die: Wir müssen sicherstellen, dass der Code Elemente an den Anfang unserer Liste einfügen kann. Deshalb sieht Zeile 66 in Code 03 so aus, wie sie aussieht.
Das war ziemlich interessant, aber wir können – und werden – es noch interessanter gestalten. Nun ändern wir Code 03 in Code 04, wie unten dargestellt:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> class stList
05. {
06.     private:
07. //+----------------+
08.         T info;
09.         stList <T>  *prev,
10.                     *start;
11. //+----------------+
12.     public:
13. //+----------------+
14.         stList(void)
15.             :prev(NULL),
16.             start(NULL)
17.         {}
18. //+----------------+
19.         void Store(T arg, const ENUM_FILE_POSITION pos = SEEK_END)
20.         {
21.             stList <T> *loc;
22.
23.             loc = new stList <T>;
24.
25.             (*loc).info = arg;
26.             (*loc).prev = NULL;
27.             switch(pos)
28.             {
29.                 case SEEK_SET:
30.                     (*loc).start = start;
31.                     (*start).prev = loc;
32.                     start = loc;
33.                     break;
34.                 case SEEK_END:
35.                     if (prev != NULL) (*prev).start = loc;
36.                     (*loc).prev = prev;
37.                     prev = loc;
38.                     start = (start == NULL ? loc : start);
39.                     break;
40.             }
41.         }
42. //+----------------+
43.         bool Restore(T &arg, const ENUM_FILE_POSITION pos = SEEK_END)
44.         {
45.             stList <T> *loc = NULL;
46.
47.             if ((prev == NULL) || (start == NULL))
48.                 return false;
49.
50.             switch (pos)
51.             {
52.                 case SEEK_SET:
53.                     loc = start;
54.                     start = (*loc).start;
55.                     break;
56.                 case SEEK_END:
57.                     loc = prev;
58.                     prev = (*loc).prev;
59.                     break;
60.             }
61.             arg = (*loc).info;
62.
63.             delete loc;
64.
65.             return true;
66.         }
67. //+----------------+
68. };
69. //+------------------------------------------------------------------+
70. void OnStart(void)
71. {
72.     stList <char> list;
73.
74.     list.Store(10);
75.     list.Store(84);
76.     list.Store(-6);
77.     list.Store(47, SEEK_SET);
78.
79.     for (char info; list.Restore(info, SEEK_SET);)
80.         Print(info);
81. };
82. //+------------------------------------------------------------------+
Code 04
In Code 04 beginnen wir bereits damit, etwas zu implementieren, bei dem auf den ersten Blick nicht erkennbar ist, worum es sich tatsächlich handelt. Entspannen wir uns also ein wenig und sehen wir uns Code 04 in aller Ruhe an. Beachten Sie, dass wir nun in Zeile 43 die Funktion „Restore“ haben, die auch eine Anweisung darüber entgegennehmen kann, wie der Lesevorgang durchgeführt werden soll.
Genau an dieser Stelle stoßen wir also auf das Problem, das bereits im Artikel „Von den Grundlagen zur Mittelstufe: Warteschlangen, Listen und Bäume (I)“ beschrieben wurde, in dem wir sowohl FIFO-Warteschlangen als auch zyklische Warteschlangen behandelt haben. Um den Code jedoch einfach zu halten, werden wir hier nicht näher auf das Thema zyklische Warteschlangen eingehen. Konzentrieren wir uns in diesem Artikel auf das einfachste – und zugleich interessanteste – Thema.
Bevor wir zur Funktion „Restore“ übergehen, sehen wir uns an, was sich in der Prozedur „Store“ gegenüber der vorherigen Version geändert hat. Auch wenn es den Anschein haben mag, dass sich nichts geändert hat, führen die an dieser Prozedur vorgenommenen Änderungen zu einem Ergebnis, das sich von dem in Abbildung 01 gezeigten unterscheidet. Passen Sie also bitte gut auf, lieber Leser, denn in Abbildung 01 haben wir gesehen, wie eine einfach verkettete Liste aussehen würde. Code 04 – genauer gesagt die Prozedur „Store“ – erstellt jedoch eine sogenannte DOPPELT VERKETTETE LISTE. „Aber Moment mal. Haben wir diese Art von doppelt verketteter Liste nicht schon in Code 03 erstellt?“ Nein, lieber Leser. In Code 03 hatten wir es noch mit einer einfach verketteten Liste zu tun. Diese geringfügigen Änderungen an Code 04 verwandelten jedoch die ursprüngliche einfach verkettete Liste in eine doppelt verkettete Liste. Um dies zu verstehen, sehen Sie sich bitte die folgende Abbildung an, die eine doppelt verkettete Liste darstellt.
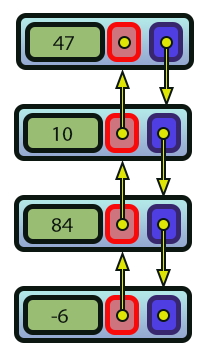
Abbildung 12
Beachten Sie, dass Abbildung 12 in diesem Fall Pfeile in zwei Richtungen enthält, im Gegensatz zu Abbildung 01, in der die Pfeile nur in eine Richtung zeigten. Genau das ermöglicht es uns, zwischen einer doppelt verketteten Liste und einer einfach verketteten Liste zu unterscheiden.
„Aber Moment mal, ich verstehe immer noch nicht, warum Code 03 eine einfach verkettete Liste ist, während Code 04 eine doppelt verkettete Liste ist. Könnten Sie das genauer erklären?“ Dann wollen wir für Klarheit sorgen. Beachten Sie, dass wir in Zeile 30 von Code 04 eine Verknüpfung erstellt haben, um den Anfang der Liste zu kennzeichnen. Das geschieht ebenfalls in Zeile 35, aber die Art und Weise, wie wir es tun, verändert das Verhalten der Liste. Nicht beim Schreiben, sondern beim Lesen – darauf werden wir etwas später noch näher eingehen. Bitte beachten Sie, dass Sie sich von jedem Element – oder Knoten, wie ein Listenelement üblicherweise genannt wird – aus in zwei Richtungen bewegen können. Die erste dieser Richtungen führt uns zum Anfang bzw. zum ersten Element der Liste, während die zweite Richtung uns hingegen zum Ende der Liste führt. Da wir das Ende der Liste nicht wieder mit ihrem Anfang verknüpfen, um eine zyklische Liste zu bilden, ist die Navigation auf diesen Bereich beschränkt.
Bitte beachten Sie, dass die zur Erstellung einer doppelt verketteten Liste vorgenommenen Änderungen ausschließlich die von mir genannten sind. Und dies ändert nichts daran, wie die Prozedur zum Speichern von Daten in der Liste verwendet wird. Dies ermöglicht es uns jedoch, eine völlig andere Art des Lesens der Liste zu entwickeln. Werfen wir nun einen Blick auf die Funktion „Restore“, die sich in Zeile 43 befindet. Sie werden sofort feststellen, dass wir festlegen können, ob die Liste vom ältesten zum neuesten Element oder umgekehrt gelesen werden soll. Und genau das unterscheidet eine FIFO-Warteschlange von einem Stapel, wie in früheren Artikeln gezeigt wurde. In diesem Fall geht es jedoch nicht um Warteschlangen, sondern um Listen. Dennoch gilt das Konzept an sich auch hier.
Bitte beachten Sie, dass wir in Zeile 47 zwei Bedingungen prüfen, unter denen die Liste leer ist. Ist sie nicht leer, fahren wir mit dem Teil fort, der für das Lesen zuständig ist. Da die Umsetzung von SEEKEND – also das Lesen vom neuesten zum ältesten Element – bereits ausführlich erläutert wurde, wollen wir nun zum neuen Stoff übergehen. Mit anderen Worten: Kommen wir nun zu SEEK_SET. Bei dieser Methode durchlaufen wir die Liste vom ältesten, also dem ersten Element, bis zum neuesten, also dem letzten Element der Liste. Beachten Sie, dass wir dazu in Zeile 53 das aktuelle Element verarbeiten und unmittelbar danach den Zeiger auf das aktuelle Element so setzen, dass er auf das nächste Element in der Liste zeigt. Dies geschieht in Zeile 54. Und das ist schon alles, was wir tun müssen. Wenn wir den Code also ausführen, erhalten wir das in der folgenden Abbildung gezeigte Ergebnis:
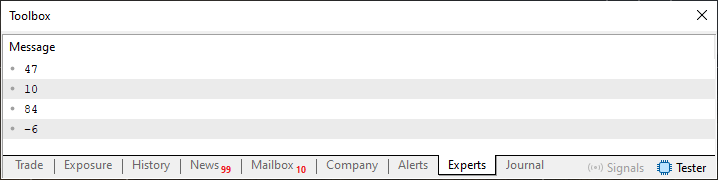
Abbildung 13
„Wow, auf den ersten Blick mag das seltsam erscheinen.“ In der Tat, lieber Leser, wenn Sie die Situation so betrachten, verstehen Sie vielleicht nicht ganz, was hier vor sich geht. Auf jeden Fall finden Sie die wichtigsten Codeausschnitte, die in diesem Artikel behandelt werden, im Anhang, sodass Sie damit experimentieren können. Vergessen Sie aber nicht, auch die im Verlauf dieses Artikels gezeigten Zwischenstände des Codes auszuprobieren, denn sie helfen Ihnen dabei, besser zu verstehen, was hier vor sich geht.
Bevor wir diesen Artikel abschließen, möchte ich Ihnen, lieber Leser, noch eine Sache zeigen. Das könnte Ihnen helfen, besser zu verstehen, wie diese doppelt verkettete Liste im Speicher angelegt wird.
Es ist sehr wichtig, dass Sie diesen Stoff beherrschen, damit Sie verstehen können, was ich im nächsten Artikel erläutern werde, da ich Sie nicht mit zu vielen Informationen überfordern möchte. Dieser Artikel enthält genügend Stoff, der vielen Lesern reichlich Anlass zum Nachdenken und Durcharbeiten bietet. Der Teil, auf den ich hinweisen möchte, ist im folgenden Code zu sehen.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> class stList
05. {
06.     private:
07. //+----------------+
08.         T info;
09.         stList <T>  *prev,
10.                     *start;
11. //+----------------+
12.     public:
13. //+----------------+
14.         stList(void)
15.             :prev(NULL),
16.             start(NULL)
17.         {}
18. //+----------------+
19.         void Store(T arg, const ENUM_FILE_POSITION pos = SEEK_END)
20.         {
21.             stList <T> *loc;
22.
23.             loc = new stList <T>;
24.
25.             (*loc).info = arg;
26.             (*loc).prev = NULL;
27.             switch(pos)
28.             {
29.                 case SEEK_SET:
30.                     (*loc).start = start;
31.                     (*start).prev = loc;
32.                     start = loc;
33.                     break;
34.                 case SEEK_END:
35.                     if (prev != NULL) (*prev).start = loc;
36.                     (*loc).prev = prev;
37.                     prev = loc;
38.                     start = (start == NULL ? loc : start);
39.                     break;
40.             }
41.         }
42. //+----------------+
43.         bool Restore(T &arg, const ENUM_FILE_POSITION pos = SEEK_END)
44.         {
45.             stList <T> *loc = NULL;
46.
47.             if ((prev == NULL) || (start == NULL))
48.                 return false;
49.
50.             switch (pos)
51.             {
52.                 case SEEK_SET:
53.                     loc = start;
54.                     start = (*loc).start;
55.                     break;
56.                 case SEEK_END:
57.                     loc = prev;
58.                     prev = (*loc).prev;
59.                     break;
60.             }
61.             arg = (*loc).info;
62.
63.             delete loc;
64.
65.             return true;
66.         }
67. //+----------------+
68.         void Debug(void)
69.         {
70.             Print("===== DEBUG =====");
71.             for (stList <T> *loc = prev; loc != NULL; loc = (*loc).prev)
72.                 PrintFormat("0x%06X ->> 0x%06X <<- 0x%06X = [%d]",(*loc).start, loc, (*loc).prev, loc.info);
73.             Print("=================");
74.         }
75. //+----------------+
76. };
77. //+------------------------------------------------------------------+
78. void OnStart(void)
79. {
80.     stList <char> list;
81.
82.     list.Store(10);
83.     list.Store(84);
84.     list.Store(-6);
85.     list.Store(47, SEEK_SET);
86.
87.     list.Debug();
88.
89.     for (char info; list.Restore(info, SEEK_SET);)
90.         Print(info);
91. };
92. //+------------------------------------------------------------------+
Code 05
Wenn Sie sich Zeit nehmen und sorgfältig mit Code 05 arbeiten, der als Anhang beigefügt ist, werden Sie verstehen, wie eine Liste in der Praxis erstellt wird. Das liegt daran, dass ich in Zeile 68 eine Prozedur hinzugefügt habe, deren Zweck darin besteht, die Liste im Speicher anzuzeigen. Da wir hier in MetaTrader 5 bestimmte Dinge nicht tun können, ohne noch tiefer in technische Details einzusteigen, zeigt die Prozedur in Zeile 68 die Listenstruktur im Terminal in einem relativ leicht verständlichen Format an. Wenn Zeile 87 ausgeführt wird, rufen wir diese Prozedur aus Zeile 68 auf. Das Ergebnis sehen Sie in der folgenden Abbildung:
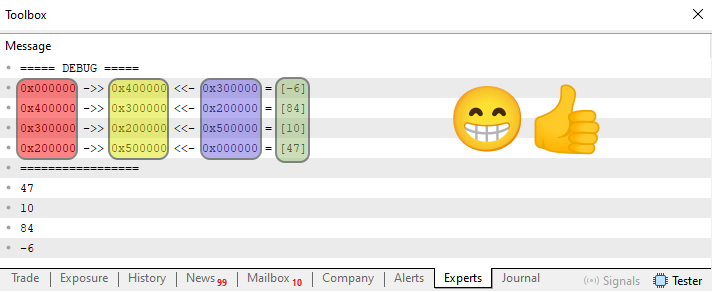
Abbildung 14
Hier sind vier Bereiche markiert. Und diese Bereiche entsprechen in gewissem Maße dem, was in Abbildung 12 dargestellt ist. Bitte beachten Sie, dass die in diesem Knoten gespeicherten Werte in der Abbildung grün hervorgehoben sind. Die Adresse des Knotens ist gelb hervorgehoben. „Was ist mit den rot und violett markierten Bereichen?“ Nun, diese Bereiche zeigen die Richtung zum nächsten bzw. zum vorherigen Knoten an. Bitte beachten Sie, dass die Pfeile in Abbildung 14 die Richtung angeben, der wir beim Durchlauf folgen werden. Wenn der Pfeil nach links zeigt, durchlaufen wir die Liste vom ältesten zum neuesten Element. Dies entspräche einem Durchlauf der Liste in FIFO-Reihenfolge. Wenn die Pfeile hingegen nach rechts zeigen, werden die Knoten so verarbeitet, wie es bei einem Stapel der Fall ist, d. h. vom neuesten Element zum ältesten in der Liste.
Nun, das war’s dann, lieber Leser. Jetzt ist es an der Zeit, zu lernen und zu üben, damit wir wirklich verstehen, was in diesen Code-Beispielen vor sich geht.
Abschließende Gedanken
In diesem Artikel, dessen Inhalt recht komplex und für die meisten Anfänger ziemlich schwierig ist, haben wir in der Praxis gesehen, wie man ein einfaches und recht nützliches Modell einer verketteten Liste implementiert. Wir haben mit etwas begonnen, das man als Implementierung einer einfach verketteten Liste bezeichnen könnte, und sind schließlich bei etwas gelandet, das als doppelt verkettete Liste klassifiziert wird.
Auch wenn das, was Sie hier sehen, viel komplizierter erscheinen mag, als es tatsächlich ist, möchte ich Sie bitten, sich Zeit zu nehmen und die Ausführungen in diesem Artikel sorgfältig durchzugehen. Die Sache ist die: Wir müssen noch zeigen, wie ein Aspekt dieses Listensystems umgesetzt wird. Dabei geht es konkret um das Einfügen und Entfernen von Elementen anhand eines Indexwerts. Da viele Leser diese Operationen bei der Verwendung von Arrays wesentlich einfacher und leichter verständlich finden würden, werde ich diesen Teil in diesem Artikel nicht behandeln. Es gibt jedoch noch ein weiteres Detail, das dieses fehlende Puzzleteil noch verwirrender macht. Auf dieses Detail wird jedoch zu einem späteren Zeitpunkt eingegangen. Meiner Meinung nach sorgt dieses Detail zwar dafür, dass die Sache für Anfänger viel verwirrender wird, vereinfacht aber die Implementierung und Verwendung des Codes erheblich.
Auf jeden Fall werde ich mich dazu im Moment nicht äußern. Aber ich möchte, dass Sie sich bemühen, auch wenn es Ihnen am Ende vielleicht nicht gelingt. Versuchen Sie, einen Mechanismus zu entwickeln, mit dem Sie Elemente anhand eines Indexwerts in eine Liste einfügen und daraus entfernen können, genau wie bei Arrays. Damit Sie besser verstehen, wie Sie dabei vorgehen können, und um allen, die testen möchten, wie viel sie bereits über die MQL5-Programmierung gelernt haben, eine Hilfestellung zu geben, hier ein Tipp:
Versuchen Sie, die Prozedur in Zeile 68 des Codes 05 so anzupassen, dass die Stellen ermittelt werden, an denen Daten aus der Liste entfernt und in die Liste eingefügt werden. Sobald Ihnen das gelungen ist, versuchen Sie, die Prozedur in Zeile 19 entsprechend anzupassen, sodass sie einen Index akzeptiert, der die Position angibt, an der die Liste geändert werden soll. Auf diese Weise können Sie einen bestimmten Knoten an der gewünschten Position in der Liste einfügen oder entfernen, was zu einem Ergebnis führt, das dem in Abbildung 09 gezeigten sehr ähnlich ist. Hinweis: Die Umsetzung des Codes für eine doppelt verkettete Liste wird einfacher sein, da in Code 05 eine doppelt verkettete Liste erstellt wird. Aber nichts hindert Sie daran, eine einfach verkettete Liste zu erstellen.
Versuchen Sie das doch einmal, bevor Sie sich meinen Lösungsvorschlag für diese Art von Problem ansehen. Denken Sie daran, dass der Code nicht genau mit dem übereinstimmen muss, den ich Ihnen zur Verfügung stellen werde. Er muss jedoch in der Lage sein, eine ähnliche Wirkung zu erzielen. Also wünsche ich Ihnen viel Erfolg beim Lernen und hoffe, dass es Ihnen Spaß macht, darüber nachzudenken, wie Sie es angehen können. Bis zum nächsten Artikel.
| MQ5-Datei | Beschreibung |
|---|---|
| Code 01 | Einfach verkettete Liste |
| Code 02 | Einfach verkettete Liste |
Übersetzt aus dem Portugiesischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/pt/articles/16628
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.