

Неопределённость как модель (Часть 9): Процессы авторегрессии
 62
 0

Оглавление
- Введение
- Модель ARMA
- Моделирование реальных данных
- Нестационарность и её тестирование
- Определение порядков модели
- Верификация модели
- Практическое применение модели
- Реализация в коде
- ACF
- PACF
- Коррелограммы
- Информационные критерии
- Автоматический подбор порядков модели
- Анализ остатков модели
- Практический пример
- Заключение
- Список приложенных файлов
Введение
При разработке торговых роботов и индикаторов автоматизация анализа рыночной динамики неизбежно сталкивается с проблемой извлечения системных закономерностей из хаотичного ценового шума. Пытаясь найти математически строгие инструменты, алготрейдеры часто обращаются к классике эконометрики — моделям авторегрессии и скользящего среднего (ARMA). Однако их практическое применение на реальных котировках порождает серию критических проблем:
- Упрощённое представление о стационарности и нестационарности. Чаще всего анализ сводится лишь к поверхностному поиску единичных корней. При этом игнорируются другие типы нестационарности (например, тренд-стационарность или структурные сдвиги), что приводит к выбору неверных методов предобработки данных и эффекту ложной регрессии.
- Слепое использование готовых пакетов. Бездумное применение сторонних библиотек без критического понимания теоретических основ и ограничений, стоящих за ними, лишает разработчика гибкости. При возникновении алгоритмических тупиков трейдер оказывается неспособен адаптировать алгоритм под свои задачи.
- Отсутствие целостного подхода. Процесс моделирования часто воспринимается как изолированные шаги, а не как единая система. Разработчики упускают из виду, что подбор порядков, калибровка весов и статистический аудит остатков — это непрерывный итерационный конвейер.
- Ограниченность стандартного инструментария. Язык MQL5 предоставляет мощные вычислительные возможности, но встроенные средства терминала не содержат готовых эконометрических модулей для автоматического подбора структуры моделей и подтверждающего анализа остатков.
Настоящая серия статей не претендует на полное академическое изложение теории временных рядов и не является заменой профильных учебных пособий. Чтобы удержать материал в рамках разумного объёма и сместить акцент на принципиально важные для алготрейдинга практические аспекты, многие теоретически верные, но второстепенные для первого этапа нюансы и математические допущения были намеренно опущены. Для детального изучения тонкостей и фундаментального уяснения теоретических вопросов эконометрики читателю рекомендуется обращаться к специализированной академической литературе.
Модель ARMA
Формально модель ARMA определяется как регрессионная модель, в которой регрессоры делятся на две группы. К первой относятся константа и лаги (предыдущие значения) самой целевой переменной Y, а ко второй — лаги ошибки модели ε:
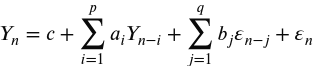
- Первую часть называют авторегрессионной и обозначают как AR(p), где p — максимальный лаг таргета. Именно этот компонент даёт название всему классу моделей.
- Вторую часть называют процессом скользящего среднего и обозначают как MA(q), где q — максимальный лаг используемых остатков. Важно уточнить, что лаги остатков можно назвать регрессорами лишь условно, поскольку они не наблюдаемы непосредственно. Ошибки рассчитываются динамически как разность между фактическим значением ряда и прогнозом модели.
Модель ARMA традиционно привлекает внимание разработчиков торговых систем, поскольку она идеально укладывается в главный постулат технического анализа: "история повторяется", а динамика цен имеет внутреннюю память. Вместо поиска внешних причин модель ищет паттерны в самой структуре ценового ряда. На выходе трейдер получает не просто точечный прогноз математического ожидания (куда пойдёт цена на следующем баре), но и вероятностный доверительный интервал. Последний имеет колоссальное прикладное значение: его границы служат математически обоснованными уровнями для выставления стоп-лоссов или шага сетки ордеров.
В реальном трейдинге базовую модель ARMA часто приходится модифицировать. Для финансовых рынков критически важен учёт сезонности (модели SARMA) или добавление внешних, неценовых предикторов вроде объёмов, показаний индикаторов или макроэкономических данных (модели ARMAX). Однако любые надстройки сохраняют фундамент авторегрессии, а значит, и её базовые свойства, сильные стороны и ограничения.
Связь со стационарностью
Связь между моделью ARMA и стационарностью носит глубокий, двусторонний характер.
- С одной стороны, стационарность — это обязательное входное условие. Как мы подробно разбирали в прошлых статьях, классические методы оценивания параметров (обучения модели) требуют, чтобы регрессоры были стационарными в широком смысле. Если запустить алгоритм оптимизации на нестационарных, "сырых" котировках, математический аппарат ломается. Процедуры поиска коэффициентов либо расходятся, либо приводят к эффекту ложной регрессии (spurious regression). В этом случае модель находит устойчивые взаимосвязи там, где их математически нет и быть не может. За редким и сложным исключением (таким как коинтеграция), мы обязаны подавать на вход регрессионной модели только стационарный ряд — например, логарифмические доходности цен вместо самих цен. Строго говоря, это преобразование цен не гарантирует стационарности, но на практике его очень часто используют как первый шаг к ней.
- С другой стороны, стационарность — это внутренняя природа самой модели. Согласно фундаментальной теореме Вольда (Wold's decomposition theorem), любой стационарный временной ряд может быть представлен в виде суммы двух некоррелированных компонентов: предсказуемого (несущественного для практики) и стохастического. Стохастический компонент представляет собой процесс скользящего среднего бесконечного порядка — MA(∞). Оценить бесконечное число параметров на практике невозможно. И здесь на сцену выходит изящное математическое решение: любой процесс MA(∞) аппроксимируется (приближение Паде) лаконичной моделью ARMA(p, q) с конечным числом параметров. Это приближение всегда верно теоретически, хотя иногда плохо применимо для практических нужд. Это может приводить к необходимости использования и других типов моделей стационарности, но обычно их применяют только если ARMA плохо справляется.
Таким образом, ARMA — это естественная форма для многих стационарных рыночных процессов.
Математические свойства модели
Отложим на время прикладные аспекты и разберём базовые математические свойства ARMA. Возьмём математическое ожидание от обеих частей исходного уравнения. Поскольку случайная ошибка представляет собой белый шум с нулевым математическим ожиданием (E[εₙ] = 0), лаги MA-части обнуляются. В результате мы получаем линейное неоднородное (при c ≠ 0) разностное уравнение для математического ожидания mₙ = E[Yn]:
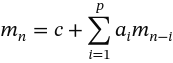
Согласно теории разностных уравнений, его общее решение складывается из частного решения неоднородного уравнения и общего решения однородной части.
- Общее решение однородного уравнения (когда c = 0) ищется в виде линейной комбинации функций вида λn. Подставив этот вид в уравнение, мы приходим к тому, что λ является корнем характеристического многочлена модели степени p: λp - a₁λp-1 - a₂λp-2 -... - aₚ = 0. Из алгебры известно, что любой многочлен степени p имеет ровно p корней (с учётом их кратностей), некоторые из которых могут быть комплексными. Вариант кратных корней мы опустим для простоты из-за его редкости на практике.
- Частное решение неоднородного уравнения. Если удаётся, мы находим его в виде константы μ = c / (1 - a₁ -... - aₚ). Если знаменатель этой формулы обращается в нуль при ненулевой константе c, то структура частного решения усложняется: его ищут в виде многочлена от n степени p.
Строгое математическое определение стационарности требует идеального постоянства математического ожидания и дисперсии. Однако в реальности финансовые ряды всегда подвержены шокам и отклонениям. Нам важно понимать: затухнут ли эти отклонения со временем (вернутся к среднему) или, наоборот, начнут лавинообразно расти? Поэтому на практике экономисты используют понятие асимптотической стационарности (слово "асимптотическая" обычно опускают для краткости). Для моделей ARMA характер поведения ряда полностью определяется корнями λᵢ характеристического многочлена. Здесь возможны три сценария:
- Стационарность: все корни по модулю строго меньше единицы (|λᵢ| < 1). На комплексной плоскости они лежат внутри единичного круга. Любое отклонение от среднего со временем затухает, возвращая систему к балансу. Это рабочее состояние для ARMA.
- Взрывная нестационарность: хотя бы один корень лежит вне единичного круга (|λᵢ| > 1). Динамика ряда быстро срывается в бесконечность. В классической эконометрике такая взрывная нестационарность, как правило, исключается из рассмотрения..
- Умеренная нестационарность: хотя бы один корень лежит строго на единичной окружности (|λᵢ| = 1). В эконометрике это называют процессом с единичным корнем (unit root). Даже если константа c = 0 и математическое ожидание стабильно, дисперсия такого ряда линейно растёт со временем.
Важное замечание об операторах лага. В академической литературе характеристическое уравнение часто выводят через операторную алгебру (оператор лага L). Такая форма удобна для сложных доказательств, но избыточна для программирования и трудна для восприятия. Мы упоминаем её лишь ради предупреждения: операторный метод даёт немного другую форму характеристического многочлена, у которого корни инвертированы (1/λ) относительно определённых нами. Из-за этого математические условия "переворачиваются": единичные корни остаются на окружности, но стационарность в таких учебниках фиксируется, когда корни лежат вне единичного круга (|λᵢ| > 1). В рамках нашей реализации мы придерживаемся классического геометрического подхода: стационарность — это корни строго внутри единичного круга.
Моделирование реальных данных
Применение ARMA к реальным рыночным котировкам можно представить как последовательный конвейер:
- Анализ и подготовка данных (препроцессинг). Мы начинаем с проверки исходной таймсерии на стационарность. Если ряд стационарен, сразу переходим к моделированию. Если нет — приводим его к стационарному виду (начинаем с взятия разностей первого порядка или логарифмирование). Если стабилизировать ряд невозможно (например, из-за структурных сдвигов), от применения ARMA придётся отказаться.
- Идентификация модели (подбор порядков p и q). На основе анализа графиков автокорреляционной (ACF) и частичной автокорреляционной (PACF) функций, либо с помощью информационных критериев (AIC, BIC), мы определяем оптимальную глубину лагов для AR и MA частей.
- Оценивание параметров. На этом этапе алгоритм рассчитывает конкретные значения весов aᵢ и bⱼ при лагах. Так как MA-компонент не наблюдаем напрямую, здесь вместо классического МНК применяются итерационные методы.
- Диагностическая проверка (проверка адекватности). Мы оцениваем статистическую значимость полученных коэффициентов и тестируем остатки (ошибки) финальной модели. Они обязаны быть "белым шумом" — то есть не содержать в себе никакой системной информации. Если в остатках осталась автокорреляция, возвращаемся к шагу 2 и меняем порядки p и q.
- Прогнозирование. Только после успешного прохождения всех проверок модель разворачивается в коде советника или индикатора для генерации точечных прогнозов и расчёта торговых интервалов.
Важное замечание: для идентифицируемости модели, помимо стационарности AR-части, требуется обратимость MA-компоненты (invertibility). На практике при итерационном CLS-оценивании поиск ведётся в стабильной зоне: уход MA-параметров в область необратимости вызывает взрывной рост суммы квадратов остатков и отсекается оптимизатором. Поэтому в рамках нашей программной реализации мы опускаем отдельную проверку MA-корней ради лаконичности кода.
Нестационарность и её тестирование
Проблема практического анализа заключается в том, что классическое определение нестационарности неконструктивно — оно лишь констатирует отсутствие стационарности. Однако для корректного преобразования ряда нам нужна чёткая модель того, как именно устроена эта нестационарность. Выделим четыре основных типа:
- Тренд-стационарность (TS, Trend Stationary). Ряд представляет собой сумму детерминированной функции времени (тренда среднего) и стационарного шума. Приведение к стационарности (детрендирование) происходит путём вычитания этой функции из исходного ряда. Это нетривиальная задача: если вид тренда заранее неизвестен и его приходится оценивать по той же выборке, возникает высокий риск "заглядывания вперед" (look-ahead bias) в торговом алгоритме.
- Разностная стационарность (DS, Difference Stationary). Такие ряды формируются как кумулятивная сумма (интеграл) некоторого стационарного процесса. В эконометрике их называют интегрированными и обозначают как I(d), где d — порядок интегрирования (сколько раз бралась кумулятивная сумма). Преобразование к стационарности здесь очевидно — это взятие разностей соседних элементов (дифференцирование) d раз.
- Нестационарность по дисперсии (гетероскедастичность). Например, когда со временем растёт или колеблется размах (волатильность) цен, то иногда ряд можно свести к тренд-стационарному с помощью логарифмирования. В подобных случаях переход к логарифмам превращает мультипликативный рост цен в аддитивный и стабилизирует дисперсию. Именно поэтому в алготрейдинге исследуют логарифмические доходности, а не "сырые" котировки.
- Структурные сдвиги (несводимая нестационарность). Явление, при котором свойства ряда (среднее или дисперсия) резко меняются в определённый момент времени — например, из-за изменения процентных ставок или кризиса. Самое очевидное решение — разбить историю на изолированные промежутки. Однако поиск точек излома (Change Point Detection) — сложная самостоятельная задача. Эта тема выходит за рамки статьи, и мы рассмотрим её позже в контексте структурной устойчивости моделей.
На практике у нас редко есть готовый ответ о стационарности наших данных. Для диагностики временного ряда приходится использовать статистические тесты. Здесь снова критически важно помнить о неконструктивности общего понятия нестационарности: универсального теста "на все случаи жизни" не существует. Каждый алгоритм проверяет строго определённую модель нарушения стационарности.
В алготрейдинге сформировались устойчивые представления о том, с какими именно процессами мы имеем дело. В этой и ближайших статьях мы сфокусируемся на трёх основных типах:
- Тренд-стационарный ряд (с линейным или квадратичным детерминированным трендом среднего).
- Интегрированный ряд первого порядка I(1). Такие процессы всегда имеют единичный корень в характеристическом уравнении, поэтому их проверку называют тестом на единичный корень (Unit Root test).
- Интегрированный ряд первого порядка I(1) с детерминированным трендом.
Важное предупреждение: нельзя бездумно применять методы, созданные для одного типа нестационарности, к рядам с совершенно другой структурой (например, к рядам со структурными разрывами). Результаты таких проверок будут не просто ошибочными, а математически бессмысленными.
Для тестирования указанной триады в эконометрике традиционно используется тандем из двух тестов: ADF (расширенный тест Дики—Фуллера) и KPSS (тест Квятковского—Филлипса—Шмидта—Шина). Это главные "рабочие лошадки" исследователя. Они идеально дополняют друг друга, работая "от противного": у них противоположные нулевые гипотезы (ADF ищет нестационарность, а KPSS — стационарность). Существует также тест Филлипса—Перрона (PP-тест), но он специфичен, применяется в основном при тяжёлой гетероскедастичности и в рамках данной серии статей рассматриваться не будет.
Реализацию ADF и KPSS на языке MQL5, а также подробные схемы их совместного применения мы разберём в следующих публикациях. Сейчас же, чтобы двигаться дальше по логике ARMA, мы временно сочтём вопросы тестирования стационарности данных успешно решёнными.
Определение порядков модели
Методы определения структуры ARMA(p, q) делятся на визуальные и автоматические.
Визуальный подход строится на анализе коррелограмм — графиков автокорреляционной (ACF) и частичной автокорреляционной (PACF) функций:
- ACF (автокорреляционная функция) измеряет линейную зависимость между текущим значением ряда и его k-м лагом. При k = 0 она всегда равна единице, а для последующих лагов колеблется в диапазоне [-1; 1]. На графике ACF отображается в виде вертикальных столбиков, дополненных двумя горизонтальными линиями — 5%-ми уровнями статистической значимости.
- PACF (частичная автокорреляционная функция) измеряет "чистую" корреляцию между текущим значением и k-м лагом, полностью очищенную от промежуточного влияния лагов с 1 до k - 1. На нулевом лаге PACF также равна единице, а на первом — в точности совпадает с ACF, так как промежуточные лаги отсутствуют. PACF не обязана быть меньше ACF по модулю: если промежуточная корреляция имеет противоположный знак, то |PACF| > |ACF|. График PACF оформляется аналогично — в виде столбцов с уровнями значимости.
Анализ ACF и PACF идеально работает для идентификации чистых процессов AR(p) или MA(q):
- Для чистой модели AR(p) (где q = 0): график PACF резко обрывается (падает ниже уровня значимости) после лага p. При этом график ACF убывает плавно (экспоненциально или в виде затухающей синусоиды).
- Для чистой модели MA(q) (где p = 0): график ACF резко обрывается после лага q. График PACF при этом затухает плавно.
- Если же на обоих графиках нет резких обрывов, а наблюдается лишь плавное геометрическое убывание, перед нами полная модель ARMA(p, q). В этом сценарии визуальный метод позволяет определить лишь верхние границы порядков. Для этого выбираются наибольшие лаги p и q, после которых столбцы на соответствующих графиках перестают существенно пересекать уровни значимости.
Автоматический способ применяется в ситуациях, когда визуальный анализ коррелограмм не даёт однозначного ответа (например, графики ACF и PACF затухают плавно и грязно, что характерно для реальных рыночных данных). В этом случае исследователь задаёт разумные верхние границы для p и q (например, на основе того же визуального метода или вычислительных лимитов), после чего запускается алгоритм сплошного перебора всех возможных пар параметров (p, q).
Для каждой пары оцениваются коэффициенты модели ARMA(p, q). Задача автоматического поиска — выбрать конфигурацию, которая наилучшим образом описывает данные, избегая при этом избыточной параметризации (overfitting). Эту задачу в статистике решают с помощью информационных критериев. Любой такой критерий математически состоит из двух противоборствующих частей: компонента правдоподобия (отвечает за точность подгонки модели к выборке) и компонента штрафа (наказывает за увеличение числа оцениваемых параметров). Оптимальной считается модель с минимальным значением критерия.
Классическими в эконометрике являются информационные критерии Акаике (AIC) и Шварца (BIC, также известный как байесовский критерий):
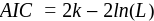
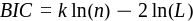
Здесь L — максимальное значение функции правдоподобия модели, k = p + q + 1 — общее число оцениваемых параметров (включая константу), а n — объём выборки. Различие между ними кроется в жёсткости штрафа за добавление нового лага:
- AIC (Akaike Information Criterion) накладывает фиксированный штраф 2 * k. Он склонен несколько завышать реальный порядок модели, однако в трейдинге это не всегда минус, так как позволяет уловить более тонкие и длинные рыночные взаимосвязи.
- BIC (Bayesian Information Criterion) штрафует модель сильнее, привязывая вес штрафа к логарифму объёма выборки ln(n). Этот критерий более консервативен и всегда выбирает более лаконичные, "строгие" модели.
Выбор между AIC и BIC в коде торгового робота обычно диктуется практическими соображениями: например, для краткосрочного скальпинга часто эффективнее AIC, тогда как для среднесрочных стратегий предпочтительнее BIC, защищающий от ложных рыночных шумов.
Верификация модели
После выбора структуры (p, q) и калибровки коэффициентов необходимо провести диагностику остатков (ошибок) модели. Этот шаг позволяет окончательно убедиться в адекватности системы. Если даже лучшая по критериям AIC/BIC модель плохо описывает данные, структура её ошибок укажет на необходимость полной смены класса модели.
В предыдущих публикациях мы уже подробно рассмотрели и реализовали полный набор методов EDA (разведочного) и CDA (подтверждающего) анализа остатков регрессии. Чтобы не повторяться, мы не будем дублировать описание пройденных инструментов, а лишь пополним наш арсенал CDA-методов новым и крайне эффективным алгоритмом. Речь идёт о тесте Бройша—Годфри (Breusch—Godfrey LM-test) на наличие в остатках автокорреляции заданной глубины. Этот тест корректно работает в авторегрессионных моделях.
Суть теста: по вектору остатков ARMA-модели строится вспомогательная линейная регрессия, где этот вектор является зависимой переменной. В качестве регрессоров используем как AR-компоненту исходной модели, так и лаги самих остатков на исследуемую глубину. На основе коэффициента детерминации (R2) этой вспомогательной регрессии оценивается значимость добавленных лагов остатков. Если коэффициенты при лагах остатков значимы, нулевая гипотеза об отсутствии автокорреляции отвергается. Для трейдера это критический сигнал: модель недостаточно впитала в себя структуру данных. Ошибки прогноза всё еще содержат системную информацию, которую можно извлечь, скорректировав порядки p и q. Если же автокорреляция не обнаружена — остатки чисты от памяти, а модель готова к практическому применению.
Практическое применение модели
На практике финальное использование регрессионной модели сводится к оценке статистической значимости её коэффициентов и непосредственно к прогнозированию. Эти задачи мы полностью решили в предыдущей статье цикла. Реализованный там CLS-алгоритм уже умеет рассчитывать коэффициенты ARMA, собирать по ним статистику, а также строить точечные и интервальные прогнозы.
Реализация в коде
Опишем реализацию в коде MQL5 всех недостающих элементов нашего аналитического конвейера (за исключением тестов ADF и KPSS, которые мы детально разберём и закодим в следующих публикациях).
ACF
Начнём с кода для расчёта автокорреляционных функций. В рамках нашего конвейера они служат для визуализации данных, однако мы намеренно разделим вычислительную логику и вывод графиков (коррелограмм) на отдельные модули. Сами по себе расчётные функции универсальны и могут использоваться независимо. Вычисление ACF реализовано в функции:
vector CalculateACF(const vector &data, const ulong max_lag)
Здесь data — вектор с исходным временным рядом, а max_lag — максимальная глубина лага. Функция возвращает вектор со значениями ACF от нулевого лага до заданного максимума.
На первом шаге выполняется валидация входных данных:
ulong n = data.Size();
vector acf = vector::Zeros(max_lag+1);
if(n <= max_lag || max_lag == 0)
   return acf;
Затем мы переходим от исходного ряда к вектору отклонений от среднего значения и находим выборочную дисперсию (сумму квадратов отклонений):
double mean = data.Mean();
vector dev = data - mean;

double variance = (dev * dev).Sum();
if(variance == 0.0)
   return acf;
На данном этапе мы опускаем деление на размер выборки n, поскольку в итоговой формуле ACF мы делим ковариацию на дисперсию, и общий множитель n просто сокращается. Если дисперсия равна нулю, автокорреляция не определена, и функция возвращает нулевой вектор.
Для нулевого лага автокорреляция всегда равна единице:
acf[0] = 1.0;
Для последующих лагов рассчитывается ковариация как скалярное произведение исходного ряда и его смещённой копии, которая затем нормируется на общую дисперсию:
for(ulong lag = 1; lag <= max_lag; lag++)
  {
   double covariance = 0.0;
   for(ulong i = 0; i < n - lag; i++)
     {
      covariance += dev[i] * dev[i + lag];
     }
   acf[lag] = covariance / variance;
  }

return acf;
Важный нюанс: при увеличении лага длина пересечения векторов становится меньше n, и теоретически можно было бы рассчитывать дисперсию по усечённой выборке. Однако на практике, в соответствии с классическим подходом Бокса—Дженкинса, в качестве знаменателя всегда используется дисперсия всего исходного ряда. Это стабилизирует поведение ACF на больших лагах и защищает график от ложных хаотичных выбросов.
PACF
Вычисление частичной автокорреляционной функции реализовано на основе эффективного рекурсивного алгоритма Дурбина—Левинсона в функции:
bool CalculatePACF(const vector &data, const ulong max_lag, vector &pacf)
Здесь data — вектор с исходным временным рядом, max_lag — максимальная глубина лага. Функция возвращает true при успешном расчёте, а сам результат записывается в вектор pacf (от нулевого лага до заданного максимума). На первом шаге выполняется валидация входных данных:
ulong n = data.Size();
if(n <= max_lag || max_lag == 0)
   return false;
Для работы алгоритма Дурбина—Левинсона необходимы предварительно рассчитанные значения ACF, причём исходный ряд не должен быть вырожденным:
vector acf = CalculateACF(data, max_lag);
if(acf.Size() == 0 || acf[0] == 0.0)
   return false;
Инициализируем вектор для PACF и, как и в случае с ACF, жёстко задаем значение на нулевом лаге:
pacf = vector::Zeros(max_lag+1);
pacf[0] = 1.0;
Для рекурсивного пересчёта нам понадобятся два вспомогательных вектора коэффициентов φ: текущего и следующего шага. Мы инициализируем их и выполняем базовый шаг алгоритма для лага k = 1, копируя значения из ACF (благодаря этому phi[1] и pacf[1] автоматически получают корректные стартовые значения acf[1]):
vector phi = vector::Zeros(max_lag+1);
vector phi_next = vector::Zeros(max_lag+1);

phi = acf;
pacf = acf;
Далее в цикле происходит последовательный расчёт PACF для всех лагов, начиная с k = 2. На каждом шаге коэффициенты φ рекурсивно пересчитываются:
for(ulong k = 2; k <= max_lag; k++)
  {
   double numerator = 0.0;
   double denominator = 0.0;

   for(ulong i = 1; i < k; i++)
     {
      numerator += phi[i] * acf[k - i];
      denominator += phi[i] * acf[i];
     }

   double num_final = acf[k] - numerator;
   double den_final = 1.0 - denominator;

   // Защита от деления на нуль для численной стабильности
   if(MathAbs(den_final) < 1e-15)
      return false;

   double pk = num_final / den_final;
   pacf[k] = pk;

   // Обновление векторов коэффициентов
   phi_next[k] = pk;
   for(ulong i = 1; i < k; i++)
     {
      phi_next[i] = phi[i] - pk * phi[k - i];
     }

   phi.Copy(phi_next);
  }
При успешном завершении цикла функция возвращает true, а вектор pacf содержит готовые значения частичной автокорреляционной функции для визуализации или дальнейшего анализа.
Коррелограммы
Графики ACF и PACF строятся по идентичному принципу, поэтому подробно разберём код только для автокорреляции. Отрисовка выполняется с помощью графической библиотеки CGraphic, входящей в состав Стандартной библиотеки MQL5. Вывод коррелограммы на экран осуществляется функцией:
void acf_plot(const vector &data, const ulong max_lag)Она принимает исходный вектор данных data и максимальную глубину лага max_lag. Функция блокирует интерфейс, выводя график поверх текущего чарта, и корректно завершает работу (сворачивая графические объекты) только после того, как пользователь нажмёт кнопку в диалоговом окне. На первом шаге выполняется валидация входных параметров:
//--- размер выборки
ulong n = data.Size();
if(n <= max_lag || max_lag == 0)
  { Print("Неверные входные данные"); return; }
Далее рассчитывается критическая граница статистической значимости по формуле Бартлетта для белого шума (для 5%-го уровня значимости коэффициент равен 1.96). На основе полученного значения формируются массивы для отрисовки двух горизонтальных линий (верхней и нижней границ):
double bound = 1.96 / MathSqrt(n);
double xb[2] = {0, double(max_lag+1)};
double upb[2] = {bound, bound};
double lowb[2] = {-bound, -bound};
Затем подготавливаются массивы координат для самой ACF. Ось X (lags) последовательно заполняется целыми числами от 0 до max_lag с помощью стандартной функции MathSequenceByCount(). Ось Y (cg) заполняется значениями из вектора автокорреляции, который конвертируется в массив типа double[] функцией vector2array():
//--- Создание массива лагов (ось X)
double lags[];
if(!MathSequenceByCount(0, max_lag, (int)max_lag+1, lags))
  {
   Print("Ошибка в MathSequenceByCount()");
   return;
  }

//--- Расчёт ACF и перенос данных в массив (ось Y)
double cg[];
vector acf = CalculateACF(data, max_lag);
vector2array(acf,cg);
Финальный этап — непосредственное построение графических кривых. Обратите внимание, что уровни значимости выводятся в режиме линий (CURVE_LINES), а значения автокорреляции — в виде гистограммы (CURVE_HISTOGRAM), как это принято в специализированных статистических пакетах:
//--- Построение графика поверх чарта
ChartSetInteger(0, CHART_SHOW, false);
CGraphic graphic;
graphic.Create(0, "G", 0, 0, 0, 750, 300);

//--- Добавление данных
graphic.CurveAdd(lags, cg, CURVE_HISTOGRAM, "ACF");
graphic.CurveAdd(xb, upb, CURVE_LINES, "Верхняя граница");
graphic.CurveAdd(xb, lowb, CURVE_LINES, "Нижняя граница");

//--- Отрисовка и обновление
graphic.CurvePlotAll();
graphic.Update();
Поскольку график создаётся динамически в памяти терминала, мы приостанавливаем выполнение программы с помощью системного окна MessageBox(). Как только пользователь оценивает форму коррелограммы и нажимает "OK", функция восстанавливает отображение свечей торгового чарта и полностью уничтожает графический объект, освобождая ресурсы:
MessageBox("Нажмите OK, чтобы закрыть график", "Закрытие графика");
ChartSetInteger(0, CHART_SHOW, true);
graphic.Destroy();
Информационные критерии
Расчёт обоих информационных критериев (AIC и BIC) для удобства объединен в одну общую функцию:
bool ARMA_IC(const vector &e, const ulong pq, double &aic, double &bic)Здесь e — вектор остатков (ошибок) модели, полученный из CLS-алгоритма, а pq — сумма порядков p и q. При успешном завершении функция возвращает true, а результаты записываются в переменные aic и bic. На первом шаге выполняется валидация входных данных и расчёт числа степеней свободы:
// n — объём выборки
ulong n = e.Size();
if(n == 0)
   return false;

// Общее число оцениваемых параметров (k)
ulong k = pq + 1;

// Защита от нехватки степеней свободы
if(n <= k)
   return false;
Тот факт, что количество оцениваемых параметров k на единицу больше суммы порядков лагов (p + q), означает, что наш алгоритм по умолчанию предполагает оценку модели с константой c. Поскольку мы предполагаем нормальное распределение случайной ошибки, для максимизации функции правдоподобия нам достаточно оценить дисперсию остатков через их сумму квадратов (RSS):
// Расчёт суммы квадратов остатков (RSS)
double rss = (e * e).Sum();

// Оценка максимального правдоподобия для дисперсии остатков (sigma^2)
double sigma_sq = rss / (double)n;

// Математическая защита от логарифма нуля log(0)
if(sigma_sq <= 1e-15)
   sigma_sq = 1e-15;
Финальный расчёт критериев выполняется по классическим формулам, где логарифм дисперсии масштабируется на размер выборки n, после чего к нему прибавляется соответствующий штраф за сложность:
// Вычисление классических AIC и BIC
aic = (double)n * MathLog(sigma_sq) + 2.0 * (double)k;
bic = (double)n * MathLog(sigma_sq) + (double)k * MathLog((double)n);

return true;
Автоматический подбор порядков модели
Поиск наилучшей архитектуры модели на основе информационных критериев (сеточный поиск, или Grid Search) реализован в функции:
void ARMA(const vector& y, const ulong p_max, const ulong q_max, bool use_AIC=true)
Здесь y — исходный временной ряд, p_max и q_max — верхние границы перебора для порядков AR и MA частей соответственно, а use_AIC — логический флаг, переключающий алгоритм между критериями Акаике (true) и Шварца/Байеса (false). Функция не возвращает значений, отправляя финальный результат подбора прямо в журнал терминала. На первом шаге выполняется обязательная валидация длины выборки с учётом максимально возможного числа оцениваемых параметров:
ulong n = y.Size();
ulong k_max = p_max + q_max + 1;
if(n <= k_max)
  { Print("Ошибка ARMA(): слишком короткий вектор y"); return; }
Затем объявляются внутренние переменные и структуры, необходимые для хранения результатов промежуточных вычислений и параметров лучшей модели:
vector e;
CoefficientStats stats[];
SPrognose prog;

ulong p_best = 0, q_best = 0, nscs = 0;
double aic, bic, ic, ic_best = 0.0;
Основное ядро функции — вложенный цикл оптимизации, который последовательно тестирует каждую пару порядков (p, q) в заданной сетке:
for(ulong p=0;p<=p_max;++p)
   for(ulong q=0;q<=q_max;++q)
     {
      if(!regression_CLS(y,p,q,vector::Zeros(p),vector::Zeros(q),e,stats,prog))
        {PrintFormat("CLS error for: p=%ld q=%ld",p,q); continue;}
      if(!ARMA_IC(e,p+q,aic,bic))
        {PrintFormat("IC error for: p=%ld q=%ld",p,q); continue;}
      ++nscs;
      ic=use_AIC?aic:bic;
      if(nscs==1||ic<ic_best)
        {
         p_best=p;
         q_best=q;
         ic_best=ic;
        }
     }
Функция regression_CLS(), вызываемая внутри цикла, реализует описанный в прошлой статье CLS-алгоритм с регуляризацией Левенберга—Марквардта. На каждой итерации она принимает нулевые стартовые векторы предыдущих лагов для таргета и остатков и возвращает обновлённый вектор остатков e, который мы сразу же передаём в функцию расчёта критериев ARMA_IC(). После завершения полного перебора сетки функция выводит параметры оптимальной конфигурации в лог терминала:
if(use_AIC)
   PrintFormat("Best ARMA(p, q) model based on the AIC criterion: p=%ld and q=%ld",p_best,q_best);
else
   PrintFormat("Best ARMA(p, q) model based on the BIC criterion: p=%ld and q=%ld",p_best,q_best);
Анализ остатков модели
Большая часть методов анализа соответствия регрессионной модели исходным данным (через поведение её остатков) уже была рассмотрена и закодирована нами в предыдущих статьях серии. В данной публикации принципиально новым инструментом является LM-тест Бройша—Годфри. Этот метод хорошо подходит для моделей класса ARMA. Он позволяет окончательно убедиться, что в остатках модели не сохранилась скрытая автокорреляция, которую алгоритм калибровки не смог учесть. Для проведения данного теста используется функция:
void LM_test(const vector& Y, const vector& y, const ulong p, const ulong m)Здесь Y — вектор с исходным временным рядом, y — вектор остатков (ошибок) проверяемой ARMA-модели, p — порядок её AR-части, а m — глубина лагов остатков, проверяемая на автокорреляцию. Функция не возвращает значений, выводя подробный вердикт непосредственно в журнал терминала. На первом шаге выполняется валидация входных данных, размеров векторов и степеней свободы:
ulong n = y.Size();
ulong k = p + m + 1; // Всего регрессоров: 1 (константа) + p (лаги Y) + m (лаги остатков)

if(n <= k)
  { Print("Ошибка LM_test(): вектор y слишком короткий"); return; }

if(Y.Size() != n)
  { Print("Ошибка LM_test(): несовпадение размеров векторов Y и y"); return; }

if(p == 0)
  { Print("Ошибка LM_test(): порядок p должен быть больше 0"); return; }

if(m == 0)
  { Print("Ошибка LM_test(): глубина проверки m должна быть больше 0"); return; }
Затем создаётся и заполняется матрица признаков X для вспомогательной регрессии, на которой и базируется логика теста. Благодаря встроенным типам MQL5, мы можем сразу инициализировать матрицу единицами, автоматически сформировав первый столбец константы:
//--- Создание вспомогательной матрицы X со столбцом единиц (константа)
matrix X = matrix::Ones(n, k);
for(ulong i = 0; i < n; ++i)
  {
   // Заполнение лагов исходного ряда Y
   for(ulong j = 1; j <= p; ++j)
      X[i][j] = (i >= j) ? Y[i - j] : 0.0;

   // Заполнение лагов остатков y
   for(ulong j = 1; j <= m; ++j)
      X[i][p + j] = (i >= j) ? y[i - j] : 0.0;
  }
Перед расчётом коэффициентов мы обязательно проверяем матрицу на мультиколлинеарность через оценку её ранга. Если ранг меньше количества столбцов, матрица вырождена, и расчёт МНК невозможен:
if(X.Rank() < k)
  { Print("Ошибка LM_test(): мультиколлинеарность в матрице X"); return; }
Используя аппарат матричной алгебры MQL5, мы находим вектор параметров b через классический обычный метод наименьших квадратов (OLS) в одну строчку, после чего вычисляем остатки этой вспомогательной регрессии:
matrix Xt = X.Transpose();
vector b = Xt.MatMul(X).Inv().MatMul(Xt).MatMul(y);

// Нахождение остатков вспомогательной регрессии
vector e = y - X.MatMul(b);
Далее мы рассчитываем коэффициент детерминации (R²), который покажет, какую долю дисперсии прошлых ошибок нам удалось объяснить с помощью добавленных лагов. Также предусмотрена защита от вычислительного ухода под нуль:
// Сумма квадратов остатков (RSS) для вспомогательной регрессии
double rss = (e * e).Sum();

// Полная сумма квадратов (TSS) для центрированного вектора y
double y_mean = y.Mean();
vector y_dev = y - y_mean;
double tss = (y_dev * y_dev).Sum();

// Защита от нулевой дисперсии
if(tss == 0.0)
  { Print("Ошибка LM_test(): tss равно 0"); return; }

double r_squared = 1.0 - (rss / tss);
if(r_squared < 0.0)
   r_squared = 0.0; // Защита от возможной микроскопической машинной ошибки в double
Статистика теста (LM-статистика) вычисляется как произведение объёма выборки на полученный R². Финальное значение p-value находится через кумулятивную функцию распределения Хи-квадрат со степенями свободы, равными числу проверяемых лагов m:
double lm_statistic = (double)n * r_squared;

int error_code = 0;
double p_value = 1.0;

// Использование перегрузки: tail=false (правый хвост), log_p=false (обычная вероятность)
p_value = MathCumulativeDistributionChiSquare(lm_statistic, (double)m, false, false, error_code);

if(error_code != 0)
  {
   PrintFormat("Ошибка расчёта распределения Хи-квадрат. Код: %d", error_code);
   return;
  }
Финальный этап функции — интерпретация результатов теста и вывод структурированного отчёта в лог советника:
PrintFormat("--- Результаты теста Бройша—Годфри ---");
PrintFormat("LM Статистика: %.4f", lm_statistic);
PrintFormat("Степени свободы (Лаги): %I64u", m);
PrintFormat("R-квадрат: %.4f", r_squared);
PrintFormat("p-value: %.5f", p_value);

if(p_value < 0.05)
  {
   Print("Вердикт: Гипотеза H0 ОТВЕРГНУТА. В остатках ЕСТЬ автокорреляция (Модель неадекватна).");
  }
else
  {
   Print("Вердикт: Гипотеза H0 НЕ отвергнута. Автокорреляция НЕ обнаружена (Остатки — белый шум).");
  }
Практический пример (скрипты vol1.mq5 и vol2.mq5)
Протестируем получившийся конвейер на реальном рыночном активе для наглядной иллюстрации его работы. Для этого проведём анализ автокорреляционной структуры волатильности валютного курса.
Спецификация модели
Анализ проводится на дневном таймфрейме (PERIOD_D1) для валютной пары EURCHF. В качестве исследуемой переменной y выступает логарифм отношения максимальной цены бара к минимальной (log(High/Low)). Полученный ряд волатильности совершает стохастические колебания вокруг своего исторического среднего и не уходит в бесконечность. Это указывает на его природную стационарность, что позволяет корректно применять аппарат моделей ARMA. Безусловно, в строгом анализе стационарность временного ряда должна доказываться математически с помощью специализированных статистических тестов (таких, как ADF и KPSS). Как было отмечено выше, эти фундаментальные инструменты будут подробно разобраны и реализованы на языке MQL5 в наших следующих публикациях. В рамках же текущей статьи, для демонстрации работы расчётного конвейера ARMA, мы опираемся на содержательные свойства волатильности и временно принимаем допущение, что исследуемый ряд успешно прошёл предварительную формальную проверку на стационарность.
Реализация в коде
Практический пример разделен на два последовательных скрипта:
- vol1.mq5 — служит для визуального анализа коррелограмм и автоматического сеточного подбора оптимальных порядков p и q.
- vol2.mq5 — предназначен для глубокого аудита остатков выбранной модели, проверяющего, насколько хорошо она впитала рыночную память.
Оба скрипта начинаются с одинакового блока входных параметров, определяющего границы исследуемой выборки:
input string   symbol = "EURCHF";         // Рыночный инструмент для анализа
input datetime from_t = D'2024.09.20';    // Начало временного интервала
input datetime to_t   = D'2026.09.20';    // Конец временного интервала
Далее идут параметры порядков модели, где и кроется различие между скриптами. В первом скрипте задаются верхние границы перебора:
input ulong pmax = 5;                     // Максимальный порядок p для перебора
input ulong qmax = 5;                     // Максимальный порядок q для перебора
Во втором скрипте фиксируются конкретные (уже найденные) значения для проведения тестов:
input ulong pfit = 3;                     // Порядок p для верификации модели
input ulong qfit = 3;                     // Порядок q для верификации модели
Для расчётов оба скрипта используют единый заголовочный файл, содержащий всю математическую базу нашего эконометрического конвейера:
#include "EconometricsM.mqh"Загрузка исторических котировок из терминала MetaTrader 5 выполняется через стандартную функцию CopyRates():
MqlRates rates[];
int n_rates = CopyRates(symbol, PERIOD_D1, from_t, to_t, rates);
PrintFormat("Загружено котировок для инструмента %s: %d", symbol, n_rates);
if(n_rates < 2)
   return;
На основе загруженных баров формируется рабочий вектор волатильности y:
ulong n = (ulong)n_rates;
vector y(n);
for(ulong i = 0; i < n; ++i)
   y[i] = MathLog(rates[i].high / rates[i].low);
После этого этапа логика скриптов разделяется.
Скрипт 1 (vol1.mq5): поиск архитектуры. Для первичной визуальной оценки возможных лагов мы последовательно выводим на экран графики автокорреляционной и частичной автокорреляционной функций:
acf_plot(y, pmax + qmax);
pacf_plot(y, pmax + qmax);
Затем запускается сеточный поиск оптимальной пары (p, q). Чтобы получить всестороннюю оценку, мы последовательно рассчитываем минимумы для обоих классических информационных критериев — AIC и BIC:
ARMA(y, pmax, qmax);         // Подбор по критерию AIC (use_AIC = true по умолчанию)
ARMA(y, pmax, qmax, false);  // Подбор по критерию BIC
Скрипт 2 (vol2.mq5): аудит и верификация остатков. Получив оптимальные значения p и q из первого скрипта, мы подставляем их в параметры pfit и qfit второго скрипта. Сначала запускается уже знакомый CLS-алгоритм для расчёта финального вектора остатков e:
vector e;
CoefficientStats stats[];
SPrognose prog;
regression_CLS(y, pfit, qfit, vector::Zeros(pfit), vector::Zeros(qfit), e, stats, prog);
Далее мы подвергаем полученные ошибки комплексному анализу. В рамках разведочного анализа данных (EDA) используются визуальные графические методы:
t_residuals_plot(e);       // График зависимости остатков от времени (поиск тренда/гетероскедастичности)
qq_plot(e);                // График квантиль-квантиль (проверка аномалий в хвостах распределения)
epdf_vs_normalpdf(e);      // Сравнение эмпирической плотности с теоретическим нормальным распределением
Финальную точку в обучении модели ставит подтверждающий анализ (CDA). Мы запускаем тест Бройша—Годфри, предварительно рассчитав адаптивную глубину лагов m по логарифмическому правилу:
//--- Вычисление адаптивной глубины лагов остатков
ulong m = (ulong)MathMax(pfit + qfit + 1, MathRound(MathLog(n)));

//--- Запуск LM-теста Бройша — Годфри
LM_test(y, e, pfit, m);
Анализ результатов
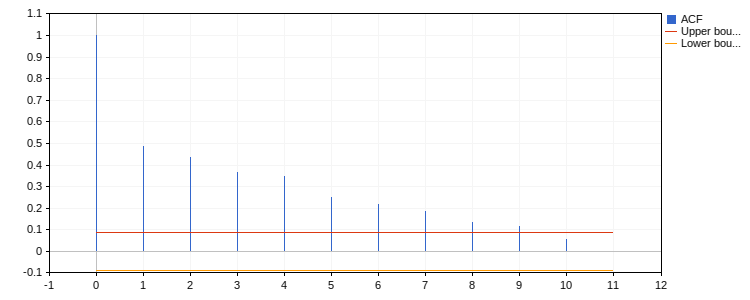
Запустим первый скрипт (vol1.mq5) в торговой платформе MetaTrader 5 при указанных значениях входных параметров. Программа последовательно выведет на экран графики корреляционных функций. Сначала мы увидим коррелограмму ACF:
Затем скрипт отобразит график частичной автокорреляции (PACF):
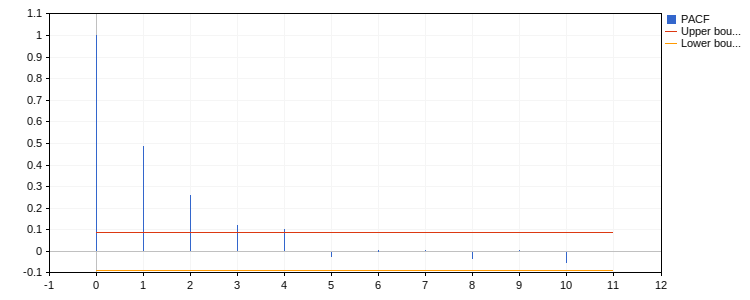
Визуальный анализ обеих коррелограмм показывает, что перед нами не чистый процесс AR или MA — столбики обеих функций убывают плавно (геометрически), хоть и с разной скоростью. Это подтверждает наше предположение о наличии полной структуры ARMA(p, q). Окончательное решение о порядке модели принимает алгоритм автоматического сеточного поиска в пределах заданных границ (pmax = 5, qmax = 5):
Best ARMA(p, q) model based on the AIC criterion: p=3 and q=3
Best ARMA(p, q) model based on the BIC criterion: p=3 and q=3
Оба информационных критериев единогласно указали на одну и ту же оптимальную конфигурацию — ARMA(3, 3). Перейдём ко второму скрипту (vol2.mq5) для проведения всестороннего аудита остатков выбранной модели. Первым делом оценим график зависимости ошибок от времени:
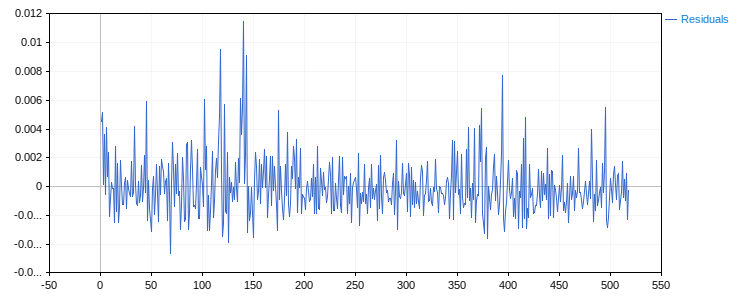
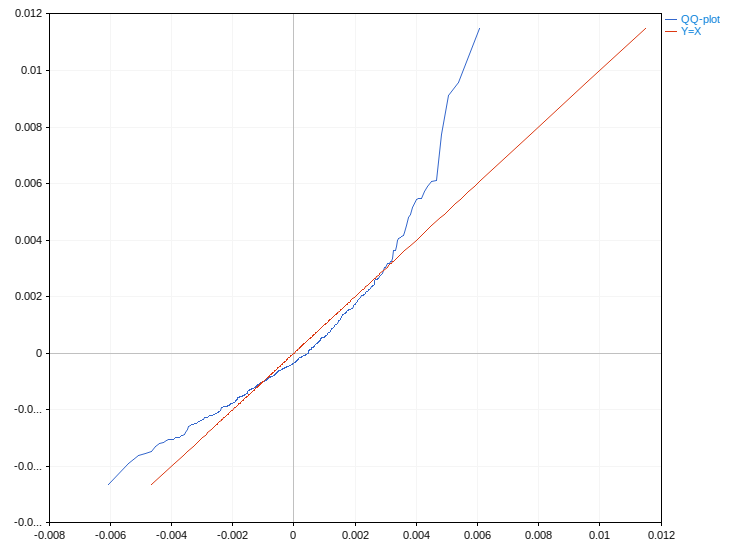
Визуально на графике не прослеживаются явные тренды или циклические закономерности, однако отчётливо видны резкие единичные выбросы. Они сигнализируют о потенциальном нарушении свойства нормальности (гауссовости) распределения остатков. Финансовые временные ряды практически всегда обладают этой спецификой, и подобные аномалии требуют отдельного изучения. Поскольку сейчас проверяется работоспособность вычислительного конвейера, ограничимся EDA для уточнения характера нарушения. График квантиль-квантиль (QQ-plot) наглядно демонстрирует сильное отклонение точек от диагональной линии на концах диапазона, что подтверждает ярко выраженную "толстохвостость" (heavy tails) распределения остатков в сравнении с теоретическим нормальным:
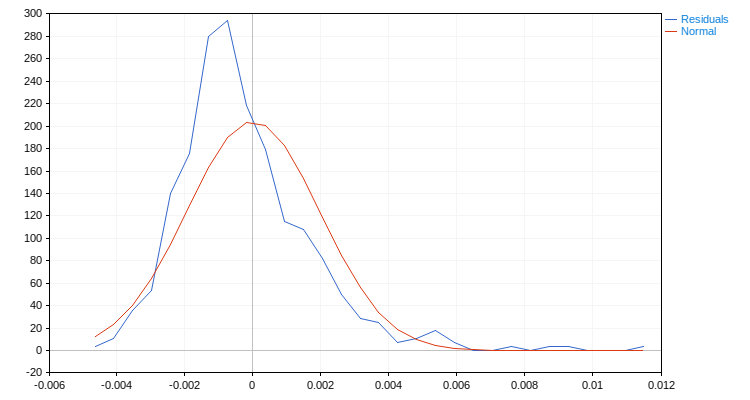
Следующий график эмпирической плотности позволяет детально рассмотреть центральную часть распределения. Мы видим, что оно является лептокуртическим (островершинным) и обладает асимметрией (смещённой модой относительно математического ожидания):
Финальную, подтверждающую точку в диагностике модели ставит CDA-подход в виде теста Бройша—Годфри. Скрипт выводит в журнал терминала следующие результаты вычислений:
--- Breusch-Godfrey Test Results ---
LM Statistic: 10.4390
Degrees of Freedom (Lags): 7
R-squared: 0.0202
p-value: 0.16503
Result: Fail to reject H0. No serial correlation detected (Residuals are white noise).
Ключевой показатель здесь — p-value (0.16503), который существенно выше критического уровня 0.05. Это означает, что у нас нет оснований отвергнуть нулевую гипотезу. Статистически значимая автокорреляция в остатках отсутствует, и с точки зрения эконометрики они представляют собой чистый белый шум. Выбранная архитектура ARMA(3, 3) неплохо справилась со своей задачей. Тем не менее обнаруженное нарушение нормальности распределения намекает на необходимость дальнейшего, более глубокого исследования данных. Очевидно, в первую очередь следовало бы протестировать влияние на волатильность внешних макроэкономических событий (перейдя к модели ARMAX). Как мы убедились в прошлых статьях серии, этот фактор оказывает значимое воздействие на рыночную динамику.
Заключение
В данной статье мы:
- Раскрыли практически важные аспекты понятий стационарности и нестационарности.
- Показали прямую связь между стационарностью и моделями ARMA.
- Построили алгоритмический конвейер моделирования стационарных данных с помощью ARMA.
- На практическом примере увидели работу этого конвейера.
В следующей статье серии мы перейдём к решению главной проблемы препроцессинга данных — автоматическому определению порядка интегрирования числовых рядов. Мы детально разберём и реализуем на MQL5 расширенный тест Дики—Фуллера (ADF). Этот инструмент по праву считается одним из ключевых столпов современной эконометрики, позволяющим алгоритмически точно диагностировать наличие единичных корней и математически обоснованно приводить рыночные котировки к стационарному виду.
Список приложенных файлов
Также все файлы выложены в хранилище Algo Forge по адресу: https://forge.mql5.io/alexeynikolaev2/Article-24041-Autoregressive-Processes
| # | Тип файла | Название | Описание |
|---|---|---|---|
| 1 | Заголовочный файл | EconometricsA.mqh | Файл со всеми необходимыми функциями (для массивов) для расчёта параметров простой регрессии, построения графиков и проведения статистических тестов. |
| 2 | Заголовочный файл | EconometricsM.mqh | Файл со всеми необходимыми функциями (для векторов и матриц) для расчёта параметров множественной регрессии, построения графиков и проведения статистических тестов. |
| 3 | MQL5 скрипт | vol1.mq5 | Скрипт для визуального анализа коррелограмм и автоматического сеточного подбора оптимальных порядков p и q в модели ARMA(p, q) для волатильности. |
| 4 | MQL5 скрипт | vol2.mq5 | Скрипт для анализа остатков подобранной ARMA-модели волатильности. |
| 5 | ZIP архив | MQL5.zip | Архив со всеми файлами. |
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Нейросети в трейдинге: Диффузионная генерация торговых планов (Окончание)
 Логика кэрри-трейда в MQL5: Создание советника, учитывающего ставки свопа при расчете размера позиции и принятии решений об удержании
 Количественный анализ совместной рекуррентности (JRQA) в MQL5: Выявление одновременной рекуррентности в двух временных рядах
 Создание индикатора Market Structure Sentinel на языке MQL5

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования