

Рыночная микроструктура в MQL5 (Часть 2): Измерение долгой памяти с помощью оценщиков Херста
 38
 0

Введение
В первой части серии мы создали защитный базовый слой: математические функции с проверками, проверку ценовых данных и устойчивые статистические функции. Каждая функция базового слоя была спроектирована так, чтобы безопасно завершаться при ошибке, а не молча продолжать работу. Теперь, когда базовый слой готов, можно приступить к первому измерению.
Главный вопрос статьи — есть ли дальняя зависимость в ценовых данных NQ на таймфрейме M1. При дальней зависимости то, что произошло час назад, остается статистически значимым для того, что происходит сейчас. При наличии такой зависимости уместен подход на основе следования за трендом. При ее отсутствии применяется логика возврата к среднему. Стандартные индикаторы не дают ответа на этот вопрос. При их расчете учитывается лишь несколько последних периодов, как будто более ранние данные не важны. В зависимости от рыночного режима такое допущение может быть верным или ошибочным. Если трейдер не различает эти случаи, он применит неподходящий подход в неподходящий момент.
Измерение долгой памяти не сводится к вычислению одного числа. Классический оценщик показателя Херста, основанный на анализе нормированного размаха (R/S), чувствителен к краткосрочной зависимости и нестационарности. Ло (1991) показал, что при наличии компонентов с короткой памятью классическая статистика R/S может давать ошибочную картину. Один оценщик дает лишь одно число — без какого-либо указания на то, насколько этому числу можно доверять.
В статье реализованы три независимых оценщика: классический метод нормированного размаха, он же R/S (Херст, 1951), метод агрегированной дисперсии и метод абсолютных моментов. Затем результаты объединяются в единую составную оценку, взвешенную по достоверности, с использованием статистических примитивов базового слоя.Итоговая оценка H и ее вес достоверности записываются прямо в соответствующие поля общей структуры RobustFractalAnalysis, определенной в первой части. Новый подключаемый файл не требуется. Четыре добавленные функции непосредственно расширяют MicroStructure_Foundation.mqh, как и планировалось.
В статье также приводится эмпирическое исследование. На данных фьючерсов NQ за 133 сессии Globex мы вычисляем H*(t) по каждому бару на таймфрейме M1 на протяжении всего торгового дня Globex. Результаты по нескольким важным пунктам расходятся с тем, что можно было бы ожидать по учебникам. Именно эти эмпирические результаты лежат в основе практических рекомендаций по пороговым значениям в заключительном разделе.
Результат работы — добавление в MicroStructure_Foundation.mqh четырех функций: HurstExponentRS(), AdvancedHurstExponent(), HurstExponentRobust() и PopulateHurstAnalysis(). Легковесный индикатор HurstProfile.mq5 отображает H*(t) на любом графике и строит три линии-ориентира, отмечающие границы режимов.
Что показатель Херста означает для трейдера NQ
Показатель Херста H характеризует дальнюю зависимость временного ряда. Гарольд Эдвин Херст ввел это понятие в 1951 году, изучая долгосрочную водоаккумулирующую способность бассейна реки Нил. H принимает значения от 0 до 1; по его значению различают три режима.
При H > 0,5 ряд персистентен. За крупными движениями обычно следуют другие крупные движения в том же направлении. При больших лагах автокорреляция доходностей положительна. В этом режиме стратегии следования за трендом имеют статистическое обоснование.
При H = 0,5 приращения не коррелируют между собой. Ряд ведет себя как случайное блуждание. Ни на одном лаге нет направленного статистического преимущества. Ни у стратегий следования за трендом, ни у стратегий возврата к среднему нет статистического преимущества.
При H < 0,5 ряд антиперсистентен. За крупными движениями вверх обычно следуют движения вниз, и наоборот. Автокорреляция отрицательна. Именно в этом режиме стратегии возврата к среднему имеют статистическое обоснование.
Значение H = 0,5 — не "безопасное нейтральное значение", а граница выбора режима. При H ниже 0,5 трейдер, выбирающий следование за трендом, идет вразрез со статистической структурой данных. Практический вопрос не в том, существует ли понятие H, а в том, успеем ли мы достаточно точно оценить H и определить режим, пока торговая возможность не исчезла.
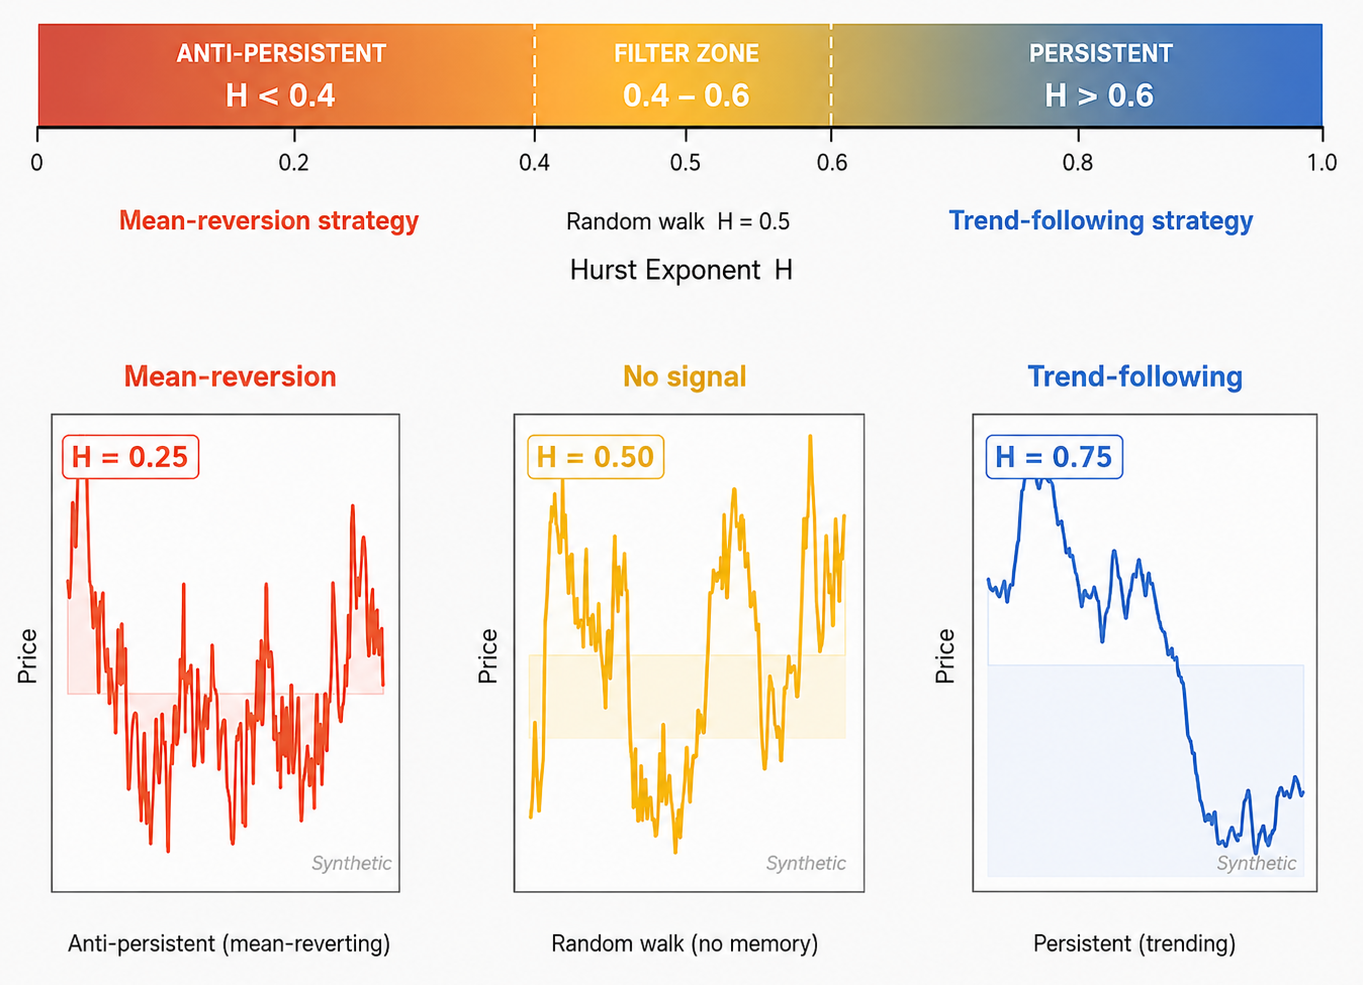
Рис. 1. Три режима H — схема выбора стратегии
Синтетические ряды: персистентность при H = 0,75, случайное блуждание при H = 0,50 и антиперсистентность при H = 0,25
Три оценщика, три ракурса
Ни один оценщик показателя Херста не надежен при всех рыночных условиях. Каждый опирается на свои допущения о данных и чувствителен к разным источникам ошибок. Решение состоит в том, чтобы запускать три независимых оценщика, а степень их согласия — или расхождения — использовать для определения доверия к итоговому результату.
Классический анализ R/S (Херст, 1951)
Статистика нормированного размаха R/S показывает величину размаха накопленных отклонений относительно стандартного отклонения исходного ряда. При масштабе n статистика R/S масштабируется как n^H. Вычислив R/S на нескольких масштабах, по наклону зависимости в логарифмических координатах получают H. Метод устойчив к тяжелым хвостам, но чувствителен к краткосрочной автокорреляции. Ло (1991) показал, что компоненты с короткой памятью могут приводить к завышению классической статистики R/S. Чтобы частично снизить этот эффект, мы применяем оценщик на масштабах, расположенных по геометрической прогрессии. Достоверность определяется числом допустимых точек регрессии: масштабы, для которых данных недостаточно для расчета R/S, не участвуют в оценке наклона.
Агрегированная дисперсия
При H > 0,5 дисперсия средних по неперекрывающимся блокам размера m масштабируется как σ²(m) ∝ m2H−2 . Наклон зависимости log(дисперсия) от log(m) дает β, после чего H = 1 + β/2. Этот оценщик менее чувствителен к диапазону масштабов, чем классический R/S, но требует большего минимального размера выборки. При стационарных данных метод работает хорошо, но тренды и структурные сдвиги ухудшают его результаты.
Абсолютные моменты
Средний модуль средних по блокам масштабируется как E[|x̄(m)|] ∝ mH−1. Наклон в логарифмических координатах дает β, после чего H = 1 + β. Этот оценщик более устойчив к тяжелым хвостам, чем метод агрегированной дисперсии. Метод остается устойчивым при лептокуртическом распределении доходностей, характерном для NQ на таймфрейме M1 вблизи открытия нью-йоркской сессии.
Каждый оценщик дает свою оценку H и свой вес достоверности. Показатель достоверности — отношение числа допустимых точек регрессии в логарифмических координатах к максимально возможному числу точек при данной длине ряда. Если оценщик дает лишь две допустимые точки масштаба, его вес достоверности составляет 0,2 при максимуме 1,0. Оценщик с семью допустимыми точками получает вес 0,7. Оценщики с весом достоверности ниже 0,1 не участвуют в объединении результатов.
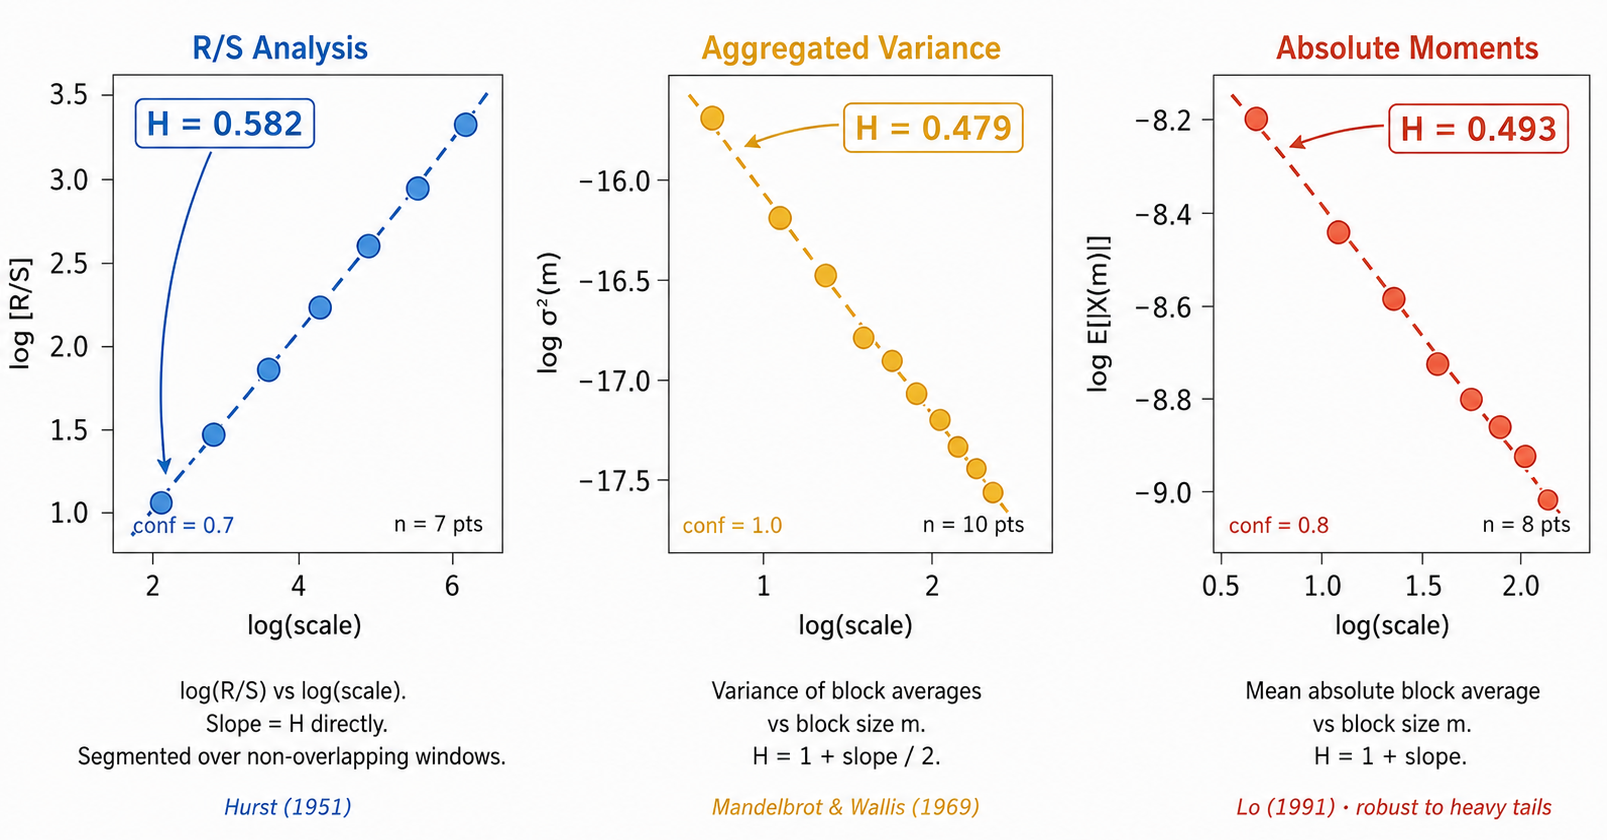
Рис. 2. Три независимых оценщика показателя Херста на реальных данных NQ M1
30 нью-йоркских сессий · только бары после открытия (10:10-12:00 ET) · сброс при начале сессии в 09:30 ET · ноябрь 2025 г. - май 2026 г.
Реализация — HurstExponentRS()
Оценщик R/S принимает предварительно проверенный массив логарифмических доходностей и ссылку на выходную переменную достоверности. Оценщик не запрашивает цены: их загрузку и проверку выполняет вызывающая функция. Поэтому оценщик остается независимым от получения данных и удобным для тестирования.
Цены закрытия не передаются напрямую ни одному оценщику. Входными данными служат логарифмические доходности: они стационарны в слабом смысле, в отличие от уровней цен. Преобразование задается следующим образом:
r i=log(close i)−log(close i+1)
Значения доходности с модулем выше 0,1 отбрасываются как артефакты данных. На NQ с таймфреймом M1 подлинная доходность 10% за минуту не возникает: столь большое значение указывает на ошибочный тик, смену контракта или аномалию потока котировок. Функция SafeLog() базового слоя обрабатывает неположительную цену закрытия еще до попытки выполнить вычитание.
Размеры окон образуют геометрическую последовательность: 8, 16, 32, 64 и т.д. — вплоть до предела, который допускает объем данных. На каждом масштабе R/S вычисляется по неперекрывающимся сегментам, затем результаты усредняются. Расчет по отдельным сегментам снижает влияние одного аномального окна и дает более устойчивую оценку наклона, чем расчет R/S по всему ряду на каждом масштабе.
//+------------------------------------------------------------------+
//| HurstExponentRS: classical rescaled-range (R/S) estimator.       |
//| Computes log(E[R/S]) ~ H * log(n) across geometrically spaced    |
//| window sizes. Each scale is averaged over non-overlapping        |
//| segments so that the estimate is less sensitive to a single      |
//| anomalous window.                                                |
//|                                                                  |
//| Parameters                                                       |
//|   returns[]   — log-return array, oldest first                   |
//|   n           — number of valid returns                          |
//|   confidence  — output: k / HURST_RS_MAX_SCALES                  |
//|                                                                  |
//| Returns H in [0.01, 0.99]. Returns 0.5 on insufficient data.     |
//+------------------------------------------------------------------+
double HurstExponentRS(const double &returns[], int n, double &confidence)
  {
   confidence = 0.0;
   if(n < 30) return 0.5;

   int    m_max = (int)MathMax(10, n / 4);
   double log_n[10], log_rs[10];
   int    k     = 0;
   int    scale = 8;

   while(scale <= m_max && k < HURST_RS_MAX_SCALES)
     {
      int segs = n / scale;
      if(segs < 2) { scale *= 2; continue; }

      double rs_sum = 0.0;
      int    v      = 0;

      for(int seg = 0; seg < segs; seg++)
        {
         int    st  = seg * scale;
         double s1  = 0.0, s2 = 0.0;
         for(int j = 0; j < scale; j++)
           { s1 += returns[st + j]; s2 += returns[st + j] * returns[st + j]; }

         double mu  = s1 / scale;
         //--- Two-pass variance: stable against catastrophic cancellation
         double var = (s2 - scale * mu * mu) / (scale - 1);
         if(var <= 0) continue;

         double mx = -1e100, mn = 1e100, cum = 0.0;
         for(int j = 0; j < scale; j++)
           {
            cum += returns[st + j] - mu;
            if(cum > mx) mx = cum;
            if(cum < mn) mn = cum;
           }

         double rng = mx - mn;
         if(rng > 0)
           { rs_sum += SafeLog(rng / SafeSqrt(var)); v++; }
        }

      if(v > 0)
        { log_n[k] = SafeLog((double)scale); log_rs[k] = rs_sum / v; k++; }

      scale *= 2;
     }

   if(k < 3) return 0.5;

   double h = LinearRegressionSlope(log_n, log_rs, k);
   confidence = (double)k / HURST_RS_MAX_SCALES;
   return MathMax(0.01, MathMin(0.99, h));
  }
Наклон вычисляется только при наличии не менее трех допустимых точек регрессии — это обязательная защитная проверка. Две точки однозначно задают прямую: это интерполяция, а не регрессия. Три точки уже позволяют выполнить аппроксимацию методом наименьших квадратов. При k = 3 показатель достоверности равен 0,3, поэтому видно, что оценка основана на малом числе точек.
Во внутреннем цикле для расчета дисперсии в два прохода используется стандартное тождество: Var = (сумма квадратов - n * среднее²) / (n - 1). При небольших размерах сегментов такой расчет численно устойчив, поскольку логарифмические доходности сосредоточены около нуля. Функции SafeLog() и SafeSqrt() базового слоя защищают завершающий этап от отрицательных и нулевых аргументов.
Реализация — AdvancedHurstExponent()
Вторая функция реализует оба метода — агрегированной дисперсии и абсолютных моментов — с переключением между ними. В обоих случаях применяется одна схема регрессии в логарифмических координатах; различается только агрегируемая величина.
Для режима агрегированной дисперсии (method = 0) наклон β зависимости log(дисперсия средних по блокам) от log(размер блока m) дает H = 1 + β/2. Для дробно-интегрированного процесса с показателем самоподобия H дисперсия средних по неперекрывающимся блокам убывает как m2H−2. При H = 0,5, то есть случайном блуждании, дисперсия убывает пропорционально 1/m, как следует из центральной предельной теоремы. При H > 0,5 дисперсия убывает медленнее: у ряда есть долгая память, а средние по соседним блокам коррелируют.
Для режима абсолютных моментов (method = 1) наклон β зависимости log(средний модуль среднего по блоку) от log(m) дает H = 1 + β. Для каждого сегмента требуется не менее 15 значений доходности вместо 10: абсолютный момент менее эффективен как статистический показатель, чем дисперсия.
//+------------------------------------------------------------------+
//| AdvancedHurstExponent: aggregated variance (method = 0) or       |
//| absolute moments (method = 1) estimator.                         |
//|                                                                  |
//| AggVar:  H = 1 + beta/2  where beta = slope of log(var) ~ log(m) |
//| AbsMom:  H = 1 + beta    where beta = slope of log(E|x|)~log(m)  |
//|                                                                  |
//| Returns H in [0.01, 0.99]; 0.5 with confidence = 0.0 on failure. |
//+------------------------------------------------------------------+
double AdvancedHurstExponent(const double &returns[], int n,
                              int method, double &confidence)
  {
   confidence = 0.0;

   //--- AggVar: min 10 returns per segment; AbsMom: min 15
   int min_per_seg = (method == 0) ? 10 : 15;
   if(n < min_per_seg * 2) return 0.5;

   int    max_scales = (method == 0) ? HURST_AV_MAX_SCALES : HURST_AM_MAX_SCALES;
   int    max_agg    = (int)MathMin(max_scales + 1, n / min_per_seg);
   double log_m[10], log_stat[10];
   int    k = 0;

   for(int m = 2; m <= max_agg && k < max_scales; m++)
     {
      int    segs = n / m;
      if(segs < 2) continue;

      double stat = 0.0;
      for(int seg = 0; seg < segs; seg++)
        {
         int    st   = seg * m;
         double sum  = 0.0;
         for(int j = 0; j < m; j++) sum += returns[st + j];
         double xbar = sum / m;
         stat += (method == 0) ? xbar * xbar : MathAbs(xbar);
        }

      stat /= segs;
      if(stat <= 0) continue;

      log_m   [k] = SafeLog((double)m);
      log_stat[k] = SafeLog(stat);
      k++;
     }

   if(k < 3) return 0.5;

   double beta = LinearRegressionSlope(log_m, log_stat, k);
   double h    = (method == 0) ? 1.0 + beta / 2.0 : 1.0 + beta;
   confidence  = (double)k / max_scales;
   return MathMax(0.01, MathMin(0.99, h));
  }
Переключение метода позволяет оставить оба режима в одной функции: структура внешнего цикла у них одинакова. Разделение режимов на две функции привело бы к повторению примерно 30 строк кода внешнего цикла из-за различия всего в одной строке внутреннего накопления. Значение параметра method в точке вызова всегда известно на этапе компиляции, поэтому во время выполнения нет затрат на выбор режима.
Реализация — HurstExponentRobust()
Функция объединения вызывает всех трех оценщиков, получает их веса достоверности и возвращает взвешенное среднее. Эта же функция загружает цены и вычисляет логарифмические доходности, поэтому отдельным оценщикам не приходится выполнять эти действия.
Нужно пояснить одно архитектурное решение — сброс окна на границе сессии. Если скользящее окно захватывает данные до открытия сессии и после него, в распределении доходностей возникает структурный сдвиг. Например, в 09:33 ET период анализа длиной 90 баров содержит 86 баров до открытия и только четыре после него. До открытия рынка данные NQ на таймфрейме M1 разрежены: активность участников низкая, а на движение влияет ночное позиционирование. После открытия активность участников выше, а движение в большей мере определяется потоком ордеров институциональных трейдеров. Если объединить оба периода в одной регрессии, полученное H не будет точно описывать ни один из режимов. В следующем разделе этот эффект показан на эмпирических данных. Чтобы избежать смешивания, при расчете внутридневного H вызывающий код должен устанавливать параметр period по числу баров, прошедших с открытия сессии.
//+------------------------------------------------------------------+
//| HurstExponentRobust: confidence-weighted blend of three          |
//| independent Hurst estimators.                                    |
//|                                                                  |
//| Session reset requirement: the period parameter should count     |
//| only bars from the current trading session. Mixing pre-open and  |
//| post-open bars creates a structural break that compresses H      |
//| artificially toward 0.5. See the empirical study section for     |
//| a demonstration on NQ M1 Globex data.                            |
//|                                                                  |
//| Returns H in [0.01, 0.99]. Returns 0.5 with confidence = 0.0     |
//| when HURST_MIN_BARS is not satisfied.                            |
//+------------------------------------------------------------------+
double HurstExponentRobust(const string symbol, const int tf,
                            const int period, double &confidence)
  {
   confidence = 0.0;
   if(!ValidateSymbolV2(symbol) || period < HURST_MIN_BARS) return 0.5;

   //--- Fetch and validate close prices
   double close[];
   int    n = SafeCopyClose(symbol, tf, 0, period, close);
   if(n < HURST_MIN_BARS) return 0.5;

   //--- Build log-return array; discard extreme values
   double returns[];
   ArrayResize(returns, n - 1);
   int valid = 0;

   for(int i = 0; i < n - 1; i++)
     {
      if(close[i] <= 0 || close[i + 1] <= 0) continue;
      double r = SafeLog(close[i]) - SafeLog(close[i + 1]);
      if(MathAbs(r) < 0.1) returns[valid++] = r;
     }

   if(valid < HURST_MIN_BARS) { confidence = 0.1; return 0.5; }
   ArrayResize(returns, valid);

   //--- Run all three estimators independently
   double conf_rs, conf_av, conf_am;
   double h_rs = HurstExponentRS(returns, valid, conf_rs);
   double h_av = AdvancedHurstExponent(returns, valid, 0, conf_av);
   double h_am = AdvancedHurstExponent(returns, valid, 1, conf_am);

   //--- Confidence-weighted blend; exclude sparse estimators
   double weighted_sum = 0.0, total_weight = 0.0;

   if(conf_rs > HURST_CONF_THRESHOLD)
     { weighted_sum += h_rs * conf_rs; total_weight += conf_rs; }
   if(conf_av > HURST_CONF_THRESHOLD)
     { weighted_sum += h_av * conf_av; total_weight += conf_av; }
   if(conf_am > HURST_CONF_THRESHOLD)
     { weighted_sum += h_am * conf_am; total_weight += conf_am; }

   if(total_weight <= 0) { confidence = 0.1; return 0.5; }

   double h_final = weighted_sum / total_weight;
   confidence = MathMin(1.0, total_weight / 3.0);

   return MathMax(0.01, MathMin(0.99, h_final));
  }
При нормализации показателя достоверности общий вес делится на 3,0: в расчете участвуют три оценщика, каждый с полным весом. Если все три оценщика получают максимальный вес, total_weight = 3.0, а выходной показатель достоверности confidence = 1.0. Если с полным весом участвуют только два оценщика, выходной показатель confidence = 0.67. Это дает вызывающему коду понятный сигнал о том, сколько независимых оценщиков подтвердили оценку H.
Вспомогательная функция-обертка PopulateHurstAnalysis() вызывает HurstExponentRobust() и записывает результат прямо в общую структуру:
//+------------------------------------------------------------------+
//| PopulateHurstAnalysis: fills RobustFractalAnalysis from one call.|
//| Writes hurst_exponent, hurst_confidence, volatility_persistence, |
//| computation_status, and validation_message. All other fields in  |
//| result are left unchanged so later parts can add their output    |
//| to the same struct without overwriting Hurst values.             |
//+------------------------------------------------------------------+
void PopulateHurstAnalysis(const string symbol, const int tf,
                            const int period,
                            RobustFractalAnalysis &result)
  {
   double confidence = 0.0;
   double h          = HurstExponentRobust(symbol, tf, period, confidence);

   result.hurst_exponent         = h;
   result.hurst_confidence       = confidence;
   //--- Persistence: 0 at H=0.5 (random walk), 1 at H=0 or H=1
   result.volatility_persistence = 2.0 * MathAbs(h - 0.5);

   if(confidence < HURST_CONF_THRESHOLD)
     {
      result.computation_status = 1;
      result.validation_message =
         StringFormat("HurstExponentRobust: confidence %.3f below threshold"
                      " — insufficient session data for %s tf %d",
                      confidence, symbol, tf);
     }
   else
     {
      result.computation_status = 0;
      result.validation_message = "OK";
     }
  }
Индикатор HurstProfile
Легковесный индикатор HurstProfile.mq5 отображает H*(t) в отдельном подокне с тремя линиями-ориентирами. Индикатор вызывает функцию HurstExponentRobust() из базового заголовочного файла; дополнительный подключаемый файл не требуется.
Индикатор использует три буфера. Первый буфер, H_buffer, отображает линию итоговой оценки H. Второй буфер, Conf_buffer, отображает показатель достоверности; его можно скрыть входным параметром InpShowConfidence. Третий буфер, Regime_buffer, выводит гистограмму: +1 при H выше порога персистентности, -1 при H ниже порога антиперсистентности и 0 в переходной зоне. Такое кодирование помогает быстро оценить состояние рынка, не разбирая точное значение H.
Структура папок выглядит следующим образом:
MQL5\
└── Indicators\
    └── HurstProfile\
        ├── HurstProfile.mq5
        └── Includes\
            └── MicroStructure_Foundation.mqh
В файле HurstProfile.mq5 директива include использует относительный путь:
#include "Includes\MicroStructure_Foundation.mqh"
Функция OnCalculate() работает по стандартной схеме rates_total / prev_calculated. При первом вызове обрабатываются все бары, начиная с InpPeriod. При последующих вызовах рассчитывается только новый бар. Так исключаются повторные расчеты, и индикатор быстрее реагирует на поступающие данные.
int OnCalculate(const int rates_total,
                const int prev_calculated,
                const datetime &time[],
                const double &open[],
                const double &high[],
                const double &low[],
                const double &close[],
                const long &tick_volume[],
                const long &volume[],
                const int &spread[])
  {
   //--- Need at least InpPeriod + 1 bars before any output is possible
   if(rates_total < InpPeriod + 1) return 0;

   //--- On first call fill pre-period bars with EMPTY_VALUE explicitly
   if(prev_calculated == 0)
     {
      for(int i = 0; i < InpPeriod; i++)
        {
         H_buffer     [i] = EMPTY_VALUE;
         Conf_buffer  [i] = EMPTY_VALUE;
         Regime_buffer[i] = EMPTY_VALUE;
        }
     }

   //--- Start bar: on first call process all bars from InpPeriod onward;
   //--- on subsequent calls recalculate only the last bar
   int start = (prev_calculated == 0) ? InpPeriod : prev_calculated - 1;

   for(int i = start; i < rates_total; i++)
     {
      double conf = 0.0;
      double h    = HurstFromClose(close, i, InpPeriod, conf);

      H_buffer   [i] = h;
      Conf_buffer[i] = conf;

      //--- Regime: 0.0 when confidence is too low to trust (matches article)
      if(conf < HURST_CONF_THRESHOLD)
         Regime_buffer[i] = 0.0;
      else if(h >= InpPersistThresh)
         Regime_buffer[i] =  1.0;   	// Persistent — trend-following conditions
      else if(h <= InpAntiPersThresh)
         Regime_buffer[i] = -1.0;   	// Anti-persistent — mean-reversion conditions
      else
         Regime_buffer[i] =  0.0;   	// Transition zone — no directional bias
     }

   return rates_total;
  }
Эмпирическое исследование — что показывают данные NQ на таймфрейме M1
Теория определяет, что показатель H измеряет. Данные показывают, какие значения H получаются на конкретном инструменте в реальных условиях. Теория и данные не всегда согласуются. Если они расходятся, приоритет у данных.
В исследовании использованы данные 133 сессий Globex по фьючерсу NQ ближайшего месяца поставки с ноября 2025 года по май 2026 года. Все данные относятся к таймфрейму M1; временные метки указаны по восточному времени. Функция HurstExponentRobust() на Python написана с нуля по спецификации MQL5: используются те же три оценщика, те же веса достоверности и тот же фильтр логарифмических доходностей. Результаты сравнили с показаниями индикатора NT8; корреляция составила 0,60. Корреляция составляет 0,60: версия NT8 использует историю за несколько дней, а анализ на Python — только данные текущей сессии. Это наглядно показывает эффект сброса на границе сессии.
Вывод 1 — NQ на таймфрейме M1 находится вблизи границы случайного блуждания
За 133 сессии среднее H*(t) в пределах нью-йоркской сессии находится в диапазоне 0,47-0,50 — у границы случайного блуждания. На объединенных данных после открытия (рис. 2) оценщик R/S дает H = 0,582, оценщик агрегированной дисперсии — H = 0,479, а оценщик абсолютных моментов — H = 0,493. Итоговая оценка со взвешиванием по достоверности составляет 0,511. Скользящее среднее по барам на рисунке 4 немного ниже — 0,47-0,49. Это отражает шум оценивания на коротком периоде анализа в 90 баров. Оба результата согласуются: NQ на таймфрейме M1 находится вблизи границы случайного блуждания: выраженной памяти ни в одном из направлений нет. Практический вывод: одного H недостаточно для надежной классификации режимов на NQ с таймфреймом M1. H полезен как фильтр: по нему можно проверить, согласуются ли рыночные условия с сигналом, полученным другим способом.
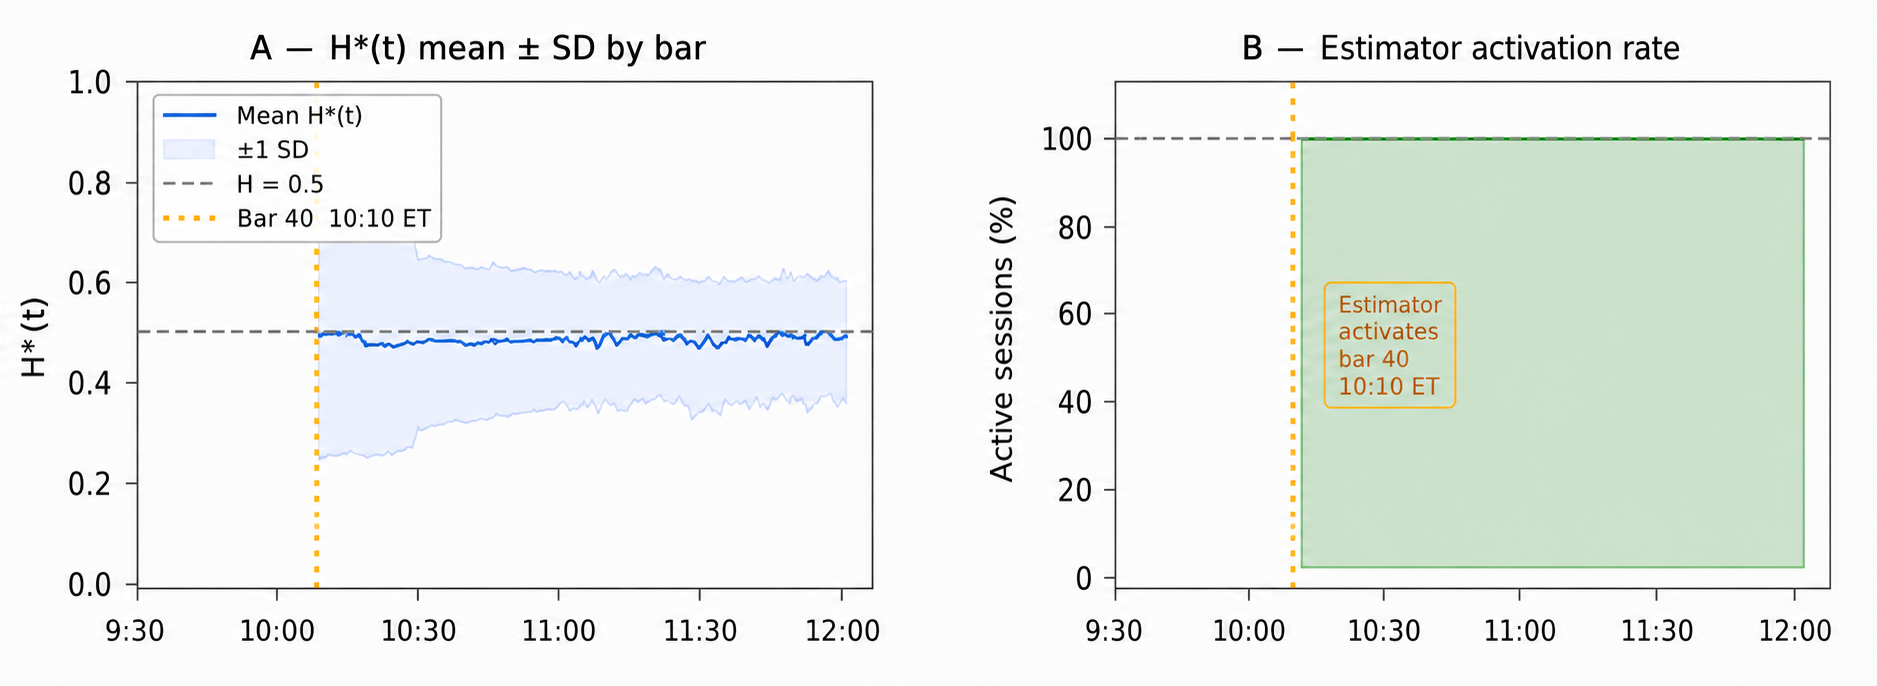
Рис. 3. Стабилизация H*(t) в пределах нью-йоркской сессии
NQ M1 Globex · 133 сессии · ноябрь 2025 г. - май 2026 г. · сброс на границе сессии в 09:30 ET
Вывод 2 — для активации оценщика требуется 40 баров после открытия
При периоде анализа в 90 баров и сбросе в 09:30 ET нужны как минимум 40 баров после открытия, чтобы каждый из трех оценщиков получил не менее трех допустимых точек регрессии в логарифмических координатах. До 40-го бара (10:10 ET) функция возвращает значение по умолчанию H = 0,5 при confidence = 0.0. На панели B рисунка 3 видна граница активации оценщика: ровно на 40-м баре доля успешных активаций скачком возрастает с 0% до 100%.
Вывод 3 — в скользящем окне нельзя смешивать данные до открытия сессии и после него
Без сброса на границе сессии в 09:33 ET скользящее окно содержит 86 баров до открытия и лишь четыре после него. В таком смешанном окне среднее H падает до 0,37 — на 0,09 ниже фактического базового уровня после открытия. Это не сигнал о смене режима. Это артефакт измерения: его вызывает структурный разрыв между двумя процессами формирования данных. Сброс в начале сессии устраняет артефакт: в 09:30 ET отсчет окна начинается заново. При оценке внутридневного режима вызывающий код должен передавать функции HurstExponentRobust() только число баров с момента открытия сессии.
Вывод 4 — в этой выборке H не дает статистически значимого прогноза краткосрочного трендового движения
При переборе параметров проверили семь баров измерения с 10:10 до 11:30 ET и четыре последующих окна — 15, 30, 45 и 60 баров. Статистически значимой связи между H и тем, будет ли следующее окно трендовым или пилообразным, не обнаружено. Лучший результат — измерение на 40-м баре с окном следующих 15 баров — дал p-значение критерия Манна — Уитни 0,094. На данных 133 сессий оно не достигло принятого порога 0,05.
Отсутствие значимого результата можно объяснить устройством измерения. В этом контексте отрицательный результат полезнее положительного. NQ на таймфрейме M1 находится у границы случайного блуждания: на объединенных данных H со взвешиванием по достоверности ≈ 0,51, скользящее среднее ≈ 0,48. Поэтому изменения H между сессиями в основном отражают шум вокруг границы, а не сигнал смены режима. Сессии с выраженным трендом здесь аномальны; оценщик Херста измеряет среднюю дальнюю корреляцию за прошедший период и не позволяет надежно распознавать такие сессии заранее. Оценщик полезен для определения положения рынка относительно границы случайного блуждания, а не для прогноза исхода конкретного дня.
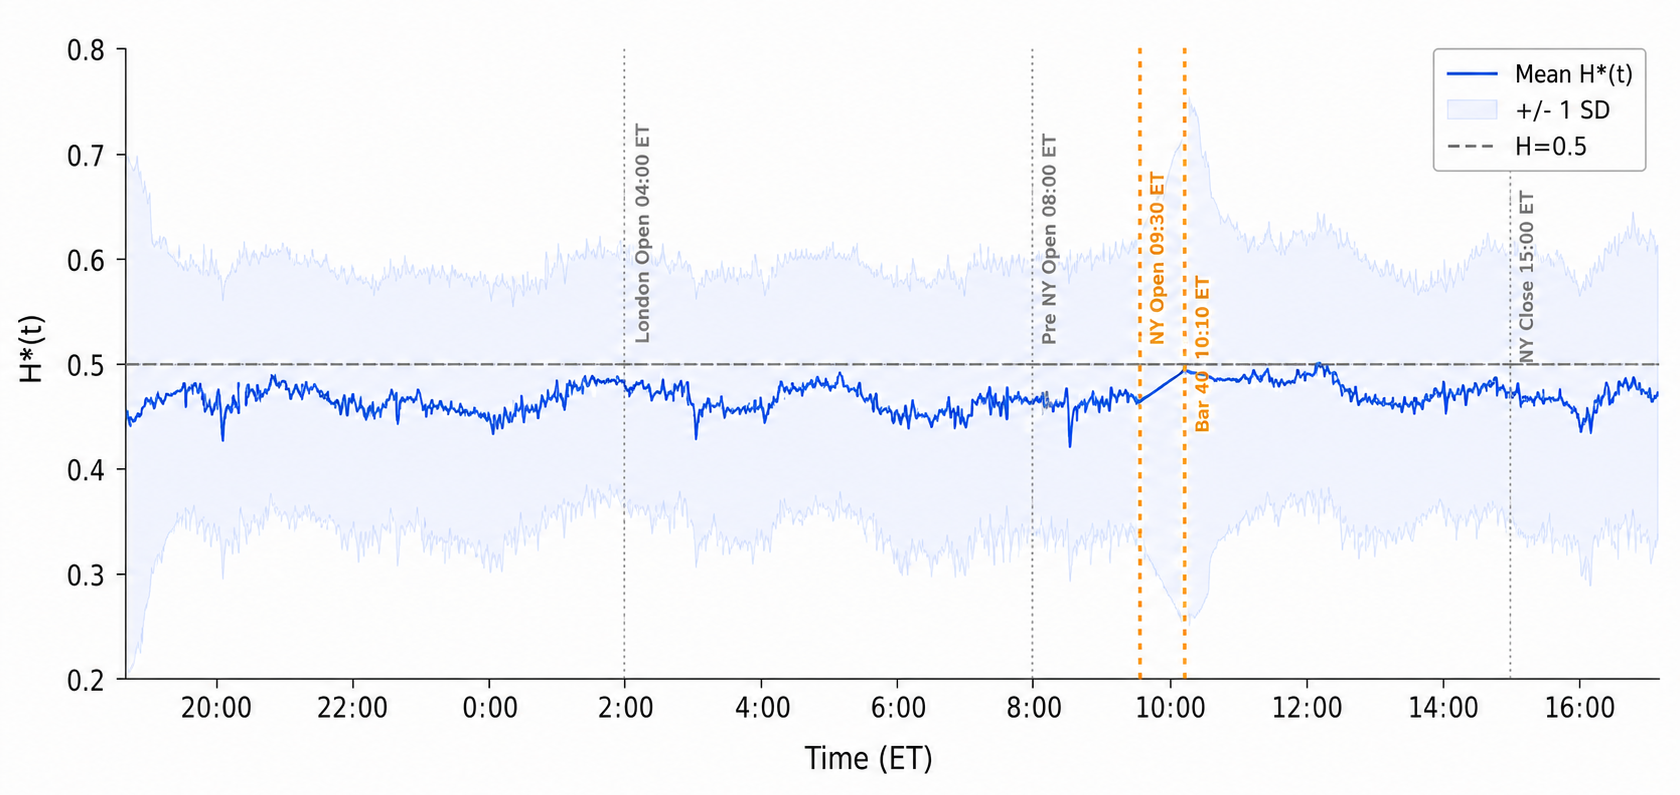
Рис. 4. Внутридневной профиль H*(t) для фьючерсов NQ на таймфрейме M1 в Globex
Среднее ± 1 стандартное отклонение — 133 сессии — ноябрь 2025 г. - май 2026 г.
Интерпретация результатов — практические пороговые значения
Результаты исследования уточняют теоретические границы режимов. Пороги ниже получены из данных NQ на таймфрейме M1, а не взяты из учебных рекомендаций.
Базовый режим NQ на таймфрейме M1 близок к границе случайного блуждания. По объединенным данным после открытия итоговая оценка со взвешиванием по достоверности равна H = 0,511; скользящее среднее по барам дает H ≈ 0,48. Оба значения близки к 0,5. Значение H в диапазоне 0,40-0,60 не дает оснований выбирать направление торговли: это базовый уровень, а не сигнал. Значение H становится значимым, только если устойчиво выходит за пределы этого диапазона.
Итоговая оценка H выше 0,60 при достоверности выше 0,30 указывает на положительную дальнюю автокорреляцию при текущем числе баров. Вход по трендовому сигналу имеет статистическое обоснование. Итоговая оценка H ниже 0,40 при том же пороге достоверности подтверждает усиление антиперсистентного режима — здесь уместны стратегии возврата к среднему. В переходной зоне 0,40-0,60 не следует делать ставку на направление движения. В таких условиях стоит пропустить сделку, уменьшить размер позиции или дождаться следующего бара, на котором будет рассчитан показатель.
Достоверность ниже 0,30 означает, что допустимыми оказались менее 30% от максимально возможного числа точек регрессии. Оценка H может быть точной, но данных недостаточно, чтобы на нее опираться. Считайте, что показание отсутствует.
//--- Practical usage: check H and confidence before acting
double conf = 0.0;
double H    = HurstExponentRobust(Symbol(), PERIOD_M1, bars_since_open, conf);

if(conf < 0.30)
  {
   // Insufficient data — no regime call
  }
else if(H > 0.60)
  {
   // Persistent regime — trend-following conditions
  }
else if(H < 0.40)
  {
   // Anti-persistent regime — mean-reversion conditions
  }
else
  {
   // Transition zone — no directional bias
  }
Переменная bars_since_open должна подсчитывать только бары после открытия сессии в 09:30 ET. Если использовать весь период анализа без сброса на границе сессии, оценка H будет искажена, как показано в третьем выводе исследования.
В третьей части данной серии итоговая оценка H служит входным значением для оценки параметра дробного дифференцирования модели ARFIMA. Там подробно рассматривается связь H с параметром дифференцирования d: для дробно-интегрированного процесса d = H-0,5.
Заключение
В этой статье мы дополнили файл MicroStructure_Foundation.mqh четырьмя функциями для оценки показателя Херста со взвешиванием по достоверности на внутридневных данных M1. Добавлены функции HurstExponentRS(), AdvancedHurstExponent(), HurstExponentRobust() и PopulateHurstAnalysis(). Новый подключаемый файл не требуется: вставьте блок дополнений из второй части перед закрывающей директивой #endif базового заголовочного файла.
Эта реализация обеспечивает пять гарантий:
- ни один оценщик не выдает NaN или Inf;
- вырожденные масштабы пропускаются;
- для возврата H требуется не менее 40 баров;
- результаты ограничиваются интервалом [0,01; 0,99];
- показатель достоверности ограничивается диапазоном [0,0; 1,0].
Исследование данных по фьючерсам NQ на таймфрейме M1 за 133 сессии Globex дало четыре вывода, важных для каждого, кто использует этот код. NQ на таймфрейме M1 находится вблизи границы случайного блуждания: итоговая оценка со взвешиванием по достоверности на объединенных данных составляет H = 0,511, а скользящее среднее по барам — H ≈ 0,48. Оценки трех оценщиков располагаются по разные стороны от 0,5. Оценщик начинает работать после появления 40 баров с момента открытия сессии. В скользящем окне нельзя смешивать данные до открытия сессии и после него. На выборке из 133 сессий итоговая оценка H не дает статистически значимого прогноза внутридневного тренда. Но она показывает положение рынка относительно границы случайного блуждания — именно так показатель Херста следует использовать для фильтрации режимов.
Легковесный индикатор HurstProfile.mq5 можно добавить на любой график с таймфреймом M1. Он отображает H*(t) в подокне вместе с тремя опорными линиями и гистограммой режима. Это инструмент визуализации для воспроизведения исследования в MetaTrader 5: запустите его на данных CFD и сравните внутридневной профиль с полученным здесь базовым профилем фьючерсов.
Список литературы
- Hurst, H.E. (1951). Long-term storage capacity of reservoirs. Transactions of the American Society of Civil Engineers, 116, 770–799.
- Lo, A.W. (1991). Long-term memory in stock market prices. Econometrica, 59(5), 1279–1313.
- Mandelbrot, B.B., and Wallis, J.R. (1969). Robustness of the rescaled range R/S in the measurement of noncyclic long-run statistical dependence. Water Resources Research, 5(5), 967–988.
- Njoroge, P.M. (2026). Beyond the Clock (Part 1): Building Activity and Imbalance Bars in Python and MQL5. Статьи сообщества MQL5.
- Engle, R. (2000). The econometrics of ultra-high-frequency data. Econometrica, 68(1), 1–22.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22553
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 От начального к среднему уровню: Подокна (I)
 За пределами GARCH (Часть III): Построение MMAR и вердикт
 Нейросети в трейдинге: Управление риском через распределение результатов (Окончание)
 GoertzelBrain: Адаптивное спектральное обнаружение циклов с помощью ансамбля нейронных сетей в MQL5

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования