

За пределами GARCH (Часть V): Подгонка мультифрактального спектра в MQL5
 58
 0

Введение
В четвертой части мы реализовали модуль анализа разбиений, который получает исходные ценовые данные, вычисляет функцию масштабирования tau(q), оценивает показатель Херста и определяет, обладают ли данные мультифрактальными свойствами. Результат работы модуля — кривая tau(q), которая кодирует, как статистические моменты разных порядков масштабируются по временному масштабу. Однако одной кривой недостаточно для построения синтетических ценовых траекторий. Чтобы построить мультипликативный каскад, формирующий мультифрактальное торговое время, нам нужны конкретное распределение и его параметры.
В этой статье мы восполним этот пробел. Мы реализуем модуль подгонки спектра, который преобразует исходную кривую tau(q) в подогнанное вероятностное распределение, готовое к использованию в моделировании. Процесс состоит из двух этапов. Сначала с помощью преобразования Лежандра получаем из tau(q) спектр сингулярностей f(alpha) — представление мультифрактальной структуры, которое легче интерпретировать физически. Затем подгоняем к эмпирическому спектру четыре распределения-кандидата методом оптимизации с ограничениями — BLEIC из ALGLIB. Затем выбираем модель с наименьшей суммой квадратов ошибок (SSE). Параметры выбранной модели будут использоваться генератором каскада в шестой части.
Мы рассмотрим следующие темы:
- От tau(q) к f(alpha) — преобразование Лежандра
- Четыре теоретические модели спектра
- Оптимизация с ограничениями методом BLEIC
- Класс CSpectrumFitter
- Запуск полного пайплайна
- Заключение
От tau(q) к f(alpha) — преобразование Лежандра
Функция масштабирования tau(q) показывает, как q-й момент доходностей меняется с временным масштабом. Но есть более наглядное представление мультифрактальной структуры — спектр сингулярностей f(alpha). Здесь alpha — локальный показатель Гельдера, характеризующий неровность или гладкость процесса в заданной точке; f(alpha) — фрактальная размерность множества точек с таким показателем. Широкая кривая f(alpha) указывает на разнообразие локального масштабирования — характерный признак мультифрактальности.
Эти два представления связаны преобразованием Лежандра:
alpha(q) = d(tau(q)) / dq

f(alpha) = q * alpha(q) - tau(q)
Согласно первому уравнению, alpha при заданном q равна наклону кривой tau(q) в этой точке. Второе уравнение позволяет вычислить f(alpha) из соотношения для касательной. Анимация на рисунке 1 показывает этот процесс. Касательная движется вдоль кривой tau(q): в каждой точке ее наклон дает alpha, а формула, следующая из уравнения касательной, — f(alpha). Справа точка за точкой строится спектр сингулярностей — характерная параболическая кривая, ширина которой показывает степень мультифрактальности.
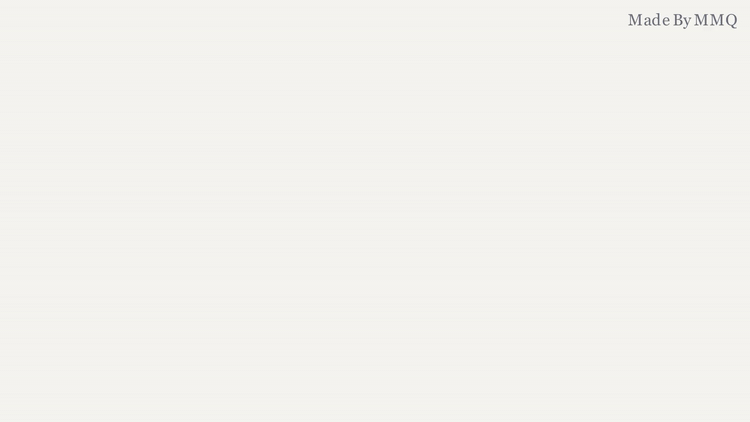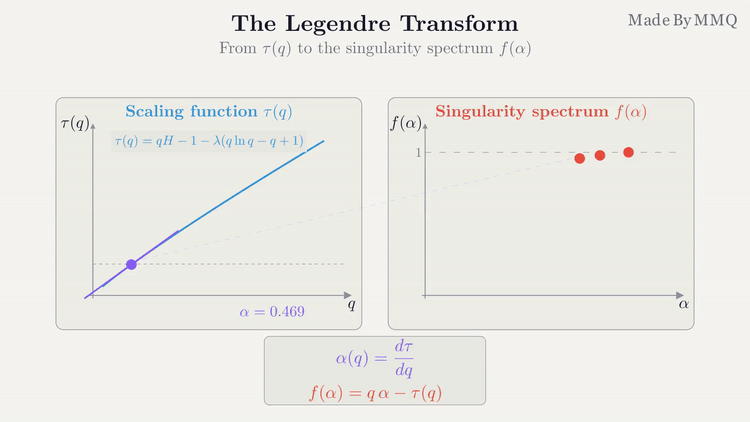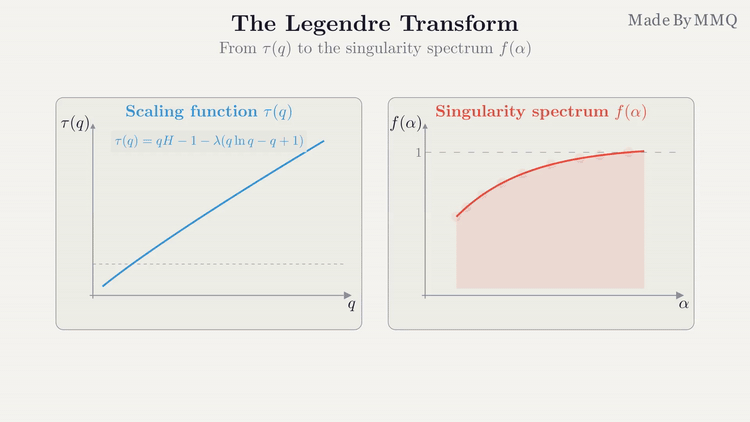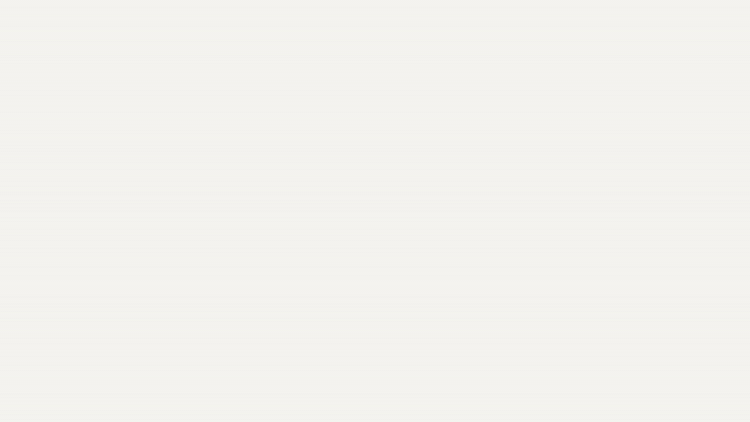
Рис. 1. Преобразование Лежандра в действии — каждому наклону касательной к tau(q) соответствует точка спектра сингулярностей f(alpha)
Поскольку tau(q) задана в дискретных точках, производную приближенно вычисляем с помощью центральных конечных разностей:
//+------------------------------------------------------------------+
//| ComputeSpectrum - Legendre transform: tau(q) → f(alpha)          |
//+------------------------------------------------------------------+
bool CSpectrumFitter::ComputeSpectrum(void)
  {
   double temp_alpha[];
   double temp_f[];
   ArrayResize(temp_alpha, m_n_q);
   ArrayResize(temp_f, m_n_q);
   int count = 0;

   for(int i = 1; i < m_n_q - 1; i++)
     {
      if(m_q_values[i] < 0.5)
         continue;

      double q_prev = m_q_values[i - 1];
      double q_next = m_q_values[i + 1];
      double tau_prev = m_tau_q[i - 1];
      double tau_next = m_tau_q[i + 1];

      double dq = q_next - q_prev;
      if(MathAbs(dq) < 1e-15)
         continue;

      double alpha = (tau_next - tau_prev) / dq;
      double f_alpha = alpha * m_q_values[i] - m_tau_q[i];

      if(!MathIsValidNumber(alpha) || !MathIsValidNumber(f_alpha))
         continue;

      if(f_alpha < -0.5)
         continue;

      temp_alpha[count] = alpha;
      temp_f[count] = f_alpha;
      count++;
     }

   if(count < 3)
     {
      Print("SpectrumFitter::ComputeSpectrum - only ", count, " valid spectrum points");
      return false;
     }

   m_n_spectrum = count;
   ArrayResize(m_alpha, count);
   ArrayResize(m_f_alpha, count);
   ArrayCopy(m_alpha, temp_alpha, 0, 0, count);
   ArrayCopy(m_f_alpha, temp_f, 0, 0, count);

   double a_min = m_alpha[0], a_max = m_alpha[0];
   double f_max = m_f_alpha[0];
   int f_max_idx = 0;
   for(int i = 1; i < m_n_spectrum; i++)
     {
      if(m_alpha[i] < a_min)
         a_min = m_alpha[i];
      if(m_alpha[i] > a_max)
         a_max = m_alpha[i];
      if(m_f_alpha[i] > f_max)
        {
         f_max = m_f_alpha[i];
         f_max_idx = i;
        }
     }

   PrintFormat("SpectrumFitter: %d spectrum points, alpha=[%.4f, %.4f], peak at alpha_0=%.4f f=%.4f",
               m_n_spectrum, a_min, a_max, m_alpha[f_max_idx], f_max);

   return true;
  }
В реализации принято несколько решений. Мы пропускаем q ниже 0,5: при очень малых q в функции разбиения преобладают доходности около нуля, поэтому численная оценка производной ненадежна. Для точности второго порядка используем центральную разность (tau[i+1] - tau[i-1]) / (q[i+1] - q[i-1]), а не прямую или обратную. Мы также отбрасываем точки спектра, где f(alpha) ниже -0,5. Функция f(alpha) описывает фрактальную размерность и теоретически должна быть неотрицательной. Однако погрешности дискретного вычисления производной могут давать небольшие отрицательные значения. Порог -0,5 достаточно мягкий, чтобы сохранять пограничные точки, но отбрасывать явно бессмысленные значения.
В результате получаем эмпирический спектр — набор пар (alpha, f(alpha)), образующих примерно параболическую кривую. Пик этой кривой приходится на alpha_0, где f(alpha_0) должна быть близка к 1,0 — фрактальной размерности всего временного ряда. Ширина кривой показывает степень мультифрактальности: чем шире спектр, тем неоднороднее масштабирование.
Четыре теоретические модели спектра
Получив эмпирический спектр, нужно подогнать к нему параметрическую модель. От выбранной модели зависит распределение, по которому будут генерироваться множители каскада при моделировании. В библиотеке реализованы четыре модели-кандидата с разными теоретическими основаниями и числом параметров.
Нормальный спектр
В простейшей модели множители каскада выбираются из логнормального распределения. Теоретический спектр — парабола с ветвями, направленными вниз, и центром при alpha_0:
f(α) = 1 - (α - α₀)^2 / [4H(α₀ - H)]
//+------------------------------------------------------------------+
//| Normal spectrum model: f(alpha) = 1 - (alpha-a0)^2 / [4H(a0-H)]  |
//+------------------------------------------------------------------+
double CSpectrumFitter::NormalSpectrum(double alpha, double alpha_0, double H)
  {
   double denom = 4.0 * H * (alpha_0 - H);
   if(denom <= 0.0)
      return -1e10;
   return 1.0 - (alpha - alpha_0) * (alpha - alpha_0) / denom;
  }
У модели один свободный параметр — alpha_0, положение вершины спектра. Условие alpha_0 > H обеспечивает положительный знаменатель и параболу, направленную ветвями вниз. Нормальная модель дает симметричный спектр и хорошо работает для данных с однородным масштабированием на обоих краях диапазона.
Биномиальный спектр
В биномиальной модели при каждом разбиении каскада возможны только два значения множителя. Спектр задается энтропийной формулой:
f(α) = -[r1 * log(r1) + r2 * log(r2)] / log(2)

where r1 = (α_max - α) / (α_max - α_min)
and   r2 = (α - α_min) / (α_max - α_min)
//+------------------------------------------------------------------+
//| Binomial spectrum model: entropy-based                           |
//+------------------------------------------------------------------+
double CSpectrumFitter::BinomialSpectrum(double alpha, double alpha_min, double alpha_max)
  {
   if(alpha_max <= alpha_min)
      return -1e10;

   double a = MathMax(alpha_min + 1e-10, MathMin(alpha, alpha_max - 1e-10));

   double r1 = (alpha_max - a) / (alpha_max - alpha_min);
   double r2 = (a - alpha_min) / (alpha_max - alpha_min);

   r1 = MathMax(r1, 1e-10);
   r2 = MathMax(r2, 1e-10);

   return -(r1 * MathLog(r1) + r2 * MathLog(r2)) / MathLog(2.0);
  }
У модели два свободных параметра — alpha_min и alpha_max, задающие границы области определения спектра. По формуле энтропии кривая достигает максимума 1,0 при alpha в середине диапазона и опускается до нуля на его границах. Несмотря на простоту — всего два значения множителя, — биномиальная модель может хорошо подгоняться к данным: функция энтропии близко воспроизводит форму многих эмпирических спектров. Ограничение alpha интервалом [alpha_min, alpha_max] и нижний порог для r1 и r2 предотвращают вычисление log(0) на границах.
Пуассоновский спектр
В пуассоновской модели множители получаются из случайной величины с распределением Пуассона:
//+------------------------------------------------------------------+
//| Poisson spectrum model                                           |
//+------------------------------------------------------------------+
double CSpectrumFitter::PoissonSpectrum(double alpha, double alpha_0, double H, double b)
  {
   if(alpha_0 <= 0.0)
      return -1e10;

   double a = MathMax(alpha, 1e-10);
   double term1 = 1.0 - alpha_0 / (H * MathLog(b));
   double term2 = (a / H) * (MathLog(alpha_0 * M_E / a) / MathLog(b));
   return term1 + term2;
  }
У пуассоновской модели один свободный параметр, alpha_0, но ее спектр асимметричен, в отличие от симметричной параболы нормальной модели. Такая асимметрия обусловлена асимметричностью самого распределения Пуассона. Основание каскада b устанавливается равным 2 (двоичный каскад).
Гамма-спектр
В наиболее гибкой модели множители выбираются из гамма-распределения:
//+------------------------------------------------------------------+
//| Gamma spectrum model                                             |
//+------------------------------------------------------------------+
double CSpectrumFitter::GammaSpectrum(double alpha, double alpha_0, double gamma, double b)
  {
   if(alpha_0 <= 0.0 || gamma <= 0.0)
      return -1e10;

   double a = MathMax(alpha, 1e-10);
   double term1 = gamma * MathLog(a / alpha_0) / MathLog(b);
   double term2 = gamma * (alpha_0 - a) / (alpha_0 * MathLog(b));
   return 1.0 + term1 + term2;
  }
Благодаря двум свободным параметрам, alpha_0 и gamma, гамма-модель может описывать как симметричные, так и асимметричные спектры. Параметр формы gamma определяет, насколько выражена или сглажена вершина распределения. При большом gamma спектр сужается, при малом — расширяется. Благодаря гибкости гамма-модель часто сопоставима с биномиальной по качеству подгонки.
Определив четыре модели, мы можем выбрать ту, которая лучше всего соответствует эмпирическому спектру. На рисунке 2 эти модели сравниваются напрямую. Все теоретические кривые наложены на одни и те же эмпирические точки, а сумма квадратов ошибок (SSE) позволяет их однозначно ранжировать. Симметричная парабола нормальной модели сильно расходится с данными. Пуассоновская модель дает лучший результат, но все еще заметно отклоняется от данных. Гамма-модель близка к эмпирическим данным. А биномиальная модель, форма которой задается энтропией, почти точно проходит через эмпирические точки.
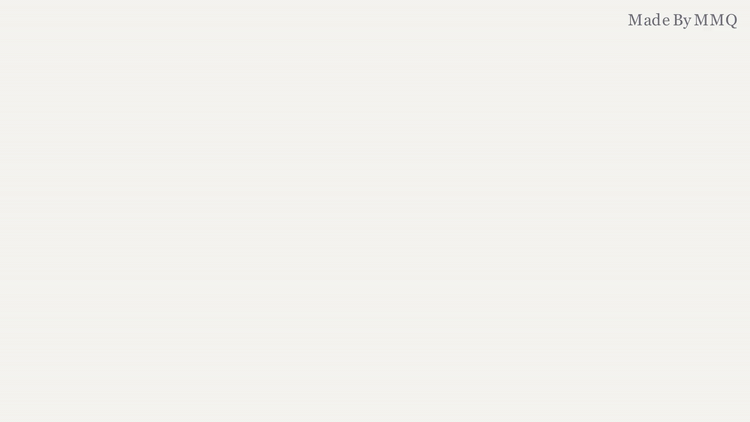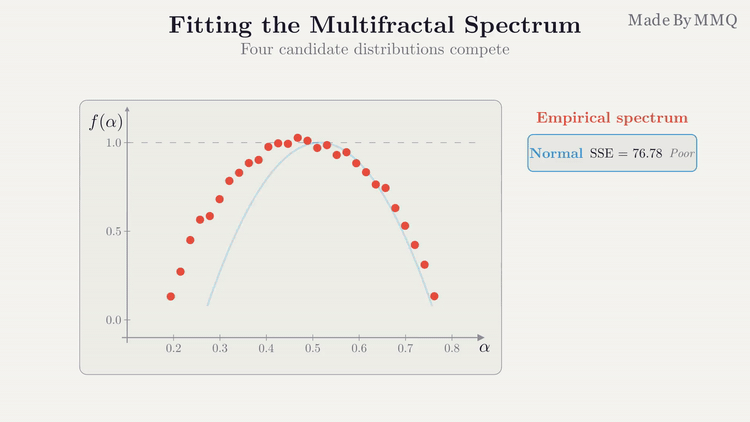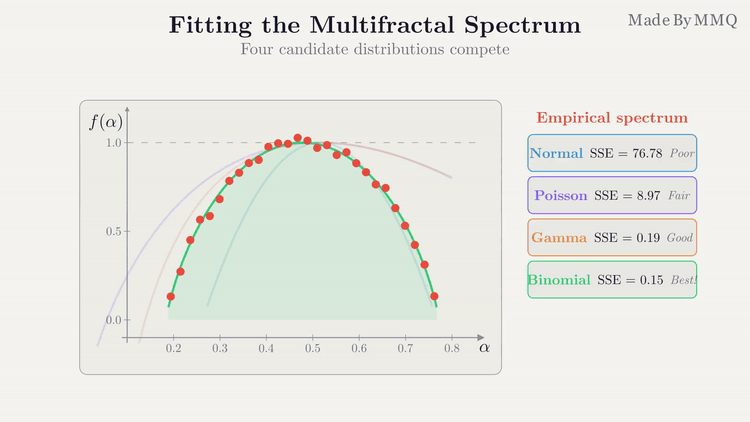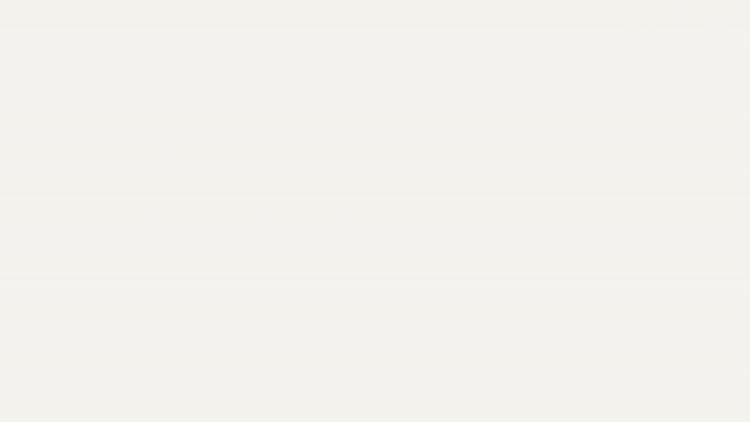
Рис. 2. Сравнение четырех распределений при подгонке эмпирического спектра — биномиальная модель уверенно выигрывает с SSE = 0,148
Оптимизация с ограничениями методом BLEIC
Подгонка каждой модели распределения к эмпирическому спектру — задача нелинейной оптимизации: нужно найти параметры, минимизирующие сумму квадратов ошибок (SSE) между теоретической моделью спектра и эмпирическими точками. Мы используем алгоритм BLEIC (Boundary L-BFGS with Equality/Inequality Constraints) из библиотеки ALGLIB, входящей в состав MetaTrader 5. BLEIC поддерживает покомпонентные ограничения — нижнюю и верхнюю границы каждого параметра. Это необходимо для сохранения физического смысла: alpha_0 должна превышать H, alpha_max — alpha_min, gamma должна быть положительной и т.д.
Оптимизатор вычисляет целевую функцию SSE при разных значениях параметров и последовательно приближается к минимуму. Мы используем вариант MinBLEICCreateF без задания производных: градиенты приближенно вычисляются по конечным разностям. Это немного медленнее использования аналитических градиентов, но значительно проще в реализации и отладке.
На рисунке 3 показана работа BLEIC при подгонке биномиальной модели. Поверхность SSE в двумерном пространстве параметров (alpha_min, alpha_max) имеет форму гладкой чаши. Оптимизатор начинает поиск в середине допустимой области и движется в направлении убывания функции, соблюдая покомпонентные ограничения. По мере приближения к минимуму шаг уменьшается. Фиолетовые пунктирные границы показывают покомпонентные ограничения, сохраняющие физический смысл параметров. Без этих ограничений оптимизатор мог бы попасть в область, где alpha_min превышает alpha_max, и получить бессмысленный результат.
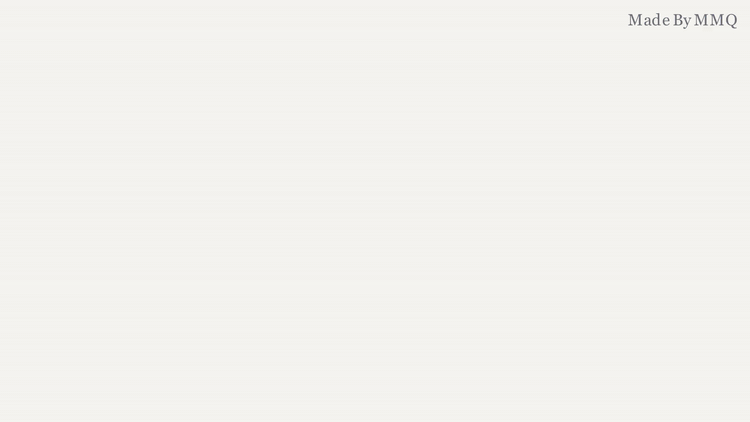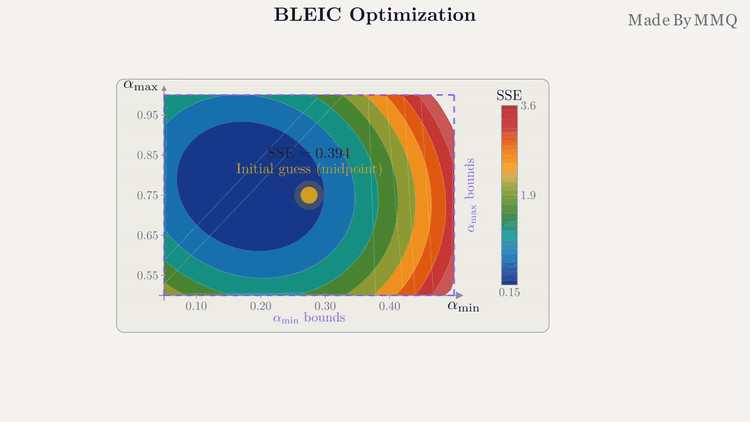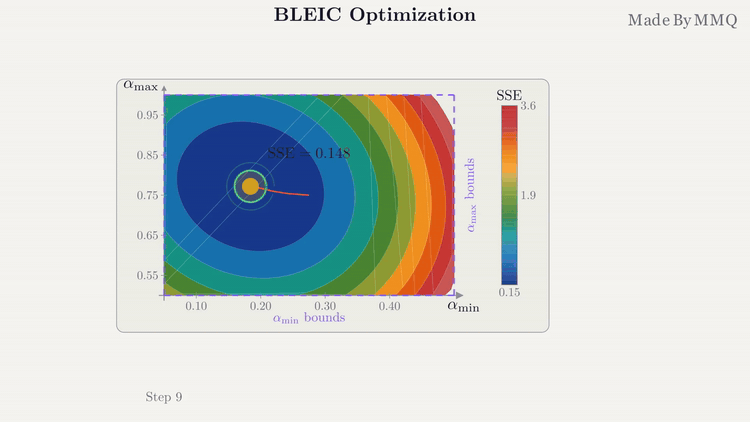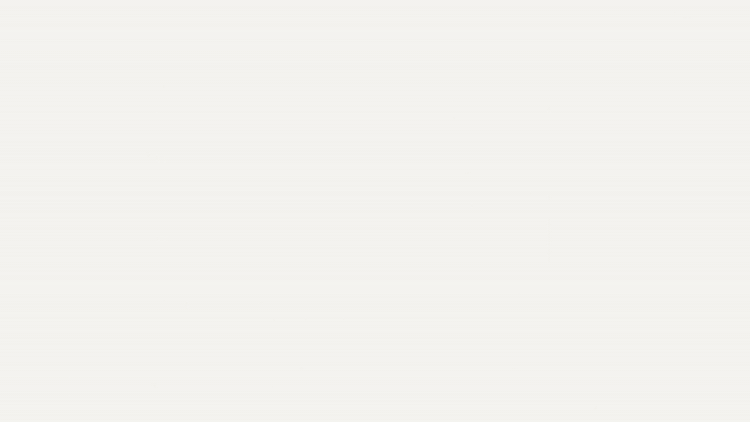
Рис. 3. BLEIC движется по поверхности SSE — оптимизация с ограничениями находит минимум, сохраняя физически допустимые значения параметров
Рассмотрим подгонку нормального спектра как пример общей схемы реализации. Здесь оптимизируется единственный параметр alpha_0:
//+------------------------------------------------------------------+
//| FitNormal - Optimize alpha_0 for Normal spectrum model           |
//+------------------------------------------------------------------+
double CSpectrumFitter::FitNormal(void)
  {
   double alpha_min_data = m_alpha[0];
   double alpha_max_data = m_alpha[0];
   for(int i = 1; i < m_n_spectrum; i++)
     {
      if(m_alpha[i] < alpha_min_data)
         alpha_min_data = m_alpha[i];
      if(m_alpha[i] > alpha_max_data)
         alpha_max_data = m_alpha[i];
     }

   double lb = MathMax(m_H + 1e-6, alpha_min_data);
   double ub = alpha_max_data;

   if(lb >= ub)
     {
      PrintFormat("SpectrumFitter::FitNormal - no valid range (need alpha_0 > H=%.4f, alpha_max=%.4f)", m_H, alpha_max_data);
      return DBL_MAX;
     }

   double x0[];
   ArrayResize(x0, 1);
   x0[0] = (lb + ub) / 2.0;

   double bndl[];
   ArrayResize(bndl, 1);
   bndl[0] = lb;

   double bndu[];
   ArrayResize(bndu, 1);
   bndu[0] = ub;

   CMinBLEICState state;
   CMinBLEIC::MinBLEICCreateF(1, x0, 1e-6, state);
   CMinBLEIC::MinBLEICSetBC(state, bndl, bndu);
   CMinBLEIC::MinBLEICSetCond(state, 1e-8, 1e-8, 1e-8, 200);

   while(CMinBLEIC::MinBLEICIteration(state))
     {
      if(state.m_needf)
        {
         double alpha_0 = state.m_x[0];
         state.m_f = ComputeSSE_Normal(alpha_0);
        }
     }

   double result[];
   CMinBLEICReport rep;
   CMinBLEIC::MinBLEICResults(state, result, rep);

   if(rep.m_terminationtype <= 0)
     {
      PrintFormat("SpectrumFitter::FitNormal - optimizer failed (type=%d)", rep.m_terminationtype);
      return DBL_MAX;
     }

   m_params[MMAR_DIST_NORMAL][0] = result[0];
   m_n_params[MMAR_DIST_NORMAL] = 1;
   double sse = ComputeSSE_Normal(result[0]);
   m_sse[MMAR_DIST_NORMAL] = sse;

   PrintFormat("  Normal:   SSE=%.6f  alpha_0=%.6f", sse, result[0]);
   return sse;
  }
Для всех четырех распределений используется одна схема реализации. Мы (1) определяем границы параметров по данным, (2) задаем начальное приближение в середине допустимой области, (3) настраиваем в BLEIC допуски сходимости и максимальное число итераций, (4) запускаем цикл вычисления SSE в каждой точке-кандидате и (5) извлекаем из результата лучшие параметры. Проверка типа завершения не позволяет принять результат неудачной оптимизации. Такая неудача возможна, если допустимая область слишком узкая или целевая функция плоская.
Функция вычисления SSE устроена просто. Она перебирает точки эмпирического спектра, вычисляет для каждой теоретическое f(alpha) и суммирует квадраты разностей:
//+------------------------------------------------------------------+
//| ComputeSSE_Normal                                                |
//+------------------------------------------------------------------+
double CSpectrumFitter::ComputeSSE_Normal(double alpha_0)
  {
   double sse = 0.0;
   for(int i = 0; i < m_n_spectrum; i++)
     {
      double f_fit = NormalSpectrum(m_alpha[i], alpha_0, m_H);
      double diff = m_f_alpha[i] - f_fit;
      sse += diff * diff;
     }
   return sse;
  }
Биномиальный и гамма-спектры подгоняются по той же схеме, но уже в двумерных пространствах параметров. Для биномиальной модели одновременно оптимизируются alpha_min и alpha_max. Условие alpha_max > alpha_min обеспечивается границами параметров и явной проверкой в целевой функции: при нарушении возвращается штраф 1e10. Для гамма-модели оптимизируются alpha_0 и параметр формы gamma, ограниченный диапазоном от 0,1 до 10,0.
Класс CSpectrumFitter
Класс объединяет преобразование Лежандра и четыре процедуры подгонки в единый пайплайн. Давайте сначала рассмотрим интерфейс класса, чтобы понять общую структуру:
//+------------------------------------------------------------------+ //| CSpectrumFitter class | //+------------------------------------------------------------------+ class CSpectrumFitter { private: //--- Input data double m_q_values[]; double m_tau_q[]; double m_H; int m_n_q; //--- Computed spectrum double m_alpha[]; double m_f_alpha[]; int m_n_spectrum; //--- Fitting results double m_sse[4]; double m_params[4][4]; int m_n_params[4]; ENUM_MMAR_DISTRIBUTION m_best_dist; bool m_fitted; //--- Spectrum model functions double NormalSpectrum(double alpha, double alpha_0, double H); double BinomialSpectrum(double alpha, double alpha_min, double alpha_max); double PoissonSpectrum(double alpha, double alpha_0, double H, double b); double GammaSpectrum(double alpha, double alpha_0, double gamma, double b); //--- Distribution fitting double FitNormal(void); double FitBinomial(void); double FitPoisson(void); double FitGamma(void); //--- SSE evaluation helpers double ComputeSSE_Normal(double alpha_0); double ComputeSSE_Binomial(double alpha_min, double alpha_max); double ComputeSSE_Poisson(double alpha_0); double ComputeSSE_Gamma(double alpha_0, double gamma); public: CSpectrumFitter(void); ~CSpectrumFitter(void); //--- Initialization bool Init(const double &q_values[], const double &tau_q[], int n_q, double H); //--- Computation bool ComputeSpectrum(void); bool FitAllDistributions(void); //--- Results access ENUM_MMAR_DISTRIBUTION GetBestDistribution(void) { return m_best_dist; } void GetBestParams(double ¶ms[]); void GetSpectrum(double &alpha[], double &f_alpha[]); int GetSpectrumSize(void) { return m_n_spectrum; } double GetBestSSE(void) { return m_sse[(int)m_best_dist]; } bool IsFitted(void) { return m_fitted; } };
Закрытая секция делится на три логические группы. В группе входных данных хранятся кривая tau(q) и показатель Херста из модуля анализа разбиений. Рассчитанный спектр содержит пары (alpha, f(alpha)), полученные преобразованием Лежандра. В результатах подгонки хранятся SSE и параметры всех четырех распределений-кандидатов. Для индексации используется перечисление ENUM_MMAR_DISTRIBUTION, определенное в MMARConstants.mqh. Двумерный массив m_params[4][4] вмещает до четырех параметров для каждого распределения, хотя наши модели используют не более двух. Открытый интерфейс предполагает два этапа: методы Init() и ComputeSpectrum() строят эмпирический спектр, затем метод FitAllDistributions() выбирает лучшую модель. Методы доступа к результатам позволяют получить выбранное распределение, его параметры и исходные данные спектра.
После инициализации данными кривой tau(q), полученными в четвертой части, последовательно вызываются методы ComputeSpectrum() и FitAllDistributions(). Они выполняют весь процесс и выбирают лучшую модель. Вот метод оркестрации:
//+------------------------------------------------------------------+
//| FitAllDistributions - Fit all 4 models and select best           |
//+------------------------------------------------------------------+
bool CSpectrumFitter::FitAllDistributions(void)
  {
   if(m_n_spectrum < 3)
     {
      Print("SpectrumFitter::FitAllDistributions - spectrum not computed");
      return false;
     }

   Print("Fitting spectrum to 4 distributions...");

   ArrayInitialize(m_sse, DBL_MAX);
   int n_success = 0;

   double sse_n = FitNormal();
   if(sse_n < DBL_MAX)
      n_success++;

   double sse_b = FitBinomial();
   if(sse_b < DBL_MAX)
      n_success++;

   double sse_p = FitPoisson();
   if(sse_p < DBL_MAX)
      n_success++;

   double sse_g = FitGamma();
   if(sse_g < DBL_MAX)
      n_success++;

   if(n_success == 0)
     {
      Print("SpectrumFitter::FitAllDistributions - all fits failed");
      return false;
     }

//--- Select best fit (lowest SSE)
   m_best_dist = MMAR_DIST_NORMAL;
   double best_sse = m_sse[MMAR_DIST_NORMAL];

   for(int d = 1; d < 4; d++)
     {
      if(m_sse[d] < best_sse)
        {
         best_sse = m_sse[d];
         m_best_dist = (ENUM_MMAR_DISTRIBUTION)d;
        }
     }

   string dist_names[] = {"Normal", "Binomial", "Poisson", "Gamma"};
   double rmse = MathSqrt(best_sse / m_n_spectrum);
   PrintFormat("BEST FIT: %s (SSE=%.6f, RMSE=%.6f)", dist_names[(int)m_best_dist], best_sse, rmse);

   m_fitted = true;
   return true;
  }
Критерий выбора прост: выигрывает вариант с минимальной SSE. Мы не вводим штраф за число параметров, как в AIC или BIC: их всего один или два, а различия в качестве подгонки обычно достаточно велики, чтобы поправка на сложность модели не изменила результат. Для удобства интерпретации вместе с SSE выводится RMSE — среднеквадратичная ошибка в единицах f(alpha).
Результаты доступны через методы доступа. Метод GetBestDistribution() возвращает значение перечисления для выбранного распределения, метод GetBestParams() заполняет массив его параметрами, а метод GetSpectrum() возвращает эмпирические пары (alpha, f(alpha)) для внешней визуализации или проверки.
Запуск полного пайплайна
Теперь мы можем написать тестовый скрипт, объединяющий анализ разбиений из четвертой части с новым модулем подгонки спектра. Скрипт загружает рыночные данные, выполняет анализ разбиений для определения tau(q), затем передает результат модулю подгонки спектра:
//+------------------------------------------------------------------+
//|                                               MMAR Spectrum Test |
//|                      Copyright 2026, MMQ - Muhammad Minhas Qamar |
//|                           https://www.mql5.com/ru/articles/22519 |
//+------------------------------------------------------------------+
#property copyright "Copyright 2026, MMQ - Muhammad Minhas Qamar"
#property link      "https://www.mql5.com/ru/articles/22519"
#property version   "1.00"
#property strict
#property script_show_inputs

#include <MMAR\PartitionAnalysis.mqh>
#include <MMAR\SpectrumFitter.mqh>

input int    InpBars       = 50000;
input double InpQMin       = 0.01;
input double InpQMax       = 30.0;
input double InpQStep      = 0.5;
input int    InpDtMin      = 1;
input int    InpDtMax      = 150;
input double InpDtSpacing  = 1.1;
input double InpMinR2      = 0.60;

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   PrintFormat("=== MMAR Spectrum Fitting Test ===");
   PrintFormat("Symbol: %s | Period: %s", _Symbol, EnumToString(_Period));

//--- Load close prices and compute log returns
   double close[];
   int copied = CopyClose(_Symbol, _Period, 0, InpBars, close);
   if(copied < 1000)
     {
      PrintFormat("Not enough bars: %d (need 1000+)", copied);
      return;
     }
   PrintFormat("Loaded %d bars", copied);

   double returns[];
   int n_returns = copied - 1;
   ArrayResize(returns, n_returns);
   for(int i = 0; i < n_returns; i++)
      returns[i] = MathLog(close[i + 1] / close[i]);

//--- Phase 2: Partition Analysis
   CPartitionAnalysis partition;
   partition.SetPartitionConfig(InpDtMin, InpDtMax, InpDtSpacing);
   partition.SetMomentConfig(InpQMin, InpQMax, InpQStep);
   partition.SetMinRSquared(InpMinR2);

   if(!partition.Init(returns, n_returns))
     {
      Print("Partition Init failed");
      return;
     }

   uint t0 = GetTickCount();
   if(!partition.Analyze())
     {
      Print("Partition Analyze failed");
      return;
     }
   uint t_partition = GetTickCount() - t0;

   double H = partition.GetH();
   PrintFormat("\n--- Partition Results (%.0f ms) ---", (double)t_partition);
   PrintFormat("H = %.4f | Vol = %.6f | R2 = %.4f | Score = %d/9",
               H, partition.GetSampleVolatility(),
               partition.GetMeanRSquared(), partition.GetMultifractalScore());

//--- Phase 3: Spectrum Fitting
   double tau[], q_vals[];
   partition.GetTauQ(tau, q_vals);
   int n_q = partition.GetNumQ();

   CSpectrumFitter fitter;
   if(!fitter.Init(q_vals, tau, n_q, H))
     {
      Print("SpectrumFitter Init failed");
      return;
     }

   t0 = GetTickCount();
   if(!fitter.ComputeSpectrum())
     {
      Print("ComputeSpectrum failed");
      return;
     }

   if(!fitter.FitAllDistributions())
     {
      Print("FitAllDistributions failed");
      return;
     }
   uint t_spectrum = GetTickCount() - t0;

//--- Print spectrum results
   PrintFormat("\n--- Spectrum Results (%.0f ms) ---", (double)t_spectrum);

   string dist_names[] = {"Normal", "Binomial", "Poisson", "Gamma"};
   ENUM_MMAR_DISTRIBUTION best = fitter.GetBestDistribution();
   PrintFormat("Best distribution: %s", dist_names[(int)best]);

   double params[];
   fitter.GetBestParams(params);
   PrintFormat("Parameters:");
   switch(best)
     {
      case MMAR_DIST_NORMAL:
         PrintFormat("  alpha_0 = %.6f", params[0]);
         break;
      case MMAR_DIST_BINOMIAL:
         PrintFormat("  alpha_min = %.6f", params[0]);
         PrintFormat("  alpha_max = %.6f", params[1]);
         break;
      case MMAR_DIST_POISSON:
         PrintFormat("  alpha_0 = %.6f", params[0]);
         break;
      case MMAR_DIST_GAMMA:
         PrintFormat("  alpha_0 = %.6f", params[0]);
         PrintFormat("  gamma   = %.6f", params[1]);
         break;
     }

   double best_sse = fitter.GetBestSSE();
   double rmse = MathSqrt(best_sse / fitter.GetSpectrumSize());
   PrintFormat("SSE = %.6f | RMSE = %.6f", best_sse, rmse);

//--- Print empirical spectrum (every 5th point)
   double alpha[], f_alpha[];
   fitter.GetSpectrum(alpha, f_alpha);
   int n_spec = fitter.GetSpectrumSize();

   PrintFormat("\n--- Empirical Spectrum (every 5th point) ---");
   PrintFormat("%10s %10s", "alpha", "f(alpha)");
   for(int i = 0; i < n_spec; i += 5)
      PrintFormat("%10.4f %10.4f", alpha[i], f_alpha[i]);

   PrintFormat("\n--- Summary ---");
   PrintFormat("Partition time: %u ms", t_partition);
   PrintFormat("Spectrum time:  %u ms", t_spectrum);
   PrintFormat("Total time:     %u ms", t_partition + t_spectrum);

   Print("\n=== Spectrum Fitting Test Complete ===");
  }
При запуске на EURUSD на таймфрейме M10 по 50 000 барам получаем следующие результаты:
=== MMAR Spectrum Fitting Test ===
Symbol: EURUSD | Period: PERIOD_M10
Loaded 50000 bars
Multifractality check: concavity=0 linearity=1 variation=1 total=2/9

--- Partition Results (438 ms) ---
H = 0.4819 | Vol = 0.000419 | R2 = 0.8712 | Score = 2/9
SpectrumFitter: 58 spectrum points, alpha=[0.1308, 0.5148], peak at alpha_0=0.5148 f=0.9924
Fitting spectrum to 4 distributions...
  Normal:   SSE=76.783833  alpha_0=0.514816
  Binomial: SSE=0.148225  alpha_min=0.183507  alpha_max=0.772224
  Poisson:  SSE=8.972094  alpha_0=0.514816
  Gamma:    SSE=0.192775  alpha_0=0.514816  gamma=1.195666
BEST FIT: Binomial (SSE=0.148225, RMSE=0.050553)

--- Spectrum Results (0 ms) ---
Best distribution: Binomial
Parameters:
  alpha_min = 0.183507
  alpha_max = 0.772224
SSE = 0.148225 | RMSE = 0.050553

--- Empirical Spectrum (every 5th point) ---
     alpha   f(alpha)
    0.5148     0.9924
    0.2886     0.5433
    0.1385    -0.0312
    0.1317    -0.0696
    0.1360    -0.0303
    0.1386     0.0005
    0.1399     0.0185
    0.1405     0.0282
    0.1407     0.0330
    0.1408     0.0349
    0.1408     0.0353
    0.1408     0.0347

--- Summary ---
Partition time: 438 ms
Spectrum time:  0 ms
Total time:     438 ms

=== Spectrum Fitting Test Complete ===
Результаты позволяют сделать несколько важных выводов. Во-первых, биномиальное распределение уверенно выигрывает: SSE составляет 0,148 против 0,193 у гамма-распределения, 8,97 у пуассоновского и 76,78 у нормального. Нормальная модель дает плохую подгонку: ее симметричная парабола не отражает асимметрию эмпирического спектра с крутой левой ветвью, где alpha быстро уменьшается от 0,51 у вершины до 0,13, и пологим правым хвостом. Формула биномиальной модели на основе энтропии естественным образом описывает такую форму.
Во-вторых, значение в вершине спектра при alpha_0 = 0,5148 составляет f(alpha_0) = 0,9924 — очень близко к теоретическому идеалу f(alpha_0) = 1,0. Это подтверждает, что преобразование Лежандра работает корректно: преобладающему показателю масштабирования соответствует фрактальная размерность около 1,0, то есть он характеризует почти весь временной ряд.
В-третьих, параметры биномиального распределения, полученные при подгонке, — alpha_min = 0,1835 и alpha_max = 0,7722 — определяют поведение каскада. В шестой части при построении мультипликативного каскада на каждом разбиении будут назначаться множители, полученные из одного из этих двух показателей. Большая разность alpha_max и alpha_min — 0,59 — указывает на существенную неоднородность масштабирования: одни интервалы будут очень гладкими при высоком alpha, другие — в значительной степени неровными при низком alpha. Именно эта неоднородность создает реалистичную кластеризацию волатильности в итоговом процессе MMAR.
Наконец, обратите внимание: сама подгонка спектра занимает практически ноль миллисекунд. Вся вычислительная нагрузка приходится на анализ разбиений (438 мс). Оптимизация BLEIC быстро сходится: поверхности SSE гладкие, а пространство поиска содержит лишь один или два параметра. Поэтому добавление подгонки спектра в рабочую систему почти не увеличивает затраты по сравнению с анализом разбиений, реализованным в четвертой части.
Заключение
В этой статье мы реализовали второй аналитический модуль библиотеки MMAR — класс CSpectrumFitter. Взяв функцию масштабирования tau(q) из модуля анализа разбиений четвертой части, мы преобразованием Лежандра получили эмпирический спектр сингулярностей f(alpha), затем подогнали четыре теоретические модели распределений методом нелинейной оптимизации с ограничениями.
- Преобразование Лежандра. Оно преобразует функцию масштабирования в физически интерпретируемое представление: alpha характеризует локальную гладкость, а f(alpha) — фрактальную размерность множества точек с такой гладкостью.
- Четыре модели-кандидата — нормальная, биномиальная, пуассоновская и гамма-модель — сравниваются по сумме квадратов ошибок (SSE). Каждая опирается на свои допущения о распределении множителей каскада.
- Оптимизация BLEIC. Алгоритм из ALGLIB учитывает ограничения на параметры и для этих задач малой размерности сходится за пренебрежимо малое время.
- Биномиальная модель. Она выиграла на наших данных EURUSD на таймфрейме M10, дав параметры alpha_min и alpha_max, определяющие неоднородность каскада.
Оба аналитических этапа теперь завершены. Мы можем взять любой ряд доходностей, проверить его мультифрактальность и при ее наличии определить распределение и параметры для моделирования. В шестой части мы используем эти параметры на практике: построим мультипликативный каскад, преобразующий равномерное время в мультифрактальное торговое время, сгенерируем фракционное броуновское движение методами Дэвиса — Харта и Холецкого, затем объединим компоненты в полный процесс MMAR X(t) = B_H[theta(t)].
Программы, представленные в этой статье, предназначены исключительно для образовательных целей. Они не предназначены для реальной торговли и не оптимизированы для работы в реальных рыночных условиях. Этот код служит основой для понимания анализа мультифрактального спектра. Прежде чем адаптировать его для реальной торговли, обязательно тщательно проверьте работу на демо-счетах.
Как получить исходный код через MQL5 Algo Forge
Все исходные файлы приложены к статье ниже. Полный репозиторий также доступен на MQL5 Algo Forge — платформе на базе Git для обмена торговыми проектами и совместной работы над ними. Algo Forge хранит историю версий локально и в облаке, поэтому вам будет доступна актуальная версия кода, в том числе обновления и исправления, внесенные после публикации статьи.
Чтобы клонировать репозиторий, откройте командную строку, PowerShell или терминал, встроенный в ваш редактор кода, и выполните команду:
git clone https://forge.mql5.io/ayantrader/MMAR.git
Для этого на вашем компьютере должен быть установлен Git. Если вы работаете в Visual Studio Code, откройте встроенный терминал сочетанием клавиш Ctrl+` и выполните команду прямо в нем. Репозиторий будет клонирован в папку MMAR в текущем каталоге.
Кроме того, проект можно просматривать по адресу forge.mql5.io/ayantrader/MMAR: исходные файлы, историю коммитов и обновления можно открыть прямо в браузере. В отличие от приложенных файлов, Algo Forge дает доступ ко всей истории Git и позволяет загружать будущие обновления одной командой:
git pull
| Имя файла | Описание |
|---|---|
| MQL5\Include\MMAR\MMARConstants.mqh | Общие перечисления, структуры и определения типов библиотеки MMAR (часть 4) |
| MQL5\Include\MMAR\OLS.mqh | Регрессия методом наименьших квадратов через псевдообратную матрицу на основе SVD с полным набором диагностических показателей (часть 4) |
| MQL5\Include\MMAR\HurstGHE.mqh | Оценщик обобщенного показателя Херста, резервный метод (часть 4) |
| MQL5\Include\MMAR\PartitionAnalysis.mqh | Мультифрактальный анализ функции разбиения с диагностикой масштабирования (часть 4) |
| MQL5\Include\MMAR\SpectrumFitter.mqh | Вычисление мультифрактального спектра и подгонка к четырем распределениям методом оптимизации BLEIC (часть 5) |
| MQL5\Scripts\MMAR\MMAR_PartitionTest.mq5 | Тестовый скрипт для анализа разбиений на реальных рыночных данных (часть 4) |
| MQL5\Scripts\MMAR\MMAR_SpectrumTest.mq5 | Тестовый скрипт полного пайплайна анализа разбиений и подгонки спектра на реальных рыночных данных (часть 5) |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22519
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Особенности написания Пользовательских Индикаторов
 Рыночная микроструктура в MQL5 (Часть 4): Волатильность с эффектом памяти

 Оптимизация на основе кривых Безье — Bezier Curve-based Optimization (BCO)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования