

从基础到中级:FileSave 和 FileLoad
 44
 0

引言
在上一篇文章“从基础到中级:沙箱与 MetaTrader”中,我们以非常简单且实用的方式解释了沙箱的概念,以及在使用 MQL5 库函数和过程创建、处理和读取文件时,沙箱对 MetaTrader 5 工作流程的影响。
该内容仅旨在解释沙箱是什么,而非展示处理文件的最佳方法。这是因为,使用纯 MQL5 实现这一功能有更高效的方法,无需依赖任何操作系统函数。
假设读者已经熟悉沙箱概念及其对工作流程的影响,接下来我们可以继续探讨如何使用文件以获得不同的结果。需要注意的是,本文并非旨在开发任何特定的应用程序。为了演示如何实现某些任务,我们将仅使用 MQL5 库中的几个函数和过程。即便如此,为了理解某些可能引发疑问的细微差别,你需要自己练习这些材料。因此,按照我们的一贯传统,让我们继续探讨一个新主题,并学习基础知识。
没有一个通用的公式
在上一篇文章中,我们为一项相当简单的任务实现了一个读写方案,当时代码本可以保持原样。然而,在实际操作中,现实世界的实现并不总是遵循我们之前展示的示例。这是因为可能会出现某些问题。为了还原事件背景,让我们再次审视一下这个问题究竟是什么。为此,我们将使用上一篇文章中讨论的一个代码示例。如下所示:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     const string szText = "This file was created by a script written in MQL5.";
07.     uchar info[];
08.
09.     StringToCharArray(szText, info);
10.
11.     FileSave("Hello.txt", info);
12. }
13. //+------------------------------------------------------------------+
代码 01
当代码 01 执行时,它将创建一个文件,其内容如下图所示。
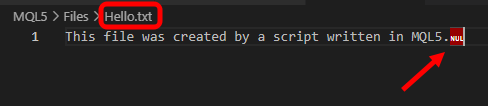
图 01
图 01 显示了一个不寻常的字符 — 在本例中是空字符 (NUL)。它用于标记字符串的结束,在使用这种字符串表示的应用程序中,这不成问题。然而,在旨在存储纯文本的文件中,这样的字符毫无意义,并且根据文本文件的目的或预期用途,它往往会造成问题。
解决这类问题有多种方法。有些方法更为直接,而另一些则较为间接,需要执行额外的步骤才能正确实施。此外,与代码 01 相关的还有另一个细微之处。尽管第 11 行可以以最简单、最直接的方式创建一个文件并直接向其中写入数据,但这种解决问题的方法会带来另一个问题,我们稍后会详细探讨:对文件数据的随机访问。
尽管这一说法可能看似不寻常,但实际上磁盘上的文件并不像顺序读取系统那样运行,例如磁带上的文件。使用磁带时,当需要读取文件或特定数据时,通常需要读取磁带的很大一部分,这有时会使读写过程变得更加复杂。然而,对于存储在磁盘上的文件,顺序访问和随机访问都是可能的,这使得文件的任何部分都可以随时读取或写入。
尽管存在这种可能性,但 FileSave 和 FileLoad 并不适合用于随机访问,因为它们将文件作为一个完整的块进行读写,并且通常会将整个文件加载或保存到磁盘。对于小文件来说,这不成问题,而且如果为了覆盖文件内容而可以忽略文件内容,应用程序使用 FileSave 和 FileLoad 也不会有任何实际问题,因为它们提供了一种非常实用且安全的读写文件的方式。
然而,如果任务是在保持文件部分内容不变的同时对其进行修改,那么使用 FileSave 和 FileLoad 可能不是最佳解决方案,因为在这种情况下,整个文件都必须保存在内存中。这完全不切实际,因为通常只需要将正在直接处理的一小部分内容保存在内存中。其余内容可以保留在磁盘上,并根据需要加载。
因此,执行任务并没有一个通用的公式或普遍、确定的方法。每个案例都是独一无二的,所选择的解决方案应根据特定案例的要求来决定,以确保用户在使用您的 MetaTrader 5 应用程序时体验便捷且实用。
为了让上述内容更容易、更清晰地理解,我们应该创建几个简单的示例,以展示为何每种实现都需要单独设计,因为许多人可能并不清楚某些决策对应用程序开发方式的影响有多大。
让我们首先尝试向已保存在磁盘上的文件添加新信息。在这种情况下,正在处理的文件将与代码 01 创建的文件完全相同。但是,为了实现这种文件处理,需要对同一个代码 01 进行一些修改。记住:我们的目标是将新信息添加到已保存的文件中。因此,从理论上讲,我们可以考虑一个类似于下面所示的解决方案。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     SaveInfo("This file was created by a script written in MQL5.");
07.     SaveInfo("New information is being added to the file.");
08. }
09. //+------------------------------------------------------------------+
10. void SaveInfo(const string szArg)
11. {
12.     uchar info[];
13.
14.     StringToCharArray(szArg, info);
15.     FileSave("Hello.txt", info);
16. }
17. //+------------------------------------------------------------------+
代码 02
当执行代码 02 时,我们期望 Hello.txt 文件同时包含来自图 01 的数据和新信息。本应出现在文件中的数据如代码 02 的第 06 行和第 07 行所示。请注意,这非常容易理解。然而,当在 MetaTrader 5 中运行此脚本时,结果却并非完全如我们所愿。如下所示:
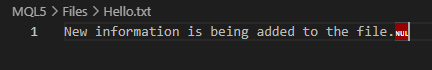
图 02
这就引出了一个主要问题,以及一个同样重要的担忧。究竟发生了什么,才会导致出现图 02 所示的结果?起初,这个结果并不在预期之中,因为第 06 行的内容和第 07 行的内容都应出现在最终文件中。然而,最终文件中仅显示了第 07 行的信息。
换句话说,出于某种原因,第 06 行的内容被忽略了,只写了第 07 行的内容。这就引出了一个问题:第 06 行的内容发生了什么?如果没有人详细解释底层过程,这是最难理解的问题之一。但实际上,这很简单。当执行第 06 行时,第 15 行的函数会将数据写入文件。紧接着,当执行第 07 行时,该文件会被覆盖,并写入新的内容。尽管这个过程很简单,但如果没有外部解释,很难发现代码为何没有写入某些数据。这会造成一种错误印象,即代码中存在严重错误,而实际上问题出在其他地方。
那么我们该如何解决这个问题呢?换句话说,我们如何才能将第 6 行和第 7 行的内容存储在同一个文件中呢?亲爱的读者,正如本节标题所述:没有单一公式。解决这个任务的方法有很多种,每种方法都有其优缺点。在此,我们仅展示一个示例进行说明。但你也可以提出其他方法并尝试实现。以 FileSave 为起点,尝试开发自己的解决方案。这是因为,只要规划得当,还有其他更简单的解决方案。
让我们来看看我们可能提出的第一个解决方案。如下所示:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     SaveInfo("This file was created by a script written in MQL5.");
07.     SaveInfo("New information is being added to the file.");
08. }
09. //+------------------------------------------------------------------+
10. void SaveInfo(const string szArg)
11. {
12.     const string FileName = "Hello.txt";
13.     uchar info[], tmp[];
14.
15.     FileLoad(FileName, info);
16.     StringToCharArray(szArg + "\n", tmp);
17.     ArrayCopy(info, tmp, info.Size(), 0, tmp.Size() - 1);
18.     FileSave(FileName, info);
19. }
20. //+------------------------------------------------------------------+
代码 03
执行代码 03 后,我们将得到与此非常相似的结果:
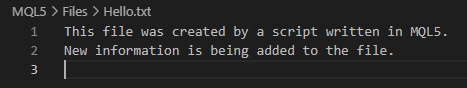
图 03
目前的结果完全符合预期。换句话说,第 06 行的内容和第 07 行的内容都会添加到文件中。但这并不是全部。您还可以看到,前面提到的 NUL 字符不再被添加。我们是如何同时解决这两个问题的呢?
此外,仔细分析后可以明确,代码 03 第 10 行的 SaveInfo 过程实际上是用于创建日志文件的代码。换句话说,只需付出极少的努力或成本,你就可以创建一个系统,将你的代码正在执行的操作写入文件。这样,你就可以详细研究和分析执行过程中发生的情况。很有意思,不是吗?这是一个易于实现的解决方案,具有非常有趣的结果和可能性。
现在,让我们来看看这里发生了什么,使得代码 02 得以修复,并且使代码 03 更加适用,最重要的是,它能够存储第 06 行和第 07 行的内容。
为了理解这一点,请注意,这里增加了一个常量。这让我们可以使用相同的文件名引用,因为第 15 行会读取它,而第 18 行会写入它。但为什么要这样做呢?亲爱的读者,原因在于,如代码 02 所示,FileSave 会一次性将缓冲区的内容写入。换句话说,如果缓冲区(在本例中为 info 数组)包含某些信息,这些信息将覆盖文件中的原始数据。然而,当我们读取文件时,会将文件内容加载到缓冲区中。紧接着,使用第 17 行代码,我们将新信息添加到原始文件缓冲区中已有的内容中。这就像我们实际上是在内存中创建文件,然后再将其保存到磁盘上。
在我们考虑的示例中,这种类型的操作执行得非常快。然而,随着文件大小的增加,这成了一个问题,因为以这种方式执行读写操作会降低应用程序在系统资源使用方面的效率。最终,这会影响执行时间,因为文件中的数据越多,将数据读写到磁盘所需的时间就越长。然而,对于像这里考虑的简单情况,这种解决方案完全可以很好地使用。
好的,但如果我们再次运行应用程序,会发生什么呢?乍一看,一切运行正常。在这种情况下,第 06 行和第 07 行会被反复写入,添加越来越多的相同信息行。这种情况会一直持续,直到我们删除原始文件,然后整个过程重新开始。换句话说,我们现在有了一项新任务。在代码中,处理这种情况主要有两种方法。虽然还有其他选择,但这里我们只关注两种。
第一种解决方案
解决这个问题的第一个方案是删除该文件,并在应用程序运行时开始重写它。为此,需要将代码 03 替换为类似于下面所示的解决方案。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define def_FILENAME "Hello.txt"
05. //+------------------------------------------------------------------+
06. void OnStart(void)
07. {
08.     FileDelete(def_FILENAME);
09.     SaveInfo("This file was created by a script written in MQL5.");
10.     SaveInfo("New information is being added to the file.");
11. }
12. //+------------------------------------------------------------------+
13. void SaveInfo(const string szArg)
14. {
15.     uchar info[], tmp[];
16.
17.     FileLoad(def_FILENAME, info);
18.     StringToCharArray(szArg + "\n", tmp);
19.     ArrayCopy(info, tmp, info.Size(), 0, tmp.Size() - 1);
20.     FileSave(def_FILENAME, info);
21. }
22. //+------------------------------------------------------------------+
代码 04
太好了,代码 04 部分解决了代码 03 中存在的问题。然而,重要的是要强调,这种解决方案虽然能正常运行,但存在一定的危险性。这是因为如果程序员忘记指定正确的沙箱,可能会发生严重问题。原因是代码 04 的第 08 行确实会删除指定的文件。但是,如果第 17 行的读取操作和第 20 行的写入操作与第 08 行使用的沙箱不匹配,我们可能会删除一个并非我们预期的文件。
由于这里提供了代码 04,您可以对其进行修改,以了解在使用不同沙箱时可能会出现哪些类型的问题。然而,为了解决这个问题,我们可可以通过添加一个宏定义,让文件删除、读取和写入操作统一使用同一沙箱,从而避免因使用不同沙箱而导致的问题。具体实现方式如下所示。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define def_FILENAME        "Hello.txt"
05. #define def_FILE_COMMON                     //If set uses the shared folder
06. //+------------------------------------------------------------------+
07. void OnStart(void)
08. {
09. #ifdef def_FILE_COMMON
10.     FileDelete(def_FILENAME, FILE_COMMON);
11. #else
12.     FileDelete(def_FILENAME);
13. #endif
14.     SaveInfo("This file was created by a script written in MQL5.");
15.     SaveInfo("New information is being added to the file.");
16. }
17. //+------------------------------------------------------------------+
18. void SaveInfo(const string szArg)
19. {
20.     uchar info[], tmp[];
21.
22. #ifdef def_FILE_COMMON
23.     FileLoad(def_FILENAME, info, FILE_COMMON);
24. #else
25.     FileLoad(def_FILENAME, info);
26. #endif
27.     StringToCharArray(szArg + "\n", tmp);
28.     ArrayCopy(info, tmp, info.Size(), 0, tmp.Size() - 1);
29. #ifdef def_FILE_COMMON
30.     FileSave(def_FILENAME, info, FILE_COMMON);
31. #else
32.     FileSave(def_FILENAME, info);
33. #endif
34. }
35. //+------------------------------------------------------------------+
代码 05
请注意,在代码 05 中,我们以一种非常实用的方式解决了同步问题,这仅仅是因为在第 05 行我们定义了应该编译的代码。这避免了在尝试以一种方式在某个地方访问文件,而在其他地方以另一种方式访问时出现的各种问题。
好的,看起来我们对代码做出了有用的修改。但是,如果你已经研究并尝试将这些文章中展示的内容付诸实践,你可能会有这样的想法:FileDelete 调用能不能不放在 SaveInfo 过程中呢?这样,虽然代码 05 中展示的实现变得没有必要,但沙箱本身仍能保持一定的同步性,因为所有库函数都会被集中在一起,从而使代码更易于修改且修改速度更快。
是的,亲爱的读者,这是可以做到的。虽然这并不是传统的方法,但它确实有效。根据目前所展示的内容,可以通过一个静态变量来实现。更安全的方法是使用类,但由于我们尚未介绍这一概念,因此不会展示如何实现基于类的解决方案。不过,我们可以展示一个使用静态变量的解决方案。这是通过以下代码实现的:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     SaveInfo("This file was created by a script written in MQL5.");
07.     SaveInfo("New information is being added to the file.");
08. }
09. //+------------------------------------------------------------------+
10. void SaveInfo(const string szArg)
11. {
12. //+----------------+
13. #define def_FILENAME "Hello.txt"
14. //+----------------+
15.     static bool b_Clear = false;
16.     uchar info[], tmp[];
17.
18.     if (!b_Clear) FileDelete(def_FILENAME);
19.     FileLoad(def_FILENAME, info);
20.     StringToCharArray(szArg + "\n", tmp);
21.     ArrayCopy(info, tmp, info.Size(), 0, tmp.Size() - 1);
22.     FileSave(def_FILENAME, info);
23.     b_Clear = true;
24. }
25. //+------------------------------------------------------------------+
代码 06
现在请注意,虽然代码 06 与代码 04 非常相似,但它的行为却大相径庭。这正是因为第 15 行声明了静态变量。但是,所有需要对文件执行的操作都集中在一个地方,即 SaveInfo 程序中,这使得根据我们的需要查找和更改数据变得更加容易。这样,我们就不必在代码中搜索可能与针对此文件的操作冲突的地方。
好了,我想现在我们可以通过删除原始文件来操作系统,这一点已经很清楚了。但是,我们可以采用稍微不同的方法,仍然可以获得与本节中所示更改相同的结果。为了说明这一点,让我们继续进入一个新的部分,我们将展示第二种解决方案。
第二种解决方案
如前所述,解决这个问题的方法有很多。然而,在此我们仅探讨两种方法,以免陷入单一解决方案的困境。思考解决问题的方案是每位优秀程序员的任务。现在,让我们来看看解决问题的第二种方法。你会惊讶于它的简单程度。说实话,这个解决方案应该介于代码 03 和代码 06 之间。然而,为了让一切更加清晰,我希望你将这个解决方案视为代码 03 经过一些简单修改后的版本。这些修改如下所示:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     SaveInfo("This file was created by a script written in MQL5.");
07.     SaveInfo("New information is being added to the file.");
08. }
09. //+------------------------------------------------------------------+
10. void SaveInfo(const string szArg)
11. {
12.     const string FileName = "Hello.txt";
13.     static bool b_isFirst = true;
14.     uchar info[], tmp[];
15.
16.     if (b_isFirst)
17.     {
18.         ArrayFree(info);
19.         b_isFirst = false;
20.     }else
21.         FileLoad(FileName, info);
22.     StringToCharArray(szArg + "\n", tmp);
23.     ArrayCopy(info, tmp, info.Size(), 0, tmp.Size() - 1);
24.     FileSave(FileName, info);
25. }
26. //+------------------------------------------------------------------+
代码 07
现在看看代码 07 并如实回答。你理解那里发生的事情吗?请注意,该代码本身非常类似于代码 03 和代码 06 的混合体。然而,与使用 FileDelete 的代码 06 不同,在代码 07 中,我们使用写入系统本身来清除文件,同时仍然在接收新信息时更新。但我们是怎么实现这一点的呢?
那么,亲爱的读者,如果你仍然对这是如何实现的存有疑问,你可能应该学习本系列的第一篇文章,我们在其中解释了如何使用静态变量。尽管许多人认为静态变量是一个难以理解的话题,但理解它们对于简单而流畅地解决各种任务至关重要,它使得代码在追求相同目标的不同应用程序之间具有相当高的可移植性。
我在文章“从基础到中级:变量(二)”中讨论了静态变量。由于代码 07 非常简单,且您已经了解其使用的基本原理,因此我们将不再花时间解释其工作原理。相反,我们将探讨另一种非常相似的解决方案,但其结果相当有趣,值得解释。
在我们考虑的所有代码片段中,你可能已经注意到,我们总是局限于一个文件,其名称在代码中的某个地方定义。您可以想象一下,无需对代码进行任何更改即可将数据保存到不同的文件中,这将多么有用。
大多数情况下,我们可以简单地将要保存的文件名作为参数传递给 SaveInfo 过程。这可能是解决问题的一种方法,但同时也会产生其他类型的问题,这些问题可能或多或少难以解决,具体取决于我们的应用程序所期望和要求的活动的类型。然而,有一个相对优雅的方法可以解决这个问题,只需付出很少的努力就能将数据保存到不同的文件中。
这种方法涉及使用结构化编程。我们已经在本系列文章中的一小部分内容中讨论过这个问题。由于已有数篇文章讨论过这个话题,我们在此不再提供链接。要真正理解结构化编程的工作原理,你很可能需要从头开始学习这个主题。但是,如果不展示如何解决与选择保存文件名相关的问题,这对那些阅读文章并学习其中信息的人来说是不公平的。
所以,对于那些已经熟悉结构化编程基础的人来说,让我们来看看为了获得一个比我们迄今为止看到的更好的解决方案,同时还需要更少的磁盘访问次数,代码会是什么样子,如代码 07 所示。解决方案如下所示:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. struct stFile
05. {
06.     private :
07.         string  FileName;
08.         int     common_flag;
09.         bool    b_isFirst;
10.     public  :
11. //+----------------+
12.         void SetFileName(const string szArg, const int iArg = 0)
13.         {
14.             FileName = szArg;
15.             common_flag = iArg;
16.             b_isFirst = true;
17.         }
18. //+----------------+
19.         void SaveInfo(const string szArg)
20.         {
21.             uchar info[], tmp[];
22.
23.             if (FileName == NULL) return;
24.             if (b_isFirst)
25.             {
26.                 ArrayFree(info);
27.                 b_isFirst = false;
28.             }else
29.                 FileLoad(FileName, info, common_flag);
30.             StringToCharArray(szArg + "\n", tmp);
31.             ArrayCopy(info, tmp, info.Size(), 0, tmp.Size() - 1);
32.             FileSave(FileName, info, common_flag);
33.         }
34. //+----------------+
35. };
36. //+------------------------------------------------------------------+
37. void OnStart(void)
38. {
39.     stFile  file;
40.
41.     file.SetFileName("Hello.txt");
42.     file.SaveInfo("This file was created by a script written in MQL5.\nStructured programming version.");
43.     file.SaveInfo("New information is being added to the file.\nFile saved in the local directory.");
44.
45.     file.SetFileName("Hello.txt", FILE_COMMON);
46.     file.SaveInfo("This file was created by a script written in MQL5.\nStructured programming version.");
47.     file.SaveInfo("New information is being added to the file.\nFile saved in shared directory.");
48. }
49. //+------------------------------------------------------------------+
代码 08
代码 08 非常有趣,甚至相当吸引人,因为它同时应用了多个概念。这样做是为了让我们有一个非常具体的任务。由于许多人,甚至是那些试图研究我们解释结构化编程如何工作的文章的人,可能对这段代码在某些地方的工作原理有疑问,我们将简要解释一些有趣的方面。然而,应该注意的是,这段代码的很大一部分与代码 07 非常相似。但在这里,我们做了一些更复杂的事情,因此至少在我看来,这段代码要好得多。
请注意,我们在第 04 行声明了一个结构体。这将作为我们接下来工作的基础。该结构内部有几个私有字段和两个过程。第 12 行的过程用于指定我们在任何给定时间要处理的文件名。此外,它还允许我们更改正在使用的沙箱。现在,第一阶段中稍微复杂一些的部分开始了。
由于我们使用的是结构化代码而不是类,因此我们无法执行某些操作。但我们还可以使用其他方法。在这种情况下,当编译器创建为第 07 行到第 09 行之间声明的变量分配内存的机制时,它还会预先初始化这些值。了解该内存区域的初始值非常重要。字符串通常初始化为 null。这样就可以执行第 23 行所示的测试了。
此测试的目的是确保已指定要使用的文件 — 换句话说,已设置文件名。换句话说,如果尚未指定要使用的文件名,该条件就会成立,SaveInfo 过程会立即退出。其余代码非常简单,因为本文其他部分已经介绍过了。
不过,让我们继续学习 OnStart 过程,因为这里需要一些解释,以便您能够正确地学习代码 08。
请注意,我们在第 39 行创建了一个变量,以使用第 4 行定义的结构。然后,当执行第 41 行时,我们指定从那时起要使用的文件。亲爱的读者,请注意这一点。如果没有第 41 行,后续的调用将不会产生任何实际效果。
但有趣的地方在第 45 行。在这个阶段,我们将之前指向第 41 行定义的文件的信息流重定向到另一个沙箱中的相同文件名。但这并不是全部。请注意,尽管如此,文件名与第 41 行指定的文件名相同。但是,在这里,我们告诉 MetaTrader 5 将数据流重定向到另一个沙箱。
我们可以这样做吗?是的,亲爱的读者,这是有可能的。请注意,无论代码应该或能够如何实现,只要我们在指定的沙箱中拥有写权限,我们就可以轻松地将数据流定向到任何可用的文件。
在实践中,这比这段代码看起来要有趣得多。因此,当执行代码 08 时,将创建两个文件,如下所示。
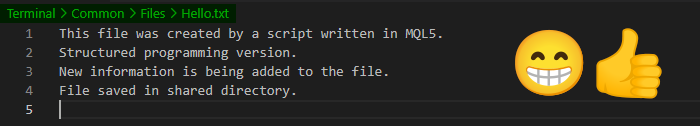
图 04
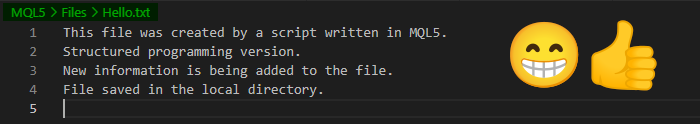
图 05
请注意,内容有所不同,绿色高亮显示的目录也不同。
最后的想法
在本文中,我们了解到,处理文件系统并没有一个固定的公式。我们开始实践一些对许多人来说可能看似困难的事情,但随着时间推移、不断学习和实践,你会逐渐乐在其中,并建立信心。没有神奇的解决方案。其精髓在于以一种方式应用不同的概念,最终获得特定的结果。
所以,亲爱的读者,请务必学习并实践你在这里看到的内容。只有正确理解,再加上不断的练习和持续寻找完成同一任务的新方法,才能获得你所需的知识。在附件中,您可以找到用于学习和练习此处所提供信息的代码。但请勿完全按照附件中提供的代码使用。尝试修改代码,尤其是代码 08,以便更好地理解第 41 行和第 45 行如何影响整体执行结果。在未来,在课程讲解完毕后,我们会发现,只要经过适当的调整,代码 08 具有很大的改进空间和更易使用的潜力。但要做到这一点,首先需要了解这种结构化代码是如何工作的。
| MQ5 文件 | 描述 |
|---|---|
| 代码 01 | 文件访问演示 |
| 代码 02 | 文件访问演示 |
| 代码 03 | 文件访问演示 |
| 代码 04 | 文件访问演示 |
| 代码 05 | 文件访问演示 |
| 代码 06 | 文件访问演示 |
| 代码 07 | 文件访问演示 |
| 代码 08 | 文件访问演示 |
本文由MetaQuotes Ltd译自葡萄牙语
原文地址: https://www.mql5.com/pt/articles/16211
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。
 交易中的神经网络:以分解替代规模化 —— 模块构建
 基于平均K线(Heikin Ashi)搭建专业交易系统(第一部分):自定义指标开发
 市场模拟:仓位视图(四)
 交易中的神经网络:以分解替代模型规模扩张(SSCNN)
