

Возможности Мастера MQL5, которые вам нужно знать (Часть 94): Использование выборки из резервуара и линейной регрессии в пользовательском классе трейлинг-стопа
 123
 0

Введение
В последней статье серии о трейлинг-стопах рассматривалось сочетание алгоритма на основе списков с пропусками и сети Хопфилда на основе ассоциативной памяти – решение, адаптированное для сред с резким моментумом. Можно сказать, что этот подход подходит агрессивным трейдерам, работающим на быстро меняющихся рынках с большим количеством гэпов. В таких случаях несвязная динамика цены часто является нормой.
Однако, как правило, для разных рыночных условий и стилей торговли подходят разные модели. Попытки разработать универсальное решение зачастую изначально обречены на неудачу. В этой статье мы рассмотрим сочетание выборки из резервуара с сетью линейной регрессии. Это переход от ассоциативной памяти к статистической нормализации. Этот подход особенно подходит для рынков, где фильтрация микрошумов и отслеживание сглаженного, экономного по памяти буфера среднего значения эффективнее быстрого обнаружения гэпов.
Математическое определение
Чтобы показать, почему эта комбинация моделей эффективна в условиях непрерывного тренда, необходимо рассмотреть ее два основных компонента. Наша реализация трейлинг-стопа работает в двух режимах: "механизм" – алгоритм выборки из резервуара, формирующий вероятностно стабилизированную базовую цену; и "фильтр" – сеть линейной регрессии, определяющая, безопасно ли обновлять стоп-лосс.
Выборка из резервуара
В большинстве алгоритмических торговых систем, высокочастотных или нет, хранение каждого ценового бара для расчета скользящей средней может быть вычислительно затратным. По мере увеличения размера буфера нагрузка на ресурсы может стать серьезным ограничением в контексте обработки данных. Если с помощью списка с пропусками сопоставлялись разрывные ценовые гэпы путем пропуска данных, то выборка из резервуара решает другую задачу. Как при минимальном потреблении памяти поддерживать статистически репрезентативное и корректное представление цен из непрерывного потока данных неизвестного размера? С помощью алгоритма выборки из резервуара. Мы определяем, должна ли поступающая цена заменить существующий элемент в буфере, то есть резервуаре, при фиксированном использовании памяти. При реализации выполняются следующие шаги:
- задается фиксированный размер массива резервуара k;
- первые k цен торговой сессии копируются в этот массив;
- после этого для каждой новой цены с индексом i, где i > k, генерируется случайное целое число j от 1 до i;
- если j меньше или равно k, новая цена заменяет в резервуаре цену с индексом j.
Формула основана на вероятности того, что новая точка данных заменит существующую точку в резервуаре; эта вероятность уменьшается по мере роста общего потока данных. Это выражается следующим образом:
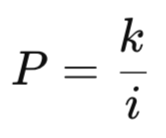
Где:
- P – вероятность замены;
- k – фиксированный максимальный размер массива резервуара;
- i – индекс (текущий счетчик) поступающего ценового бара.
Поскольку каждая точка потока имеет одинаковую вероятность k/i попасть в резервуар, выборка со временем остается равномерно сбалансированной. Алгоритм в той или иной степени отфильтровывает микрошум и мгновенные обвалы цены, не накапливая лишние объемы данных. В Тестере стратегий MQL5 псевдослучайные генераторы, такие как MathRand(), используют общее глобальное состояние. Чтобы сохранить целостность выборки и обеспечить повторяемость результатов тестирования на исторических данных, случайность изолируется с помощью детерминированного линейного конгруэнтного генератора. Это встроено непосредственно в класс, как показано далее в разделе с кодом.
Линейная регрессия
Хотя выборка из резервуара помогает получить стабилизированную базовую цену для корректировки стоп-лосса, этот метод по своей сути опирается на исторические данные. Это связано с тем, что метод показывает, где рынок находился большую часть времени, но не дает направленного сигнала о том, куда может пойти цена. В предыдущей статье о трейлинг-стопах использовалась сеть Хопфилда, поскольку ее ассоциативная память хорошо распознает хаотичные и фрагментированные паттерны. Однако сети Хопфилда могут быть избыточны при работе с плавными непрерывными трендами. В таких условиях используется более простая однослойная прогнозирующая сеть, применяющая метод наименьших квадратов (OLS) для линейной регрессии.
Вместо сопоставления паттернов линейная регрессия вычисляет базовый математический вектор текущего ценового движения. Она служит фильтром принятия решений: когда рассчитанный вектор прогнозирует резкое движение рынка против текущей позиции, трейлинг-стоп замораживается, чтобы избежать его преждевременного срабатывания из-за микроотката. Формула, используемая сетью, определяет линию наилучшего приближения по скользящему окну последних цен. Основное уравнение имеет следующий вид:
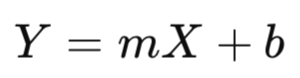
Для получения наклона (m) и пересечения с осью Y (b) сеть минимизирует сумму квадратов вертикальных отклонений ценовых данных от линии наилучшего приближения. Ниже приведены уравнения наклона и пересечения с осью Y:
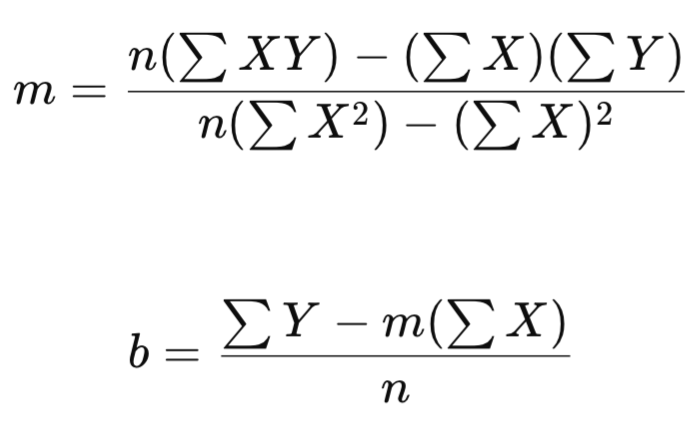
Где:
- Y – прогнозируемая будущая цена;
- X – прогнозируемый будущий временной шаг, рассчитываемый как n + 1;
- ΣX – сумма временных индексов от 1 до n;
- ΣY – сумма наблюдаемых цен в скользящем окне;
- ΣXY – сумма произведений временных индексов и соответствующих цен;
- ΣX^2 – сумма квадратов временных индексов.
Прогнозируя Y для следующего ценового бара, сеть определяет логику выполнения. Например, при трейлинге длинной позиции, если сеть прогнозирует нисходящий вектор (Y < текущей цены), трейлинг-стоп приостанавливается. Когда микрооткат завершается и вектор снова направлен вверх, механизм выборки из резервуара может возобновить трейлинг.
Реализация на MQL5
Для реализации этой двухфазной модели создается пользовательский класс трейлинг-стопа CTrailingReservoirLinReg. Этот класс, как и ранее, напрямую наследуется от класса стандартной библиотеки CExpertTrailing, тесно интегрированного с другими классами Мастера MQL5. Пользовательский класс позволяет оптимизировать размер резервуара, режим итерации и включать или отключать фильтр сети линейной регрессии.
Рассмотрим код, показывающий, как модель обрабатывает непрерывные данные при эффективном использовании памяти. На этапе инициализации класса в этой стандартной функции также выделяется память. В отличие от стратегий, которым требуется много исторических буферов, этот класс с помощью динамических массивов строго контролирует объем используемой памяти. В функции инициализации индикатора выделяется только объем оперативной памяти, заданный пользователем через входные параметры.
//+------------------------------------------------------------------+
//| Initialize Indicators and Arrays                                 |
//+------------------------------------------------------------------+
bool CTrailingReservoirLinReg::InitIndicators(CIndicators *indicators)
  {
   if(!CExpertTrailing::InitIndicators(indicators))
      return false;
//--- Initialize dynamic arrays for algorithms and networks
   if(m_res_size <= 0)
      m_res_size = 100;
   if(m_lr_period <= 0)
      m_lr_period = 14;
   ArrayResize(m_reservoir, m_res_size);
   ArrayInitialize(m_reservoir, 0.0);
   ArrayResize(m_lr_prices, m_lr_period);
   ArrayInitialize(m_lr_prices, 0.0);
   return true;
  }
Однократное использование функций ArrayResize() и ArrayInitialize() при запуске советника предварительно выделяет память для репрезентативной выборки m_reservoir и скользящего окна сети m_lr_prices. Также используются резервные значения 100 и 14, чтобы избежать ошибок выхода за пределы массива при недопустимых нулевых значениях входных параметров. Далее рассматривается детерминированное ядро, то есть алгоритмический механизм. Основная сложность при тестировании вероятностных случайных алгоритмов в Тестере стратегий MQL5 состоит в том, что встроенные функции, такие как MathRand(), зависят от общего глобального состояния.
Когда в тесте MathRand() вызывается индикатором, фоновым событием или другим советником, глобальное состояние по своей природе изменяется непредсказуемо. Такая предусмотренная рассинхронизация может нарушить воспроизводимость репрезентативной выборки. В результате оптимизация или тонкая настройка этого алгоритма вместе с другими торговыми классами и системами становится проблематичной. Чтобы обеспечить максимальную воспроизводимость результатов тестирования на исторических данных, случайность алгоритма изолируется с помощью линейного конгруэнтного генератора (LCG), встроенного непосредственно в класс:
//+------------------------------------------------------------------+
//| Isolated Deterministic Random Generator (POSIX.1 LCG)            |
//+------------------------------------------------------------------+
int CTrailingReservoirLinReg::DeterministicRand()
  {
//--- Normalizes randomness completely independent of MT5's MathRand()
//--- Guarantees identical sequence generation per backtest pass
   m_norm_seed = (m_norm_seed * 1103515245 + 12345) & 0x7FFFFFFF;
   return (int)m_norm_seed;
  }
В приведенном выше листинге ключевое значение имеет побитовая операция AND & 0x7FFFFFFF. Ее использование маскирует знаковый бит, гарантируя, что LCG всегда будет возвращать положительное целое число, которое можно безопасно преобразовать в допустимый индекс массива. Затем нормализованный механизм использует в диспетчере состояний логику замены P = k/i:
//+------------------------------------------------------------------+
//| Reservoir State Manager (Algorithm R Core)                       |
//+------------------------------------------------------------------+
void CTrailingReservoirLinReg::UpdateReservoirState(double price)
  {
   m_samples_seen++;
   if(m_samples_seen <= m_res_size)
     {
      m_reservoir[m_samples_seen - 1] = price;
     }
   else
     {
      //--- Standard Reservoir Sampling replacement probability
      //--- utilizing the deterministic normalization factor
      int random_index = DeterministicRand() % m_samples_seen;
      if(random_index < m_res_size)
         m_reservoir[random_index] = price;
     }
  }
При вызове UpdateReservoirState() сначала постепенно заполняется выделенный массив памяти, пока m_samples_seen не станет больше m_res_size. После заполнения массива используется детерминированный случайный индекс, получаемый по модулю числа обработанных ценовых баров (DeterministicRand() % m_samples_seen), для замены старых баров новыми. Благодаря вероятностному отбору выборка сохраняет репрезентативность на неограниченном временном интервале без увеличения объема памяти.
Как и в предыдущих статьях серии, основной алгоритм реализуется в четырех различных режимах. Эти режимы можно настраивать, чтобы трейдеры выбирали вариант, подходящий для их торговой ситуации. После формирования репрезентативной выборки класс использует оператор switch в стандартных функциях для длинных и коротких позиций CheckTrailingStopLong() и CheckTrailingStopShort(). Резервуар оценивается четырьмя способами. Ниже показан первый режим, использующий среднее значение выборки:
//+------------------------------------------------------------------+
//| Mode 1: Standard Mean of Fair Sample                             |
//+------------------------------------------------------------------+
double CTrailingReservoirLinReg::ReservoirModeMean(double price)
  {
   double sum = 0.0;
   int count = MathMin(m_samples_seen, m_res_size);
   if(count == 0)
      return price;
   for(int i = 0; i < count; i++)
      sum += m_reservoir[i];
   return sum / count;
  }
В этом режиме массив перебирается для расчета статистического среднего. При этом используется MathMin(m_samples_seen, m_res_size), чтобы цикл for обрабатывал только данные, существующие на начальном этапе. Поскольку выборка вероятностно репрезентативна, она теоретически формирует более плавную базовую линию для установки уровней стоп-лосса по сравнению с запаздывающим эффектом, характерным для простых скользящих средних. Второй режим отличается от первого тем, что вместо усреднения всех значений определяются абсолютные минимум и максимум репрезентативной выборки.
В режиме 2 переменным min_val и max_val присваивается значение m_reservoir[0], затем с индекса 1 выполняется цикл для динамического обновления экстремальных значений. Возвращаемое значение (max_val + min_val) / 2.0 формирует срединный уровень, который может выступать признаком стабильности и некоторого иммунитета к плотным скоплениям микробаров. Следующий режим, режим 3, реализует адаптивность к волатильности. В ситуациях, когда тренд растягивается и сжимается в определенном ритме, в этом режиме базовая цена корректируется с учетом стандартного отклонения. Это реализуется следующим образом:
//+------------------------------------------------------------------+
//| Mode 3: Volatility Adjusted (Mean shifted by Std Dev)            |
//+------------------------------------------------------------------+
double CTrailingReservoirLinReg::ReservoirModeVolatility(double price)
  {
   int count = MathMin(m_samples_seen, m_res_size);
   if(count < 2)
      return price;
   double mean = ReservoirModeMean(price);
   double variance_sum = 0.0;
   for(int i = 0; i < count; i++)
      variance_sum += MathPow(m_reservoir[i] - mean, 2);
   double std_dev = MathSqrt(variance_sum / count);
//--- Stabilize price by pulling it toward the mean minus/plus volatility buffer
   return (price > mean) ? mean + std_dev : mean - std_dev;
  }
Дисперсия выборки рассчитывается с помощью MathPow(m_reservoir[i] - mean, 2). Затем значения суммируются и с помощью MathSqrt() извлекается квадратный корень. С помощью тернарного оператора базовая трейлинг-цена динамически повышается или понижается на одно стандартное отклонение:
(price > mean) ? mean + std_dev : mean - std_dev
Эта корректировка ужесточает стоп-лосс при всплесках волатильности. В режиме 4 используется затухание с приоритетом недавних данных. Это означает, что непрерывная выборка, резервуар, связывается с недавним моментумом. Рассчитывается среднее значение репрезентативной выборки, которое затем объединяется с текущей ценой по следующему взвешиванию:
(mean * 0.3) + (price * 0.7)
Это повышает отзывчивость при усилении непрерывного тренда, приближая стоп-лосс к текущей цене. Далее рассматриваются фильтр на основе сети и динамический сдвиг массива. Прогнозирующий фильтр реализован двумя функциями. Первая функция, UpdateLinReg(), поддерживает скользящее окно цен. Если массив m_lr_prices заполнен, она выполняет цикл for, сдвигающий все элементы массива на один индекс влево:
m_lr_prices[i] = m_lr_prices[i + 1] Благодаря этому в конце массива освобождается место для добавления нового значения:
m_lr_prices[m_lr_period - 1] = price Вторая функция, GetLinRegPrediction(), вычисляет вектор методом наименьших квадратов, как показано ниже:
//+------------------------------------------------------------------+
//| Linear Regression Prediction (Y = mX + b)                        |
//+------------------------------------------------------------------+
double CTrailingReservoirLinReg::GetLinRegPrediction()
  {
   if(m_lr_count < m_lr_period)
      return m_lr_prices[m_lr_count - 1];
   double sum_x = 0, sum_y = 0, sum_xy = 0, sum_x2 = 0;
   int n = m_lr_period;
   for(int i = 0; i < n; i++)
     {
      double x = (double)(i + 1);
      double y = m_lr_prices[i];
      sum_x  += x;
      sum_y  += y;
      sum_xy += x * y;
      sum_x2 += x * x;
     }
//--- Calculate Slope (m) and Intercept (b)
   double denominator = (n * sum_x2) - (sum_x * sum_x);
   if(denominator == 0.0)
      return m_lr_prices[n - 1];
   double m = ((n * sum_xy) - (sum_x * sum_y)) / denominator;
   double b = (sum_y - (m * sum_x)) / n;
//--- Predict the *next* data point in the series (X = n + 1)
   return m * (n + 1) + b;
  }
Эта модель выполняет итерации для вычисления сумм sum_x, sum_y, sum_xy и sum_x2. Также предусмотрена защита от деления на ноль:
if(denominator == 0.0)
Если условие выполняется, возвращается последняя известная цена, чтобы избежать ошибок времени выполнения. Затем решается уравнение Y = mX + b, чтобы спрогнозировать следующее значение Y, то есть следующую точку ценовых данных, когда X = n + 1. Затем логика исполнения проверяет результат следующего условия:
//--- 1. Linear Regression Network (Predictive Filter)
   if(m_use_linreg)
     {
      UpdateLinReg(price);
      // If the trend is predicted to fall below price, hold stop
      if(m_lr_count >= m_lr_period && GetLinRegPrediction() < price)
         return false;
     }
Если сеть прогнозирует вектор против текущей позиции, например Y < текущей цены для позиции на покупку или Y > текущей цены для короткой позиции, корректировка трейлинг-стопа приостанавливается, а предложенная базовая цена игнорируется. Кроме того, предусмотрена дополнительная защита от недопустимых уровней стоп-лосса. Это критически важно, поскольку система трейлинг-стопа, которая при корректировке стоп-лосса выдает только ошибки, не представляет большой ценности. Вероятность этой ошибки минимизируется за счет обрамления логики выполнения динамическими границами, учитывающими абсолютные лимиты брокера:
//--- 3. Execution Logic
   double new_sl = NormalizeDouble(fmin(base_price, m_symbol.Bid()) - (((2 * m_symbol.Spread()) + m_symbol.FreezeLevel() + m_symbol.StopsLevel()) * m_symbol.Point()), m_symbol.Digits());
   double current_sl = position.StopLoss();
   sl = EMPTY_VALUE;
   tp = EMPTY_VALUE;
   if(new_sl > current_sl || current_sl == 0.0)
     {
      sl = new_sl;
      return true;
     }
Вместо статического условия if используется:
fmin(base_price, m_symbol.Bid()) Это применяется к длинным позициям, чтобы модель выбирала более низкое значение цены. Благодаря этому, если базовая цена резервуара выше данного значения, конфликтов не возникает. В качестве дополнительной меры из минимальной цены вычитаются стоп-уровень, уровень заморозки и как минимум удвоенный спред. Благодаря этому система лучше учитывает проскальзывание, характерное для значимых новостей и макроэкономических событий. Эти значения хранятся в классе символа как целые числа, поэтому для получения ценовых единиц их нужно умножить на размер пункта. Наконец, вычисленное значение нормализуется до числа знаков после запятой, требуемого символом, для которого корректируется стоп-лосс. Это предотвращает ошибку недопустимой цены.
Для короткой позиции эта защитная логика зеркально повторяется следующим образом:
fmax(base_price, m_symbol.Ask()) Это задает максимально допустимую верхнюю границу цены и тем самым предотвращает модификации, которые привели бы к недопустимо низким значениям. Как и выше, вместо вычитания, применяемого для длинной позиции, добавляются требуемые брокером ценовые расстояния. Ограничение выходных данных алгоритма резервуара приводит цену в соответствие с текущими рыночными условиями. Обязательные ценовые буферы брокера делают советник практически защищенным от ошибок недопустимых уровней стоп-лосса. Теоретически это позволяет советнику выполнять трейлинг позиций и приостанавливать обновления только тогда, когда фильтр линейной регрессии сигнализирует о неблагоприятном следующем интервале.
Результаты тестирования и анализ
Для демонстрации преимуществ этого трейлинг-стопа тестируется советник на символе EURJPY за типичный период с 1.01.2025 по 1.05.2026 на 4-часовом таймфрейме. Как и ранее, для оптимизации используется 2025 год, а форвардное тестирование проводится в первые четыре месяца 2026 года. Эти тесты позволяют не только измерить эффективность модели, но и независимо оценить работу ее двух основных частей – алгоритма и сети. Сеть нельзя использовать отдельно, поэтому тестируются два режима: только алгоритм и алгоритм вместе с сетью.
Алгоритм выборки из резервуара
В первом тестовом прогоне советник был настроен на использование только алгоритма, а параметру Trailing_ReservoirLinReg_UseLinReg было присвоено значение false. По результатам оптимизации за 2025 год значение 20 выбрано как оптимальный размер резервуара. Оптимальным режимом алгоритма выбран режим 1 (из четырех доступных). При этих основных настройках и типичных порогах открытия и закрытия форвардное тестирование в 2026 году дало восемь сделок, вполне достойный профит-фактор 3,03 и чистую прибыль 545,83 USD. Эта прибыль достигнута при просадке 4,84%, что в абсолютном выражении составляет чуть более 480 USD.
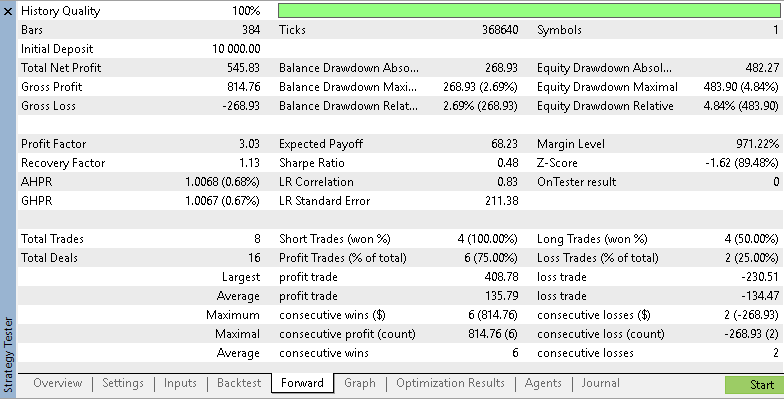
Таким образом, подход без прогнозирующего фильтра на основе среднего значения по резервуару оказывается достаточно прибыльным. Однако при внезапных откатах он может приводить к большим потерям, особенно на более длительном периоде тестирования. Хотя алгоритм выполняет трейлинг ожидаемым образом, ему не хватает способности опережающе оценивать дальнейшее движение цены, необходимой для остановки корректировки стоп-лосса в особых ситуациях. Здесь используется сеть.
Сеть линейной регрессии
Во втором прогоне сетевой фильтр активируется присвоением входному параметру Trailing_ReservoirLinReg_UseLinReg значения true. После перехода к этой логике оптимизация показывает, что размер резервуара увеличивается до 56 точек данных, формируя более широкую статистическую базу, при этом сохраняется режим работы 1 (из четырех доступных). Выбранный период линейной регрессии составил 83.
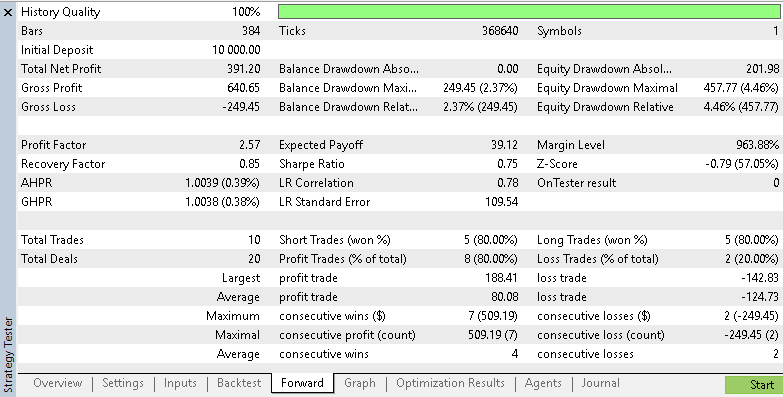
Эти изменения, главным образом добавление сети, привели к увеличению общего числа сделок, снижению чистой прибыли до 391,20 USD и профит-фактора до 2,57. При этом, возможно, положительным результатом стало снижение просадки по средствам счета до 4,46%, или примерно 458 USD. Хотя на первый взгляд эти результаты могут показаться ухудшением, снижение просадки по средствам счета требует дальнейшего тестирования и анализа на более длительных периодах и на более широком наборе торговых символов.
Заключение
Подводя итог, в алгоритмической торговле нет готового универсального решения для установки трейлинг-стопа. Сравнение этого подхода с подходом из статьи о списках с пропусками и сети Хопфилда подчеркивает необходимость подбора математических инструментов под конкретные рыночные условия. Ассоциативная память сети Хопфилда хорошо работает на фрагментированных хаотичных рынках с множеством гэпов, которые могут предпочитать агрессивные трейдеры или трейдеры с более высокой терпимостью к риску. Статистическая нормализация на основе выборки из резервуара может лучше подходить трендовым стратегиям, особенно на рынках с более непрерывной динамикой и высокой долей алгоритмической торговли.
Поддержание вероятностной репрезентативной выборки ценовых данных в оперативной памяти позволяет избежать значительных вычислительных затрат, характерных для больших массивов данных. Сочетание этого подхода с прогнозирующим сглаживанием фильтра линейной регрессии в результате дает стратегию, которая жертвует более высокой чистой прибылью ради меньшей просадки и более высокого коэффициента Шарпа. Таким образом, целью должно быть не нахождение лучшей модели, а корректная диагностика рыночных условий и использование алгоритма или сети, что может оказаться более продуктивным подходом.
| имя | описание |
|---|---|
| wz_94.mq5 | Советник, собранный Мастером MQL5 |
| TrailingReservoirLinReg.mqh | Пользовательский класс трейлинга, необходимый для сборки советника Мастером MQL5 |
| r1.set | Входные параметры для первого тестового прогона |
| r2.set | Входные параметры для второго тестового прогона |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22901
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Разработка индикатора Market Memory Zones: Зоны вероятного возврата цены
 Моделирование рынка: Position View (XIX)
 Возможности Мастера MQL5, которые вам нужно знать (Часть 96): Использование вейвлетного порогового преобразования и сети LSTM в пользовательском классе управления капиталом
 От начального до среднего уровня: Перегрузка операторов (I)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования