

Нейронная сеть на практике: Начинаем строить цепочку
 65
 2

Введение
В предыдущей статье, Нейронная сеть на практике: Вопрос шкалы, было объяснено довольно необычное явление, которое необходимо хорошо понять, поскольку подобная ситуация может повлиять на обучаемую систему и полностью сделать обучение невозможным. И самое странное, что перцептрон, используя функцию наименьших квадратов, может сходиться, уменьшая свою ошибку. При использовании градиента этого может и не происходить, даже если сохраняются те же самые обучающие данные.
В этой статье мы продолжим рассматривать тот же вопрос, но с несколько иной точки зрения, поскольку здесь проанализируем, что происходит, когда используем небольшую последовательность перцептронов, соединённых последовательно. Или, короче говоря, что происходит, когда мы меняем масштаб данных и используем выход одного перцептрона как вход для нового перцептрона.
Небольшой удар по самолюбию
Прежде чем мы действительно перейдём к коду, я хочу поговорить кое о чём, что может помочь вам понять один довольно странный момент, который на первый взгляд не имеет особого смысла.
Сказанное во введении может показаться чем-то выбивающимся из общего контекста: в определённых сценариях система перцептронов может сходиться при коррекции с помощью коррекции по методу наименьших квадратов и при этом не удаваться уменьшить ошибку при обучении методом градиента. Это объясняется именно тем, что все говорят, будто градиент лучше, чем при коррекции по методу наименьших квадратов.
Тот, кто изучает программирование и занимается им, знает, что иногда то, что кажется хуже, может удивить в некоторых конкретных ситуациях. Типичный пример — сортировка данных. Если поискать алгоритмы сортировки, то можно увидеть, что многие называют QuickSort лучшим из существующих алгоритмов, а Bubble Sort — худшим именно из-за принципа его работы. Поэтому казалось бы очевидным и разумным, что всякий раз, когда нужно сортировать данные, QuickSort должен быть наиболее подходящим вариантом. И вот здесь всё начинает становиться странным. Бывают случаи, когда при использовании QuickSort производительность оказывается ниже, чем при использовании Bubble Sort. Как такое возможно? В этом нет никакого смысла. Что ж, мой друг-читатель, правда в том, что то, что нравится всем, не всегда действительно является лучшим выбором.
Такого рода ситуация, которую мы видели в предыдущей статье и которую здесь рассмотрим подробнее, может показаться несколько неудобной, если анализировать её недостаточно внимательно. Выбор механизма, который следует использовать для исправления ошибки сети или даже отдельного перцептрона, должен делаться с учётом не только экономии вычислительных ресурсов, но и способности самого механизма обеспечивать сходимость ошибки к более низкому уровню. Система, реализованная для определённого класса задач может с треском провалиться, если использовать её в совершенно иной ситуации. По этой причине, соединяя перцептроны, мы должны учитывать тип задачи, с которой будем работать, поскольку не существует формулы, которую нужно всегда применять в любой ситуации.
Поскольку мы подходим к пределу того, что можно сделать с помощью одного перцептрона, возможно, значительная часть того, что будет здесь объясняться, начнёт казаться некоторым несколько неудобной. Это связано с тем, что нам нужно начать думать о топологии сети, и в этот момент вопрос перестаёт быть просто любопытной темой и становится чем-то немного более серьёзным.
Обычно, и в этом нет ничего плохого, многие просто предпочитают использовать какой-нибудь фреймворк, чтобы не думать о топологии сети перцептронов. Однако использование подобных инструментов и компонентов не помогает нам понять, как всё действительно работает. Оно лишь всё упрощает, скрывая значительную часть того, что на самом деле нужно знать, прежде чем утверждать, что вы умеете реализовывать сеть перцептронов и понимаете, как она работает при решении самых разных задач.
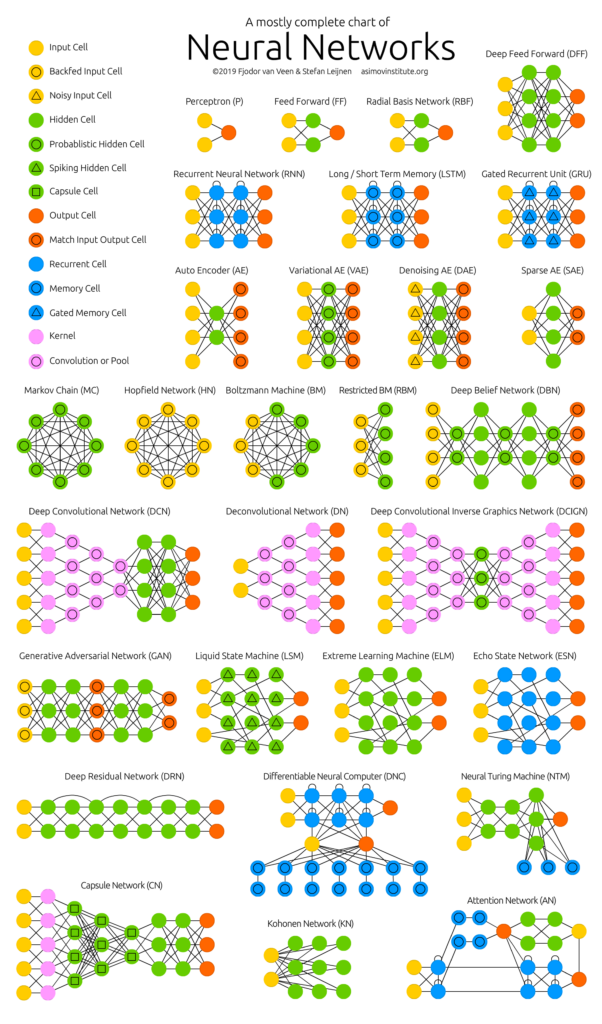
Изображение 01
На этом изображении показаны основные способы соединения перцептронов в различных конфигурациях. Многие из вас, наверное, уже слышали о сетях со скрытыми слоями и тому подобном. Но я уверен, что вы не знали, что между ними есть различия. Существуют даже сети без скрытых слоёв или такие, у которых точки входа и выхода данных чётко не определены. Это расходится с привычным представлением о том, что у сети есть точка входа и точка выхода. Важно то, что редко упоминается: эти точки не всегда чётко определены, поскольку зависят от выбранной топологии.
Здесь, в этих статьях, поскольку мы сосредоточены на учебной стороне вопроса, я всегда использовал модели, в которых вход и выход чётко определены. Что касается входа, то, как уже было показано, их может быть несколько. Что касается выхода, то до сих пор у нас был только один. Но это не значит, что так будет всегда или что так и должно быть. На практике архитектуры с несколькими выходами встречаются чаще, чем с одним. Но, чтобы иметь более одного выхода, мы, скорее всего, используем более одного перцептрона. Однако это ни в коем случае не правило. Не беспокойтесь об этом сейчас. В другой раз мы рассмотрим это более спокойно.
Хорошо, раз у нас уже есть работающий перцептрон и мы уже знаем, как подавать данные, чтобы добиться определённого обучения, мы можем сделать ещё несколько шагов. Это правда, что я ещё не объяснил, зачем нужны функции активации. Но на это есть причина. Объяснять функции активации имеет смысл только тогда, когда мы начинаем работать более чем с одним перцептроном или когда нам нужно получить определённый тип выходных данных. Однако, поскольку здесь я не буду работать с конкретными выходами, нам нужно хотя бы определить простую топологию, или архитектуру сети, чтобы понять, что значит использовать ту или иную функцию активации. Просто сказать: «Я буду использовать эту функцию, потому что она кажется лучше», или «Я буду использовать ту, потому что все говорят, что она даёт хорошие результаты», — это просто глупость. Правильный выбор зависит от различных факторов. Однако, чтобы понять эти факторы, нам сначала понадобится немного более сложная топология. Недостаточно использовать только один перцептрон. Нам нужно больше перцептронов.
Новое начало
Многие думают, что для существования сети нужны сотни, тысячи или, возможно, миллионы некоторым образом соединённых между собой перцептронов. Но на практике всё работает не совсем так. На самом деле нам нужно, чтобы каждый перцептрон мог работать совместно с другими перцептронами. Неважно, работают ли они синхронно или асинхронно. Параллельно или последовательно. Это не так уж важно. На самом деле нам нужно, чтобы несколько отдельных перцептронов работали так, словно это один мощный перцептрон. Представьте это как муравьиную работу. Один муравей не может сдвинуть гору. Но огромный муравейник может сдвинуть практически что угодно.
Если только им дать достаточно времени, чтобы сделать свою работу. По отдельности каждый муравей может сдвинуть небольшой камешек. Но когда все они объединяются, всё приобретает совсем иной масштаб. Однако, если они не будут организованы, в итоге им не удастся построить гору. Они даже могут превратить гору в кучу мелких камешков. Но на этом всё и закончится. А вот если каждая из них сможет сообщать остальным, какая работа уже выполнена, то в конце концов они достигнут цели. И именно это мы и должны начать делать с этого момента.
Если перенести эту идею, о которой говорилось выше, на построение сети, мы начнём понимать, как создать набор перцептронов и добиться того, чтобы каждый из них по отдельности достиг определённой степени сходимости. Но что произойдёт, если мы их соединим? То есть если выход одного перцептрона подключить ко входу другого, что на самом деле произойдёт? Итак, именно здесь начинается самое интересное, и именно здесь мы начинаем использовать сети на практике.
Давайте сделаем следующее: на основе кода, который мы рассмотрели в предыдущей статье, создадим небольшую цепочку из двух перцептронов, где выход одного будет подключён ко входу другого. Нам важно, чтобы несколько отдельных перцептронов работали так, как если бы они были одним мощным перцептроном. Чтобы это выглядело правдоподобнее и было легче понять, давайте для начала рассмотрим пример кода. Для начала мы целиком воспользуемся кодом, приведённым ниже.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property script_show_inputs
04. #property description "Experiencing a simple chain of neurons"
05. //+------------------------------------------------------------------+
06. #include <Neural Network\C_Neuron.mqh>
07. //+------------------------------------------------------------------+
08. enum eFactorization {
09.                         Minimum_Square,
10.                         Gradient_Descent,
11.                     };
12. //+------------------------------------------------------------------+
13. input eFactorization        user00 = Minimum_Square;        //Тип факторизации
14. input double                user01 = 1e-6;                  //Оценочная ошибка
15. input double                user02 = 1e-6;                  //Скорость обучения
16. input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Функция активации
17. //+------------------------------------------------------------------+
18. //Выражение для обучения: f(x) = (w0 * 2)
19. //+------------------------------------------------------------------+
20. double Train[] {
21.                 0, 0,
22.                 1, 2,
23.                 2, 4,
24.                 3, 6
25.                };
26. //+------------------------------------------------------------------+
27. #define nColumns    2
28. #define nLines      Train.Size() / nColumns
29. //+------------------------------------------------------------------+
30. void SimpleChain(void)
31. {
32.     C_Neuron *neuron;
33.
34.     neuron = new C_Neuron(nColumns - 1, user03, user00 == Minimum_Square);
35.
36.     (*neuron).Learning(Train, 1.0, user01, user02, ULONG_MAX);
37.     (*neuron).View_Variables();
38.
39.     delete neuron;
40. }
41. //+------------------------------------------------------------------+
42. void OnStart()
43. {
44.     Print("************************************");
45.     Print("A simple chain of neurons...");
46.     Print("************************************");
47.     Print("Parameters:");
48.     Print("Type of factorization: ", EnumToString(user00));
49.     Print("Estimated error: ", user01);
50.     Print("Learning Rate:", user02);
51.     Print("Activation function: ", EnumToString(user03));
52.     Print("************************************");
53.
54.     SimpleChain();
55. }
56. //+------------------------------------------------------------------+
Код 01
Это довольно простой код, и все, кто следит за этими статьями, уже должны понимать, что здесь происходит. Поэтому я не вижу необходимости комментировать, как он работает. Тем не менее, просто из любопытства давайте посмотрим, какой результат мы получим.
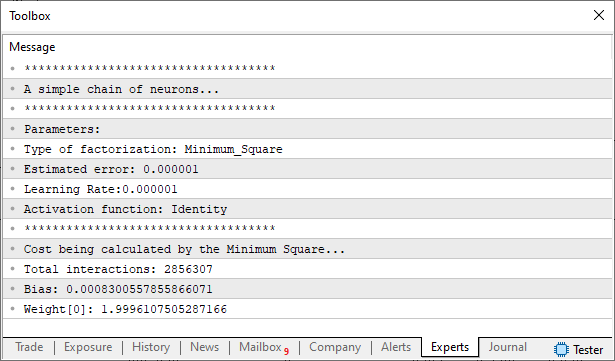
Изображение 02
Определённо, ничего неожиданного. Теперь мы немного изменим подход, чтобы можно было контролировать количество перцептронов, соединённых в цепочку. Таким образом, выход одного будет входом следующего. В итоге цель состоит в том, чтобы создать нечто похожее на то, что мы увидим ниже.
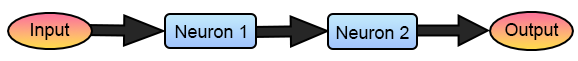
Изображение 03
Обратите внимание, что мы соединяем только два перцептрона — это самый простой возможный случай. Но давайте посмотрим, как это будет выглядеть в коде. Сначала изменим код, чтобы получить нечто вроде показанного ниже.
18. //+------------------------------------------------------------------+
19. void SimpleChain(const uchar nNeurons, const ulong Limit)
20. {
21.     C_Neuron *neuron[];
22.     double err, tmp[], v0[nColumns - 1];
23.
24.     if (!nNeurons)
25.         return;
26.
27.     ArrayResize(neuron, nNeurons);
28.     for (uchar c = 0; c < nNeurons; c++)
29.         neuron[c] = new C_Neuron(nColumns - 1, user03, user00 == Minimum_Square);
30.
31.     ArrayResize(tmp, Train.Size());
32.     for (ulong count = 0; count < Limit; count++)
33.     {
34.         ArrayCopy(tmp, Train);
35.         for (uchar c = 0; c < nNeurons; c++)
36.         {
37.             if ((err = (*neuron[c]).Learning(tmp, 1.0, user01, user02, 1)) < user01)
38.                 break;
39.             for (uchar nl = 0; nl < nLines; nl++)
40.             {
41.                 v0[0] = tmp[nl * nColumns];
42.                 tmp[nl * nColumns] = (*neuron[c]).Perceptron(v0);
43.             }
44.         }
45.     }
46.
47.     for (uchar c = 0; c < nNeurons; c++)
48.     {
49.         PrintFormat("====== information of neuron number #%02d ======", c);
50.         (*neuron[c]).View_Variables();
51.     }
52.
53.     for (uchar c = 0; c < nNeurons; c++)
54.         delete neuron[c];
55.
56.     ArrayFree(tmp);
57.     ArrayFree(neuron);
58. }
59. //+------------------------------------------------------------------+
60. void OnStart()
61. {
62.     Print("************************************");
63.     Print("A simple chain of neurons...");
64.     Print("************************************");
65.     Print("Parameters:");
66.     Print("Type of factorization: ", EnumToString(user00));
67.     Print("Estimated error: ", user01);
68.     Print("Learning Rate:", user02);
69.     Print("Activation function: ", EnumToString(user03));
70.     Print("************************************");
71.
72.     SimpleChain(1, 10);
73. }
74. //+------------------------------------------------------------------+
Фрагмент 01
Очевидно, то, что мы сделали, не даст идеального кода, поскольку будут появляться сообщения из класса C_Neuron, которые нам не интересны, как видно на следующем изображении.
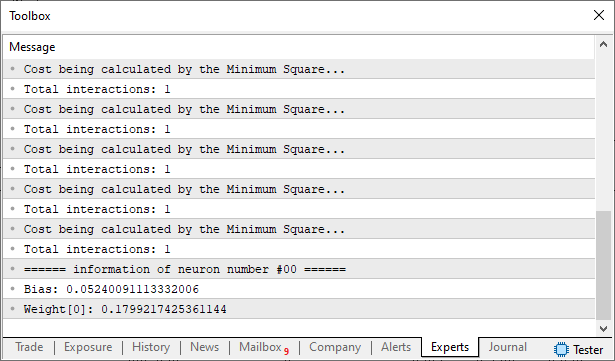
Изображение 04
Хорошо, мы можем убрать эти сообщения и тем самым очистить код. Но у меня есть идея получше: я хочу показать вам, как делать некоторые вещи без необходимости постоянно менять код. Достаточно просто указать компилятору, что включать в итоговый код, а что — нет. Так что будьте внимательны, потому что сейчас вы узнаете кое-что, чем многие не пользуются, потому что не очень хорошо понимают, как это работает.
Использование директив компиляции
Одна из возможностей, которые MQL5 унаследовал от C/C++ и которая оказывается очень полезной, — это использование директив компиляции. Но что же это за директивы? Итак, они служат для генерации кода с определёнными характеристиками. Таким образом, фактически не изменяя исходный код, вы, как программист, можете указать компилятору, как должен собираться код. И вы можете создавать совершенно разные версии кода, даже не изменяя исходный текст, а лишь используя соответствующие директивы компиляции.
Возможно, чаще всего до сих пор вы видели, как я использую директиву #define, которая создаёт определение — будь то макрос или имя константы. Однако эта же директива, если использовать её вместе с другими, позволяет создавать гораздо более сложный код на C/C++. Конечно, в MQL5 у нас нет всей той мощи, которую мы видим в C/C++, но даже этого достаточно, чтобы делать гораздо больше, написав гораздо меньше кода.
Сейчас мы как раз будем использовать эти директивы, чтобы включать или исключать определённые части кода. Подобные вещи могут показаться довольно запутанными многим из вас. Поэтому, прежде чем пытаться вносить большие изменения в код, я рекомендую вам пробовать каждую вещь по мере объяснения. Так вы сможете понять, как всё на самом деле работает и почему работают директивы.
076. //+------------------------------------------------------------------+
077.         inline double Learning_FX(const double &train[], const double epsilon,  const double LearningRate, const ulong limit)
078.         {
079.             double  err,
080.                     memT,
081.                     err_w[];
082.             ulong   count;
083.
084. #ifndef def_NO_MSG
085.             Print("Cost being calculated by the Minimum Square...");
086. #endif
087.             ArrayResize(err_w, m_Infos.nInputs);
088.             for (count = 0; (count < limit) && ((err = Cost_FX(train)) > epsilon); count++)
089.             {
090.                 for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
091.                 {
092.                     memT = m_Infos.Weight[c];
093.                     m_Infos.Weight[c] += LearningRate;
094.                     err_w[c] = Cost_FX(train) - err;
095.                     m_Infos.Weight[c] = memT;
096.                 }
097.                 memT = m_Infos.Bias;
098.                 m_Infos.Bias += LearningRate;
099.                 m_Infos.Bias = memT - (Cost_FX(train) - err);
100.                 for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
101.                     m_Infos.Weight[c] -= err_w[c];
102.             }
103. #ifndef def_NO_MSG
104.             PrintFormat("Total interactions: %I64u", count);
105. #endif
106.             ArrayFree(err_w);
107.
108.             return err;
109.         }
110. //+------------------------------------------------------------------+
                                   .
                                   .
                                   .
131. //+------------------------------------------------------------------+
132.         inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit)
133.         {
134.             ulong   count;
135.             double  eRet;
136.
137. #ifndef def_NO_MSG
138.             Print("Cost being calculated by the Gradient...");
139. #endif
140.             for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++)
141.             {
142.                 m_Infos.Bias -= (m_Error.bias * LearningRate);
143.                 for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
144.                     m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate);
145.             }
146. #ifndef def_NO_MSG
147.             PrintFormat("Total interactions: %I64u", count);
148. #endif
149.
150.             return eRet;
151.         }
152. //+------------------------------------------------------------------+
Фрагмент 02
То, что мы здесь видим, — это просто нечто фантастическое. Обратите внимание на строки 84, 103, 137 и 146. В них используется директива #ifndef. Эта директива указывает компилятору, что, если def_NO_MSG не определена, фрагменты кода между #ifndef и #endif ДОЛЖНЫ БЫТЬ СКОМПИЛИРОВАНЫ. Если def_NO_MSG уже определена на момент обработки #ifndef, эти фрагменты НЕ ДОЛЖНЫ входить в итоговый код.
Хорошо. Но чем это нам на самом деле поможет? Не волнуйтесь, мой дорогой читатель, вы скоро всё поймёте. Теперь вы можете определить макрос в заголовочном файле класса или, как это чаще делают более опытные программисты, определить его в главном файле. И вот в чём секрет. Вы можете добавить это определение в любой момент; в зависимости от того, в каком месте вы его определите, код будет вести себя по-разному. Чтобы это было легче понять, давайте рассмотрим гораздо более простой пример. Вам не о чем беспокоиться. В приложении вы найдёте эти коды, чтобы изучить их и протестировать локально, а также понять, как работают директивы.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void Demo_Directives(const string msg)
05. {
06. #ifdef def_DEMO
07.     Print("Demonstrated Directive #1: ",msg);
08. #else
09.     Print("Demonstrated Directive #2: ",msg);
10. #endif
11. }
12. //+------------------------------------------------------------------+
Код 02
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define def_DEMO
05. //+------------------------------------------------------------------+
06. #include <Tutor\Tutor.mqh>
07. //+------------------------------------------------------------------+
08. void OnStart(void)
09. {
10.     Print("Experimenting with compilation guidelines");
11.     Demo_Directives("Checking...");
12. }
13. //+------------------------------------------------------------------+
Код 03
А теперь начинается самое интересное. Обратите внимание, что в четвёртой строке скрипта есть определение макроса. Поскольку определение находится перед директивой #include, макрос уже будет определён к тому моменту, когда препроцессор обработает включаемый файл. Таким образом, при обработке заголовочного файла условие в шестой строке будет истинным, поскольку макрос был определён РАНЬШЕ. Таким образом, именно седьмая строка заголовочного файла и будет фактически скомпилирована.
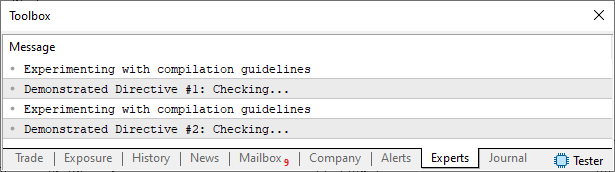
Если бы макрос не был определён или был бы определён после директивы #include, условие в шестой строке было бы ложным. Вместо этого будет выбрана ветвь, указанная начиная с восьмой строки. Таким образом, будет скомпилирован код из девятой строки. И это привело бы к появлению совершенно другого сообщения в терминале MetaTrader 5. Вы можете увидеть это на следующем изображении.
Изображение 05
Думаю, теперь уже легко понять, что происходит. Если макрос определён в момент проверки #ifdef, будет скомпилирован соответствующий блок; если нет, будет скомпилирован блок между #else и #endif. И именно это мы и будем использовать здесь, чтобы убрать эти сообщения из класса C_Neuron. Если мы определим def_NO_MSG, это будет означать, что сообщения нам не нужны. Если def_NO_MSG не определён, сообщения будут отображаться. Из-за этой особенности, а также других, которые я, возможно, когда-нибудь покажу, нужно следить за тем, чтобы не оставлять ненужные определения активными в разных файлах. В противном случае со временем, по мере роста кода, у вас возникнут трудности с его сопровождением.
Теперь, когда это понятно, мы можем вернуться к нашему основному коду. Мы уже внесли изменения в заголовочный файл C_Neuron. Нам нужно лишь определить def_NO_MSG перед директивой #include, чтобы сообщения не компилировались. Итак, код, который мы будем использовать, показан в следующем фрагменте.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property script_show_inputs
04. #property description "Experiencing a simple chain of neurons"
05. //+------------------------------------------------------------------+
06. #define def_NO_MSG
07. //+------------------------------------------------------------------+
08. #include <Neural Network\C_Neuron.mqh>
09. //+------------------------------------------------------------------+
Фрагмент 03
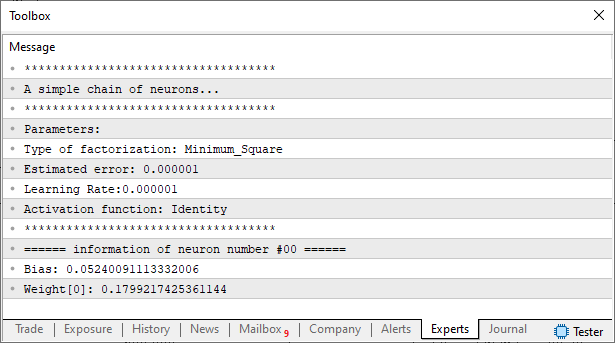
И, словно по волшебству, теперь мы получаем результат, показанный ниже. С одной оговоркой: если вам понадобится использовать класс C_Neuron и снова выводить сообщения, вам не придётся заново писать соответствующий код. Единственное, что вам нужно сделать, — это не определять def_NO_MSG. Вот и всё.
Изображение 06
Хорошо. Теперь у нас уже есть с чем поэкспериментировать. Но вы наверняка заметили, что я использую только один перцептрон и десять итераций. Итак, чтобы начать использовать больше перцептронов, нам нужно внести ещё несколько изменений. Чтобы избежать путаницы, давайте начнём новую тему.
Цепочка перцептронов
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property description "Experiencing a simple chain of neurons"
04. //+------------------------------------------------------------------+
05. #define def_NO_MSG
06. #define def_ERROR_MAX 1e-3
07. //+------------------------------------------------------------------+
08. #include <Neural Network\C_Neuron.mqh>
09. //+------------------------------------------------------------------+
10. //Выражение для обучения: f(x) = (w0 * 2)
11. //+------------------------------------------------------------------+
12. double Train[] {
13.                 10, 20
14.                };
15. //+------------------------------------------------------------------+
16. #define nColumns    2
17. #define nLines      Train.Size() / nColumns
18. //+------------------------------------------------------------------+
19. void SimpleChain(const uchar nNeurons, const ulong Limit)
20. {
21.     C_Neuron *neuron[];
22.     double err, tmp[], in, out;
23.
24.     if ((!nNeurons) || (Train.Size() > 2))
25.         return;
26.
27.     ArrayResize(neuron, nNeurons);
28.     for (uchar c = 0; c < nNeurons; c++)
29.         neuron[c] = new C_Neuron(nColumns - 1, C_Neuron::Identity, true);
30.
31.     ArrayResize(tmp, Train.Size());
32.     in = out = Train[0];
33.     for (ulong count = 0; count < Limit; count++)
34.     {
35.         PrintFormat("====== Interaction #%02d ======", count);
36.         for (uchar c = 0; c < nNeurons; c++)
37.         {
38.             tmp[0] = (c > 0 ? out : in);
39.             if ((err = (*neuron[c]).Learning(tmp, 1.0, def_ERROR_MAX, def_ERROR_MAX, 1)) < def_ERROR_MAX)
40.                 break;
41.             PrintFormat("Input value in the neuron #%02d: %.8f [%.16f]", c, tmp[0], err);
42.             out = (*neuron[c]).Perceptron(tmp);
43.         }
44.     }
45.
46.     PrintFormat("Final exit: %.8f || Expected: %.8f", out, Train[1]);
47.
48.     for (uchar c = 0; c < nNeurons; c++)
49.         delete neuron[c];
50.
51.     ArrayFree(tmp);
52.     ArrayFree(neuron);
53. }
54. //+------------------------------------------------------------------+
55. void OnStart()
56. {
57.     Print("************************************");
58.     Print("A simple chain of neurons...");
59.     Print("************************************");
60.
61.     SimpleChain(2, 1);
62. }
63. //+------------------------------------------------------------------+
Код 04
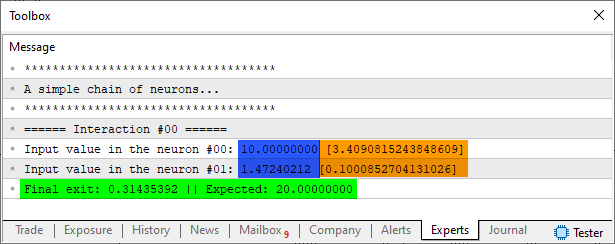
В результате мы получаем следующее изображение:
Изображение 07
То, что делает пятая строка, объяснялось в предыдущем разделе. Шестая строка, в свою очередь, избавляет нас от необходимости постоянно что-то подстраивать. Итак, чтобы придерживаться единого подхода в ходе объяснения, вы не сможете менять настройки, пока не поймёте, что происходит. Просто используйте то, что показано в коде. В двенадцатой строке находится наш новый обучающий массив. Обратите внимание, что я сократил его до одной строки. Далее, в строке 61, мы указываем, сколько перцептронов и сколько итераций будет использовано. В данном случае мы будем использовать два перцептрона: выход одного будет подключён ко входу другого, но, внимание, мы выполним только одну итерацию. На этом мы подошли к девятнадцатой строке. А теперь начинается та часть, которую вам действительно нужно понять.
В 27-й строке мы выделяем память для всех перцептронов, которые будем использовать. В 28-й строке мы входим в цикл, который создаст перцептроны. Неважно, сколько мы хотим их создать. Все они будут созданы одинаково, с использованием одних и тех же значений, причём эти значения — самые базовые из возможных, чтобы всё было легко понять.
В 31-й строке мы выделяем память для обучающего массива. Но зачем выделять память, если массив уже определён? На самом деле массив, определённый в двенадцатой строке, служит исключительно для ввода и вывода. Он не подходит для того, что будет происходить внутри сети, и да, вы правильно прочитали, уважаемый читатель. Теперь мы уже не будем работать с перцептроном. Мы будем использовать нашу первую сеть. А теперь начинается часть, которая может вызвать большую путаницу. В строке 32 мы получаем входное значение. Помните, что нам нужен только один вход, то есть самая простая из возможных система. В строке 33 мы входим в цикл итераций. В строке 36 мы входим в другой цикл, задача которого — выполнить FORWARD PROPAGATION, то есть прямое распространение.
Обратите внимание: в строке 38 мы берём значение переменной `out`, если не находимся в начале сети, и присваиваем его локальному обучающему массиву. Если мы находимся в начале сети, то есть в первом перцептроне, используется значение переменной in. Далее, в строке 39, мы выполняем обучение перцептрона. В строке 41 мы выводим значения, использованные во время обучения. В строке 42 мы выполняем прямое распространение. Таким образом, если цикл в строке 36 выполнится снова, выход одного перцептрона будет использоваться как вход следующего. В конце строка 46 выводит результаты. А остальная часть кода нужна для уничтожения нашей SKYNET.
Хорошо. А теперь начинается сложная часть. Обратите внимание, что мы используем метод наименьших квадратов. Мы не используем никаких специальных функций активации. Все перцептроны одинаковы. Но посмотрите на изображение с результатом. Я хочу, чтобы вы посмотрели на эту картинку и сказали мне: выполняем ли мы обратное распространение? ДА или НЕТ? Если ответ «да», то я спрошу вас: где это происходит? Если ваш ответ «нет», то почему перцептроны показывают значение ошибки?
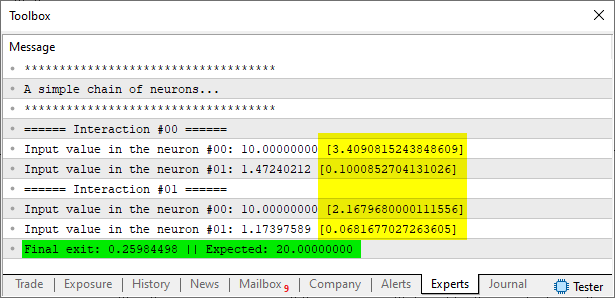
SimpleChain(2, 2);
Результат показан ниже.
Изображение 08
Обратите внимание, что указанное значение ошибки, выделенное жёлтым цветом, уменьшилось. Это означает, что обратное распространение действительно происходит. Но обратите внимание на то, что итоговое значение оказалось хуже полученного ранее. Это означает, что происходит что-то странное. У нас есть обратное распространение, но нейронная сеть не может сойтись к ожидаемому ответу. Что мы делаем не так?
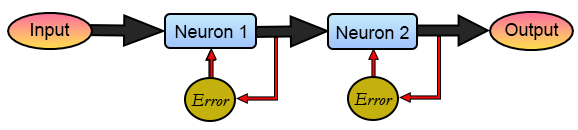
Изображение 09
То есть каждый из перцептронов влияет на следующий. Однако обратное распространение происходит только по связям, обозначенным красными стрелками; то есть перцептроны работают независимо друг от друга, и между ними нет обмена информацией. Таким образом, перцептрон № 1 пытается подстроиться, но перцептрон № 2 ему в этом мешает. В то же время перцептрон № 2 пытается найти направление настройки, но перцептрон № 1 уводит его от него. В итоге индивидуальная ошибка каждого перцептрона уменьшается. Но общая ошибка увеличивается. И вот эту проблему нам и нужно решить.
Заключительные замечания
Цель этой статьи состояла в том, чтобы начать показывать, что привычный способ объяснения работы перцептронных сетей во многих случаях не является самым подходящим. Ведь, вопреки тому, что многие могли бы подумать, недостаточно просто подключить выход одного перцептрона ко входу другого, чтобы создать полноценно работающую сеть.
Кроме того, вопреки тому, что многие думают или представляют как наиболее подходящий способ построения сети перцептронов, мы увидели, что существуют различные конфигурации, каждая из которых ориентирована на конкретную цель. Однако выбор подходящей топологии и определение точек входа и выхода сети радикально меняют характер обработки данных, которого ожидают от сети. Однако, независимо от используемой топологии, способ создания перцептрона остаётся тем же самым или, по крайней мере, должен оставаться таким.
Итак, мы увидели, что при попытке последовательно соединить перцептроны для достижения определённого результата система не смогла работать должным образом и, следовательно, не смогла сойтись к предполагаемому решению. В связи с этим у меня к вам вопрос: как бы вы реализовали перцептрон, чтобы можно было соединить несколько таких перцептронов в определённой конфигурации, например последовательно, как мы это сделали здесь? Идея в том, чтобы они работали как единое целое. Я знаю, что это может показаться немного сложным. Однако цель состоит в том, чтобы создать перцептрон, который без каких-либо дополнительных изменений можно было бы соединить с произвольным количеством других перцептронов для решения какой-либо задачи так, чтобы нам не приходилось беспокоиться о количестве перцептронов между точкой входа и точкой, определённой как выход.
| Файл MQ5 | Описание |
|---|---|
| Script\Example A | Базовая демонстрация |
| Script\Tutor | Базовая демонстрация |
Перевод с португальского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/pt/articles/13952
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Особенности написания Пользовательских Индикаторов
 Создание объектно-ориентированного движка инференса ONNX на языке MQL5

 Альтернатива временным барам (Часть 2): Построение баров серий в MQL5

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Даниэль, всё в порядке, самая важная мысль статьи находится прямо посередине, почти между делом:
«Никакого универсального рецепта здесь нет».
Эта фраза подытоживает то, что большинство никогда не хочет слышать. Гораздо удобнее верить, что существует единственно верная архитектура, единственно верный оптимизатор, единственно верное количество слоёв — и что достаточно просто скопировать и запустить.
Работа по истинному пониманию топологии — это медленный, неудобный процесс, полный неудачных попыток. Но именно этот дискомфорт отличает тех, кто использует искусственный интеллект, от тех, кто понимает, что делает.
Спасибо, что не пошли по пути наименьшего сопротивления в объяснении.
Даниэль, всё в порядке, самая важная мысль статьи находится прямо посередине, почти между делом:
«Никакого универсального рецепта здесь нет».
Эта фраза кратко выражает то, что большинство никогда не хочет слышать. Гораздо удобнее верить, что существует единственно верная архитектура, единственно верный оптимизатор, единственно верное количество уровней — и что достаточно просто скопировать и запустить.
Работа по истинному пониманию топологии — это медленный, неудобный процесс, полный неудачных попыток. Но именно этот дискомфорт отличает тех, кто просто использует искусственный интеллект, от тех, кто понимает, что делает.
Спасибо, что не пошли по пути наименьшего сопротивления в объяснении.
Спасибо за слова. И действительно, в статьях, которые я ещё планирую опубликовать — если не будет новых задержек, ведь все они уже готовы, но… ладно, неважно — я покажу, что не всегда что-то сработает только потому, что кто-то сказал сделать так или иначе.
Часто приходится адаптировать саму топологию, сеть или даже метод обучения, чтобы добиться желаемого результата.