
Arbitraje estadístico mediante acciones cointegradas (Parte 5): Filtrado
 18
 0

Introducción
Comenzamos esta serie utilizando un método heurístico para identificar algunas acciones de la industria de los semiconductores que, en el momento de redactar este artículo, presentaban una elevada correlación con NVDA (Nvidia Corporation). A continuación, redujimos la selección a un par de acciones cointegradas que utilizamos en la configuración de nuestra base de datos y en los ejemplos correspondientes. Esas acciones constituían nuestra «cartera», y resultaban útiles a efectos de demostración y para ayudar a comprender el proceso.
Ahora que hemos implementado un servicio de MetaTrader 5 para actualizar nuestra base de datos de forma continua, y que nuestro asesor experto también es capaz de actualizarse en tiempo real sin interrupciones, es el momento de empezar a crear una cartera real de acciones cointegradas. Es hora de empezar con el filtrado.
«El screening consiste en filtrar un amplio universo de acciones u otros instrumentos financieros para identificar aquellos que cumplen determinados criterios o parámetros establecidos por el inversor o trader. Este proceso es fundamental para reducir el amplio abanico de opciones disponibles y centrarse en aquellas que se ajustan a una estrategia de inversión o a un objetivo de trading específico.» (Investing.com)
Nuestra estrategia se basa en la reversión a la media, una forma de arbitraje estadístico que selecciona acciones del Nasdaq cointegradas con Nvidia y, a continuación, las compra y vende simultáneamente de acuerdo con las ponderaciones de la cartera, con el fin de alcanzar la neutralidad de mercado. Nuestra amplia gama de opciones disponibles incluye todas las acciones del Nasdaq. Los criterios específicos que deben cumplirse son:
- La intensidad de la cointegración, según indican la prueba de Engle-Granger y la prueba de Johansen
- La estabilidad de las ponderaciones de la cartera
- La calidad de la estacionariedad del spread, según indican las pruebas ADF y KPSS
- La liquidez de los activos
Estos cuatro criterios son suficientes para que podamos crear un sistema de puntuación. Un sistema de puntuación debería proporcionarnos una ventaja operativa derivada de la identificación de grupos de acciones cuyos precios evolucionan de forma conjunta, estable y predecible a largo plazo. Necesitamos un sistema de puntuación porque no todos los pares o grupos se ajustan a nuestros objetivos. Si nos limitáramos a analizar todas las combinaciones posibles de acciones —con cientos o miles de ellas—, el número de pares y cestas de acciones potenciales se dispararía. No debemos olvidar que estamos desarrollando este marco de arbitraje estadístico para el inversor minorista medio, con un portátil de consumo y un ancho de banda de red normal. Si empezamos a probar todas las combinaciones posibles, el proceso resulta costoso desde el punto de vista computacional desde el principio. Al contar con un sistema de puntuación, evitamos arriesgar nuestro dinero en pares o grupos que solo están correlacionados a corto plazo, o que no son negociables debido a su escasa liquidez o a los costes de transacción.
Quizá la mejor analogía para un proceso de filtrado con un sistema de puntuación sea la de un embudo: partimos de un grupo amplio y vamos eliminando gradualmente a los candidatos no adecuados, primero aplicando criterios de exclusión basados en la similitud de sector e industria y luego puntuándolos en función de la correlación, la cointegración y la estacionariedad. Por último, descartamos los candidatos que no son negociables según nuestros criterios de gestión del riesgo y del capital. Este proceso aumenta la probabilidad de encontrar cestas de acciones que no solo sean estadísticamente significativas, sino también económicamente relevantes y negociables.
El filtrado y la puntuación permiten convertir la extensa lista de todas las acciones disponibles a través de nuestro bróker en un conjunto acotado de oportunidades. Esto permite ahorrar tiempo y recursos para dedicarlos a las fases, igualmente importantes, de las pruebas retrospectivas y la operativa en una cuenta de demostración.
La Fig. 1 muestra el diagrama de flujo de nuestro proceso de selección y filtrado.
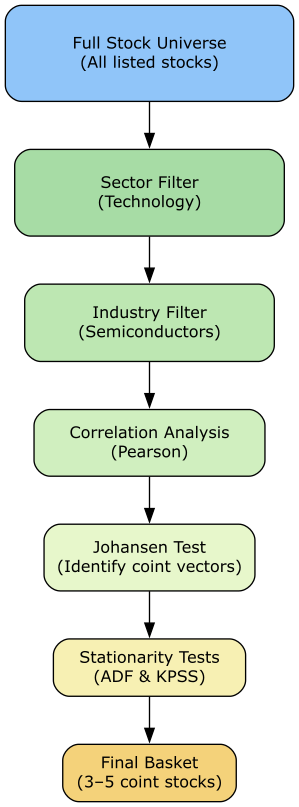
Fig. 1. Diagrama de flujo conceptual del proceso de filtrado
Definición del universo de activos inicial
El último de los cuatro criterios mencionados anteriormente —la liquidez de los activos— suele ser el primero en tenerse en cuenta cuando se empieza desde cero. La liquidez influirá no solo en los costes de transacción (por ejemplo, a través del spread), sino también en la propia posibilidad de operar, dependiendo de la estrategia. Dado que nuestra estrategia depende de la disponibilidad de acciones para realizar operaciones en corto, la liquidez es un criterio de exclusión.
Podríamos empezar por un índice importante, como el S&P 500 o el Nasdaq-100, cuya composición ya responde a criterios de liquidez y relevancia en el mercado. O bien podríamos crear un universo personalizado utilizando criterios como una capitalización bursátil mínima, el volumen medio diario de negociación o spreads reducidos entre los precios de compra y venta (bid-ask). Ambas formas serían válidas para definir este universo de activos inicial. Pero mi principal objetivo aquí es que tú, como lector interesado en reproducir el proceso con el código de ejemplo adjunto, puedas hacerlo de la forma más sencilla y directa posible. Por lo tanto, estoy utilizando el servidor MetaQuotes-Demo como fuente de datos, ya que supongo que está disponible de forma gratuita para todos los usuarios de MetaTrader 5. Resulta que, por lo que puedo ver, el servidor MetaQuotes-Demo no tiene una ruta independiente (véase más abajo) para las acciones que componen el S&P 500 ni para las que componen el Nasdaq-100. En cambio, ofrece una ruta para el conjunto de las acciones del Nasdaq.

Fig. 2. Ventana «Símbolos» de MetaTrader 5 con la ruta «Nasdaq/Stock» resaltada
Si decidiéramos empezar solo con las acciones del Nasdaq-100, tendríamos que elaborar una lista de acciones seleccionadas que habría que mantener al día cuando se actualizara la composición del índice o se reequilibraran sus ponderaciones, o ambas cosas. Eso haría que nuestros ejemplos quedaran obsoletos en muy poco tiempo. Por lo tanto, para nuestros propósitos, la ruta «Nasdaq/Stock» constituye una opción ideal como punto de partida, es decir, como nuestro universo de activos inicial.
¡Son más de seis mil símbolos!

Fig. 3. Número de símbolos en el servidor MetaQuotes-Demo por grupo
Filtrado por sectores e industrias
Una vez definido el universo de activos inicial, el siguiente paso consiste en aplicar nuestros conocimientos del mercado, nuestra experiencia y nuestro sentido común para reducir las opciones. Esto nos indica que las acciones de un mismo sector o industria suelen compartir factores determinantes comunes, como formar parte de la misma cadena de suministro o depender de los tipos de interés del banco central. Estos factores comunes aumentan la probabilidad de que sus precios evolucionen de forma sincronizada y estable. Por ejemplo, los bancos pueden reaccionar de forma similar ante las variaciones de los tipos de interés, mientras que las empresas de semiconductores —que es nuestro caso aquí— pueden verse afectadas por la demanda mundial de chips.
Este conocimiento del mercado, casi intuitivo, y el sentido común fueron la base de nuestras heurísticas a la hora de seleccionar esa primera cesta de acciones cointegradas con Nvidia.
Queremos tener a mano las acciones filtradas para nuestro análisis de datos, por lo que las almacenaremos junto con los metadatos pertinentes en nuestra tabla «symbol». Pero primero, vamos a incluir la columna «source» en nuestra tabla, ya que tanto la ruta de MetaTrader 5 como
los metadatos del símbolo pueden ser, y probablemente serán, diferentes al cambiar de bróker o de servidor. Tendremos que filtrar los datos de mercado por fuente a la hora de analizar los datos de diferentes brókeres.
ALTER TABLE symbol ADD source TEXT CHECK(LENGTH(source) <= 50) DEFAULT ('MetaQuotes') NOT NULL; Y un script de MQL5 (SymbolImporter.mql5) para importar a la base de datos los símbolos de la ruta especificada.

Fig. 4. Cuadro de diálogo «SymbolImporter» de MetaTrader 5 con parámetros
Esto completará los datos que hemos dejado sin rellenar en la base de datos al empezar, concretamente: tipo de activo, bolsa, industria y sector. Además, añadirá la fuente de los datos en el campo recién creado que aparece más arriba.
//+------------------------------------------------------------------+
//| Insert a symbol into the database                                |
//+------------------------------------------------------------------+
bool InsertSymbol(int db_handle, string ticker, string source)
  {
   ResetLastError();
// Get symbol information
   string exchange = SymbolInfoString(ticker, SYMBOL_EXCHANGE);
   string asset_type = GetAssetType(ticker);
   string sector = SymbolInfoString(ticker, SYMBOL_SECTOR_NAME);
   string industry = SymbolInfoString(ticker, SYMBOL_INDUSTRY_NAME);
   string currency = SymbolInfoString(ticker, SYMBOL_CURRENCY_BASE);
   if(currency == "")
      currency = SymbolInfoString(ticker, SYMBOL_CURRENCY_PROFIT);
// Prepare SQL insert statement (symbol_id is auto-generated by SQLite)
   string req = StringFormat(
                   "INSERT INTO symbol(ticker, exchange, asset_type, sector, industry, currency, source)"
                   " VALUES( '%s', '%s', '%s', '%s', '%s', '%s', '%s')",
                   ticker, exchange, asset_type, sector, industry, currency, source);
   if(!DatabaseExecute(db_handle, req))
     {
      printf("Failed to insert symbol: %d", GetLastError());
      return false;
     }
   return true;
  }
Intentará obtener el tipo de activo a partir de la ruta.
//+------------------------------------------------------------------+
//| Determine asset type based on symbol characteristics             |
//+------------------------------------------------------------------+

string GetAssetType(string symbol_name)
  {
   ResetLastError();
// Simple asset type detection - you may want to enhance this
   string description = SymbolInfoString(symbol_name, SYMBOL_DESCRIPTION);
   string path = SymbolInfoString(symbol_name, SYMBOL_PATH);
   if(StringFind(path, "Forex") != -1)
      return "Forex";
   if(StringFind(path, "Stock") != -1)
      return "Stock";
   if(StringFind(path, "Index") != -1)
      return "Index";
   if(StringFind(path, "Future") != -1)
      return "Future";
   if(StringFind(path, "CFD") != -1)
      return "CFD";
   if(StringFind(path, "Crypto") != -1)
      return "Cryptocurrency";
// Fallback based on symbol name patterns
   if(StringLen(symbol_name) == 6 && StringFind(symbol_name, "USD") != -1)
      return "Forex";
   if(StringFind(symbol_name, ".", 0) != -1)
      return "Stock";
   return "Other";
  }
Si todo va bien, deberías ver algo parecido a esto en el registro de la pestaña «Expertos».

Fig. 5. Pestaña «Expertos» de MetaTrader 5 que muestra el registro de SymbolImport tras completar las importaciones correctamente
Y si compruebas tu base de datos, debería contener todas las acciones que cotizan en el Nasdaq y que están disponibles en este servidor (MetaQuotes-Demo, en este caso).

Fig. 6. Interfaz de la base de datos de MetaEditor con una muestra de los metadatos de las acciones del Nasdaq
Podemos comprobar el número total de símbolos bursátiles importados mediante una instrucción SELECT count().

Fig. 7. Interfaz de la base de datos de MetaEditor que muestra el número total de acciones del Nasdaq importadas a la base de datos SQLite
Casi setecientos de ellos pertenecen al sector tecnológico.

Fig. 8. Interfaz de la base de datos de MetaEditor que muestra el número total de acciones del Nasdaq pertenecientes al sector tecnológico
Pero solo algo más de sesenta pertenecen a la industria de los semiconductores.

Fig. 9. Interfaz de la base de datos de MetaEditor que muestra el número total de acciones del Nasdaq pertenecientes a la industria de los semiconductores
Estas sesenta y tres acciones del Nasdaq pertenecientes a la industria de los semiconductores son las que merecen nuestra atención. Más adelante, podremos explorar nuevas oportunidades en las intersecciones entre sectores e industrias, pero ahora debemos centrarnos en las acciones que más tienden a fluctuar al unísono. Son estas acciones las que merecen que dediquemos nuestros esfuerzos a someterlas a pruebas estadísticas de forma continua.
Análisis de correlación
Ahora que hemos reducido nuestro universo inicial mediante filtros por sector e industria, el siguiente paso consiste en comprobar si las acciones realmente se mueven de forma conjunta en la práctica. La forma más sencilla es calcular los coeficientes de correlación. Llevamos utilizando la correlación de Pearson desde el inicio de esta serie, y seguiremos haciéndolo. La correlación de Pearson se calcula rápidamente y es fácil de interpretar, lo que la convierte en una herramienta práctica para el filtrado.
Hemos hablado mucho sobre la prueba de correlación de Pearson en el segundo y tercer artículo de esta serie. No tiene sentido repetir esa información aquí. Te invitamos a que eches un vistazo a esos artículos si no estás familiarizado con este tema. Solo hay que tener en cuenta una cosa:
La correlación NO ES lo mismo que la cointegración. Los precios de las acciones suelen ser series temporales no estacionarias, y las series temporales no estacionarias pueden presentar una elevada correlación a corto plazo, pero no estar cointegradas a largo plazo.
La prueba de correlación de Spearman también es muy habitual y tiene una aplicación clara y concreta como comprobación complementaria, pero por ahora no la trataremos. En cambio, veremos más adelante la correlación de Spearman como una mejora para esos casos de uso concretos.
Almacenaremos los resultados de la prueba de correlación en una tabla específica de nuestra base de datos, una tabla que, como era de esperar, se llama «corr_pearson».
-- corr_pearson definition

CREATE TABLE corr_pearson (
        tstamp INTEGER NOT NULL,
        ref_ticker TEXT CHECK(LENGTH(ref_ticker) <= 10) NOT NULL,
        corr_ticker TEXT CHECK(LENGTH(corr_ticker) <= 10) NOT NULL,
        timeframe TEXT CHECK(LENGTH(timeframe) <= 10) NOT NULL,
        lookback INTEGER NOT NULL,
        coefficient REAL NOT NULL,
CONSTRAINT corr_pearson_pk PRIMARY KEY(tstamp, ref_ticker, corr_ticker)
) STRICT;
Técnicamente, no sería necesario almacenar los resultados de estos cálculos preliminares. Sin embargo, en el arbitraje estadístico, los DATOS son la clave. Estamos calculando los coeficientes de correlación entre las acciones de empresas de semiconductores y Nvidia Corp., en el marco temporal H4, con un periodo retrospectivo de 180 días. Pero pronto calcularemos estos coeficientes para otros marcos temporales y periodos retrospectivos. Probablemente, repetiremos este proceso con otros símbolos de referencia además de NVDA. A medida que avance nuestro análisis de datos, dispondremos de una gran cantidad de datos procesados para el análisis de correlación de Pearson, para la cointegración de Engle-Granger y Johansen, y quizá para otros cálculos intermedios.
Ya te haces una idea: todos estos cálculos proporcionan información muy valiosa que hay que conservar, contrastar y reutilizar más adelante. Por lo tanto, si nos tomamos en serio el arbitraje estadístico, deberíamos acostumbrarnos a no conformarnos con datos efímeros ni descartar los resultados de los cálculos intermedios. Guardemos todo lo que pueda resultarnos útil en el futuro. Y, si aún no estás convencido, piensa simplemente en estas dos palabras: APRENDIZAJE AUTOMÁTICO. Seguro que llegaremos allí en algún momento. 😀

Fig. 10. Interfaz de la base de datos de MetaEditor que muestra los campos de la tabla «corr_pearson»
Observarás que volvemos a tener una clave primaria compuesta, que ahora utiliza la marca de tiempo de inserción, el ticker de referencia y el ticker correlacionado. Esto nos permite conocer el momento exacto en el que se calculó el coeficiente de correlación para este par concreto de símbolos. De esta forma, podemos volver a calcular con seguridad la correlación de todos los símbolos, pero ahora con un marco temporal diferente.

Fig. 11. Interfaz de la base de datos de MetaEditor que muestra la tabla «corr_pearson» con datos ordenados de dos marcos temporales diferentes
Como se puede observar fácilmente en la figura 11 anterior, en el mismo periodo retrospectivo, para algunos símbolos la correlación aumenta al pasar del marco temporal H4 al D1, mientras que para otros disminuye. Si ampliamos esto a varios marcos temporales y periodos retrospectivos, dispondremos de una potente herramienta de análisis. Además, estos datos serán, en cierto sentido, exclusivos para ti, ya que serás tú quien elija qué símbolos analizar y con qué parámetros. Las conclusiones a las que puedas llegar a partir de este análisis de datos pueden darte o no una ventaja operativa, pero esa es la idea.
Más adelante, podremos ver la evolución de la correlación de cada símbolo con NVDA a lo largo del tiempo. Aquí tenemos la evolución de la correlación entre Broadcom Inc. (AVGO) y NVDA, desde un año (periodo retrospectivo de 252) hasta un mes (periodo retrospectivo de 30), pasando por periodos retrospectivos de 180, 120, 90 y 60. Dado que estamos ordenando los resultados por coeficiente, estos muestran claramente que D1 es el marco temporal más adecuado para este par; que la correlación disminuye a medida que se acorta el marco temporal; y que la correlación cae drásticamente cuando el periodo retrospectivo es inferior a 90. Es mucha información, y apenas hemos arañado la superficie.
Nota: Salvo en el caso del periodo retrospectivo anual (252), estoy utilizando cifras redondeadas para los periodos retrospectivos mensuales, con el fin de facilitar la visualización en este contexto.

Fig. 12. Interfaz de la base de datos de MetaEditor que muestra la evolución de «corr_pearson» entre Broadcom Inc. (AVGO) y Nvidia Corp. (NVDA), con periodos retrospectivos que van de un año a un mes, en un marco temporal diario
¿Te das cuenta de lo útil que puede resultar esta sencilla tabla de correlaciones? A modo de ejemplo sencillo, he excluido el marco temporal H4, conservando únicamente las correlaciones diarias, y las he representado gráficamente. 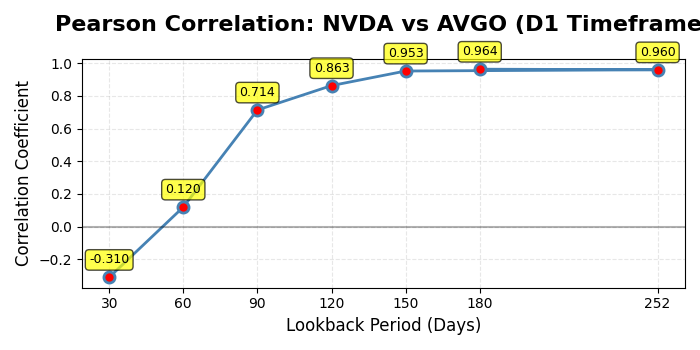
Fig. 13. Gráfico de la evolución de la correlación de Pearson entre Broadcom Inc. (AVGO) y Nvidia Corp. (NVDA), con periodos retrospectivos que van de un año a un mes, en un marco temporal diario
Aunque es habitual utilizar la correlación como filtro preliminar, esto no aporta ninguna información sobre la cointegración. Por lo tanto, no podemos dar por sentado que aquellos símbolos con una baja correlación con Nvidia no estén cointegrados. Entonces, ¿cuál es el objetivo de realizar pruebas de correlación? Ayuda a comprender los patrones de fluctuación a lo largo del tiempo. Pero si la correlación no garantiza la cointegración, ¿cómo podemos utilizarla en la práctica? Calculando la correlación en marcos temporales cortos y con periodos retrospectivos cortos, al tiempo que se comprueba la cointegración en marcos temporales largos y con periodos retrospectivos largos. Ten en cuenta que, en este contexto, «corto» y «largo» son términos relativos entre sí. Como siempre en el mundo del trading, incluso en el trading basado en estadísticas, no hay una fórmula mágica. Debes realizar pruebas y experimentos, hacer pruebas retrospectivas y evaluar los resultados para encontrar la mejor combinación de los parámetros de la prueba de correlación y de la prueba de cointegración para cada par o grupo específico de activos. Utiliza con acierto tus conocimientos del mercado, tu sentido común y tu capacidad de cálculo. Y vuelta a empezar.
El script en sí está estructurado ahora como una clase especializada de Python.

Fig. 14. Captura de pantalla de la vista de esquema del editor de uno de los scripts de Python, donde se muestran los métodos de su clase
Ahora, veamos cómo podemos combinar las pruebas de cointegración en nuestro proceso de filtrado.
Pruebas de cointegración
Engle-Granger
La prueba de Engle-Granger es sencilla y requiere pocos recursos computacionales. Fue la primera prueba de cointegración que se popularizó entre los operadores cuantitativos en la década de los 80 y sigue siendo popular, incluso tras el auge de la prueba de Johansen en la década siguiente (véase más adelante). Como se ha mencionado anteriormente, ya hemos hablado en detalle sobre las pruebas de cointegración en la segunda y tercera parte de esta serie, por lo que no vamos a repetirnos aquí para que no pierdas tiempo. Ahora nos centraremos en su implementación y uso en el proceso de filtrado. Si eres nuevo en este tema, te recomendamos que consultes esos dos artículos.
Recuerda que, en el caso de dos activos (símbolos), el método habitual es la prueba de Engle-Granger. Comprueba si los residuos de una regresión lineal entre dos series de precios son estacionarios. Sin embargo, se limita a una única relación de cointegración, por lo que solo funciona por pares.
Al igual que hicimos con la correlación de Pearson, almacenaremos los resultados de la prueba de cointegración de Engle-Granger en una tabla específica de nuestra base de datos, «coint_eg».
-- coint_eg definition

CREATE TABLE coint_eg (
        tstamp INTEGER NOT NULL,
        ref_ticker TEXT CHECK(LENGTH(ref_ticker) <= 10) NOT NULL,
        coint_ticker TEXT CHECK(LENGTH(coint_ticker) <= 10) NOT NULL,
        timeframe TEXT CHECK(LENGTH(timeframe) <= 10) NOT NULL,
        lookback INTEGER NOT NULL,
        pvalue REAL NOT NULL,
        test_stat REAL NOT NULL,
        crit_val_1 REAL NOT NULL,
        crit_val_5 REAL NOT NULL,
        crit_val_10 REAL NOT NULL,
        hedge_ratio REAL,
        is_coint INTEGER NOT NULL,
CONSTRAINT coint_eg_pk PRIMARY KEY(tstamp, ref_ticker, coint_ticker)
) STRICT;
El campo «is_coint» es de tipo BOOLEAN, pero SQLite no dispone de un tipo de datos booleano independiente. En su lugar, utiliza INTEGER (o INT) para almacenar valores booleanos como 1 o 0, aceptando TRUE o FALSE como entrada.
«A diferencia de la mayoría de las demás implementaciones de SQL, SQLite no cuenta con un tipo de datos BOOLEAN independiente. En cambio, TRUE y FALSE se representan (normalmente) como los números enteros 1 y 0, respectivamente». (Documentación de SQLite)

Fig. 15. Interfaz de la base de datos de MetaEditor que muestra los campos de la tabla «coint_eg»
En el momento de redactar este artículo, de los sesenta y dos símbolos, solo Aeluma Inc. (ALMU) está cointegrada con Nvidia Corp. (NVDA) en el marco temporal diario para el periodo retrospectivo de 365.

Fig. 16. Interfaz de la base de datos de MetaEditor que muestra los campos de la tabla «coint_eg» con una acción cointegrada con NVDA (ALMU)
Al igual que en el ejemplo «corr_pearson» anterior, volverás a observar que tenemos una clave primaria compuesta, formada por la marca de tiempo de inserción, el ticker de referencia y el ticker correlacionado. Es por la misma razón. Al disponer de la marca de tiempo de la prueba de cointegración asociada al ticker de referencia y al ticker que, en su caso, resulte cointegrado, podemos volver a comprobar la cointegración de todos los símbolos, pero esta vez con un marco temporal y/o un periodo retrospectivo diferentes.
Esta tabla, junto con la «coint_joh» que aparece a continuación, constituirá el núcleo de nuestro proceso de filtrado. A modo de ejemplo, veamos qué oportunidades nos ofrece el marco temporal H4.

Fig. 17. Interfaz de la base de datos de MetaEditor que muestra la tabla «coint_eg» con diecisiete acciones cointegradas con Nvidia Corp. (NVDA) en el marco temporal H4 y con diferentes periodos retrospectivos
La tabla de la fig. 17 está ordenada por el valor p. En el momento de redactar este artículo, la primera de ellas, Silicon Laboratories Inc. (SLAB), es la que presenta una mayor cointegración con NVDA, si tomamos como referencia un periodo retrospectivo de 30. Sin embargo, cualquiera de estas acciones es una buena candidata para el trading de pares con NVDA en el marco temporal H4, dentro de sus respectivos periodos retrospectivos. Es decir, en este momento ya contamos con una sólida cartera de acciones cointegradas con NVDA para el trading de pares, junto con sus respectivos ratios de cobertura. Si nos detenemos aquí, disponemos de una cartera clasificada según la fuerza de la cointegración para la que solo falta comprobar la estacionariedad del spread y realizar la validación mediante pruebas retrospectivas.
Johansen
El método de Johansen se desarrolló justo después de la prueba de Engle-Granger, a finales de la década de los 80. En la década de los 90, se convirtió en una herramienta habitual en el ámbito académico y, a principios de este siglo, fue adoptada progresivamente por los equipos cuantitativos de los fondos de cobertura de todo el mundo.
Mientras que la prueba de Engle-Granger está diseñada para dos —y solo dos— series temporales o dos activos, la prueba de Johansen está diseñada para múltiples series temporales, aunque también incluye el caso de solo dos series temporales. Esto hace que la prueba sea especialmente eficaz para el filtrado de cestas de acciones compuestas por dos, tres, cuatro o más acciones, en las que pueden coexistir varias relaciones diferentes a largo plazo.
La prueba de Johansen calcula dos estadísticos principales: el estadístico de la traza y el estadístico del valor propio máximo. Estos estadísticos determinan el rango de cointegración, es decir, el número de relaciones estacionarias independientes entre los activos.
- Rango = 0: no hay cointegración.
- Rango = 1: un spread estable. Hemos estado tratando este caso en todos los artículos de esta serie.
- Rango > 1: múltiples spreads independientes, lo que nos ofrece mayor flexibilidad a la hora de construir la cartera. Analizaremos este caso en detalle cuando abordemos la estacionalidad y las anomalías.
La prueba nos proporciona un conjunto de vectores propios asociados a estas relaciones estacionarias. Cada uno de estos vectores propios indica las ponderaciones de una combinación lineal de las acciones que es estacionaria a lo largo del tiempo. Son estas ponderaciones las que utilizamos como ratios de cobertura, es decir, las proporciones en las que combinaremos los activos para formar un spread sintético con reversión a la media. Al proporcionarnos estos ratios de cobertura, la prueba nos indica cómo construir el spread entre las acciones cointegradas. Utilizamos esta función en el segundo artículo de esta serie, cuando realizamos pruebas retrospectivas con un grupo de cuatro acciones de la industria de los semiconductores.
Al igual que hicimos con las dos pruebas anteriores, utilizaremos una tabla específica para almacenar tanto los parámetros como los resultados de la prueba de Johansen, con vistas a su posterior análisis. Pero ahora necesitaremos dos tablas:
Primera tabla: una tabla principal denominada «coint_johansen_test» para almacenar los metadatos de cada ejecución de la prueba.
-- coint_johansen_test definition

CREATE TABLE coint_johansen_test (
        test_id INTEGER PRIMARY KEY AUTOINCREMENT,
        tstamp INTEGER NOT NULL,
        timeframe TEXT CHECK(LENGTH(timeframe) <= 10) NOT NULL,
        lookback INTEGER NOT NULL,
        num_assets INTEGER NOT NULL,
        trace_stats_json TEXT NOT NULL,
        trace_crit_vals_json TEXT NOT NULL,
        eigen_stats_json TEXT NOT NULL,
        eigen_crit_vals_json TEXT NOT NULL,
        coint_rank INTEGER NOT NULL,
        CONSTRAINT coint_johansen_test_unique UNIQUE (tstamp, timeframe, lookback)
) STRICT;
En lugar de utilizar una clave primaria compuesta con los tickers de los activos, como hicimos en las tablas de la prueba de correlación y de la prueba de Engle-Granger, ahora se utiliza un único identificador «test_id» autoincremental como clave primaria en la tabla principal. La tabla «coint_johansen_test_assets» (que se muestra a continuación) almacena una fila por cada activo incluido en una ejecución de prueba determinada. De esta forma, podemos realizar la prueba con cualquier número de activos sin modificar la estructura de la tabla. Si te interesa profundizar en este procedimiento, echa un vistazo a este artículo de Wikipedia sobre la normalización de bases de datos.
La restricción que exige que la combinación de la marca de tiempo de la prueba, el marco temporal y el periodo retrospectivo sea única nos permite volver a ejecutar la prueba para los mismos símbolos siempre que queramos, con distintos marcos temporales y periodos retrospectivos, y que el resultado de cada prueba sea único.
La prueba de Johansen proporciona varios valores para los estadísticos de la traza y del valor propio máximo, junto con sus valores críticos. Almacenarlos en campos individuales como «trace_stat» ya no es una opción. En su lugar, utilizaremos columnas JSON (trace_stats_json, trace_crit_vals_json, etc.) para almacenar todo el array de resultados como una cadena de caracteres. Utilizamos cadenas en formato JSON y un campo TEXT para almacenar los arrays de valores críticos y de estadísticos de la traza, ya que SQLite no dispone de forma nativa del tipo de datos ARRAY. Consulta el artículo anterior para ver con detalle cómo estamos abordando esta limitación de SQLite y cómo leemos y analizamos estas cadenas JSON en MQL5.
En el siguiente paso veremos cómo podemos aprovechar los valores críticos (trace_crit_vals_json) al realizar pruebas retrospectivas con un grupo de acciones utilizando este filtrado automatizado. Por ahora, basta con tener en cuenta que estos son los valores que comparamos con el estadístico de la traza (trace_stats_json) para obtener el número de relaciones de cointegración en cada nivel de significación (1 %, 5 % y 10 %, respectivamente).
El campo booleano «is_coint» ya no es suficiente. El resultado clave de una prueba de Johansen para múltiples activos es el número de relaciones de cointegración, o rango (r). El nuevo campo «coint_rank» almacenará el valor entero del rango.
Segunda tabla: «coint_johansen_test_assets», para vincular cada prueba con los activos concretos implicados.
-- coint_johansen_test_assets definition

CREATE TABLE coint_johansen_test_assets (
        test_id INTEGER NOT NULL,
        symbol_id INTEGER NOT NULL,
        CONSTRAINT coint_johansen_test_assets_pk PRIMARY KEY(test_id, symbol_id),
        CONSTRAINT coint_johansen_test_assets_test_fk FOREIGN KEY(test_id) REFERENCES coint_johansen_test(test_id) ON DELETE CASCADE,
        CONSTRAINT coint_johansen_test_assets_symbol_fk FOREIGN KEY(symbol_id) REFERENCES symbol(symbol_id) ON DELETE CASCADE
) STRICT;
La tabla «coint_johansen_test_assets» utiliza «symbol_id» en lugar de «ticker» para establecer una relación de clave foránea con la tabla «symbol». Esto garantiza que los activos que estamos probando estén siempre presentes en nuestro sistema. Además, esto nos aporta algunas mejoras de rendimiento de forma gratuita, ya que, por lo general, resulta más eficiente para las bases de datos realizar uniones con claves enteras (symbol_id) que con campos de texto (ticker). Por ahora, mientras no tengamos un sistema que funcione, esto no es relevante ni constituye nuestra prioridad. Pero merece la pena señalarlo, y no nos supone ningún coste adicional. 🙂
Por último, recuerda que nuestra tabla «market_data» ya está vinculada a la tabla «symbol». Al vincular los resultados de nuestra prueba de Johansen con la tabla «symbol», los vinculamos indirectamente con nuestros datos de mercado, que en algún momento depuraremos, lo que contribuye a la coherencia de nuestra base de datos.
Pero, si sigues el razonamiento, quizá te preguntes: ¿por qué no hicimos lo mismo con los resultados de la correlación de Pearson y de la prueba de cointegración de Engle-Granger? ¿Por qué no utilizamos «symbol_id» en lugar de «ticker» para vincular estos resultados con el resto de nuestro sistema?
Hay dos razones que justifican esta elección, una de ellas un poco peculiar. La primera es que prefiero que puedas realizar las pruebas de correlación de Pearson y de cointegración de Engle-Granger para el trading de pares de la forma más sencilla posible, sin tener que preocuparte por la tarea previa de importar los símbolos de MetaTrader a la base de datos.
La segunda razón es que la prueba de Johansen será nuestra herramienta principal en el sistema automatizado, mientras que las pruebas de correlación y de Engle-Granger se limitarán al filtrado manual, dado que en nuestra cartera trabajaremos con cestas de acciones.

Fig. 18. Interfaz de la base de datos de MetaEditor que muestra los campos de la tabla «coint_johansen_test»
La fig. 18 anterior muestra la tabla de la prueba de cointegración de Johansen con todos los campos y una prueba con los vectores de cointegración que utilizaríamos como ratios de cobertura o ponderaciones de la cartera. Se puede ver mejor en la figura 19 que aparece a continuación.

Fig. 19. Interfaz de la base de datos de MetaEditor que muestra los campos de la tabla «coint_johansen_test», con un resultado positivo en la prueba de cointegración, junto con los ratios de cobertura recomendados (ponderaciones de la cartera)

Fig. 20. Interfaz de la base de datos de MetaEditor que muestra la tabla «coint_johansen_test» con siete resultados positivos de cointegración, con distintos rangos de cointegración en el marco temporal D1 y distintos periodos retrospectivos.
Aquí ya contamos con una sólida cartera de acciones cointegradas de la industria de los semiconductores para todos los periodos retrospectivos más habituales: un mes, un trimestre, medio año, un año, etc. Cada grupo de acciones correspondiente a un mismo periodo retrospectivo puede someterse a pruebas para determinar si puede formar parte de una cesta de acciones.
Estos son los datos que se utilizarán en nuestra tabla «strategy» para actualizar nuestro modelo en tiempo real, tal y como se vio en el artículo anterior. Aquí se encuentra la base de las pruebas retrospectivas que realizaremos en el próximo artículo.
Es importante comprender que la prueba de Engle-Granger no quedó obsoleta con la llegada de la prueba de Johansen. Ambas buscan lo mismo —determinar si dos o más precios evolucionan conjuntamente a largo plazo—, pero lo hacen de formas diferentes. La prueba de Engle-Granger es más sencilla y resulta adecuada para analizar dos activos a la vez, mientras que la prueba de Johansen es más potente cuando se desea analizar varios activos conjuntamente. En la práctica, a menudo deberíamos utilizar la prueba que mejor se adapte a la situación y, en ocasiones, aplicar ambas para tener más confianza en el resultado.
Prueba de Engle-Granger
| ✔️Ventajas | ❌Contras |
|---|---|
|
|
Tabla 1 - Lista con viñetas de las ventajas y desventajas de la prueba de cointegración de Engle-Granger
Prueba de Johansen
| ✔️Ventajas | ❌Desventajas |
|---|---|
|
|
Tabla 2 - Lista con viñetas de las ventajas y desventajas de la prueba de cointegración de Johansen
Como regla general, para una comprobación rápida de dos acciones, utiliza la prueba de Engle-Granger; para pruebas más exhaustivas con carteras o con más de dos activos, utiliza la prueba de Johansen.
El último paso antes de establecer un sistema de clasificación consiste en validar la estacionariedad del spread.
Validación de la estacionariedad
Una vez que hayamos identificado una relación de cointegración en un grupo de acciones para un marco temporal y un periodo retrospectivo determinados, el último paso consiste en comprobar que el spread es realmente estacionario. Es la propiedad de estacionariedad la que garantiza que el spread fluctúe en torno a una media estable y no presente una deriva con el tiempo. Este paso es necesario porque, sin estacionariedad, no podemos estar seguros de que se produzca la reversión a la media, y la reversión a la media es el núcleo de nuestra estrategia; es ahí donde se encuentran las oportunidades de arbitraje.
Las dos pruebas que hemos utilizado para validar la estacionariedad del spread son la ADF (Dickey-Fuller aumentada) y la KPSS (Kwiatkowski-Phillips-Schmidt-Shin). Interpretar ambas pruebas conjuntamente aporta robustez: si sus conclusiones coinciden, obtenemos indicios sólidos de que el spread presenta realmente reversión a la media. Cuando las conclusiones de ambas pruebas no coinciden, suele ser indicativo de un comportamiento inestable, por lo que debemos actuar con cautela: es una señal de alarma.
Al igual que en todas las pruebas anteriores, también disponemos de una tabla específica, «coint_adf_kpss», para almacenar los resultados de las pruebas de estacionariedad.
-- coint_adf_kpss definition

CREATE TABLE "coint_adf_kpss" (
        test_id INTEGER NOT NULL,
        symbol_id INTEGER NOT NULL,
        adf_stat REAL NOT NULL,
        adf_pvalue REAL NOT NULL,
        is_adf_stationary INTEGER NOT NULL,
        kpss_stat REAL NOT NULL,
        kpss_pvalue REAL NOT NULL,
        is_kpss_stationary INTEGER NOT NULL,
        CONSTRAINT coint_adf_kpss_pk PRIMARY KEY (test_id, symbol_id),
        CONSTRAINT coint_adf_kpss_test_fk FOREIGN KEY (test_id) REFERENCES coint_johansen_test(test_id) ON DELETE CASCADE,
        CONSTRAINT coint_adf_kpss_symbol_fk FOREIGN KEY (symbol_id) REFERENCES symbol(symbol_id) ON DELETE CASCADE
) STRICT;
Una vez más, utilizamos una clave primaria compuesta, pero ahora lo que hace que cada prueba sea única no es el trío formado por la marca de tiempo de ejecución de la prueba, el marco temporal y el periodo retrospectivo, sino la vinculación con el ID de la prueba de Johansen y el símbolo (cuya unicidad viene determinada por ese trío). De este modo, vinculamos las pruebas de estacionariedad con la prueba de Johansen, pero también hacemos que la prueba ADF/KPSS dependa de que la prueba de cointegración previa haya dado como resultado al menos un vector de cointegración.
Esta dependencia de que una prueba de cointegración previa haya dado como resultado al menos un vector de cointegración queda explícita en el código de Python:
def get_coint_groups(self):
        """
        Retrieves information for all Johansen tests with a cointegrating rank > 0.
        Returns a list of dictionaries, each containing test_id, timeframe, lookback, and a list of symbol_ids.
        """
        if not self.conn:
            print("Database connection not established.")
            return []

        try:
            query = """
            SELECT test_id, timeframe, lookback
            FROM coint_johansen_test
            WHERE coint_rank > 0
            """

            df_tests = pd.read_sql_query(query, self.conn)

            if df_tests.empty:
                print("No cointegrated groups found in the database.")
                return []
Se trata de una decisión de diseño. En teoría, nada nos impide utilizar las pruebas ADF como herramienta independiente. Es solo que no tiene sentido dentro de nuestro proceso. En nuestro caso, ejecutar estas pruebas únicamente en un grupo cointegrado consume menos recursos, ya que muy pronto las ejecutaremos las 24 horas del día, los 7 días de la semana, sobre miles de acciones y con diferentes combinaciones de marcos temporales y periodos retrospectivos.

Fig. 21. Interfaz de la base de datos de MetaEditor que muestra la tabla «coint_adf_kpss» con un resultado positivo en ambas pruebas de estacionariedad del spread, ADF y KPSS
A partir del ID de la prueba (20), obtenemos los símbolos, el marco temporal y el periodo retrospectivo utilizados en la prueba de cointegración de Johansen, así como los vectores de cointegración (ponderaciones de la cartera) que esta devuelve.
SELECT
    t1.test_id,
    t3.ticker,
    t2.timeframe,
    t2.lookback,
    t2.coint_vectors_json
FROM coint_johansen_test_assets AS t1
JOIN coint_johansen_test AS t2
    ON t1.test_id = t2.test_id
JOIN symbol AS t3
    ON t1.symbol_id = t3.symbol_id
WHERE t1.test_id = 123;
Se trata de una consulta relativamente costosa que incluye dos operaciones JOIN. Pero tengamos en cuenta que ejecutaremos un número reducido de estas consultas, y solo cuando encontremos un grupo de activos que haya superado todos los filtros anteriores. Es decir, esta consulta se encuentra al final de nuestro proceso. A partir de ahí, ya disponemos de nuestra cesta de acciones cointegradas con un spread estable, lista para copiarla en nuestra tabla «strategy». El EA lee la tabla «strategy» para actualizar sus propios parámetros en tiempo real (véase nuestro artículo anterior).

Fig. 22. Interfaz de la base de datos de MetaEditor que muestra la tabla «coint_johansen_test» con los detalles de un ID de prueba específico, con resultados positivos tanto para la prueba ADF como para la prueba KPSS.
En este ejemplo, dado que las pruebas de estacionariedad ADF y KPSS han dado resultado positivo para la prueba n.º 20, sabemos que AMD, INTC, LAES, RMBS, TSM y WOLF pueden negociarse en el marco temporal diario (D1), con las respectivas ponderaciones de la cartera almacenadas como «coint_vectors_json».
A estas alturas, el esquema de nuestra base de datos ha cambiado mucho.
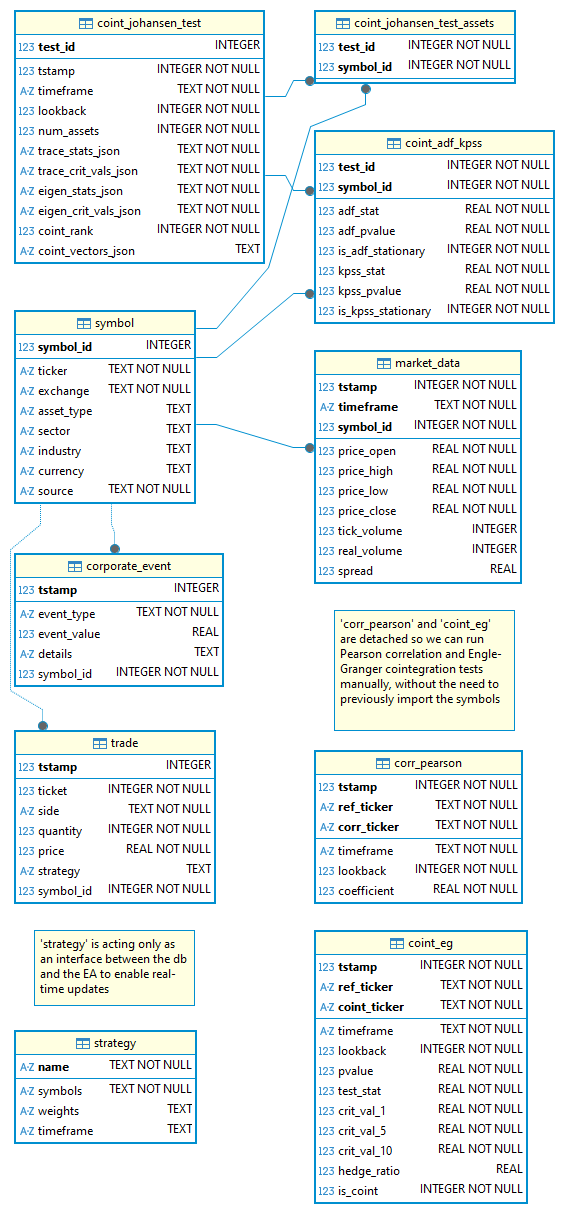
Fig. 23. Diagrama de entidad-relación (ERD) que representa la versión statarb-0.3 del esquema.
Quizá hayas observado que todavía no tenemos índices en la base de datos. Esto es a propósito. Dado que hemos optado por un enfoque de diseño ascendente, por ahora solo podemos suponer (con un grado razonable de certeza, eso sí) dónde necesitaremos índices para acelerar las consultas más frecuentes o más exigentes (como las realizadas sobre claves primarias compuestas en las que uno de los campos es de tipo TEXT). Sin embargo, para evitar darle demasiadas vueltas y complicar innecesariamente el diseño, solo los añadiremos cuando sepamos con certeza cuáles son las consultas más exigentes o más frecuentes.
Selección de cestas de acciones: creación de un sistema de puntuación
El conjunto de acciones que se muestra en la figura 22 anterior representa una única cesta de acciones que formará parte de nuestra cartera. Y se prevé que nuestra cartera cuente con al menos una docena de estas cestas de acciones. Esto se debe a que tendremos que rotar la cartera; es decir, tendremos que sustituir la cesta de acciones n.º 1 por la cesta de acciones n.º 2 siempre que esta última resulte más prometedora en términos de rentabilidad esperada que la primera. Debemos contar con una cartera lo suficientemente amplia como para hacer frente a los cambios del mercado, a los acontecimientos corporativos y a nuestras propias decisiones de negociación (por ejemplo, dejar de negociar con la acción X).
Llevamos a cabo todo este proceso de filtrado partiendo de un universo de activos de aproximadamente 10.000 instrumentos —entre los que, con fines didácticos, se incluían otros tipos de activos además de las acciones— hasta obtener una cesta de acciones reducida a seis valores, con un marco temporal específico y una cointegración válida para un periodo retrospectivo concreto. Te hemos explicado cada detalle para que te resulte más fácil entenderlo, pero recuerda que todo este proceso se ejecutará de forma continua en modo automático, probando numerosas combinaciones de estas tres variables (símbolo, marco temporal y periodo retrospectivo). Gracias a estas combinaciones, cabe esperar que obtengamos muchas cestas de acciones, no solo una. Es de esperar que nos encontremos con docenas de cestas de acciones en cola, a la espera de ser incluidas en nuestra cartera de negociación. ¿Cómo podemos decidir qué cesta de acciones será la siguiente en incorporarse y cuáles deberían pasar al final de la cola? La respuesta es un sistema de clasificación.
Estos son algunos de los criterios de clasificación que podríamos tener en cuenta:
Grado de cointegración: podemos utilizar los estadísticos de Johansen (estadístico de la traza y estadístico del valor propio máximo) para evaluar el grado de cointegración entre las series. Los valores más altos de los estadísticos de prueba indican una relación a largo plazo más fiable.
Número de vectores de cointegración (rango): al tener en cuenta el número de vectores de cointegración, podemos evaluar la complejidad deseada del sistema que estamos construyendo.
- Un rango = 1 indica un único spread estable. Más fácil de supervisar.
- Un rango > 1 indica varios spreads posibles. Más flexible, pero también más complejo.
Estabilidad de las ponderaciones de la cartera: podemos evitar los ratios de cobertura que varíen considerablemente entre distintas ventanas muestrales. Puede indicar que las relaciones son frágiles.
Spreads razonables: el spread debe ser económicamente razonable. Debemos evitar posiciones excesivamente grandes en una sola acción.
Tiempo de reversión: podemos calcular la semivida de la reversión a la media para evaluar la rapidez con la que el spread vuelve al equilibrio.
Liquidez: la liquidez es un criterio indispensable, ya que operar con spreads que incluyan acciones ilíquidas puede resultar costoso.
Costes de transacción: se trata de un criterio de clasificación muy personal, ya que depende de los objetivos y del sistema de negociación de cada uno, pero lo incluimos aquí para que la información sea completa.
Podemos crear un sistema de puntuación combinando todos o algunos de los criterios anteriores. Por ejemplo, ponderando el grado de cointegración, la estabilidad de las ponderaciones de la cartera y el spread medio. Al fin y al cabo, la selección de cestas de acciones consiste en encontrar un equilibrio entre el filtrado estadístico, el conocimiento del mercado y la negociabilidad.
Sin embargo, este sistema de puntuación solo tiene sentido en la práctica. Dado que nuestro próximo artículo tratará exclusivamente sobre las pruebas retrospectivas del sistema automatizado que estamos desarrollando, empezaremos por desarrollar y probar un sistema de puntuación basado en algunos de los criterios mencionados anteriormente. De esta forma, pondremos a prueba el propio sistema de puntuación, junto con el EA y las distintas composiciones de sus cestas de acciones.
Conclusión
Hemos visto cómo se puede crear un proceso simplificado de filtrado de activos para una estrategia de negociación basada en el arbitraje estadístico mediante acciones cointegradas. Partimos de un amplio universo de activos con miles de símbolos disponibles en la plataforma de negociación o en el servidor del bróker y, mediante sucesivos filtros, llegamos a una única cesta de acciones compuesta por seis valores, con un vector de cointegración y un spread estacionario.
Comenzamos filtrando por sector económico e industria y, a continuación, seleccionamos las acciones con mayor correlación dentro de la industria de semiconductores para construir la cesta definitiva a partir de la prueba de cointegración de Johansen y las pruebas de estacionariedad ADF/KPSS.
En el proceso, modificamos nuestra base de datos para incluir tablas específicas en las que almacenar cada resultado de las pruebas con vistas a su posterior análisis. Además, hemos desarrollado clases modulares en Python para sustituir los scripts que hemos estado utilizando hasta ahora.
Llegados a este punto, estamos listos para experimentar con nuestro sistema de puntuación, lo cual haremos en el siguiente paso mientras realizamos pruebas retrospectivas de nuestro sistema con el método de filtrado desarrollado aquí.
Una nota un tanto personal sobre el código adjunto
El código adjunto, principalmente en Python, se ha escrito con un amplio apoyo de los asistentes de IA integrados en MetaTrader 5, VS Code y otras herramientas.
Considero que la IA para el desarrollo de código es el lenguaje de más alto nivel de nuestra época. Eso no elimina la necesidad de saber programar. En cambio, exige que el desarrollador tenga un conocimiento claro del sistema, así como de los denominados «requisitos de usuario». Hay que saber muy bien qué pedir y cómo pedirlo y, sobre todo, el desarrollador debe saber comprobar si el código proporcionado por el asistente se ajusta a los requisitos, es decir, si hace lo que se espera de él. Entonces, el asistente actuará como un desarrollador júnior «potenciado al máximo», o incluso como un desarrollador sénior, dependiendo del modelo de IA, las instrucciones y el lenguaje de programación en cuestión.
Por analogía, considero que la IA aplicada al desarrollo de código es como la creación del lenguaje de programación C: no elimina la necesidad de saber programar; solo reduce la necesidad de que el desarrollador escriba código en ensamblador. Los asistentes de IA ya son capaces de escribir código de mejor calidad, en menos tiempo y con pruebas y documentación incluidas de forma gratuita.
En nuestro caso, el lenguaje de programación de nivel relativamente «bajo» es Python o MQL5.
| Nombre del archivo | Descripción |
|---|---|
| Files\StatArb\schema-0.3.sql | Esquema SQL (DDL) para la base de datos SQLite, versión 0.3 |
| Scripts\StatArb\db-setup.mq5 | Script de MQL5 para configurar la base de datos (lee el archivo de esquema anterior) |
| Scripts\StatArb\SymbolImporter.mq5 | Script de MQL5 para importar los metadatos de los símbolos de MetaTrader 5 a una base de datos SQLite |
| coint_adf_kpss_to_db.py | Clase de Python con métodos para realizar las pruebas de estacionariedad ADF y KPSS |
| coint_eg_to_db.py | Clase de Python con métodos para realizar la prueba de Engle-Granger para evaluar la cointegración |
| coint_johansen_to_db.py | Clase de Python con métodos para realizar la prueba de Johansen para evaluar la cointegración |
| corr_pearson_to_db.py | Clase de Python con métodos para realizar la prueba de correlación de Pearson |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19626
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Reimaginando las estrategias clásicas (parte 16): Rupturas de las bandas de Bollinger dobles
 Herramientas de trading de MQL5 (Parte 9): Desarrollo de un asistente de configuración inicial del usuario para asesores expertos (EAs) con una guía desplazable
 Creación de un sistema de trading (Parte 4): Cómo influyen las salidas aleatorias en la esperanza matemática del trading
 Integración de una plataforma de intercambio de criptomonedas con MQL5 (Parte 1): Conexión a MEXC Futures

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso