通过协整股票进行统计套利(第四部分):实时模型更新
 53
 0

引言
现在是时候开始实时更新我们的协整模型了。 更具体地说,现在是时候在 EA 运行期间,根据最新计算结果更新交易投资组合中每只股票的相对权重了。 到目前为止,我们在解释和回测中一直使用相同的投资组合权重。 采用固定的投资组合权重是一种简化处理,有助于理解整个过程,以及所用统计检验的含义和工作原理。 但在实际应用中,这些投资组合权重几乎每收到一个新数据点就会变化;在我们的情形下,也就是每新增一根已收盘K线时。
不过,我们先简单回顾一下背景,确保大家对前文内容有一致的理解。
我们正在开发一种"平民版"的统计套利框架——一条面向普通散户交易者的统计套利流水线,只需一台消费级笔记本电脑和普通网络带宽即可运行。 在本系列文章中,我们记录并介绍了多种统计检验:用于寻找配对交易所需的高度相关资产、寻找构建投资组合所需的协整股票,以及评估其相对价差的平稳性;而价差的平稳性正是我们这类均值回归策略的必要条件。
在本系列的前一篇文章(第三部分)中,我们介绍了数据库的配置,并就我们的设计选择做了一些说明。 本文是上一篇文章的直接延续。 数据库建立并定期更新后,我们就可以将数据分析与交易活动解耦。
现在我们来看看:
- 我们如何根据总结出的经验修改 Python 脚本,使其在一次运行中完成所有检验,从而方便资产选择;
- 我们如何彻底重构 EA 的代码,使其在运行期间使用数据库中的最新数据,以及如何将几乎所有函数移至 MQL5 头文件中,仅在主文件中保留原生事件处理函数,从而提高代码的可管理性和可维护性;
- 最后,我们将介绍对数据库所做的修改,使其能够充当实时数据分析与在线交易环境之间的接口。
我们先从最后一项,即第3项开始讲起,这样在介绍另外两项时,大家就能明白其中的含义了。
数据库作为唯一可信数据源
在上一篇文章开头,我们明确了数据库应向 EA 提供什么样的响应,以便实时更新模型。 这是自底向上设计中常用的一种"实用技巧"(cheat code)。 我们先明确眼前的需求是什么,再着手实现。 这样既避免了过度设计,又使路线调整更加容易。 这是上一篇文章中的相关片段。
归根结底,我们的数据库应该能回答一个非常简单的问题:现在应该交易什么,才能获得尽可能高的回报?
在本系列的上一篇文章中,我们根据一篮子股票的投资组合权重确定了订单方向和交易量,因此,一个可能的答案如下:
| symbols | 权重 | 时间周期 |
|---|---|---|
| "MU"、"NVDA"、"MPWR"、"MCHP" | 2.699439, 1.000000, -1.877447, -2.505294 | D1(日线时间周期) |
表1. 用于实时更新模型的预期查询响应的虚构示例(上一篇文章)
为了得到这样的答案,我们在数据库模式中新增了一张表,即"strategy"表。 它有四个TEXT字段:- Name PRIMARY KEY(名称主键)
- Symbols(交易品种)
- Weights(权重)
- Timeframe(时间周期)
-- strategy definition CREATE TABLE strategy ( name TEXT CHECK(LENGTH(name) <= 20) NOT NULL, symbols TEXT CHECK(LENGTH(symbols) <= 255) NOT NULL, weights TEXT CHECK(LENGTH(weights) <= 255), timeframe TEXT CHECK ( timeframe IN ( 'M1', 'M2', 'M3', 'M4', 'M5', 'M6', 'M10', 'M12', 'M15', 'M20', 'M30', 'H1', 'H2', 'H3', 'H4', 'H6', 'H8', 'H12', 'D1', 'W1', 'MN1' ) ),CONSTRAINT strategy_pk PRIMARY KEY (name) ) WITHOUT ROWID, STRICT;我们将该表定义为WITHOUT ROWID表。在 SQLite 中,rowid 表是指除虚拟表和带有 INTEGER PRIMARY KEY 约束的表之外的所有常规表。 在 ROWID 表中,主键并非真正的主键。
因此,通过将该表定义为 WITHOUT ROWID 表,我们可以避免插入 NULL 值,从而避免关系完整性受到损害。 其缺点在于,该子句是 SQLite 特有的,这意味着我们的数据库模式将无法完全移植到其他关系型数据库管理系统(RDBMS)。 要在其他 RDBMS 中使用同一数据库模式,我们必须对其进行调整。 但我认为,避免在主键字段中插入 NULL 所带来的好处值得付出这一代价。
您可能已经注意到,‘symbols’ 和 ‘weights’ 都是数组。 但 SQLite 没有 ARRAY 数据类型。 由于这一限制,我们将把这些数据格式化为 JSON 数组,再以 TEXT 类型插入。 如果以后迁移到支持 ARRAY 数据类型的其他 RDBMS,这一做法将使迁移工作更加轻松。
| 名称 | 交易品种 | 权重 | 时间周期 |
|---|---|---|---|
| Nasdaq_NVDA_Coint | ‘["MU", "NVDA", "MPWR", "MCHP"]’ | ‘["2.699439", "1.000000", "-1.877447", "-2.505294"]’ | D1 |
表2. 交易品种和权重数据以 TEXT 数据类型插入到‘strategy’表中,格式为 JSON 数组
要查询这些数据,我们将使用SQLite 的 json_extract() 函数。
因此,我们的数据库模式现已升级至 statarb-0.2 版本,新增了 strategy 表,其实体关系图如下所示:
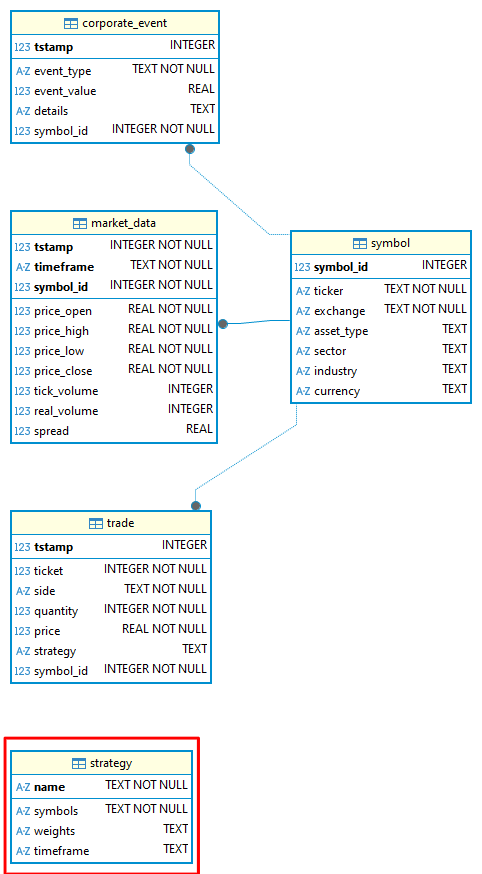
图1. statarb-0.2 数据库实体关系图(ERD)
提示——在使用 SQLite 进行开发时,我通常不会删除数据库文件的旧版本,也不会删除模式文件的旧版本。 由于我们处理的只是一个文件,因此可以轻松地复制该文件,将副本重命名为新版本,并在版本控制系统(VCS)中同时维护这两个版本。 这种做法为我们提供了一条简单的"回滚路径",以备不时之需。

图2. MetaEditor 导航器中显示的不同版本的 SQLite 数据库文件及其相应的模式文件
从上面的实体关系图(ERD)可以看出,我们新增的 strategy 表目前尚未与任何其他表建立关联。 一旦我们开始使用这个新版本的 EA 进行回测或交易,情况就会发生变化:届时,strategy 表将与 trade 表建立关联。 同样,由于我们采用自底向上设计,因此只有在确实有需要时才会修改数据库。 目前,strategy 表只是一个接口,用于在数据分析环境与交易环境之间进行通信。
该数据库将充当数据分析与交易 EA 之间的接口,同时也是筛选(即数据分析的应用)与 EA 之间的接口。 流程大致如下:
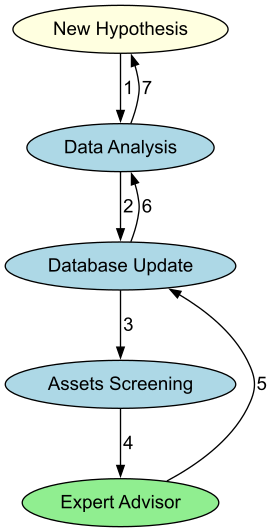
图3. 流程图展示了我们统计套利流水线的循环特性
Python 端
我们已经从为每项任务分别使用独立的 Jupyter 笔记本,转变为使用一个统一的 Python 脚本,该脚本可针对协整股票执行一套完整的统计套利流水线。 该脚本将:
检查 SQLite 数据库是否存在。
def CheckForDb(db_path: str | Path) -> bool:
    """Return True if the SQLite database file exists on disk."""
    exists = Path(db_path).is_file()
    logger.info("Database exists: %s (%s)", exists, db_path)
    return exists
如果未找到数据库,则会创建一个数据库。 如果您没有跟随本系列学习,只是想尝试一下统计套利流水线,这会非常方便。 您只需提供数据库模式(见附件)即可。
def CreateDbIfMissing(db_path: str | Path, schema_path: Optional[str | Path] = None) -> None:
    """
    If the database does not exist and a schema is provided, create it from SQL.
    Otherwise, create an empty file (SQLite creates DB on first connection).
    """
    db_path = Path(db_path)
    if db_path.exists():
        logger.info("DB already present: %s", db_path)
        return
    logger.info("DB missing; creating: %s", db_path)

    with sqlite3.connect(db_path) as conn:
        if schema_path:
            schema_sql = Path(schema_path).read_text(encoding="utf-8")
            conn.executescript(schema_sql)
            logger.info("Applied schema from: %s", schema_path)
连接到 MetaTrader 5 交易终端。
def InitMT5(login: Optional[int] = None, password: Optional[str] = None,
            server: Optional[str] = None, path: Optional[str] = None) -> None:

    """Initialize connection to the running MetaTrader 5 terminal."""

    if mt5 is None:
        raise RuntimeError("MetaTrader5 package not available.")

    # if not mt5.initialize(path=path, login=login, password=password, server=server):
    if not mt5.initialize():
        raise RuntimeError(f"MT5 initialize() failed: {mt5.last_error()}")
    logger.info("MetaTrader5 initialized.")
从 MetaTrader 5 下载市场数据。
def DownloadMarketData(symbols: List[str], timeframes: List[str], bars: int = 5000
                       ) -> Dict[Tuple[str, str], pd.DataFrame]:
    """
    Download OHLCV data from MT5 for each (symbol, timeframe).
    Returns dict with keys (symbol, timeframe) -> DataFrame columns:
    ['tstamp','timeframe','open','high','low','close','tick_volume','real_volume','spread']
    """
    if mt5 is None:
        raise RuntimeError("MetaTrader5 package not available.")
    out: Dict[Tuple[str, str], pd.DataFrame] = {}

    for sym in symbols:
        for tf in timeframes:
            tf_const = _mt5_timeframe_constant(tf)
            rates = mt5.copy_rates_from_pos(sym, tf_const, 0, bars)

            if rates is None or len(rates) == 0:
                logger.warning("No data for %s %s", sym, tf)
                continue

            df = pd.DataFrame(rates)

            # Rename & select
            df = df.rename(columns={
                "time": "tstamp",
                "open": "price_open",
                "high": "price_high",
                "low": "price_low",
                "close": "price_close",
                "real_volume": "real_volume",
            })

            df["timeframe"] = tf

            cols = ["tstamp","timeframe","price_open","price_high","price_low","price_close",
                    "tick_volume","real_volume","spread"]
            df = df[cols].copy()
            out[(sym, tf)] = df
            logger.info("Downloaded %d bars for %s %s", len(df), sym, tf)
    return out
将这些市场数据存储在 SQLite 数据库中。
def StoreMarketData(db_path: str | Path, data: Dict[Tuple[str, str], pd.DataFrame]) -> None:

    """Upsert market data into SQLite according to the provided schema."""
    with sqlite3.connect(db_path) as conn:
        for (sym, tf), df in data.items():
            symbol_id = _ensure_symbol(conn, sym)

            df = df.copy()
            df["symbol_id"] = symbol_id

            # Use executemany for performance
            sql = """
            INSERT OR REPLACE INTO market_data
            (tstamp, timeframe, price_open, price_high, price_low, price_close,
             tick_volume, real_volume, spread, symbol_id)
            VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
            """

            rows = list(df[["tstamp","timeframe","price_open","price_high","price_low","price_close",
                            "tick_volume","real_volume","spread","symbol_id"]].itertuples(index=False, name=None))
            conn.executemany(sql, rows)
            conn.commit()

            logger.info("Stored %d rows for %s %s", len(rows), sym, tf)
检查所选交易品种的皮尔逊相关性。
def RunCorrelationTest(prices: pd.DataFrame, plot: bool = True) -> Tuple[pd.DataFrame, Tuple[str, str], float]:

    """Compute Pearson correlation matrix and return the most correlated pair (off-diagonal)."""
    corr = prices.corr(method="pearson")

    # Mask diagonal, find max
    corr_values = corr.where(~np.eye(len(corr), dtype=bool))
    idxmax = np.unravel_index(np.nanargmax(corr_values.values), corr_values.shape)
    symbols = corr.columns.tolist()
    pair = (symbols[idxmax[0]], symbols[idxmax[1]])
    value = corr_values.values[idxmax]

    logger.info("Most correlated pair: %s ~ %s (r=%.4f)", pair[0], pair[1], value)

    if plot:
        plt.figure(figsize=(10, 7))
        sns.heatmap(corr, annot=False, vmin=-1, vmax=1, cmap="coolwarm", square=True)
        plt.title("Pearson Correlation Heatmap")
        plt.tight_layout()
        plt.show()

    print(f"Most correlated pair: {pair[0]} ~ {pair[1]} (r={value:.4f})")

    return corr, pair, float(value)
计算所选交易品种恩格尔-格兰杰协整系数,并指出协整检验结果最优的品种对。
def RunEngleGrangerTest(prices: pd.DataFrame, plot: bool = True ) -> Tuple[Tuple[str, str], float, float, pd.Series]: """ Loop over all symbol pairs, run statsmodels.coint (Engle-Granger). Return: best_pair, best_pvalue, hedge_ratio (y_on_x), spread series (y - beta*x) """ best_pair, best_p, best_beta, best_spread = None, 1.0, np.nan, None cols = list(prices.columns) for y_sym, x_sym in itertools.combinations(cols, 2): y = prices[y_sym].dropna() x = prices[x_sym].dropna() join = pd.concat([y, x], axis=1).dropna() if len(join) < 50: continue score, pvalue, _ = coint(join.iloc[:,0], join.iloc[:,1]) if pvalue < best_p: beta = _ols_hedge_ratio(join.iloc[:,0], join.iloc[:,1]) spread = join.iloc[:,0] - beta * join.iloc[:,1] best_pair, best_p, best_beta, best_spread = (y_sym, x_sym), pvalue, beta, spread if best_pair is None: raise ValueError("No cointegrated pairs found (Engle-Granger) with sufficient data.") print(f"Most cointegrated pair (Engle-Granger): {best_pair[0]} ~ {best_pair[1]} (p={best_p:.6f}, beta={best_beta:.4f})") if plot: fig, ax = plt.subplots(figsize=(10, 5)) ax.plot(prices.index, prices[best_pair[0]], label=best_pair[0]) ax.plot(prices.index, prices[best_pair[1]]*best_beta, label=f"{best_pair[1]} * beta") ax.set_title(f"Best EG Pair Overlay (beta={best_beta:.4f})") ax.legend() fig.tight_layout() plt.show()fig2, ax2 = plt.subplots(figsize=(10, 4)) ax2.plot(best_spread.index, best_spread.values, label="Spread") ax2.axhline(0, line) ax2.set_title("Spread (y - beta*x)")
ax2.legend() fig2.tight_layout()
plt.show()
return best_pair, float(best_p), float(best_beta), best_spread
对恩格尔-格兰杰价差进行平稳性检验(ADF 检验和KPSS 检验)。
def RunADFTest(series: pd.Series) -> Tuple[float, float, dict]:
    """Augmented Dickey-Fuller test on a univariate series."""
    series = pd.Series(series).dropna()
    adf_stat, pvalue, usedlag, nobs, crit, icbest = adfuller(series, autolag="AIC")

    print(f"ADF: stat={adf_stat:.4f}, p={pvalue:.6f}, lags={usedlag}, nobs={nobs}, crit={crit}")

    return float(adf_stat), float(pvalue), crit
def RunKPSSTest(series: pd.Series, regression: str = "c") -> Tuple[float, float, dict]:

    """KPSS stationarity test on a univariate series (regression='c' or 'ct')."""
    series = pd.Series(series).dropna()
    stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")

    print(f"KPSS({regression}): stat={stat:.4f}, p={pvalue:.6f}, lags={lags}, crit={crit}")

    return float(stat), float(pvalue), crit
验证约翰森协整关系(当秩≥1时,投资组合权重取自第一个特征向量)。
def RunJohansenTest(prices: pd.DataFrame, det_order: int = 0, k_ar_diff: int = 1, plot: bool = True
                    ) -> Tuple[int, np.ndarray, np.ndarray, Optional[pd.Series]]:
    """
    Johansen cointegration test on a set of symbols (>=2).
    Returns: (rank, eigenvectors (beta), eigenvalues, spread_from_first_vector or None)
    - Significant rank determined by trace statistics vs 95% critical values.
    - First eigenvector provides portfolio weights (normalized s.t. min(|w|)=1 or w[-1]=1).
    """

    data = prices.dropna().values

    if data.shape[1] < 2:
        raise ValueError("Johansen requires at least two series.")

    joh = coint_johansen(data, det_order, k_ar_diff)

    # Significant rank by trace statistic > crit value (95% = column index 1)
    trace_stats = joh.lr1  # trace stats
    crit_vals = joh.cvt[:, 1]  # 95%
    rank = int(np.sum(trace_stats > crit_vals))
    print("Johansen trace stats:", trace_stats)

    print("Johansen 95% crit vals:", crit_vals)

    print(f"Johansen inferred rank: {rank}")

    weights = None
    spread = None

    if rank >= 1:

        # Beta columns are cointegrating vectors; take the first (associated with largest eigenvalue)
        beta = joh.evec  # shape (k, k)
        eigvals = joh.eig  # shape (k,)

        # Sort by eigenvalue desc to be explicit
        order = np.argsort(eigvals)[::-1]
        beta_sorted = beta[:, order]
        eig_sorted = eigvals[order]
        first_vec = beta_sorted[:, 0]

        # Normalize such that the weight of the last symbol is 1 (common in practice)
        if first_vec[-1] == 0:
            norm = np.max(np.abs(first_vec))
        else:
            norm = first_vec[-1]

        weights = first_vec / norm

        print("First Johansen eigenvector (portfolio weights):")

        for sym, w in zip(prices.columns, weights):
            print(f"  {sym:>12s}: {w:+.6f}")

        # Spread = P * weights
        spread = pd.Series(prices.values @ weights, index=prices.index, name="JohansenSpread")

        if plot:
            fig, ax = plt.subplots(figsize=(10, 4))
            ax.plot(spread.index, spread.values, label="Johansen Spread")
            ax.axhline(0, linestyle="--")
            ax.set_title("Johansen Spread (1st eigenvector)")
            ax.legend()
            fig.tight_layout()

            plt.show()

        return rank, beta_sorted, eig_sorted, spread, weights

    return rank, joh.evec, joh.eig, weights, None
如果约翰森检验得出显著秩,即所选交易品种之间存在至少一个协整向量,那么脚本还将对约翰森价差进行 ADF 检验和 KPSS 检验,最后将策略参数(交易品种、权重和时间周期)保存到"strategy"表中,如上一节所述。
def StoreJohansenStrategy(db_path: str | Path, name: str, symbols: List[str],
                          weights: np.ndarray, timeframe: str) -> None:
    """
    Store Johansen eigenvector (portfolio weights) and symbols into the strategy table.
    Symbols and weights are stored as JSON arrays (text).
    """

    import json

    with sqlite3.connect(db_path) as conn:
        cur = conn.cursor()
        cur.execute("""
            INSERT OR REPLACE INTO strategy (name, symbols, weights, timeframe)
            VALUES (?, ?, ?, ?)
        """, (
            name,
            json.dumps(symbols),
            json.dumps([float(w) for w in weights]),
            timeframe
        ))
        conn.commit()

    logger.info("Stored Johansen strategy '%s' with symbols=%s timeframe=%s",
                name, symbols, timeframe)
为方便评估,脚本会在每个相关环节(例如价差分析)暂停执行并绘制图表,以便您轻松判断所选交易品种是否值得进一步详细评估,并视情况调整其在列表中的顺序(用于恩格尔-格兰杰协整分析)或时间周期。 在下一步建立完全自动化的流水线之前,该脚本可用作手动筛选工具。 每个任务都被封装为一个独立的函数,因此您可以轻松地将它们导入到其他脚本中。
警告:此脚本是我们的系统入口点。 在此定义新的交易品种列表后,应立即将其添加到 db-update 服务程序的品种清单中。 这样可以确保数据库以平稳的节奏持续更新,即使您的 EA 因任何原因未运行也是如此。 目前,这一步必须手动完成。
要运行该脚本,请在命令行中带上参数调用它。 例如:
PS C:\Users\your\path\to\JupyterNotebooks\StatArb\coint> python py/stat_arb_pipeline_mt5.py --db $env:STATARB_DB_PATH --schema sql/schema-0.2.sql --symbols "MU,NVDA,MPWR,MCHP" --timeframes "D1" --bars 1000 --run
如您所见,我们正在使用环境变量来指定数据库路径参数。 一切顺利的话,当约翰森检验表明不存在协整关系时,您应该会看到类似下面的输出。
2025-09-03 15:35:24,588 [INFO] Database exists: True (C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db)
2025-09-03 15:35:24,589 [INFO] Using existing DB at C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db.
2025-09-03 15:35:24,605 [INFO] MetaTrader 5 initialized.
2025-09-03 15:35:24,613 [INFO] Downloaded 1000 bars for MU D1
2025-09-03 15:35:24,618 [INFO] Downloaded 1000 bars for NVDA D1
2025-09-03 15:35:24,625 [INFO] Downloaded 1000 bars for MPWR D1
2025-09-03 15:35:24,633 [INFO] Downloaded 1000 bars for MCHP D1
2025-09-03 15:35:24,997 [INFO] Stored 1000 rows for MU D1
2025-09-03 15:35:25,261 [INFO] Stored 1000 rows for NVDA D1
2025-09-03 15:35:25,514 [INFO] Stored 1000 rows for MPWR D1
2025-09-03 15:35:25,870 [INFO] Stored 1000 rows for MCHP D1
2025-09-03 15:35:25,871 [INFO] MetaTrader 5 shutdown.
2025-09-03 15:35:25,961 [INFO] ReadMarketData: D1 timeframe, 1000 rows, 4 symbols
2025-09-03 15:35:25,964 [INFO] Most correlated pair: MPWR ~ NVDA (r=0.8335)
相关性最高的股票对: MPWR ~ NVDA (r=0.8335)
协整关系最强的股票对 (Engle-Granger):MPWR ~ MU (p=0.010558, beta=5.4940)
对恩格尔-格兰杰协整价差进行ADF检验与KPSS检验:
ADF: stat=-3.8778, p=0.002204, lags=16, nobs=983, crit={'1%': np.float64(-3.4370198458812156), '5%': np.float64(-2.864484708707697), '10%': np.float64(-2.568337912084273)}
C:\Users\your\path\to\JupyterNotebooks\StatArb\coint\py\stat_arb_pipeline_mt5.py:321: InterpolationWarning:The test statistic is outside of the range of p-values available in the look-up table. The actual p-value is smaller than the p-value returned.
stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")
KPSS(c): stat=0.9279, p=0.010000, lags=19, crit={'10%': 0.347, '5%': 0.463, '2.5%': 0.574, '1%': 0.739}
对所有给定的交易品种进行约翰森检验:
约翰森迹统计量:[34.26486877 18.91156161 8.04865462 0.11018312]
约翰森 95% 临界值:[47.8545 29.7961 15.4943 3.8415]
约翰森检验推断的秩:0
如上所述,当约翰森检验得出显著的秩(≥1)时,即所选交易品种之间至少存在一个协整向量时,脚本会将第一个特征向量的各分量值(投资组合权重)存储在数据库的"strategy"表中。 脚本还将对价差进行ADF检验和KPSS检验。
PS C:\Users\your\path\to\JupyterNotebooks\StatArb\coint> python py/stat_arb_pipeline_mt5.py --db $env:STATARB_DB_PATH --schema sql/schema-0.2.sql --symbols "MU,NVDA,MPWR,MCHP" --timeframes "H4" --bars 90 --run
在这种情况下,您应该会在 Windows PowerShell 或终端中看到类似以下的内容:
2025-09-03 15:50:43,168 [INFO] 数据库已存在:True (C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db)
2025-09-03 15:50:43,169 [INFO] 使用位于 C:\Users\your\path\to\Files\StatArb\statarb-0.2.db 的现有数据库。
2025-09-03 15:50:43,188 [INFO] MetaTrader 5 已初始化。
2025-09-03 15:50:44,297 [INFO] 已下载 MU H4 的 90 根K线
2025-09-03 15:50:44,357 [INFO] 已下载 NVDA H4 的 90 根K线
2025-09-03 15:50:46,322 [INFO] 已下载 MPWR H4 的 90 根K线
2025-09-03 15:50:46,732 [INFO] 已下载 MCHP H4 的 90 根K线
2025-09-03 15:50:49,148 [INFO] 已存储 MU H4 的 90 行数据
2025-09-03 15:50:49,160 [INFO] 为 NVDA H4 存储了 90 行数据
2025-09-03 15:50:49,171 [INFO] 已为 MPWR H4 存储 90 行数据
2025-09-03 15:50:49,276 [INFO] 已存储 MCHP H4 的 90 行数据
2025-09-03 15:50:49,277 [INFO] MetaTrader 5 已关闭。
2025-09-03 15:50:49,617 [INFO] ReadMarketData:H4时间周期,90行,4个交易品种
2025-09-03 15:50:49,622 [INFO] 相关性最高的股票对:MPWR ~ NVDA (r=0.6115)
相关性最高的股票对:MPWR ~ NVDA (r=0.6115)
协整关系最强的股票对 (Engle-Granger):MU ~ NVDA (p=0.072055, beta=-0.2391)
对恩格尔-格兰杰协整价差进行ADF检验和KPSS检验:
ADF: stat=-3.1693, p=0.021831, lags=0, nobs=89, crit={'1%': np.float64(-3.506057133647011), '5%': np.float64(-2.8946066061911946), '10%': np.float64(-2.5844100201994697)}
C:\Users\your\path\to\JupyterNotebooks\StatArb\coint\py\stat_arb_pipeline_mt5.py:321: InterpolationWarning:The test statistic is outside of the range of p-values available in the look-up table. 实际 p 值大于返回的 p 值。
stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")
KPSS(c): stat=0.1793, p=0.100000, lags=5, crit={'10%': 0.347, '5%': 0.463, '2.5%': 0.574, '1%': 0.739}
对所有给定的交易品种进行约翰森检验:
约翰森迹统计量:[63.23695088 32.35462044 16.63904745 5.4295422 ]
约翰森 95% 临界值:[47.8545 29.7961 15.4943 3.8415]
约翰森检验推断的秩:4
第一个约翰森特征向量(投资组合权重):
MCHP:+0.273652
MPWR:-0.148092
MU:+2.256498
NVDA:+1.000000
对约翰森价差进行ADF检验与KPSS检验:
ADF: stat=-4.1427, p=0.000823, lags=1, nobs=88, crit={'1%': np.float64(-3.506944401824286), '5%': np.float64(-2.894989819214876), '10%': np.float64(-2.584614550619835)}
KPSS(c): stat=0.4009, p=0.076784, lags=4, crit={'10%': 0.347, '5%': 0.463, '2.5%': 0.574, '1%': 0.739}
2025-09-03 15:50:50,051
[INFO] 已保存约翰森策略 'Nasdaq_NVDA_Coint',交易品种列表 symbols=['MCHP', 'MPWR', 'MU', 'NVDA'],时间周期 timeframe=H4
那么,上面的插值警告(interpolation warnings)又该如何解释呢?
这些插值警告与对恩格尔-格兰杰价差进行的KPSS平稳性检验有关。 这些警告提示我们,所得结果较为极端,超出了检验查找表的范围。 这些警告只是告诉我们,我们的恩格尔-格兰杰价差
- 具有很强的平稳性(实际p值大于返回的p值)
- 或具有很强的非平稳性(实际p值小于返回的p值)
目前,在处理模型参数的实时更新时,我们可以放心地暂时忽略这些警告。 我们将在下一步进行资产筛选时,详细讨论这些警告。
MQL5 端
我们在主文件中只保留了 EA 的事件处理器。 所有其他函数均已移至 Nasdaq_NVDA_Coint.mqh 头文件中。
此前,策略参数是硬编码的。 现在,它们是全局变量。
// Global variables
string symbols[] = {}; // Asset symbols
double weights[] = {}; // Portfolio weights
ENUM_TIMEFRAMES timeframe = PERIOD_CURRENT; // Strategy cointegrated timeframe
这些全局变量会直接在 OnInit() 事件处理器中进行检查。
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+

int OnInit()
  {
   ResetLastError();

// Check if all symbols are available
   for(int i = 0; i < ArraySize(symbols); i++)
     {
      if(!SymbolSelect(symbols[i], true))
        {
         Print("Error: Symbol ", symbols[i], " not found!");
         return(INIT_FAILED);
        }
     }
// Initialize spread buffer
   ArrayResize(spreadBuffer, InpLookbackPeriod);

// Set a timer for spread, mean, and stdev calculations
   EventSetTimer(InpUpdateFreq * 60); // min one minute

// Load strategy parameters from database
   if(!LoadStrategyFromDB(InpDbFilename,
                                InpStrategyName,
                                symbols,
                                weights,
                                timeframe))
     {
      // Handle error - maybe use default values
      printf("Error at " + __FUNCTION__ + " %s ",
             getUninitReasonText(GetLastError()));
      return INIT_FAILED;
     }
   return(INIT_SUCCEEDED);
  }
函数 LoadStrategyFromDB() 位于头文件中。
//+------------------------------------------------------------------+
//|          Load strategy parameter from database                   |
//+------------------------------------------------------------------+

bool LoadStrategyFromDB(string db_name,
                        string strat_name,
                        string &symbols_arr[],
                        double &weights_arr[],
                        ENUM_TIMEFRAMES &tf)
  {

// Open the database (Metatrader's integrated SQLite)
   int db = DatabaseOpen(db_name, DATABASE_OPEN_READONLY);
   if(db == INVALID_HANDLE)
     {
      Print("Failed to open database: %s", GetLastError());
      return false;
     }
// Prepare the SQL query with json_extract
   string query = StringFormat(
                     "SELECT "
                     "json_extract(symbols, '$') as symbols_json, "
                     "json_extract(weights, '$') as weights_json, "
                     "timeframe "
                     "FROM strategy WHERE name = '%s'",
                     strat_name
                  );

// Execute the query
   int result = DatabasePrepare(db, query);

   if(result <= 0)
     {
      Print("Failed to prepare query: ", GetLastError());
      DatabaseClose(db);
      return false;
     }

// Read the results
   if(DatabaseRead(result))
     {
      // Get symbols_arr JSON array and parse it
      string symbolsJson;
      DatabaseColumnText(result, 0, symbolsJson);
      ParseJsonArray(symbolsJson, symbols_arr);

      // Get weights_arr JSON array and parse it
      string weightsJson;
      DatabaseColumnText(result, 1, weightsJson);
      ParseJsonDoubleArray(weightsJson, weights_arr);

      // Get tf string and convert to ENUM_TIMEFRAMES
      string timeframeStr;
      DatabaseColumnText(result, 2, timeframeStr);
      tf = StringToTimeframe(timeframeStr);

      Print("Successfully loaded strategy: ", strat_name);

      Print("Symbols JSON: ", symbolsJson);
      Print("Weights JSON: ", weightsJson);
      Print("Timeframe: ", timeframeStr);
     }
   else
     {
      Print("Strategy not found: ", strat_name);

      DatabaseFinalize(result);
      DatabaseClose(db);
      return false;
     }
// Clean up

   DatabaseFinalize(result);
   DatabaseClose(db);
   return true;
  }
如上所述,我们将使用 SQLite 的 json_extract() 函数读取交易品种数组和投资组合权重数组。 它的签名如下:
json_extract(json, path)
其中:
- "json" 是包含 JSON 数据的文本列或字符串
- "path" 是一个 JSON 路径表达式,用于指定要提取的值在 JSON 中的位置。 它通常以 $ 开头,表示 JSON 文档的根节点,后接表示对象键的点表示法($.key),或表示数组索引的方括号表示法($[index])。 我们在这里正是使用后一种形式来读取数组数据的。
这两个辅助函数用于解析 JSON 数组。 这些函数先移除方括号和引号,再按逗号拆分,以此处理 JSON 格式的数据。
ParseJsonArray()
解析类似 ["MU", "NVDA", "MPWR", "MCHP"] 这样的 JSON 字符串数组
// Helper function to parse JSON array of strings
void ParseJsonArray(string json, string &array[])
  {
// Remove brackets and quotes from JSON array
   string cleaned = StringSubstr(json, 1, StringLen(json) - 2); // Remove [ and ]
   StringReplace(cleaned, "\"", ""); // Remove quotes

// Split by commas
   StringSplit(cleaned, ',', array);

// Trim whitespace from each element
   for(int i = 0; i < ArraySize(array); i++)
     {
      array[i] = StringTrim(array[i]);
     }
  }
ParseJsonDoubleArray()
解析类似 [2.699439, 1.000000, -1.877447, -2.505294] 这样的 JSON 数值数组
// Helper function to parse JSON array of doubles
void ParseJsonDoubleArray(string json, double &array[])
  {
// Remove brackets from JSON array
   string cleaned = StringSubstr(json, 1, StringLen(json) - 2); // Remove [ and ]

// Split by commas
   string stringArray[];
   int count = StringSplit(cleaned, ',', stringArray);

// Convert to double array
   ArrayResize(array, count);

   for(int i = 0; i < count; i++)
     {
      array[i] = StringToDouble(StringTrim(stringArray[i]));
     }
  }
添加了
StringTrim()
函数用于移除 JSON 值中可能存在的任何空白字符。
// Helper function to trim whitespace
string StringTrim(string str)
  {

// Trim leading whitespace
   while(StringLen(str) > 0 && str[0] == ' ')
     {
      str = StringSubstr(str, 1);
     }

// Trim trailing whitespace
   while(StringLen(str) > 0 && str[StringLen(str) - 1] == ' ')
     {
      str = StringSubstr(str, 0, StringLen(str) - 1);
     }

   return str;
  }
MQL5 代码库中提供了 JSON 库。 如果您对 JSON 对象的使用更加深入,或许值得查找这些库,并评估使用它们的好处。 对于这种简单场景,我认为还不至于为此引入外部依赖。
辅助函数
StringToTimeframe()
将数据库中的时间周期字符串转换为相应的 MQL5 ENUM_TIMEFRAMES 值。
// Helper function to convert tf string to ENUM_TIMEFRAMES
ENUM_TIMEFRAMES StringToTimeframe(string tfStr)
  {
   if(tfStr == "M1")
      return PERIOD_M1;
   if(tfStr == "M2")
      return PERIOD_M2;
.
.
.
   if(tfStr == "MN1")
      return PERIOD_MN1;
   return PERIOD_CURRENT; // Default if not found
  }
除了在 EA 启动或重启时调用的 OnInit() 中检查策略参数外,我们还会在 OnTimer() 事件处理函数中按固定时间间隔调用同一个参数检查函数。 该时间间隔是一个用户输入参数。
// Set a timer for spread, mean, and stdev calculations
// and strategy parameters update (check DB)
   EventSetTimer(InpUpdateFreq * 60); // min one minute

void OnTimer(void)
  {
   ResetLastError();
// Wrapper around LoadStrategyFromDB: for clarity
   if(!UpdateModelParams(InpDbFilename,
                         InpStrategyName,
                         symbols,
                         weights,
                         timeframe))
     {
      printf("%s failed: %s", __FUNCTION__, GetLastError());
     }
UpdateModelParams() 只是 LoadStrategyFromDB() 的一个封装函数。
//+------------------------------------------------------------------+
//|          Wrapper to load strategy from db                        |
//+------------------------------------------------------------------+

// Load strategy parameters from database
bool UpdateModelParams(string db_name,
                       string strat_name,
                       string &symbols_arr[],
                       double &weights_arr[],
                       ENUM_TIMEFRAMES tf)
  {
   return LoadStrategyFromDB(db_name, strat_name, symbols_arr, weights_arr, tf);
  }
这使得该函数的用途更加清晰。
结论
用于均值回归策略的均衡协整股票篮子,必须持续更新其投资组合权重。 本文展示了如何始终保持策略参数为最新状态,包括篮子所包含的交易品种本身。
我们介绍了如何将MetaTrader 5内置的SQLite数据库用作数据分析与交易环境之间的接口,同时确保这两项活动保持解耦。
为了方便那些可能没有持续关注本系列的读者,我们提供了一个统一的 Python 脚本,其中包含针对协整股票的完整统计套利流水线。 该脚本可在单次运行中完成相关性、协整和平稳性检验,并将最新的策略参数写入数据库,供 EA 读取。
参考文献
Daniel P. Palomar(2025). Portfolio Optimization: Theory and Application(《投资组合优化:理论与应用》)。剑桥大学出版社。
| 文件名 | 描述 |
|---|---|
| StatArb/db-setup.mq5 | MQL5 脚本,通过读取数据库模式文件 schema-0.2.sql 来创建并初始化 SQLite 数据库。 |
| StatArb/db-update-statarb-0.2.mq5 | MQL5 服务程序,用于将最新的已收盘K线数据写入 SQLite 数据库。 |
| StatArb/Nasdaq_NVDA_Coint.mql5 | 该文件包含示例 EA。 |
| StatArb/Nasdaq_NVDA_Coint.mqh | 该文件包含示例 EA 的头文件。 |
| StatArb/schema-0.2.sql | 用于初始化数据库(生成表、字段和约束)的 SQL 数据库模式文件(DDL)。 |
| stat_arb_pipeline_mt5.py | 该 Python 脚本基于皮尔逊相关性检验、约翰森协整检验以及 ADF 和 KPSS 平稳性检验,为协整股票运行完整的统计套利流水线。 |
本文由MetaQuotes Ltd译自英文
原文地址: https://www.mql5.com/en/articles/19428
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。