ARV ML Dataset Export
- Utilitys
-
Roman Amirov
 I’ve been trading Forex for over 5 years. During this time, I’ve tested a lot of third‑party EAs and realized a simple thing: if you want something done right, do it yourself! That’s why, instead of endlessly searching for the “perfect” ready‑made solution, I started turning my own trading ideas
- Version: 1.0
- Aktivierungen: 5
„ARV ML Dataset Export“ wandelt Kursverläufe in einen Datensatz für maschinelles Lernen um, der für das Training eines
ONNX-Modells außerhalb des Terminals. Ein Durchlauf auf einem beliebigen Chart erzeugt zwei Dateien:
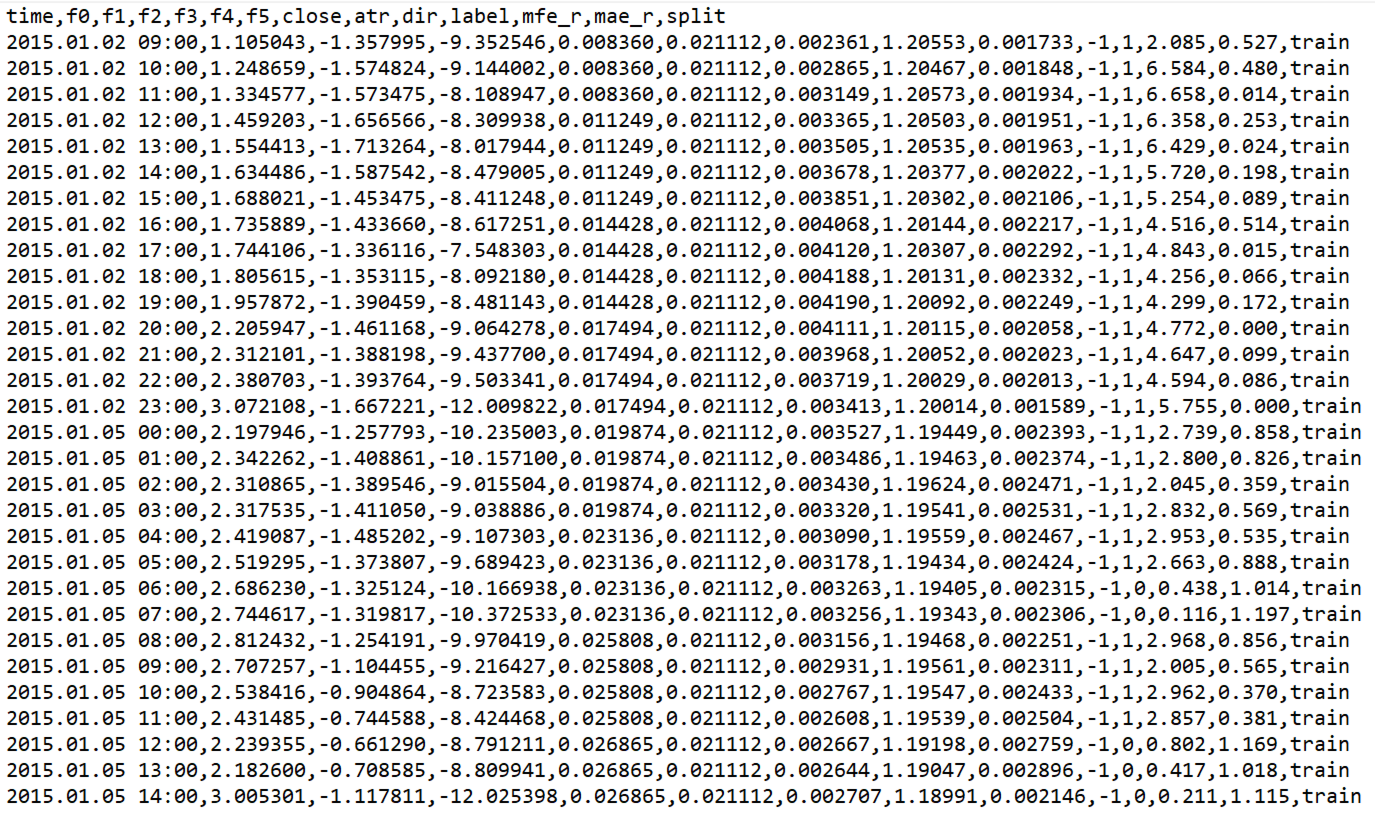
- „ARV_ML_<SYMBOL>_H1.csv“ – die Merkmalsmatrix, TP/SL-Bezeichnungen, Ausreißer und die Aufteilung in Trainings- und Testdaten.
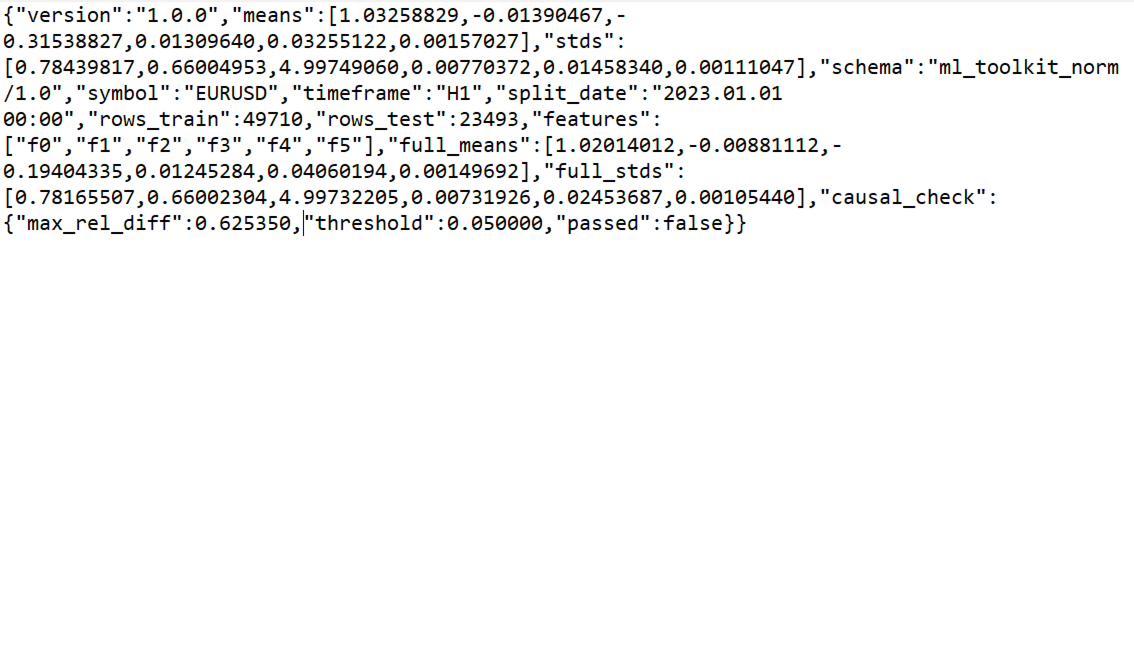
- „ARV_ML_Norm_<SYMBOL>_H1.json“ – Normalisierungsstatistiken, die ausschließlich auf den Trainingsteil angewendet wurden, sowie ein Kausalitätsbericht.
Das Skript liest lediglich historische Daten ein und schreibt Dateien innerhalb der Terminal-Sandbox. Es führt keine Handelsgeschäfte durch,
gibt keine Orders auf und sendet keine Daten an Dritte.
Warum die Normalisierung nur auf das Trainingsfenster angewendet wird
Dies ist der Punkt, den die meisten Datensatz-Exporteure falsch verstehen.
Wenn Mittelwert und Standardabweichung über die gesamte Historie berechnet werden und das Modell anschließend
an einem Teil desselben Verlaufs trainiert wird, gelangen zukünftige Informationen in die Trainingsdaten: Die frühesten Balken
werden anhand von Statistiken skaliert, die bereits spätere Balken berücksichtigen. Das Modell schneidet dann bei der Validierung besser ab
als es tatsächlich ist.
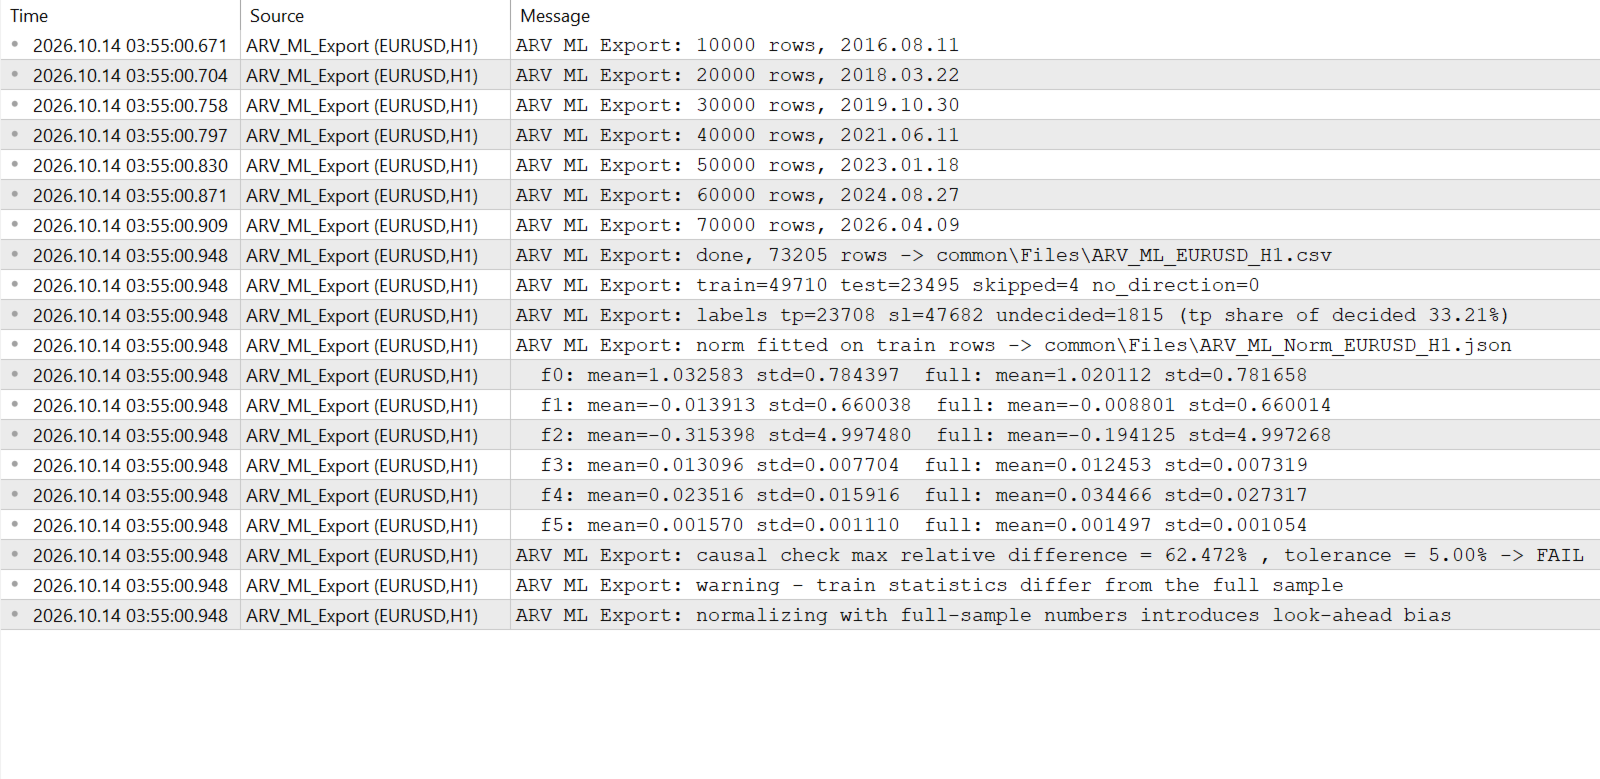
Die exportierte JSON-Datei enthält daher zwei Sätze von Statistiken: „means“ und „stds“, die ausschließlich auf Trainingszeilen
, sowie „full_means“ und „full_stds“, die auf der gesamten Stichprobe berechnet wurden. Ein „causal_check“-Block vergleicht
diese miteinander und meldet „max_rel_diff“. Liegt die Differenz über der in „InpCausalTolPct“ festgelegten Toleranz,
gibt das Protokoll vor Beginn des Trainings eine FAIL-Zeile aus.
Die Aufteilung in Trainings- und Testdaten erfolgt anhand eines Datums (`InpSplitDate`), nicht durch zufällige Vermischung. Finanzreihen sind nicht
unabhängig, sodass eine zufällige Aufteilung benachbarte Balken aus demselben Marktregime in beide
Teile.
Ausgabe: CSV-Spalten
Kopfzeile:
| Zeit, f0, f1, f2, f3, f4, f5, Schlusskurs, ATR, Richtung, Bezeichnung, mfe_r, mae_r, Split |
|---|
| Spalte | Bedeutung |
|---|---|
| Zeit | Eröffnungszeit des Signalbalkens, „JJJJ.MM.TT HH:MM“ |
| f0..f5 | Rohdaten, unnormalisierte Merkmale des geschlossenen H1-Balkens |
| Schlusskurs | Schlusskurs des Signal-Bars |
| atr | ATR(14) der H1-Serie am Signalbalken |
| dir | Handelsrichtung „1“ / „-1“ / „0“ |
| label | „1“, wenn TP vor SL erreicht wurde, „0“, wenn SL zuerst erreicht wurde, leer, wenn beides innerhalb des Zeitraums nicht eingetreten ist |
| „mfe_r“, „mae_r“ | maximale positive und negative Abweichung innerhalb des Zeitraums, in R-Einheiten |
| Aufteilung | „train“ oder „test“ |
Merkmale:
f0 = |EMA20(H1)  - EMA50(H1)| / ATR14(H1)
f1 = (EMA20(H1)  - EMA20(H1) 5 bars ago) / ATR14(H1)
f2 = (Close(H1)  - EMA200(H1)) / ATR14(H1)
f3 = (BB_upper(H4) - BB_lower(H4)) / EMA20(H4)     Bollinger 20, 2.0
f4 = ATR14(M15) / Close(M15) * 100
f5 = StdDev20(H1, SMA) / EMA20(H1)
Ausgabe: JSON-Schlüssel
version, means[6], stds[6], schema, symbol, timeframe, split_date,
rows_train, rows_test, features[], full_means[6], full_stds[6],
causal_check{max_rel_diff, threshold, passed}
Eingaben
| Eingabe | Standard | Bedeutung |
|---|---|---|
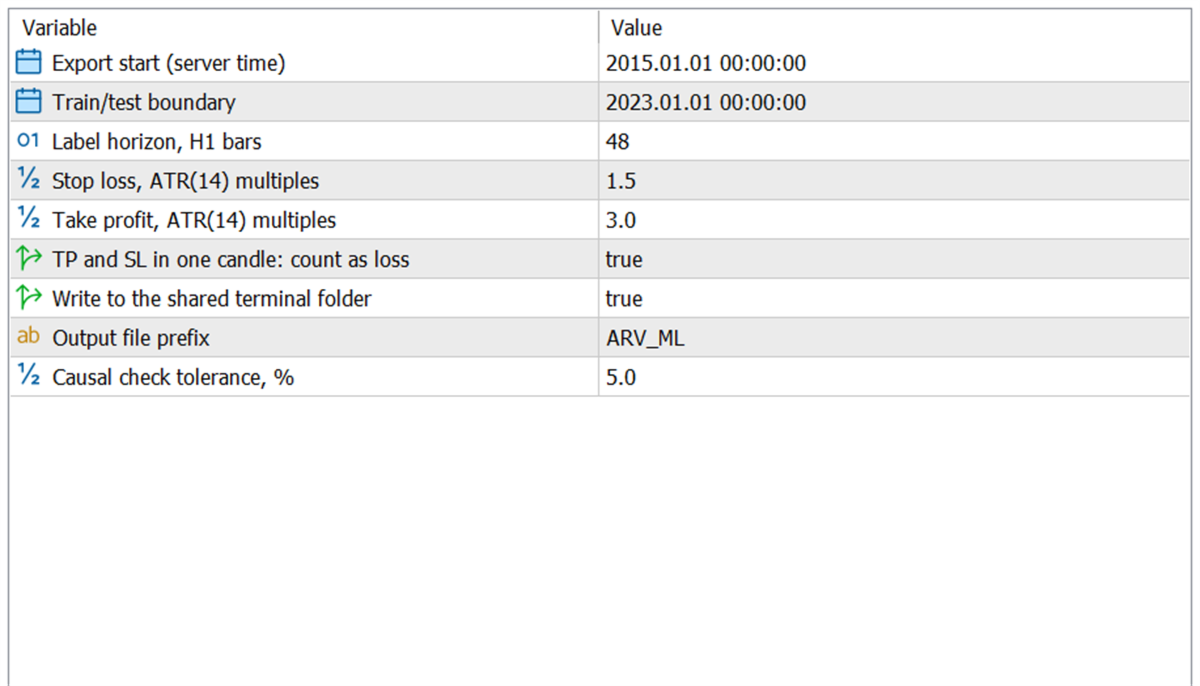
| InpFrom | 01.01.2015 | Startdatum des Exports, Serverzeit |
| InpSplitDate | 01.01.2023 | Grenze zwischen Trainings- und Testteil |
| InpHorizonBars | 48 | Anzahl der H1-Bars, die für ein TP/SL-Ergebnis gescannt werden |
| InpSL_ATR_Mult | 1,5 | Stop-Loss-Abstand in Vielfachen von ATR(14,H1) |
| InpTP_ATR_Mult | 3,0 | Take-Profit-Abstand in ATR(14,H1)-Vielfachen |
| InpAmbigPessimistic | true | Die Kerze hat sowohl TP als auch SL berührt: als Verlust werten |
| InpUseCommon | true | In den gemeinsamen Terminal-Ordner statt in „MQL5\Files“ schreiben |
| InpPrefix | ARV_ML | Präfix für die Namen der Ausgabedateien |
| InpCausalTolPct | 5,0 | Toleranz des Kausalitätsberichts, Prozent |
Ausführung
1. Kopieren Sie „ARV_ML_Export.ex5“ in den Ordner „MQL5\Scripts“ des Terminal-Datenverzeichnisses.
2. Drücken Sie im Navigator die Taste F5, damit das Skript angezeigt wird.
3. Öffnen Sie ein Chart des Instruments, das Sie exportieren möchten. Der Chartzeitraum spielt keine Rolle: Das Skript
verwendet die H1-, H4- und M15-Reihen dieses Symbols.
4. Ziehen Sie „ARV_ML_Export“ auf das Chart, überprüfen Sie die Eingaben und klicken Sie auf „OK“.
5. Warten Sie, bis die Zeile `ARV ML Export: done, ... rows` in der Toolbox – Experten angezeigt wird.
Training außerhalb des Terminals
Das Training erfolgt bewusst außerhalb des Terminals. Laden Sie die CSV-Datei, normalisieren Sie die Merkmale anhand der
„means“ und „stds“ aus der JSON-Datei, trainieren Sie ein beliebiges Modell, das nach ONNX exportiert werden kann, und laden Sie es in
MetaTrader 5 mit „OnnxCreateFromBuffer“ ein. Der Export ist frameworkunabhängig: Jedes Tool, das CSV
und JSON lesen kann, ist dafür geeignet. Ein begleitender Artikel auf MQL5.com führt durch die gesamte Pipeline von diesem Datensatz
bis hin zu einem in MetaTrader 5 laufenden ONNX-Modell.
Kompatibilität
MetaTrader 5 Build 3000 oder höher. Reines MQL5: keine DLL, kein WebRequest, keine externen Dienste, keine
Lizenzierungsaufrufe. Das Skript ist in Bezug auf das Konto schreibgeschützt: Es eröffnet, ändert oder
schließt keine Positionen oder Orders.
Haftungsausschluss
Dieses Dienstprogramm erstellt ausschließlich Datendateien. Es führt keine Handelsvorgänge durch: Es eröffnet oder schließt keine
Positionen, gibt keine Orders auf und generiert keine Signale. Die anhand des exportierten
Datensatz oder mit daraus trainierten Modellen erzielten Ergebnisse hängen von der Datenqualität und der Forschungsmethode ab und
keine Garantie für zukünftige Ergebnisse. Der Autor übernimmt keine Verantwortung für Handelsentscheidungen, die auf der Grundlage
dieser Daten getroffenen Handelsentscheidungen.