ARV ML Dataset Export
- Utilidades
-
Roman Amirov
 I’ve been trading Forex for over 5 years. During this time, I’ve tested a lot of third‑party EAs and realized a simple thing: if you want something done right, do it yourself! That’s why, instead of endlessly searching for the “perfect” ready‑made solution, I started turning my own trading ideas
- Versión: 1.0
- Activaciones: 5
La función «Exportación de conjunto de datos de ARV ML » convierte el historial de precios en un conjunto de datos de aprendizaje automático, listo para entrenar un
modelo ONNX fuera de la terminal. Una ejecución en cualquier gráfico genera dos archivos:
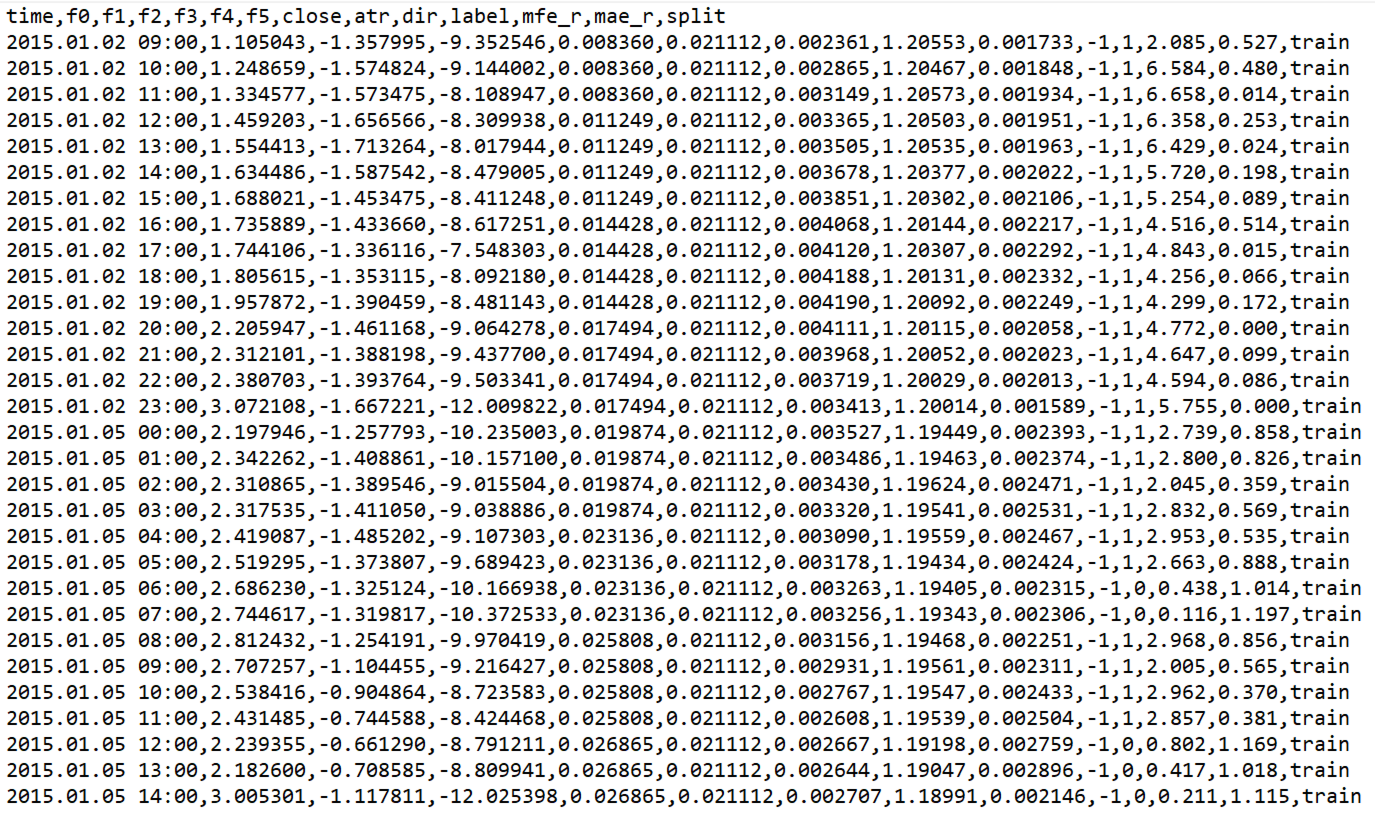
- «ARV_ML_<SYMBOL>_H1.csv»: la matriz de características, las etiquetas de TP/SL, las excursiones y la división entre entrenamiento y prueba.
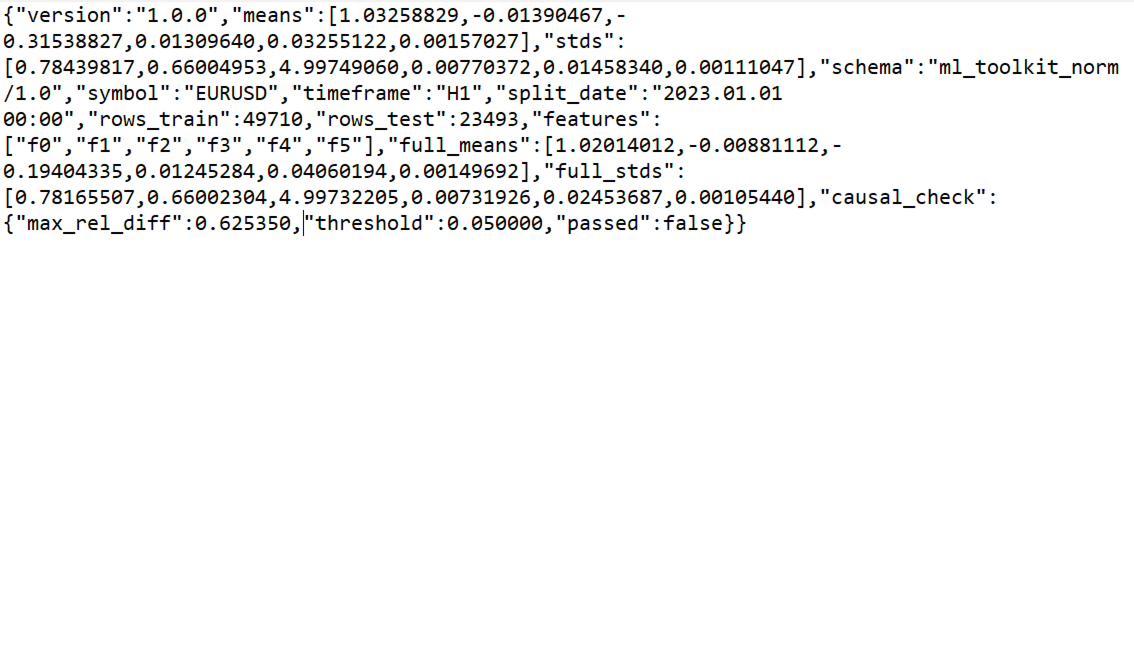
- «ARV_ML_Norm_<SYMBOL>_H1.json»: estadísticas de normalización ajustadas únicamente a la parte de entrenamiento, además de un informe de causalidad.
El script solo lee el historial y escribe archivos dentro del entorno aislado de la terminal. No opera,
ni realiza órdenes, ni envía datos a ningún sitio.
Por qué la normalización se aplica únicamente a la ventana de entrenamiento
Esta es la parte en la que la mayoría de los exportadores de conjuntos de datos se equivocan.
Si la media y la desviación estándar se calculan sobre todo el historial y, a continuación, el modelo se entrena
con una parte de ese mismo historial, la información futura se filtra en los datos de entrenamiento: las barras más antiguas
se escalan según estadísticas que ya incluyen barras posteriores. El modelo parece entonces mejor en la validación
de lo que realmente es.
Por lo tanto, el JSON exportado contiene dos conjuntos de estadísticas: «means» y «stds» ajustados únicamente a las filas de entrenamiento
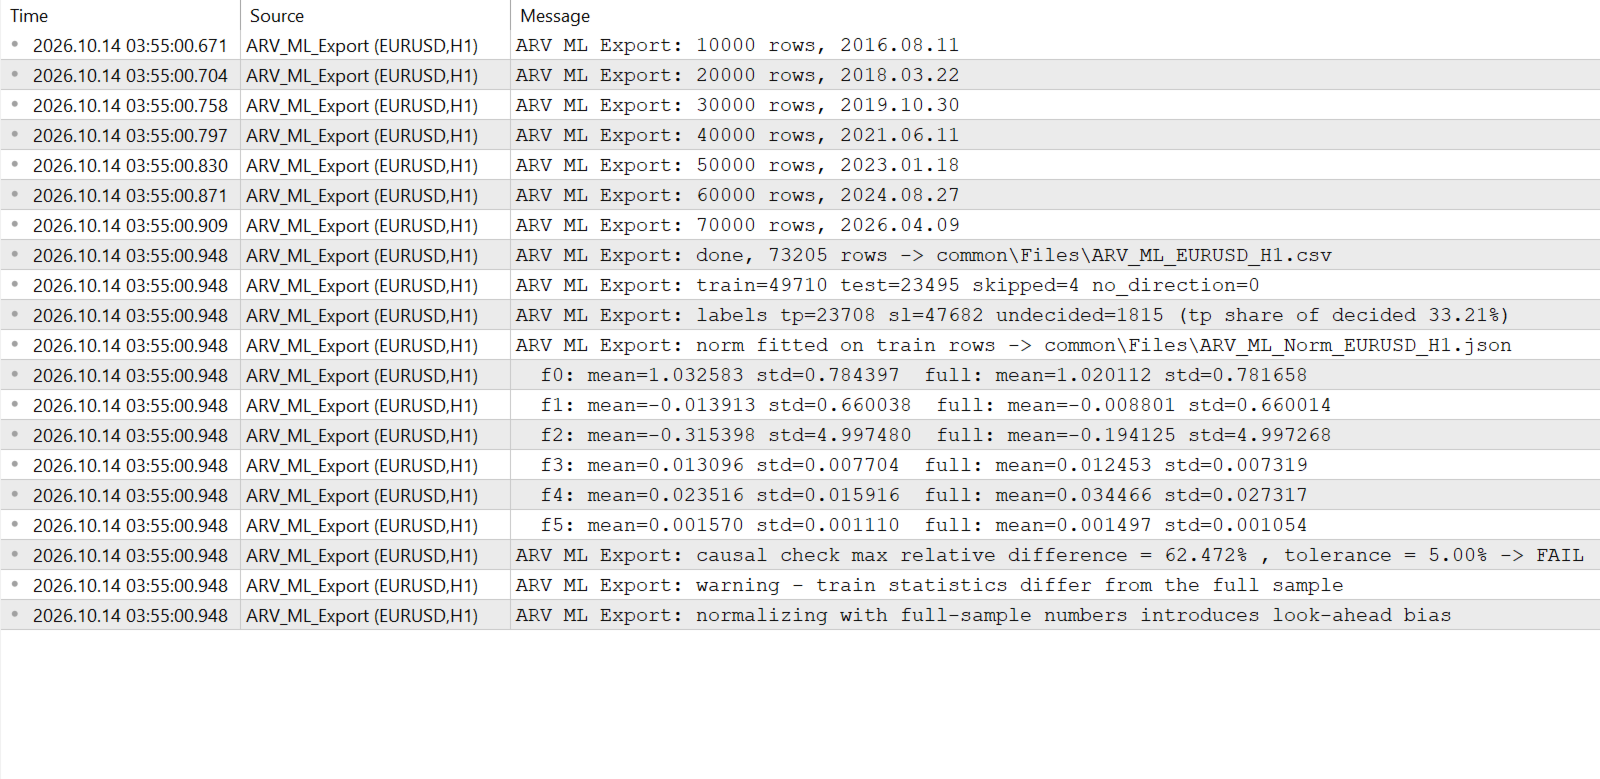
, y «full_means» y «full_stds», calculadas a partir de toda la muestra. Un bloque «causal_check» compara
ambos y muestra «max_rel_diff». Cuando la diferencia supera la tolerancia establecida en «InpCausalTolPct»,
el registro imprime una línea «FAIL» antes de que comience cualquier entrenamiento.
La división entre entrenamiento y prueba se realiza por fecha (`InpSplitDate`), no mediante un orden aleatorio. Las series financieras no son
independientes, por lo que una división aleatoria incluiría barras contiguas del mismo régimen de mercado en ambas
partes.
Salida: columnas CSV
Línea de encabezado:
| hora,f0,f1,f2,f3,f4,f5,cierre,atr,dir,etiqueta,mfe_r,mae_r,división |
|---|
| Columna | Significado |
|---|---|
| tiempo | hora de apertura de la barra de la señal, «AAAA.MM.DD HH:MM» |
| f0..f5 | características sin procesar y no normalizadas de la barra H1 cerrada |
| cierre | precio de cierre de la barra de señal |
| atr | ATR(14) de la serie H1 en la barra de señal |
| dir | dirección de la operación «1» / «-1» / «0» |
| etiqueta | «1» si se alcanzó el TP antes que el SL, «0» si el SL se activó primero, vacío si no ocurrió ninguno de los dos dentro del horizonte |
| «mfe_r», «mae_r» | desviación máxima favorable y desfavorable dentro del horizonte, en unidades R |
| división | «train» o «test» |
Características:
f0 = |EMA20(H1)  - EMA50(H1)| / ATR14(H1)
f1 = (EMA20(H1)  - EMA20(H1) 5 bars ago) / ATR14(H1)
f2 = (Close(H1)  - EMA200(H1)) / ATR14(H1)
f3 = (BB_upper(H4) - BB_lower(H4)) / EMA20(H4)     Bollinger 20, 2.0
f4 = ATR14(M15) / Close(M15) * 100
f5 = StdDev20(H1, SMA) / EMA20(H1)
Salida: claves JSON
version, means[6], stds[6], schema, symbol, timeframe, split_date,
rows_train, rows_test, features[], full_means[6], full_stds[6],
causal_check{max_rel_diff, threshold, passed}
Entradas
| Entrada | Por defecto | Significado |
|---|---|---|
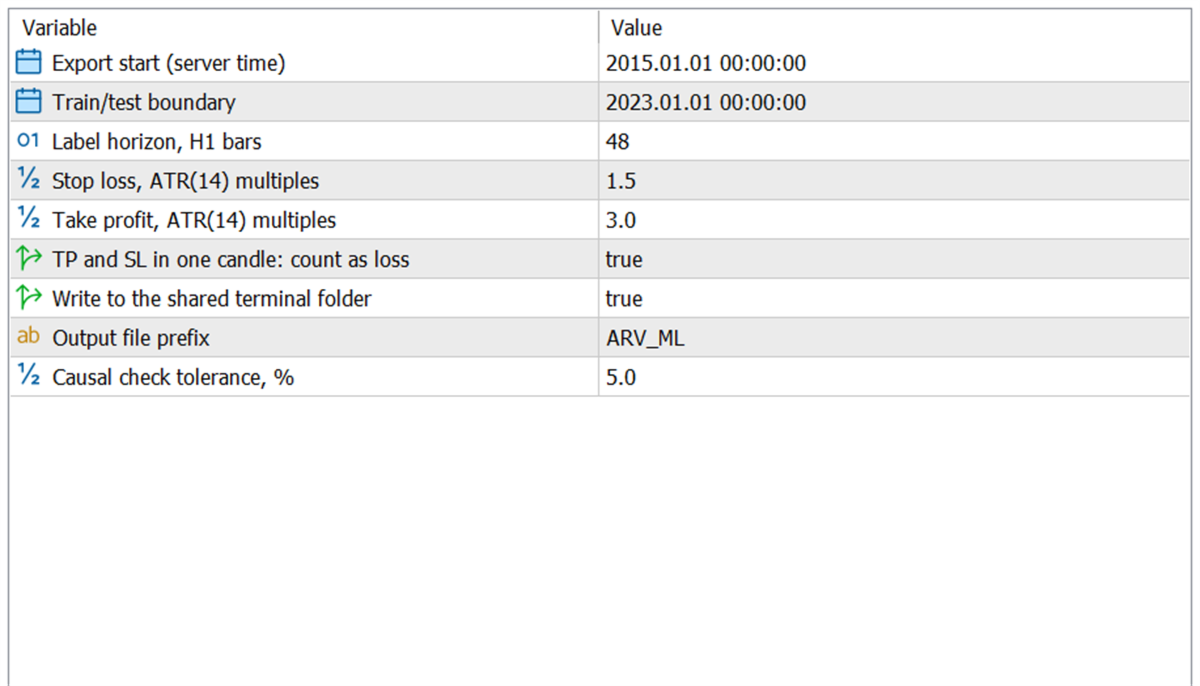
| InpFrom | 01/01/2015 | Fecha de inicio de la exportación, hora del servidor |
| Fecha de división de entrada | 01/01/2023 | Límite entre las partes de entrenamiento y de prueba |
| InpHorizonBars | 48 | Número de barras H1 analizadas para obtener un resultado de TP/SL |
| InpSL_ATR_Mult | 1,5 | Distancia del stop loss en múltiplos de ATR(14,H1) |
| InpTP_ATR_Mult | 3,0 | Distancia de take profit en múltiplos de ATR(14,H1) |
| InpAmbigPessimistic | true | Si la barra ha tocado tanto el TP como el SL: contabilízalo como una pérdida |
| InpUseCommon | true | Escribir en la carpeta compartida de la terminal en lugar de en «MQL5\Files» |
| InpPrefix | ARV_ML | Prefijo de los nombres de los archivos de salida |
| InpCausalTolPct | 5,0 | Tolerancia del informe de causalidad, en porcentaje |
Cómo ejecutarlo
1. Copie «ARV_ML_Export.ex5» en la carpeta «MQL5\Scripts» del directorio de datos del terminal.
2. Pulsa F5 en el Navegador para que aparezca el script.
3. Abre un gráfico del instrumento que desees exportar. El periodo del gráfico no importa: el script
utiliza las series H1, H4 y M15 de ese símbolo.
4. Arrastra «ARV_ML_Export» al gráfico, comprueba los parámetros y pulsa Aceptar.
5. Espera a que aparezca la línea «ARV ML Export: done, ... rows» en la caja de herramientas - Expertos.
Entrenamiento fuera de la terminal
El entrenamiento se realiza deliberadamente fuera de la terminal. Carga el archivo CSV, normaliza las características con los
«means» y «stds» del JSON, entrena cualquier modelo que se pueda exportar a ONNX y cárgalo en
MetaTrader 5 con «OnnxCreateFromBuffer». La exportación es independiente del marco de trabajo: cualquier herramienta que lea CSV
y JSON servirá. Un artículo complementario en MQL5.com explica paso a paso todo el proceso, desde este conjunto de datos
hasta un modelo ONNX que se ejecuta en MetaTrader 5.
Compatibilidad
MetaTrader 5, versión 3000 o posterior. MQL5 puro: sin DLL, sin WebRequest, sin servicios externos, sin
llamadas de licencia. El script es de solo lectura con respecto a la cuenta: nunca abre, modifica ni
cierra posiciones ni órdenes.
Aviso legal
Esta utilidad solo genera archivos de datos. No realiza operaciones de trading: no abre ni cierra
posiciones, no realiza órdenes y no genera señales. Los resultados obtenidos en el
, ni en los modelos entrenados a partir de él, dependen de la calidad de los datos y del método de investigación, y no
garantizan resultados futuros. El autor no se hace responsable de las decisiones de negociación tomadas sobre la base de
estos datos.