

От статической MA к адаптивной фильтрации (Часть 1): Знакомство с SAMA на основе NLMS в MQL5
 62
 1

Введение
Трейдерам знакома такая картина: SMA или EMA какое-то время может выглядеть идеально — пока не сменится рыночный режим и тот же фильтр с фиксированным периодом не начнет либо сильно запаздывать при импульсных движениях, либо приводить к убыткам в боковых диапазонах. Дело не в том, что скользящие средние реализованы некачественно, а в том, что их период является фиксированным, в то время как рынок — нет. Это несоответствие вынуждает постоянно вручную перенастраивать систему: сократите период — получите шум; увеличьте его — получите запаздывание.
Эта серия статей предлагает конкретную альтернативу: готовую к использованию на графиках самоадаптивную скользящую среднюю (SAMA), реализованную на MQL5 на основе адаптивной фильтрации с конечной импульсной характеристикой (FIR) и нормализованного алгоритма наименьших средних квадратов (NLMS). Принципиально важно, что в основу разработки положен четкий критерий успеха: создать работающий в реальном времени индикатор без перерисовки, который адаптируется к смене рыночных режимов без настройки периода под каждый режим, остается стабильным при ценовых скачках и выходе новостей, обновляет веса только на закрытых барах и может использоваться непосредственно на графиках, в советниках и при тестировании на исторических данных. В части 1 объясняются причины выбора этого подхода, математические основы и основной цикл NLMS. В части 2 создается полнофункциональный индикатор на MQL5; в части 3 проводится его сравнительное тестирование с классическими фильтрами.
Быстрый старт: основная идея в коде
Прежде чем перейти к теории, приведем минимальную рабочую версию цикла адаптивного обновления. Это ядро всего индикатора:
//--- 1. Calculate input vector energy (sum of squares of PAST prices)

double energy = 0.0;
for(int j = 0; j < inp_filter_length; j++)
  {
   double p = GetSourcePrice(close, high, low, i - 1 - j);
   energy += p * p;
  }

//--- Safeguard against division by zero
if(energy < 1e-8)
   energy = 1e-8;

//--- 2. Compute filter output (predicted value for current bar i) using past data
double predicted = 0.0;
for(int j = 0; j < inp_filter_length; j++)
  {
   predicted += g_weights[j] * GetSourcePrice(close, high, low, i - 1 - j);
  }

//--- 3. Compute error on the current bar
double src_price = GetSourcePrice(close, high, low, i);
double error = src_price - predicted;

//--- 4. Update weights via Normalized LMS rule (only permanently commit closed bars)
if(i < rates_total - 1)
  {
   double normalized_lr = inp_learning_rate / energy;
   for(int j = 0; j < inp_filter_length; j++)
     {
      g_weights[j] += normalized_lr * error * GetSourcePrice(close, high, low, i - 1 - j);
     }
  }

//--- 5. Store output for plotting
g_sama_buffer[i] = predicted;
Основная логика реализована как быстро выполняемая последовательность операций непосредственно в коде. Сначала алгоритм масштабирует шаг адаптации с учетом энергии прошлых цен. Затем он вычисляет прогноз и измеряет ошибку. Затем он обновляет веса — и, что особенно важно, только на закрытых барах. Если вы усвоите именно эти пять шагов, остальная часть серии станет пошаговым руководством по расширению этого цикла до стабильного индикатора, готового к внедрению.
Раздел 1: Теоретические основы фильтра NLMS
Что такое адаптивный FIR-фильтр?
Представьте обычную простую скользящую среднюю как фильтр: она берёт последние N цен, присваивает каждой одинаковый вес 1/N и выдаёт сумму взвешенных цен. Веса никогда не меняются.
Адаптивный FIR-фильтр (фильтр с конечной импульсной характеристикой) делает то же самое, но веса меняются на каждом баре. Он постоянно стремится свести к минимуму разницу между своим выходным значением и фактической ценой.
Концептуальная основа: SAMA как адаптивный FIR-фильтр
Хотя самоадаптивная скользящая средняя (SAMA) обычно называется скользящей средней, более точно её следует классифицировать как адаптивный фильтр с конечной импульсной характеристикой (FIR). Традиционные скользящие средние применяют статические, жестко заданные веса к историческим ценовым данным.
В отличие от них, SAMA работает на основе нормализованного алгоритма наименьших средних квадратов (NLMS). Она динамически пересчитывает свои внутренние коэффициенты (веса) на каждом тике или баре, чтобы минимизировать ошибку между прогнозируемым значением и фактической поступающей ценой. Это означает, что SAMA не осуществляет пассивное сглаживание данных, а активно изучает текущую структуру рынка. Если рынок переходит из фазы тренда в фазу бокового движения, веса FIR-фильтра адаптируются к новому частотному профилю. Это позволяет алгоритму сохранять актуальность без необходимости вручную менять длину периода.
Алгоритм NLMS
Нормализованный алгоритм наименьших средних квадратов (NLMS) совершенствует стандартный адаптивный подход за счёт масштабирования шага адаптации в зависимости от полной энергии вектора входных данных. На каждом баре алгоритм выполняет три основных шага:
- Сформировать прогноз: вычислить выходное значение как скалярное произведение вектора весов и вектора прошлых цен.
- Измерить ошибку: error = фактическая_цена - прогнозируемый_выход
- Обновить веса: скорректировать каждый вес с учётом нормализованной скорости обучения, чтобы обеспечить сходимость, не зависящую от масштаба.
Формула обновления весов:
w[j] ← w[j] + (μ / E) · e · x[j]
Где:
- w[j] — j-й вес (коэффициент) в фильтре.
- μ (мю) — нормализованная скорость обучения, значение которой поддерживается в пределах 0 < μ < 2; она определяет скорость адаптации весов без потери устойчивости при различных ценовых показателях.
- E — энергия входного сигнала: сумма квадратов исторических цен в окне анализа, E = Σ x[j]². Деление на E позволяет нормализовать шаг и предотвратить расхождение весов.
- e — ошибка прогноза, e = фактическая_цена − прогнозируемое_значение.
- x[j] — историческое значение входного сигнала со смещением j в окне анализа.
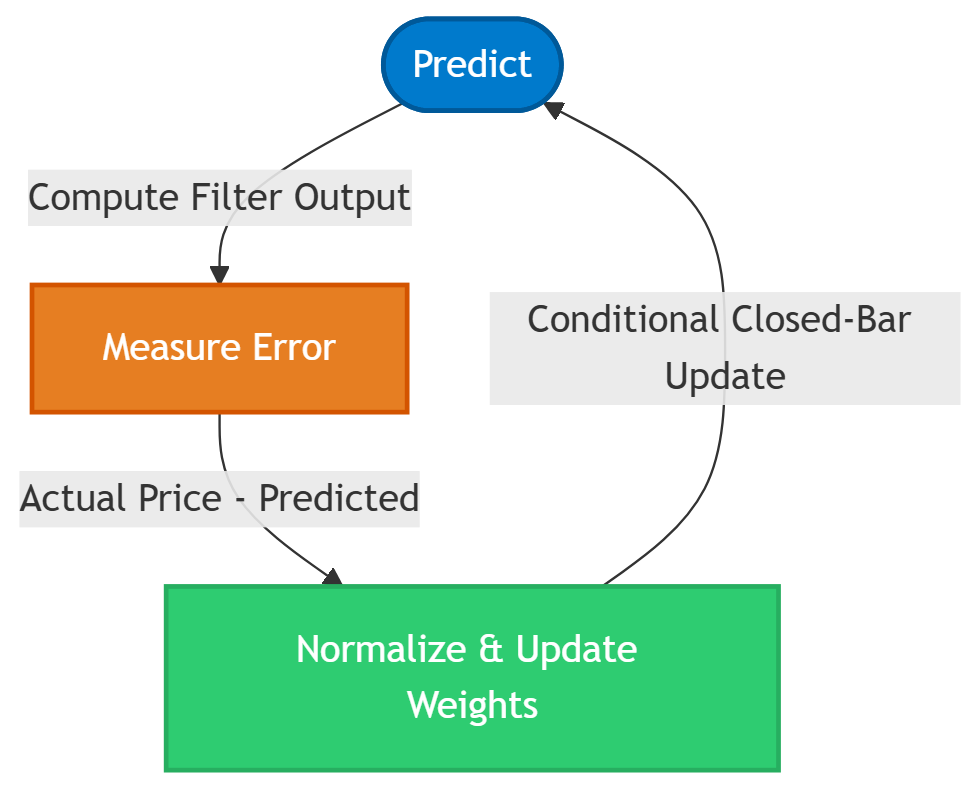
Рис. 1: Рекурсивный цикл оптимизации NLMS, обрабатывающий рыночные данные в режиме реального времени посредством непрерывной коррекции ошибки прогноза.
Почему используется инкрементальная обработка (а не пакетное обучение)
При пакетном обучении используется статический набор исторических данных, а результат развертывается в виде фиксированного артефакта. Такая модель не может реагировать на меняющуюся динамику рынка без ручного вмешательства или периодического переобучения.
При инкрементальной обработке параметры модели обновляются с каждой поступающей точкой данных. Алгоритм NLMS является наглядным примером такого подхода. Этот метод идеально подходит для потока данных о ценах в реальном времени, когда данные поступают последовательно, по одному бару за раз. Модель фактически работает непрерывно, не требуя ни переобучения, ни повторного развертывания.
Алгоритм NLMS использует этот инкрементальный цикл для вычисления корректировок весов непосредственно в функции OnCalculate(). Такая архитектурная эффективность позволяет избавиться от внешних зависимостей. Это обеспечивает стабильную адаптацию в режиме реального времени полностью в среде MQL5.
Раздел 2: Обзор архитектуры (концептуальный)
Прежде чем приступить к реализации полного кода в части 2, мы рассмотрим базовую структуру индикатора и защитные механизмы, необходимые для выполнения цикла NLMS на поступающих тиках.
Структура проекта
Таблица 1: Структура индикатора «Самоадаптивная скользящая средняя» (SAMA).
| Блок | Назначение |
|---|---|
| Объявления #property | Отрисовка на графике и настройка единственного буфера данных |
| входные параметры | Настраиваемые пользователем параметры нормализованного обучения |
| Глобальные массивы состояния | Массив вектора весов, сохраняемый между вызовами |
| Цикл OnCalculate() | Расчет энергии → Прогноз → Ошибка → Обновление на закрытом баре → Вывод |
В таблице 1 представлена структура индикатора «Самоадаптивная скользящая средняя» (SAMA). В ней описаны четыре основных функциональных блока, необходимых для управления обработкой данных и визуальным выводом в среде MQL5.
Архитектурные средства защиты: ограничение по ATR и утечка весов
Известная уязвимость стандартных адаптивных фильтров — чрезмерная реакция на внезапные аномальные скачки цен, например вызванные выходом важных макроэкономических новостей. Для решения этой проблемы в SAMA реализована функция ошибки с ограничением по ATR. Прежде чем алгоритм NLMS обновит веса, абсолютная ошибка между прогнозом и ценой сравнивается со значением среднего истинного диапазона (ATR), умноженным на заданный коэффициент. Если ошибка превышает этот динамический порог, сигнал ошибки ограничивается. Это предотвращает искажение весов фильтра из-за одной значительной ценовой аномалии, обеспечивая стабильность индикатора и возобновление отслеживания истинного тренда после того, как шок пройдет.
Для уменьшения долгосрочного численного дрейфа в SAMA используется коэффициент утечки (γ). Без регуляризации веса могут стать нестабильными при использовании входных данных с низкой дисперсией или высокой коллинеарностью. Коэффициент утечки представляет собой практическую эвристику стабилизации, а не строгую математическую гарантию ограниченности. Вводя небольшую утечку, алгоритм постоянно слегка уменьшает веса, постепенно приближая их к нулю:
w[j] ← (1 − γ) · w[j] + (μ/E) · e · x[j]
Это служит механизмом регуляризации, предотвращая насыщение весов и сохраняя способность фильтра реагировать на новые данные на протяжении многих лет непрерывной работы.
Режимы преобразования входных данных
SAMA может обучаться на трех различных представлениях цены, которые можно выбрать во входных параметрах:
- INPUT_PRICE — исходные значения цен. Режим по умолчанию; формирует стандартную сглаживающую линию, привязанную к ценовой оси.
- INPUT_DIFF — разности первого порядка между последовательными барами. В этом режиме обучение сосредоточено на импульсе движения цены, а не на ее абсолютном уровне; выходное значение преобразуется обратно в цену путем накопления прогнозируемых разностей, начиная с цены предыдущего бара.
- INPUT_RET — доходность в процентах. Этот процесс обеспечивает масштабную инвариантность фильтра за счет нормализации обучающего сигнала для разных ценовых масштабов. Для восстановления итогового значения прогнозируемая доходность просто применяется к предыдущему закрытию.
На этапе восстановления внутреннее представление всегда преобразуется обратно в исходные единицы цены. Это гарантирует правильное построение линии графика независимо от того, в каком режиме были обучены веса.
Адаптивная скорость обучения с использованием коэффициента эффективности
Когда параметр inp_use_adaptive_lr включен, базовая скорость обучения (μ) динамически масштабируется с использованием коэффициента эффективности Кауфмана (ER) на каждом баре. Показатель ER характеризует направленность недавнего движения цены относительно общей длины ее траектории: значение, близкое к 1,0, свидетельствует о четком, эффективном тренде, тогда как значение, близкое к 0,0, указывает на хаотичный шум без выраженного направления.
Используется следующая формула масштабирования:
efficiency_ratio = net_direction / net_volatility
μ_effective = μ · (0.5 + efficiency_ratio)
В условиях устойчивого тренда показатель ER приближается к 1,0, а эффективная скорость обучения — к 1,5 базового значения, что позволяет фильтру точно следовать за ценой. Во время консолидации ER резко падает, а скорость обучения снижается, приближаясь к половине базового значения, в результате чего фильтр сильнее сглаживает сигнал и подавляет шум. Это позволяет заменить статическое значение μ на регулятор адаптации, учитывающий состояние рынка.
Нормализация весов
При включении этого параметра алгоритм обеспечивает, чтобы сумма элементов внутреннего вектора весов фильтра равнялась ровно 1,0 после каждого цикла обновления. Это ограничение не позволяет исходному правилу обновления NLMS формировать конфигурации весов, которые при применении к исходным ценам дают выходные значения, отклоняющиеся от ценовой оси. При включенной нормализации взвешенная сумма исторических цен всегда дает значение в том же масштабе, что и входные данные, благодаря чему индикатор остается численно устойчивым и визуально согласованным без необходимости ручной настройки коэффициента усиления.
Динамическая цветовая классификация по наклону
В индикаторе используется график DRAW_COLOR_LINE с тремя цветовыми состояниями. На каждом закрытом баре вычисляется производная (наклон) линии SAMA:
- Положительный наклон соответствует цвету MediumSeaGreen, что указывает на фазу восходящего тренда.
- Отрицательный наклон соответствует цвету Crimson, что указывает на фазу нисходящего тренда.
- Нулевой наклон соответствует цвету SlateGray, что указывает на боковое движение или переходное состояние.
Это позволяет мгновенно визуально определять рыночный режим непосредственно по самой линии, без отдельного индикатора в подокне.
Оптимизация линейного буфера
Внутри функции OnCalculate индикатор в начале каждого вызова предварительно выделяет два локальных массива — source[] и tr_input[] — размером, равным значению rates_total. Все ценовые данные и результаты преобразований помещаются в эти непрерывные блоки памяти до начала основного вычислительного цикла. Такой подход позволяет избежать многократного разыменования указателей при обращении к массивам временных рядов терминала во внутреннем цикле, что улучшает локальность доступа к данным и эффективность использования кэш-памяти, снижая накладные расходы на обработку каждого бара.
Бары прогрева
Параметр inp_warmup_bars определяет, сколько баров обрабатывается без отображения результатов до начала отрисовки линии индикатора. Смещение PLOT_DRAW_BEGIN устанавливается равным inp_filter_length + inp_warmup_bars + inp_er_period, скрывая период, в течение которого вектор весов NLMS еще сходится после инициализации одинаковыми значениями. Это позволяет скрыть переходный процесс, который иначе отображался бы у левого края графика при первом применении индикатора к большому набору исторических данных и мог бы вводить в заблуждение.Заключение
Итак, по итогам этого раздела у вас должны быть четкая постановка задачи и точная инженерная цель: заменить фиксированный период ретроспективного анализа адаптивным вектором весов и механизмом регулирования интенсивности адаптации с учетом рыночной ситуации. Ядро NLMS выполняет на закрытых барах цикл «прогноз → ошибка → нормализованное обновление весов», а адаптивный механизм, заменяющий «настройку периода», сочетает адаптацию каждого веса с опциональным масштабированием скорости обучения по коэффициенту эффективности.
Не менее важно, что мы определили минимальный, пригодный для практического применения набор защитных механизмов, необходимых любому адаптивному индикатору на графике: ограничение экстремальных ошибок на основе ATR для устойчивости к макроэкономическим потрясениям, небольшой член утечки весов для предотвращения долгосрочного дрейфа, опциональная нормализация весов для сохранения выходных значений в масштабе цены, несколько режимов входных данных (цена/разности/доходность) с корректным восстановлением цены, адаптивный параметр μ на основе ER и период прогрева для скрытия переходных процессов сходимости. В совокупности все это составляет практическую «рецептуру» SAMA: алгоритмический каркас, надежно работающий в режиме реального времени и готовый к реализации на языке MQL5. В части 2 мы воплотим эту концепцию в полном исходном коде SAMA_NLMS.mq5: рассмотрим буферы, инициализацию весов, логику обновления на закрытых барах, отрисовку и рекомендации по применению, чтобы вы могли добавить индикатор на график или использовать его ядро в советнике (EA) либо при тестировании на исторических данных без скрытой перерисовки и нестабильного обучения.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22695
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


Мне очень понравилась эта первая часть — то, как вы позиционируете SAMA как настоящий адаптивный FIR-фильтр, а не просто очередной вариант MA, — это точно в точку, а детали реализации NLMS изложены исключительно ясно. С нетерпением жду третью часть, где вы проведете сравнительный анализ SAMA с классическими фильтрами.
Есть одна вещь, которую, надеюсь, вы могли бы учесть при сравнении: прокси периода,основанный на автокоррелограмме. Поскольку SAMA адаптируется к меняющемуся частотному профилю рынка, было бы интересно увидеть, насколько его поведение совпадает с доминирующими лагами/периодичностями, выявленными автокоррелограммой, особенно в сравнении с SMA/EMA с фиксированным периодом. Мне кажется, это естественный диагностический инструмент, позволяющий показать, где адаптивная фильтрация улавливает структуру, которую упускают статические фильтры.
В любом случае, отличная работа — с нетерпением жду следующих частей.