

Возможности Мастера MQL5, которые вам нужно знать (Часть 88): Использование фильтра Блума с пользовательским классом трейлинга
 154
 0

Введение
Обычные трейлинг-стопы часто используют логику, основанную на фиксированном ценовом отступе, которая линейно обрабатывает каждый тик или бар. Этот метод без памяти плохо отличает реальные структурные тренды от повторяющегося рыночного шума. В этой статье в качестве еще одного подхода к такому управлению сделками рассматривается фильтр Блума. Вместо отслеживания расстояний в пунктах используется вероятностная проверка принадлежности. Стопы перемещаются только при ценах, определенных как уникальные. Этот подход дополняется RNN, реализованной на MQL5 и выступающей в роли фильтра, учитывающего состояние. Она реагирует только на новые ценовые движения и одновременно смягчает сопутствующие проблемы вычислительных задержек.
Проблема
Торговля на малых таймфреймах набирает популярность (отчасти благодаря проп-фирмам) и ближе к высокочастотной торговле, чем к торговле на дневных или недельных таймфреймах. Необходимость управлять просадками позиций путем более частого отслеживания сделок привлекает все больше внимания трейдеров. Как правило, для этого требуется торговля или мониторинг сделок на малых таймфреймах.
При автоматизации такой системы из-за более частой обработки баров и тиков могут возникать вычислительные задержки. В результате советники могут выполнять избыточные логические циклы, расходующие ограниченные ресурсы процессора без получения полезной информации. Традиционные алгоритмические трейлинг-стопы нередко используют жесткие пороги без учета предыдущих состояний рынка. Такие пороги могут не адаптироваться к меняющейся микроструктуре рынка. Статический стоп-лосс, заданный в пунктах или на основе ATR, может преждевременно закрыть позиции при кратковременном всплеске волатильности, который уже затухает. При этом игнорируются более широкие структурные тренды в пользу краткосрочного шума.
Неизбирательная обработка ценовых баров может препятствовать интеграции сложных прогнозных моделей при ограничениях на выполнение в реальном времени. Если на каждом новом баре или тике вычислять матричные операции нейросети, это явно приведет к аппаратным ограничениям. Это может вызвать рассинхронизацию между локальным торговым терминалом и сервером брокера.
При поиске подходящей цены для добавления или корректировки уровней стоп-лосса нефильтрованный рыночный шум может создавать ложноположительные сигналы и искажать последовательное управление сделками. Алгоритм, реагирующий на микроколебания, будет слишком агрессивно подтягивать стоп-лосс. В результате активу не останется пространства для реализации моментума основного направления.
В статье предлагается двухуровневая архитектура фильтрации, реализованная в пользовательском классе трейлинга на языке MQL5, для устранения этих системных неэффективностей. Используется вероятностный фильтр Блума для устранения дубликатов тиков со сложностью O(1), а также простая рекуррентная нейронная сеть RNN для модерации порога. Цель – более точное управление сделками. Методология резервирует вычислительные ресурсы для особых событий. Корректировка стоп-лосса определяется последовательной памятью рынка, а не случайными колебаниями.
Архитектура и управление памятью
Структурная надежность пользовательского модуля трейлинга на языке MQL5 зависит от соблюдения правил наследования стандартной библиотеки и внутренней стратегии выделения памяти. Определение класса как "CTrailingBloomRNN : public CExpertTrailing" позволяет Мастеру MQL5 распознать модуль для бесшовной интеграции в сборку, формируемую Мастером.
Наследование пользовательского класса обеспечивает прямой доступ к важным торговым объектам m_position и m_symbol. Это необходимо для получения рыночных цен, а также исполнения и изменения ордеров. Ручная реализация, несмотря на наличие библиотек, увеличивает время разработки и риск утечек памяти и рассинхронизации терминала с сервером. Встроенные библиотеки MQL5 оптимизированы для низкой задержки.
Как и многие классы Мастера MQL5, CTrailingBloomRNN использует структуру памяти, ориентированную на производительность. В этом классе объявляются и управляются только элементы, необходимые для стратегии. В пользовательском классе используется массив беззнаковых символов m_bitset[] для побайтной упаковки памяти при работе с вероятностным фильтром Блума.
В отличие от обычных булевых или целочисленных массивов, массив uchar позволяет точно управлять отдельными битами в непрерывном блоке памяти. Поэтому модуль фильтрации дубликатов остается компактным и малонагруженным независимо от параметра m_filter_size. В то же время переменная m_hidden_state служит постоянным хранилищем последовательной памяти RNN. Состояние этой переменной сохраняется после завершения и разрушения локальных областей видимости функций, выполняемых при каждом новом баре. Это позволяет пользовательскому классу сохранять математическую память о рыночном моментуме на протяжении нескольких баров или тиков.
Логика инициализации предварительно выделяет память, заранее задавая размер массива m_bitset. Функция преобразует требуемое число битов в число байтов. Благодаря этому объем необходимой памяти сокращается в восемь раз. Благодаря этому даже большой битовый набор для тысяч уникальных ценовых точек будет потреблять минимум ресурсов.
После выделения памяти и изменения размера массива вероятностная память очищается. Это предотвращает реакцию пользовательского класса на "мусорные" данные, оставшиеся в оперативной памяти. Для этого массив заполняется нулями. Кроме того, инициализация m_hidden_state = 0.5 задает для RNN нейтральное исходное состояние. Это значение гарантирует, что первый уникальный ценовой бар, обработанный советником, не попадет в состояние насыщения. Это создает сбалансированную исходную точку для функции активации гиперболического тангенса.
Вероятностное устранение дубликатов цен
Снижение избыточных вычислений в высокочастотной среде достигается с помощью функций IsDuplicateTick и Hash. Эти методы выполняют роль фильтра со сложностью O(1), используя фильтр Блума для выявления и отбрасывания повторяющихся ценовых данных. Перед решением о корректировке трейлинг-стопа, по сути, учитываются только значимые ценовые отклонения, интерпретируемые относительно предыдущих уровней поддержки и сопротивления.
Метод Hash создает основу для вероятностной проверки принадлежности, отображая числа с плавающей точкой в дискретное целочисленное пространство. Реализуем это на языке MQL5 следующим образом:
//+------------------------------------------------------------------+
//| FNV-1a Style Hash for Bloom Filter                               |
//+------------------------------------------------------------------+
uint CTrailingBloomRNN::Hash(double val, int seed)
  {
   uint hash = 2166136261 + seed;
   string s = DoubleToString(val, 8);
   for(int i = 0; i < StringLen(s); i++)
      hash = (hash ^ s[i]) * 16777619;
   return hash;
  }
При использовании FNV-1a инициализируется беззнаковое целое значение hash. Используется базовое смещение FNV – стандартное значение процесса хеширования, с которого хэш начинается в ненулевой точке с высокой энтропией. Преобразование входного значения double в строку важно для сохранения целостности тиковых данных. Фиксация 8 знаков после запятой позволяет представлять небольшие колебания как различимые значения.
Итеративный цикл ниже:
hash = (hash ^ s[i]) * 16777619;
выполняет побитовую операцию XOR для каждого символа. Эта последовательность максимально распределяет значения по битовому пространству uint, уменьшая вероятность коллизий, при которых две разные ценовые точки попадают в один индекс фильтра.
Затем модуль устранения дубликатов проверяет уникальность тика. Это выполняется в функции IsDuplicateTick(), где сгенерированные хэш-значения преобразуются в конкретные позиции внутри битового набора. Код для этого приведен ниже:
//+------------------------------------------------------------------+
//| Bloom Filter Logic: Tick Deduplication                           |
//+------------------------------------------------------------------+
bool CTrailingBloomRNN::IsDuplicateTick(double price)
  {
   uint price_bits = (uint)MathRound(price / m_symbol.Point());
   bool already_exists = true;
   for(int i = 0; i < m_hash_count; i++)
     {
      uint h = Hash(price_bits, i) % m_filter_size;
      int byte_idx = int(h / 8);
      int bit_idx = int(h % 8);
      if(!(m_bitset[byte_idx] & (1 << bit_idx)))
        {
         already_exists = false;
         m_bitset[byte_idx] |= uchar(1 << bit_idx); // Mark as seen
        }
     }
   return already_exists;
  }
В этой функции входная цена сначала округляется до пунктов и преобразуется в целочисленное значение. Некоторые могут счесть округление до абсолютных пунктов слишком чувствительным и предпочесть порог, подобный порогам ренко. Это обоснованный аргумент. Однако здесь выбран упрощенный пример, а поскольку код в открытом доступе, читатель может внести необходимые изменения. В следующем цикле for алгоритм вычисляет битовые координаты. byte_idx определяет соответствующий элемент типа uchar в массиве, а bit_idx с помощью операции по модулю определяет позицию от 0 до 7 внутри байта.
Условие if(!(m_bitset[byte_idx] & (1 << bit_idx))) лежит в основе проверки принадлежности со сложностью O(1). Здесь побитовая операция AND определяет, равен ли нулю бит по вычисленной координате. Если бит равен нулю, тик считается уникальным, после чего бит устанавливается в единицу с помощью побитовой операции OR: m_bitset[byte_idx] \|= uchar(1 << bit_idx);. Если все хэшированные биты для данной цены уже равны единице, функция вернет true. Это сообщает вызывающему методу, что текущий тик является повторным и должен быть проигнорирован. Благодаря этому ресурсы процессора сохраняются для обработки более значимых изменений рынка.
Последовательная нейронная модерация
Можно сказать, что "стратегический интеллект" пользовательского класса трейлинга CTrailingBloomRNN реализован именно в методе UpdateRNN. Здесь используется рекуррентная нейронная сеть, обеспечивающая логику стоп-лосса с постоянной "памятью рынка". Обработка потока данных после устранения дубликатов через матрицу переходов скрытого состояния позволяет алгоритму преодолеть ограничения реактивного исполнения без памяти.
Перед обработкой рекуррентной сетью ценовые данные необходимо привести к масштабо-независимому виду. Первой операцией в нейронном модуле является следующее объявление нормированного входного значения:
double input_normalized = (price - m_symbol.Bid()) / m_symbol.Point();
Эта строка кода выполняет важное нормирование, вычисляя мгновенное расстояние между текущей ценой и ценой Bid символа в абсолютных пунктах. Благодаря этому преобразованию входное значение нейронной сети становится безразмерным. Это предотвращает искажение взвешенной суммы скрытого состояния абсолютной величиной цены актива, например $1.0850 по сравнению с $150.250. Без этого шага сеть пришлось бы переобучать для каждого инструмента, чтобы компенсировать различия в масштабе цен и точности десятичных знаков.
Основное математическое преобразование нейронного фильтра выполняется в следующей компактной строке кода:
M_hidden_state = MathTanh(0.5 * m_hidden_state + 0.5 * input_normalized);
Эта строка кода реализует упрощенную версию обновления состояния RNN. Переменная m_hidden_state обозначает накопленную память ценовой последовательности. Она обновляется вычислением взвешенной суммы предыдущего и текущего нормированных входных значений. В этой реализации алгоритм придает равный вес прошлому моментуму и текущему ценовому движению.
Выбор функции активации MathTanh – гиперболического тангенса – важен по нескольким причинам:
-
Ограничение насыщения: функция Tanh отображает все входные значения в диапазон от -1 до +1. Это предотвращает проблемы исчезающего и взрывающегося градиента, возможные в рекуррентных архитектурах. Благодаря этому значение m_hidden_state остается стабильным даже в периоды экстремальной рыночной волатильности.
-
Симметрия: в отличие от сигмоидной функции, ограниченной значениями от 0 до 1, функция Tanh центрирована относительно нуля. Благодаря этому скрытое состояние с одинаковой чувствительностью отражает положительный, то есть бычий, и отрицательный, то есть медвежий, моментум.
Сохранение значения переменной-члена m_hidden_state означает, что каждый уникальный тик оставляет рекурсивный след в логике алгоритма. Поскольку h_t зависит от h_(t−1), решение о трейлинге отражает все уникальные ценовые бары, прошедшие через фильтр Блума с момента открытия позиции.
Эта последовательная зависимость позволяет советнику определить статистическую значимость ценового движения и обосновать корректировку стоп-лосса. Фактически отфильтровываются случайные кратковременные колебания, которые в нерекуррентной системе часто вызывали бы преждевременное закрытие позиции. Этот слой нейронной модерации превращает трейлинг-стоп из жесткого математического смещения в динамический протокол, учитывающий последовательность событий.
Логика исполнения и переопределения
Устранение дубликатов и нейронная модерация объединены в переопределенных виртуальных методах CExpertTrailing. Эта логика реализована в функциях CheckTrailingStopLong и CheckTrailingStopShort. Переопределение заменяет поведение метода по умолчанию; в этой реализации дополнительные вычисления сведены к минимуму.
Методы CheckTrailingStopLong и CheckTrailingStopShort реализуют основную логику, уже представленную в предыдущих разделах. При рассмотрении кода этих функций становится видна иерархия выполнения:
//+------------------------------------------------------------------+
//| Check Long: Bloom -> RNN -> Execution                            |
//+------------------------------------------------------------------+
bool CTrailingBloomRNN::CheckTrailingStopLong(CPositionInfo *position, double &sl, double &tp)
  {
   if(position == NULL)
      return false;
   double price = m_symbol.Bid();
//--- 1. Bloom Filter Deduplication
   if(IsDuplicateTick(price))
      return false;
//--- 2. Sequential Neural Filter
   if(MathAbs(m_rnn_threshold) > 0.0)//zero means threshold is not used
     {
      UpdateRNN(price);
      if(MathAbs(m_hidden_state) < m_rnn_threshold)
         return false;
     }
//--- 3. Trailing Execution
   double new_sl = price - (m_symbol.StopsLevel() * m_symbol.Point());
   double current_sl = position.StopLoss();
   if(new_sl > current_sl || current_sl == 0.0)
     {
      sl = NormalizeDouble(new_sl, m_symbol.Digits());
      return true;
     }
   return false;
  }
Начальная проверка "if(position == NULL) return false;" – необходимая мера безопасности, исключающая применение логики трейлинга к несуществующим объектам. Затем переменной price присваивается текущая цена Bid символа, отражающая последнее ценовое изменение. Затем проверяется значимость ценовой точки, то есть ее существенное отличие от предыдущих уровней, с помощью рассмотренной выше функции "if(IsDuplicateTick(price)) return false;". Это также служит ранним завершением: если тик является дубликатом, функция немедленно возвращает false и экономит ресурсы процессора. Использование фильтра Блума со сложностью O(1) позволяет алгоритму немедленно завершить выполнение метода.
После определения ценового бара или тика как уникального он проходит через второй интеллектуальный фильтр. Здесь вызывается функция UpdateRNN, использующая порог, по которому текущее состояние проверяется и обновляется последними данными. Этот шаг опционален: если оптимизированный порог равен нулю, уникальные цены не фильтруются через RNN и используется только алгоритм устранения дубликатов.
Если эта модерация активна, то есть m_rnn_threshold не равен нулю, выполняется проверка абсолютного значения. Это гарантирует, что стоп-лосс останется без изменений, пока внутренняя память ценовой последовательности не достигнет заданного пользователем порога активации. Этот механизм не позволяет советнику реагировать на случайные кратковременные колебания и ограничивает корректировки периодами реального моментума.
После прохождения ценового бара через оба фильтра пользовательский класс рассчитывает фактические параметры стоп-лосса. Строка "new_sl = price - (m_symbol.StopsLevel() * m_symbol.Point());" вычисляет новый уровень, соблюдая требуемый брокером Stops Level. Условие if(new_sl > current_sl \|\| current_sl == 0.0) реализует основное правило трейлинг-стопа: уровень стоп-лосса может перемещаться только в направлении открытой позиции, фиксируя прибыль. Наконец, команда "sl = NormalizeDouble(new_sl, m_symbol.Digits());" важна, поскольку округляет цену с плавающей точкой до значения, приемлемого для торгового сервера брокера. Эта переопределенная функция возвращает true, только если выполнены все условия вероятностной проверки.
Эмпирический анализ
Переход от теоретического кода к эмпирической проверке важен для оценки влияния вероятностных фильтров и нейронных сетей. Можно оценить соотношение риска и доходности, обеспечиваемое классом трейлинга, за стандартный тестовый период по символу GBPJPY с 01.03.2023 по 15.04.2026. Тестирование проводится в двух режимах. В первом варианте используется только базовый фильтр Блума, а во втором к нему добавляется RNN-фильтр.
В первой тестовой итерации советник использовал фильтр Блума для устранения дубликатов тиков без RNN. Отчет показал высокоэффективный, хотя и агрессивный профиль управления рисками:
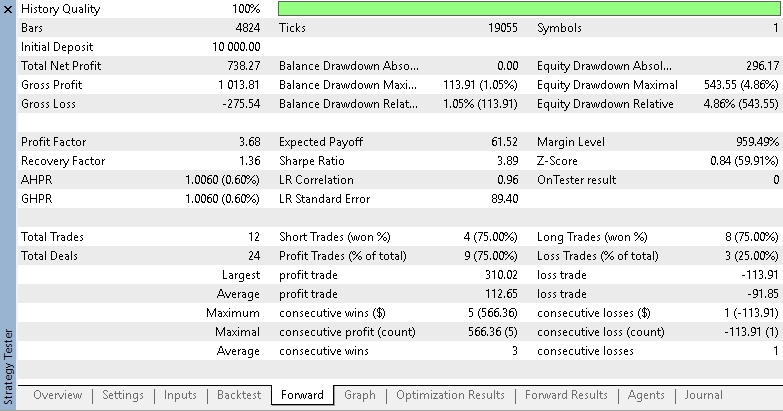
Советник достиг профит-фактора 3,68 и коэффициента Шарпа 3,89, что согласуется с 12 сделками в форвардном тестировании. Еще одним преимуществом базового варианта был строгий контроль просадки: максимальная просадка баланса ограничилась 1,05%. Без пороговой обработки RNN советник с трейлинг-стопом оставался очень чувствительным к последнему ценовому движению. Согласно отчету, это предотвратило крупные неблагоприятные просадки, но привело к "жесткому" управлению сделками, ограничившему валовую прибыль суммой чуть более 1 000 долларов США. По-видимому, советник отдавал приоритет немедленной защите уже полученной прибыли, а не развитию более широкого движения. После добавления RNN-фильтра получен следующий отчет по результатам оптимизации:
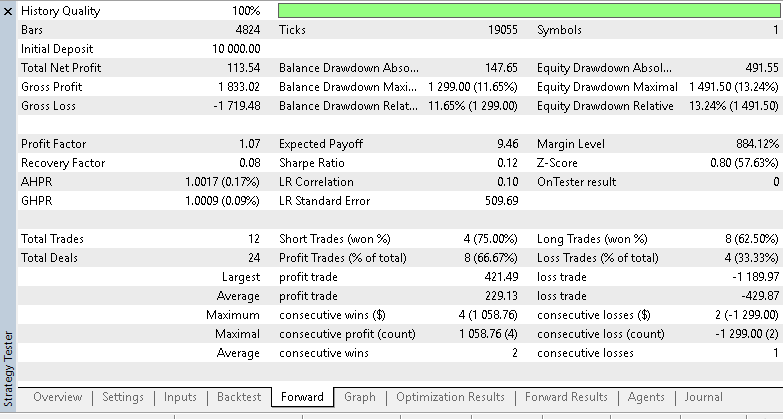
В этой итерации введен параметр m_rnn_threshold для модерации изменений стоп-лосса. Эти изменения основаны на скрытом состоянии ценовой последовательности. Эта модификация кардинально изменила геометрию результатов стратегии. Однако, несмотря на дополнительный фильтр, результаты не улучшились. Валовая прибыль выросла на 80% до 1 833,02, однако чистая прибыль сократилась с более чем $700 до приблизительно $100. Это может быть связано с появлением математического "запаздывания памяти".
Также стоит отметить, что максимальная просадка средств счета выросла до 11,65%, а коэффициент Шарпа снизился до 0,12. Валовой убыток также вырос с -275,54 до -1 719,48 долларов США, хотя общее число сделок осталось прежним – 12. Это может указывать на то, что при тестировании GBPJPY RNN-модерация, возможно, заставляла советник удерживать позиции дольше в ожидании подтверждения разворота тренда от m_hidden_state.
Для более обоснованных выводов подход следует протестировать на большем числе символов и за более длительные периоды. Это расхождение между отчетами может указывать на двоякий эффект нейросетевой модерации. Хотя фильтр Блума стабильно снижал вычислительную нагрузку, слой RNN, по-видимому, превратил советник из скальпирующей системы в систему, следующую за трендом. Это подчеркивает важность тщательной калибровки порогов RNN. Должен ли входной порог изменяться в разных рыночных условиях?
Выводы
Реализация пользовательского класса трейлинга CTrailingBloomRNN в определенной степени позволяет устранить вычислительные задержки и протоколы исполнения без учета предшествующих состояний, выявленные в исходной постановке проблемы. Сочетание вероятностных структур данных и рекуррентной нейронной сети призвано показать, что торговая логика может одновременно экономить вычислительные ресурсы и учитывать стратегический контекст.
Фильтр Блума с хешированием FNV-1a устраняет аппаратные ограничения, связанные с высокочастотными ценовыми потоками, обеспечивая устранение дубликатов со сложностью O(1). Параллельно RNN с функцией активации гиперболического тангенса формирует динамический порог, учитывающий последовательность событий и помогающий преодолеть ограничения жестких статичных трейлинг-стопов.
Отчеты по форвардному тестированию подтверждают, что фильтр Блума стабильно оптимизирует использование ресурсов процессора. Однако слой нейронной модерации создает сложный компромисс между немедленным сохранением капитала и способностью удерживать позиции в рамках более крупного тренда. Значительный рост валовой прибыли в тесте с модерацией, то есть во втором отчете, в некоторой степени подтверждает эффективность скрытого состояния при фильтрации случайного рыночного шума.
Однако одновременный рост просадки средств счета напоминает о запаздывании памяти, присущем последовательным моделям. Это может потребовать точной калибровки входного параметра m_rnn_threshold для лучшего соответствия заданному уровню толерантности к риску.
Заключение
Подводя итог, переход от реактивных математических смещений к проактивной интеллектуальной фильтрации может стать эволюцией в проектировании алгоритмов MQL5. Представленный здесь прототип пользовательского класса может стать важной отправной точкой, предоставляющей трейдерам инструменты для более точной работы с современной рыночной микроструктурой. Резервируя вычислительные ресурсы для необходимых событий и учитывая память рынка, автор стремится создать надежную систему управления сделками прежде всего для тестовых сред, а в перспективе, возможно, и для реальной торговли.
| имя | описание |
|---|---|
| wz_88.mq5 | Советник, собранный Мастером MQL5 |
| TrailingBlooming.mqh | Пользовательский класс трейлинга, используемый при сборке советника Мастером MQL5 |
Прилагаемый пользовательский класс TrailingBlooming.mqh предназначен для сборки советника с помощью Мастера MQL5. В этом тестировании использовались пользовательские сигналы SignalEnvelopes.mqh и SignalRSI.mqh. Новые читатели могут ознакомиться с руководствами здесь и здесь, чтобы узнать, как собрать советник с помощью Мастера MQL5.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22389
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Нейросети в трейдинге: Долговременная память торговых сценариев (Окончание)
 Изучение стандартной библиотеки MQL5 (Часть 7): Создание интерактивных меток позиций с помощью класса CCanvas
 Возможности Мастера MQL5, которые вам нужно знать (Часть 89): Использование побитовой векторизации с перцептронными классификаторами
 Создание торговых систем с искусственным интеллектом на MQL5 (Часть 9): Создание диспетчера сигналов ИИ

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования