

Как реализовать прогнозирование с помощью AutoARIMA в MQL5
 12
 0

Введение
Вам нужен практический одношаговый прогноз цены прямо в торговом терминале, но типовой процесс работы с ARIMA создает два распространенных препятствия: ручной выбор p, d и q и сложность встраивания в MQL5 статистически надежной процедуры оценки параметров. Эта инженерная задача решается компактной воспроизводимой процедурой, которая принимает один массив MQL5 с последними ценами закрытия, где Close[0] — самая последняя цена закрытия, и возвращает числовой прогноз следующей цены закрытия.
Реализованный подход автоматизирует всю последовательность обработки:
- (1) оценить порядок дифференцирования d с помощью эвристики на основе дисперсии и применить дифференцирование для достижения стационарности;
- (2) подобрать модели ARMA(p,q) для небольшой сетки порядков путем минимизации SSE с градиентными обновлениями и оптимизатором Adam, при этом коэффициенты ограничиваются для стабильности;
- (3) выбрать наилучшую модель по скорректированному информационному критерию Акаике (AICc);
- (4) выполнить обратное преобразование после дифференцирования и округлить результат до размера тика, чтобы получить одношаговый прогноз цены.
Ограничения по умолчанию, например max p/max q = 5, и одношаговый горизонт прогнозирования — явные инженерные решения, обеспечивающие надежность и высокую скорость процедуры в реальном времени.
Временной ряд
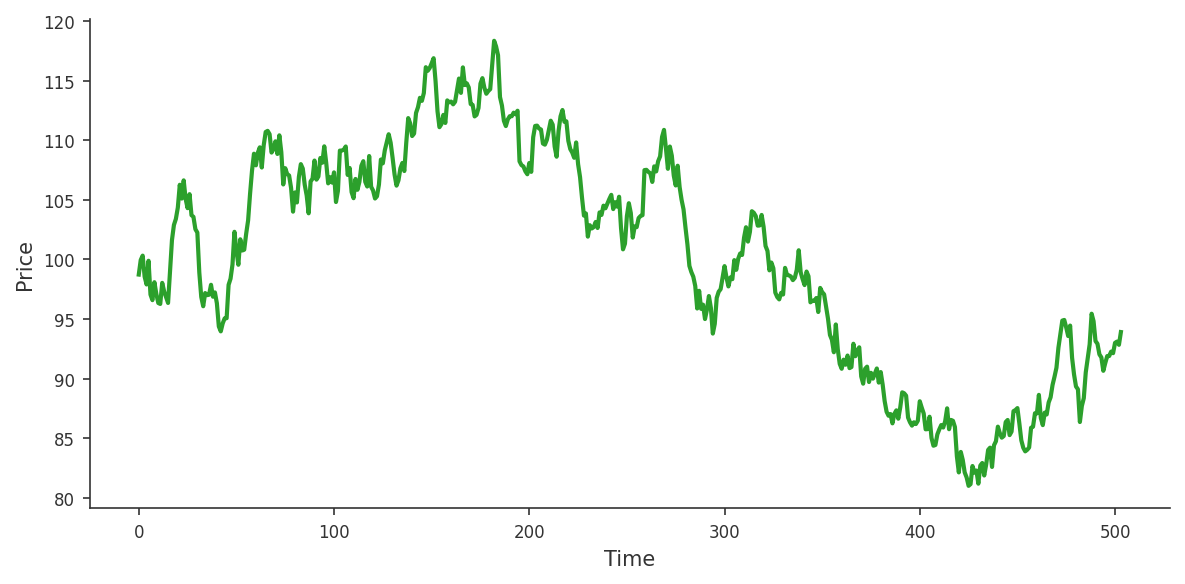
Временной ряд — последовательность наблюдений, индексированных по времени. В отличие от традиционных наборов данных, данные временных рядов могут демонстрировать временную зависимость, при которой прошлые значения влияют на будущие наблюдения. Эта зависимость присутствует не всегда, но при ее наличии она служит основой для моделей прогнозирования, таких как ARIMA.
Цены финансовых инструментов образуют временной ряд: каждое закрытие свечи привязано к конкретному моменту времени, формируя хронологическую последовательность наблюдений.
В более общем виде временной ряд можно записать как последовательность:
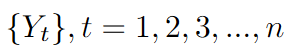
При этом каждое наблюдение индексируется по времени.
ARIMA
Модель ARIMA определяется тремя параметрами: p, d и q. Параметр p обозначает порядок авторегрессии, d — порядок дифференцирования, а q — порядок компоненты скользящего среднего.
Параметр d
Параметр d играет решающую роль в преобразовании ряда в стационарный процесс. Рассмотрим временной ряд, выглядящий в целом случайным: цены могут непредсказуемо двигаться вверх или вниз. Такое поведение часто наблюдается у нестационарных рядов, статистические свойства которых (например, среднее и дисперсия) меняются со временем.
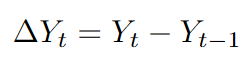
Это преобразование измеряет изменение между последовательными наблюдениями. Если исходный ряд имеет тренд, продифференцированный ряд часто ведет себя ближе к стационарному процессу.
Когда первой разности недостаточно, ряд дифференцируется дважды:
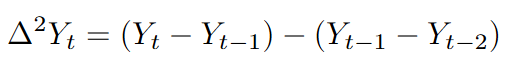
Параметр p
Параметр p определяет авторегрессионную компоненту модели ARIMA. Эта компонента отражает взаимосвязь между текущим значением ряда и его прошлыми наблюдениями. Другими словами, предполагается, что текущее значение можно частично объяснить прошлыми значениями.
Например, в финансовых временных рядах часто наблюдаются краткосрочные зависимости, при которых недавние движения цен влияют на последующие. Авторегрессионный член моделирует это поведение, присваивая прошлым значениям ряда определенные веса.
По мере увеличения p модель учитывает больше прошлых наблюдений, что позволяет ей отражать более сложные временные структуры. Однако выбор слишком большого значения может привести к переобучению, когда модель начинает улавливать шум вместо значимых закономерностей.
По сути, авторегрессионная компонента отвечает на простой вопрос: насколько настоящее можно объяснить прошлым?
Вот как выглядит модель AR(p):
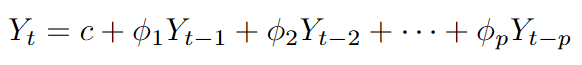
Ошибки (εₜ)
Прежде чем вводить параметр q, компоненту скользящего среднего, важно определить понятие ошибки в моделировании временных рядов.
В данном контексте ошибка, или остаток, представляет собой разность между наблюдаемым значением и значением, прогнозируемым моделью на данном временном шаге. Это можно выразить следующим образом:
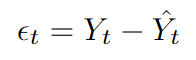
где Yₜ — наблюдаемое, фактическое значение, а Ŷₜ — прогнозируемое значение.
Эти ошибки отражают ту часть ряда, которую модель не может объяснить.
Параметр q
Этот параметр определяет, сколько прошлых ошибок используется для моделирования текущего значения ряда. На практике компонента скользящего среднего учитывает прошлые ошибки прогнозирования при расчете текущей оценки. Если модель систематически завышала или занижала последние значения, включение прошлых ошибок в модель помогает корректировать будущие прогнозы.
Вот как выглядит модель MA(q):
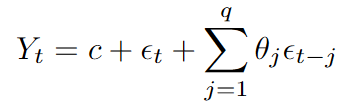
ARMA(p,q)
После преобразования ряда к стационарности выполняется подгонка модели ARMA, сочетающей авторегрессионные члены и члены скользящего среднего. Эта модель учитывает p предыдущих значений ряда и q предыдущих ошибок и может быть представлена следующим образом:
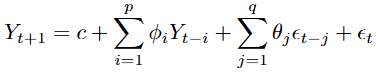
После этого краткого введения в модели ARIMA возникает естественный вопрос: как выбрать оптимальные значения p, d и q?
Именно для этого предназначен алгоритм AutoARIMA: по заданному набору данных он автоматически выбирает оптимальную модель и формирует прогноз на следующий период.
Среднее значение
В коде среднее значение временного ряда используется в процессе оценки модели. Оно определяется следующим образом:
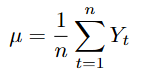
//+------------------------------------------------------------------+
//| mean: arithmetic mean of a double array                          |
//+------------------------------------------------------------------+
double mean(const double &series[])
  {
   double sum = 0.0;
   int n = ArraySize(series);

   if(n == 0)
      return 0.0;

   for(int i=0;i<n;i++)
     {
      sum += series[i];
     }
   sum /= n;

   return sum;
  }
Дисперсия
Кроме того, в процессе оценки модели используется дисперсия временного ряда. Она определяется следующим образом:
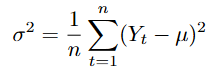
//+------------------------------------------------------------------+
//| variance: population variance of a double array                  |
//+------------------------------------------------------------------+
double variance(const double &series[])
  {
   double sum = 0.0;
   int n = ArraySize(series);

   if(n < 2)
      return 0.0;

   double mu = mean(series);

   for(int i=0;i<n;i++)
     {
      sum += (series[i]-mu)*(series[i]-mu);
     }
   sum /= n;
   return sum;
  }
Вычисление d
В данной реализации алгоритма AutoARIMA значение d не выбирается вручную, а оценивается с помощью простой эвристики на основе дисперсии.
Идея состоит в сравнении дисперсии исходного ряда с дисперсией после дифференцирования:
если дисперсия существенно не уменьшается, ряд считается стационарным и d = 0;
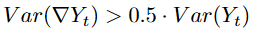
если после первого дифференцирования дисперсия значительно уменьшается, d = 1;
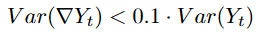
если дальнейшее дифференцирование продолжает уменьшать дисперсию, d = 2.
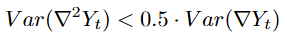
//+------------------------------------------------------------------+
//| Calculate_d: heuristic to determine differencing order d         |
//+------------------------------------------------------------------+
int Calculate_d(const double &Series[])
  {
   int n = ArraySize(Series);
   if(n < 3)
      return 0;   // Not enough data, assume no differencing

//--- Variance of the original series
   double var0 = variance(Series);

//--- First difference and its variance
   double diff1[];
   ArrayResize(diff1, n-1);
   for(int i = 0; i < n-1; i++)
      diff1[i] = Series[i] - Series[i+1]; // Note: Series is most-recent-first, so diff is computed backwards
   double var1 = variance(diff1);

//--- Heuristic: if first difference doesn't reduce variance much, no differencing needed
   if(var1 > 0.5 * var0)
      return 0;
   if(var1 < 0.1 * var0)
      return 1;   // Strong variance reduction suggests d=1

//--- Second difference and its variance
   double diff2[];
   ArrayResize(diff2, n-2);
   for(int i = 0; i < n-2; i++)
      diff2[i] = diff1[i] - diff1[i+1];
   double var2 = variance(diff2);

//--- If second difference further significantly reduces variance, use d=2
   if(var2 < 0.5 * var1)
      return 2;

//--- Default to first-order differencing
   return 1;
  }
Дифференцирование временного ряда
Теперь, когда значение d определено, его можно применить к исходному ряду с помощью функции дифференцирования.
//+------------------------------------------------------------------+
//| Difference: applies d-order differencing and returns series in   |
//| ascending chronological order                                    |
//+------------------------------------------------------------------+
void Difference(int d, const double &Close[], double &diff[])
  {
   int n = ArraySize(Close);

   if(n <= d)
     {
      Print("Not enough data.");
      ArrayResize(diff, 0);
      return;
     }

//--- Case d = 0: no differencing, just reverse to chronological order
   if(d==0)
     {
      ArrayResize(diff, n);
      ArrayCopy(diff, Close);
      ArrayReverse(diff);  // Most-recent-first -> oldest-first
      return;
     }

//--- Case d = 1: first difference
   if(d==1)
     {
      ArrayResize(diff,n-1);
      for(int i=0;i<n-1;i++)
        {
         diff[i] = Close[i]-Close[i+1];   // Backward difference (since Close is most recent first)
        }
      ArrayReverse(diff);
      return;
     }

//--- Case d = 2: second difference
   if(d==2)
     {
      double first_diff[];
      ArrayResize(first_diff, n-1);
      for(int i=0;i<n-1;i++)
        {
         first_diff[i] = Close[i]-Close[i+1];
        }
      ArrayResize(diff, n-2);
      for(int i=0;i<n-2;i++)
        {
         diff[i] = first_diff[i]-first_diff[i+1];
        }
      ArrayReverse(diff);
      return;
     }
  }
Сумма квадратов ошибок (SSE)
Чтобы оценить, насколько хорошо модель соответствует данным, необходима количественная мера ошибки прогноза.
SSE измеряет сумму квадратов разностей между наблюдаемыми значениями и прогнозными значениями, полученными моделью.
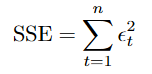
Эта величина служит целевой функцией, которую необходимо минимизировать при оценке параметров модели ARMA(p,q).
sse_local += errors[t] * errors[t];
Оценка ARMA(p,q) с помощью градиентной оптимизации
После преобразования временного ряда в стационарный процесс его можно моделировать с помощью структуры ARMA(p,q).
Используется следующая функция:
ARMA(int p, int q, const double &Series[], double &sse, double &c, double &AR[], double &MA[])
Эта функция принимает на вход параметры p, q и временной ряд. В качестве результата функция возвращает оцененные коэффициенты модели — компоненты AR и MA, а также свободный член c и SSE.
Для аппроксимации значений параметров модели ARMA используются c, ϕᵢ, и θⱼ, а коэффициенты итеративно обновляются с помощью градиентной оптимизации.
Сначала инициализируются параметры модели ARMA. Коэффициенты компонент AR(p) и MA(q) устанавливаются равными нулю, а свободный член c инициализируется средним значением временного ряда.
Затем вычисляются ошибки модели, чтобы оценить ее качество.
//--- Forward pass: compute predictions and errors
for(int t = 1; t < n; t++)
  {
   double pred = c;

//--- AR part
   for(int i = 0; i < p && t-1-i >= 0; i++)
      pred += AR_local[i] * Series[t-1-i];

//--- MA part
   for(int j = 0; j < q && t-1-j >= 0; j++)
     {
      pred += MA_local[j] * errors[t-1-j];
     }

   errors[t] = Series[t] - pred;
   sse_local += errors[t] * errors[t];
  }
С учетом критериев остановки
//--- Early stopping based on absolute SSE change
if(iter > 1 && fabs(prev_sse - sse_local) < 1e-10)
  {
   sse = sse_local;
   ArrayResize(AR, p);
   ArrayCopy(AR, AR_local);
   ArrayResize(MA, q);
   ArrayCopy(MA, MA_local);
   break;
  }
На каждой итерации вычисляются градиенты по каждому параметру и обновляются коэффициенты, чтобы уменьшить общую ошибку.
Процесс останавливается при достижении максимального числа итераций или когда изменение ошибки между итерациями становится незначительным.
Для константы:
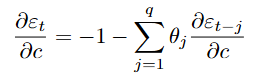
Для авторегрессионных коэффициентов:
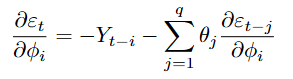
Для коэффициентов скользящего среднего:
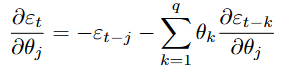
//--- Backpropagation through time (BPTT) to compute gradients
for(int t = 1; t < n; t++)
  {
//--- ∂ε_t/∂c = -1 - Σ(θ_j * ∂ε_{t-j}/∂c)
   dEdc[t] = -1.0;
   for(int j = 0; j < q && t-1-j >= 0; j++)
      dEdc[t] -= MA_local[j] * dEdc[t-1-j];

//--- ∂ε_t/∂AR_local[i]
   for(int i = 0; i < p; i++)
     {
      double der = (t-1-i >= 0) ? -Series[t-1-i] : 0.0;
      for(int j = 0; j < q && t-1-j >= 0; j++)
         der -= MA_local[j] * dEdAR[(t-1-j)*p + i];
      dEdAR[t*p + i] = der;
     }

//--- ∂ε_t/∂MA_local[j]
   for(int j = 0; j < q; j++)
     {
      double der = (t-1-j >= 0) ? -errors[t-1-j] : 0.0;
      for(int k = 0; k < q && t-1-k >= 0; k++)
         der -= MA_local[k] * dEdMA[(t-1-k)*q + j];
      dEdMA[t*q + j] = der;
     }
  }
Затем вычисляются частные производные для каждой части модели.
Для константы:
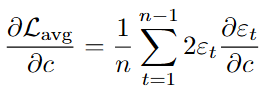
Для авторегрессионных коэффициентов:
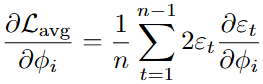
Для коэффициентов скользящего среднего:
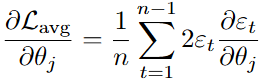
//--- Accumulate gradients of SSE with respect to parameters
double grad_c = 0.0;

for(int t = 1; t < n; t++)
  {
   grad_c += 2.0 * errors[t] * dEdc[t];
   for(int i = 0; i < p; i++)
      grad_AR[i] += 2.0 * errors[t] * dEdAR[t*p + i];
   for(int j = 0; j < q; j++)
      grad_MA[j] += 2.0 * errors[t] * dEdMA[t*q + j];
  }

//--- Average gradients over the series length
grad_c /= n;
for(int i = 0; i < p; i++)
   grad_AR[i] /= n;
for(int j = 0; j < q; j++)
   grad_MA[j] /= n;
ADAM (адаптивная оценка моментов)
После вычисления средних градиентов функции потерь по каждому параметру оптимизатор Adam итеративно обновляет параметры c, ϕᵢ и θⱼ.
Для каждого параметра:
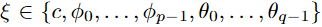
Алгоритм поддерживает две экспоненциальные скользящие средние на основе первого и второго моментов градиентов.
Пусть

обозначает средний градиент по параметруξ на итерации k. Смещенная оценка первого момента

и смещенная оценка второго момента

обновляются рекурсивно следующим образом:
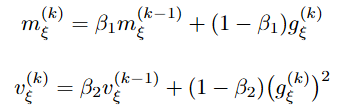
где
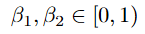
Поскольку эти оценки моментов инициализируются нулем, они смещены к нулю, особенно на ранних итерациях. Чтобы исправить смещение из-за инициализации, вычисляются оценки с поправкой на смещение.
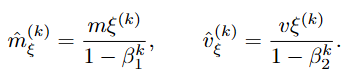
С учетом этих исправленных значений параметр ξ обновляется по правилу Adam.
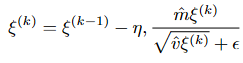
где η > 0 — скорость обучения, а ϵ > 0 — небольшая константа, добавляемая для обеспечения численной стабильности.
В контексте модели ARMA обновления применяются отдельно к каждой группе параметров:
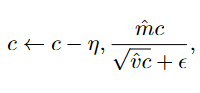
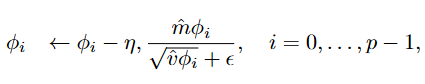
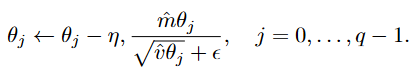
После каждого обновления авторегрессионные коэффициенты и коэффициенты скользящего среднего ограничиваются интервалом [-0,99; 0,99] для повышения численной стабильности и снижения риска нестационарных или необратимых параметров. Это помогает сохранять стабильность оптимизации и делает поведение полученного ARMA-процесса более надежным.
//--- Adam optimizer hyperparameters
double beta1 = 0.9, beta2 = 0.999, eps = 1e-8, eta   = 0.001;

//--- Adam updates for AR coefficients
for(int i = 0; i < p; i++)
  {
   m_AR[i] = beta1 * m_AR[i] + (1-beta1) * grad_AR[i];
   v_AR[i] = beta2 * v_AR[i] + (1-beta2) * grad_AR[i] * grad_AR[i];
   double m_hat = m_AR[i] / (1 - beta1_pow);
   double v_hat = v_AR[i] / (1 - beta2_pow);
   AR_local[i] -= eta * m_hat / (sqrt(v_hat) + eps);

   //--- Clamp AR coefficients to ensure stationarity ([-0.99, 0.99])
   if(AR_local[i] > 0.99)
      AR_local[i] = 0.99;
   if(AR_local[i] < -0.99)
      AR_local[i] = -0.99;
  }

//--- Adam updates for MA coefficients
for(int j = 0; j < q; j++)
  {
   m_MA[j] = beta1 * m_MA[j] + (1-beta1) * grad_MA[j];
   v_MA[j] = beta2 * v_MA[j] + (1-beta2) * grad_MA[j] * grad_MA[j];
   double m_hat = m_MA[j] / (1 - beta1_pow);
   double v_hat = v_MA[j] / (1 - beta2_pow);
   MA_local[j] -= eta * m_hat / (sqrt(v_hat) + eps);

   //--- Clamp MA coefficients to ensure invertibility ([-0.99, 0.99])
   if(MA_local[j] > 0.99)
      MA_local[j] = 0.99;
   if(MA_local[j] < -0.99)
      MA_local[j] = -0.99;
  }
AutoARIMA
Используя процедуру оценки для любой пары (p, q), можно автоматизировать выбор модели. Сначала функция дифференцирует исходный ряд, используя ранее оцененный порядок d. Затем выполняется поиск по сетке среди заранее заданных порядков для компонентов авторегрессии и скользящего среднего, после чего выбирается комбинация с наилучшим значением информационного критерия.
Для каждой пары p и q к дифференцированному ряду выполняется подгонка модели ARMA(p,q) с использованием градиентной процедуры оценки, описанной в предыдущем разделе.
Оценка модели
Для сравнения моделей используется скорректированный информационный критерий Акаике (AICc), который вводит штраф за количество параметров с учетом небольшого размера выборки:
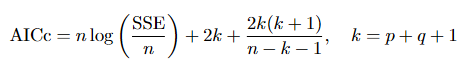
//+------------------------------------------------------------------+
//| AICc: Akaike Information Criterion corrected                     |
//+------------------------------------------------------------------+
double AICc(const double &Series[], double sse, int p, int q)
  {
   int n = ArraySize(Series);
   int k = p + q + 1;   // Total number of parameters (AR + MA + constant)

//--- Avoid division by zero or negative degrees of freedom
   if(n - k - 1 <= 0)
      return DBL_MAX;

//--- If SSE is zero or negative, return a very large value (model invalid)
   if(sse <= 0.0)
      return DBL_MAX;

//--- Estimate residual variance
   double sigma2 = sse / n;
   if(sigma2 < 1e-15)
      return DBL_MAX;

//--- Compute standard AIC and apply finite-sample correction
   double aic  = n * MathLog(sigma2) + 2.0 * k;
   double aicc = aic + (2.0 * k * (k + 1.0)) / (double)(n - k - 1);
   return aicc;
  }
Лучшая модель
После определения критерия качества подогнанной модели автоматизируется выбор оптимальных порядков (p,q) модели ARMA для дифференцированного ряда:
//--- Define the maximum orders to test for AR and MA parts
int max_p = 5;
int max_q = 5;

//--- Variables to store the best model found
int best_p = -1, best_q = -1;
double best_c = 0.0, best_sse = DBL_MAX;
double best_AR[], best_MA[];

//--- AICc values for model comparison
double AICc_ARMA = DBL_MAX, Best_AICc = DBL_MAX;

//--- Array for the differenced (stationary) series
double diff[];

//--- Determine differencing order using a variance heuristic
int d = Calculate_d(Series);

//--- Apply d-order differencing; the result is in chronological order (oldest first)
Difference(d, Series, diff);

//--- Grid search over p and q – choose the model with the lowest AICc
for(int p=0; p<max_p; p++)
  {
   for(int q=0; q<max_q; q++)
     {
      //--- Variables passed by reference to store ARMA results
      double sse = 0.0, dummy_c;
      double dummy_AR[], dummy_MA[];

      //--- Train ARMA(p,q) on the differenced data using Adam optimizer
      ARMA(p, q, diff, sse, dummy_c, dummy_AR, dummy_MA);

      //--- Compute corrected AIC for this model
      AICc_ARMA = AICc(diff, sse, p, q);

      //--- Update best model if current AICc is lower
      if(AICc_ARMA < Best_AICc)
        {
         Best_AICc = AICc_ARMA;
         best_p = p;
         best_q = q;
         best_c = dummy_c;
         best_sse = sse;
         ArrayCopy(best_AR, dummy_AR);
         ArrayCopy(best_MA, dummy_MA);
        }
     }
  }
Прогнозирование
После выбора оптимальной модели ARMA строится прогноз на следующий период. Первым шагом восстанавливается последовательность ошибок для дифференцированного ряда с использованием оптимальных коэффициентов. Выполняется перебор дифференцированных данных с вычислением прогнозного значения на каждом временном шаге:
//--- Recalculate the error series using the best ARMA coefficients
int n_diff = ArraySize(diff);
double errors[];
ArrayResize(errors, n_diff);
ArrayInitialize(errors, 0.0);

for(int t=1; t<n_diff; t++)
  {
   double pred = best_c;

//--- Add AR contribution
   for(int i=0; i<best_p && t-1-i>=0; i++)
      pred += best_AR[i] * diff[t-1-i];

//--- Add MA contribution (using previously computed errors)
   for(int j=0; j<best_q && t-1-j>=0; j++)
      pred += best_MA[j] * errors[t-1-j];
   errors[t] = diff[t] - pred;
  }
Далее вычисляется одношаговый прогноз для дифференцированного ряда. Используя последний доступный индекс, мы прогнозируем следующую разность как сумму свободного члена, вкладов авторегрессионных лагов и слагаемых компоненты скользящего среднего, рассчитанных на основе восстановленных ошибок.
//--- Compute one-step-ahead forecast on the differenced scale
double forecast_diff = best_c;
int last_t = n_diff-1;

for(int i=0; i<best_p; i++)
   if(last_t-i >= 0)
      forecast_diff += best_AR[i] * diff[last_t-i];

for(int j=0; j<best_q; j++)
   if(last_t-j >= 1)
      forecast_diff += best_MA[j] * errors[last_t-j];
Наконец, этот прогноз в разностях восстанавливается до исходного ценового уровня. Преобразование зависит от порядка дифференцирования d.
Затем результат округляется до ближайшего значения, кратного размеру тика.
//+------------------------------------------------------------------+
//| Round2Ticksize: rounds price to valid tick size                  |
//+------------------------------------------------------------------+
double Round2Ticksize(double price)
  {
   double tick_size = SymbolInfoDouble(_Symbol, SYMBOL_TRADE_TICK_SIZE);
   return(round(price / tick_size) * tick_size);
  }
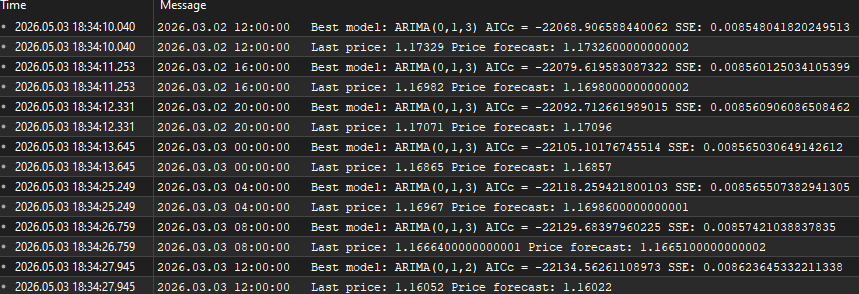
Функция возвращает окончательный прогноз цены и выводит диагностику наилучшей модели.
forecast_price = Round2Ticksize(forecast_price);

Print("Best model: ARIMA(", best_p, ",", d, ",", best_q, ") AICc = ", Best_AICc, " SSE: ", best_sse);
Print("Last price: ", Series[0], " Price forecast: ", forecast_price);
return forecast_price;
Использование AutoARIMA
Функция AutoARIMA() вызывается для ценового ряда и возвращает одношаговый прогноз. Ей требуется минимальная настройка.
Функция ожидает один массив с последними ценами финансового инструмента, упорядоченными от самого нового значения к самому старому.
AutoARIMA(Close)
Затем функция возвращает значение типа double, представляющее прогнозируемую цену на следующий период.
double forecast = AutoARIMA(Close);
Функция в действии
Чтобы продемонстрировать работу реализации AutoARIMA, функция применяется к индексу Nikkei 225 на таймфрейме H4. Входной ряд формируется на основе последних цен закрытия, причем самое последнее значение сохраняется под индексом 0.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- Detect new bar formation
   bool isNewBar = false;
   int CurrBar = iBars(_Symbol, PERIOD_CURRENT);   // total bars on chart now
   static int PrevBar = CurrBar;                   // remember previous count

   if(PrevBar == CurrBar)
      isNewBar = false;                            // no new bar yet
   else
     {
      isNewBar = true;                             // a new bar has appeared
      PrevBar = CurrBar;                           // update the reference count
     }

//--- When a new bar completes, run the ARIMA model
   if(isNewBar)
     {
      int Candles_To_Copy = 5000;                  // lookback size for training

      double Close[];
      ArrayResize(Close, Candles_To_Copy);
      CopyClose(Symbol(), PERIOD_CURRENT, 0, Candles_To_Copy, Close);
      ArraySetAsSeries(Close, true);               // index 0 = most recent price

      double forecast = AutoARIMA(Close);          // forecast for the next bar
     }
  }
Заключение
В статье представлен исполняемый модуль AutoARIMA для MQL5 с четким контрактом: AutoARIMA(Close[]) принимает массив последних цен закрытия, упорядоченных от самых новых к самым старым, и возвращает значение типа double — одношаговый прогноз цены, — одновременно выводя диагностику: лучшая модель — ARIMA(p,d,q), AICc, SSE, последняя цена, прогноз. В этой реализации закреплены основные инженерные решения для практического применения ARIMA в торговой среде: оценка d на основе дисперсии, SSE как целевая функция, вычисление градиентов чувствительности параметров, Adam для стабильных итеративных обновлений и ограничение коэффициентов AR/MA интервалом [-0,99; 0,99] для предотвращения нестационарных или необратимых решений. Выбор модели автоматизируется поиском по сетке по (p,q) со штрафом AICc, а прогноз преобразуется обратно в пространство цен и округляется до тика инструмента.
Ограничения и практические примечания: процедура формирует только одношаговый прогноз; d выбирается эвристически, а не формальным тестом на единичный корень; при поиске по сетке используются ограниченные порядки — например, max p = max q = 5, — чтобы обеспечить приемлемое время выполнения; для надежных результатов требуется достаточная история наблюдений. Используйте AutoARIMA(Close) как встраиваемый прогнозный модуль — фильтр сигналов, целевой уровень или вход для логики принятия решений более высокого уровня. При необходимости более строгих статистических гарантий или прогнозов на нескольких горизонтах рассмотрите расширения: выбор d на основе ADF, более широкую сетку p/q, многошаговое прогнозирование или альтернативные методы оценивания.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22224
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Три фильтра MACD на US_TECH100: Тестирование на данных брокера за пять лет
 Нейросети в трейдинге: Управление риском через распределение результатов (Вычислительная основа)

 Использование Экономического календаря MQL5 для фильтрации новостей (Часть 4): Точное тестирование на истории со статическими данными

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования