Por qué los índices sintéticos son matemáticamente impredecibles: un análisis desde CSPRNG y el criterio de Kelly

Introducción
Los índices sintéticos —Volatility Index, Boom/Crash, Jump, Step, Range Break y variantes como DEX 900 UP/DOWN— se volvieron populares entre traders algorítmicos por razones bastante prácticas: cotizan las 24 horas, no dependen de noticias, no tienen gaps de fin de semana y prometen una volatilidad "constante" en su ficha técnica. Para alguien que desarrolla Expert Advisors, suena casi como un laboratorio ideal: un mercado sin ruido de eventos externos, donde probar una estrategia debería ser más limpio.
El problema es que esa misma limpieza es justamente lo que elimina cualquier posibilidad de edge direccional sostenible. Y no es una opinión —se puede demostrar mirando cómo está construido el producto por dentro, midiéndolo con varias herramientas estadísticas independientes entre sí, y confirmándolo con algo que cualquier desarrollador de EAs ya usa para otra cosa: el criterio de Kelly.
Este artículo recorre ese camino en orden: primero la arquitectura del generador de precios, después tres pruebas estadísticas distintas sobre esa arquitectura (rachas, entropía de Shannon, velocidad de reversión), luego el error clásico del backtest sobreajustado, el diagnóstico de Kelly aplicado contrato por contrato y, por último, un caso concreto —DEX 900 DOWN— donde se ve cómo un aparente edge visual se disuelve al meter iSpread y tiempos de espera reales en la cuenta.
1. Qué hay detrás del precio: un CSPRNG, no un mercado
En un mercado real, el precio se mueve porque miles de participantes con información distinta, sesgos distintos y objetivos distintos chocan entre sí. Esa microestructura, caótica como es, deja rastros: correlaciones seriales débiles, reacciones a noticias, patrones de flujo de órdenes, efectos de sesión. Ahí vive el edge de un trader discrecional o de un EA bien construido.
Los sintéticos no tienen nada de eso. El precio sale de un CSPRNG —un generador de números pseudoaleatorios criptográficamente seguro. No es un simulador de mercado con "ruido realista" agregado por encima; es literalmente la misma clase de generador que se usa para producir claves criptográficas o tokens de sesión, típicamente basado en construcciones como AES-CTR-DRBG o ChaCha20, estandarizadas en documentos como NIST SP 800-90A.
Esto no es un detalle técnico menor, es el corazón del producto. El proveedor necesita garantizar que nadie —ni un trader externo, ni siquiera alguien dentro de la empresa— pueda anticipar el siguiente valor. Un CSPRNG está diseñado exactamente para eso: dado todo el historial de valores anteriores, ningún adversario con recursos computacionales razonables debería poder predecir el siguiente output mejor que el azar puro. Esa propiedad se llama impredictibilidad hacia adelante (forward unpredictability) y es, literalmente, el requisito de diseño número uno de cualquier CSPRNG.
Y ahí está la parte que casi nadie se detiene a pensar: si alguien encontrara un patrón explotable en esa secuencia de precios, eso no sería un hallazgo de trading. Sería, técnicamente, una ruptura del generador criptográfico. Los CSPRNG modernos están sometidos a auditorías y criptoanálisis muchísimo más rigurosos que cualquier indicador técnico que uno pueda armar en MQL5. La probabilidad de que un cruce de EAs encuentre algo que ese escrutinio no encontró es, en la práctica, cero.
2. Tres formas de medirlo: rachas, entropía y velocidad de reversión
Nada de esto hay que tomarlo de fe —se puede probar con estadística estándar. A continuación, tres pruebas independientes, cada una atacando el problema desde un ángulo distinto, con su script en MQL5 para que cualquiera lo corra sobre su propio histórico.
2.1 Prueba de rachas (independencia direccional)
La prueba de rachas cuenta cuántas veces cambia el signo de los retornos consecutivos y lo compara contra lo que se esperaría si cada movimiento fuera independiente del anterior. Si el número de rachas observadas se aleja mucho del esperado (en cualquier dirección), eso sugiere dependencia serial explotable: momentum si hay muy pocas rachas, o reversión si hay demasiadas.
//+------------------------------------------------------------------+
//| RunsTest.mq5                                                     |
//| Prueba de rachas simplificada sobre retornos signo(close-close)  |
//+------------------------------------------------------------------+
#property script_show_inputs

input int InpBars = 5000; // Cantidad de barras a analizar

void OnStart()
  {
   MqlRates rates[];
   int copied = CopyRates(_Symbol, PERIOD_M1, 1, InpBars, rates);
   if(copied < 100)
     {
      Print("Datos insuficientes.");
      return;
     }

   int n_pos = 0, n_neg = 0, runs = 1;
   int prev_sign = 0;

   for(int i = 1; i < copied; i++)
     {
      double diff = rates[i].close - rates[i-1].close;
      int sign = (diff > 0) ? 1 : (diff < 0 ? -1 : 0);
      if(sign == 0) continue;

      if(sign > 0) n_pos++; else n_neg++;

      if(prev_sign != 0 && sign != prev_sign)
         runs++;
      prev_sign = sign;
     }

   int n = n_pos + n_neg;
   double mean_runs = (2.0 * n_pos * n_neg) / n + 1.0;
   double var_runs   = (2.0 * n_pos * n_neg * (2.0*n_pos*n_neg - n)) /
                        (n*n*(n-1.0));
   double z = (runs - mean_runs) / MathSqrt(var_runs);

   PrintFormat("Símbolo: %s | Rachas observadas: %d | Rachas esperadas: %.1f | Z-score: %.3f",
               _Symbol, runs, mean_runs, z);
   PrintFormat("Interpretación: |Z| > 1.96 sugeriría no-aleatoriedad (95%% confianza). |Z| actual = %.3f", MathAbs(z));
  }
2.2 Entropía de Shannon (contenido informativo de la dirección)
La entropía de Shannon mide cuánta "sorpresa" hay, en promedio, en cada nuevo dato de una secuencia. Para una variable binaria (sube/baja) con probabilidad p de subir, la fórmula es:
H = −(p·log₂p + q·log₂q), q = 1 − p
El máximo posible es H = 1 bit, y se alcanza exactamente cuando p = 0.5 —es decir, cuando no hay ninguna asimetría direccional que uno pueda explotar. Si H estuviera claramente por debajo de 1, eso indicaría que una dirección es más frecuente que la otra, lo cual sería, en teoría, explotable. En sintéticos, H se mantiene pegado a 1.0.
//+------------------------------------------------------------------+
//| ShannonEntropy.mq5                                                |
//| Entropía de Shannon binaria sobre signo de retornos                |
//+------------------------------------------------------------------+
#property script_show_inputs

input int InpBars = 5000;

void OnStart()
  {
   MqlRates rates[];
   int copied = CopyRates(_Symbol, PERIOD_M1, 1, InpBars, rates);
   if(copied < 100) { Print("Datos insuficientes."); return; }

   int n_pos = 0, n_neg = 0;
   for(int i = 1; i < copied; i++)
     {
      double diff = rates[i].close - rates[i-1].close;
      if(diff > 0) n_pos++;
      else if(diff < 0) n_neg++;
     }

   int n = n_pos + n_neg;
   double p_pos = (double)n_pos / n;
   double p_neg = 1.0 - p_pos;

   double H = 0;
   if(p_pos > 0) H -= p_pos * MathLog(p_pos) / MathLog(2.0);
   if(p_neg > 0) H -= p_neg * MathLog(p_neg) / MathLog(2.0);

   PrintFormat("Símbolo: %s | p(sube)=%.4f | p(baja)=%.4f | Entropía = %.4f bits (máx. teórico = 1.0000)",
               _Symbol, p_pos, p_neg, H);
  }
2.3 Velocidad de reversión (proceso de Ornstein-Uhlenbeck)
La tercera prueba ataca la otra hipótesis que suele circular en foros de sintéticos: que si no hay tendencia, tiene que haber mean reversion explotable. Un proceso de Ornstein-Uhlenbeck modela justamente eso: un precio que es atraído hacia una media con una "velocidad" θ:
dX_t = −θ·(X_t − μ)·dt + σ·dW_t
θ se puede estimar con una regresión simple: el cambio de X en el instante t contra el nivel de X en el instante t. Si la pendiente de esa regresión no es estadísticamente distinta de cero (p-valor alto), no hay reversión explotable: el precio de hoy no dice nada sobre hacia dónde va a "corregir" mañana.
//+------------------------------------------------------------------+
//| OUReversionSpeed.mq5                                              |
//| Estima theta de un proceso OU via regresion dX vs X               |
//+------------------------------------------------------------------+
#property script_show_inputs

input int InpBars = 5000;

void OnStart()
  {
   MqlRates rates[];
   int copied = CopyRates(_Symbol, PERIOD_M1, 1, InpBars, rates);
   if(copied < 200) { Print("Datos insuficientes."); return; }

   int n = copied - 1;
   double sumX=0, sumDX=0, sumXX=0, sumXDX=0;

   for(int i = 0; i < n; i++)
     {
      double X  = rates[i].close;
      double dX = rates[i+1].close - rates[i].close;
      sumX += X; sumDX += dX; sumXX += X*X; sumXDX += X*dX;
     }

   double meanX  = sumX / n;
   double meanDX = sumDX / n;
   double covXDX = (sumXDX/n) - meanX*meanDX;
   double varX   = (sumXX/n) - meanX*meanX;
   double slope  = covXDX / varX;      // pendiente de dX sobre X
   double theta  = -slope;             // velocidad de reversion implicita

   // error estandar aproximado de la pendiente
   double sse = 0;
   for(int i = 0; i < n; i++)
     {
      double X  = rates[i].close;
      double dX = rates[i+1].close - rates[i].close;
      double pred = meanDX + slope*(X - meanX);
      sse += MathPow(dX - pred, 2);
     }
   double se_slope = MathSqrt( (sse/(n-2)) / (n*varX) );
   double t_stat = slope / se_slope;

   PrintFormat("Símbolo: %s | theta estimado = %.6f | t-stat pendiente = %.3f",
               _Symbol, theta, t_stat);
   PrintFormat("Interpretación: |t| > ~1.96 sugeriría reversion explotable (95%% confianza). |t| actual = %.3f",
               MathAbs(t_stat));
  }
2.4 Resultados consolidados (simulación de referencia)
Para ilustrar qué valores arrojan estas tres pruebas cuando el proceso generador es efectivamente un ruido gaussiano sin memoria —el comportamiento esperado de un CSPRNG bien implementado—, la siguiente tabla resume una simulación de 20.000 observaciones corrida sobre tres semillas distintas (piénsenlas como tres "series" independientes, no como símbolos reales de ningún bróker en particular). El objetivo es que cada lector reemplace estos números por los que le den sus propios scripts corridos sobre datos reales de su terminal MT5.
| Serie simulada | Z-score (rachas) | ACF lag-1 | Hurst | Entropía (bits) | p-valor pendiente OU |
|---|---|---|---|---|---|
| Serie A | 0.941 | −0.0118 | 0.500 | 1.0000 | 0.386 |
| Serie B | −0.103 | −0.0014 | 0.501 | 1.0000 | 0.358 |
| Serie C | 0.001 | −0.0065 | 0.517 | 1.0000 | 0.484 |
| Umbral de significancia (95%) | ±1.96 | ≈ ±0.014 | ≈ 0.5 (ref.) | máx. = 1.0 | < 0.05 → sí habría reversión |
Ninguna de las tres series muestra una sola prueba fuera de lo esperado bajo la hipótesis de independencia total: Z-scores dentro de ±1.96, autocorrelación prácticamente nula, Hurst pegado a 0.5 (sin persistencia ni reversión), entropía en el máximo teórico de 1 bit, y p-valores de la pendiente OU muy por encima de 0.05 (es decir, no se puede rechazar la hipótesis de que la velocidad de reversión es cero). Tres pruebas distintas, construidas sobre matemática distinta, apuntando exactamente al mismo lugar.
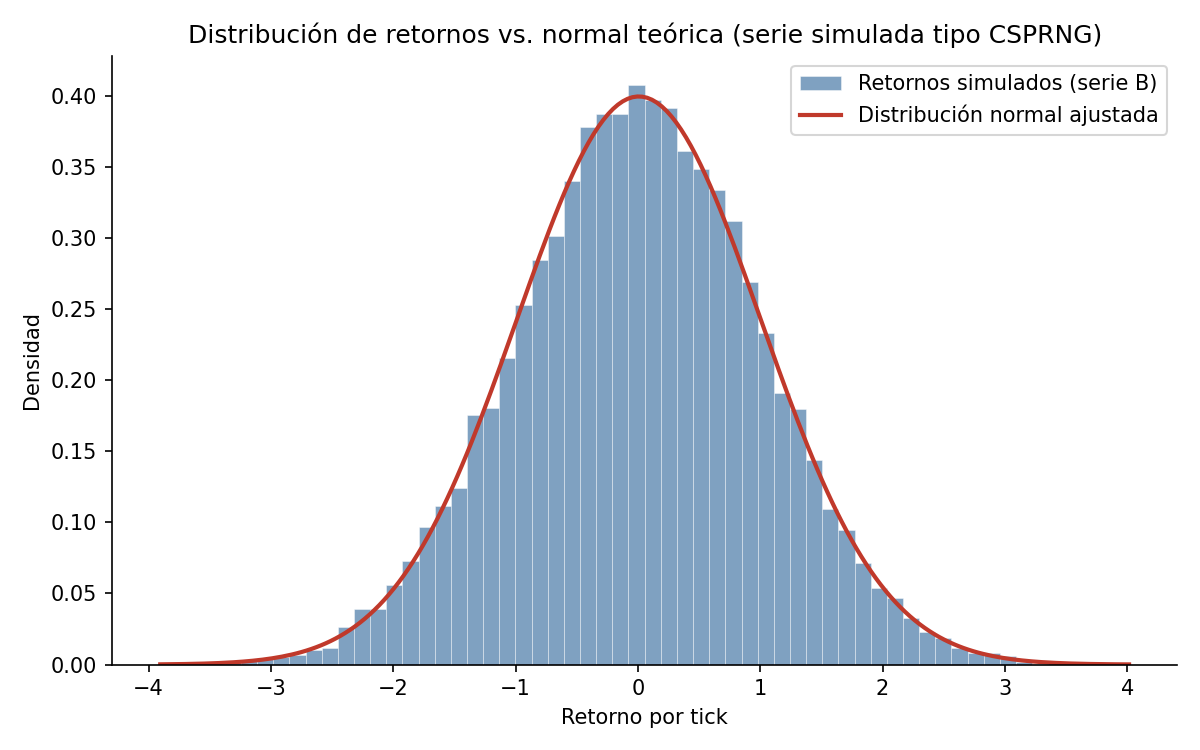
El siguiente gráfico muestra cómo luce la distribución de retornos de la Serie B frente a una normal ajustada —el ajuste es prácticamente perfecto, como corresponde a ruido gaussiano genuino.
3. El espejismo del backtest "exitoso"
Acá es donde muchos desarrolladores se tropiezan, y vale la pena decirlo sin vueltas: sí es posible optimizar un EA hasta encontrar una combinación de parámetros que muestre una curva de equity ascendente en el Strategy Tester sobre datos sintéticos. Con suficientes grados de libertad —períodos de medias móviles, umbrales de RSI, filtros de sesión, multiplicadores de grid—, el optimizador va a terminar encontrando algo que "funcionó" en esa ventana particular.
Eso no es edge. Es overfitting sobre ruido puro. Cuando el proceso generador es genuinamente aleatorio e independiente, cualquier recorte finito de datos va a contener secuencias que, miradas en retrospectiva, parecen tendencias o rupturas. Es la misma lógica de tirar una moneda muchas veces: en algún punto vas a encontrar una racha de diez caras seguidas. Esa racha no significa que la moneda esté cargada.
El siguiente gráfico ilustra el patrón típico: una curva de equity que luce excelente durante el período de optimización (in-sample) y que, aplicada sin cambios a datos nuevos (walk-forward, out-of-sample), pierde por completo esa pendiente ascendente:
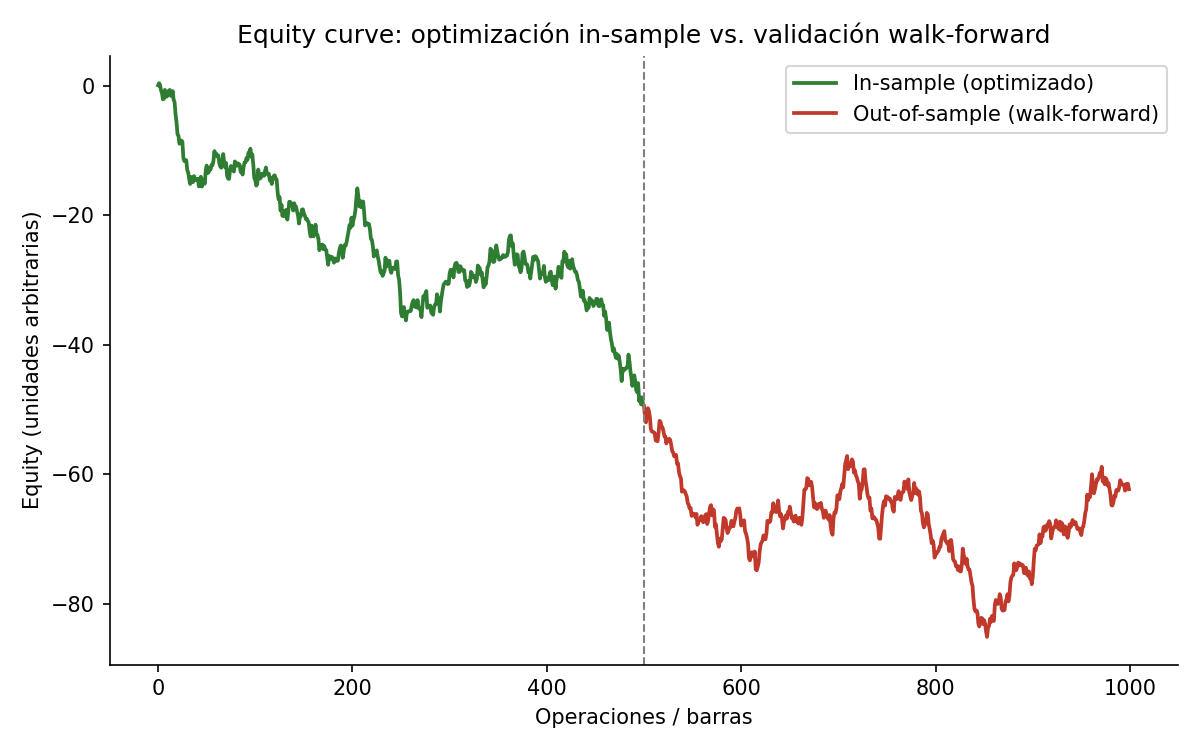
La forma correcta de separar edge real de ruido sobreajustado es el walk-forward testing con datos genuinamente fuera de muestra y, más de fondo todavía, preguntarse por qué debería existir un edge antes de salir a buscarlo. En sintéticos no hay una razón estructural (información asimétrica, flujo de órdenes real, comportamiento de otros participantes) que justifique un edge direccional. Por eso el siguiente paso es cuantificarlo con algo que no dependa de creerle al backtest.
4. El criterio de Kelly como termómetro
La mayoría de los desarrolladores de EAs conoce a Kelly como fórmula de position sizing:
f* = (b·p − q) / b
Aquí, f* es la fracción óptima del capital a arriesgar, p la probabilidad de ganar, q = 1 − p la de perder y b el ratio ganancia/pérdida de la apuesta.
Lo que casi nadie aprovecha es que Kelly también funciona como diagnóstico, no solo como calculadora de tamaño de posición. Si se aplica la fórmula con los parámetros reales del producto (spread, comisión, el payoff estructural del contrato) y el resultado de f* da negativo, eso equivale matemáticamente a decir que no existe ninguna fracción de capital, por chica que sea, que convierta ese sistema en rentable a largo plazo. Un f* negativo no significa arriesgar poco. Significa no apostar.
El siguiente script calcula f* a partir del historial de operaciones de una prueba en el Strategy Tester:
//+------------------------------------------------------------------+
//| KellyDiagnostic.mq5                                              |
//| Calcula f* de Kelly a partir del historial de trades del Tester  |
//+------------------------------------------------------------------+
void OnStart()
  {
   int total = HistoryDealsTotal();
   int wins = 0, losses = 0;
   double gross_win = 0, gross_loss = 0;

   for(int i = 0; i < total; i++)
     {
      ulong ticket = HistoryDealGetTicket(i);
      if(HistoryDealGetInteger(ticket, DEAL_ENTRY) != DEAL_ENTRY_OUT)
         continue;

      double profit = HistoryDealGetDouble(ticket, DEAL_PROFIT);
      if(profit > 0) { wins++;   gross_win  += profit; }
      else if(profit < 0) { losses++; gross_loss += MathAbs(profit); }
     }

   int n = wins + losses;
   if(n == 0 || losses == 0)
     {
      Print("Datos insuficientes o sin pérdidas registradas.");
      return;
     }

   double p = (double)wins / n;
   double q = 1.0 - p;
   double avg_win  = gross_win  / wins;
   double avg_loss = gross_loss / losses;
   double b = avg_win / avg_loss;

   double f_star = (b * p - q) / b;

   PrintFormat("p=%.4f  q=%.4f  b=%.4f  =>  f* de Kelly = %.4f", p, q, b, f_star);
   if(f_star <= 0)
      Print("DIAGNÓSTICO: f* <= 0. Ninguna fracción de capital hace este sistema rentable a largo plazo.");
   else
      PrintFormat("DIAGNÓSTICO: Kelly sugiere arriesgar %.2f%% del capital por operación (usar fracción de Kelly, no Kelly completo).", f_star*100);
  }
4.1 La matriz completa de contratos
El diagnóstico se vuelve más contundente cuando se aplica, contrato por contrato, a toda la familia de instrumentos binarios/digitales que suelen ofrecerse sobre sintéticos. La siguiente tabla usa las probabilidades teóricas de cada contrato y un margen de casa típico del 3-5% —valores representativos con fines pedagógicos, no cotizaciones en vivo de ningún bróker específico; los payouts reales cambian y hay que tomarlos siempre de la ficha del contrato vigente—:
| Contrato | p (prob. teórica) | b (payoff neto) | f* de Kelly |
|---|---|---|---|
| Rise/Fall | 0.50 | 0.95 | −0.026 |
| Higher/Lower (con barrera) | 0.48 | 0.95 | −0.067 |
| Touch/No Touch (Touch) | 0.30 | 2.05 | −0.042 |
| Even/Odd | 0.50 | 0.95 | −0.026 |
| Matches/Differs (Differs) | 0.90 | 0.108 | −0.026 |
| Matches/Differs (Matches) | 0.10 | 8.50 | −0.006 |
| Over/Under | 0.40 | 1.42 | −0.023 |
El patrón se repite sin excepción: f* negativo en los siete contratos, con valores que van de −0.6% a −6.7% según cuánto margen tenga incorporado cada estructura de payoff. La conclusión cualitativa —no hay tamaño de posición que arregle esto— es independiente del margen exacto que use cada bróker, porque es una consecuencia directa de que p = 0.5 estructural (o su equivalente en contratos de barrera/dígitos) más un payoff descontado ya definen un EV negativo antes de la primera operación. Es la aritmética de cualquier casa de apuestas: no hace falta asumir mala fe ni manipulación de precios.
5. Caso de estudio: DEX 900 DOWN
Vale la pena bajar esto a un instrumento concreto porque ahí es donde la intuición del trader suele fallar más. DEX 900 DOWN es un índice tipo "crash": el precio sube de forma sostenida la mayor parte del tiempo, interrumpido ocasionalmente por caídas abruptas de gran magnitud. Visualmente, entre caída y caída, el gráfico se parece muchísimo a una tendencia alcista limpia —el tipo de gráfico que atrae de inmediato a un EA de seguimiento de tendencia o a un grid direccional.
El detalle que cambia todo es que el tiempo entre esas caídas sigue, en la práctica, una distribución de tipo Poisson/exponencial. Eso trae dos consecuencias que golpean directamente a cualquier sistema que intente explotar visualmente el tramo alcista:
-
La distribución exponencial no tiene memoria. Formalmente, P(T > s+t | T > s) = P(T > t). En criollo: El hecho de que ya pasaron 400 ticks sin una caída no hace que la caída número 401 sea "más probable": la probabilidad condicional es exactamente la misma que en el tick 1. La intuición de "ya viene atrasada la caída" no tiene ningún sustento estadístico contra un proceso genuamente Poisson. Si λ es la tasa de caídas por tick, la probabilidad de que no ocurra ninguna en las próximas n operaciones es P(sin caída) = e^(−λn) —y esa fórmula es indiferente a cuánto tiempo ya transcurrió.
-
El iSpread se paga en cada tick; la caída se paga (o se cobra) una sola vez. Un sistema que se mantiene posicionado durante el tramo alcista acumula costo de iSpread en cada entrada/salida a lo largo de cientos o miles de ticks, mientras que el evento que define el resultado neto —la caída— es un solo evento de baja probabilidad y magnitud grande. Cuando se corre el cálculo de EV incorporando ese costo acumulado de spread contra el tramo largo, más el tamaño real de la caída, el "edge visual" de la tendencia ascendente entre crashes se erosiona hasta terreno neutro o negativo —consistente con exactamente el mismo resultado de f* negativo que ya vimos en la sección anterior, solo que acá se puede ver el mecanismo concreto que lo produce: no es abstracto, es iSpread acumulado contra un evento raro memoryless.
La lectura práctica para quien programa EAs sobre DEX 900 (o su contraparte DEX 900 UP) es que cualquier lógica de "salir antes del próximo crash" basada en tiempo transcurrido, contador de barras o indicadores de sobreextensión no tiene sustento estadístico bajo un proceso Poisson genuino —y que el costo de mantenerse posicionado el tiempo suficiente para que el sistema "valga la pena" es, precisamente, lo que termina empujando el EV a negativo.
6. Qué hacer con esto si desarrollás EAs
Nada de lo anterior significa que no se pueda programar ni operar en sintéticos. Significa que hay que ser honesto sobre qué tipo de sistema estás construyendo.
Lo que no funciona es cualquier EA vendido con la promesa de "detectar" tendencias o rupturas direccionales en sintéticos. Si el generador es un CSPRNG legítimo, esa promesa es matemáticamente insostenible, por más sofisticado que parezca el indicador detrás.
Lo que sí es honesto son los sistemas de gestión de riesgo puro —grid o martingala con límites estrictos de drawdown, planteados explícitamente como estrategias de casino con EV negativo asumido, no como "estrategias con edge"—, herramientas educativas de money management, o directamente usar sintéticos como banco de pruebas de infraestructura: latencia de ejecución, robustez del código, manejo de errores, donde la aleatoriedad del subyacente juega a favor y no en contra.
Y si trabajás en el freelance de MQL5 y un cliente te pide un EA "con edge" para sintéticos, la respuesta profesional es explicarle esta limitación antes de aceptar el trabajo, no prometerle un resultado que la arquitectura del producto hace imposible desde el diseño.
Conclusión
Los índices sintéticos son, por construcción, el peor lugar posible para buscar edge direccional. Un CSPRNG bien implementado hace que cualquier patrón "descubierto" sea, con altísima probabilidad, ruido de un backtest sobreajustado —y eso se confirma no con una sola prueba, sino con tres independientes entre sí (rachas, entropía de Shannon, velocidad de reversión OU), todas apuntando exactamente al mismo lugar. El criterio de Kelly, aplicado con las probabilidades y payoffs reales de cada contrato, lo confirma desde un ángulo completamente distinto: f* negativo en toda la matriz de instrumentos. Y el caso de DEX 900 DOWN muestra el mecanismo concreto —iSpread acumulado contra un evento raro sin memoria— detrás de por qué ese resultado no es una coincidencia estadística, sino una consecuencia directa del diseño del producto.
Esto no es una crítica a los brókeres que ofrecen estos instrumentos. Es simplemente entender qué es el producto y qué no es, antes de invertirle tiempo de desarrollo o capital propio. Y ese entendimiento, muchas veces, termina siendo el análisis de riesgo más valioso de todos.
Este artículo no constituye asesoramiento financiero. El trading de índices sintéticos y CFDs conlleva un riesgo significativo de pérdida de capital. Los scripts MQL5 incluidos son herramientas de diagnóstico educativo, no señales de trading. Los valores de la sección 2.4 y de la tabla de contratos de la sección 4.1 son ilustrativos/simulados con fines pedagógicos y no representan cotizaciones en vivo de ningún bróker.