Du « meilleur passage » aux solutions robustes : exploration de la surface d’optimisation dans MetaTrader 5
 33
 0

Introduction
L’optimisation des stratégies de trading fait depuis longtemps partie intégrante du développement des systèmes de trading algorithmique. MetaTrader 5 offre pour cela des outils puissants : un testeur multithread, le calcul distribué et des critères définis par l’utilisateur. Les résultats de l’optimisation peuvent être visualisés sous forme de dépendances à une, deux ou trois dimensions des métriques de performance en fonction des paramètres de l’EA. À première vue, c’est largement suffisant : on lance l’optimisation, on trie les résultats par Facteur de Profit ou par un autre critère de synthèse, puis on sélectionne la meilleure passe. Mais c’est précisément là que commence l’une des illusions les plus répandues du trading algorithmique.
Le problème, c’est que l’optimisation se concentre presque toujours sur la recherche du meilleur résultat d’une passe individuelle. Le testeur montre le sommet de la surface des paramètres : le Facteur de Profit le plus élevé, le meilleur Ratio de Sharpe ou le profit maximal. Mais le marché récompense rarement les systèmes bâtis sur des extrêmes isolés. Au contraire, ces pics s’avèrent souvent n’être qu’une coïncidence fortuite entre les paramètres et la structure locale des données historiques. Il suffit d’une légère modification de la période de l’indicateur, de la valeur du Stop Loss ou du régime de marché pour qu’un résultat impressionnant commence à s’effondrer rapidement.
C’est pourquoi un Facteur de Profit élevé ne garantit rien en soi. Deux stratégies peuvent afficher les mêmes rendements tout en différant fondamentalement en termes de robustesse. La première conserve des résultats acceptables sur toute la plage des paramètres voisins. La seconde n’existe que sous la forme d’une aiguille étroite sur la surface d’optimisation, entourée de configurations chaotiques et non rentables. Formellement, les deux systèmes sont rentables. En pratique, un seul d’entre eux a une chance de survivre sur le marché réel.
Les outils de visualisation intégrés de MetaTrader 5 montrent clairement la dépendance des métriques finales vis-à-vis de chaque paramètre d’optimisation. Le testeur affiche les valeurs des métriques et la distribution des résultats. En revanche, il aide peu à évaluer les configurations voisines : vitesse de dégradation, présence de plateaux stables, sensibilité aux paramètres et limites de la suroptimisation. Autrement dit, le maximum de la fonction devient moins important que la géométrie de l’ensemble de la surface d’optimisation.
C’est là que les frames d’optimisation prennent toute leur valeur. Ce mécanisme permet de stocker et d’analyser des données utilisateur arbitraires après chaque passe d’optimisation. Au lieu de se limiter à quelques indicateurs intégrés, le développeur peut créer sa propre télémétrie de recherche : transmettre des métriques supplémentaires, évaluer la stabilité des configurations voisines, analyser des zones locales de paramètres et construire des critères axés non pas sur une rentabilité extrême, mais sur la stabilité du comportement du système. À ce stade, l’optimisation cesse d’être la recherche d’un joli chiffre pour devenir une véritable recherche.
Dans cet article, nous verrons l’application pratique des frames d’optimisation dans MetaTrader 5, nous apprendrons à enregistrer nos propres métriques et à analyser les résultats, et nous construirons des critères de stabilité personnalisés fondés sur l’ensemble de la surface d’optimisation. L’accent sera mis sur l’identification de zones de paramètres stables, capables de conserver un comportement prévisible même lorsque les conditions de marché changent.
Les frames d’optimisation comme système de télémétrie de recherche
Malgré toutes les possibilités du testeur intégré, l’optimisation standard dans MetaTrader 5 reste par nature une procédure sèche. L’agent effectue les calculs. Le testeur enregistre le résultat. Au final, l’utilisateur voit un ensemble de chiffres déjà calculés : Facteur de Profit, Ratio de Sharpe, drawdown, profit et autres métriques de synthèse. C’est suffisant pour une première sélection. Mais pour une analyse sérieuse, cela ne suffit pas. Le sommet est visible, mais le relief lui-même reste en grande partie invisible.
C’est là qu’interviennent les frames d’optimisation. Il ne s’agit pas simplement d’une autre façon d’enregistrer le résultat d’une passe. C’est un véritable canal de transmission des données de recherche entre les agents de test et le code d’analyse. Grâce aux frames, nous pouvons transmettre tout ce qui aide à comprendre plus finement le comportement de la stratégie : statistiques supplémentaires, paramètres intermédiaires, état du modèle, caractéristiques de la courbe des fonds, évaluation de la stabilité et toute autre métrique personnalisée.
Le fonctionnement de ce mécanisme est assez naturel. À la fin de chaque passe, l’expert transmet les données via FrameAdd() depuis OnTester(). Cela déclenche dans le terminal l’événement TesterPass, qui appelle à son tour OnTesterPass(). Dans ce gestionnaire, on peut analyser immédiatement le frame reçu : lire les données une à une via FrameFirst() et FrameNext(), et filtrer au besoin les entrées souhaitées. En pratique, cela donne l’impression d’un flux de résultats en direct : la passe est terminée, le frame est arrivé, les données peuvent être analysées.
Mais ce flux présente une particularité importante. Les frames peuvent arriver non pas un par un, mais par lots, et parfois avec un retard notable. C’est particulièrement visible lors d’une optimisation distribuée, lorsqu’une partie des calculs est effectuée par des agents distants. C’est pourquoi chaque TesterPass ne peut pas toujours être traité exactement au moment où la passe suivante se termine. C’est pour cette raison que OnTesterDeinit() reste la dernière étape fiable du traitement des résultats. Si certains frames sont arrivés plus tard, ils peuvent être lus une fois l’optimisation terminée, en reparcourant tout le tableau de données depuis le début via FrameFirst() et, si nécessaire, en les triant ou en les filtrant avec FrameFilter().
L’optimisation n’est donc plus une simple série de passes isolées. Elle devient un système d’accumulation de télémétrie de recherche sur l’ensemble de la surface des paramètres. Cela change fondamentalement la logique même du travail. Le développeur voit désormais non seulement la valeur finale du critère, mais aussi le contexte dans lequel elle a été obtenue. En plus du Facteur de Profit, nous pouvons stocker des métriques supplémentaires : concentration du profit, régularité des transactions, stabilité selon les segments de temps et caractéristiques des fonds. On peut aussi enregistrer séparément des indicateurs de dégradation sur les paramètres voisins et la sensibilité au régime de marché.
Chaque passe commence ainsi à ressembler à un véritable dossier de diagnostic. Et plus l’optimisation est longue ou complexe, plus cette approche prend de la valeur. En fait, la vraie valeur des frames d’optimisation réside dans l’analyse a posteriori de l’ensemble de la surface d’optimisation. Au lieu d’analyser des points isolés, il devient possible d’étudier l’espace des paramètres dans son ensemble : rechercher des zones stables, mesurer la vitesse de dégradation des résultats, évaluer la sensibilité d’une stratégie et construire ses propres critères de stabilité à partir des configurations voisines.
Dans cette approche, l’optimisation devient donc l’étude d’une surface multidimensionnelle, où comptent non seulement les valeurs absolues des métriques, mais aussi la forme de leur distribution, la densité des zones stables et le comportement des paramètres voisins. Le gagnant n’est plus celui qui présente le pic isolé le plus élevé, mais celui dont la surface est la plus robuste et la plus fiable.
Une stratégie simple comme objet de recherche
Une fois les frames d’optimisation découverts, une question tout à fait naturelle se pose : que prendre exactement comme objet de cette analyse ? Intuitivement, on a envie de prendre un système de trading complexe : un modèle multicouche, un ensemble de filtres, une cascade d’indicateurs, une gestion adaptative des positions. Mais une stratégie complexe finit par voler la vedette. Au lieu d’explorer l’optimisation, l’article se transforme peu à peu en une discussion sur le système de trading lui-même. Et c’est une tout autre histoire.
Pour notre travail, il faut l’approche inverse. La stratégie doit être aussi simple que possible, presque triviale. Elle doit être si transparente que le lecteur puisse comprendre facilement l’origine de chaque signal et de chaque variation des résultats. La pureté de l’expérience compte ici davantage que la magie de la rentabilité.
Nous prenons donc comme objet de recherche un modèle extrêmement simple, construit autour de deux idées bien connues : le croisement de moyennes mobiles et le mode du RSI. La première partie du système détermine le moment de l’entrée. La seconde filtre l’état du marché. Les signaux eux-mêmes ne sont pas obtenus en interrogeant directement les indicateurs depuis l’EA, mais via un modèle événementiel. Les indicateurs génèrent les signaux de manière autonome et les transmettent via des événements personnalisés.
Cette approche résout plusieurs problèmes à la fois. La stratégie reste extrêmement compacte et lisible. La logique des signaux est bien découpée : les indicateurs se chargent uniquement de générer les événements, et l’EA uniquement de traiter les états et de gérer les positions. Et c’est justement l’architecture événementielle qui convient particulièrement à la démarche de recherche de l’article, car elle permet d’accumuler facilement une télémétrie de diagnostic sur le comportement du système.
Au cœur de la logique se trouve une idée simple. Le croisement des EMA sert de déclencheur d’entrée potentiel.
//--- chek signal
   if(fast_buff[1] > slow_buff[1] &&
      fast_buff[0] <= slow_buff[0])
      SendSignalEvent(EVENT_EMA_CROSS, DIR_BUY, 0.0, "EMA CROSS");
   if(fast_buff[1] < slow_buff[1] &&
      fast_buff[0] >= slow_buff[0])
      SendSignalEvent(EVENT_EMA_CROSS, DIR_SELL, 0.0, "EMA CROSS");
Cependant, le signal de croisement à lui seul n’ouvre pas de position. Le système vérifie d’abord le mode actuel du RSI.
De son côté, le RSI ne génère un événement qu’au moment d’un changement de mode, c’est-à-dire lorsque les niveaux définis sont franchis.
//--- chek signal
   ENUM_SIGNAL_DIRECTION new_regime = current_regime;
   if(rsi_buff[0] <= UpperLevel &&
      rsi_buff[1] > UpperLevel)
      new_regime = DIR_BUY;
   if(rsi_buff[0] >= LowerLevel &&
      rsi_buff[1] < LowerLevel)
      new_regime = DIR_SELL;
   if(rsi_buff[1] >= LowerLevel &&
      rsi_buff[1] <= UpperLevel)
      new_regime = DIR_NONE;
//--- send signal
   if(new_regime != current_regime)
     {
      current_regime = new_regime;
      SendSignalEvent(EVENT_RSI_REGIME, current_regime,
                      rsi_buff[1], "RSI REGIME");
     }
Cela permet de réduire le bruit de manière significative. L’EA mémorise l’état actuel du RSI sous la forme d’une variable booléenne interne et l’utilise comme contexte de marché. Si les signaux concordent, l’événement est considéré comme synchronisé et l’EA ouvre une transaction.
void OnChartEvent(const int32_t id,
                  const long &lparam,
                  const double &dparam,
                  const string &sparam)
  {
//---
   if(id-CHARTEVENT_CUSTOM == EVENT_RSI_REGIME)
     {
      rsi_regime = (ENUM_SIGNAL_DIRECTION)lparam;
      rsi_regime_changes++;
      CloseConflictingPosition();
     }
   if(id-CHARTEVENT_CUSTOM == EVENT_EMA_CROSS)
     {
      ema_events++;
      ProcessEntry((int)lparam);
     }
  }
C’est un point important pour toute l’optimisation qui suit. Nous construisons volontairement un système fondé sur la concordance de sources d’information indépendantes.
La gestion du risque est elle aussi volontairement simple. Le Stop Loss et le Take Profit sont calculés à partir de multiplicateurs de l’ATR à l’ouverture d’une position. La valeur de l’ATR sert uniquement à estimer la volatilité actuelle et n’intervient pas dans le modèle événementiel. Cela permet de garder une architecture aussi propre que possible : les événements déterminent le sens, tandis que l’ATR définit l’échelle du risque.
void ProcessEntry(const int signal)
  {
   if(PositionSelect(_Symbol))
      return;
   if(signal == DIR_BUY &&
      rsi_regime == DIR_BUY)
     {
      if(!atr_buff.CopyIndicatorBuffer(atr_handle, 0, 1, 2))
         return;
      double atr = atr_buff[0];
      double bid = SymbolInfoDouble(_Symbol, SYMBOL_BID);
      synchronized_entries++;
      double sl = NormalizeDouble(bid - atr * iSLmult,
                                  _Digits);
      double tp = NormalizeDouble(bid + atr * iTPmult,
                                  _Digits);
      trade.Buy(iLots, _Symbol, 0, sl, tp);
     }
   if(signal == DIR_SELL &&
      rsi_regime == DIR_SELL)
     {
      if(!atr_buff.CopyIndicatorBuffer(atr_handle, 0, 1, 2))
         return;
      double atr = atr_buff[0];
      double ask = SymbolInfoDouble(_Symbol, SYMBOL_ASK);
      synchronized_entries++;
      double sl = NormalizeDouble(ask + atr * iSLmult,
                                  _Digits);
      double tp = NormalizeDouble(ask - atr * iTPmult,
                                  _Digits);
      trade.Sell(iLots, _Symbol, 0, sl, tp);
     }
  }
D’un point de vue pratique, une telle stratégie est intéressante précisément parce qu’elle est prévisible. Pas de logique complexe, pas de dépendances cachées, pas de filtrage lourd. Toute variation des résultats d’optimisation est presque directement liée à une modification des paramètres du modèle. La surface d’optimisation devient ainsi beaucoup plus lisible et se prête mieux à une analyse exploratoire.
Métriques personnalisées et analyse de niveau supérieur
Le testeur de MetaTrader 5 calcule de nombreuses métriques intégrées : profit, Facteur de Profit, Facteur de Recouvrement, Ratio de Sharpe, drawdown, rendement attendu et autres caractéristiques de la passe. C’est largement suffisant pour évaluer une configuration donnée. Mais ces métriques ne décrivent qu’un seul point de l’espace des paramètres. Elles indiquent dans quelle mesure une passe donnée a réussi. Mais elles ne disent presque rien du comportement de la stratégie au voisinage de ce point.
C’est là que les choses deviennent intéressantes. MetaTrader 5 propose plusieurs modes d’optimisation et trie les résultats selon la meilleure valeur du critère choisi. Le tableau des résultats affiche aussi d’autres métriques de performance, si bien que l’image paraît assez complète. Toutefois, la visualisation ne porte que sur le critère choisi, et uniquement sous la forme de sa dépendance aux paramètres optimisés. Autrement dit, le développeur voit la surface d’une métrique, mais pas sa stabilité au voisinage de la zone trouvée. Or c’est une question fondamentalement différente.
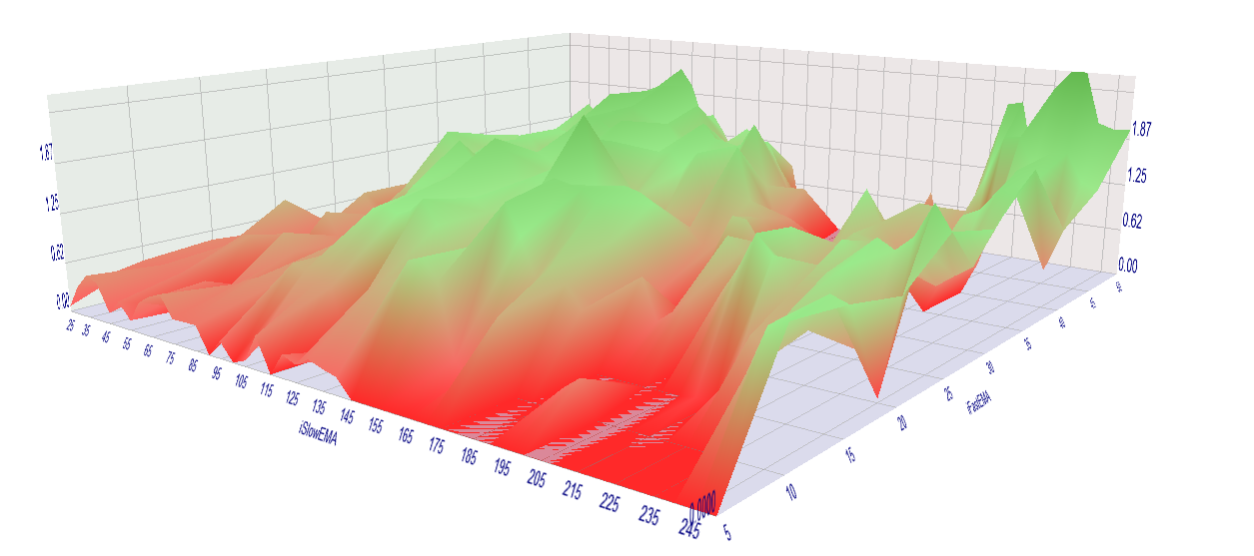
Deux configurations peuvent sembler très proches dans le rapport final, mais se comporter de manière totalement différente. L’une donne un Facteur de Profit élevé, mais elle ne tient que sur un pic étroit qui s’effondre au moindre décalage des paramètres. L’autre affiche un résultat plus modeste, mais conserve des valeurs proches sur une plage plus large. Un testeur standard choisira presque toujours la première configuration comme la meilleure. Mais du point de vue de la recherche, la seconde se révèle souvent plus précieuse, car son comportement paraît stable.
Nous commençons donc à collecter, dès le niveau de chaque passe, non seulement les statistiques intégrées, mais aussi nos propres métriques de diagnostic. FrameAdd permet de transmettre toute télémétrie supplémentaire utile pour comprendre le comportement interne. Dans notre cas, le nombre de croisements des EMA, le nombre de changements de mode du RSI et d’entrées synchronisées, ainsi que le taux de conversion des signaux, le profit par signal et un critère de stabilité personnalisé sont enregistrés avec les données de base. Il s’agit de voir précisément comment le système fonctionne de l’intérieur.
double OnTester()
  {
//---
   double profit_per_signal = 0.0;
   double trigger_conversion_ratio = 0.0;
//---
   double profit = TesterStatistics(STAT_PROFIT);
   double pf = TesterStatistics(STAT_PROFIT_FACTOR);
   if(ema_events > 0)
     {
      trigger_conversion_ratio =
         (double)synchronized_entries / (double)ema_events;
     }
   if(synchronized_entries > 0)
     {
      profit_per_signal =
         profit / synchronized_entries;
     }
   double ret =
      CalculateCustomCriterion(pf,
                               trigger_conversion_ratio,
                               profit_per_signal
                              );
//---
   double telemetry[12];
   telemetry[0]  = profit;
   telemetry[1]  = pf;
   telemetry[2]  = ema_events;
   telemetry[3]  = rsi_regime_changes;
   telemetry[4]  = synchronized_entries;
   telemetry[5]  = trigger_conversion_ratio;
   telemetry[6]  = profit_per_signal;
   telemetry[7]  = ret;
   telemetry[8]  = iFastEMA;
   telemetry[9]  = iSlowEMA;
   telemetry[10] = iSLmult;
   telemetry[11] = iTPmult;
//---
   FrameAdd("Telemetry", 0, ret, telemetry);
//---
   return(ret);
  }
Le taux de conversion des signaux trigger_conversion_ratio est particulièrement utile. Il indique la part des déclenchements des EMA qui aboutissent réellement à une transaction. Si cette valeur est élevée, le signal de base et le filtre de mode se comportent de manière coordonnée. Si elle est faible, le système est soit trop sélectif, soit trop bruité, soit la logique des paramètres elle-même ne fonctionne pas correctement. Dans tous les cas, cette métrique ne parle pas du profit en tant que tel, mais de la qualité de l’interaction entre les composants du modèle.
Une autre métrique est le profit par signal (profit_per_signal). Elle ressemble au profit moyen par transaction, mais ce sont deux valeurs différentes. Dans notre modèle, une transaction n’est ouverte qu’une fois les signaux des EMA et du RSI concordants, mais la position ouverte n’est pas clôturée automatiquement lors du croisement inverse des EMA. De plus, tant que la position reste ouverte, les signaux suivants peuvent tout simplement être ignorés. Le nombre de signaux synchronisés et le nombre de cycles de trading réellement exécutés ne coïncident donc pas toujours exactement. En ce sens, le profit par signal reflète l’efficacité avec laquelle le système monétise les points d’entrée disponibles, en tenant compte des signaux manqués.
C’est ici qu’apparaît le passage au niveau suivant. Lorsque les frames d’optimisation commencent à accumuler de la télémétrie sur l’ensemble de la surface des paramètres, il devient possible d’analyser non plus seulement des passes individuelles, mais leur comportement les unes par rapport aux autres. Et c’est bien plus important qu’une simple liste des meilleurs résultats. Ce qui nous intéresse, ce n’est pas seulement l’emplacement du maximum, mais aussi le comportement des configurations voisines, la vitesse à laquelle le résultat se dégrade lorsque les paramètres changent légèrement et l’existence ou non d’un plateau stable autour du point trouvé.
C’est pourquoi les données exportées via les frames sont enregistrées dans un fichier CSV.
void OnTesterDeinit()
  {
   ArrayResize(frames, 0, 100);
   FrameFirst();
   int pos = 0;
   ulong pass = 0;
   string name = "";
   long id = 0;
   double value = 0;
   double data[];
   SFrameData item;
//---
   while(FrameNext(pass, name, id, value, data))
     {
      if(ArraySize(data) < 12)
         continue;
      item.pass                 = id;
      item.profit               = data[0];
      item.pf                   = data[1];
      item.ema_events           = data[2];
      item.regime_changes       = data[3];
      item.synchronized_entries = data[4];
      item.conversion_ratio     = data[5];
      item.profit_per_signal    = data[6];
      item.custom_criterion     = data[7];
      item.fast_ema             = data[8];
      item.slow_ema             = data[9];
      item.sl_mult              = data[10];
      item.tp_mult              = data[11];
      pos = ArraySize(frames);
      if(ArrayResize(frames, pos + 1, (pos + 49) / 50) < pos + 1)
         return;
      frames[pos] = item;
     }
   ExportCSV();
//---
  }
Ce format est pratique, car il peut ensuite être analysé avec de nombreux outils à la portée du lecteur, du tableur aux logiciels d’analyse spécialisés. Dans notre travail, nous avons utilisé Python à cette fin. MetaTrader 5 offre l’intégration nécessaire avec ce langage. Cela nous permet de mener une étude de la surface des paramètres : lisser les valeurs, évaluer la stabilité locale, examiner la distribution des résultats et comparer les zones voisines.
Pour les tests et l’analyse qui suit, nous avons pris les données historiques de l’EURUSD sur la période H1, du 01/01/2020 au 01/01/2026. Cet intervalle est assez long pour faire apparaître des situations de marché variées : périodes calmes, mouvements impulsifs, tendances prolongées et phases de bruit accru. C’est important non seulement pour obtenir un résultat plausible, mais aussi pour que la surface d’optimisation ne paraisse pas artificiellement lisse.
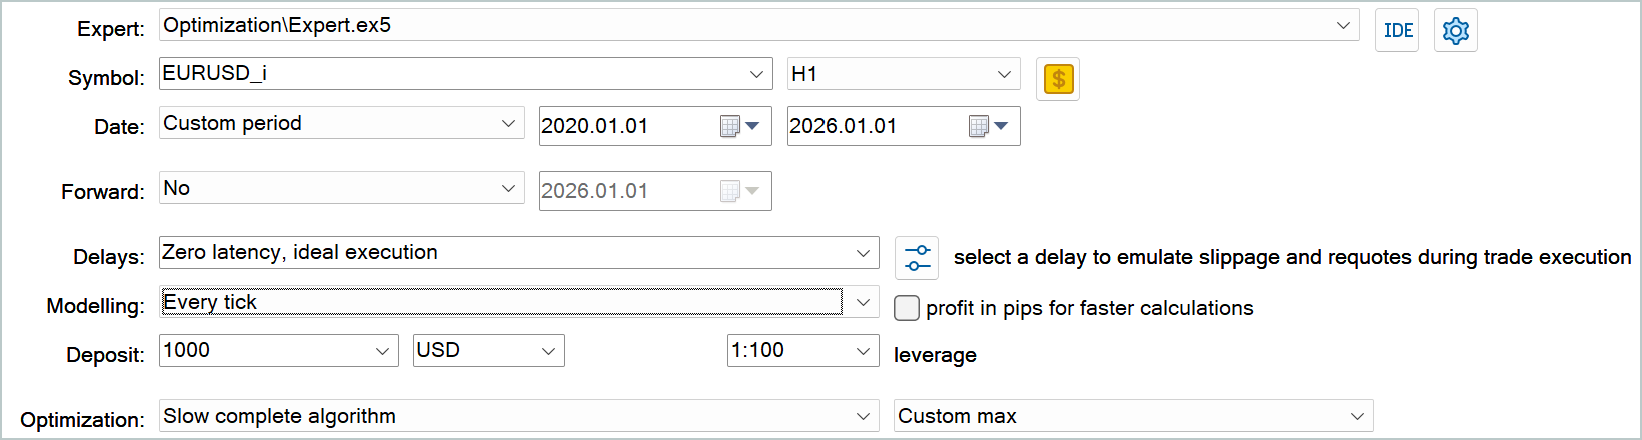
Lors de la première étape, l’EA est optimisé selon quatre paramètres : EMA rapide, EMA lente, multiplicateur du Stop Loss et multiplicateur du Take Profit. Ces quatre paramètres définissent la forme de base de la stratégie et sa réaction au marché. Pour élargir la plage active de génération d’événements et éviter un filtrage trop étroit, les limites du RSI ont été déplacées à 40 et 60. Dans cette configuration, le filtre de mode devient plus sensible et le modèle événementiel moins contraint. L’EA entre ainsi plus souvent dans les états de marché étudiés, ce qui donne une surface d’optimisation plus expressive.
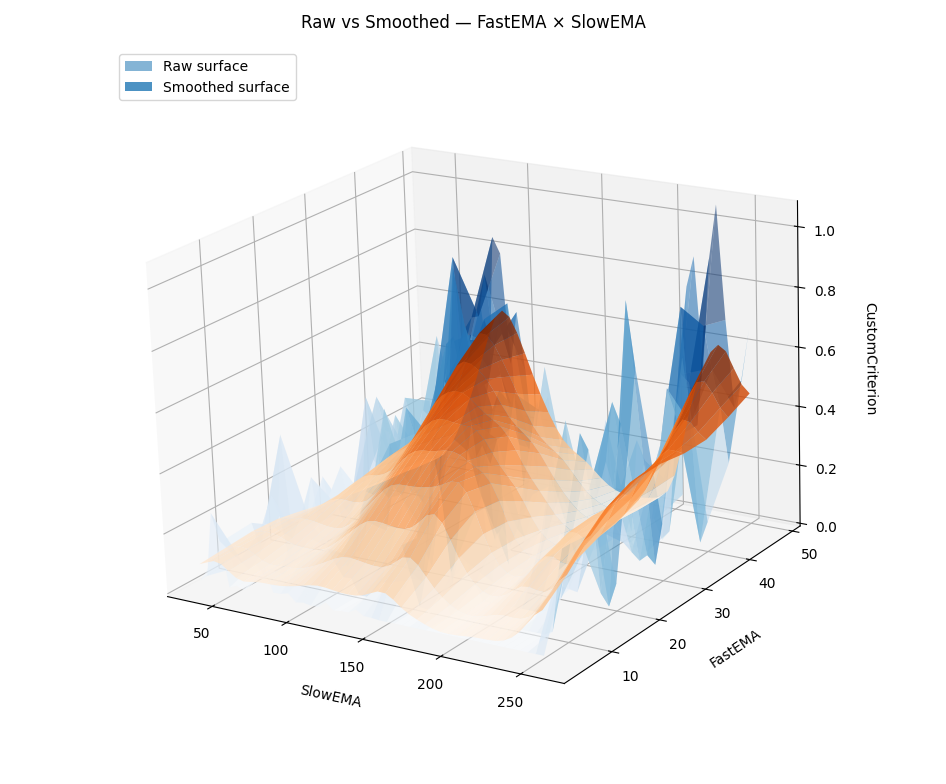
Une fois l’optimisation terminée, les résultats sont enregistrés dans un fichier CSV et traités en Python. Pour chaque paire de paramètres, une surface bidimensionnelle est construite via pivot_table, puis un lissage gaussien lui est appliqué. On obtient ainsi une surface du critère plus calme et plus lisse (la version de recherche), où les pics aléatoires sont nettement moins marqués.
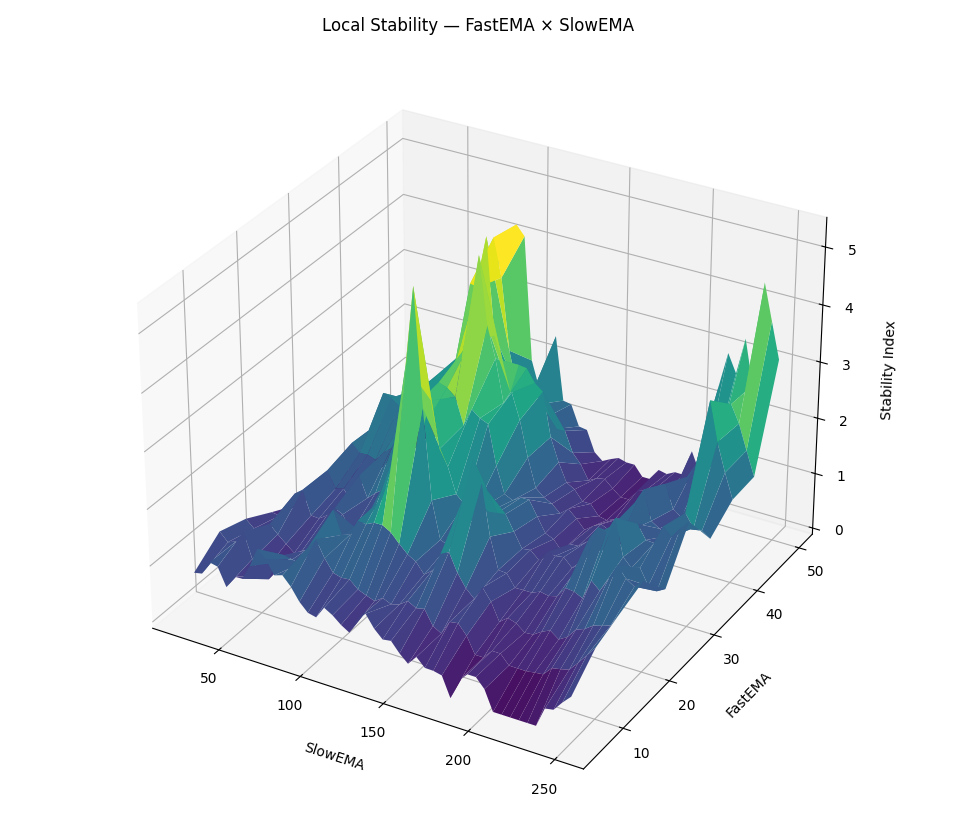
Dans la même fonction, la stabilité locale est calculée comme le rapport entre la valeur moyenne du voisinage et son écart type.
On construit ensuite une carte des gradients, qui montre où la surface varie brusquement et où elle reste relativement plate.
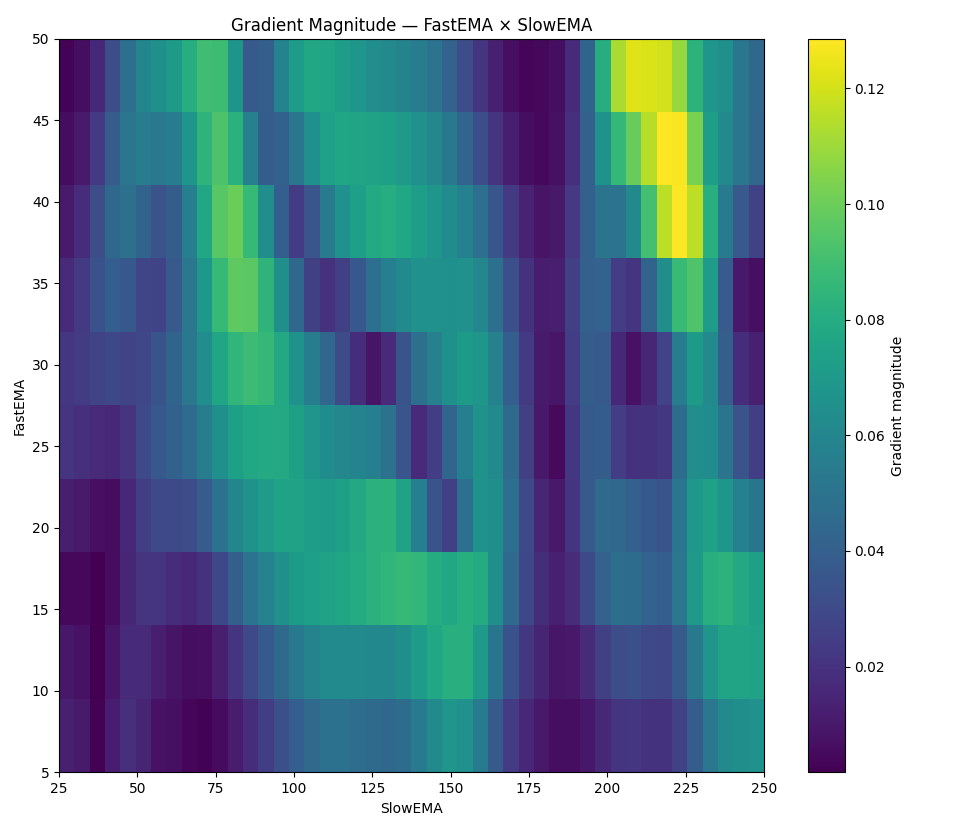
Ces graphiques permettent de voir s’il existe un large plateau dans l’espace des paramètres ou seulement un pic étroit et fragile.
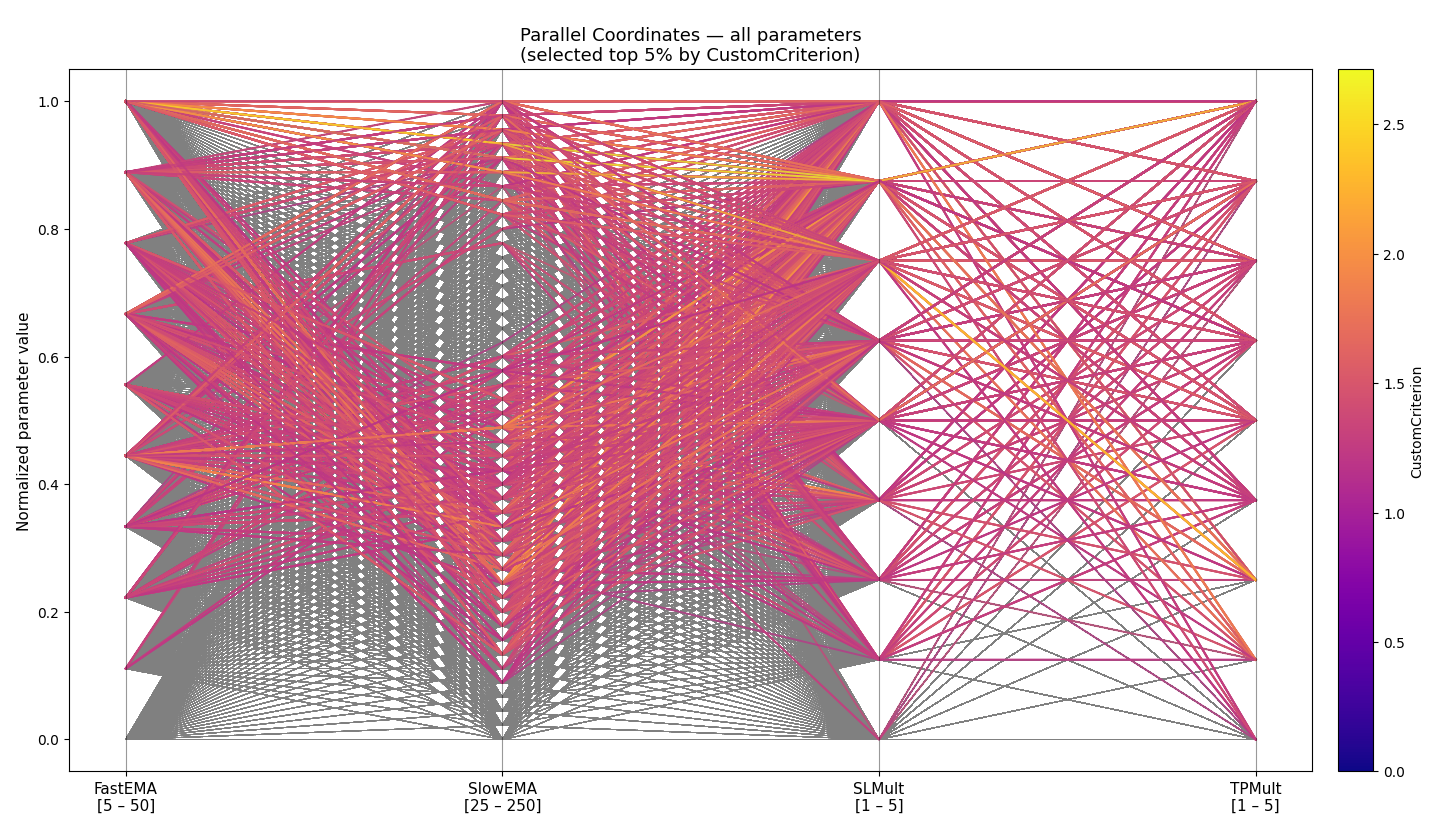
Une couche d’analyse distincte fournit un graphique en coordonnées parallèles de tous les paramètres à la fois. Avant sa construction, les paramètres sont normalisés, et seules les meilleures passes selon le critère choisi sont mises en évidence sur le graphique Parallel Coordinates. C’est pratique lorsqu’on veut voir non seulement un point réussi, mais aussi sa position parmi les autres configurations. Le script affiche les 5 % meilleurs résultats selon le critère, si bien que l’image est immédiatement accompagnée de données chiffrées.
Python intervient donc comme niveau d’analyse suivant. MetaTrader 5 fournit la surface d’optimisation, tandis que Python en retire le bruit, montre la stabilité locale, compare les zones voisines et aide à distinguer une zone de paramètres réellement stable d’un joli pic dû au hasard. L’optimisation n’est plus une affaire de tri des passes individuelles selon un seul chiffre. Elle devient l’étude d’une surface multidimensionnelle, où compte non seulement la valeur du critère, mais aussi le comportement de toute la zone environnante. C’est ce qui permet d’examiner la stratégie plus en profondeur, comme un système dont la stabilité est déterminée par la forme de la surface d’optimisation.
De la recherche d’un maximum à la recherche d’un plateau stable
L’objectif principal de l’optimisation exploratoire n’est pas de maximiser le résultat, mais de trouver des plages de paramètres dans lesquelles la stratégie reste stable, même lorsque la configuration change légèrement.
Cette différence est fondamentale. Un pic unique et élevé sur la surface d’optimisation est presque toujours tentant. Mais en pratique, ces extrêmes s’avèrent souvent dus au bruit du marché, aux particularités d’une période historique donnée ou simplement au surapprentissage du modèle. Ils paraissent convaincants dans le testeur, mais ce n’est pas forcément le cas sur le marché réel.
C’est pourquoi, une fois les résultats chargés dans Python, nous n’examinons pas les passes individuelles, mais toute la surface des paramètres dans son ensemble.
Il est d’abord utile de comparer la surface brute et la surface lissée du critère d’optimisation. La surface initiale paraît bigarrée : on y voit de nombreuses poussées locales, des maxima abrupts et des pics isolés. C’est l’image typique d’une optimisation sur du bruit, où des coïncidences aléatoires se font facilement passer pour des solutions réussies. Après lissage, la plupart de ces valeurs aberrantes disparaissent, et ce sont des structures plus stables, et non plus aléatoires, qui passent au premier plan.
C’est là que l’on voit que tous les beaux pics ne sont pas dignes de confiance. Si, après lissage, la surface se désagrège et perd sa forme, les extrêmes trouvés relevaient plus du hasard que d’une régularité. Dans notre cas, l’image est différente : deux crêtes distinctes subsistent autour de SlowEMA, dans les plages 120–150 et 220–240. C’est déjà un signe sérieux : nous n’avons pas affaire à une poussée ponctuelle, mais à une régularité statistiquement stable. De plus, l’optimum ne ressemble pas ici à une aiguille pointue, mais à un large peigne. Et c’est plutôt bon signe. Les stratégies robustes naissent rarement en un seul point. Le plus souvent, elles se trouvent sur un plateau, où des valeurs voisines donnent des résultats similaires.
Il est ensuite utile d’examiner la carte thermique des gradients. Ce graphique montre à quelle vitesse la fonction objectif varie lorsque les paramètres des EMA sont décalés. On y voit apparaître des zones de sensibilité accrue, principalement pour SlowEMA dans les plages 70–90 et 200–220. Dans ces plages, même une petite modification des réglages peut changer radicalement le résultat. C’est déjà une indication directe d’un risque accru de suroptimisation.
Le gradient lui-même présente un caractère nettement vertical. Cela signifie que SlowEMA influe beaucoup plus sur le résultat que FastEMA. La logique est assez naturelle : la moyenne lente définit le régime de marché, tandis que la moyenne rapide détermine plutôt le point d’entrée et l’ajustement local du comportement du système. À l’inverse, les zones autour de SlowEMA dans les plages 160–190 et 30–50 présentent un faible gradient. Mais il ne faut pas surestimer ce constat : Raw Surface et Smoothed Surface montrent clairement qu’il s’agit plutôt de zones à rentabilité faible ou quasi nulle que de zones réellement productives. Une surface régulière ne rend pas pour autant la stratégie intéressante.
Le graphique Parallel Coordinates, construit pour les 5 % meilleures configurations selon le critère personnalisé, complète le tableau. Et l’essentiel apparaît clairement : les solutions robustes ne convergent pas vers un point magique unique. Elles se répartissent entre plusieurs combinaisons opérationnelles. C’est un signal très important. Un maximum unique et étroit paraît souvent impressionnant, mais il est généralement lié à une suroptimisation. À l’inverse, des groupes répartis indiquent que le système peut fonctionner selon plusieurs modes.
On remarque notamment que les meilleures configurations tendent à présenter des valeurs de FastEMA plus élevées. C’est logique : des valeurs plus lissées réduisent le bruit et rendent les signaux plus nets. Dans le même temps, SlowEMA forme plusieurs groupes, ce qui peut indiquer différents régimes de marché dans lesquels la stratégie fonctionne. Les paramètres SLMult et TPMult sont répartis de manière plus uniforme. Cela suggère que la gestion des positions influe moins sur le résultat final que la structure même des signaux EMA. Autrement dit, le cœur du système réside dans la logique d’entrée, et la gestion des transactions joue un rôle secondaire.
L’étape suivante porte donc logiquement non plus sur toute la grille initiale de paramètres, mais sur la zone qui a montré des signes de fonctionnement stable. Après la première étape, nous restreignons FastEMA, SlowEMA, SLMult et TPMult aux zones où la surface ressemble à un large plateau. Deux paramètres sont ensuite ajoutés au modèle, les limites inférieure et supérieure du RSI, que nous optimisons à ce stade dans le cadre de la structure d’entrée globale. Cela évite de s’attaquer d’un coup à l’ensemble des paramètres et permet de passer de la configuration stable trouvée à un réglage plus fin.
C’est là que le test forward s’avère utile. Dans MetaTrader 5, lors d’une optimisation forward, la période définie pour l’étude est automatiquement divisée en deux parties : la première sert à l’optimisation, la seconde au test forward. De plus, les passes ne sont pas toutes lancées sur la période forward, seulement les meilleures : 10 % des meilleures avec une énumération complète des paramètres, et 25 % avec l’algorithme génétique. Les résultats de l’optimisation et du test forward peuvent ensuite être comparés dans des onglets distincts du testeur. C’est pratique pour vérifier la qualité de l’ajustement. On peut aussi s’en servir pour vérifier si le groupe de paramètres choisi reste stable en dehors de la portion d’historique utilisée pour l’entraînement.
La première étape a déjà montré que la stratégie n’est pas obligée de reposer sur un seul pic aigu. Il s’agit maintenant de vérifier si la zone de paramètres trouvée résiste au passage à un mode de test plus exigeant. Le test forward permet de distinguer une zone de paramètres stable d’une zone qui ne paraît bonne que sur la période passée des données.
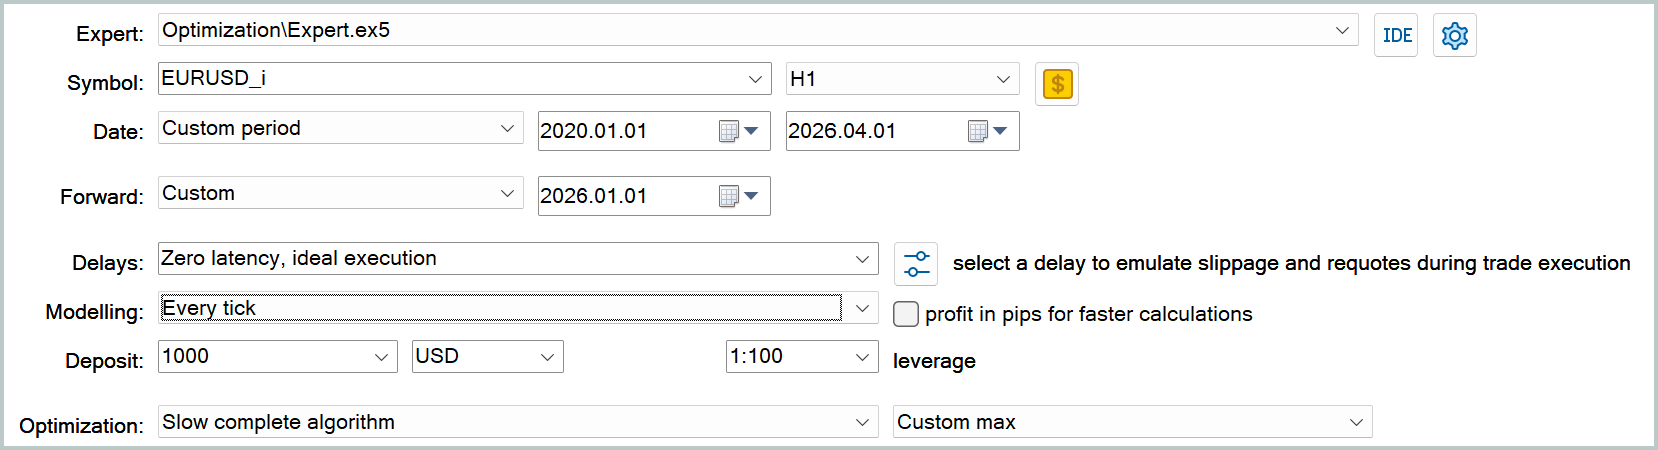
Lors de la deuxième étape, la tâche change. Ce qui nous intéresse désormais, c’est la capacité de la zone de paramètres trouvée à rester stable sur de nouvelles données. C’est pourquoi le test forward devient le prolongement logique de l’analyse d’un plateau stable. Il s’agit de vérifier la viabilité de la configuration trouvée sur une portion de données indépendante. C’est particulièrement important pour notre modèle EMA avec filtre de mode RSI. Ce type de système affiche souvent des résultats très séduisants sur la période d’optimisation, mais perd nettement en qualité dès qu’on sort de l’ensemble d’entraînement. C’est le test forward qui permet de distinguer les solutions réellement stables des paramètres qui coïncident par hasard avec les caractéristiques d’un régime de marché particulier.
Le tableau de l’optimisation forward montre d’emblée que les meilleures valeurs du critère personnalisé en phase forward ne coïncident pas forcément avec les meilleures valeurs de la phase d’optimisation.
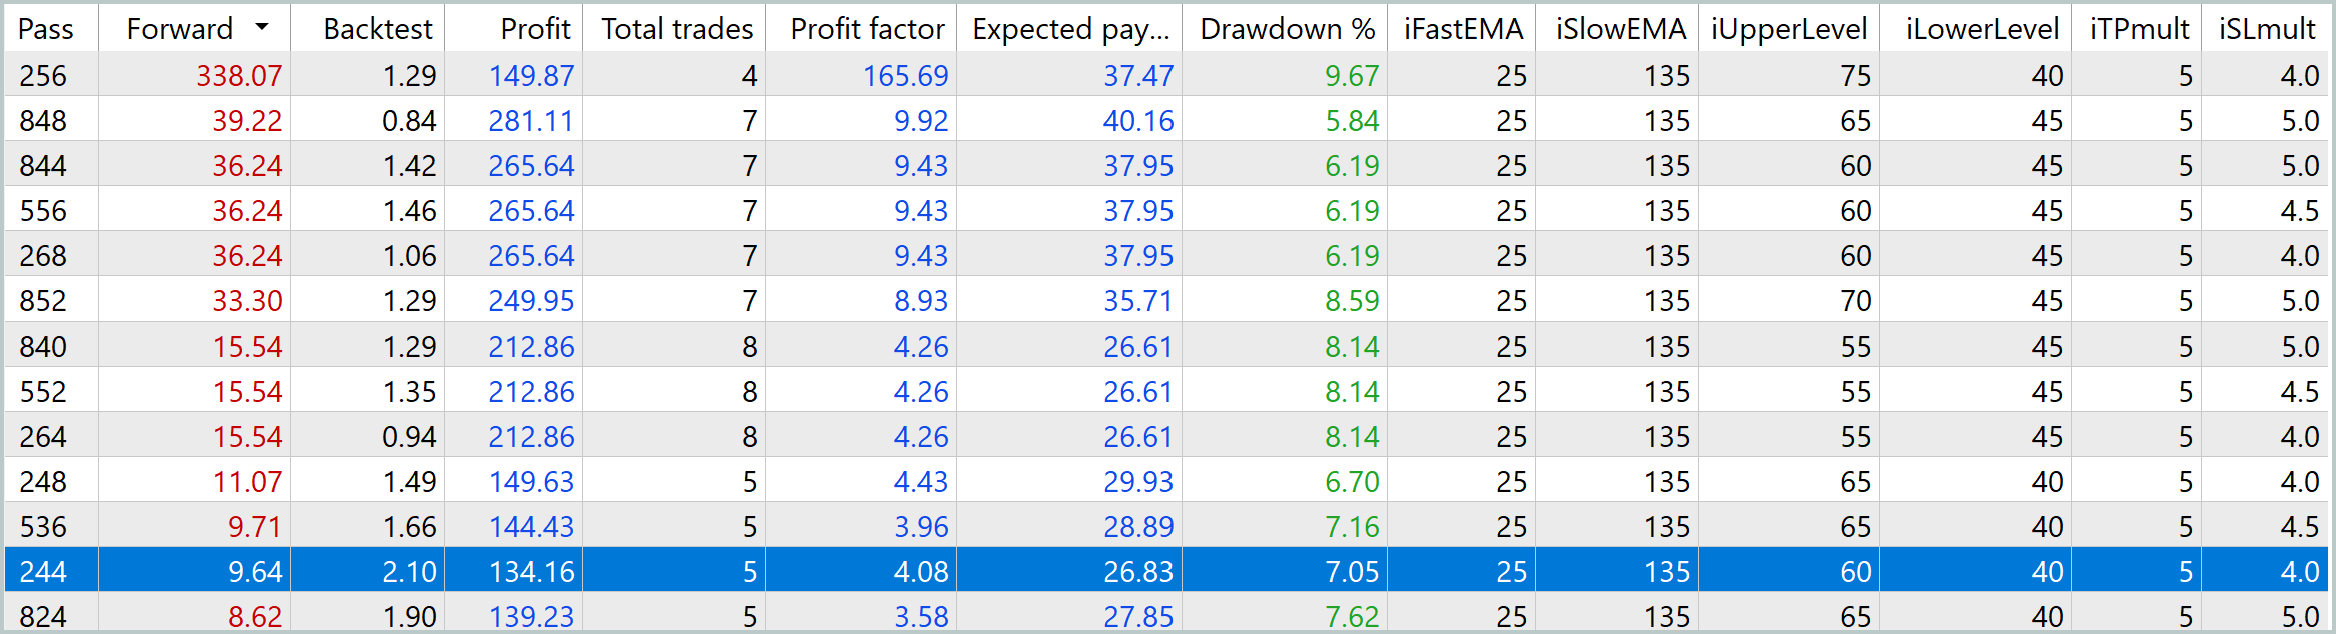
Dans notre cas, en haut du tableau, on trouve des passes avec un critère d’optimisation très élevé, mais un examen plus attentif montre que certaines de ces solutions reposent sur un nombre extrêmement faible de transactions.
Le déséquilibre des niveaux du RSI en haut du tableau est particulièrement révélateur. La limite inférieure se situe autour de 40-45, tandis que la limite supérieure monte dans la plage 75-90. Cela signifie que le modèle commence en fait à intégrer le régime de marché globalement haussier et se décale nettement vers un biais de tendance unilatéral. Une telle configuration peut donner de très bons résultats sur une portion où le marché soutient réellement le mouvement directionnel, mais elle perd facilement une grande partie de son efficacité lorsque la phase change. Autrement dit, le risque de surapprentissage est déjà visible ici : la stratégie est trop bien adaptée aux particularités de la période historique.
Dans ce contexte, la ligne de la passe 244 paraît beaucoup plus intéressante. Elle ne donne pas une valeur extrême du critère, mais elle paraît nettement plus équilibrée, et donc probablement plus robuste. Les paramètres suivants ont été utilisés pour cette configuration :
- iFastEMA = 25,
- iSlowEMA = 135,
- iUpperLevel = 60,
- iLowerLevel = 40,
- iTPmult = 5,
- iSLmult = 4.
Cette combinaison ne cherche plus à tirer le maximum d’une seule portion de marché favorable : elle forme plutôt une structure d’entrées plus régulière et plus mesurée. La stratégie affiche ainsi un profit de 134,16 USD, un Facteur de Profit de 4,08, un Drawdown de 7,05 % et 5 transactions. Sur cette période, c’est un profil tout à fait viable et en même temps prudent.
Les graphiques du solde et des fonds pour cet ensemble de paramètres confirment ce constat.
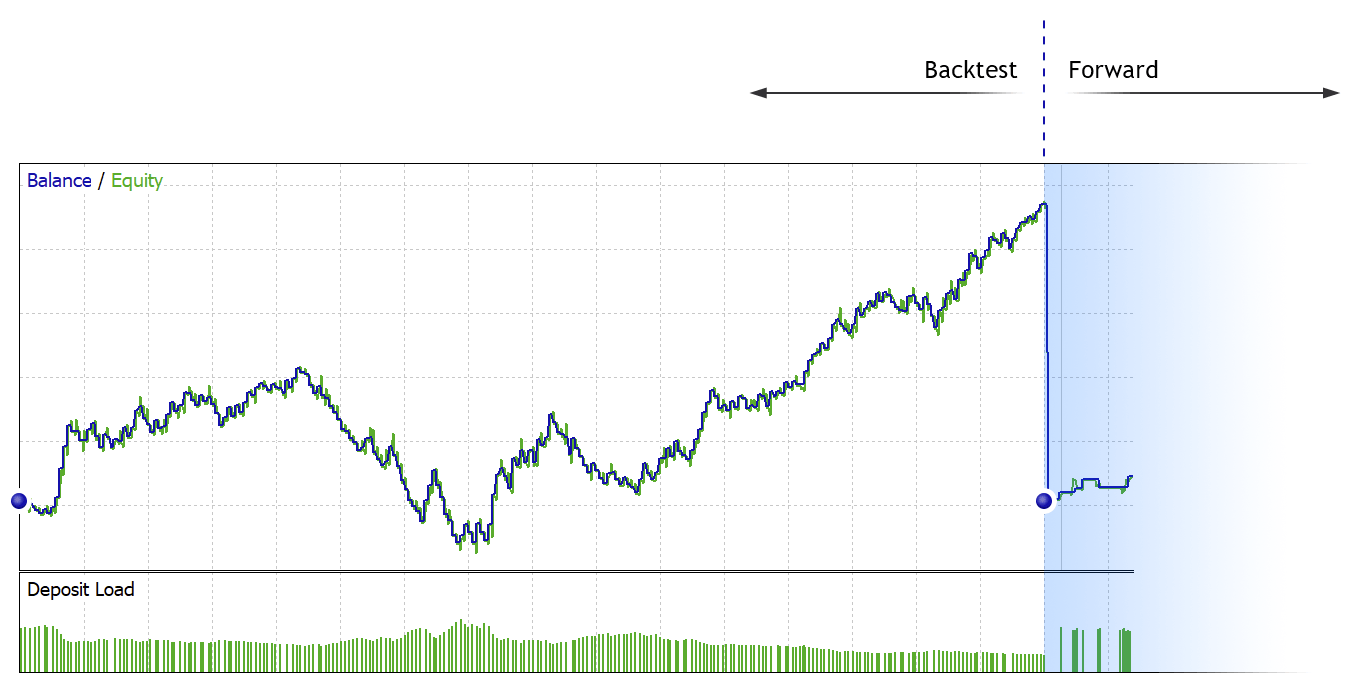
Graphique d’une passe unique sur deux périodes : optimisation et test forward.
Pendant la phase d’optimisation, qui couvrait 72 mois, la stratégie a effectué 259 transactions et affiché un profit de 141,16 %, avec un drawdown maximal du solde de 63,57 % et un Facteur de Profit de 1,25.
Pendant le test forward de 3 mois, 5 transactions ont été effectuées : le profit s’élève à 13,42 %, le drawdown à 3,91 % et le Facteur de Profit à 4,08.
Avec un dépôt initial de 1 000 USD, la stratégie progresse d’abord jusqu’à environ 1 700 USD, puis subit une correction importante et tombe à un minimum local d’environ 620 USD en septembre 2022. Suivent une longue reprise et une phase de hausse soutenue, qui se termine aux alentours de 2 400 USD à la fin de la période d’optimisation. Sur la portion forward, on observe également une tendance à la hausse du solde, ce qui conforte la conclusion sur la viabilité pratique de la configuration choisie.
L’optimisation forward nous a ainsi permis d’écarter les solutions trop agressives et statistiquement fragiles, notamment les configurations avec un PF supérieur à 8 qui, à y regarder de plus près, s’avèrent taillées sur mesure pour la période de test. Dans ce contexte, la passe 244 apparaît comme l’option la plus équilibrée : elle allie une rentabilité acceptable, un drawdown modéré et une stabilité suffisante sur une portion de données indépendante. Ce sont précisément ces solutions qui présentent le plus d’intérêt en optimisation exploratoire, non parce qu’elles produisent le pic le plus spectaculaire, mais parce qu’elles résistent mieux à l’épreuve du temps et aux changements des conditions de marché.
Conclusion
Dans cet article, nous avons volontairement déplacé l’attention de la recherche du profit maximal vers l’étude de la robustesse d’une stratégie de trading. Cette approche change la logique même de l’optimisation. L’attention ne porte pas sur une seule passe réussie, mais sur toute la surface des paramètres : là où la stratégie tient bon, là où elle commence à se déformer et là où elle se réduit à un pic fin et fragile. C’est pourquoi les frames d’optimisation sont particulièrement utiles. Ils permettent d’examiner la structure des résultats, leur comportement dans les configurations voisines et la façon dont la qualité du modèle évolue lorsque les paramètres se décalent légèrement. En ce sens, les frames deviennent un outil de diagnostic d’ingénierie.
D’où la conclusion principale de ce travail :
Une bonne optimisation ne consiste pas à maximiser le profit, mais à comprendre au mieux ce qui a été optimisé exactement.
Et c’est pour cette raison que nous avons choisi pour cet article non pas la stratégie la plus rentable, mais une stratégie extrêmement simple et transparente. Ici, c’est un avantage méthodologique. Il nous fallait un banc d’essai propre, capable de montrer le processus lui-même : de l’optimisation de base et du choix d’un plateau stable jusqu’au test forward et à l’analyse des résultats en dehors de la zone d’entraînement. Ce choix permet de montrer l’essentiel sans complication inutile : les possibilités d’optimisation de MetaTrader 5 se révèlent particulièrement clairement lorsque le développeur cherche une zone stable capable de survivre à un changement de régime de marché.
Programmes utilisés dans l’article
| # | Nom | Type | Description |
|---|---|---|---|
| 1 | Expert.mq5 | Expert Advisor | EA de la stratégie optimisée dans l’article |
| 2 | CrossEMA.mq5 | Indicateur | Indicateur générant des événements lors du croisement des EMA |
| 3 | RSI.mq5 | Indicateur | RSI générant des événements lors du franchissement de niveaux |
| 4 | postanalysis.py | Script | Script d’analyse a posteriori en Python |
| 5 | defines.mqh | Code Base | Bibliothèque de macros de substitution et de méthodes communes |
Traduit du russe par MetaQuotes Ltd.
Article original : https://www.mql5.com/ru/articles/22578
Avertissement: Tous les droits sur ces documents sont réservés par MetaQuotes Ltd. La copie ou la réimpression de ces documents, en tout ou en partie, est interdite.