
Des matrices aux modèles : comment construire un pipeline ML en MQL5 et l’exporter au format ONNX
 28
 2

Introduction
Ce qui rend l’apprentissage automatique (ML) intimidant dans le terminal, ce n’est pas tant le modèle lui-même que tout ce qui l’entoure. On pourrait croire qu’il est impossible de se passer d’une pile technique distincte, de scripts Python et d’une intégration complexe. On finit donc par avoir l’impression que le ML est quelque chose d’extérieur à MetaTrader 5.
Mais une fois les couches superflues retirées, les choses deviennent plus claires. Tout pipeline ML est une suite d’opérations de base : générer des caractéristiques, les mettre à l’échelle, supprimer la redondance et transmettre le résultat au modèle. Il ne s’agit pas de la magie des réseaux neuronaux, mais d’algèbre linéaire ordinaire.
Et voici le point clé. La préparation des données est une tâche MQL5. C’est dans le terminal que les caractéristiques sont construites, que la normalisation est effectuée et, si nécessaire, qu’une ACP (analyse en composantes principales) est appliquée pour réduire la dimensionnalité des données et supprimer le bruit corrélé. Autrement dit, l’intégralité du chemin des données jusqu’au modèle doit être reproduite là où le modèle est utilisé. Sans cela, impossible d’obtenir des résultats concordants.
C’est crucial, car toute tentative de transfert partiel du pipeline en rompt la cohérence. En Python, les données suivent un chemin, et dans le terminal, un autre. La différence est peut-être minime, mais pour le modèle, il s’agit déjà d’un espace différent. Par conséquent, le signal ne disparaît pas : il est simplement déformé.
C’est là que le rôle de Python devient beaucoup plus simple et précis. Il sert à entraîner le modèle et à calculer les paramètres — la normalisation, l’ACP et les poids eux-mêmes. Le modèle est ensuite exporté au format ONNX (Open Neural Network Exchange), un format qui préserve le graphe de calcul et permet de transférer le modèle sans réécrire le code.
Ensuite, tout se joue dans MQL5. Le modèle ONNX effectue les calculs, mais ne contrôle pas ses entrées. Cela signifie que c’est dans le terminal qu’il est nécessaire de reproduire le même chemin de données que celui utilisé lors de l’entraînement.
C’est là que les matrices prennent toute leur importance. Les types intégrés matrix et vector permettent de décrire directement toutes les transformations, telles qu’elles sont définies en mathématiques. Normalisation, projection, préparation des entrées : tout cela s’effectue comme une suite d’opérations linéaires, sans distorsion intermédiaire. Le code n’interprète pas les équations : il les reproduit.
C’est à ce moment précis que disparaît le sentiment de complexité. Le ML cesse de ressembler à un ensemble hétérogène de technologies pour devenir une suite d’étapes claires, entièrement maîtrisées au sein du terminal.
Dans cet article, nous suivrons ce chemin étape par étape, sans théorie superflue, en nous appuyant sur les matrices et les vecteurs comme outil principal. L’accent est mis sur l’objectif principal : comment obtenir des résultats reproductibles aussi bien à l’entraînement que dans un environnement de trading réel.
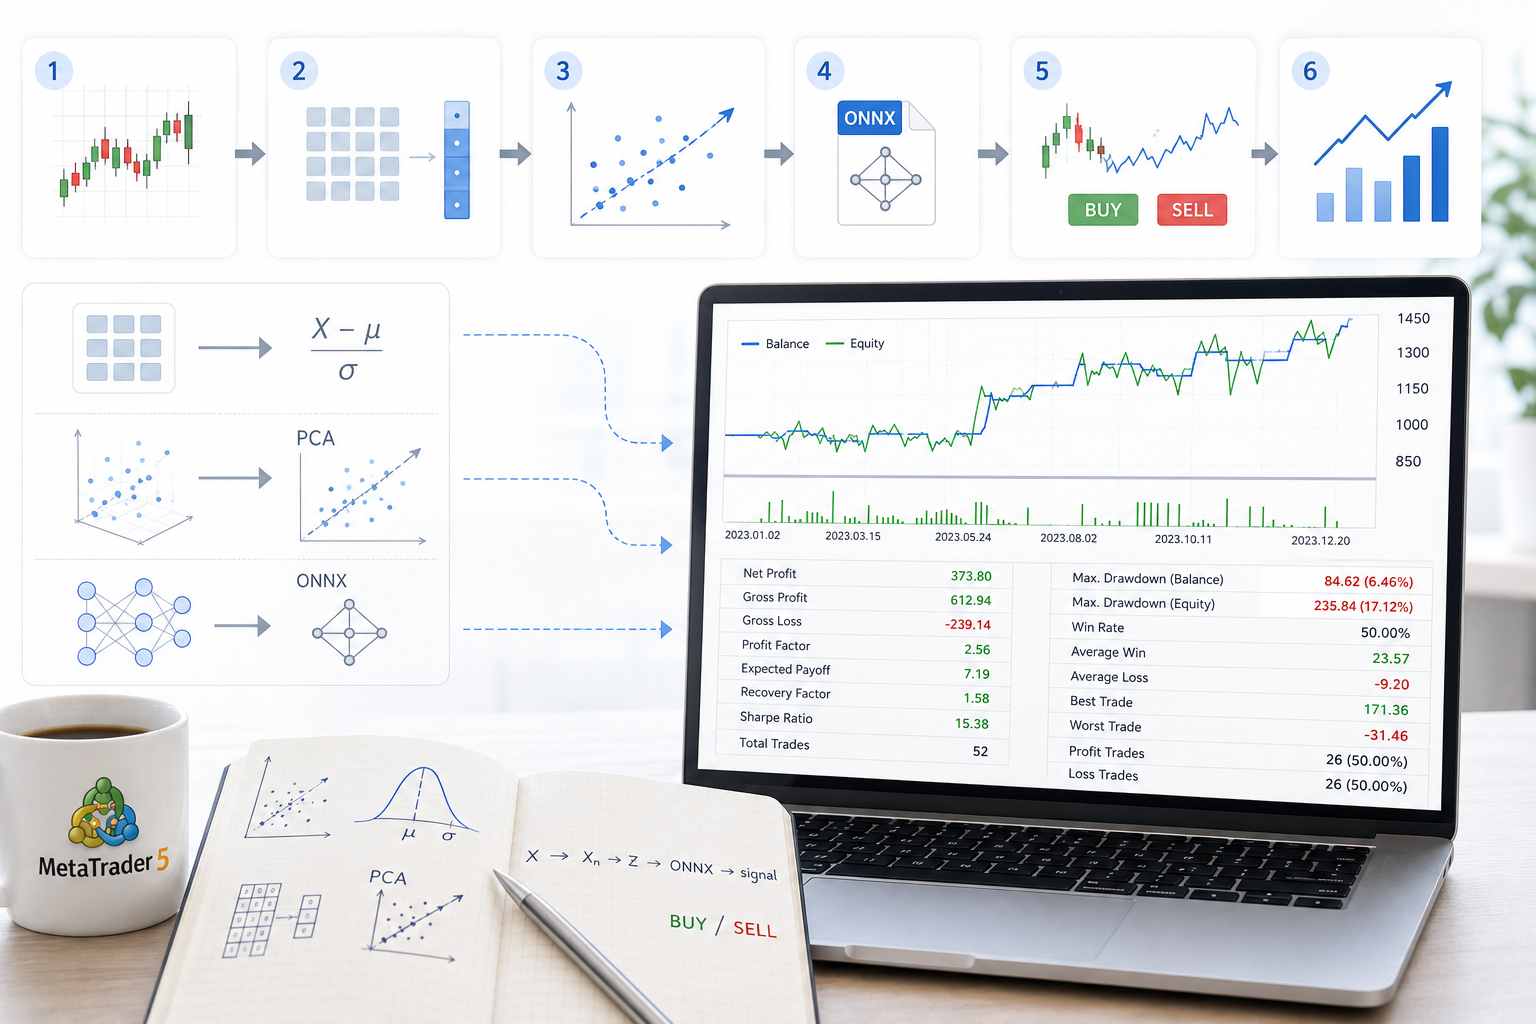
Les matrices comme base du pipeline : des caractéristiques à l’espace des données
Les données de marché constituent un flux continu de prix. Mais le modèle lui-même ne travaille pas directement sur ce flux. Il lui faut un ensemble de caractéristiques préparées à l’avance : rendements, amplitudes, écarts, décalages. Et une question pratique se pose immédiatement : faut-il conserver chaque caractéristique séparément ou les regrouper dans une structure unique ? En pratique, la seconde voie s’avère beaucoup plus stable.
C’est pourquoi il est pratique de regrouper les caractéristiques dans une matrice X, dont les lignes correspondent aux observations et les colonnes aux caractéristiques. À partir de ce moment, les données cessent d’être un ensemble dispersé de valeurs individuelles. Les données deviennent un objet unique pour un traitement séquentiel. Les opérations matricielles intégrées à MQL5 permettent d’effectuer des transformations sur l’ensemble de l’espace de données en une seule fois, plutôt que sur des valeurs individuelles. Cela modifie non seulement le code, mais aussi la logique de traitement.
Ceci est particulièrement important pour la normalisation. Les caractéristiques de marché existent presque toujours à des échelles différentes : prix, amplitude, rendements, écart, volume. Si elles ne sont pas ramenées à une forme comparable, le modèle réagira à l’ordre de grandeur des nombres, et non à la structure du signal. La normalisation est donc une étape obligatoire de la préparation des données. Et il est plus pratique de s’en charger côté MQL5. Ici, les types intégrés matrix et vector permettent d’obtenir directement les séries de marché, puis d’appliquer des opérations statistiques comme Mean et Std directement à la matrice préparée.
   matrix<double> vRates;
   if(!vRates.CopyRates(cSymbol.Name(), PERIOD_CURRENT, COPY_RATES_OHLC | COPY_RATES_VERTICAL, 1, HistoryBars))
     {
      PrintFormat("Error of load rates %d", GetLastError());
      return;
     }
   matrix<double> means=matrix<double>::Zeros(vRates.Rows(),vRates.Cols());
   matrix<double> STDs=matrix<double>::Zeros(vRates.Rows(),vRates.Cols());
   means.Row(vRates.Mean(0),0);
   STDs.Row(vRates.Std(0)+DBL_EPSILON,0);
   means=means.CumSum(0);
   STDs=STDs.CumSum(0);
   vRates=(vRates-means)/STDs;
À première vue, il peut sembler plus simple de cacher la normalisation à l’intérieur du modèle ONNX. Mais cette solution a ses limites. En MQL5, ONNX est conçu principalement comme une couche d’exécution. Le modèle est chargé via OnnxCreate. Ses formes d’entrée et de sortie sont ensuite définies. Enfin, il est exécuté via OnnxRun. C’est idéal pour l’inférence, mais cela n’offre pas la même commodité ni la même transparence pour gérer l’espace d’entrée. Lorsque la normalisation est définie en MQL5, il est plus facile de la tester, de la reproduire, de la modifier et de la comparer aux données de marché réelles, directement dans le testeur ou sur le graphique.
Il y a un autre point important. Lorsque l’on modifie le symbole ou la période, la distribution des données change. Si la normalisation est intégrée au graphe ONNX, le modèle se retrouve rigidement lié à l’ancienne distribution des entrées. Dès lors, tout changement significatif de l’environnement exige non pas de simples ajustements ciblés, mais un réentraînement complet et une nouvelle exportation. Si la normalisation est définie en MQL5, il suffit de mettre à jour ses paramètres et d’alimenter le modèle avec des données à l’échelle requise. Cela préserve la structure des entrées et évite de reconstruire entièrement le modèle.
C’est pourquoi la couche matricielle externe du terminal offre plus de flexibilité que de vouloir tout enfermer dans ONNX. En Python, le modèle est entraîné une seule fois. En MQL5, les données sont transformées de manière cohérente à chaque fois. C’est là la force de cette architecture : le modèle reste un modèle, et les matrices et vecteurs du terminal se chargent de préparer et de contrôler l’entrée.
Compression et stabilisation : l’ACP comme prolongement de la logique matricielle
Les indicateurs de marché ne sont presque jamais indépendants. Prix, rendements, amplitude, écarts : ce sont autant de projections différentes d’un même mouvement. Il en résulte une redondance dans les données : plusieurs caractéristiques décrivent le même comportement du marché, mais sous des angles différents. Pour le modèle, il ne s’agit pas d’une amplification du signal, mais d’une source de bruit et d’instabilité.
C’est là que l’ACP (analyse en composantes principales) devient le prolongement naturel de l’approche matricielle. L’idée est simple : au lieu de fournir tout en même temps au modèle, il s’agit de condenser l’information dans des composantes plus compactes qui capturent l’essentiel de la variance des données.
D’un point de vue mathématique, rien de nouveau n’apparaît. C’est toujours de l’algèbre linéaire. La matrice X des caractéristiques est centrée et multipliée par la matrice des vecteurs propres. On obtient un nouvel espace dans lequel les caractéristiques représentent des composantes indépendantes des variations du marché.
Et le point important ici n’est pas l’équation, mais l’effet. L’ACP résout deux problèmes à la fois. D’une part, elle compresse l’espace des caractéristiques en supprimant les dimensions inutiles. D’autre part, elle stabilise les données, car le bruit et les corrélations ne dispersent plus le signal entre plusieurs variables. Le modèle travaille désormais sur une structure de données plus propre.
Le résultat concret se fait sentir immédiatement. L’entraînement devient plus robuste, le comportement du modèle devient plus prévisible et la sensibilité aux fluctuations faibles et aléatoires diminue. De plus, le code ne se complique pas du tout. La seule différence est une opération matricielle supplémentaire sur la matrice X déjà préparée.
Et il est important ici de conserver la même logique architecturale qu’auparavant. L’ACP n’est pas implémentée sous forme de calculs et de boucles séparés. Elle fait partie d’un même circuit matriciel en MQL5.
Résultat : les données ne sont pas seulement ramenées à une même échelle, elles sont aussi simplifiées sur le plan structurel. Elles perdent leur redondance, mais conservent leur noyau d’information. C’est là l’effet clé de l’ACP dans le contexte du trading : le modèle perd en bruit et gagne en pertinence.
C’est ainsi que se forme le niveau suivant du pipeline. Après normalisation des données, nous organisons leur structure. Et plus cet espace est propre, plus le comportement du modèle est stable.
Modèle et ONNX : de l’entraînement à l’exécution
Une fois l’espace de données nettoyé et stabilisé, la logique du pipeline passe naturellement à l’étape suivante : le modèle lui-même. Mais il faut poser d’emblée le principe : ici, le modèle n’est pas le centre du système, mais son aboutissement.
L’entraînement se déroule en dehors du terminal, en Python. Ce n’est pas un choix arbitraire, mais une question de commodité et d’écosystème. L’entraînement du modèle se compose de deux étapes clairement distinctes, et c’est ce qui détermine la stabilité de l’ensemble du système.
Lors de la première étape, l’ensemble d’entraînement est utilisé dans son intégralité. À ce stade, on ne construit pas encore le modèle lui-même, mais son système de coordonnées. Les paramètres de normalisation sont calculés : valeurs moyennes et écarts types pour chaque caractéristique. L’ACP est calculée en parallèle. Elle définit une transformation de l’espace des caractéristiques d’origine en une représentation plus compacte et ordonnée.
# Standardize features and apply PCA to retain 99% variance
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
pca = PCA(n_components=NComponents, random_state=42)
X_pca = pca.fit_transform(X_scaled)
L’étape de préparation des données est cruciale. En substance, c’est ici que l’on fixe l’espace dans lequel le modèle va travailler. Tout écart à ce niveau se répercute automatiquement sur la suite. C’est donc elle qui détermine toute la stabilité ultérieure du système.
Une fois l’espace des données fixé, on passe à la deuxième étape. Le modèle est alors assemblé comme un mécanisme bien précis. À ce stade, les caractéristiques ont été normalisées et sont passées par l’ACP, de sorte que le réseau reçoit une représentation du marché cohérente et dense. C’est un point important : Le réseau LSTM n’a pas à démêler le chaos des valeurs d’origine. Il travaille directement dans l’espace préparé pour lui.
Tout d’abord, les données sont converties dans un format adapté à PyTorch.
# --- LSTM training block with PyTorch ---
# Prepare data for LSTM: form rolling sequence windows
X_np = X_pca.astype(np.float32)
y_np = y.to_numpy(dtype=float)
n_sequences = X_np.shape[0]
if n_sequences <= 0:
    print("Not enough samples for sequence windows; reduce window_size or collect more data.")
    quit()

X_tensor = torch.tensor(X_np, dtype=torch.float32).unsqueeze(1)  # (n_samples, 1, n_features)
y_tensor = torch.tensor(y_np.reshape(-1, 1), dtype=torch.float32)
Rien d’intelligent ne se produit à ce stade, mais c’est ici que se joue la précision technique de tout le travail ultérieur. Le tableau est converti en tenseur et une dimension supplémentaire lui est ajoutée. C’est un petit détail, mais pour le LSTM, il est fondamental : le réseau n’attend pas seulement un ensemble de caractéristiques, mais une séquence. Même si la longueur de la séquence est de un, la forme de l’entrée correspond bien à l’architecture d’un réseau récurrent.
Les données sont ensuite divisées en un jeu d’entraînement et un jeu de validation. Une étape en apparence anodine joue ici un rôle important : le modèle ne se contente pas de mémoriser l’historique, il peut aussi se tester sur une partie des données mise de côté. C’est ce qui permet de déterminer si le modèle apprend un motif ou s’il ne fait que répéter le bruit.
# Train/validation split
split = int(Train_test_split * len(X_tensor))
train_ds = TensorDataset(X_tensor[:split], y_tensor[:split])
val_ds = TensorDataset(X_tensor[split:], y_tensor[split:])
train_loader = DataLoader(train_ds, batch_size=Batch_size, shuffle=False)
val_loader = DataLoader(val_ds, batch_size=Batch_size, shuffle=False)
Les données sont ensuite transmises à DataLoader. Et c’est là que le processus trouve son rythme de travail. Au lieu de fournir les exemples au réseau un par un, nous les lui fournissons par lots. Cela rend l’entraînement plus stable et nettement plus facile à optimiser.
Vient ensuite la construction du modèle lui-même. L’important ici est de ne pas le surcharger de complexité inutile. Dans le code, il s’agit d’une architecture soignée et compacte : quelques couches récurrentes, un état caché de taille fixe, un Dropout pour limiter le surapprentissage et une couche linéaire finale qui convertit l’état interne du réseau en une valeur de prédiction unique.
class LSTMRegressor(nn.Module):
    def __init__(self, input_size, hidden_size=64, num_layers=3, dropout=0.1):
        super().__init__()
        self.lstm = nn.LSTM(input_size=input_size,
                            hidden_size=hidden_size,
                            num_layers=num_layers,
                            batch_first=True,
                            dropout=dropout)
        self.fc = nn.Linear(hidden_size, 1)

    def forward(self, x):
        # x: (batch, seq_len, input_size)
        out, (hn, cn) = self.lstm(x)
        last_h = hn[-1]
        return self.fc(last_h)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"Using device: {device}")

model = LSTMRegressor(input_size=X_np.shape[1], hidden_size=64, num_layers=Layers, dropout=0.2).to(device)
La logique est simple, mais très expressive : le réseau extrait d’abord l’information pertinente, puis produit une réponse.
Le modèle est transféré sur le périphérique disponible. Si un GPU est disponible, les calculs y sont effectués. Sinon, tout fonctionne sur le CPU. Pour les données financières, ce n’est pas un luxe, mais une pratique d’ingénierie normale : les calculs séquentiels et les grands ensembles de données deviennent vite lourds, et l’accélération compte vraiment ici.
On définit ensuite l’optimiseur Adam et la fonction de perte MSELoss.
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
criterion = nn.MSELoss()
C’est seulement à ce stade que commence véritablement l’entraînement. Jusqu’ici, nous n’avons fait que préparer soigneusement le terrain : préparer les données, définir la forme de l’entrée, assembler l’architecture et configurer le mécanisme de mise à jour des poids.
for epoch in range(1, Epochs + 1):
    model.train()
    train_loss = 0.0
    for xb, yb in train_loader:
        xb, yb = xb.to(device), yb.to(device)
        optimizer.zero_grad()
        preds = model(xb)
        loss = criterion(preds, yb)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * xb.size(0)
    train_loss /= len(train_loader.dataset)

    model.eval()
    val_loss = 0.0
    with torch.no_grad():
        for xb, yb in val_loader:
            xb, yb = xb.to(device), yb.to(device)
            preds = model(xb)
            loss = criterion(preds, yb)
            val_loss += loss.item() * xb.size(0)
    val_loss /= len(val_loader.dataset) if len(val_loader.dataset) > 0 else float('nan')

    print(f"Epoch {epoch}/{Epochs} — train_loss: {train_loss:.6f} val_loss: {val_loss:.6f}")
La force du pipeline réside dans l’enchaînement des étapes : préparation des données → assemblage du modèle → entraînement. Cet ordre simplifie le transfert vers MQL5 via ONNX sans perdre la correspondance des entrées.
Au cours de l’entraînement, la partie comportementale du système se met en place : les poids du modèle, sa réponse aux données analysées et la structure de prévision. Mais il faut bien comprendre que le modèle n’est pas entraîné sur des données brutes, mais sur la représentation déjà préparée et compressée.
On obtient ainsi deux blocs qu’il ne faut pas mélanger. Le premier est la base statistique : la normalisation et l’ACP. Le second est le modèle lui-même, entraîné dans cet espace. Ensemble, ils forment un même pipeline de traitement des données.
Après l’entraînement, le modèle est exporté au format ONNX. Ce format fige le graphe de calcul et rend le modèle portable.
# Try exporting to ONNX
try:
    onnx_path = os.path.join(data_path, 'MQL5', 'Files', 'lstm3.onnx')
    dummy_input = torch.randn(1, 1, X_np.shape[1], device=device)
    model.eval()
    torch.onnx.export(
        model,
        dummy_input,
        onnx_path,
        input_names=['PCA_features'],
        output_names=['Forecast'],
        opset_version=18,
        dynamo=True,
        external_data=False,
        verify=True
    )
    print(f"Exported model to ONNX: {onnx_path}")
except Exception as e:
    print("ONNX export failed:", e)
Dans cette architecture, ONNX reste un conteneur de calculs. Il stocke le modèle sous forme de fonction fixe, prête à être exécutée en MQL5 via OnnxCreate et OnnxRun. Mais toute la logique de préparation des données reste en dehors d’ONNX et est reproduite à l’identique dans le terminal à l’aide de matrices et de vecteurs.
C’est pourquoi Python joue un rôle strictement limité dans cette structure. Il n’intervient qu’une seule fois : pour entraîner le modèle et fixer ses paramètres. Après l’exportation, il n’intervient plus dans la prise de décision. Tout le travail ultérieur est confié au terminal.
C’est ainsi que se forme une répartition claire des rôles. Python se charge de construire le modèle. ONNX le fige sous forme d’objet de calcul. MQL5 reproduit le pipeline d’entrée et exécute l’inférence. Et plus cette répartition est respectée, plus le système est stable dans un environnement de trading réel.
Reproduction et contrôle des données dans MQL5
Après l’exportation du modèle au format ONNX, le travail est transféré au terminal. Et c’est là que l’on comprend particulièrement bien pourquoi les matrices et les vecteurs étaient dès le départ des éléments clés de toute l’architecture. Dans cette structure, MQL5 reproduit l’intégralité du chemin de préparation des données sur lequel le modèle a été entraîné.
Et il faut ici distinguer d’emblée deux modes différents. Le premier mode est l’initialisation, qui est effectuée une seule fois lors du lancement de l’Expert Advisor. Le second est une boucle d’exécution répétée à chaque nouvelle barre. Cette division est très importante. Elle rend les calculs stables. Tout ce qui peut être préparé à l’avance doit l’être. Seule la logique de marché en temps réel doit rester dans la boucle exécutée à chaque barre.
Lors de l’initialisation, MQL5 met en place toute l’infrastructure sur laquelle le modèle va s’appuyer. Les paramètres de normalisation, le centre de l’espace ACP et la matrice des composantes sont chargés en premier.
   if(!LoadBinaryParams(sFileName, vMeans, vScales, vPCAmeans, mPCAcomponents, vEvr, iNFeatures, iNComponents))
     {
      PrintFormat("Error of load PCA params: %d", GetLastError());
      return INIT_FAILED;
     }
   PrintFormat("Loaded PCA params: features=%d components=%d", iNFeatures, iNComponents);
Il convient ici de prêter attention à un détail important. Les paramètres de normalisation sont chargés dans des vecteurs, tandis que les composantes de l’ACP sont chargées dans une matrice. Cela semble naturel, mais reflète en fait bien la structure de la préparation des données.
Les moyennes et les écarts types sont des statistiques univariées. Chaque caractéristique possède sa propre moyenne et son propre écart type. Ils sont donc représentés sous forme de vecteurs. Chaque élément d’un tel vecteur correspond à une caractéristique distincte de l’espace d’entrée. La logique est linéaire et transparente.
Avec l’ACP, la situation est différente. Il ne s’agit plus ici d’un ensemble de coefficients individuels, mais de la transformation de l’ensemble de l’espace des caractéristiques. C’est pourquoi les composantes sont chargées dans une matrice. Et ce n’est plus un simple conteneur de données. La matrice définit la règle de passage de l’espace des caractéristiques d’origine au nouvel espace compressé des composantes. Chaque ligne décrit ici la direction du nouvel axe après la transformation par ACP. En fait, le terminal reçoit une géométrie de l’espace toute faite, construite en Python sur l’ensemble d’entraînement.
Il s’agit d’un point très important pour comprendre l’architecture dans son ensemble. Les vecteurs se chargent des opérations locales sur chaque caractéristique : centrage et mise à l’échelle. La matrice se charge de la transformation globale de l’ensemble de l’espace des données. Les types intégrés matrix et vector de MQL5 reflètent parfaitement cette structure mathématique directement dans le code.
Le modèle ONNX est ensuite chargé, et ses dimensions d’entrée et de sortie sont définies.
//--- load models
   hONNX = OnnxCreateFromBuffer(model, ONNX_DEFAULT);
   if(hONNX == INVALID_HANDLE)
     {
      Print("OnnxCreateFromBuffer error ", GetLastError());
      return INIT_FAILED;
     }
   const ulong input_state[] = {1, 1, iNComponents};
   if(!OnnxSetInputShape(hONNX, 0, input_state))
     {
      PrintFormat("OnnxSetInputShape error: %d ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
   const ulong output_forecast[] = {1, vForecast.Size()};
   if(!OnnxSetOutputShape(hONNX, 0, output_forecast))
     {
      Print("OnnxSetOutputShape error ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
C’est là qu’intervient un point architectural très important. La taille d’entrée du modèle n’est plus égale au nombre de caractéristiques d’origine. Elle est égale au nombre de composantes de l’ACP, c’est-à-dire à la dimension de l’espace des données déjà compressé.
Cela signifie que le modèle ne travaille pas avec l’ensemble complet des indicateurs initiaux et des valeurs dérivées, mais avec leur représentation compacte après l’ACP. Le bruit et les corrélations excessives restent dans l’espace d’origine, tandis qu’ONNX reçoit un signal plus stable et concentré.
En pratique, cela produit plusieurs effets simultanément. Une taille réduite du tenseur d’entrée. Une charge de calcul plus faible. Une tâche simplifiée pour le modèle. Mais surtout, l’espace d’entrée devient plus stable. Le réseau cesse de gaspiller des ressources à traiter des caractéristiques qui se recoupent et travaille avec une représentation plus dense de la structure du marché.
C’est pourquoi, ici, l’ACP n’est pas seulement un moyen de réduire la dimensionnalité. Elle devient une couche intermédiaire entre les données brutes du marché et le modèle. Les matrices MQL5 nous permettent de reproduire cette couche directement dans le terminal, sous une forme presque identique à celle qu’elle avait en Python.
Ensuite, les indicateurs sont connectés et les tampons de travail sont préparés.
//--- Indicators
   if(!ciSMA.Create(Symb.Name(), TimeFrame, 12, 0, MODE_SMA, PRICE_CLOSE))
     {
      Print("SMA create error ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
   ciSMA.BufferResize(2);
   for(uint i = 0; i < ciMACD.Size(); i++)
     {
      if(!ciMACD[i].Create(Symb.Name(), TimeFrame, int(mMACDset[i, 0]), int(mMACDset[i, 1]),
                                                          int(mMACDset[i, 2]), PRICE_CLOSE))
        {
         PrintFormat("MACD %d create error %d", i, GetLastError());
         OnnxRelease(hONNX);
         return INIT_FAILED;
        }
      ciMACD[i].BufferResize(4);
     }
Il ne s’agit pas simplement d’une formalité technique. C’est à ce moment que le terminal reçoit la même base statistique que celle sur laquelle le modèle a été entraîné en Python. En d’autres termes, MQL5 reconstruit l’environnement dans lequel la prédiction générée par le modèle a du sens.
Cela est particulièrement évident lors du chargement des paramètres de préparation des données. Ils ne sont ni recalculés ni ajustés sur place. Ils arrivent au terminal déjà préparés. C’est là toute la force de l’approche matricielle. Les paramètres de préparation des données sont chargés une seule fois et fixés dans la structure de calcul ; ils ne sont pas recalculés sur place. Le terminal travaille donc avec un modèle lié à un espace de données précis.
Commence ensuite le cycle de travail. Il est désormais d’une tout autre nature. À chaque nouvelle barre, l’Expert Advisor collecte de nouvelles données de marché.
   ciSMA.Refresh();
   for(uint i = 0; i < ciMACD.Size(); i++)
      ciMACD[i].Refresh();
   if(!vRates.CopyRates(Symb.Name(), TimeFrame, COPY_RATES_CLOSE, 1, 12))
     {
      Print("CopyRates error ", GetLastError());
      return;
     }
Le vecteur de caractéristiques est généré…
   vInputs[0] = vRates[11] - vRates[10];
   vInputs[1] = (vRates[11] - vRates[0]) / 11;
   vInputs[2] = vInputs[1] - vInputs[0];
   vInputs[3] = float(ciSMA.Main(1));
   for(uint i = 0; i < ciMACD.Size(); i++)
     {
      vInputs[4 + i * 6] = float(ciMACD[i].Main(1));
      vInputs[5 + i * 6] = float(ciMACD[i].Main(1) - ciMACD[i].Main(2));
      vInputs[6 + i * 6] = float(ciMACD[i].Signal(1));
      vInputs[7 + i * 6] = float(ciMACD[i].Signal(1) - ciMACD[i].Signal(2));
      vInputs[8 + i * 6] = vInputs[6 + i * 6] - vInputs[4 + i * 6];
      vInputs[9 + i * 6] = vInputs[7 + i * 6] - vInputs[5 + i * 6];
     }
…puis il subit les mêmes transformations que celles utilisées lors de l’entraînement. D’abord la normalisation, puis la projection par ACP.
bool TransformPCA(const vector<float> &data, const vector<float> &scaler_mean,
                  const vector<float> &scaler_scale, const vector<float> &pca_mean,
                  const matrix<float> &pca_components, vector<float> &out)
  {
   ulong n = data.Size();
   if(n == 0)
      return false;
//---
   vector<float> centered = (data - scaler_mean) / scaler_scale - pca_mean;
//--- projection: out = pca_components * centered (matrix * vertical vector)
   out = pca_components.MatMul(centered);
   return true;
  }
L’avantage des mathématiques intégrées de MQL5 est particulièrement visible ici. Le code reprend pratiquement la notation mathématique elle-même. Le terminal reproduit simplement les mêmes opérations que celles utilisées pour entraîner le modèle.
Ce n’est qu’ensuite que le vecteur préparé est transmis à ONNX.
//--- ONNX
   if(!OnnxRun(hONNX, ONNX_LOGLEVEL_INFO, vCompressed, vForecast))
     {
      PrintFormat("OnnxRun error: %d ", GetLastError());
      return;
     }
Il n’y a plus de place ici pour une préparation lourde ou une réinitialisation. Tout fonctionne comme une chaîne de production. Nouvelle barre, nouvelle entrée. Mais le chemin suivi par cette entrée reste inchangé.
C’est là que l’intérêt pratique des matrices et vecteurs intégrés à MQL5 entre en jeu. Ils nous permettent d’assembler toute la structure des données une seule fois, puis de la reproduire autant de fois que nécessaire, sans complication inutile et sans perte de cohérence. L’initialisation définit le cadre. Le cycle de travail l’utilise tout simplement. Cela rend le système non seulement compact, mais aussi discipliné. Pour le ML dans le terminal, la discipline compte plus que les beaux discours. Car c’est la discipline qui maintient le modèle dans l’espace même où il peut réellement fonctionner.
Test du résultat : du modèle au comportement de trading
Le modèle a été entraîné en Python, tandis que le pipeline de calcul est soigneusement reproduit en MQL5. La normalisation et l’ACP s’appuient sur des matrices et des vecteurs. Le modèle ONNX est chargé dans le terminal. Tous les éléments sont réunis en un système unique. La question principale est maintenant simple : comment ce système va-t-il se comporter sur le marché ?
C’est là qu’intervient le Testeur de Stratégie de MetaTrader 5. Il montre non seulement que le modèle fonctionne, mais aussi à quel point l’ensemble du pipeline ML est stable, de la préparation des données à la décision de trading. Il s’agit d’un test complet de toute l’architecture sur la dynamique réelle du marché.
C’est l’un des plus grands atouts de la plateforme. En Python, il est facile d’obtenir de bonnes valeurs de fonction de perte ou une précision élevée sur l’ensemble d’entraînement. Mais le marché met rapidement à l’épreuve la solidité de tels résultats. Le testeur de MetaTrader 5 permet de le constater immédiatement. La combinaison des métriques fournies par MetaTrader 5 est importante. C’est là que le testeur révèle sa véritable valeur. Il permet de considérer la stratégie comme un système vivant, doté de son propre comportement, de son risque, de sa stabilité et de sa structure interne.
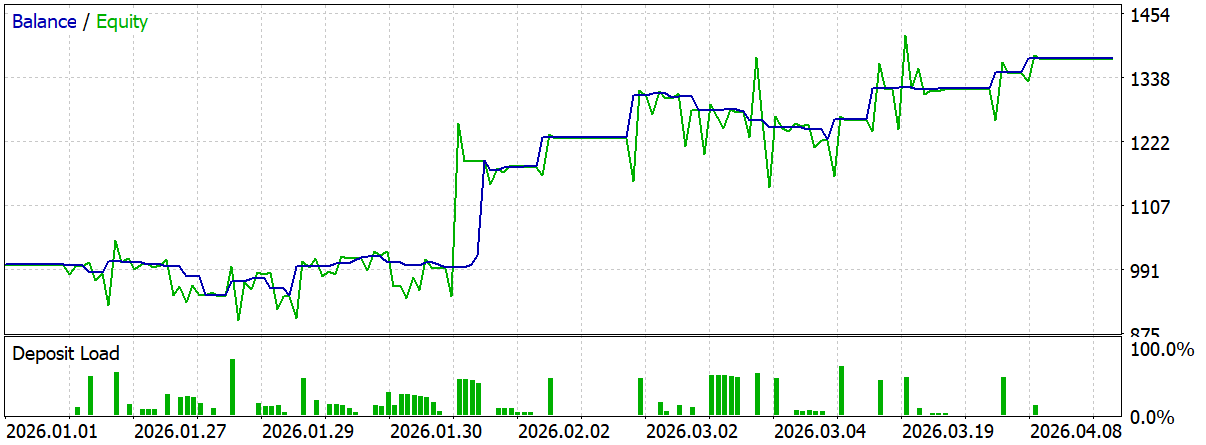
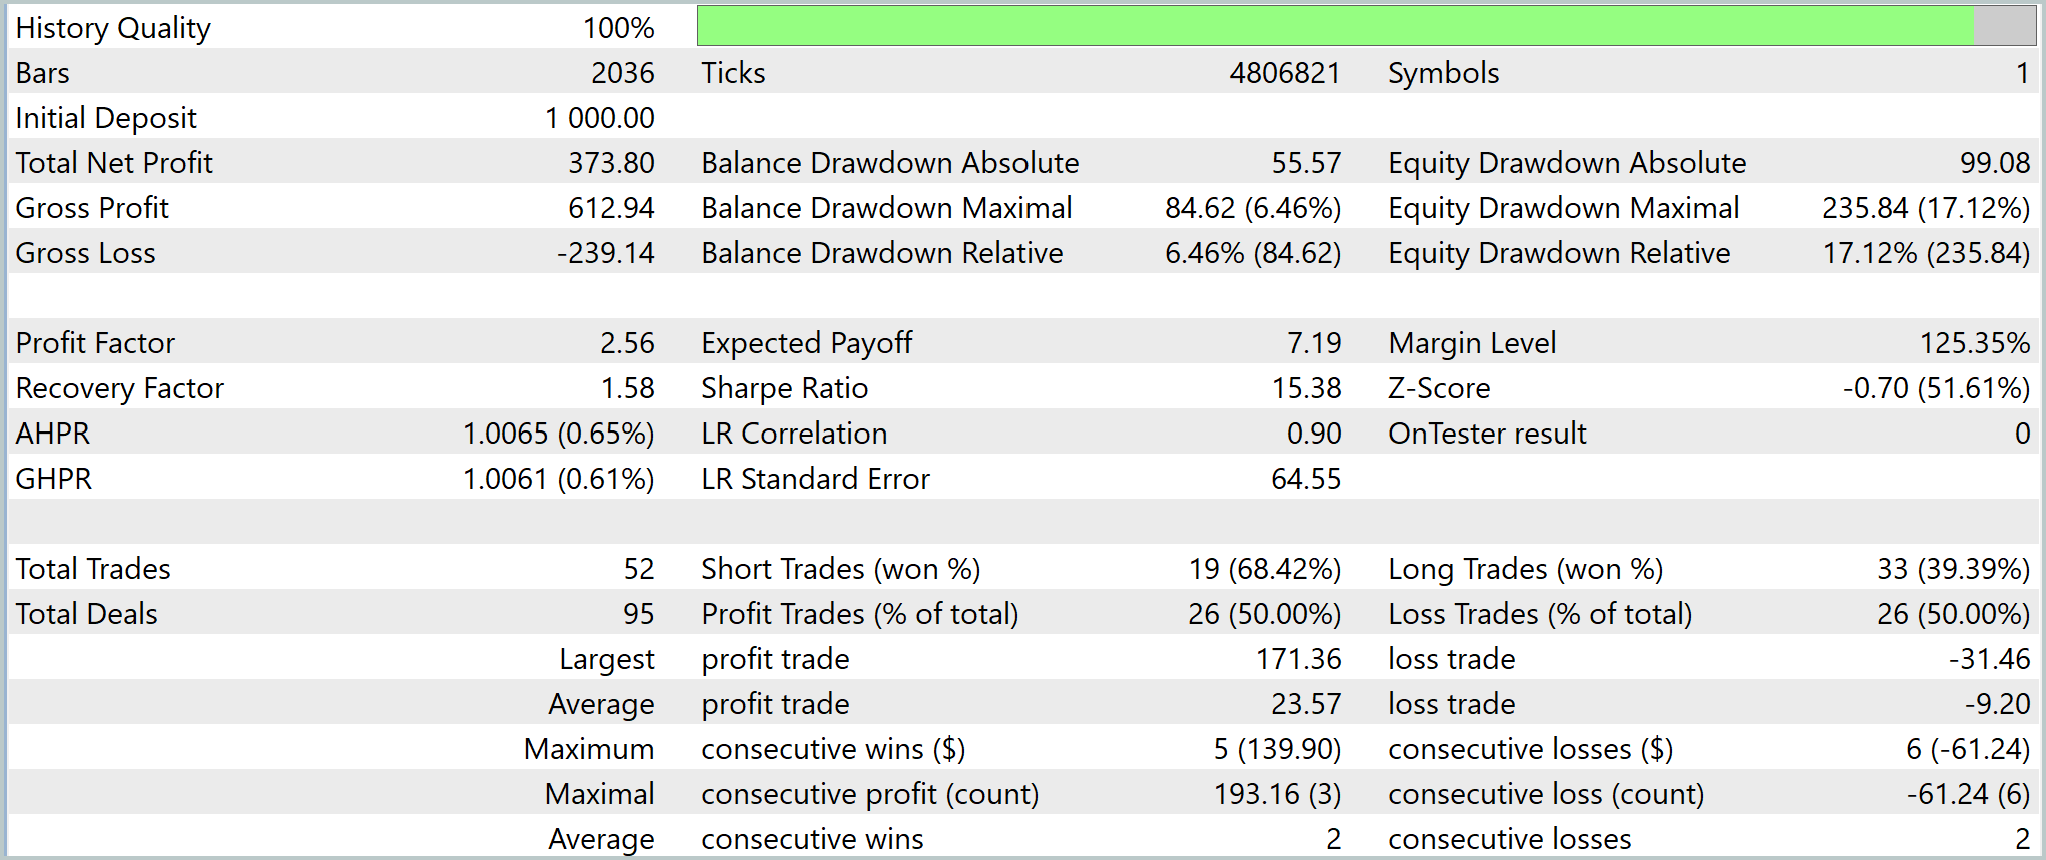
- La Qualité de l’Historique constitue un point de départ important.
Les conditions de test écartent tout doute quant à la validité de l’exécution. Les résultats peuvent être considérés comme techniquement fiables, ce qui signifie que l’analyse des métriques a un sens. - Le résultat financier (Profit Total Net) s’élève à 373,80 USD pour un dépôt initial de 1 000,00 USD.
Cela signifie que la stratégie a terminé le test sur un résultat positif. Toutefois, cette métrique seule ne dit rien de la qualité de la logique : elle doit donc être lue avec les autres métriques. - Le Profit Brut s’élève à 612,94 USD, et la Perte Brute à -239,14 USD.
Cela signifie que les transactions gagnantes l’ont nettement emporté sur les transactions perdantes, d’où le résultat positif. La stratégie tire son profit d’une prédominance constante de résultats positifs. - Le Facteur de Profit est égal à 2,56.
C’est une valeur solide. Le profit est plus de deux fois et demie supérieur à la perte. Pour un système de trading, c’est déjà le signe que les transactions gagnantes l’emportent réellement sur les perdantes. - Le Rendement Attendu s’élève à 7,19.
Cela signifie qu’en moyenne, chaque transaction a produit une contribution mathématique positive. Le système ne vit pas d’une ou deux séries gagnantes : il conserve une espérance positive au niveau de chaque transaction. - Le Facteur de Recouvrement, égal à 1,58, indique dans quelle mesure le résultat justifie le drawdown subi.
Dans ce cas, le système est capable de se remettre des pertes, même si la marge de sécurité ne peut être qualifiée d’énorme. La stratégie fonctionne, mais il ne faut pas sous-estimer les drawdowns. - Le Ratio de Sharpe atteint 15,38.
C’est une valeur très élevée, qui indique un rapport important entre le rendement et la volatilité des résultats. Mais il faut garder à l’esprit que, dans le testeur, cet indicateur doit être lu conjointement avec les drawdowns et l’enchaînement des transactions. - L’AHPR s’élève à 1,0065, soit 0,65 %. Le GHPR s’élève à 1,0061, soit 0,61 %.
Ces métriques indiquent la rentabilité moyenne d’une transaction en termes arithmétiques et géométriques. La conclusion est claire : il y a bien une croissance, et elle est inscrite dans la structure même du flux de transactions. - Le Drawdown Absolu du Solde s’élève à 55,57 USD, le Drawdown Maximal du Solde à 84,62 USD, soit 6,46 % (Drawdown Relatif du Solde).
Cela signifie que la stratégie est restée relativement équilibrée. Les transactions clôturées forment une courbe de capital acceptable. - Le Drawdown des Fonds donne une image toute différente. Le drawdown absolu s’élève à 99,08 USD, le drawdown maximal à 235,84 USD, soit 17,12 %.
C’est un point important : les positions ouvertes ont créé une exposition au marché, même si le solde final semblait modéré. La conclusion est honnête : la stratégie sait gagner de l’argent, mais pas sans tension interne. - Le Niveau de Marge s’élève à 125,35 %.
C’est un niveau sûr, mais sans grande marge de sécurité. Cela montre que la réserve de marge était suffisante. Cependant, le système n’a pas fonctionné dans des conditions de laboratoire. La logique de trading est restée dans sa plage de fonctionnement, sans pression critique sur le compte. - Le Score Z est égal à -0,70, avec un niveau de signification de 51,61 %.
Cela indique l’absence de séries anormales nettement marquées de gains et de pertes. Autrement dit, les résultats ne ressemblent pas à un simple coup de chance. La séquence des transactions ressemble davantage à une structure de trading fonctionnelle qu’à un bruit aléatoire. - La Corrélation LR est égale à 0,90, et l’Erreur Standard LR à 64,55.
La corrélation indique une tendance linéaire assez régulière de la courbe des fonds. L’erreur standard montre que la progression n’a pas été parfaitement régulière. La croissance est bien là, mais elle s’est construite au fil des fluctuations normales du marché. - Au total, 52 positions (Positions Totales) ont été ouvertes et 95 transactions (Transactions Totales) enregistrées.
Ce volume est déjà suffisant pour appréhender la nature de la stratégie. Le test ne se limite pas à quelques entrées aléatoires et donne une image très parlante. - Les Positions Shorts comptent 19 transactions, dont 68,42 % gagnantes, et les Positions Longues 33 transactions, dont 39,39 % gagnantes.
On observe une divergence intéressante selon le sens des transactions. C’est un signal très important. La stratégie s’en sort nettement mieux à la vente qu’à l’achat. Elle présente donc peut-être un biais marqué en faveur des mouvements baissiers. - Les Positions Gagnantes et les Positions Perdantes sont à égalité : 26 transactions chacune, soit 50,00 % chacune.
À première vue, c’est l’égalité, mais cela n’empêche pas le système de rester rentable. La stratégie gagne de l’argent grâce à la qualité de ses transactions. - La transaction la plus profitable (Plus grande position gagnante) s’élève à 171,36 USD, et la plus déficitaire (Plus grande position perdante) à -31,46 USD.
Le Gain moyen par position est égal à 23,57 USD, et la perte moyenne (Perte moyenne par position) à -9,20 USD. Ce sont peut-être là quelques-unes des métriques les plus importantes du rapport. La transaction gagnante moyenne est plus de deux fois supérieure à la transaction perdante moyenne. Le système parvient à conserver un avantage, même avec une proportion d’entrées gagnantes loin d’être idéale. - Les Gains consécutifs maximum s’élèvent à 5 transactions pour 139,90 USD, et les Pertes consécutives maximum à 6 transactions pour -61,24 USD.
Cela montre que la stratégie sait profiter des séries favorables, mais qu’elle n’est pas à l’abri d’une série perdante.
Chaque métrique reflète un aspect différent de la mécanique de la stratégie. C’est là le principal avantage de la plateforme : elle nous permet de voir non seulement le résultat, mais aussi sa structure.
Conclusion
L’apprentissage automatique appliqué au trading semble souvent lourd et complexe. Mais la pratique donne une tout autre image. MetaTrader 5 contient la plupart des outils nécessaires à la construction d’un pipeline ML complet. C’était précisément l’objectif principal de l’article. Au lieu de présenter un modèle magique et de faire une énième tentative de prédiction du marché, il analyse le chemin lui-même : des données de marché ordinaires à un modèle ONNX fonctionnel à l’intérieur du terminal. Il est particulièrement important que les matrices et vecteurs intégrés de MQL5 y jouent un rôle clé. Ils transforment la préparation des données, d’un ensemble d’opérations disparates, en une structure de calcul claire et maîtrisable.
Normalisation, calculs statistiques, travail sur l’espace des caractéristiques, transformation par ACP : tout cela est reproduit directement dans le terminal, sous une forme quasi identique à sa description mathématique. Le code cesse d’être surchargé de détails techniques et commence à refléter la logique des calculs eux-mêmes. Cela abaisse considérablement, pour un trader, le seuil d’entrée dans le développement ML.
La prise en charge d’ONNX est également importante. MetaTrader 5 permet d’utiliser le modèle comme un bloc de calcul prêt à l’emploi. Python reste l’outil de préparation du modèle, et le terminal devient l’environnement de son exécution et de son contrôle stables. Cette répartition rend l’architecture beaucoup plus propre et plus pratique. Le modèle est entraîné une seule fois, puis le travail est confié à MQL5. Cela garantit la transparence, la reproductibilité et un contrôle total des données d’entrée.
Le Testeur de Stratégie de MetaTrader 5 est particulièrement précieux. Il nous permet d’évaluer non seulement le profit final, mais aussi le comportement interne de l’ensemble du système. Drawdown, stabilité des fonds, structure des transactions, qualité du redressement après les pertes, stabilité du rythme de trading : tout cela devient mesurable grâce à un riche ensemble de métriques intégrées. Derrière chacune de ces métriques se cache une facette distincte du comportement de la stratégie. C’est cette approche qui fait passer les tests d’un simple contrôle formel à une véritable analyse d’ingénierie.
Ainsi, MetaTrader 5 peut servir à construire et à reproduire des pipelines ML sans transférer la logique vers une infrastructure externe. Conclusion principale : Le ML dans MetaTrader 5 repose sur les mathématiques linéaires, les matrices et une préparation transparente des données, sans donner l’impression que le ML existe quelque part en dehors du terminal.
Programmes utilisés dans l’article
| # | Nom | Type | Description |
|---|---|---|---|
| 1 | create_pca_lstm.py | Script | Script pour la construction et l’entraînement du modèle |
| 2 | MLpipeline.mq5 | Expert Advisor | EA pour tester le modèle ONNX |
Traduit du russe par MetaQuotes Ltd.
Article original : https://www.mql5.com/ru/articles/22474
Avertissement: Tous les droits sur ces documents sont réservés par MetaQuotes Ltd. La copie ou la réimpression de ces documents, en tout ou en partie, est interdite.
 Comment Échanger des Données : Une DLL pour MQL5 en 10 minutes
 La puissance de MetaTrader 5 : du débogage pas à pas à la protection des fichiers EX5 dans un environnement unifié
 L'Histogramme des prix (Profile du Marché) et son implémentation en MQL5
 Visualisation 3D sans bibliothèques externes : comment MetaTrader 5 révèle les résultats d’optimisation avec MQL5 et DirectX 11

- Applications de trading gratuites
- Plus de 8 000 signaux à copier
- Actualités économiques pour explorer les marchés financiers
Vous acceptez la politique du site Web et les conditions d'utilisation
À mon humble avis, normaliser et calculer l'ACP sur l'ensemble des données, puis seulement ensuite le diviser en échantillons d'apprentissage et de validation, revient à prédire l'avenir. Lorsque vous travaillez en ligne, vous n'avez pas la possibilité de modifier la normalisation ni d'adapter l'ACP en fonction des dernières données. Une expérience rigoureuse consisterait à diviser d’abord les données en deux ensembles, puis à effectuer la normalisation et l’ACP uniquement sur la partie « in-sample », avant d’appliquer les métaparamètres de transformation des données d’entrée ainsi obtenus à la partie « out-of-sample ».
En conséquence, même un indicateur à aiguilles classique affiche des aiguilles « aux extrêmes ».
C’est dangereux, on ne comprend pas tout de suite où est le piège.