
"최적 패스"에서 견고한 솔루션으로: MetaTrader 5에서 최적화 표면 탐색하기
 18
 0

소개
매매 전략 최적화는 알고리즘 거래 시스템 개발의 표준적인 부분으로 오랫동안 자리매김해 왔습니다. MetaTrader 5는 이를 위한 강력한 도구를 제공합니다: 멀티스레드 테스터, 분산 컴퓨팅, 사용자 정의 기준 등. 최적화 결과는 EA 매개변수에서 성능 지표의 1차원, 2차원 및 3차원 의존성으로 시각화할 수 있습니다. 언뜻 보면 이것으로 충분해 보입니다: 최적화가 시작되고 결과가 수익계수 또는 다른 요약 기준에 따라 정렬된 후 최적의 패스가 선택됩니다. 하지만 바로 여기서 알고리즘 트레이딩에 관한 가장 흔한 오해 중 하나가 시작됩니다.
문제는 최적화는 거의 항상 개별 패스에서 최대의 결과를 찾는 데 초점을 맞춘다는 점입니다. 테스터는 매개변수 표면의 최고점, 즉 가장 높은 수익계수, 최상의 샤프 비율 또는 최대 수익을 보여줍니다. 하지만 시장은 한가지 극단적인 요소에 기반한 시스템에 보상을 해주는 경우가 드뭅니다. 반대로 그러한 피크는 종종 매개변수와 과거 데이터의 지역적 구조가 무작위로 일치한 결과로 나타나는 경우가 많습니다. 지표 기간, 손절매 값 또는 시장 모드에 약간의 변화만 있어도 놀라웠던 결과가 순식간에 무너지기 시작합니다.
그렇기 때문에 높은 수익계수 그 자체는 아무것도 보장하지 않습니다. 두 전략이 동일한 수익을 보일 수 있지만 안정성 측면에서는 근본적으로 다를 수 있습니다. 첫 번째 방법은 인접한 매개변수의 전체 범위에 걸쳐 허용 가능한 결과를 유지합니다. 두 번째 방법은 최적화 표면에서 가느다란 바늘 형태로만 존재하며 주변에는 혼란스럽고 비효율적인 구성들로 둘러싸여 있습니다. 형식적으로는 두 시스템 모두 수익성이 있습니다. 실제로는 그중 단 하나만이 실제의 시장에서 살아남을 가능성이 있습니다.
MetaTrader 5에 내장된 시각화 도구는 최종 메트릭이 개별 최적화 매개변수에 어떻게 의존하는지 명확하게 보여줍니다. 테스터는 메트릭의 값과 결과 분포를 보여줍니다. 하지만 이는 인접한 구성을 평가하는 데에는 거의 도움이 되지 않습니다: 성능 저하 속도, 안정적인 평탄 영역의 존재 여부, 매개변수에 대한 민감도 및 과최적화 한계. 다시 말해 함수의 최대치는 더 이상 전체 최적화 표면의 기하학적 구조만큼 중요하지 않습니다.
이것이 바로 최적화 프레임이 특별한 의미를 갖는 이유입니다. 이 메커니즘을 통해 각 최적화 패스 후 임의의 사용자 데이터를 저장하고 분석할 수 있습니다. 개발자는 몇 가지 내장 지표를 사용하는 대신 자체적인 연구 원격 측정 데이터를 생성할 수 있습니다: 추가 지표를 전송하고, 인접 구성의 안정성을 평가하고, 로컬 매개변수 영역을 분석하고, 극단적인 수익성이 아닌 시스템 동작의 안정성에 초점을 맞춘 기준을 구축. 이 시점에서 최적화는 단순히 보기 좋은 숫자를 찾는 것을 넘어 본격적인 연구로 전환됩니다.
이 글에서는 MetaTrader 5의 최적화 프레임을 적용하는 실제 사례를 살펴보고 자체 메트릭을 저장하고 결과를 분석하는 방법 그리고 전체 최적화 영역을 기반으로 사용자 정의 안정성 기준을 구축하는 방법을 알아보겠습니다. 주요 목표는 시장 상황의 변화에도 불구하고 예측 가능한 행동을 유지할 수 있는 안정적인 매개변수의 영역을 파악하는 것입니다.
연구 원격 측정 시스템으로서의 최적화 프레임
내장 테스터의 모든 기능에도 불구하고 MetaTrader 5에서의 표준 최적화는 본질적으로 형식적인 절차로 남아 있습니다. 에이전트가 계산을 수행합니다. 테스터는 결과를 기록합니다. 결과적으로 사용자는 완성된 수치 세트를 보게 됩니다: 수익계수, 샤프 비율, 드로다운, 수익 및 기타 요약 메트릭. 기초적인 선택에는 이 정도면 충분합니다. 하지만 심도 있는 분석을 위해서는 이것 만으로는 불충분합니다. 상위 결과는 보이지만 지형 자체는 대부분 보이지 않습니다.
바로 이 부분에서 최적화 프레임이 중요한 역할을 합니다. 이것은 단순히 패스 결과를 저장하는 또 다른 방법이 아닙니다. 이는 테스트 에이전트와 분석 코드 간에 연구 데이터를 전송하기 위한 완벽한 채널입니다. 프레임을 통해 우리는 전략의 동작을 더 깊이 이해하는 데 도움이 되는 모든 것을 전달할 수 있습니다: 추가 통계, 중간 매개변수, 모델 상태, 평가금액 곡선 피처, 안정성 평가 및 기타 사용자 정의 지표.
이 메커니즘의 작동 방식은 매우 직관적입니다. 각 패스가 완료되면 EA는 OnTester()에서 FrameAdd()를 통해 데이터를 전송합니다. 이렇게 하면 터미널에서 TesterPass 이벤트가 발생하고 이 이벤트는 다시 OnTesterPass()를 호출합니다. 이 핸들러 내부에서는 들어오는 프레임을 즉시 구문 분석할 수 있습니다: FrameFirst() 및 FrameNext()를 통해 데이터를 순차적으로 읽고 필요한 항목을 필터링할 수 있습니다. 실제로 이는 마치 결과가 실시간으로 스트리밍 되는 듯한 느낌을 줍니다: 패스가 완료되었고 프레임이 도착했으며 이제 데이터를 분석할 수 있습니다.
하지만 이 흐름에는 중요한 피처가 있습니다. 프레임은 한 장씩 도착하지 않고 묶음으로 도착할 수 있으며 때로는 눈에 띄는 지연이 발생할 수 있습니다. 이는 특히 일부 계산이 원격 에이전트에 의해 수행되는 분산 최적화에서 두드러지게 나타납니다. 그렇기 때문에 모든 TesterPass가 다음 테스트 완료 시점에 정확히 처리되는 것은 아닙니다. 이러한 이유로 OnTesterDeinit()는 결과 작업을 수행하는 데 있어 마지막으로 신뢰할 수 있는 단계로 남아 있습니다. 일부 프레임이 나중에 도착한 경우 최적화가 완료된 후 FrameFirst()를 통해 처음부터 전체 데이터 배열을 다시 살펴보면서 읽을 수 있으며 필요한 경우 FrameFilter()를 사용하여 정렬하거나 필터링할 수 있습니다.
결과적으로 최적화는 더 이상 단순히 일련의 개별적인 패스가 아니며 이는 모든 매개변수 영역에 걸쳐 연구 원격 측정 데이터를 축적하는 시스템으로 변환됩니다. 이는 작업의 근본적인 로직을 바꿔놓습니다. 이제 개발자는 평가 기준의 최종 값뿐만 아니라 그 값이 얻어진 맥락까지도 파악할 수 있게 되었습니다. 수익 계수와 함께 수익 집중도, 거래 균일성, 시간 구간별 안정성 및 평가금액 특성과 같은 추가 지표를 저장할 수 있습니다. 별도로 인접 매개변수에 대한 성능 저하 지표와 시장 환경에 대한 민감도를 저장할 수 있습니다.
따라서 각 패스는 본격적인 진단 배치처럼 보이기 시작합니다. 최적화 과정이 길거나 복잡할수록 이 접근 방식의 가치는 더욱 높아집니다. 사실 최적화 프레임의 진정한 가치는 전체 최적화 표면에 대한 사후 분석 에 있습니다. 개별 지점을 분석하는 대신 매개변수 공간 전체를 연구하는 것이 가능해집니다: 즉 안정적인 영역을 찾고 결과 저하 속도를 측정하고 전략의 민감도를 평가하고 인접한 구성을 기반으로 자체적인 안정성 기준을 구축할 수 있습니다.
이러한 이유로 이 접근 방식에서의 최적화는 다차원 표면에 대한 연구가 되며 여기서는 메트릭의 절대값뿐만 아니라 메트릭의 분포 형태 안정 영역의 밀도 그리고 인접한 매개변수의 동작 방식 또한 중요합니다. 여기서는 가장 높은 고립된 피크인 개체가 승자가 아니라 더 견고하고 안정적인 표면을 가진 개체가 승자가 됩니다.
연구 대상으로서의 단순 전략
최적화 프레임워크에 익숙해지고 나면 아주 자연스러운 질문이 떠오릅니다: 우리는 이 분석의 대상으로 정확히 무엇을 사용해야 할까요? 직관적으로 우리는 복합적인 거래 시스템을 사용하고자 합니다 — 다층 모델, 필터 세트, 지표의 계층 구조, 적응형 포지션 관리 등. 하지만 복잡한 전략이 점점 더 논의의 중심을 빼앗기 시작합니다. 최적화 방안을 탐구하는 대신 이 글은 점차 거래 시스템 자체에 대한 논의로 방향을 전환합니다. 그리고 이건 완전히 다른 이야기입니다.
실제로는 정반대의 접근 방식이 필요합니다. 전략은 가능한 한 단순해야 하며 거의 사소할 정도여야 합니다. 독자가 각 신호의 출처와 결과의 변화를 쉽게 이해할 수 있도록 매우 투명해야 합니다. 여기서는 수익성이라는 마법 보다 연구 실험의 순수성이 더 중요합니다.
따라서 본 연구에서는 이동평균선의 교차점과 RSI 모드라는 두 가지 잘 알려진 개념을 기반으로 구축된 매우 간단한 모델을 연구의 대상으로 사용합니다. 시스템의 첫 번째 부분은 진입 시점을 담당합니다. 두 번째는 시장 상황을 필터링하기 위한 것입니다. 이 경우 신호 자체는 EA에서 지표를 직접 폴링하는 것이 아니라 이벤트 모델을 통해 생성됩니다. 지표는 독립적으로 신호를 생성하고 사용자 이벤트를 통해 신호를 전송합니다.
이 접근 방식은 여러 문제를 한 번에 해결합니다. 이 전략은 매우 간결하고 읽기 쉽습니다. 신호 로직은 잘 분해되어 있는 것으로 나타났습니다: 지표는 이벤트 생성만 담당하고 EA는 상태 처리 및 포지션 관리만 담당합니다. 이벤트 기반 아키텍처는 시스템 동작에 대한 진단 원격 측정 데이터를 쉽게 축적할 수 있도록 해주기 때문에 이 작업의 연구적 성격과 특히 잘 어울립니다.
로직의 핵심에는 간단한 아이디어가 자리 잡고 있습니다. EMA 교차점은 잠재적 진입 트리거로 사용됩니다.
//--- chek signal
   if(fast_buff[1] > slow_buff[1] &&
      fast_buff[0] <= slow_buff[0])
      SendSignalEvent(EVENT_EMA_CROSS, DIR_BUY, 0.0, "EMA CROSS");
   if(fast_buff[1] < slow_buff[1] &&
      fast_buff[0] >= slow_buff[0])
      SendSignalEvent(EVENT_EMA_CROSS, DIR_SELL, 0.0, "EMA CROSS");
하지만 교차 신호 자체는 포지션을 열지 않습니다. 먼저 시스템은 현재 RSI 모드를 체크합니다.
동시에 RSI는 지정된 레벨을 넘어서는 모드 전환 순간에만 이벤트를 생성합니다.
//--- chek signal
   ENUM_SIGNAL_DIRECTION new_regime = current_regime;
   if(rsi_buff[0] <= UpperLevel &&
      rsi_buff[1] > UpperLevel)
      new_regime = DIR_BUY;
   if(rsi_buff[0] >= LowerLevel &&
      rsi_buff[1] < LowerLevel)
      new_regime = DIR_SELL;
   if(rsi_buff[1] >= LowerLevel &&
      rsi_buff[1] <= UpperLevel)
      new_regime = DIR_NONE;
//--- send signal
   if(new_regime != current_regime)
     {
      current_regime = new_regime;
      SendSignalEvent(EVENT_RSI_REGIME, current_regime,
                      rsi_buff[1], "RSI REGIME");
     }
이 덕분에 노이즈를 크게 줄일 수 있습니다. EA는 현재 RSI 상태를 내부 플래그 형태로 저장하고 이를 시장 상황으로 활용합니다. 신호가 일치하면 해당 이벤트는 동기화된 것으로 간주되어 EA가 거래를 시작합니다.
void OnChartEvent(const int32_t id,
                  const long &lparam,
                  const double &dparam,
                  const string &sparam)
  {
//---
   if(id-CHARTEVENT_CUSTOM == EVENT_RSI_REGIME)
     {
      rsi_regime = (ENUM_SIGNAL_DIRECTION)lparam;
      rsi_regime_changes++;
      CloseConflictingPosition();
     }
   if(id-CHARTEVENT_CUSTOM == EVENT_EMA_CROSS)
     {
      ema_events++;
      ProcessEntry((int)lparam);
     }
  }
이는 향후 모든 최적화 작업에 있어 중요한 사항입니다. 우리는 의도적으로 독립적인 정보 출처의 일관성을 중심으로 시스템을 구축합니다.
위험 관리 또한 의도적으로 단순하게 유지됩니다. 손절매와 수익실현은 포지션을 개설할 때 ATR 승수를 통해 계산됩니다. ATR 값은 현재 변동성을 추정하는 용도로만 사용되며 이벤트 모델에는 포함되지 않습니다. 이를 통해 아키텍처를 최대한 간결하게 유지할 수 있습니다. 이벤트는 방향을 담당하고 ATR은 위험 규모를 정의합니다.
void ProcessEntry(const int signal)
  {
   if(PositionSelect(_Symbol))
      return;
   if(signal == DIR_BUY &&
      rsi_regime == DIR_BUY)
     {
      if(!atr_buff.CopyIndicatorBuffer(atr_handle, 0, 1, 2))
         return;
      double atr = atr_buff[0];
      double bid = SymbolInfoDouble(_Symbol, SYMBOL_BID);
      synchronized_entries++;
      double sl = NormalizeDouble(bid - atr * iSLmult,
                                  _Digits);
      double tp = NormalizeDouble(bid + atr * iTPmult,
                                  _Digits);
      trade.Buy(iLots, _Symbol, 0, sl, tp);
     }
   if(signal == DIR_SELL &&
      rsi_regime == DIR_SELL)
     {
      if(!atr_buff.CopyIndicatorBuffer(atr_handle, 0, 1, 2))
         return;
      double atr = atr_buff[0];
      double ask = SymbolInfoDouble(_Symbol, SYMBOL_ASK);
      synchronized_entries++;
      double sl = NormalizeDouble(ask + atr * iSLmult,
                                  _Digits);
      double tp = NormalizeDouble(ask - atr * iTPmult,
                                  _Digits);
      trade.Sell(iLots, _Symbol, 0, sl, tp);
     }
  }
실용적인 관점에서 볼 때 이러한 전략은 예측 가능성이라는 점에서 흥미롭습니다. 복잡한 로직이나 숨겨진 의존성, 과도한 필터링은 없습니다. 최적화 결과의 변화는 모델 매개변수의 변화와 거의 직접적으로 관련되어 있습니다. 이는 최적화 영역이 훨씬 더 읽기 쉬워지고 탐색적인 분석에 적합 해진다는 것을 의미합니다.
맞춤형 메트릭 및 고급 분석
MetaTrader 5 테스터는 수익, 수익계수, 회복계수, 샤프 비율, 드로다운, 예상 수익 및 기타 패스 특성과 같은 다양한 내장 지표를 계산할 수 있습니다. 이는 단일 구성을 평가하기에는 충분합니다. 하지만 그러한 지표들은 매개변수 공간의 한 지점만을 설명할 뿐이며 특정 패스가 얼마나 성공적이었는지에 대한 질문에 답합니다. 하지만 이 시점에서 전략이 어떻게 작용하는지에 대해서는 거의 언급된 바가 없습니다.
이제부터 재미 있어집니다. MetaTrader 5는 여러 최적화 옵션을 제공하며 선택한 기준에 따라 최적의 값으로 결과를 정렬합니다. 결과표에는 다른 성과 지표도 표시되어 있어 전체적인 상황을 상당히 잘 파악할 수 있습니다. 하지만 시각화는 선택된 기준에 대해서만 그리고 최적화된 매개변수에 대한 의존성만을 보여주면서 구축됩니다. 즉, 개발자는 메트릭 하나의 표면만 볼 뿐이며 발견된 영역 주변에서 해당 메트릭이 얼마나 안정적인지는 볼 수 없습니다. 하지만 이는 근본적으로 다른 문제입니다.
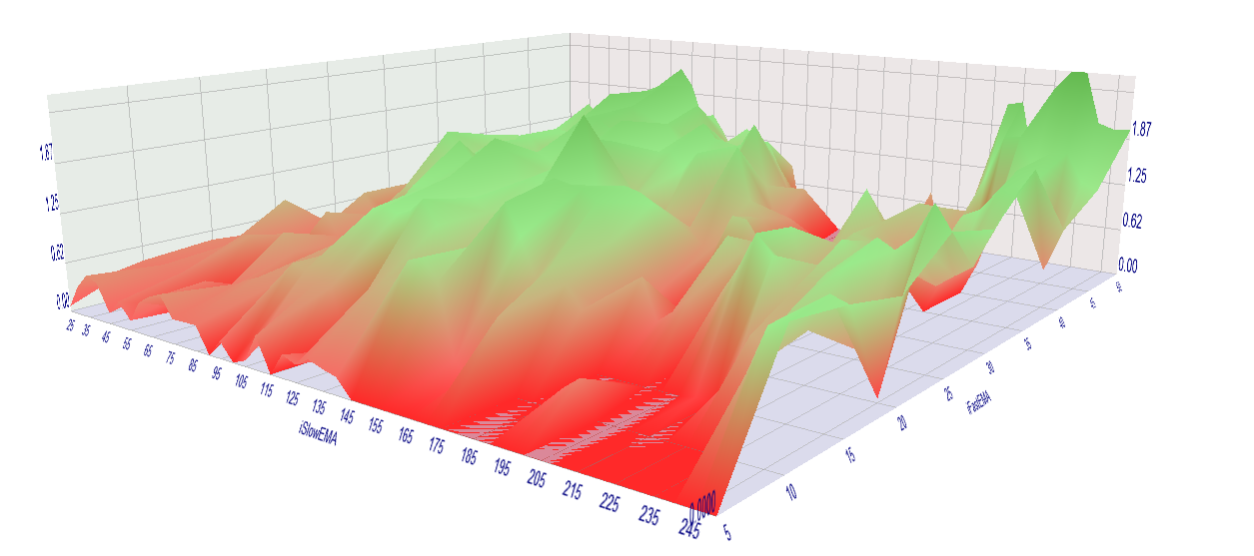
최종 보고서에서는 두 구성이 매우 유사해 보일 수 있지만 실제 동작은 완전히 다를 수 있습니다. 하나는 높은 수익계수를 제공하지만 좁은 피크 구간에만 성립하다가 매개변수의 아주 작은 변화에도 무너집니다. 다른 하나는 다소 완만한 결과를 보이지만 더 넓은 범위에 걸쳐 유사한 값을 유지합니다. 일반적인 테스트 환경에서는 거의 항상 첫 번째 구성이 가장 좋은 것으로 선택됩니다. 하지만 연구의 관점에서 보면 두 번째가 더 가치 있는 것으로 드러나는 경우가 많은데 그 이유는 두 번째의 움직임이 안정적으로 보이기 때문입니다.
따라서 우리는 내장된 통계뿐만 아니라 단일 패스 단계에서부터 자체 진단 메트릭까지 수집하기 시작합니다. FrameAdd를 사용하면 내부 동작을 이해하는 데 도움이 되는 추가적인 원격 측정 데이터를 전송할 수 있습니다. 우리의 경우 EMA 교차 횟수, RSI 모드 변경 횟수, 동기화 진입 횟수, 신호 전환율, 신호당 수익, 사용자 정의 안정성 기준 등이 기본 데이터와 함께 저장됩니다. 이는 시스템이 내부적으로 정확히 어떻게 작동하는지 파악하려는 시도입니다.
double OnTester()
  {
//---
   double profit_per_signal = 0.0;
   double trigger_conversion_ratio = 0.0;
//---
   double profit = TesterStatistics(STAT_PROFIT);
   double pf = TesterStatistics(STAT_PROFIT_FACTOR);
   if(ema_events > 0)
     {
      trigger_conversion_ratio =
         (double)synchronized_entries / (double)ema_events;
     }
   if(synchronized_entries > 0)
     {
      profit_per_signal =
         profit / synchronized_entries;
     }
   double ret =
      CalculateCustomCriterion(pf,
                               trigger_conversion_ratio,
                               profit_per_signal
                              );
//---
   double telemetry[12];
   telemetry[0]  = profit;
   telemetry[1]  = pf;
   telemetry[2]  = ema_events;
   telemetry[3]  = rsi_regime_changes;
   telemetry[4]  = synchronized_entries;
   telemetry[5]  = trigger_conversion_ratio;
   telemetry[6]  = profit_per_signal;
   telemetry[7]  = ret;
   telemetry[8]  = iFastEMA;
   telemetry[9]  = iSlowEMA;
   telemetry[10] = iSLmult;
   telemetry[11] = iTPmult;
//---
   FrameAdd("Telemetry", 0, ret, telemetry);
//---
   return(ret);
  }
신호의 전환율인 trigger_conversion_ratio는 특히 유용합니다. 이는 EMA 트리거 중 실제 거래로 이어지는 비율을 보여줍니다. 값이 높으면 기본 신호와 모드 필터가 서로 연동하여 동작합니다. 값이 낮으면 시스템이 지나치게 선택적이거나 노이즈가 너무 많거나 또는 매개변수 로직 자체가 제대로 작동하지 않는 것입니다. 어쨌든 이 지표는 수익 그 자체에 대한 것이 아니라 모델 구성 요소 간의 상호 작용 품질에 대한 것입니다.
또 다른 메트릭은 신호당 수익(profit_per_signal)입니다. 이는 거래당 평균 수익과 유사하지만 다른 값입니다. 우리 모델에서는 EMA와 RSI 신호가 일치할 때만 거래가 시작되지만, EMA가 역교차하더라도 개설된 포지션이 자동으로 청산되지는 않습니다. 게다가 해당 포지션이 활성화된 상태로 유지되는 동안에는 이후의 신호는 무시해도 됩니다. 따라서 동기화된 신호의 수와 실제로 실행된 거래 사이클의 수가 항상 정확히 일치하는 것은 아닙니다. 이러한 의미에서 신호당 수익은 시스템이 놓친 신호를 고려하여 사용 가능한 진입점을 얼마나 효율적으로 수익화 하는지를 반영합니다.
여기서 다음 단계로 넘어가는 전환점이 등장합니다. 최적화 프레임이 전체 파라미터 영역에 걸쳐 원격 측정 데이터를 축적하기 시작하면 개별 패스뿐만 아니라 패스 간의 상호 작용도 분석할 수 있게 됩니다. 그리고 이는 단순히 최고의 결과들의 목록을 나열하는 것보다 훨씬 더 중요합니다. 우리는 최댓값이 어디에 있는지 뿐만 아니라 인접한 구성들이 어떻게 작동하는지, 매개변수의 작은 변화에 따라 결과가 얼마나 빨리 저하되는지, 그리고 발견된 지점 주변에 안정적인 평탄 영역이 있는지 여부에도 관심이 있습니다.
그렇기 때문에 프레임을 통해 내보낸 데이터는 CSV 파일로 저장됩니다.
void OnTesterDeinit()
  {
   ArrayResize(frames, 0, 100);
   FrameFirst();
   int pos = 0;
   ulong pass = 0;
   string name = "";
   long id = 0;
   double value = 0;
   double data[];
   SFrameData item;
//---
   while(FrameNext(pass, name, id, value, data))
     {
      if(ArraySize(data) < 12)
         continue;
      item.pass                 = id;
      item.profit               = data[0];
      item.pf                   = data[1];
      item.ema_events           = data[2];
      item.regime_changes       = data[3];
      item.synchronized_entries = data[4];
      item.conversion_ratio     = data[5];
      item.profit_per_signal    = data[6];
      item.custom_criterion     = data[7];
      item.fast_ema             = data[8];
      item.slow_ema             = data[9];
      item.sl_mult              = data[10];
      item.tp_mult              = data[11];
      pos = ArraySize(frames);
      if(ArrayResize(frames, pos + 1, (pos + 49) / 50) < pos + 1)
         return;
      frames[pos] = item;
     }
   ExportCSV();
//---
  }
이 형식은 다양한 도구를 사용하여 추가적인 분석을 할 수 있기 때문에 편리합니다: 스프레드시트부터 전문 분석 프로그램에 이르기까지. 우리는 이 작업을 위해 파이썬을 사용했습니다. MetaTrader 5는 해당 파이썬과의 통합 기능을 제공합니다. 이를 통해 매개변수 표면 연구를 수행할 수 있습니다: 값을 평활화하고 로컬 안정성을 평가하고 결과 분포를 살펴보고 인접 영역을 비교할 수 있습니다.
테스트 및 후속 분석을 위해 2020년 1월 1일부터 2026년 1월 1일까지의 H1 시간대 EURUSD 과거 데이터를 사용했습니다. 이 범위는 시장 패턴이 다양하게 나타날 수 있을 만큼 충분히 깁니다: 안정기, 돌발적인 움직임, 장기적인 추세, 그리고 변동성이 커지는 시기 등이 모두 나타날 수 있습니다. 이는 타당한 결과를 얻는 데 중요할 뿐만 아니라 최적화 표면이 인위적으로 매끄럽게 보이지 않도록 하는 데에도 중요합니다.
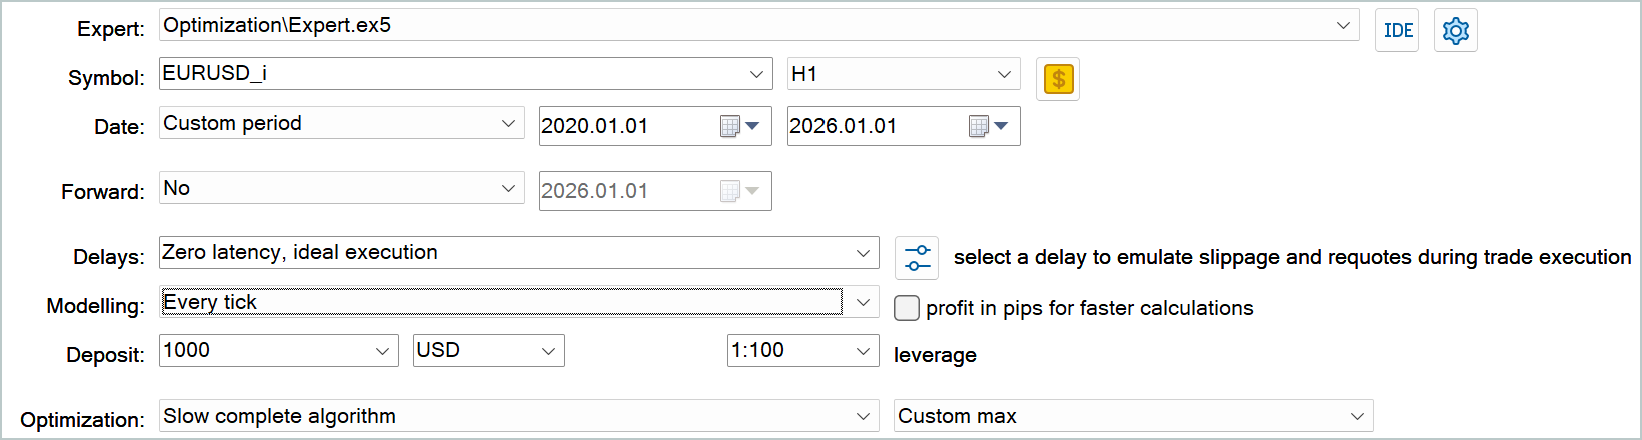
첫 번째 단계에서 EA는 빠른 EMA, 느린 EMA, 손절매 배율 및 이익 실현 배율이라는 네 가지 매개변수에 따라 최적화됩니다. 이 네 가지 매개변수는 전략의 기본 형태를 정의하고 시장에 대한 전략의 반응을 결정합니다. 이벤트 생성의 활성 범위를 확장하고 지나치게 좁은 필터링을 방지하기 위해 RSI 경계를 40과 60으로 변경했습니다. 이 구성에서는 모드 필터의 민감도가 높아지고 이벤트 모델이 덜 경직됩니다. 이를 통해 EA는 탐색 중인 시장 상태에 더 자주 진입할 수 있습니다. 따라서 더욱 표현력이 풍부한 최적화 영역을 형성할 수 있습니다.
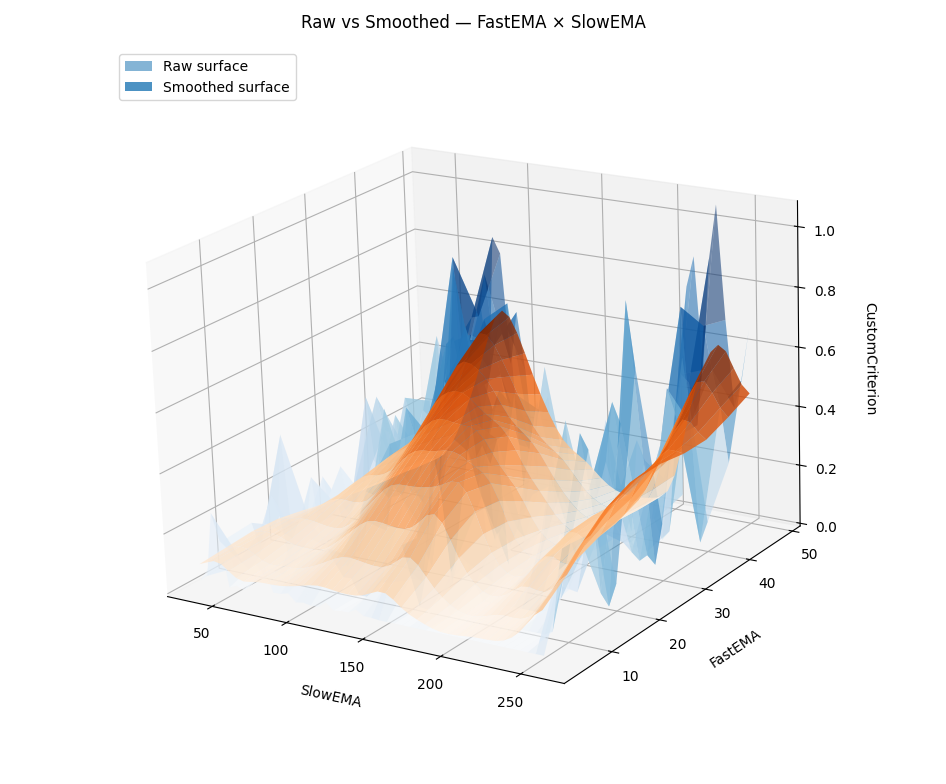
최적화가 완료되면 결과는 CSV 파일에 저장되고 파이썬 처리를 거칩니다. 여기서는 각 매개변수 쌍에 대해 pivot_table을 통해 가우스 평활화를 적용한 다음 2차원 표면이 구성됩니다. 그 결과 무작위로 나타나는 피크가 눈에 띄게 덜 두드러지는 보다 차분하고 매끄러운 기준 표면(연구 버전)이 생성됩니다.
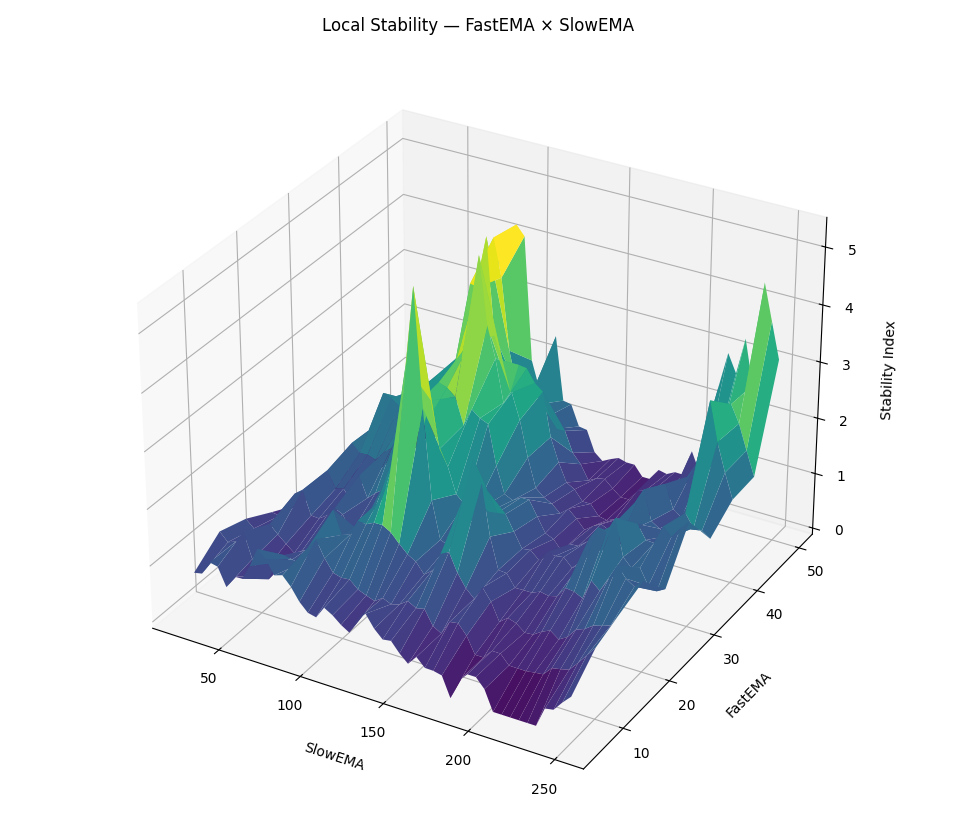
동일한 함수에서 로컬 안정성은 주변 영역의 평균값과 표준 편차의 비율로 계산됩니다.
그런 다음 표면이 급격하게 변하는 부분과 비교적 평평하게 유지되는 부분을 보여주는 경사도 지도가 작성됩니다.
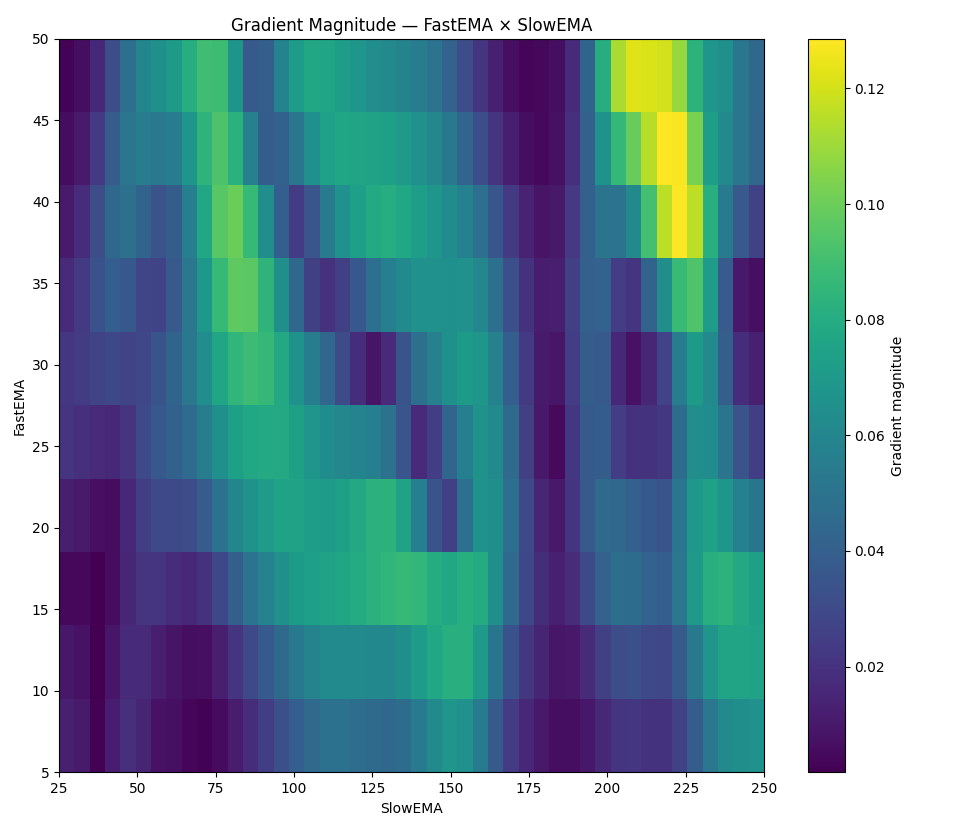
이러한 그래프를 통해 매개변수 공간에 넓은 평탄 영역이 있는지 아니면 좁고 불안정한 피크만 있는지 확인할 수 있습니다.
별도의 분석 레이어는 모든 매개변수에 대한 좌표 그래프를 한 번에 제공합니다. 구축 전에 매개변수가 정규화 되고 평행 좌표에서 선택된 기준에 따라 최상의 패스만 강조 표시됩니다. 이는 단일 성공 지점뿐만 아니라 다른 구성들 사이에서의 해당 지점의 위치까지 확인해야 할 때 편리합니다. 이 스크립트는 기준에 따라 가장 우수한 결과의 5%를 보여주므로 시각적인 정보와 함께 수치적인 뒷받침이 즉시 제공됩니다.
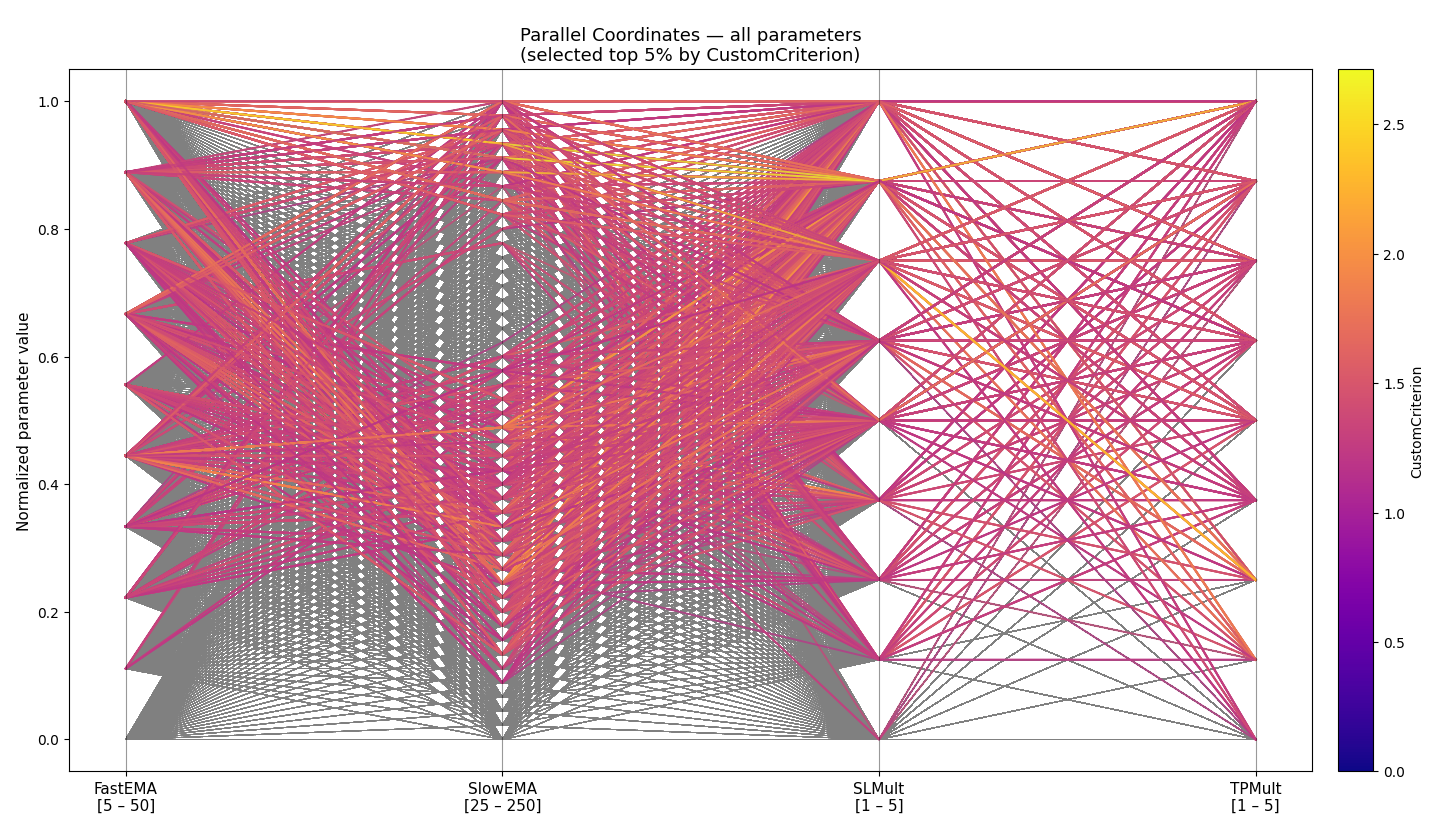
결과적으로 파이썬은 그 다음 단계의 분석 도구로 활용됩니다. MetaTrader 5는 최적화 영역을 제공하고 Python은 그 영역에서 노이즈를 제거하고 국소적인 안정성을 보여주고 인접 영역을 비교하며 진정으로 안정적인 매개변수 구간과 무작위로 나타나는 아름다운 피크를 구분하는 데 도움을 줍니다. 최적화는 더 이상 단일 수치를 기준으로 개별 패스를 정렬하는 것이 아닙니다. 이제 이는 다차원적인 표면에 대한 연구로 이어지는데 여기서는 기준값 뿐만 아니라 주변 영역 전체가 어떻게 작용하는지도 중요합니다. 이것이 바로 우리가 전략을 최적화 표면의 형태에 따라 안정성이 결정되는 시스템으로 더 깊이 살펴볼 수 있는 기회를 제공합니다.
최대값 찾기에서 안정적인 평탄 영역 찾기로
탐색적 최적화의 주요 목표는 결과를 최대화하는 것이 아니라 구성에 작은 변화가 있더라도 전략이 안정적으로 유지되는 매개변수의 범위를 찾는 것입니다.
이 차이는 중요합니다. 최적화 표면에서 단 하나의 높은 피크는 거의 항상 매력적으로 보입니다. 하지만 실제로는 그러한 극단적인 현상은 시장의 노이즈, 특정한 시기의 특성, 또는 단순히 모델의 과적합으로 인해 발생하는 경우가 많습니다. 테스트 환경에서는 괜찮아 보이지만 실제 시장에서는 그렇지 않을 수도 있습니다.
그렇기 때문에 결과를 파이썬에 업로드한 후에는 개별 패스가 아니라 매개변수의 표면을 전체적으로 살펴봐야 하는 것입니다.
우선 최적화 기준의 원본 표면과 평활화 된 표면을 비교하는 것이 유용합니다. 초기 표면은 불규칙적으로 보입니다: 국소적 돌출, 날카로운 최대값, 단일 피크 등이 많이 나타납니다. 이는 무작위적인 우연의 일치가 성공적인 해결책으로 바뀌어 버리는 전형적인 노이즈 최적화 사례입니다. 평활화 과정을 거치면 이러한 이상치 대부분이 사라지고 무작위적인 구조보다는 보다 안정적인 구조가 드러납니다.
아름다운 피크라고 해서 모두 믿을 만한 것은 아니라는 사실이 바로 이 지점에서 분명해집니다. 표면을 매끄럽게 한 후에도 부서지고 형태가 변형된다면 발견된 극단은 패턴이라기보다는 우연의 산물에 가까운 것입니다. 우리의 경우는 상황이 다릅니다: SlowEMA 주변에는 120~150 범위와 220~240 범위에서 뚜렷한 두 개의 능선이 남아 있습니다. 이는 우리가 일시적인 급증 현상을 다루는 것이 아니라 통계적으로 안정적인 패턴이라는 중요한 징후입니다. 게다가 여기서 최적의 방법은 날카로운 바늘이 아니라 넓은 빗과 같은 형태일 것으로 보입니다. 그리고 이건 사실 좋은 징조입니다. 견고한 전략은 드물게 한 곳에서 탄생합니다. 대부분의 경우 인접한 값들이 비슷한 결과를 나타내는 평탄한 영역에 머무릅니다.
그 다음에는 경사도 히트맵을 살펴보는 것이 좋습니다. 이 그래프는 EMA 매개변수가 변경될 때 목적 함수가 얼마나 빠르게 변하는지를 보여줍니다. 여기서 민감도가 증가하는 영역이 두드러지게 나타나는데 특히 SlowEMA 값이 70~90 및 200~220 범위에 있을 때입니다. 이러한 범위에서는 설정값의 작은 변화조차도 결과에 큰 영향을 미칠 수 있습니다. 그리고 이는 과잉 최적화의 위험이 증가할 수 있음을 직접적으로 시사하는 것입니다.
경사도 자체는 뚜렷한 수직적 특성을 지니고 있습니다. 이는 SlowEMA가 FastEMA 보다 결과에 훨씬 더 큰 영향을 미친다는 것을 의미합니다. 여기서의 논리는 매우 자연스럽습니다: 느린 평균은 시장 체제를 설정하는 반면, 빠른 평균은 시스템 동작의 진입점과 로컬 조정에 더 큰 영향을 미칩니다. 반대로 160~190 및 30~50 범위에서의 SlowEMA 주변 영역은 낮은 기울기를 보인다. 하지만 이 사실을 과대평가해서는 안 됩니다: 가공되지 않은 표면과 평활화 된 표면은 이러한 영역들이 진정한 생산성을 가진 영역이라기보다는 수익성이 매우 낮거나 거의 없는 영역임을 분명히 보여줍니다. 표면이 매끄럽다고 해서 그 전략이 가치 있는 것은 아닙니다.
평행 좌표 그래프는 사용자의 기준에 따라 상위 5% 구성에 대한 전체적인 그림을 완성합니다. 여기서 가장 중요한 점은 분명합니다: 지속 가능한 해결책은 하나의 마법과 같은 지점으로 수렴하지 않습니다. 대신 여러 가지 조합으로 나뉘어져 있습니다. 이것은 매우 중요한 신호입니다. 좁은 단일 최대값은 종종 인상적으로 보이지만 대개 과적합과 관련이 있습니다. 반대로 분산형 클러스터는 시스템이 여러 모드로 작동할 수 있음을 나타냅니다.
특히 최적의 구성일수록 FastEMA 값이 더 높은 경향이 있다는 점이 두드러집니다. 이는 당연한 결과입니다: 값이 매끄러워질수록 노이즈가 줄어들고 신호가 더 깨끗해지기 때문입니다. 동시에 SlowEMA는 여러개의 클러스터를 형성하는데 이는 전략 운영의 다양한 시장 모드라는 것을 나타낼 수 있습니다. SLMult 및 TPMult 매개변수는 더 고르게 분포됩니다. 이는 포지션 관리가 최종 결과에 미치는 영향이 EMA 신호 구조 자체보다 약하다는 것을 시사합니다. 즉 시스템의 핵심은 진입 로직에 있으며 트레이딩 관리는 부차적인 역할을 합니다.
다음 단계는 논리적으로 초기 매개변수 전체 범위가 아니라 안정적인 작동 징후를 보인 영역을 대상으로 진행됩니다. 첫 번째 단계 이후에는 FastEMA, SlowEMA, SLMult 및 TPMult를 표면이 넓은 고원처럼 보이는 영역으로 좁힙니다. 그런 다음 모델에 두 가지 매개변수, 즉 RSI 하한 및 상한을 추가하는데 이 단계에서 우리는 전체 진입 구조의 일부로 이를 최적화합니다. 이를 통해 우리는 전체 파라미터 배열에 한 번에 집중하는 것을 피하고 발견된 안정적인 구성에서 더 세밀한 조정으로 나아갈 수 있습니다.
이럴 때 포워드 테스트가 유용합니다. MetaTrader 5에서는 포워드 최적화 과정에서 지정된 기간이 자동으로 두 부분으로 나뉩니다: 첫 번째 부분은 최적화에 사용되고 두 번째 부분은 포워드 테스트에 사용됩니다. 또한 모든 실행 결과가 포워드 기간에 실행되는 것은 아닙니다. 가장 좋은 결과만 선택됩니다: 매개변수를 모두 열거하는 경우에는 가장 좋은 결과의 10%가 선택되고 유전자 알고리즘을 사용하는 경우에는 25%가 선택됩니다. 최적화 결과와 포워드 결과를 별도의 테스터 탭에서 비교할 수 있습니다. 이렇게 하면 적합성을 확인하기에 편리합니다. 이 기능을 사용하면 선택된 매개변수 클러스터가 훈련 히스토리 영역 외부에서도 안정적으로 유지되는지 확인할 수 있습니다.
첫 번째 단계에서 전략이 하나의 날카로운 피크에만 의존할 필요는 없다는 것이 이미 입증되었습니다. 이제 남은 과제는 감지된 파라미터 영역이 더욱 엄격한 테스트 모드로의 전환을 견딜 수 있는지 확인하는 것입니다. 포워드 테스트는 과거 데이터 기간에만 좋아 보이는 영역으로부터 안정적인 매개변수 영역을 구분하는 데 도움이 됩니다.
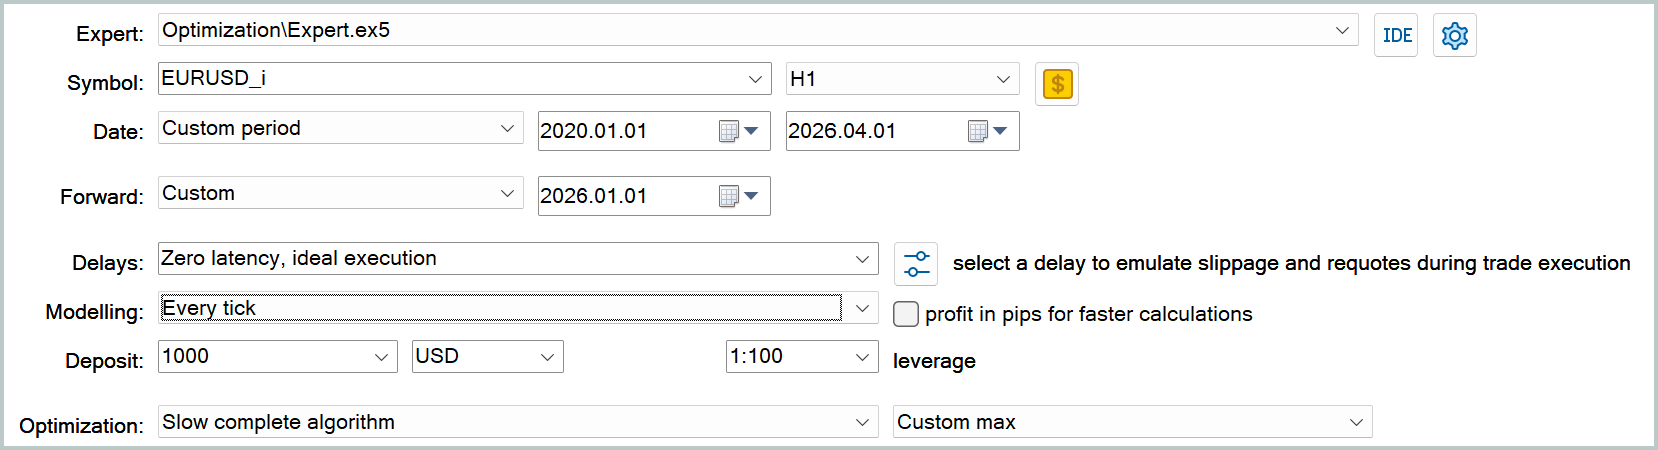
두 번째 단계에서는 과제가 바뀝니다. 이제 우리는 발견된 매개변수 영역이 새로운 데이터로 옮겨진 후에도 안정적으로 유지될 수 있는지에 관심을 갖고 있습니다. 이것이 바로 포워드 테스팅이 안정적인 평탄 영역 분석의 논리적인 연장선이 되는 이유입니다. 우리는 발견된 구성의 타당성을 독립적인 데이터 섹션에서 확인하는 것에 대해 이야기하고 있습니다. 이는 우리의 RSI 모드 필터가 포함된 EMA 모델에서 특히 중요합니다. 이러한 시스템은 최적화 기간 동안에는 매우 매력적인 결과를 보여주는 경우가 많지만 훈련 데이터 세트를 넘어서면 품질이 눈에 띄게 떨어집니다. 진정으로 안정적인 결정과 특정 시장 체제의 특성과 우연히 일치하는 변수를 구분할 수 있게 해주는 것이 바로 포워드 테스트입니다.
포워드 최적화 표를 보면 포워드 단계에서 사용자 기준의 최적값이 최적화 단계에서의 최적값과 반드시 일치할 필요는 없다는 것을 즉시 알 수 있습니다.
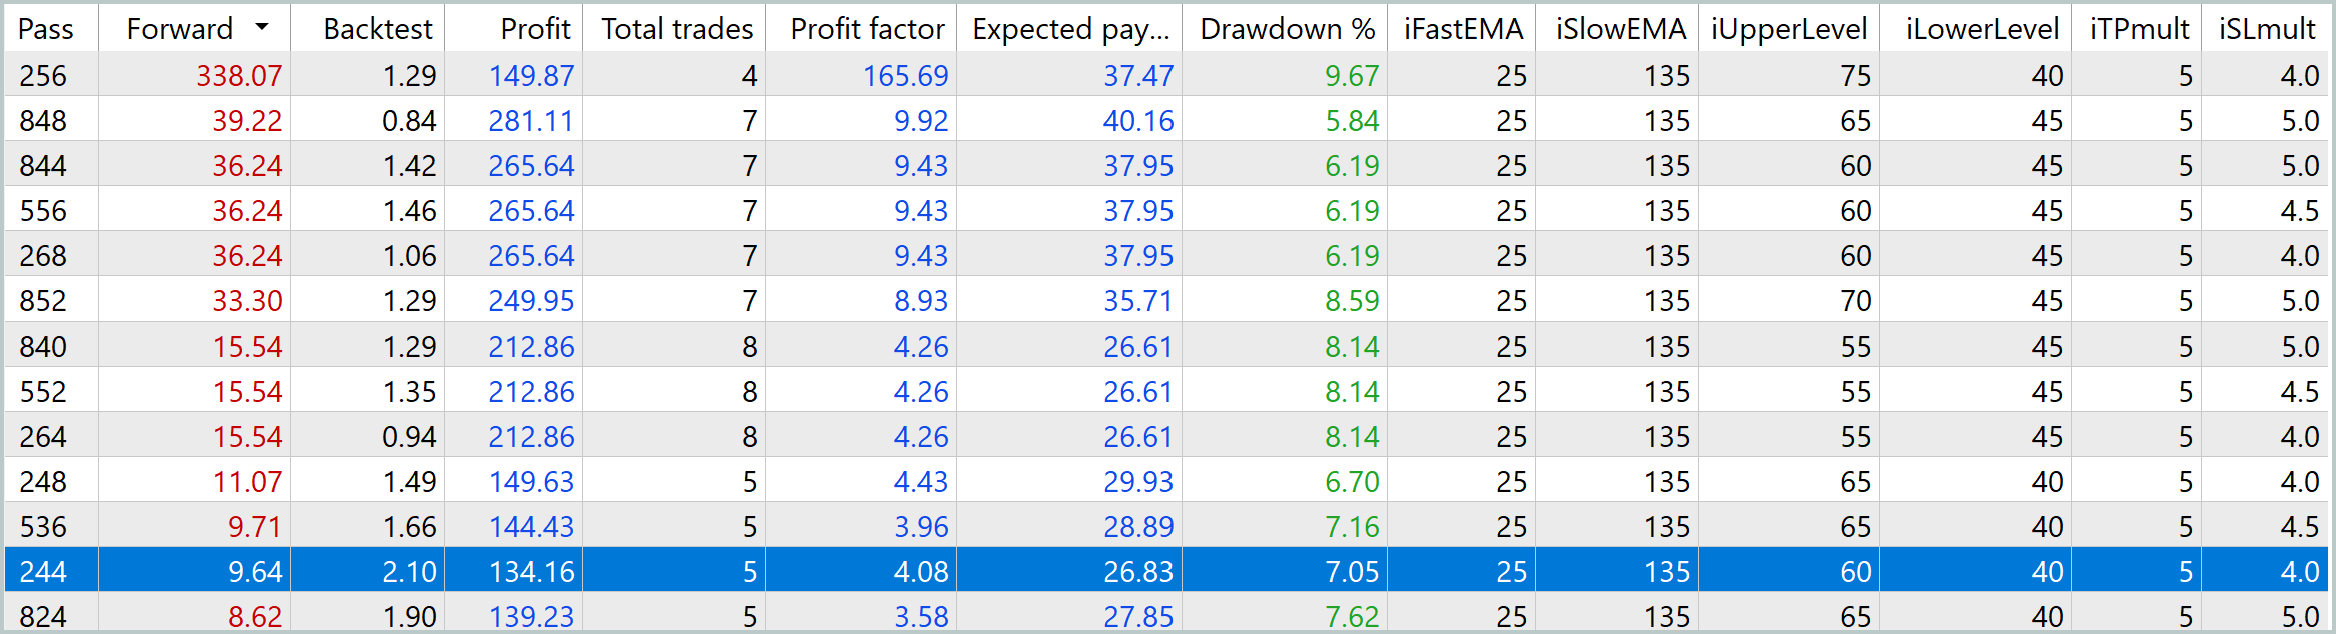
우리의 경우에는 표 상단에 최적화 기준이 매우 높은 패스들이 보이지만 자세히 살펴보면 이러한 결정 중 일부는 극히 적은 수의 거래를 기반으로 이루어졌다는 것을 알 수 있습니다.
표 상단의 RSI 레벨의 불균형은 특히 주목할 만합니다. 하한선은 40~45 정도로 정해져 있고 상한선은 75~90 범위에 속합니다. 이는 해당 모델이 실제로 전반적으로 상승 우위인 시장 환경을 고려하기 시작한다는 것이며 추세의 일방적인 경향으로 뚜렷하게 전환됨을 의미합니다. 이 디자인은 시장이 방향성 움직임을 강력하게 지지하는 구간에서는 매우 좋은 결과를 보여줄 수 있지만 시장 상황이 바뀌면 효과가 크게 떨어집니다. 다시 말해 과적합의 위험이 이미 여기서 드러나고 있습니다: 해당 전략이 특정한 역사적 시기의 특성에 너무 잘 맞춰져 있다는 것입니다.
이러한 배경을 고려할 때 244 패스 라인은 훨씬 더 매력적으로 보입니다. 이는 해당 기준의 극단적인 값을 제시하지는 않지만, 훨씬 더 균형 잡힌 결과를 보여주므로 아마도 더 견고해 보일 것입니다. 이 구성에는 다음 매개변수가 사용되었습니다:
- iFastEMA = 25,
- iSlowEMA = 135,
- iUpperLevel = 60,
- iLowerLevel = 40,
- iTPmult = 5,
- iSLmult = 4.
이러한 조합은 더 이상 특정 유리한 시장 부문에서 최대한의 이익을 짜내려 하지 않고 보다 균형 있고 절제된 진입 구조를 형성합니다. 결과적으로 이 전략은 134.16달러의 수익, 4.08의 수익계수, 7.05%의 드로다운, 그리고 5회의 거래를 기록했습니다. 이 기간 동안에는 이것이 완전히 실현 가능하면서도 동시에 신중한 프로필로 보입니다.
이러한 매개변수 세트에 대한 잔고 그래프와 평가 금액은 동일한 결과를 보여줍니다.
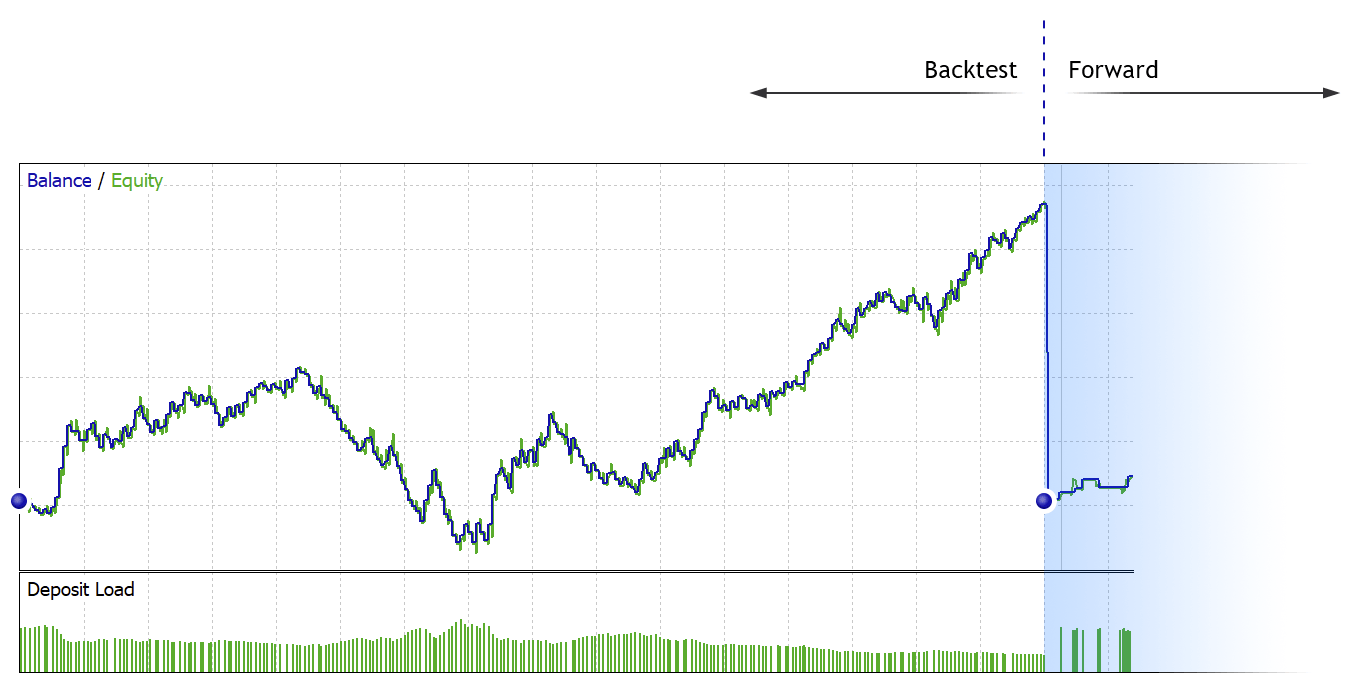
최적화 및 포워드 테스트의 두 기간에 대한 단일 패스 그래프.
72개월에 걸친 최적화 단계 동안 해당 전략은 259건의 거래를 완료했으며 최대 잔고 드로다운 63.57% 및 수익계수 1.25에서 141.16%의 수익률을 기록했습니다.
3개월 선행 테스트 기간 동안 5건의 거래가 이루어졌으며 수익률은 13.42% 드로다운은 3.91%, 수익계수는 4.08을 기록했습니다.
1,000달러 예치금으로 시작하는 이 전략은 초기에는 약 1,700달러 수준까지 성장세를 보이다가 이후 상당한 조정을 거쳐 2022년 9월에는 약 620달러의 최저점까지 하락합니다. 이후 장기간의 회복세와 지속적인 상승세가 이어져 최적화 기간이 끝날 무렵에는 약 2400달러 수준에 도달할 것으로 예상됩니다. 포워드 구간에서도 잔고가 향상하는 경향이 뚜렷하게 나타나는데 이는 선택된 구성의 실용성에 대한 결론을 더욱 뒷받침합니다.
따라서 포워드 최적화를 통해 우리는 지나치게 공격적이고 통계적으로 취약한 솔루션 특히 PF가 8을 초과하는 구성을 걸러낼 수 있었는데, 자세히 살펴보면 이러한 구성은 테스트 기간에 맞춰 조정된 것으로 밝혀졌습니다. 이러한 배경을 고려할 때 244 패스가 가장 균형 잡힌 옵션으로 보입니다: 적절한 수익성, 적당한 드로다운, 그리고 독립적인 데이터 섹션에서 충분한 안정성을 모두 갖추고 있기 때문입니다. 탐색적 최적화에서 가장 큰 관심을 끄는 것은 바로 이러한 솔루션들입니다 — 가장 눈에 띄는 정점을 만들어내기 때문이 아니라 시간과 변화하는 시장 상황의 시험을 더 잘 견뎌내기 때문입니다.
결론
이 글에서는 의도적으로 최대 수익 추구에서 벗어나 트레이딩 전략의 지속 가능성에 대한 연구로 초점을 옮겼습니다. 이러한 접근 방식은 최적화의 논리 자체를 바꿉니다. 핵심은 단 한 번의 성공적인 실행에 있는 것이 아니라 모든 변수의 표면을 종합적으로 살펴보는 것입니다: 전략이 견고하게 유지되는 지점, 형태가 흔들리기 시작하는 지점, 그리고 위태롭고 취약한 피크로 변하는 지점 등. 이것이 바로 최적화 프레임이 특히 유용한 이유입니다. 이를 통해 결과의 구조, 인접한 구성에서의 동작 방식, 그리고 매개변수의 작은 변화에 따른 모델의 품질 변화를 살펴볼 수 있습니다. 이러한 점에서 프레임은 엔지니어링적 진단을 위한 도구가 됩니다.
이상 이 연구의 주요 결론은 다음과 같습니다.
진정한 최적화는 수익 극대화가 아니라 무엇을 정확히 최적화했는지에 대한 이해도를 극대화하는 것입니다.
바로 이러한 이유로 이 글에서는 가장 수익성이 높은 전략이 아니라 매우 간단하고 투명한 전략을 선택했습니다. 여기서 이는 방법론적 이점을 의미합니다. 우리는 기본적인 최적화 및 안정적인 평탄 영역 선택부터 훈련 영역 외부에서의 포워드 테스트 및 결과 분석에 이르기까지 프로세스 자체를 보여줄 수 있는 순수한 실험 환경이 필요했습니다. 이러한 선택을 통해 불필요한 번거로움 없이 핵심을 보여줄 수 있습니다 — MetaTrader 5의 최적화 기능은 개발자가 시장 상황 변화에도 안정적인 영역을 찾기 시작할 때 특히 명확하게 드러납니다.
이 글에서 사용된 프로그램
| # | 이름 | 타입 | 설명 |
|---|---|---|---|
| 1 | Expert.mq5 | Expert Advisor | 이 글에서 최적화한 전략용 EA |
| 2 | CrossEMA.mq5 | 지표 | EMA 교차 시 이벤트 발생 지표 |
| 3 | RSI.mq5 | 지표 | 레벨을 교차할 때 이벤트가 생성되는 RSI |
| 4 | postanalysis.py | 스크립트 | 파이썬 으로 작성된 사후 분석 스크립트 |
| 5 | defines.mqh | 코드베이스 | 매크로 치환 및 공통 메서드 라이브러리 |
MetaQuotes 소프트웨어 사를 통해 러시아어가 번역됨.
원본 기고글: https://www.mql5.com/ru/articles/22578
경고: 이 자료들에 대한 모든 권한은 MetaQuotes(MetaQuotes Ltd.)에 있습니다. 이 자료들의 전부 또는 일부에 대한 복제 및 재출력은 금지됩니다.
 새로운 기능: MQL5의 커스텀 인디케이터
 행렬에서 모델로: MQL5에서 머신러닝 파이프라인을 구축하고 ONNX로 내보내는 방법
 새 MetaTrader 와 MQL5를 소개해드립니다
 MetaTrader 5의 강력한 기능: 통합 개발 환경에서의 단계별 디버깅부터 EX5 보호까지
