
Está perdiendo oportunidades comerciales:
- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Registro
Entrada
Usted acepta la política del sitio web y las condiciones de uso
Si no tiene cuenta de usuario, regístrese
Es inequívoco. Mientras se compare una opa con un dedo, no participaré más en el diálogo. Además, yo no lo empecé.
Esencialmente la probabilidad futura y la agrupación de estados son lo mismo, ¿cuál es la diferencia?
Esencialmente, la probabilidad futura y la agrupación de estados son lo mismo, ¿cuál es la diferencia?
Va duro, ¿verdad? Probabilidades brutas sin umbral frente a agrupaciones ya con umbral
En realidad, hay una similitud, una línea es un promedio de patrones, sí, más es menos, y ¿cómo caracterizar el movimiento? Sólo por la distancia recorrida, y la distancia es sólo por la distancia más pequeña, es decir, una cuadrícula. Sí, las entidades discretas son más complicadas que las continuas, pero lo que tenemos es con lo que trabajamos)).
Prefiero transmitir un juguete. ¿Qué otra cosa se puede hacer un sábado?
https://www.twitch.tv/gamearbuser
Tengo un hijo que trabaja a tiempo parcial como comentarista en comp races)))). Bueno, y en la vida real en el kart también y patina él mismo))))))
Tengo un hijo que trabaja a tiempo parcial como comentarista en las carreras comp)))). Bueno, y en la vida real en el kart también y él mismo patina)))))
que transmita como patina ) luego recogerá donativos.
fijar fecha
información sobre la cotización de las 10 primeras acciones.
última línea - objetivo
dividir la selección en dos para entrenamiento y prueba
en el Forrest sin afinar obtengo en los nuevos datos
en hgbusta con las nuevas características que obtuve Akurashi 0,83.
Me pregunto si es posible lograr 0,9 Akurasi ?
¿Nadie lo ha tocado siquiera? (
Yo lo toqué sólo por diversión).
Usado Random forest.
Variables no utilizadas:
X_OI
X_PER
X_TICKER
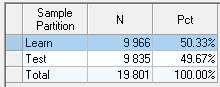
Como se pidió, treyne y prueba por la mitad.
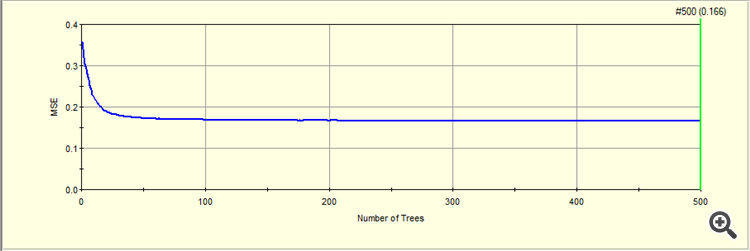
Limité el máximo de árboles cultivados a 500.
MSE en la prueba para 500 árboles cultivados
MSE en la prueba para 500 árboles cultivados
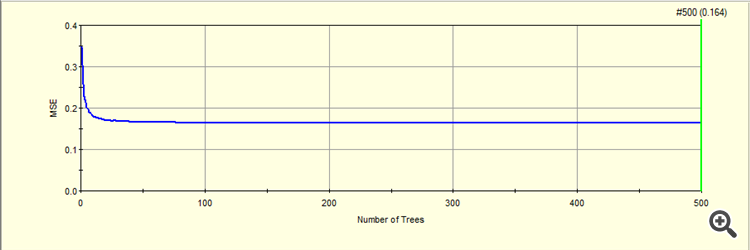
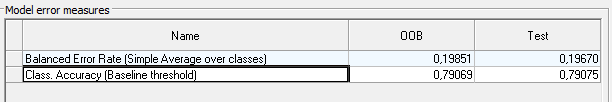
La métrica resultante en traine(OOB) y en la prueba.
Aquí no sé cómo llevar su precisión 0 ,77 bosque aleatorio a esta métrica.
Probablemente usted debe restar MSE de uno,
1- 0,16 = 0,84
A continuación, se obtiene la precisión que tiene en XGBoost )).
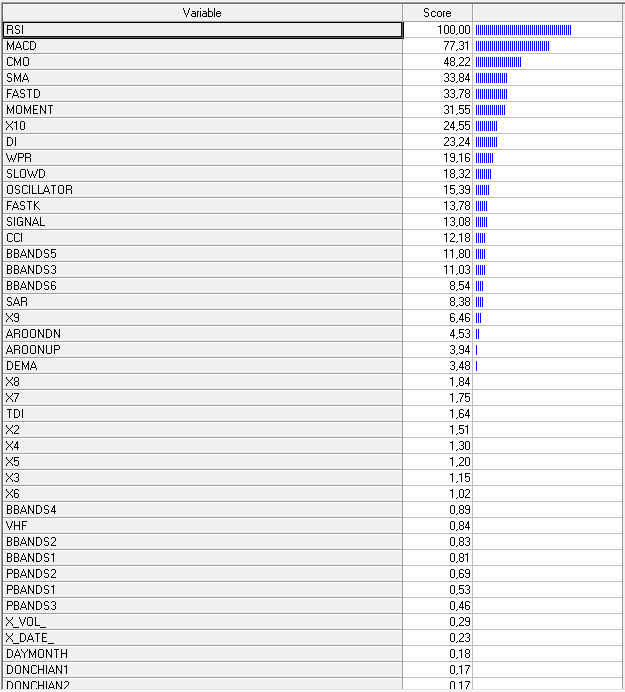
Bueno, y las variables que contribuyen a la formación.
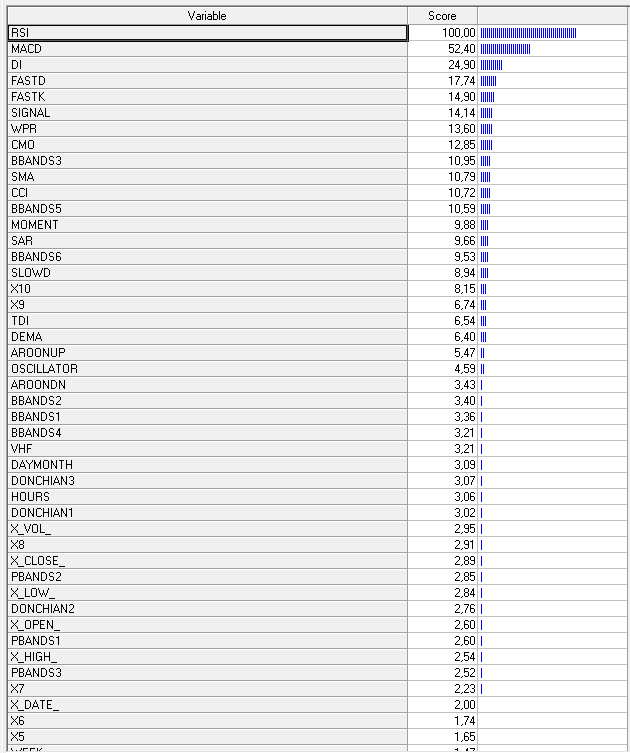
Este es el tipo de análisis que tengo )
Lo toqué sólo por diversión )
Usado Bosque aleatorio.
Variables no utilizadas:
X_OI
X_PER
X_TICKER
Según lo solicitado, pista y prueba por la mitad.
Bueno OHLC precios absolutos probablemente debería ser desechado también ) como escribí )
MSE en trayne para 500 árboles crecidos
MSE en prueba para 500 árboles cultivados
La métrica resultante en traine (OOB) y en la prueba.
Aquí no sé cómo llevar su precisión 0 ,77 Bosque aleatorio a esta métrica.
Probablemente MSE debe restarse de uno,
¡Estás haciendo regresión, estás haciendo clasificación! Lo has entendido todo mal.
Bueno los precios absolutos de OHLC probablemente deberían ser desechados también ) mientras escribo esto
Estás haciendo regresión, ¡deberías estar haciendo clasificación! Lo has entendido todo mal.
Aquí está la clasificación, sin OHLC.
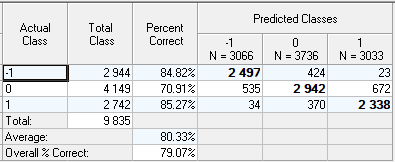
La precisión es de 0,79.
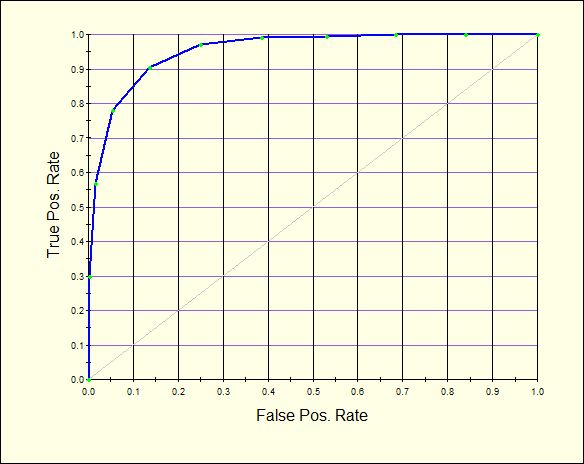
Prueba ROC.
Matriz de confusión.
Variables influyentes
Aumento del gradiente
en el trayne, el asscgasu subea 0,85
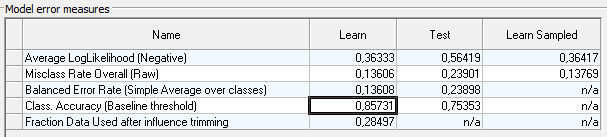
pero en el test baja a 0,75.
Como opción para elevar el assgassu, se puede intentar aproximar la influenciade las variables significativas , para cada clase -1, 0, 1
Para utilizar estas splines como nuevas variables.
Por ejemplo, para la clase 1, la influencia de RSI fue la siguiente
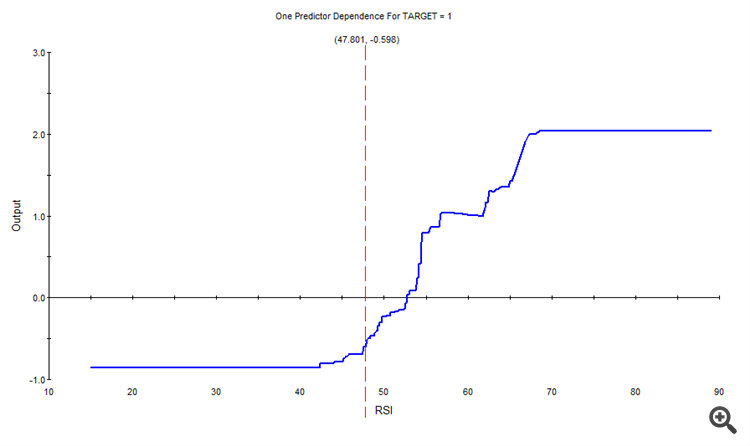
Aproximada, obtenemos una nueva spline.
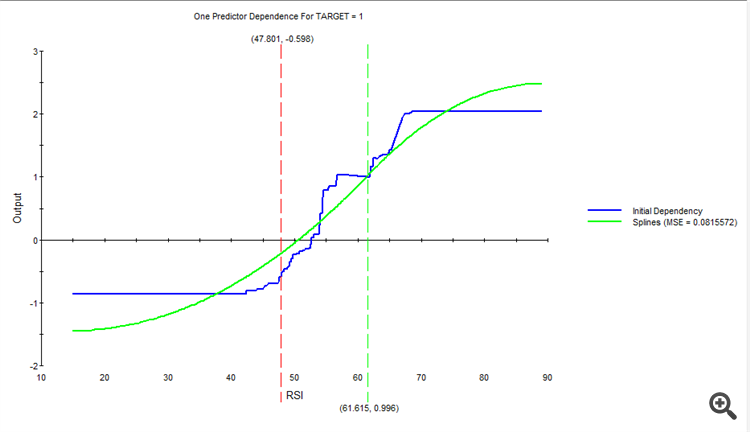
Y así sucesivamente, para cada variable y cada clase.
Como resultado, se obtendrá un nuevo conjunto de splines, que alimentamos a la entrada en lugar de las variables originales.
Refuerzo de gradiente
en el traine, la gananciasube a 0,85
pero baja a 0,75 en la prueba
Como opción para elevar el asssugasu, se puede tratar de aproximar el efecto de las variables significativas , para cada clase -1, 0, 1
Para utilizar estas splines como nuevas variables.
Por ejemplo, para la clase 1, el impacto de RSI fue el siguiente
Aproximado, obtenemos un nuevo spline.
Y así sucesivamente, para cada variable y cada clase.
Como resultado, obtenemos un nuevo conjunto de splines, que alimentamos a la entrada en lugar de las variables originales.