Машинное обучение в трейдинге: теория, модели, практика и алготорговля - страница 2819

Вы упускаете торговые возможности:
- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Регистрация
Вход
Вы принимаете политику сайта и условия использования
Если у вас нет учетной записи, зарегистрируйтесь
Gradient Boosting
на трейне аccuracy повышается до 0,85
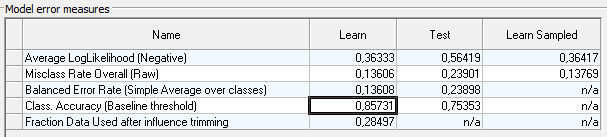
но на тесте падает до 0,75
Как вариант для поднятия аccuracy, можно попробовать аппроксимировать влияние значимых переменных, для каждого класса -1, 0, 1
Для использования этих сплайнов в качестве новых переменных.
Например для класса 1, влияние RSI было таким
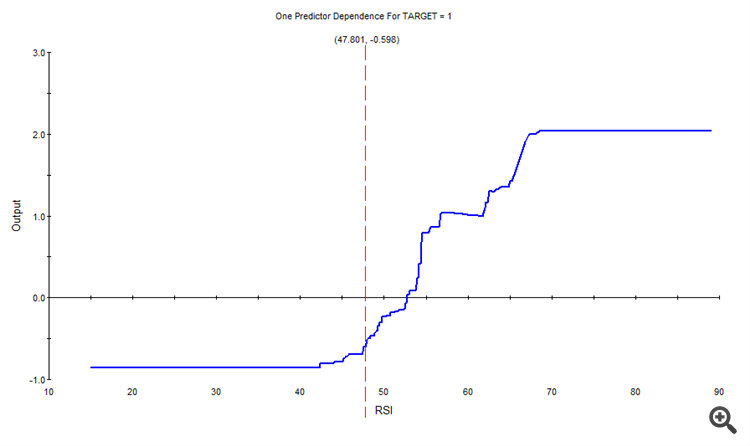
Аппроксимировали, получили новый сплайн.
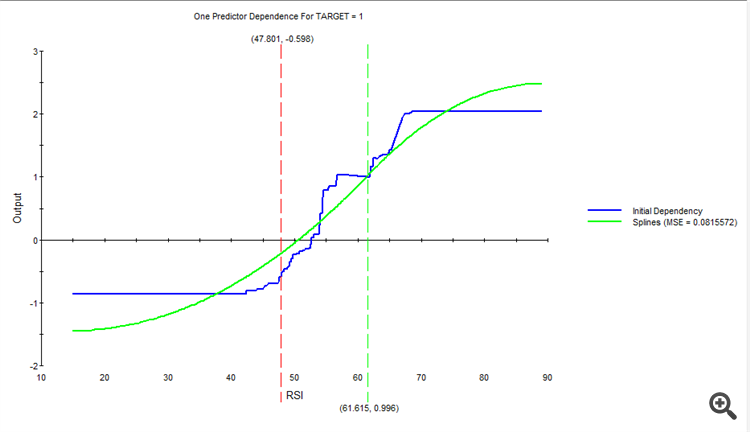
И так далее, для каждой переменной и каждого класса.
В итоге, наберётся новый набор сплайнов, который подаём на вход вместо исходных переменных.
Gradient Boosting
на трейне аccuracy повышается до 0,85
но на тесте падает до 0,75
Как вариант для поднятия аccuracy, можно попробовать аппроксимировать влияние значимых переменных, для каждого класса -1, 0, 1
Для использования этих сплайнов в качестве новых переменных.
Например для класса 1, влияние RSI было таким
Аппроксимировали, получили новый сплайн.
И так далее, для каждой переменной и каждого класса.
В итоге, наберётся новый набор сплайнов, который подаём на вход вместо исходных переменных.
В данных примерах все возможные отношения между переменными, автоматом были установлены.
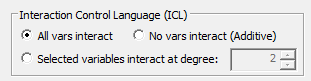
Хотя можно их отключить, или задать конкретные переменные для связи.
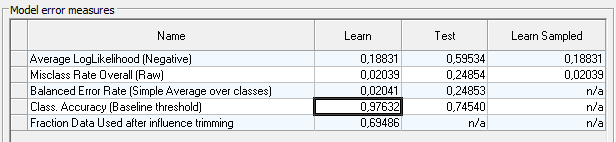
Поигрался с тюнингом без апроксимации, увеличил количество узлов на дерево до количества переменных.
Моделька усложнилась, обучалась 12 минут.
на трейне аccuracy поднялось до 0,97
но тест всё портит на 0,74
В общем наверно есть над чем поработать и подумать. Может что и выжмется.
В проге много разных настроек, просто не до конца их понимаю как с ними работать.
Сам только изучаю функционал со вчерашнего дня ))
А твой дата сет как раз кстати подвернулся, для изучения функционала, ну может что и выжмется из твоих данных.
Не совсем понял,что ты представляешь под автоматическим конструктором признаков?
Авто поиск самих признаков, или авто поиск отношений между имеющимися признаками?
В данных примерах все возможные отношения между переменными, автоматом были установлены.
Хотя можно их отключить, или задать конкретные переменные для связи.
Не, я о совсем другом ..
Я имел в виду что обучал xgboost на других признаках чтобы получить акураси 0,83 на новых данных.
Конструировались признаки из OHLC и еще индикатор
по принципу
O[i] - H[i-1]
L[i-5]-indic[i-10]
........
....
..
и так все возможные комбинации (все со всеми)
получилось около 10к признаков
из них 300 полезных..
модель дала 0,83 на новых данных
===========
Не совсем понял,что ты представляешь под автоматическим конструктором признаков?
А вот описаное выше я хочу автоматизировать чтобы комп сам констуировал признаки, и тогда уже там будет не 10к признаков на выбор а миллиард например..
Авто поиск самих признаков, или авто поиск зависимостей между имеющимися признаками?
автоматическое создание/конструирование признаков ---> опробование на пригодность ---> селекция лучших ---> возможно мутация лучшых в поисках еще лучшых ...
И все на автомате.
По мотивам МГУА , если читал.. но только по мотивам..
В проге много разных настроек, просто не до конца их понимаю как с ними работать.
Сам только изучаю функционал со вчерашнего дня ))
А твой дата сет как раз кстати подвернулся, для изучения функционала, ну может что и выжмется из твоих данных.
Что это за программа?
геометрическую вероятность почитай
реально пень, за каждое слово цепляется
у тебя тотальная когнитивная дистрофия, как ты вообще спорить можешь о чем-то