
행렬에서 모델로: MQL5에서 머신러닝 파이프라인을 구축하고 ONNX로 내보내는 방법
 16
 2

소개
머신러닝(ML)이 터미널에서 위압적으로 보이는 이유는 모델 자체라기보다는 그 주변의 모든 것들 때문입니다. 보기에는 별도의 기술 스택, 파이썬 스크립트, 복잡한 통합 없이는 작업이 불가능해 보일 수도 있습니다. 결과적으로 우리는 ML이 MetaTrader 5와 관련해서 보면 별개의 외부적인 요소라는 느낌을 받게 됩니다.
하지만 불필요한 층들을 제거하고 나면 그림이 훨씬 선명 해집니다. 모든 머신러닝 파이프라인은 다음과 같은 기본 작업들의 연속입니다: 피처 생성, 스케일링, 중복 제거, 그리고 결과를 모델에 전달하는 것. 이것은 신경망의 마법이 아니라 일반적인 선형대수입니다.
자, 이제 핵심입니다. 데이터 준비는 MQL5의 임무입니다. 터미널에서는 피처 추출과 정규화 작업이 수행되며 필요한 경우 주성분 분석(PCA;Principal Component Analysis)도 진행됩니다. 이를 통해 데이터의 차원을 축소하고 상관 관계가 있는 노이즈를 제거할 수 있습니다. 즉 모델이 사용되는 곳에서 모델까지의 전체 데이터 경로가 그대로 재현되어야 합니다. 이것 없이는 결과 비교가 불가능합니다.
이는 파이프라인을 부분적으로 이전하려는 시도는 언제나 일관성을 깨뜨리기 때문에 매우 중요합니다. 파이썬 에서는 데이터가 한 방향으로 흐르지만 터미널에서는 다른 방향으로 흐릅니다. 차이는 미미할 수 있지만 모델 입장에서는 이미 완전히 다른 영역입니다. 결과적으로 신호는 사라지지 않습니다 - 단지 왜곡될 뿐입니다.
이 시점에서 파이썬의 역할은 훨씬 더 간단하고 정확 해집니다. 모델을 학습시키고 정규화, PCA 및 가중치와 같은 매개변수를 계산하는 데 사용됩니다. 이후 모델은 ONNX (Open Neural Network Exchange) 형식으로 내 보내집니다. ONNX는 계산 그래프를 보존하고 코드를 다시 작성하지 않고도 모델을 전송할 수 있도록 하는 형식입니다.
그 이후의 모든 결정은 MQL5에 의해 이루어집니다. ONNX 모델은 계산을 수행하지만 입력값을 제어하지는 않습니다. 즉 학습 중에 사용된 것과 동일한 데이터 경로를 터미널이 재현해야 한다는 의미입니다.
바로 이 지점에서 행렬이 중요한 역할을 합니다. 내장된 행렬 및 벡터를 통해 수학에서 정의된 그대로 모든 변환을 직접 설명할 수 있습니다. 정규화, 투영, 입력 준비 등 이 모든 과정은 중간 왜곡 없이 일련의 선형 연산으로 수행됩니다. 해당 코드는 방정식을 해석하는 것이 아니라 방정식을 그대로 반복합니다.
바로 이 순간이 복잡하다는 느낌이 사라지는 순간입니다. 머신러닝은 더 이상 서로 다른 기술들의 집합처럼 보이지 않고 터미널 내에서 완벽하게 제어되는 일련의 명확한 단계로 변하게 되는 것입니다.
이 글에서는 행렬과 벡터를 주요 도구로 사용하여 불필요한 이론 없이 순차적으로 이 과정을 살펴보겠습니다. 핵심은 훈련 환경과 실제 트레이딩 환경 모두에서 재현 가능한 결과를 얻는 방법에 있습니다.
파이프라인의 기반으로서의 행렬: 피처부터 데이터 공간까지
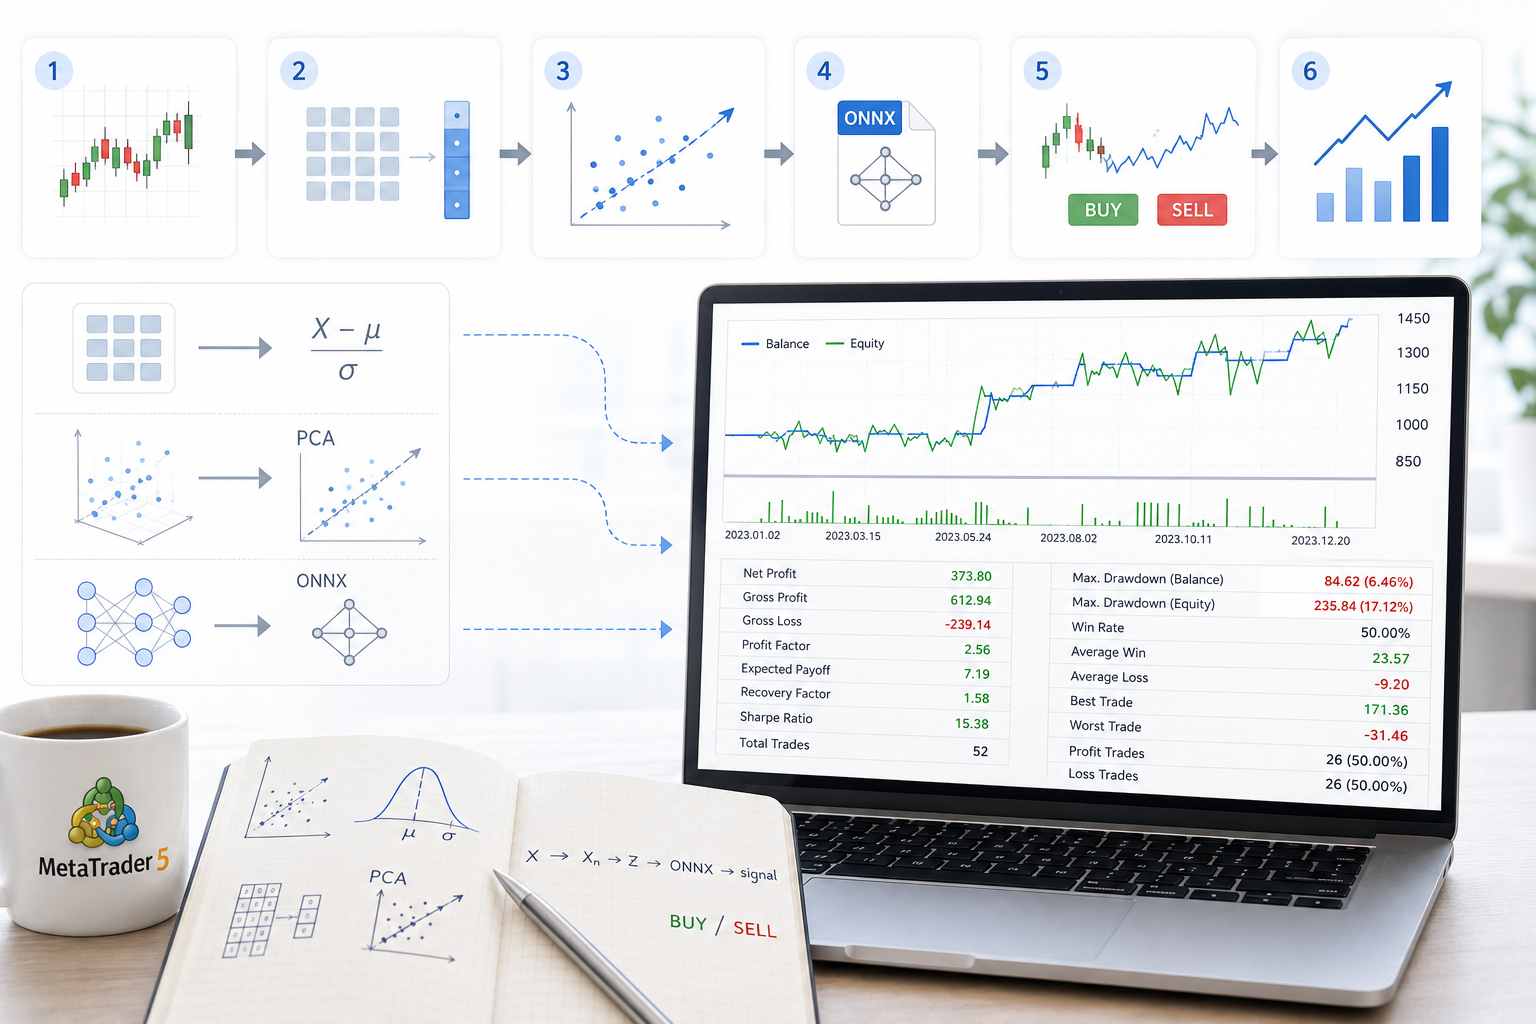
시장 데이터는 지속적인 가격의 흐름입니다. 하지만 모델 자체는 시장 데이터를 직접적으로 작업하지 않습니다. 미리 준비된 피처 데이터 세트가 필요합니다: 수익률, 범위, 편차, 시차. 여기서 곧바로 실질적인 질문이 제기됩니다: 각 피처를 개별적으로 유지할 것인가 아니면 하나의 구조로 통합할 것인가? 실제로 두 번째 방법이 훨씬 더 안정적인 것으로 나타났습니다.
따라서 피처들을 X 행렬로 모아서 표현하는 것이 편리하며 이 행렬의 행은 관측치에 해당하고 열은 피처에 해당합니다. 이 시점부터 데이터는 더 이상 개별 값들의 산포가 아닙니다. 데이터는 순차 처리를 위해 단일 객체가 됩니다. MQL5에 내장된 행렬 연산을 사용하면 개별 값이 아닌 전체 데이터 공간에 대해 한 번에 변환을 수행할 수 있습니다. 이는 코드뿐만 아니라 처리 로직까지 변경합니다.
이는 특히 정규화에 있어 중요합니다. 시장 피처는 가격, 범위, 수익률, 편차, 볼륨 등에 거의 항상 다양한 규모로 존재합니다. 이들이 서로 비교 가능한 형태로 변환되지 않으면 모델은 신호 구조가 아닌 숫자의 크기에만 반응하기 시작할 것입니다. 따라서 정규화는 데이터 준비 과정에서 필수적인 단계입니다. MQL5 측에서 이를 처리하는 것이 더 편리합니다. 여기서 내장된 행렬 및 벡터를 사용하면 시장 시계열 데이터를 즉시 얻은 다음 준비된 행렬에 Mean 및 Std와 같은 통계 연산을 직접 적용할 수 있습니다.
   matrix<double> vRates;
   if(!vRates.CopyRates(cSymbol.Name(), PERIOD_CURRENT, COPY_RATES_OHLC | COPY_RATES_VERTICAL, 1, HistoryBars))
     {
      PrintFormat("Error of load rates %d", GetLastError());
      return;
     }
   matrix<double> means=matrix<double>::Zeros(vRates.Rows(),vRates.Cols());
   matrix<double> STDs=matrix<double>::Zeros(vRates.Rows(),vRates.Cols());
   means.Row(vRates.Mean(0),0);
   STDs.Row(vRates.Std(0)+DBL_EPSILON,0);
   means=means.CumSum(0);
   STDs=STDs.CumSum(0);
   vRates=(vRates-means)/STDs;
언뜻 보면 ONNX 모델 내부에 정규화를 숨기는 것이 더 쉬워 보일 수 있습니다. 하지만 이 해결책에는 한계가 있습니다. MQL5에서 ONNX는 주로 실행 계층으로 간주됩니다. 모델은 OnnxCreate를 통해 로드 됩니다. 그런 다음 입력 및 출력 형태가 지정됩니다. 그 후 OnnxRun을 통해 실행됩니다. 이는 추론에는 매우 유용하지만 입력 공간 관리 측면에서는 같은 편의성과 투명성을 제공하지 못합니다. MQL5에서 정규화를 설정하면 테스터나 차트에서 직접 실제 시장 데이터와 비교하여 테스트, 반복, 변경 및 비교가 더 쉬워집니다.
한 가지 더 중요한 점이 있습니다. 종목이나 차트 주기를 변경하면 데이터 분포가 달라집니다. 정규화가 ONNX 그래프에 내장되어 있으면 모델은 이전 입력 분포에 엄격하게 종속되는 것으로 나타납니다. 따라서 환경에 중요한 변화가 생기면 단순히 특정 분야에 대한 조정만으로는 부족하며 전체를 다시 훈련하고 다시 내보내기 해야 합니다. MQL5에서 정규화가 설정되어 있는 경우 해당 매개변수를 업데이트하고 필요한 스케일의 데이터를 모델에 제공하기만 하면 됩니다. 이렇게 하면 입력 구조가 유지되므로 전체 모델을 전부 다시 구축할 필요가 없습니다.
이것이 바로 터미널의 외부 행렬 계층이 ONNX 내부에서 모든 것을 하려는 시도보다 더 큰 유연성을 제공하는 이유입니다. 파이썬에서는 모델을 한 번만 학습시키면 됩니다. MQL5에서는 데이터가 매번 일관된 방식으로 변환됩니다. 이 아키텍처의 강점은 바로 여기에 있습니다: 모델은 모델로서의 역할을 유지하고 터미널의 행렬과 벡터가 입력값을 준비하고 제어하는 역할을 담당한다는 점입니다.
압축 및 안정화: 행렬 로직의 확장으로서의 PCA
시장 지표는 거의 언제나 독립적이지 않습니다. 가격, 수익률, 변동폭, 편차 - 이 모든 것은 동일한 움직임을 나타내는 서로 다른 표현입니다. 결과적으로 데이터 내에 중복이 발생합니다: 여러 피처들이 서로 다른 관점에서 동일한 시장 행동을 설명합니다. 모델에게 이는 신호의 개선이 아니라 잡음과 불안정성의 원인이 됩니다.
이것이 바로 PCA(주성분 분석)이 필요한 부분입니다. 이는 행렬 접근법의 자연스러운 연장선이 됩니다. 이 방법의 이면의 아이디어는 간단합니다: 모델에 모든 데이터를 한 번에 입력하려 하지 말고 데이터의 분산을 대부분 포착하는 더 압축된 구성 요소로 정보를 모으라는 것입니다.
수학적 관점에서 볼 때 새로운 것은 아무것도 나타나지 않습니다. 이는 선형대수와 동일합니다. 피처 행렬 X는 중심화 된 후 고유벡터 행렬과 곱해집니다. 그 결과 시장 변화의 독립적인 구성 요소를 나타내는 피처들이 존재하는 새로운 공간이 탄생했습니다.
여기서 중요한 것은 방정식 자체가 아니라 그 효과입니다. PCA는 두 가지 문제를 동시에 해결합니다. 한편으로는 불필요한 차원을 제거하여 피처 공간을 압축합니다. 다른 한편으로는 잡음과 상관관계가 더 이상 변수들의 집합 간에 신호를 분산시키지 않기 때문에 데이터가 안정화됩니다. 이제 이 모델은 더욱 깔끔한 데이터 구조를 사용하여 작동하기 시작합니다.
실질적인 효과는 즉시 나타납니다. 학습이 더욱 견고해지고 모델의 동작이 더욱 예측 가능해지며 작고 무작위 적인 변동에 대한 민감도가 감소합니다. 게다가 코드는 더 복잡해지지 않습니다. 달라지는 것은 이미 준비된 X에 대한 또 다른 행렬 연산뿐입니다.
여기서 중요한 것은 이전과 동일한 아키텍처 논리를 유지하는 것입니다. PCA는 별도의 계산 및 사이클로 설정되지 않습니다. MQL5에서는 단일한 행렬 처리 체계 일부로 남아 있습니다.
그 결과 데이터는 단일 스케일로 통합될 뿐만 아니라 구조적으로도 단순화됩니다. 이렇게 중복성은 제거되지만 정보의 핵심은 유지합니다. 이것이 트레이딩의 맥락에서 PCA의 핵심 효과입니다: 모델에서 노이즈는 줄어들지만 의미는 더욱 풍부 해집니다.
이것이 바로 파이프라인의 다음 단계가 형성되는 방식입니다. 데이터를 정규화 한 후 데이터의 구조를 정리합니다. 그리고 이 공간이 깨끗 해질수록 모델의 동작은 더욱 안정됩니다.
모델 및 ONNX: 훈련부터 실행까지
데이터 공간이 정리되고 안정적인 형태로 만들어지면 파이프라인 로직은 자연스럽게 다음 단계인 모델로 넘어갑니다. 하지만 여기서 중요한 원칙이 있습니다: 모델은 시스템의 중심이 아니라 시스템의 최종 표현이라는 것입니다.
훈련은 터미널 외부에서 파이썬을 사용하여 진행됩니다. 이는 임의적인 선택이 아니라 편의성과 생태계를 고려한 문제입니다. 모델 훈련은 명확하게 구분된 두 단계로 구성되며 이것이 전체 시스템의 안정성을 결정하는 요소입니다.
첫 번째 단계에서는 훈련 데이터 세트 전체가 사용됩니다. 여기서는 모델 자체가 아직 구축되는 것이 아니라 모델의 좌표 시스템이 형성되는 것입니다. 정규화 매개변수는 각 피처에 대한 평균값과 표준편차로 계산됩니다. PCA는 병렬로 계산됩니다. 이는 원래의 피처 공간을 보다 간결하고 질서 있는 표현으로 변환하는 것을 명시합니다.
# Standardize features and apply PCA to retain 99% variance
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
pca = PCA(n_components=NComponents, random_state=42)
X_pca = pca.fit_transform(X_scaled)
데이터 준비 단계는 매우 중요합니다. 기본적으로 모델이 작동할 공간은 여기에 고정되어 있습니다. 이 수준에서 발생하는 모든 편차는 자동으로 다음 단계로 이어집니다. 따라서 이는 시스템의 후속 안정성 전체를 결정합니다.
데이터 공간이 확정되면 두 번째 단계로 넘어갑니다. 이 모델은 보다 구체적인 구조를 가진 메커니즘으로 구성됩니다. 이 시점에서 피처들은 정규화 되었고 PCA를 통과했으므로 시장에 대한 일관되고 밀도 높은 표현이 네트워크에 입력됩니다. 이것은 중요한 포인트입니다: LSTM은 초기값의 혼란을 해결할 필요가 없으며 마련된 공간에 즉시 적용되어 작동합니다.
먼저, 데이터를 PyTorch에서 사용하기 편리한 형식으로 변환합니다.
# --- LSTM training block with PyTorch ---
# Prepare data for LSTM: form rolling sequence windows
X_np = X_pca.astype(np.float32)
y_np = y.to_numpy(dtype=float)
n_sequences = X_np.shape[0]
if n_sequences <= 0:
    print("Not enough samples for sequence windows; reduce window_size or collect more data.")
    quit()

X_tensor = torch.tensor(X_np, dtype=torch.float32).unsqueeze(1)  # (n_samples, 1, n_features)
y_tensor = torch.tensor(y_np.reshape(-1, 1), dtype=torch.float32)
이 단계에서는 특별히 스마트한 일이 일어나지는 않지만 향후 모든 작업의 기술적 정확성이 바로 이 단계에서 결정됩니다. 배열이 텐서로 변환되고 차원이 하나 더 추가됩니다. 이는 사소한 디테일이지만 LSTM에게는 매우 중요합니다: 네트워크는 단순히 피처의 집합을 기다리는 것이 아니라 피처의 순서를 기다립니다. 시퀀스 길이가 1이더라도 입력 형태 자체는 순환 신경망의 구조와 일치합니다.
이후 데이터는 훈련 데이터와 검증 데이터로 나뉩니다. 겉보기에는 평범해 보이는 이 단계가 중요한 역할을 합니다: 모델은 단순히 과거 데이터를 기억하는 데 그치지 않고 데이터셋의 일부를 따로 분리하여 자체적으로 테스트를 진행할 기회를 얻습니다. 이것이 바로 모델이 패턴을 찾는 법을 배우는 것인지 아니면 단순히 노이즈를 반복하는 것인지를 알 수 있게 해주는 부분입니다.
# Train/validation split
split = int(Train_test_split * len(X_tensor))
train_ds = TensorDataset(X_tensor[:split], y_tensor[:split])
val_ds = TensorDataset(X_tensor[split:], y_tensor[split:])
train_loader = DataLoader(train_ds, batch_size=Batch_size, shuffle=False)
val_loader = DataLoader(val_ds, batch_size=Batch_size, shuffle=False)
그런 다음 해당 데이터가 DataLoader로 전달됩니다. 그리고 여기서 그 과정은 일정한 리듬을 갖게 됩니다. 네트워크에 예제를 하나씩 제공하는 대신 우리는 배치 단위로 제공합니다. 이를 통해 훈련이 더욱 안정되고 최적화가 훨씬 쉬워집니다.
다음으로 모델 자체가 만들어집니다. 여기서 중요한 것은 불필요한 복잡성으로 과부하를 주지 않는 것입니다. 코드상으로 보면 이는 깔끔하고 간결한 아키텍처입니다: 몇 개의 순환 레이어, 고정 크기의 은닉 상태, 과적합을 줄이기 위한 드롭아웃, 그리고 네트워크의 내부 상태를 단일 예측값으로 변환하는 마지막 선형 레이어로 구성됩니다.
class LSTMRegressor(nn.Module):
    def __init__(self, input_size, hidden_size=64, num_layers=3, dropout=0.1):
        super().__init__()
        self.lstm = nn.LSTM(input_size=input_size,
                            hidden_size=hidden_size,
                            num_layers=num_layers,
                            batch_first=True,
                            dropout=dropout)
        self.fc = nn.Linear(hidden_size, 1)

    def forward(self, x):
        # x: (batch, seq_len, input_size)
        out, (hn, cn) = self.lstm(x)
        last_h = hn[-1]
        return self.fc(last_h)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"Using device: {device}")

model = LSTMRegressor(input_size=X_np.shape[1], hidden_size=64, num_layers=Layers, dropout=0.2).to(device)
로직은 간단하지만 매우 명확합니다: 네트워크는 먼저 의미를 수집한 다음 답을 도출합니다.
해당 모델이 사용 가능한 기기로 이동됩니다. GPU가 있으면 계산은 GPU에서 수행됩니다. 그렇지 않으면 모든 것이 CPU에서 계산됩니다. 금융 데이터의 경우 이는 선택 사항이 아니라 일반적인 엔지니어링 관행입니다: 순차 계산과 대규모 데이터 세트는 빠르게 부하가 걸리기 때문에 가속화가 매우 중요합니다.
그 다음으로는 Adam 최적화기와 MSELoss 손실 함수입니다.
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
criterion = nn.MSELoss()
이 단계에 이르러서야 비로소 진정한 훈련이 시작됩니다. 지금까지 우리는 장면을 신중하게 구축해 왔습니다: 데이터를 준비하고, 입력 형태를 정의하고, 아키텍처를 조립하고, 가중치 업데이트 메커니즘을 구성했습니다.
for epoch in range(1, Epochs + 1):
    model.train()
    train_loss = 0.0
    for xb, yb in train_loader:
        xb, yb = xb.to(device), yb.to(device)
        optimizer.zero_grad()
        preds = model(xb)
        loss = criterion(preds, yb)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * xb.size(0)
    train_loss /= len(train_loader.dataset)

    model.eval()
    val_loss = 0.0
    with torch.no_grad():
        for xb, yb in val_loader:
            xb, yb = xb.to(device), yb.to(device)
            preds = model(xb)
            loss = criterion(preds, yb)
            val_loss += loss.item() * xb.size(0)
    val_loss /= len(val_loader.dataset) if len(val_loader.dataset) > 0 else float('nan')

    print(f"Epoch {epoch}/{Epochs} — train_loss: {train_loss:.6f} val_loss: {val_loss:.6f}")
파이프라인의 강점은 데이터 준비 → 모델 조립 → 훈련이라는 단계의 순서에 있습니다. 이 순서는 입력 일관성을 잃지 않고 ONNX를 통해 MQL5로의 전송을 간소화 하는 역할을 합니다
훈련 과정에서는 시스템의 행동적 부분이 형성됩니다 — 모델 가중치, 분석된 데이터에 대한 반응, 예측 구조. 하지만 중요한 점이 있습니다: 이 모델은 원시 데이터가 아니라 이미 정제되고 압축된 표현을 반으로 학습된다는 것입니다.
그 결과 서로 섞일 수 없는 두 개의 블록이 생성됩니다. 첫 번째는 통계적 근거입니다: 정규화와 주성분 분석(PCA) 입니다. 두 번째는 이 공간에서 훈련된 모델 자체입니다. 이들은 함께 한개의 데이터 흐름 파이프라인을 형성합니다.
훈련이 완료되면 모델은 ONNX로 내 보내집니다. 이 형식은 계산 그래프를 캡처하여 모델을 이식 가능한 포터블로 만듭니다.
# Try exporting to ONNX
try:
    onnx_path = os.path.join(data_path, 'MQL5', 'Files', 'lstm3.onnx')
    dummy_input = torch.randn(1, 1, X_np.shape[1], device=device)
    model.eval()
    torch.onnx.export(
        model,
        dummy_input,
        onnx_path,
        input_names=['PCA_features'],
        output_names=['Forecast'],
        opset_version=18,
        dynamo=True,
        external_data=False,
        verify=True
    )
    print(f"Exported model to ONNX: {onnx_path}")
except Exception as e:
    print("ONNX export failed:", e)
ONNX는 아키텍처 내에서 연산을 담는 컨테이너 역할을 계속 수행하며 모델을 고정 함수로 저장하여 OnnxCreate 및 OnnxRun을 통해 MQL5에서 실행할 수 있도록 준비합니다. 하지만 전체 데이터 준비 로직은 ONNX 외부에 남아 있으며 터미널에서 행렬과 벡터를 통해 엄격하게 반복 처리됩니다.
그렇기 때문에 파이썬은 이 구조에서 매우 제한적인 역할만 수행합니다. 파이썬은 모델을 학습시키고 매개변수를 설정할 때 한 번만 필요합니다. 내보내기 이후에는 의사 결정 과정에 더 이상 관여하지 않습니다. 이후의 모든 작업은 터미널로 이관됩니다.
이렇게 해서 역할 분담이 명확하게 이루어지는 것입니다. 파이썬은 모델의 구축을 담당합니다. ONNX는 이를 계산 객체로 캡처합니다. MQL5는 입력 파이프라인과 추론 실행을 재현하는 기능을 제공합니다. 이러한 구분이 더욱 정확하게 지켜질수록 시스템은 실제의 트레이딩 환경에서 더욱 안정적으로 작동합니다.
MQL5에서의 재현 및 데이터 제어
모델을 ONNX 형식으로 내보낸 후 작업이 터미널로 이송됩니다. 그리고 여기서 행렬과 벡터가 처음부터 전체 아키텍처의 핵심 요소였던 이유가 특히 분명해집니다. 이 구조에서 MQL5는 모델 학습에 사용된 전체 데이터 준비 경로를 재현합니다.
여기서 우리는 두 가지 다른 방식을 즉시 구분해야 합니다. 첫 번째는 초기화인데 이는 EA가 실행될 때 한 번 수행됩니다. 두 번째는 각 새로운 바마다 반복되는 런타임 루프입니다. 이 구분은 매우 중요합니다. 이는 컴퓨팅 환경을 안정화 시켜 줍니다. 가능한 모든 것은 미리 준비되어야 합니다. 각 바별 주기에는 실시간 시장 로직만 남아 있어야 합니다.
MQL5는 초기화 단계에서 모델이 기반으로 삼을 기반 인프라 전체를 준비합니다 먼저 정규화 매개변수, PCA 공간 중심, 그리고 구성 요소 행렬이 로드 됩니다.
   if(!LoadBinaryParams(sFileName, vMeans, vScales, vPCAmeans, mPCAcomponents, vEvr, iNFeatures, iNComponents))
     {
      PrintFormat("Error of load PCA params: %d", GetLastError());
      return INIT_FAILED;
     }
   PrintFormat("Loaded PCA params: features=%d components=%d", iNFeatures, iNComponents);
여기서 우리는 한 가지 중요한 세부 사항에 주목할 필요가 있습니다. 정규화 매개변수는 벡터로 로드되고 PCA 구성 요소는 행렬로 로드 됩니다. 이 모습은 자연스러워 보이지만 실제로는 데이터 준비 과정의 구조를 잘 보여줍니다.
평균과 표준편차는 단변량 통계입니다. 각 피처에는 고유한 평균과 표준편차가 있습니다. 따라서 이들은 벡터로 표현됩니다. 이러한 벡터의 각 요소는 입력 공간의 개별적인 피처에 해당됩니다. 논리는 선형적이고 투명합니다.
PCA의 경우에는 상황이 다릅니다. 여기서 우리는 개별 비율의 집합에 대해 이야기하는 것이 아니라 전체 피처 공간의 변환에 대해 이야기하고 있습니다. 이것이 바로 구성 요소들이 행렬에 로드되는 이유입니다. 이것은 더 이상 단순한 데이터 컨테이너가 아닙니다. 이 행렬은 원래 피처 공간에서 새롭고 압축된 구성 요소 공간으로의 전환 규칙을 정의합니다. 여기서 각 행은 PCA 변환 후 새로운 축의 방향을 설명합니다. 실제로 터미널은 학습 데이터 세트를 기반으로 파이썬으로 구축된, 미리 만들어진 공간의 기하학 구조를 수신합니다.
이는 전체 아키텍처를 이해하는 데 매우 중요한 부분입니다. 벡터는 개별 피처에서 로컬 연산(중심 맞춤 및 크기 조정)을 담당합니다. 행렬은 전체 데이터 공간의 집합적 변환을 담당합니다. MQL5의 내장 행렬 및 벡터 함수는 이러한 수학적 구조를 코드에 직접적으로 완벽하게 반영합니다.
다음으로 ONNX 모델이 로드되고 입력 및 출력 차원이 지정됩니다.
//--- load models
   hONNX = OnnxCreateFromBuffer(model, ONNX_DEFAULT);
   if(hONNX == INVALID_HANDLE)
     {
      Print("OnnxCreateFromBuffer error ", GetLastError());
      return INIT_FAILED;
     }
   const ulong input_state[] = {1, 1, iNComponents};
   if(!OnnxSetInputShape(hONNX, 0, input_state))
     {
      PrintFormat("OnnxSetInputShape error: %d ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
   const ulong output_forecast[] = {1, vForecast.Size()};
   if(!OnnxSetOutputShape(hONNX, 0, output_forecast))
     {
      Print("OnnxSetOutputShape error ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
바로 이 부분에서 매우 중요한 구조적 관점이 나타납니다. 모델의 입력 크기가 원래 피처의 개수와 더 이상 같지 않습니다. 이는 PCA 구성 요소의 개수, 즉 이미 압축된 데이터 공간의 차원과 같습니다.
이는 모델이 초기 지표와 파생 값의 전체 세트를 사용하는 것이 아니라 PCA 후의 간결한 표현을 사용하여 작동한다는 것을 의미합니다. 오리지널 공간에는 잡음과 과도한 상관관계가 남아 있지만 ONNX는 더욱 안정적이고 집중된 신호를 수신합니다.
실제로 이는 여러 가지 효과를 동시에 가져옵니다. 줄어든 입력 텐서 크기. 낮은 부하의 컴퓨팅. 단순화된 모델 작업. 하지만 가장 중요한 점은 입력 공간이 더욱 안정화된다는 것입니다. 네트워크는 서로 중복되는 피처를 처리하는 데 자원을 낭비하는 것을 멈추고 시장 구조에 대한 더욱 밀도 높은 표현을 사용하여 작동하기 시작합니다.
그렇기 때문에 여기서 PCA는 단순히 차원을 축소하는 방법이 아닙니다. PCA는 원시 시장 데이터와 모델 사이의 중간 계층이 되는 것입니다. MQL5 행렬을 사용하면 이 레이어를 파이썬에서 존재했던 것과 거의 동일한 형태로 터미널 내에서 직접 재현할 수 있습니다.
이후에는 지표가 연결되고 작업 버퍼가 준비됩니다.
//--- Indicators
   if(!ciSMA.Create(Symb.Name(), TimeFrame, 12, 0, MODE_SMA, PRICE_CLOSE))
     {
      Print("SMA create error ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
   ciSMA.BufferResize(2);
   for(uint i = 0; i < ciMACD.Size(); i++)
     {
      if(!ciMACD[i].Create(Symb.Name(), TimeFrame, int(mMACDset[i, 0]), int(mMACDset[i, 1]),
                                                          int(mMACDset[i, 2]), PRICE_CLOSE))
        {
         PrintFormat("MACD %d create error %d", i, GetLastError());
         OnnxRelease(hONNX);
         return INIT_FAILED;
        }
      ciMACD[i].BufferResize(4);
     }
이것은 단순히 기술적인 절차가 아닙니다. 이 순간 터미널은 파이썬에서 모델을 훈련시킬 때 사용했던 것과 동일한 통계적 기반을 수신하게 됩니다. 즉 MQL5는 모델이 생성한 예측이 의미를 지니게 되는 환경을 재구성합니다.
이는 데이터 준비 매개변수를 로드할 때 특히 두드러집니다. 이 매개변수들은 현장에서 재계산되거나 선택되지 않으며 이미 모든 준비를 마친 채 터미널에 도착합니다. 이것이 바로 행렬 접근법의 강점입니다. 데이터 준비 매개변수는 한 번 로드되어 계산 구조에 고정됩니다; 현장에서 다시 계산되지 않습니다. 결과적으로 터미널은 특정 데이터 공간에 연결된 모델을 사용하여 작동하기 시작합니다.
이후 작업 주기가 시작됩니다. 이제 완전히 다른 유형입니다. 새로운 바가 나타날 때마다 EA는 새로운 시장 데이터를 수집합니다.
   ciSMA.Refresh();
   for(uint i = 0; i < ciMACD.Size(); i++)
      ciMACD[i].Refresh();
   if(!vRates.CopyRates(Symb.Name(), TimeFrame, COPY_RATES_CLOSE, 1, 12))
     {
      Print("CopyRates error ", GetLastError());
      return;
     }
피처 벡터가 생성됩니다...
   vInputs[0] = vRates[11] - vRates[10];
   vInputs[1] = (vRates[11] - vRates[0]) / 11;
   vInputs[2] = vInputs[1] - vInputs[0];
   vInputs[3] = float(ciSMA.Main(1));
   for(uint i = 0; i < ciMACD.Size(); i++)
     {
      vInputs[4 + i * 6] = float(ciMACD[i].Main(1));
      vInputs[5 + i * 6] = float(ciMACD[i].Main(1) - ciMACD[i].Main(2));
      vInputs[6 + i * 6] = float(ciMACD[i].Signal(1));
      vInputs[7 + i * 6] = float(ciMACD[i].Signal(1) - ciMACD[i].Signal(2));
      vInputs[8 + i * 6] = vInputs[6 + i * 6] - vInputs[4 + i * 6];
      vInputs[9 + i * 6] = vInputs[7 + i * 6] - vInputs[5 + i * 6];
     }
...그리고 훈련 과정에서 사용되었던 것과 동일한 변환 과정을 거쳤습니다. 먼저 정규화를 수행한 다음 PCA 투영을 진행합니다.
bool TransformPCA(const vector<float> &data, const vector<float> &scaler_mean,
                  const vector<float> &scaler_scale, const vector<float> &pca_mean,
                  const matrix<float> &pca_components, vector<float> &out)
  {
   ulong n = data.Size();
   if(n == 0)
      return false;
//---
   vector<float> centered = (data - scaler_mean) / scaler_scale - pca_mean;
//--- projection: out = pca_components * centered (matrix * vertical vector)
   out = pca_components.MatMul(centered);
   return true;
  }
MQL5 내장 연산 기능의 장점은 특히 이 부분에서 두드러지게 나타납니다. 해당 코드는 수학적 표기법을 사실상 그대로 반복합니다. 터미널은 단순히 모델을 훈련시키는 데 사용된 동일한 작업을 재현합니다.
그제서야 준비된 벡터가 ONNX로 전달됩니다.
//--- ONNX
   if(!OnnxRun(hONNX, ONNX_LOGLEVEL_INFO, vCompressed, vForecast))
     {
      PrintFormat("OnnxRun error: %d ", GetLastError());
      return;
     }
이제 더 이상 많은 양의 준비나 재초기화에 시간을 쏟을 필요가 없습니다. 모든 것이 컨베이어 벨트처럼 작동합니다. 새로운 바 - 새로운 입력. 하지만 이 입구의 경로는 변함없이 유지됩니다.
바로 이 지점에서 MQL5에 내장된 행렬과 벡터의 실질적인 가치가 드러납니다. 이를 통해 전체 데이터 구조를 한 번만 구성한 다음 불필요한 번거로움이나 일관성을 헤치지 않고 필요한 만큼 여러 번 복제할 수 있습니다. 초기화는 기본 틀을 설정합니다. 작업 주기는 이 틀을 활용합니다. 이로써 시스템은 간결해질 뿐만 아니라 체계적으로 운영될 수 있습니다. 터미널에서의 머신러닝에 있어서는 화려한 설명 보다는 규율이 더 중요합니다. 왜냐하면 규율은 모델을 제대로 작동할 수 있는 동일한 영역에 유지시켜주기 때문입니다.
결과 테스트: 모델에서 트레이딩까지
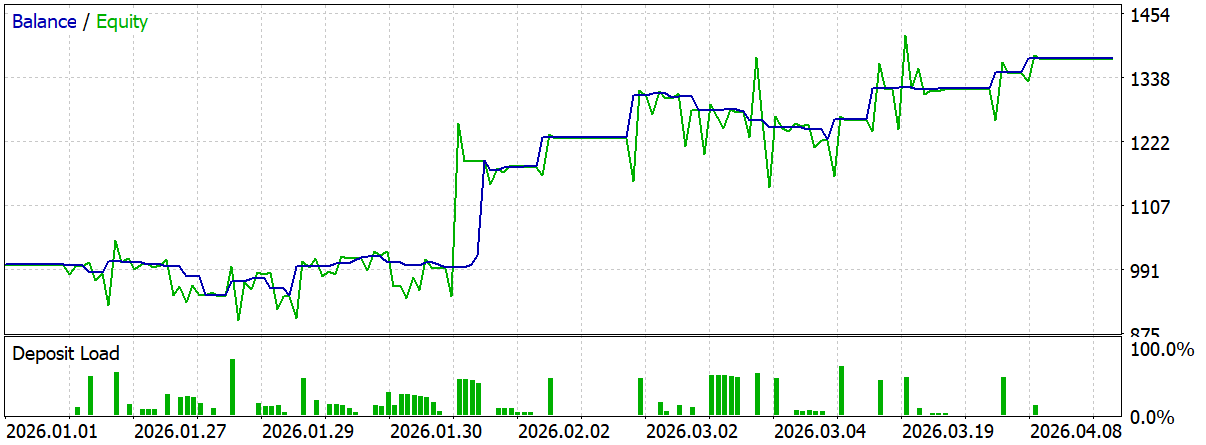
해당 모델은 Python으로 훈련되었고 계산 파이프라인은 MQL5로 세심하게 재현되었습니다. 정규화와 PCA는 행렬과 벡터를 통해 작동합니다. ONNX 모델이 터미널에 업로드 됩니다. 모든 요소가 하나의 시스템으로 연결됩니다. 이제 핵심 질문은 간단합니다: 이 시스템이 시장에서 어떻게 작동할까요?
바로 이 부분에서 MetaTrader 5 전략 테스터가 유용하게 사용됩니다. 이는 모델이 작동한다는 사실뿐만 아니라 데이터 준비부터 매매 결정에 이르기까지 전체 머신러닝 파이프라인이 얼마나 안정적인지를 보여줍니다. 이는 실제 시장 역학을 기반으로 전체 아키텍처를 본격적으로 테스트하는 것으로
이 플랫폼의 가장 큰 장점 중 하나입니다. 파이썬에서는 손실 함수 값이 좋거나 훈련 데이터셋에서 높은 정확도를 얻는 것이 쉽습니다. 하지만 시장은 그러한 결과의 타당성을 빠르게 시험합니다. MetaTrader 5 테스터를 사용하면 이 순간을 즉시 확인할 수 있습니다. MetaTrader 5에서 제공하는 여러 지표들의 조합이 중요합니다. 바로 이 부분에서 테스트 도구의 진정한 가치가 드러납니다. 이를 통해 우리는 전략을 고유한 행동, 위험, 안정성 및 내부 구조를 가진 살아있는 시스템으로 볼 수 있습니다.
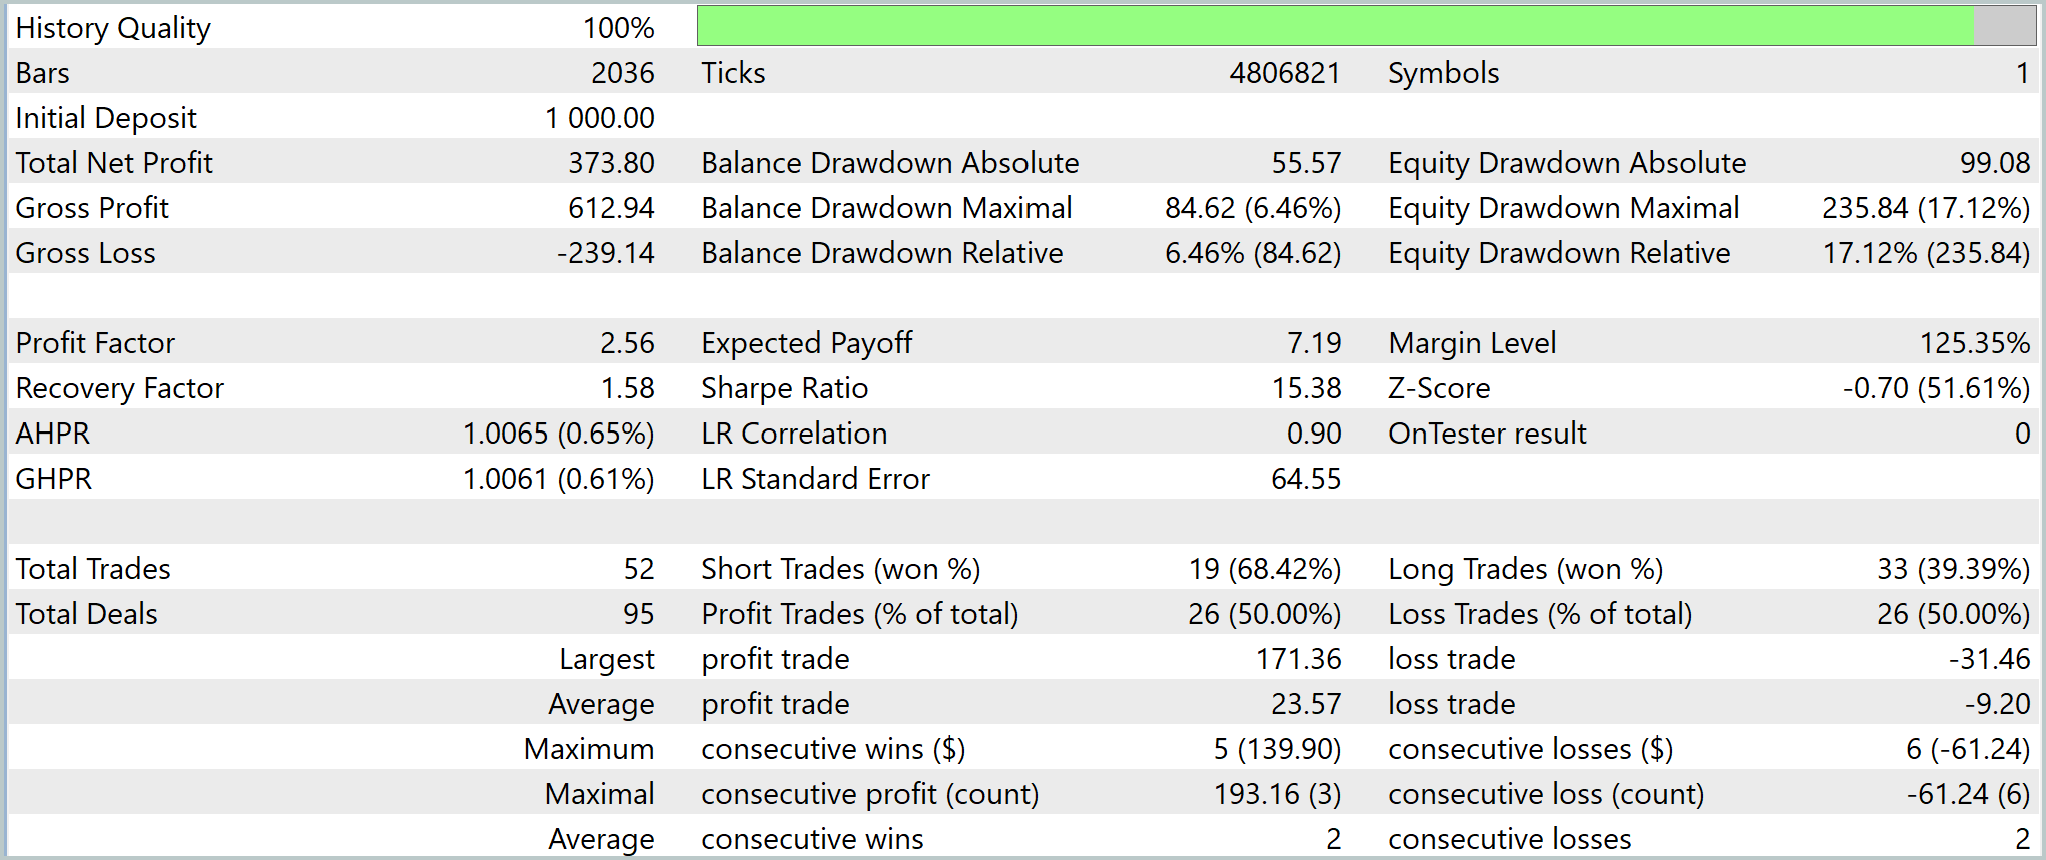
- 히스토리의 품질은 중요한 출발점입니다.
시험 조건은 실행의 정확성에 대한 모든 의심을 없애줍니다. 결과는 기술적으로 신뢰할 수 있는 것으로 간주될 수 있으며 이는 메트릭 분석이 의미 있다는 것을 의미합니다. - 재무적 결과(총 순이익)는 초기 예치금 1,000달러에 대해 373.80달러를 기록했습니다.
이는 해당 전략이 테스트를 성공적으로 완료했으며 긍정적인 결과를 얻었다는 것을 의미합니다. 하지만 이 메트릭 하나만으로는 논리적 품질에 대해 아무것도 알 수 없으므로 다른 메트릭과 함께 살펴보아야 합니다. - 총 수익은 612.94달러, 총 손실 은 -239.14달러로 나타났습니다.
이는 수익성 있는 거래가 손실 거래보다 훨씬 많아 긍정적인 결과로 이어졌다는 것을 의미합니다. 이 전략은 지속적으로 긍정적인 결과가 수익으로 이어집니다. - 수익 계수는 2.56 입니다.
이는 강력한 메트릭입니다. 이익은 손실보다 두 배 반 이상 큽니다. 트레이딩 시스템의 경우 이는 이미 긍정적인 거래가 부정적인 거래보다 더 많다는 신호입니다. - 예상 보상은 7.19였습니다.
이는 평균적으로 각각의 거래가 긍정적인 기여를 했다는 것을 의미합니다. 이 시스템은 한두 번의 성공에 의존하는 것이 아니라 트레이딩에서 긍정적인 기대감을 유지합니다. - 회복률이 1.58 이라는 것은 발생한 드로다운이 결과에 어느 정도 정당화되는지를 보여줍니다.
이 경우 시스템은 손실로부터 회복할 수 있지만 안전 마진이 크다고는 할 수 없습니다. 이 전략은 효과적이지만 드로다운을 과소평가해서는 안 됩니다. - 샤프 비율은 15.38에 달했습니다.
이는 매우 높은 수치로 결과 변동성에 대한 수익률 비율이 높다는 것을 나타냅니다. 하지만 여기서 중요한 것은 테스트 환경에서 이 지표를 드로다운 및 거래의 연속성과 함께 해석해야 한다는 점입니다. - AHPR은 1.0065, 즉 0.65%로 구성되었습니다. GHPR은 1.0061, 즉 0.61%로 구성되었습니다.
이들 메트릭들은 거래의 평균 수익성을 산술적 및 기하적 관점에서 보여줍니다. 여기서 내릴 수 있는 결론은 분명합니다: 수익이 있으며 이는 매매의 흐름의 구조에 있습니다. - 절대 드로다운 잔액은 55.57 USD, 최대 드로다운 잔액은 84.62 USD로 이는 6.46%에 해당합니다(상대 드로다운 잔액 감소율).
이는 전략이 비교적 균형을 유지했음을 의미합니다. 체결된 거래들은 적절한 자본 곡선을 형성했습니다. - 평가금액 드로다운은 완전히 다른 양상을 보여줍니다. 총 드로다운은 99.08달러였으며 최대 드로다운은 235.84달러로 17.12%에 해당합니다.
이는 중요한 포인트입니다: 최종 잔액은 적당해 보이지만 미결제 포지션은 시장 노출을 초래했습니다. 결론은 솔직합니다: 이 전략은 수익을 창출할 수 있지만 내부적인 긴장 없이는 불가능합니다. - 마진율은 125.35% 였습니다.
이 수준은 안전하지만 여유가 크지는 않습니다. 이는 준비금이 충분했음을 보여줍니다. 하지만 해당 시스템은 마냥 안전한 상태에서 작동하지 않았습니다. 트레이딩 로직은 계정에 심각한 압박을 가하지 않고 정상 범위 내에 머물렀습니다. - Z-점수는 유의수준 51.61%에서 -0.70 으로 나타났습니다.
이는 명확하게 정의된 이례적인 승패의 연속이 없었다는 것을 나타냅니다. 다시 말해 이러한 결과는 우연한 행운처럼 보이지 않습니다. 일련의 거래 내역은 무작위적인 잡음보다는 실제 작동하는 매매 구조에 더 가깝습니다. - LR 상관계수는 0.90 이고 LR 표준 오차는 64.55 입니다.
상관관계는 평가금액 곡선이 상당히 매끄러운 선형 추세를 보인다는 것을 나타냅니다. 표준 오차는 모션이 완벽하게 부드럽지 않았음을 보여줍니다. 성장은 있었지만 이는 정상적인 시장 변동을 통해 형성된 것입니다. - 총 52건의 포지션(총 거래 건수)이 개설되었고 95건의 체결거래(총 체결 건수)가 등록되었습니다.
이 정도 분량이면 전략의 본질을 파악하기에 충분합니다. 이 테스트는 몇 가지 랜덤 입력에만 국한되지 않으면서 매우 의미 있는 그림을 제공합니다. - 매도는 19건으로 수익률이 68.42% 였으며 매수는 33 건으로 수익률이 39.39% 였습니다.
매매 방향에 흥미로운 차이가 있습니다. 이것은 매우 중요한 신호입니다. 이 전략은 롱 트레이드보다 숏 트레이드를 훨씬 더 잘 처리합니다. 이는 하락세에 대한 편향이 뚜렷할 수 있음을 의미합니다. - 수익 거래와 손실 거래는 각각 26 건으로, 즉 50.00% 씩 동일하게 나타났습니다.
언뜻 보기에는 같은 것처럼 보이지만 그렇다고 해서 시스템이 수익성을 유지하는 것을 막지는 못합니다. 이 전략은 매매의 질을 통해 수익을 창출합니다. - 최대 수익을 낸 거래(최대 수익 거래 )는 171.36달러 였으며 손실을 본 거래(최대 손실 거래)는 -31.46달러 였습니다.
평균 수익 거래는 23.57달러이고 손실 거래( 평균 손실 거래)는 -9.20달러입니다. 이것들은 아마도 보고서에서 가장 중요한 메트릭들 중 일부일 것입니다. 평균적으로 수익을 내는 거래의 규모는 평균적으로 손실을 보는 거래의 규모보다 두 배 이상 큽니다. 이 시스템은 성공적인 진입 비율이 이상적이지 않더라도 경쟁 우위를 유지할 수 있습니다. - 최대 연속 승리는 139.90달러 상당의 매매 5건이며 최대 연속 손실은 -61.24달러 상당의 매매 6건입니다.
이는 해당 전략이 좋은 흐름을 포착할 수는 있지만 연패에서 완전히 자유로운 것은 아니라는 것을 보여줍니다.
각 메트릭은 전략 메커니즘의 서로 다른 측면을 나타냅니다. 이 플랫폼의 가장 큰 장점은 결과뿐만 아니라 그 구조까지도 확인할 수 있다는 점입니다.
결론
트레이딩 분야에서 머신러닝은 종종 무겁고 과부하처럼 보입니다. 하지만 현실은 전혀 다릅니다. MetaTrader 5에는 완전한 형태의 머신러닝 파이프라인을 구축하는 데 필요한 대부분의 도구가 포함되어 있습니다. 이것이 바로 이 글의 주된 목적이었습니다. 마법 같은 모델을 제시하거나 시장을 예측하려는 또 다른 시도를 하는 대신 일반적인 시장 데이터부터 터미널 내에서 작동하는 ONNX 모델에 이르기까지의 경로 자체를 분석합니다. 특히 MQL5에 내장된 행렬과 벡터가 여기서 핵심적인 역할을 한다는 점이 중요합니다. 이들은 데이터 준비를 서로 다른 작업들의 집합에서 명확하고 관리하기 쉬운 계산 구조로 변환합니다.
정규화, 통계 계산, 피처 공간 작업, PCA 변환 등 이 모든 것이 수학적으로 설명된 방식과 거의 동일한 형태로 터미널 내에서 직접 구현됩니다. 코드는 더 이상 기술적인 세부 사항으로 과도하게 채워지지 않고 계산 자체의 논리를 반영하기 시작합니다. 이로써 트레이더들이 머신러닝 개발에 진입하는 문턱이 크게 낮아지게 되는 것입니다.
ONNX 지원 또한 중요합니다. MetaTrader 5는 해당 모델을 즉시 사용 가능한 계산 블록으로 활용될 수 있도록 지원합니다. 파이썬은 모델을 준비하는 도구가 되고 터미널은 모델의 안정적인 실행 및 제어를 위한 환경이 됩니다. 이러한 구분 덕분에 아키텍처가 훨씬 깔끔하고 실용적이게 됩니다. 모델은 한 번 훈련되면 이후 작업은 MQL5로 이전됩니다. 이를 통해 투명성, 재현성 및 입력 데이터에 대한 완벽한 제어 기능이 가능해집니다.
MetaTrader 5 전략 테스터는 특히 유용합니다. 이를 통해 최종 수익뿐만 아니라 전체 시스템의 내부 작동 방식까지 평가할 수 있습니다. 드로다운, 평가금액 안정성, 매매 구조, 손실 회복의 질, 매매 리듬의 안정성 등 이 모든 것을 풍부한 내장 메트릭 세트를 통해 측정할 수 있습니다. 이러한 메트릭 각각의 뒤에는 전략의 작동 방식에 대한 서로 다른 측면이 놓여 있습니다. 바로 이러한 접근 방식 덕분에 테스트는 단순한 형식적인 점검에서 본격적인 엔지니어링 분석으로 탈바꿈하게 되었습니다.
결과적으로 MetaTrader 5는 로직을 외부 인프라로 이전하지 않고도 머신러닝 파이프라인을 구축하고 재현하는 데 사용될 수 있습니다. 주요 결론: MetaTrader 5의 머신러닝은 선형 수학, 행렬 및 투명한 데이터 준비를 통해 구현됩니다. 따라서 머신러닝이 터미널과 별개로 존재한다는 느낌을 주지 않습니다.
이 글에서 사용된 프로그램
| # | 이름 | 타입 | 설명 |
|---|---|---|---|
| 1 | create_pca_lstm.py | Script | 모델 구축 및 학습용 스크립트 |
| 2 | MLpipeline.mq5 | Expert Advisor | ONNX 모델 테스트를 위한 EA |
MetaQuotes 소프트웨어 사를 통해 러시아어가 번역됨.
원본 기고글: https://www.mql5.com/ru/articles/22474
경고: 이 자료들에 대한 모든 권한은 MetaQuotes(MetaQuotes Ltd.)에 있습니다. 이 자료들의 전부 또는 일부에 대한 복제 및 재출력은 금지됩니다.
 새로운 기능: MQL5의 커스텀 인디케이터
 MetaTrader 5의 강력한 기능: 통합 개발 환경에서의 단계별 디버깅부터 EX5 보호까지
 새 MetaTrader 와 MQL5를 소개해드립니다
 외부 라이브러리를 사용하지 않고 3D 시각화 구현: MetaTrader 5에서 MQL5 + DX11을 통해 최적화 결과를 보여주는 방법

제 생각에는, 전체 데이터 세트에 대해 정규화와 PCA 계산을 먼저 수행한 뒤, 그 후에야 훈련 데이터와 검증 데이터로 나누는 것은 미래를 미리 예측하는 것과 같습니다. 온라인으로 작업할 때는 최신 데이터를 반영하여 정규화를 변경하거나 PCA를 조정할 수 없습니다. 정직한 실험이라면, 처음에 데이터를 두 세트로 나누고, 인-샘플(in-sample) 부분에만 정규화 및 PCA를 수행한 뒤, 도출된 메타파라미터를 사용하여 아웃-오브-샘플(out-of-sample) 데이터에 입력 데이터를 변환하는 것이 될 것입니다.
그 결과, 평범한 화살표 지표조차도 "가장 극단적인 지점"을 가리키게 됩니다.
위험한 일인데, 한눈에 어디에 함정이 있는지 알아차리기 어렵습니다.