
Dalle matrici ai modelli: Come costruire una pipeline di machine learning in MQL5 ed esportarla nel formato ONNX
 13
 2

Introduzione
Cosa rende intimidatorio il Machine Learning (ML) nel terminale non è tanto il modello in sé quanto tutto ciò che lo circonda. Potrebbe sembrare che non possiamo fare a meno di uno stack separato, di script Python e di un'integrazione complessa. Di conseguenza, si ha la sensazione che l’ML sia qualcosa di esterno rispetto a MetaTrader 5.
Ma una volta rimossi gli strati superflui, il quadro diventa più chiaro. Qualsiasi pipeline ML è una sequenza di operazioni di base: generare le caratteristiche, scalarle, rimuovere la ridondanza e passare il risultato al modello. Non si tratta della magia delle reti neurali, ma di normale algebra lineare.
E qui arriva il punto più importante. La preparazione dei dati è un compito di MQL5. È nel terminale che vengono formate le caratteristiche, viene eseguita la normalizzazione e, se necessario, la PCA (Principal Component Analysis) viene applicata per ridurre la dimensionalità dei dati e rimuovere il rumore correlato. In altre parole, l'intero percorso dei dati verso il modello deve essere riprodotto nel punto in cui il modello viene utilizzato. Senza questo, la confrontabilità dei risultati è impossibile.
Questo è fondamentale perché qualsiasi tentativo di trasferire parzialmente la pipeline compromette la coerenza. In Python, i dati viaggiano in una direzione, mentre nel terminale seguono un percorso diverso. La differenza può essere minima, ma per il modello si tratta già di uno spazio diverso. Di conseguenza, il segnale non scompare, ma viene semplicemente distorto.
A questo punto, il ruolo di Python diventa molto più semplice e preciso. Viene utilizzato per addestrare il modello e calcolare i parametri: normalizzazione, PCA e i pesi stessi. Dopodiché il modello viene esportato in formato ONNX (Open Neural Network Exchange), un formato che preserva il grafo computazionale e consente il trasferimento del modello senza dover riscrivere il codice.
Quindi tutto viene deciso da MQL5. Il modello ONNX esegue i calcoli ma non controlla l'input. Ciò significa che è nel terminale che è necessario riprodurre lo stesso percorso dati utilizzato durante l'addestramento.
È qui che entrano in gioco le matrici. Le matrici e i vettori integrati ci permettono di descrivere tutte le trasformazioni direttamente, così come sono definite in matematica. Normalizzazione, proiezione, preparazione dell'input: - tutto ciò viene eseguito come una sequenza di operazioni lineari senza distorsioni intermedie. Il codice non interpreta le equazioni, ma le ripete.
È in questo momento che scompare il senso di complessità. L’ML smette di apparire come un insieme di tecnologie disparate e si trasforma in una sequenza di passaggi chiari, completamente controllabili all'interno del terminale.
In questo articolo, seguendo questo percorso in modo sequenziale, senza teoria superflua e usando matrici e vettori come strumenti principali. L'attenzione si concentra sull'obiettivo principale: come ottenere risultati riproducibili sia in fase di formazione che in un ambiente di trading reale.
Le matrici come base per una pipeline: Dalle caratteristiche (features) allo spazio dei dati
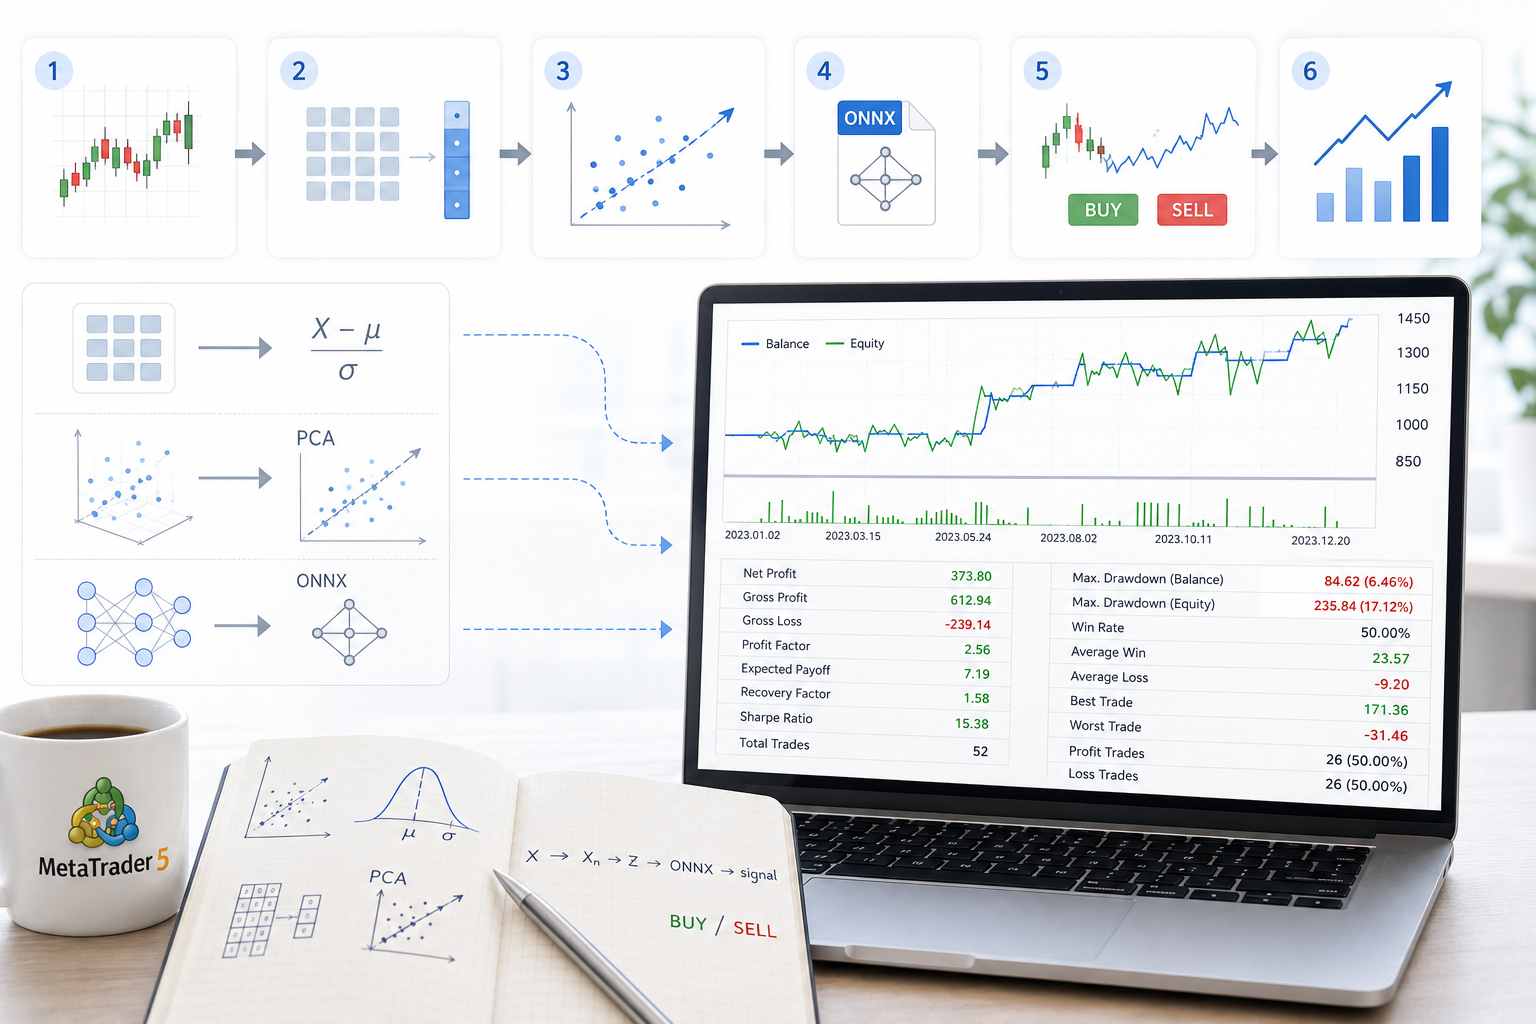
I dati di mercato costituiscono un flusso continuo di prezzi. Ma il modello in sé non funziona direttamente con esso. Richiede un insieme di caratteristiche predefinite: rendimenti, intervalli, deviazioni, ritardi. E qui sorge subito una questione pratica: mantenere ogni caratteristica separatamente o raggrupparle in un'unica struttura. In pratica, la seconda strada si rivela molto più stabile.
Pertanto, è conveniente ridurre le caratteristiche nella matrice X, le cui righe corrispondono alle osservazioni, mentre le colonne corrispondono alle caratteristiche. Da questo punto in poi, i dati cessano di essere una dispersione di valori individuali. I dati diventano un singolo oggetto per l'elaborazione sequenziale. Le operazioni matriciali integrate in MQL5 consentono di eseguire trasformazioni sull'intero spazio dati contemporaneamente, anziché sui singoli valori. Ciò modifica non solo il codice, ma anche la logica di gestione.
Ciò è particolarmente importante ai fini della normalizzazione. Le features di mercato esistono quasi sempre su scale diverse: prezzo, intervallo, rendimenti, deviazione, volume. Se non vengono riportati in una forma comparabile, il modello inizierà a rispondere all'entità dei numeri e non alla struttura del segnale. Pertanto, la normalizzazione è necessaria come fase obbligatoria nella preparazione dei dati. Ed è più conveniente gestire questa operazione dal lato MQL5. Qui, le matrici e i vettori integrati ci permettono di ottenere immediatamente le serie di mercato e quindi di applicare operazioni statistiche come Mean e Std direttamente alla matrice preparata.
   matrix<double> vRates;
   if(!vRates.CopyRates(cSymbol.Name(), PERIOD_CURRENT, COPY_RATES_OHLC | COPY_RATES_VERTICAL, 1, HistoryBars))
     {
      PrintFormat("Error of load rates %d", GetLastError());
      return;
     }
   matrix<double> means=matrix<double>::Zeros(vRates.Rows(),vRates.Cols());
   matrix<double> STDs=matrix<double>::Zeros(vRates.Rows(),vRates.Cols());
   means.Row(vRates.Mean(0),0);
   STDs.Row(vRates.Std(0)+DBL_EPSILON,0);
   means=means.CumSum(0);
   STDs=STDs.CumSum(0);
   vRates=(vRates-means)/STDs;
A prima vista, potrebbe sembrare che la normalizzazione sia più facile da nascondere all'interno del modello ONNX. Ma questa soluzione ha i suoi limiti. In MQL5, ONNX è concepito principalmente come livello di esecuzione. Il modello viene caricato tramite OnnxCreate. Vengono quindi specificate le forme di input e output. Dopodiché, viene avviato tramite OnnxRun. Questo è ottimo per l'inferenza, ma non offre la stessa praticità e trasparenza per la gestione dello spazio di input. Quando la normalizzazione è impostata in MQL5, è più facile testarla, ripeterla, modificarla e confrontarla con i dati di mercato reali direttamente nel tester o sul grafico.
C'è un altro punto importante. Quando cambiamo il simbolo o il timeframe, la distribuzione dei dati cambia. Se la normalizzazione è incorporata nel grafo ONNX, il modello risulta essere rigidamente vincolato alla vecchia distribuzione di input. Pertanto, qualsiasi cambiamento significativo nell'ambiente richiede non solo aggiustamenti mirati, ma un completo riaddestramento e riesportazione. Se la normalizzazione è impostata in MQL5, è sufficiente aggiornarne i parametri e fornire al modello i dati della scala richiesta. Questo preserva la struttura di input e ci permette di fare a meno di ricostruire completamente l'intero modello.
Ecco perché il livello di matrice esterno nel terminale offre maggiore flessibilità rispetto al tentativo di racchiudere tutto all'interno di ONNX. In Python, il modello viene addestrato una sola volta. In MQL5, i dati vengono trasformati in modo coerente ogni volta. Questo è il punto di forza dell'architettura: il modello rimane tale, mentre le matrici e i vettori nel terminale si occupano di preparare e controllare l'input.
Compressione e stabilizzazione: PCA come estensione della logica matriciale
Gli indicatori di mercato non sono quasi mai indipendenti. Prezzo, rendimenti, range, deviazioni - tutte queste sono diverse proiezioni dello stesso movimento. Di conseguenza, nei dati si genera ridondanza: diverse caratteristiche descrivono lo stesso comportamento di mercato, ma da prospettive differenti. Per il modello, questo non rappresenta un miglioramento del segnale, bensì una fonte di rumore e instabilità.
È qui che la PCA (Principal Component Analysis) diventa la naturale continuazione dell'approccio matriciale. L'idea alla base del suo utilizzo è semplice: non cercare di fornire al modello tutti i dati in una volta, ma piuttosto raccogliere le informazioni in componenti più compatte che catturino la maggior parte della varianza presente nei dati.
Dal punto di vista matematico, non emerge nulla di nuovo. Si tratta della stessa algebra lineare. La matrice X delle caratteristiche viene centrata e moltiplicata per la matrice degli autovettori. Il risultato è un nuovo spazio, in cui le caratteristiche rappresentano componenti indipendenti del cambiamento del mercato.
E il punto importante qui non è l'equazione, ma l'effetto. PCA risolve due problemi contemporaneamente. Da un lato, comprime lo spazio delle caratteristiche eliminando le dimensioni superflue. D'altro canto, stabilizza i dati, perché il rumore e le correlazioni non disperdono più il segnale tra un insieme di variabili. Il modello inizia a funzionare con una struttura dati più pulita.
Il risultato pratico si avverte immediatamente. L'addestramento diventa più robusto, il comportamento del modello più prevedibile e la sensibilità alle fluttuazioni piccole e casuali diminuisce. Inoltre, il codice non diventa affatto più complicato. Tutto ciò che cambia è un'ulteriore operazione matriciale sulla matrice X già preparata.
Ed è importante mantenere la stessa logica architetturale di prima. PCA non è impostata in calcoli e cicli separati. Rimane parte di un singolo circuito a matrice in MQL5.
Di conseguenza, i dati non solo vengono uniformati a una singola scala, ma risultano anche strutturalmente semplificati. Perde la ridondanza ma conserva il nucleo informativo. Questo è l'effetto chiave di PCA nel contesto del trading: il modello ottiene meno rumore ma più significato.
Ecco come si forma il livello successivo della pipeline. Dopo aver normalizzato i dati, ne organizziamo la struttura. E più questo spazio diventa pulito, più stabile risulta il comportamento del modello.
Modello e ONNX: Dall’addestramento all'esecuzione
Una volta che lo spazio dati è stato ripulito e reso stabile, la logica della pipeline passa naturalmente alla fase successiva - il modello vero e proprio. È importante chiarire subito il principio: il modello qui non è il centro del sistema, ma la sua espressione finale.
L’addestramento si svolge al di fuori del terminale, in Python. Non si tratta di una scelta casuale, ma di una questione di convenienza e di ecosistema. L'addestramento del modello si compone di due fasi ben distinte, ed è proprio questo che determina la stabilità dell'intero sistema.
Nella prima fase, viene utilizzato l'intero volume del set di addestramento. Qui, il modello vero e proprio non è ancora in fase di costruzione, ma piuttosto si sta formando il suo sistema di coordinate. Vengono calcolati i parametri di normalizzazione: valori medi e deviazioni standard per ciascuna caratteristica. PCA viene calcolata in parallelo. Specifica una trasformazione dello spazio delle caratteristiche originale in una rappresentazione più compatta e ordinata.
# Standardize features and apply PCA to retain 99% variance
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
pca = PCA(n_components=NComponents, random_state=42)
X_pca = pca.fit_transform(X_scaled)
La fase di preparazione dei dati è fondamentale. In sostanza, lo spazio in cui il modello opererà è definito qui. Qualsiasi deviazione a questo livello viene automaticamente riportata ai livelli successivi. Pertanto, determina l'intera stabilità successiva del sistema.
Una volta definito lo spazio dei dati, si passa alla seconda fase. Il modello viene costruito come un meccanismo ben definito. A questo punto, le caratteristiche sono state normalizzate e hanno superato l'analisi PCA, in modo che una rappresentazione coerente e densa del mercato venga immessa nella rete. Questo è un punto importante: LSTM non deve risolvere il caos dei valori iniziali. Lavora immediatamente su uno spazio già preparato per essa.
Innanzitutto, i dati vengono convertiti in un formato adatto a PyTorch.
# --- LSTM training block with PyTorch ---
# Prepare data for LSTM: form rolling sequence windows
X_np = X_pca.astype(np.float32)
y_np = y.to_numpy(dtype=float)
n_sequences = X_np.shape[0]
if n_sequences <= 0:
    print("Not enough samples for sequence windows; reduce window_size or collect more data.")
    quit()

X_tensor = torch.tensor(X_np, dtype=torch.float32).unsqueeze(1)  # (n_samples, 1, n_features)
y_tensor = torch.tensor(y_np.reshape(-1, 1), dtype=torch.float32)
In questa fase non accade nulla di particolarmente rilevante, ma è qui che vengono gettate le basi per la precisione tecnica di tutto il lavoro successivo. L'array viene trasformato in un tensore e ad esso viene aggiunta una dimensione extra. È un piccolo dettaglio, ma per LSTM è fondamentale: la rete non attende solo un insieme di caratteristiche, bensì una sequenza. Anche se la lunghezza della sequenza è pari a uno, la forma dell'input stesso corrisponde all'architettura di una rete ricorrente.
Dopodiché, i dati vengono suddivisi in parti di addestramento e di validazione. Un passaggio apparentemente ordinario gioca un ruolo importante: il modello non si limita a memorizzare la cronologia, ma ha anche l'opportunità di testarsi su una porzione del dataset tenuta da parte. Ecco come si può capire se sta imparando a trovare uno schema o se si limita a ripetere il rumore.
# Train/validation split
split = int(Train_test_split * len(X_tensor))
train_ds = TensorDataset(X_tensor[:split], y_tensor[:split])
val_ds = TensorDataset(X_tensor[split:], y_tensor[split:])
train_loader = DataLoader(train_ds, batch_size=Batch_size, shuffle=False)
val_loader = DataLoader(val_ds, batch_size=Batch_size, shuffle=False)
I dati vengono quindi inseriti in DataLoader. E qui il processo acquisisce un ritmo di lavoro. Anziché fornire alla rete un esempio alla volta, lo forniamo in batch. Ciò rende l'addestramento più stabile e significativamente più facile da ottimizzare.
In seguito, si procede alla costruzione del modello vero e proprio. L'importante è non sovraccaricarlo con una complessità inutile. Nel codice, si tratta di un'architettura ordinata e compatta: alcuni strati ricorrenti, uno stato nascosto di dimensioni fisse, Dropout per ridurre l'overfitting e un ultimo strato lineare che converte lo stato interno della rete in un singolo numero di predizione.
class LSTMRegressor(nn.Module):
    def __init__(self, input_size, hidden_size=64, num_layers=3, dropout=0.1):
        super().__init__()
        self.lstm = nn.LSTM(input_size=input_size,
                            hidden_size=hidden_size,
                            num_layers=num_layers,
                            batch_first=True,
                            dropout=dropout)
        self.fc = nn.Linear(hidden_size, 1)

    def forward(self, x):
        # x: (batch, seq_len, input_size)
        out, (hn, cn) = self.lstm(x)
        last_h = hn[-1]
        return self.fc(last_h)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"Using device: {device}")

model = LSTMRegressor(input_size=X_np.shape[1], hidden_size=64, num_layers=Layers, dropout=0.2).to(device)
La logica è semplice, ma molto efficace: la rete prima ne raccoglie il significato e poi formula la risposta.
Il modello viene spostato su un dispositivo disponibile. Se è presente una GPU, i calcoli vengono eseguiti lì. Altrimenti, tutto il lavoro viene eseguito sulla CPU. Nel caso dei dati finanziari, questo non è un lusso, ma una normale pratica ingegneristica: i calcoli sequenziali e i grandi set di dati diventano rapidamente onerosi, e in questi casi l'accelerazione è davvero importante.
Dopodiché, l'ottimizzatore Adam e la funzione di perdita MSELoss.
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
criterion = nn.MSELoss()
Solo a questo punto inizia il vero e proprio addestramento. Fino a questo punto, abbiamo solo costruito con cura la scena: preparato i dati, definito la forma dell'input, assemblato l'architettura e configurato il meccanismo di aggiornamento dei pesi.
for epoch in range(1, Epochs + 1):
    model.train()
    train_loss = 0.0
    for xb, yb in train_loader:
        xb, yb = xb.to(device), yb.to(device)
        optimizer.zero_grad()
        preds = model(xb)
        loss = criterion(preds, yb)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * xb.size(0)
    train_loss /= len(train_loader.dataset)

    model.eval()
    val_loss = 0.0
    with torch.no_grad():
        for xb, yb in val_loader:
            xb, yb = xb.to(device), yb.to(device)
            preds = model(xb)
            loss = criterion(preds, yb)
            val_loss += loss.item() * xb.size(0)
    val_loss /= len(val_loader.dataset) if len(val_loader.dataset) > 0 else float('nan')

    print(f"Epoch {epoch}/{Epochs} — train_loss: {train_loss:.6f} val_loss: {val_loss:.6f}")
Il punto di forza della pipeline risiede nella sequenza delle fasi: preparazione dei dati → assemblaggio del modello → addestramento. Questo ordine semplifica il trasferimento a MQL5 tramite ONNX senza perdere la coerenza tra gli input.
Durante la fase di addestramento, si forma la parte comportamentale del sistema — i pesi del modello, la sua risposta ai dati analizzati e la struttura di previsione. È importante però capire che il modello non viene addestrato sui dati grezzi, bensì sulla rappresentazione già fornita e compressa.
Il risultato sono due blocchi che non possono essere mescolati. Il primo elemento è la base statistica: normalizzazione e PCA. Il secondo è il modello stesso, addestrato in questo spazio. Insieme formano un unico flusso di dati della pipeline.
Dopo l'addestramento, il modello viene esportato in formato ONNX. Il formato cattura il grafo computazionale e rende il modello portatile.
# Try exporting to ONNX
try:
    onnx_path = os.path.join(data_path, 'MQL5', 'Files', 'lstm3.onnx')
    dummy_input = torch.randn(1, 1, X_np.shape[1], device=device)
    model.eval()
    torch.onnx.export(
        model,
        dummy_input,
        onnx_path,
        input_names=['PCA_features'],
        output_names=['Forecast'],
        opset_version=18,
        dynamo=True,
        external_data=False,
        verify=True
    )
    print(f"Exported model to ONNX: {onnx_path}")
except Exception as e:
    print("ONNX export failed:", e)
ONNX rimane un contenitore di calcoli all'interno dell'architettura. Memorizza il modello come una funzione fissa, pronta per l'esecuzione in MQL5 tramite OnnxCreate e OnnxRun. Ma l'intera logica di preparazione dei dati rimane al di fuori di ONNX e viene rigorosamente ripetuta nel terminale tramite matrici e vettori.
Ecco perché Python svolge un ruolo strettamente limitato in questa struttura. È necessario una sola volta: per addestrare il modello e fissarne i parametri. Dopo l'esportazione, non è più coinvolto nel processo decisionale. Tutto il lavoro successivo viene trasferito al terminale.
In questo modo si crea una chiara divisione dei ruoli. Python è responsabile della creazione del modello. ONNX lo acquisisce come oggetto computazionale. MQL5 consente la riproduzione della pipeline di input e l'esecuzione dell'inferenza. Quanto più accuratamente viene rispettata questa divisione, tanto più stabile risulterà il sistema in un ambiente di trading reale.
Riproduzione e controllo dei dati in MQL5
Dopo aver esportato il modello in ONNX, il lavoro viene trasferito al terminale. Ed è qui che risulta particolarmente chiaro perché matrici e vettori siano stati elementi chiave dell'intera architettura fin dall'inizio. In questa struttura, MQL5 riproduce l'intero percorso di preparazione dei dati su cui è stato addestrato il modello.
E qui dobbiamo subito distinguere tra due modalità differenti. La prima fase è l'inizializzazione, che viene eseguita una sola volta all'avvio dell'EA. La seconda è un ciclo di runtime che si ripete su ogni nuova barra. Questa divisione è molto importante. Rende l’elaborazione più stabile. Tutto ciò che si può fare dovrebbe essere preparato in anticipo. Solo la logica del mercato in tempo reale dovrebbe rimanere nel ciclo per barra.
Nella fase di inizializzazione, MQL5 crea l'intera infrastruttura su cui si baserà il modello. I parametri di normalizzazione, il centro dello spazio PCA e la matrice dei componenti vengono caricati per primi.
   if(!LoadBinaryParams(sFileName, vMeans, vScales, vPCAmeans, mPCAcomponents, vEvr, iNFeatures, iNComponents))
     {
      PrintFormat("Error of load PCA params: %d", GetLastError());
      return INIT_FAILED;
     }
   PrintFormat("Loaded PCA params: features=%d components=%d", iNFeatures, iNComponents);
A questo proposito, vale la pena prestare attenzione a un dettaglio importante. I parametri di normalizzazione vengono caricati in vettori, mentre i componenti PCA vengono caricati nella matrice. Questo può sembrare naturale, ma in realtà mostra bene la struttura della preparazione dei dati.
La media e la deviazione standard sono statistiche univariate. Ogni caratteristica ha la sua media e la sua deviazione. Pertanto, vengono rappresentate come vettori. Ciascun elemento di tale vettore corrisponde a una caratteristica distinta dello spazio di input. La logica è lineare e trasparente.
Con PCA, la situazione è diversa. Qui non stiamo parlando di un insieme di rapporti individuali, ma della trasformazione dell'intero spazio delle caratteristiche. Ecco perché i componenti vengono caricati nella matrice. E questo non è più solo un contenitore di dati. La matrice definisce la regola di transizione dallo spazio delle caratteristiche originale al nuovo spazio dei componenti compresso. Ciascuna riga descrive la direzione del nuovo asse dopo una trasformazione PCA. Di fatto, il terminale riceve una geometria dello spazio già pronta, costruita in Python sul set di addestramento.
Questo è un punto molto importante per comprendere l'intera architettura. I vettori sono responsabili delle operazioni locali sulle singole caratteristiche - come la centratura e il ridimensionamento. La matrice è responsabile della trasformazione collettiva dell'intero spazio dei dati. Le matrici e i vettori integrati in MQL5 riflettono perfettamente questa struttura matematica direttamente nel codice.
Successivamente viene caricato il modello ONNX e vengono specificate le dimensioni di input e output.
//--- load models
   hONNX = OnnxCreateFromBuffer(model, ONNX_DEFAULT);
   if(hONNX == INVALID_HANDLE)
     {
      Print("OnnxCreateFromBuffer error ", GetLastError());
      return INIT_FAILED;
     }
   const ulong input_state[] = {1, 1, iNComponents};
   if(!OnnxSetInputShape(hONNX, 0, input_state))
     {
      PrintFormat("OnnxSetInputShape error: %d ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
   const ulong output_forecast[] = {1, vForecast.Size()};
   if(!OnnxSetOutputShape(hONNX, 0, output_forecast))
     {
      Print("OnnxSetOutputShape error ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
È qui che entra in gioco un punto architetturale molto importante. La dimensione di input del modello non è più uguale al numero di caratteristiche originali. È pari al numero di componenti PCA, ovvero alle dimensioni dello spazio dati già compresso.
Ciò significa che il modello non funziona con un set completo di indicatori iniziali e valori derivati, ma con la loro rappresentazione compatta dopo PCA. Il rumore e le correlazioni eccessive rimangono nello spazio originale, mentre ONNX riceve un segnale più stabile e concentrato.
In pratica, ciò produce diversi effetti contemporaneamente. Riduzione delle dimensioni del tensore di input. Basso carico computazionale. Compito del modello semplificato. Ma la cosa principale è che lo spazio di input diventa più stabile. La rete smette di sprecare risorse elaborando caratteristiche duplicate e inizia a lavorare con una rappresentazione più densa della struttura del mercato.
Ecco perché, in questo caso, PCA non è solo un metodo per ridurre la dimensionalità. Funge da strato intermedio tra i dati grezzi di mercato e il modello. Le matrici MQL5 ci permettono di riprodurre questo livello direttamente all'interno del terminale in una forma pressoché identica a quella che aveva in Python.
Dopodiché, vengono collegati gli indicatori e vengono preparati i buffer di lavoro.
//--- Indicators
   if(!ciSMA.Create(Symb.Name(), TimeFrame, 12, 0, MODE_SMA, PRICE_CLOSE))
     {
      Print("SMA create error ", GetLastError());
      OnnxRelease(hONNX);
      return INIT_FAILED;
     }
   ciSMA.BufferResize(2);
   for(uint i = 0; i < ciMACD.Size(); i++)
     {
      if(!ciMACD[i].Create(Symb.Name(), TimeFrame, int(mMACDset[i, 0]), int(mMACDset[i, 1]),
                                                          int(mMACDset[i, 2]), PRICE_CLOSE))
        {
         PrintFormat("MACD %d create error %d", i, GetLastError());
         OnnxRelease(hONNX);
         return INIT_FAILED;
        }
      ciMACD[i].BufferResize(4);
     }
Non si tratta solo di una formalità tecnica. Questo è il momento in cui il terminale riceve la stessa base statistica su cui è stato addestrato il modello in Python. In altre parole, MQL5 ricostruisce l'ambiente in cui la previsione generata dal modello prende significato.
Ciò è particolarmente evidente durante il caricamento dei parametri di preparazione dei dati. Non vengono ricalcolati o selezionati in loco. Arrivano al terminal già preparati. Questo è il punto di forza dell'approccio a matrice. I parametri di preparazione dei dati vengono caricati una sola volta e fissati nella struttura computazionale; non vengono ricalcolati in loco. Di conseguenza, il terminale inizia a funzionare con un modello legato a uno specifico spazio dati.
Dopodiché, inizia il ciclo di lavoro. Ora è di un tipo completamente diverso. Ad ogni nuova barra, l'EA raccoglie nuovi dati di mercato.
   ciSMA.Refresh();
   for(uint i = 0; i < ciMACD.Size(); i++)
      ciMACD[i].Refresh();
   if(!vRates.CopyRates(Symb.Name(), TimeFrame, COPY_RATES_CLOSE, 1, 12))
     {
      Print("CopyRates error ", GetLastError());
      return;
     }
Il vettore delle caratteristiche viene generato...
   vInputs[0] = vRates[11] - vRates[10];
   vInputs[1] = (vRates[11] - vRates[0]) / 11;
   vInputs[2] = vInputs[1] - vInputs[0];
   vInputs[3] = float(ciSMA.Main(1));
   for(uint i = 0; i < ciMACD.Size(); i++)
     {
      vInputs[4 + i * 6] = float(ciMACD[i].Main(1));
      vInputs[5 + i * 6] = float(ciMACD[i].Main(1) - ciMACD[i].Main(2));
      vInputs[6 + i * 6] = float(ciMACD[i].Signal(1));
      vInputs[7 + i * 6] = float(ciMACD[i].Signal(1) - ciMACD[i].Signal(2));
      vInputs[8 + i * 6] = vInputs[6 + i * 6] - vInputs[4 + i * 6];
      vInputs[9 + i * 6] = vInputs[7 + i * 6] - vInputs[5 + i * 6];
     }
...e subisce le stesse trasformazioni utilizzate durante l'addestramento. Prima viene la normalizzazione, poi la proiezione PCA.
bool TransformPCA(const vector<float> &data, const vector<float> &scaler_mean,
                  const vector<float> &scaler_scale, const vector<float> &pca_mean,
                  const matrix<float> &pca_components, vector<float> &out)
  {
   ulong n = data.Size();
   if(n == 0)
      return false;
//---
   vector<float> centered = (data - scaler_mean) / scaler_scale - pca_mean;
//--- projection: out = pca_components * centered (matrix * vertical vector)
   out = pca_components.MatMul(centered);
   return true;
  }
Il vantaggio delle funzioni matematiche integrate in MQL5 è particolarmente evidente in questo caso. Il codice ripete praticamente la notazione matematica stessa. Il terminale si limita a riprodurre le stesse operazioni utilizzate per addestrare il modello.
Solo dopo, il vettore preparato viene passato a ONNX.
//--- ONNX
   if(!OnnxRun(hONNX, ONNX_LOGLEVEL_INFO, vCompressed, vForecast))
     {
      PrintFormat("OnnxRun error: %d ", GetLastError());
      return;
     }
Qui non c'è più spazio per una preparazione o una reinizializzazione approfondita. Tutto funziona come un nastro trasportatore. Nuova barra - nuovo input. Ma il percorso di questo ingresso rimane invariato.
È qui che entra in gioco il valore pratico delle matrici e dei vettori integrati in MQL5. Ci consentono di assemblare l'intera struttura dati una sola volta e poi di riprodurla tutte le volte che è necessario, senza inutili complicazioni e senza perdita di coerenza. L'inizializzazione imposta il framework. Il ciclo di lavoro lo utilizza semplicemente. Ciò rende il sistema non solo compatto, ma anche disciplinato. Per l’ML nel terminale, la disciplina è più importante delle parole altisonanti. Perché è la disciplina che mantiene il modello nello stesso spazio in cui può effettivamente lavorare.
Verifica del risultato: Dal modello al comportamento nel trading
Il modello è stato addestrato in Python, mentre la pipeline computazionale è stata riprodotta fedelmente in MQL5. La normalizzazione e la PCA funzionano tramite matrici e vettori. Il modello ONNX viene caricato nel terminale. Tutti gli elementi sono collegati in un unico sistema. Ora la domanda principale è semplice: come si comporterà questo sistema sul mercato?
È qui che entra in gioco lo strategy tester di MetaTrader 5. Dimostra non solo che il modello funziona, ma anche quanto sia stabile l'intera pipeline ML - dalla preparazione dei dati alla decisione di trading. Si tratta di un test completo dell'intera architettura su dinamiche di mercato reali.
Questo è uno dei maggiori punti di forza della piattaforma. In Python è facile ottenere buoni valori della funzione di perdita o un'elevata accuratezza sul set di addestramento. Ma il mercato mette rapidamente alla prova la solidità di tali risultati. Il tester di MetaTrader 5 ci permette di vedere questo momento immediatamente. La combinazione delle metriche fornite da MetaTrader 5 è importante. È qui che il tester dimostra il suo vero valore. Ciò ci consente di considerare la strategia come un sistema vivente con un proprio comportamento, rischio, stabilità e struttura interna.
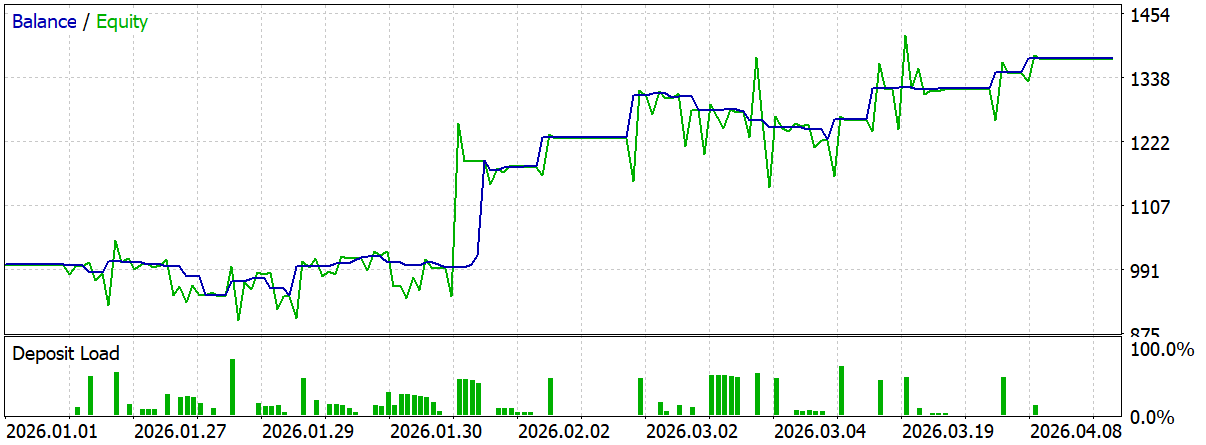
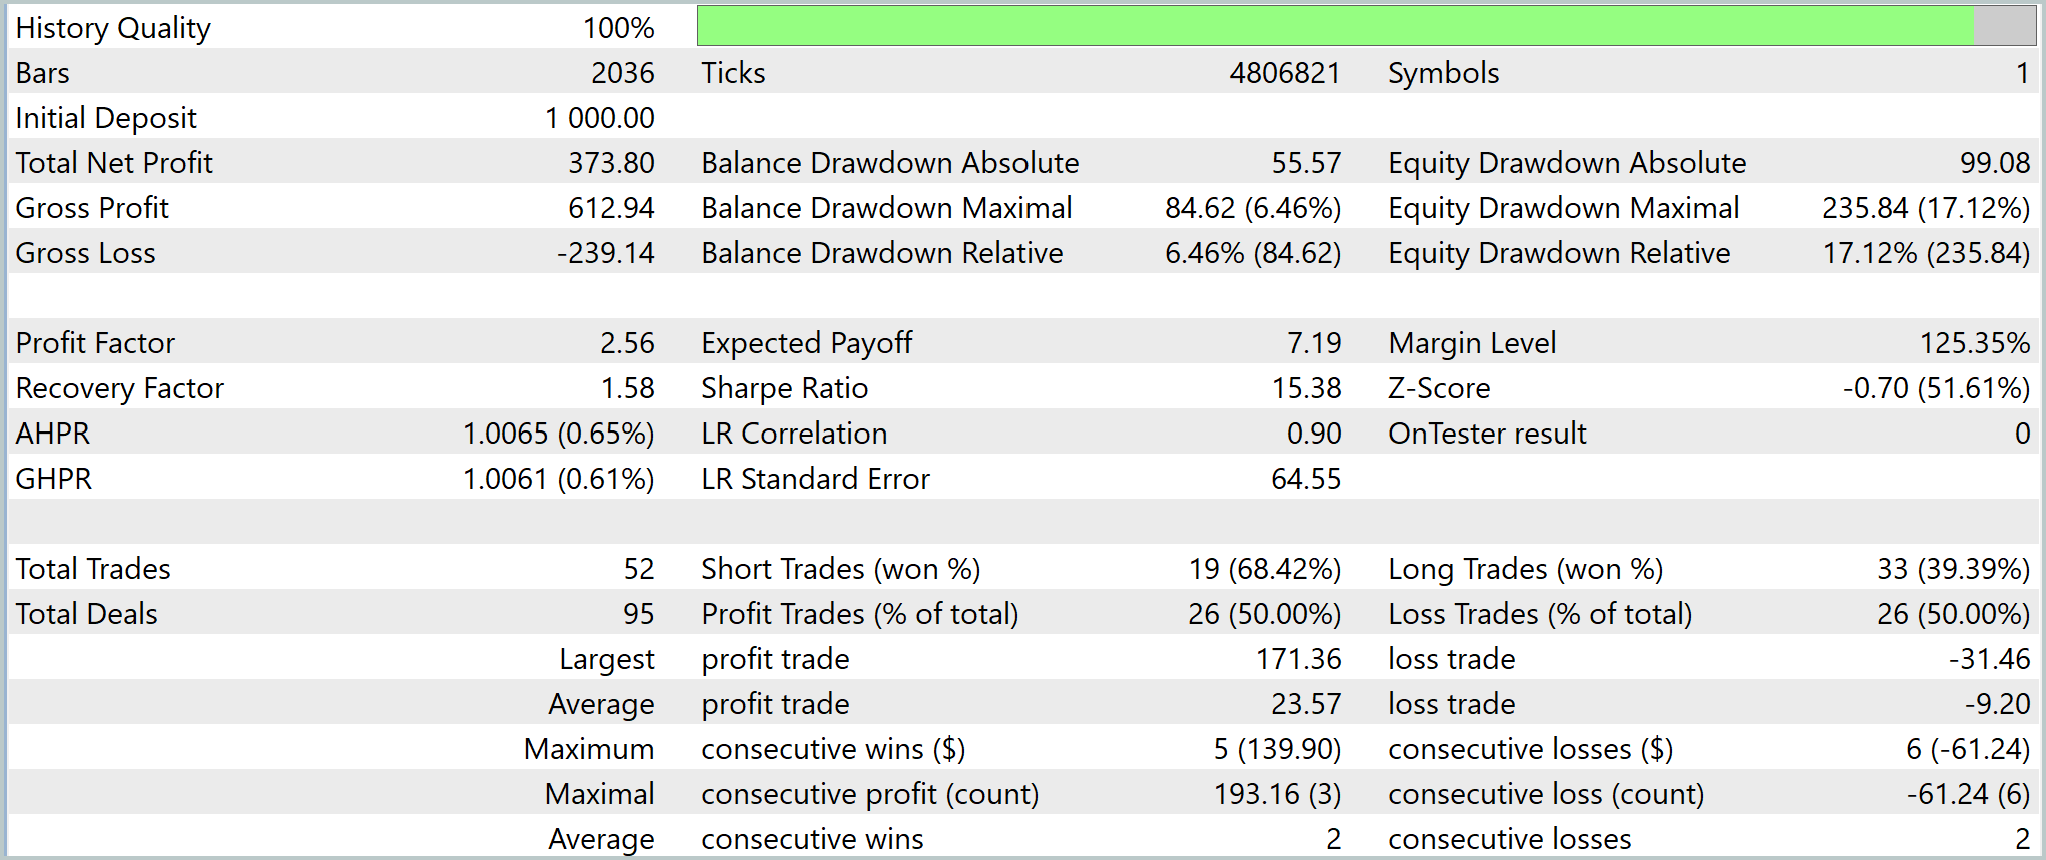
- History Quality è un punto di partenza importante.
Le condizioni di prova eliminano ogni dubbio sulla correttezza dell'esecuzione. I risultati possono essere considerati tecnicamente affidabili, il che significa che l'analisi delle metriche è significativa. - Risultato finanziario (Total Net Profit) pari a 373.80 USD con un deposito iniziale di 1000.00 USD.
Ciò significa che la strategia ha completato il test con risultati positivi. Tuttavia, questa metrica da sola non dice nulla sulla qualità della logica, quindi dovrebbe essere letta insieme ad altre metriche. - Gross Profit è risultato pari a 612.94 USD, mentre Gross Loss è stata di -239.14 USD.
Ciò significa che i trade profittevoli hanno superato di gran lunga quelle in perdita, determinando il risultato positivo. La strategia trae vantaggio da una costante prevalenza di risultati positivi. - Profit Factor è pari a 2.56.
Si tratta di un indicatore significativo. Il profitto è più di due volte e mezzo superiore alla perdita. Per un sistema di trading, questo è già un segnale che i trade positivi superano effettivamente quelli negativi. - Expected Payoff era pari a 7.19.
Ciò significa che, in media, ogni trade ha prodotto un contributo matematico positivo. Il sistema non si basa su una o due serie di successi, ma mantiene un'aspettativa positiva a livello di singola operazione. - Recovery Factor pari a 1.58 indica in che misura il risultato giustifica il drawdown registrato.
In questo caso, il sistema è in grado di riprendersi dalle perdite, sebbene il margine di sicurezza non possa essere definito elevato. La strategia funziona, ma non bisogna sottovalutare i drawdown. - Sharpe Ratio ha raggiunto 15.38.
Si tratta di un valore molto elevato, che indica un alto rapporto tra rendimento e volatilità dei risultati. È importante però ricordare che nel tester questo indicatore va letto insieme ai drawdown e alla serialità dei trade. - AHPR era pari a 1.0065, ovvero lo 0.65%. GHPR era pari a 1.0061, ovvero lo 0.61%.
Queste metriche mostrano la redditività media di un trade in termini aritmetici e geometrici. La conclusione è chiara: la crescita c'è, ed è intrinseca alla struttura dei flussi dei trade. - Balance Drawdown Absolute ammontava a 55.57 USD, Balance Drawdown Maximal - di 84,62 USD, pari al 6.46% (Balance Drawdown Relative).
Ciò significa che la strategia è rimasta relativamente equilibrata. Le operazioni concluse hanno prodotto una curva del saldo accettabile. - Equity Drawdown mostra un quadro completamente diverso. Il drawdown assoluto è stato di 99.08 USD, quello massimo di 235.84 USD, che corrisponde al 17,12%.
Questo è un punto importante: le posizioni aperte hanno creato un'esposizione al mercato, anche se il saldo finale è apparso moderato. La conclusione è onesta: la strategia è in grado di generare profitto, ma non senza tensioni interne. - Margin Level era pari al 125.35%.
Si tratta di un livello di sicurezza, ma senza un margine significativo. Ciò dimostra che la riserva di margine era sufficiente. Tuttavia, il sistema non operava in condizioni sterili. La logica di trading è rimasta entro i limiti operativi, senza esercitare una pressione critica sul conto. - Z-Score è risultato pari a -0,70 al livello di significatività del 51.61%.
Ciò indica l'assenza di una serie anomala di vittorie e sconfitte chiaramente definita. In altre parole, i risultati non sembrano frutto di una fortunata coincidenza. La sequenza dei trade è più simile a una struttura di trading funzionante che a rumore casuale. - LR Correlation è pari a 0.90, mentre LR Standard Error - 64.55.
La correlazione indica un andamento lineare piuttosto regolare dell’equity curve. L'errore standard mostra che il movimento non è stato perfettamente uniforme. Si registra una crescita, ma è avvenuta attraverso le normali fluttuazioni del mercato. - Complessivamente, sono state aperte 52 posizioni (Total Trades) e registrate 95 transazioni (Total Deals).
Si tratta già di un volume sufficiente per comprendere la natura della strategia. Il test non si limita a pochi input casuali, ma fornisce un quadro molto significativo. - Gli Short Trades comprendevano 19 trade, di cui il 68.42% profittevoli, mentre i Long Trades - 33 trade, di cui il 39.39% profittevoli.
Si osserva un'interessante discrepanza nella direzione dei trade. Questo è un segnale molto importante. La strategia gestisce le operazioni short in modo nettamente migliore rispetto a quelle long. Ciò significa che potrebbe presentare una marcata propensione ai movimenti al ribasso. - I Profit Trades e i Loss Trades sono risultati uguali - 26 trade ciascuno, ovvero il 50.00% ognuno.
A prima vista sembra una parità, ma ciò non impedisce al sistema di rimanere redditizio. La strategia genera profitto grazie alla qualità dei trade. - L'operazione più redditizia (Largest profit trade) ha generato un guadagno di 171.36 USD, mentre quella in perdita (Largest loss trade) — -31.46 USD.
L’Average profit trade è pari a 23.57 USD, mentre quelle in perdita (Average loss trade è pari a -9.20 USD. Questi sono forse alcuni degli indicatori più importanti del report. Il valore medio di un'operazione vincente è più del doppio del valore medio di un'operazione perdente. Il sistema è in grado di mantenere un vantaggio anche con una quota non ideale di ingressi riusciti. - Maximum consecutive wins è stato di 5 trade per un totale di 139.90 USD, mentre Maximum consecutive losses — 6 trade per un totale di -61.24 USD.
Ciò dimostra che la strategia è in grado di sfruttare i periodi positivi, ma non è immune ai periodi negativi.
Ciascuna metrica rappresenta un aspetto differente delle meccaniche della strategia. Questo è il principale vantaggio della piattaforma: ci permette di vedere non solo il risultato, ma anche la sua struttura.
Conclusioni
L'apprendimento automatico nel trading spesso appare un argomento complesso e sovraccarico. Ma la pratica dimostra il contrario. MetaTrader 5 contiene la maggior parte degli strumenti necessari per costruire una pipeline ML completa. Questo era precisamente lo scopo principale dell'articolo. Anziché presentare un modello magico e tentare ancora una volta di prevedere l'andamento del mercato, il testo analizza il percorso stesso: dai dati di mercato ordinari a un modello ONNX funzionante all'interno del terminale. È particolarmente importante sottolineare che le matrici e i vettori integrati in MQL5 svolgono un ruolo chiave in questo contesto. Trasformano la preparazione dei dati da un insieme di operazioni disparate in una struttura computazionale chiara e gestibile.
Normalizzazione, calcolo statistico, elaborazione dello spazio delle caratteristiche, trasformazione PCA — tutto ciò viene riprodotto direttamente all'interno del terminale in una forma pressoché identica a quella descritta matematicamente. Il codice smette di essere sovraccarico di dettagli tecnici e inizia a riflettere la logica dei calcoli stessi. Ciò riduce drasticamente la soglia di accesso allo sviluppo di un algoritmo di ML per un trader.
Anche il supporto per ONNX è importante. MetaTrader 5 consente di utilizzare il modello come blocco computazionale predefinito. Python rimane uno strumento per la preparazione del modello, mentre il terminale diventa un ambiente stabile per la sua esecuzione e il suo controllo. Questa suddivisione rende l'architettura molto più pulita e funzionale. Il modello viene addestrato una sola volta e il lavoro successivo viene trasferito a MQL5. Ciò garantisce trasparenza, riproducibilità e controllo completo sui dati di input.
Lo strategy tester di MetaTrader 5 è particolarmente utile. Ciò ci consente di valutare non solo il profitto finale, ma anche il comportamento interno dell'intero sistema. Drawdown, stabilità dell’equity curve, struttura dei trade, qualità del recupero dalle perdite, stabilità del ritmo di trading - tutto ciò diventa misurabile attraverso una ricca serie di metriche integrate. Dietro ognuna di queste metriche si cela un aspetto distinto del comportamento della strategia. È questo approccio che trasforma i test da una verifica formale in una vera e propria analisi ingegneristica.
Di conseguenza, MetaTrader 5 può essere utilizzato per la creazione e la riproduzione di pipeline ML senza dover trasferire la logica a infrastrutture esterne. La conclusione principale: In MetaTrader 5, l'apprendimento automatico (ML) è implementato tramite matematica lineare, matrici e una preparazione trasparente dei dati, senza avere la sensazione che l’ML sia come qualcosa di separato dal terminale.
Programmi utilizzati nell'articolo
| # | Nome | Tipo | Descrizione |
|---|---|---|---|
| 1 | create_pca_lstm.py | Script | Script per la creazione e l'addestramento del modello |
| 2 | MLpipeline.mq5 | Expert Advisor | EA per testare il modello ONNX |
Tradotto dal russo da MetaQuotes Ltd.
Articolo originale: https://www.mql5.com/ru/articles/22474
Avvertimento: Tutti i diritti su questi materiali sono riservati a MetaQuotes Ltd. La copia o la ristampa di questi materiali in tutto o in parte sono proibite.
 Arriva il Nuovo MetaTrader 5 e MQL5
 La potenza di MetaTrader 5: Dal debug passo-passo alla protezione dei file EX5 in un ambiente integrato
 Utilizza i canali MQL5.community e le chat di gruppo
 Come abbiamo creato la piattaforma di trading più potente basata sull'apprendimento automatico: L'evoluzione di MQL e MetaTrader attraverso archivi, forum e nuove versioni.

- App di trading gratuite
- Oltre 8.000 segnali per il copy trading
- Notizie economiche per esplorare i mercati finanziari
Accetti la politica del sito e le condizioni d’uso
A mio modesto parere, normalizzare e calcolare la PCA sull’intero set di dati e solo successivamente dividerlo in set di addestramento e di validazione significa guardare al futuro. Quando si lavora online, non è possibile modificare la normalizzazione o adattare la PCA in base ai dati più recenti. Un esperimento corretto consisterebbe nel dividere inizialmente i dati in due insiemi e poi applicare la normalizzazione e la PCA solo alla parte in-sample, per poi applicare i metaparametri di trasformazione dei dati di input così individuati alla parte out-of-sample.
Di conseguenza, anche un semplice indicatore a lancetta mostra le lancette «ai punti di svolta».
È una cosa pericolosa: non si capisce subito dove sta il trucco.