Nikolai Semko: Então está disposto a acender uma nota de 100 dólares para encontrar um centavo enrolado debaixo da cama?
Pode ou não ser uma moeda
srand(GetTickCount());
uint v10 = 0, v19900 = 0;
for (uint i = 0; i < UINT_MAX; ++ i) {
int cur = rand();
if (cur % 20000 == 10)
++ v10;
elseif (cur % 20000 == 19900)
++ v19900;
}
Alert("10 probability = ", (double)v10/UINT_MAX*100, "%; 1990 probability = ", (double)v19900/UINT_MAX*100, "%");
// Alert: 10 probability = 0.006103515626421085%; 19900 probability = 0.003051757813210543%
A probabilidade de um dez é duas vezes mais elevada. E o mais importante, o get_rand() costliness claim é sugado da sua mão, então porquê obter números aleatórios através da porta traseira com uma probabilidade deslocada (enquanto espera uma distribuição uniforme) quando pode ter uma distribuição normal? Não está a guardar uma nota de 100 dólares, está a guardar fósforos.
Sim, eu estava enganado quanto à grande lentidão da sua função. Interpretei mal o algoritmo. Desculpe. Mas ainda assim o meu algoritmo é o mais rápido de todos os propostos, apesar de ser mais universal e não limitado a 32767, como o seu. Código para o provar.
Este guião gera aleatoriamente um conjunto de pontos com cores e coordenadas aleatórias. O tamanho da matriz é igual ao número de pixels no gráfico. É repetido 5 vezes
2019.06.0903:42:25.958 TestSpeedRand (EURGBP,H4) Время формирования случайных массивов = 9894 микросекунд. Всего сгенерировано 5203975 случайных чисел rand()
2019.06.0903:42:28.010 TestSpeedRand (EURGBP,H4) Время формирования случайных массивов = 24899 микросекунд. Всего сгенерировано 5203975 случайных чисел get_rand()
2019.06.0903:42:30.057 TestSpeedRand (EURGBP,H4) Время формирования случайных массивов = 22172 микросекунд. Всего сгенерировано 5203975 случайных чисел randUlong()
2019.06.0903:42:32.098 TestSpeedRand (EURGBP,H4) Время формирования случайных массивов = 16013 микросекунд. Всего сгенерировано 5203975 случайных чисел randUint()
2019.06.0903:42:34.145 TestSpeedRand (EURGBP,H4) Время формирования случайных массивов = 25524 микросекунд. Всего сгенерировано 5203975 случайных чисел RandomLong()
Apanhei números de tal forma para mostrar a essência do problema, quando aplicamos rand()%20000
funcionará ainda mais rapidamente. Esta função irá gerar um número aleatório de 0 a 1073741824. Este número é ainda maior do que o número de carraças para qualquer instrumento ao longo de toda a história. A "injustiça" de tal função seria microscópica para 99,9% das tarefas.
Mas mesmo assim o meu algoritmo revela-se o mais rápido de todos os algoritmos propostos, apesar de ser mais universal e não limitado a 32767 como o seu. O código como prova.
Obrigado pelo trabalho, resultados realmente interessantes. Acontece que a função rand() é tão rápida que funciona mais rapidamente do que as operações aritméticas.
Obrigado pelo esforço, resultados realmente interessantes. Acontece que o rand() é tão rápido que é mais rápido do que as operações aritméticas.
Não, não é. Cerca de um nanossegundo, tal como extrair a raiz quadrada a partir de um número duplo. As operações +-*/ são realizadas em fracções de um nanossegundo. Mas tal como a raiz quadrada, o rand() é executado em processadores modernos a nível de hardware, não programático.
não, não mais rápido. Cerca de um nanossegundo, tal como extrair a raiz quadrada a partir de um número duplo. As operações +-*/ são realizadas em fracções de um nanossegundo. Mas tal como a raiz quadrada, o rand() é executado em processadores modernos a nível de hardware, não programático.
Porque não, não é. A sua versão difere da minha porque rand() é sempre chamada 5 vezes enquanto a minha tem uma média de 1,64 vezes a 20 000 e 1 vez a 256. Ao todo rand() é chamada 25 vezes para cada iteração no seu código enquanto a minha tem 1,64*2+3 = 5,3 vezes. É claro que a situação é estranha, temos de descobrir qual é exactamente a razão. Além disso, há lá muitas operações bitwise a serem realizadas...
1. Bem, compreendemos que nas suas funções o problema não está resolvido, mas apenas mascarado, não vou perder peso, vou apenas apertar mais o meu cinto.
2. Nas nossas versões e nas de Alexey é o pior cenário, enquanto em muitas outras situações a velocidade estará quase ao nível do rand(), enquanto se tem tempo constante.
Alguma vez se perguntou porque é que o rand() gera números num intervalo tão estreito? Este é um gerador pseudo-aleatória, por isso é periódico, gerando assim um monte de números aleatórios em locais onde não é necessário, com posterior descarte dos mesmos, a sua qualidade está a deteriorar-se (irá repetir-se mais cedo).
4. Algumas pessoas extraem dados aleatórios de uma forma mais complicada. Eu, por exemplo, puxar da rede, alguém pode até comprá-la. Porque haveria de querer desperdiçar dados duramente conquistados para depois descartá-los (gerar ulong, escrever o algoritmo certo não é o nosso caminho)?
Porque não, se sim. A sua versão difere da minha porque chama sempre 5 rand() enquanto que a minha tem uma média de 1,64 vezes a 20 000 intervalos e 1 vez a 256 intervalos. Ao todo, o seu rand() é chamado 25 vezes para cada iteração, enquanto que a minha tem 1,64*2+3 = 5,3 vezes. É claro que esta situação é estranha, temos de descobrir qual é exactamente a razão. Porque, para além disso, tem lá muitas operações bitwise a serem realizadas...
são as operações mais baratas. Quase sem custos.
Mas de um modo geral, concordo. Também não compreendo porquê... Talvez sejam as maravilhas da optimização. Embora o que aí pode ser optimizado...
Mas de um modo geral, concordo. Também não compreendo porquê... Talvez sejam as maravilhas da optimização. Embora o que há para optimizar...
Parece que não se trata de operações aritméticas, porque não existem, todos os valores são calculados na fase de compilação. A razão é a presença de um laço com um número desconhecido de iterações (embora estas iterações sejam em média inferiores a duas). Assim, o seu código é de alguma forma optimizado devido ao número conhecido de chamadas rand()
1. Bem, compreendemos que nas suas funções o problema não está resolvido, mas apenas mascarado, não vou perder peso, vou apenas apertar mais o meu cinto.
2. Nas nossas e nas variantes de Alexey é o pior cenário, enquanto em muitas outras situações a velocidade será quase ao nível do rand(), enquanto se tem tempo constante.
Alguma vez se perguntou porque é que o rand() gera números num intervalo tão estreito? Este é um gerador pseudo-aleatória, portanto é periódico, gerando assim um monte de números aleatórios onde não é necessário, com posterior descarte, a sua qualidade está a deteriorar-se (irá repetir-se mais cedo).
4. Algumas pessoas extraem dados aleatórios de uma forma mais complicada. Eu, por exemplo, puxar da rede, alguém pode até comprá-la. É por isso que eu deveria desperdiçar dados difíceis de obter para depois estupidamente os descartar (gerar ulong, escrever um algoritmo adequado não é o nosso caminho, afinal de contas)?
bem, isso é nerd. Para reproduzir a situação, quando este problema for perceptível pelo menos em 0,1%, é necessário operar com intervalos acima dos seguintes valores:
(ULONG_MAX)/1000= 18446744073709551 para a função randUlong()
(UINT_MAX)/1000= 4294967 para a função randUint()
Alguma vez utilizou tais intervalos? Então porque é que colocou estes controlos e laços? O melhor é o inimigo do bom.
Pessoalmente, os meus intervalos degeração aleatórios na prática são limitados a 2000, 4000 no máximo. rand() funciona bastante bem para este fim. Inserir tal opção no meu código:
ulong t=GetMicrosecondCount();
for(int i=0;i<size;i++)
{
X[i]=ushort(rand()%W.Width);
Y[i]=ushort(rand()%W.Width);
clr[i]=XRGB(rand()%256,rand()%256,rand()%256);
}
t=GetMicrosecondCount()-t;
Print("Время формирования случайных массивов = "+string(t)+" микросекунд. Всего сгенерировано "+string(size*5)+" случайных чисел rand()%W.Width");
Canvas.Erase();
for(int i=0;i<size;i++) Canvas.PixelSet(X[i],Y[i],clr[i]);
Canvas.Update();
Sleep(2000);
Assim, não notará "injustiça" da função rand() (como foi com rand()%20000) e os pontos serão situados visualmente de forma uniforme, pelo que é a função mais rápida e mais eficiente.
Não é por nada que os programadores do processador limitaram rand() a 2^15=32768. Eles não são pessoas estúpidas. Isto cobre 99% dos problemas práticos. E para os amantes de ideias "extremas" existe uma opção mais do que suficiente:
Pessoalmente, os meus intervalos degeração de números aleatórios na prática são limitados a 2000, máximo 4000. Para isto, rand() funciona bastante bem. Inserir tal variante no meu código:
e não notará "injustiça" da função rand() (como era com rand()%20000) e os pontos serão visualmente uniformes, por isso está a funcionar bastante e é o mais rápido.
É bem-vinda a sua utilização, não me importo. Tanto mais que o lado direito de % é um múltiplo de RAND_MAX+1 (256 ou 1024).
Não é por nada que os programadores do processador limitaram rand() a 2^15=32768. Eles não são pessoas estúpidas. Cobre 99% das tarefas práticas. E há variantes mais do que suficientes para aqueles que gostam de ideias "fora dos limites":
O que é que os desenvolvedores de processadores têm a ver com isto? O gerador é um software implementado. O único requisito é RAND_MAX >= 32767 e um período de pelo menos 2^32. Assim, o µl tem um oscilador muito esparso em "mínimos".
E os mais clarividentes farão eles próprios um rand() justo (se não houver multiplicidade), isto até é recomendado em livros de referência.
Então está disposto a acender uma nota de 100 dólares para encontrar um centavo enrolado debaixo da cama?
Pode ou não ser uma moeda
A probabilidade de um dez é duas vezes mais elevada. E o mais importante, o get_rand() costliness claim é sugado da sua mão, então porquê obter números aleatórios através da porta traseira com uma probabilidade deslocada (enquanto espera uma distribuição uniforme) quando pode ter uma distribuição normal? Não está a guardar uma nota de 100 dólares, está a guardar fósforos.
Pode ou não ser uma moeda
A probabilidade de um dez é duas vezes mais elevada. E o mais importante, o get_rand() costliness claim é sugado da sua mão, então porquê obter números aleatórios através da porta traseira com uma probabilidade deslocada (enquanto espera uma distribuição uniforme) quando pode ter uma distribuição normal? Não está a guardar uma nota de 100 dólares, está a guardar fósforos.
Sim, eu estava enganado quanto à grande lentidão da sua função. Interpretei mal o algoritmo. Desculpe.
Mas ainda assim o meu algoritmo é o mais rápido de todos os propostos, apesar de ser mais universal e não limitado a 32767, como o seu.
Código para o provar.
Este guião gera aleatoriamente um conjunto de pontos com cores e coordenadas aleatórias. O tamanho da matriz é igual ao número de pixels no gráfico. É repetido 5 vezes
Apanhei números de tal forma para mostrar a essência do problema, quando aplicamos rand()%20000
como deve ser:
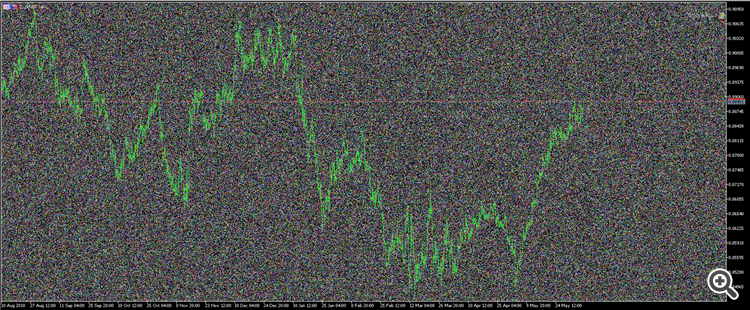
Mas 99,9% do tempo, esta função também funcionará: funcionará ainda mais rapidamente.Esta função irá gerar um número aleatório de 0 a 1073741824. Este número é ainda maior do que o número de carraças para qualquer instrumento ao longo de toda a história. A "injustiça" de tal função seria microscópica para 99,9% das tarefas.
Mas mesmo assim o meu algoritmo revela-se o mais rápido de todos os algoritmos propostos, apesar de ser mais universal e não limitado a 32767 como o seu.
O código como prova.
Obrigado pelo trabalho, resultados realmente interessantes. Acontece que a função rand() é tão rápida que funciona mais rapidamente do que as operações aritméticas.
Obrigado pelo esforço, resultados realmente interessantes. Acontece que o rand() é tão rápido que é mais rápido do que as operações aritméticas.
Não, não é. Cerca de um nanossegundo, tal como extrair a raiz quadrada a partir de um número duplo. As operações +-*/ são realizadas em fracções de um nanossegundo.
Mas tal como a raiz quadrada, o rand() é executado em processadores modernos a nível de hardware, não programático.
não, não mais rápido. Cerca de um nanossegundo, tal como extrair a raiz quadrada a partir de um número duplo. As operações +-*/ são realizadas em fracções de um nanossegundo.
Mas tal como a raiz quadrada, o rand() é executado em processadores modernos a nível de hardware, não programático.
Porque não, não é. A sua versão difere da minha porque rand() é sempre chamada 5 vezes enquanto a minha tem uma média de 1,64 vezes a 20 000 e 1 vez a 256. Ao todo rand() é chamada 25 vezes para cada iteração no seu código enquanto a minha tem 1,64*2+3 = 5,3 vezes. É claro que a situação é estranha, temos de descobrir qual é exactamente a razão. Além disso, há lá muitas operações bitwise a serem realizadas...
1. Bem, compreendemos que nas suas funções o problema não está resolvido, mas apenas mascarado, não vou perder peso, vou apenas apertar mais o meu cinto.
2. Nas nossas versões e nas de Alexey é o pior cenário, enquanto em muitas outras situações a velocidade estará quase ao nível do rand(), enquanto se tem tempo constante.
Alguma vez se perguntou porque é que o rand() gera números num intervalo tão estreito? Este é um gerador pseudo-aleatória, por isso é periódico, gerando assim um monte de números aleatórios em locais onde não é necessário, com posterior descarte dos mesmos, a sua qualidade está a deteriorar-se (irá repetir-se mais cedo).
4. Algumas pessoas extraem dados aleatórios de uma forma mais complicada. Eu, por exemplo, puxar da rede, alguém pode até comprá-la. Porque haveria de querer desperdiçar dados duramente conquistados para depois descartá-los (gerar ulong, escrever o algoritmo certo não é o nosso caminho)?
Porque não, se sim. A sua versão difere da minha porque chama sempre 5 rand() enquanto que a minha tem uma média de 1,64 vezes a 20 000 intervalos e 1 vez a 256 intervalos. Ao todo, o seu rand() é chamado 25 vezes para cada iteração, enquanto que a minha tem 1,64*2+3 = 5,3 vezes. É claro que esta situação é estranha, temos de descobrir qual é exactamente a razão. Porque, para além disso, tem lá muitas operações bitwise a serem realizadas...
são as operações mais baratas. Quase sem custos.
Mas de um modo geral, concordo. Também não compreendo porquê... Talvez sejam as maravilhas da optimização. Embora o que aí pode ser optimizado...
são as operações mais baratas. Quase sem custos.
Mas de um modo geral, concordo. Também não compreendo porquê... Talvez sejam as maravilhas da optimização. Embora o que há para optimizar...
1. Bem, compreendemos que nas suas funções o problema não está resolvido, mas apenas mascarado, não vou perder peso, vou apenas apertar mais o meu cinto.
2. Nas nossas e nas variantes de Alexey é o pior cenário, enquanto em muitas outras situações a velocidade será quase ao nível do rand(), enquanto se tem tempo constante.
Alguma vez se perguntou porque é que o rand() gera números num intervalo tão estreito? Este é um gerador pseudo-aleatória, portanto é periódico, gerando assim um monte de números aleatórios onde não é necessário, com posterior descarte, a sua qualidade está a deteriorar-se (irá repetir-se mais cedo).
4. Algumas pessoas extraem dados aleatórios de uma forma mais complicada. Eu, por exemplo, puxar da rede, alguém pode até comprá-la. É por isso que eu deveria desperdiçar dados difíceis de obter para depois estupidamente os descartar (gerar ulong, escrever um algoritmo adequado não é o nosso caminho, afinal de contas)?
bem, isso é nerd.
Para reproduzir a situação, quando este problema for perceptível pelo menos em 0,1%, é necessário operar com intervalos acima dos seguintes valores:
Alguma vez utilizou tais intervalos? Então porque é que colocou estes controlos e laços?
O melhor é o inimigo do bom.
Pessoalmente, os meus intervalos degeração aleatórios na prática são limitados a 2000, 4000 no máximo. rand() funciona bastante bem para este fim.
Inserir tal opção no meu código:
Assim, não notará "injustiça" da função rand() (como foi com rand()%20000) e os pontos serão situados visualmente de forma uniforme, pelo que é a função mais rápida e mais eficiente.
Não é por nada que os programadores do processador limitaram rand() a 2^15=32768. Eles não são pessoas estúpidas. Isto cobre 99% dos problemas práticos.
E para os amantes de ideias "extremas" existe uma opção mais do que suficiente:
Pessoalmente, os meus intervalos degeração de números aleatórios na prática são limitados a 2000, máximo 4000. Para isto, rand() funciona bastante bem.
Inserir tal variante no meu código:
e não notará "injustiça" da função rand() (como era com rand()%20000) e os pontos serão visualmente uniformes, por isso está a funcionar bastante e é o mais rápido.
É bem-vinda a sua utilização, não me importo. Tanto mais que o lado direito de % é um múltiplo de RAND_MAX+1 (256 ou 1024).
E há variantes mais do que suficientes para aqueles que gostam de ideias "fora dos limites":
O que é que os desenvolvedores de processadores têm a ver com isto? O gerador é um software implementado. O único requisito é RAND_MAX >= 32767 e um período de pelo menos 2^32. Assim, o µl tem um oscilador muito esparso em "mínimos".
E os mais clarividentes farão eles próprios um rand() justo (se não houver multiplicidade), isto até é recomendado em livros de referência.