Trixter SVM

  • Experts
  • Andrei Samokhin
    Andrei Samokhin
    Welcome to my seller page. I develop applications in the fields of AI and machine learning, and I am also passionate about trading systems. My products are based on various machine learning techniques. I research and apply state-of-the-art algorithms for time series analysis and am constantly
  • 버전: 1.0
  • 활성화: 10

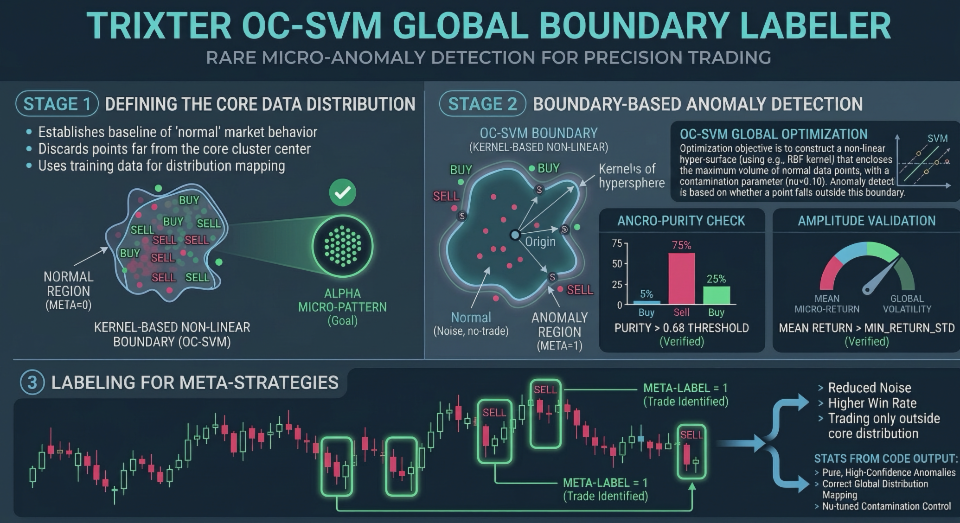
SVM은 이진 분류 문제를 해결한다: 두 클래스를 분리한다. 하지만 One-Class SVM은 단 하나의 클래스 데이터("정상" 예시)로만 학습하며, 그 주위에 경계(변환된 공간에서의 초평면)를 구축하여 이 영역을 나머지 모든 것과 분리한다.

영역 내부에 들어오는 모든 것은 정상으로 간주되고, 외부에 있는 모든 것은 이상으로 간주된다.

작동 방식

  1. 데이터는 특징 공간으로 매핑된다(커널, 예를 들어 RBF를 통해).

  2. 알고리즘은 원점에서 최대한 멀리 떨어져 대부분의 점을 0에서 분리하는 초평면을 찾는다.

  3. 매개변수 ν (뉴)는 다음을 정의한다:

    • 훈련 샘플에서 이상치 비율의 상한,

    • 서포트 벡터 비율의 하한.

  4. 경계의 "반대편"에 있는 점들은 이상으로 간주된다.

용도

  • 이상 / 이상치 탐지 (사기 탐지, 네트워크 침입, 시세의 스파이크).

  • 신규성 탐지(novelty detection) — "깨끗한" 정상 데이터만 있고 편차를 잡아내야 할 때.

  • 시스템 모니터링 — 정상 행동에서 지표의 편차, 시장 비효율 탐색.


봇 Trixter SVM은 이 접근법을 적용하여 구축되었다.

Trixter SVM 알고리즘은 Support vector machine(줄여서 SVM)을 사용하여 패턴 탐색을 구현한다. 우리는 금 시장이 충분히 효율적이며 대부분의 가격 변동이 예측 불가능한 시장 잡음을 형성한다는 가정에서 출발한다. 하지만 우리는 금 차트의 일부 조각(소위 이상)을 식별할 수 있으며, 그곳에서는 최대한 예측 가능하다. 이렇게 나는 잘 예측되는 차트 구간의 40%를 선별했다.

핵심 원칙

  • 여러 타임프레임과 지표 기간에 걸친 금 변동성 분석.
  • 효과적인 패턴을 찾기 위한 변동성 그룹화(100에서 3000까지).
  • 통계적 검증: 높은 수학적 기대 이익과 통계적 유의성.
  • 검증을 통과하지 못한 패턴은 잡음으로 표시된다 — 그러한 상황에서는 거래를 열지 않는다.
  • 실계좌 허용 전 필수 2년 포워드 테스트.

거래 로직의 특징

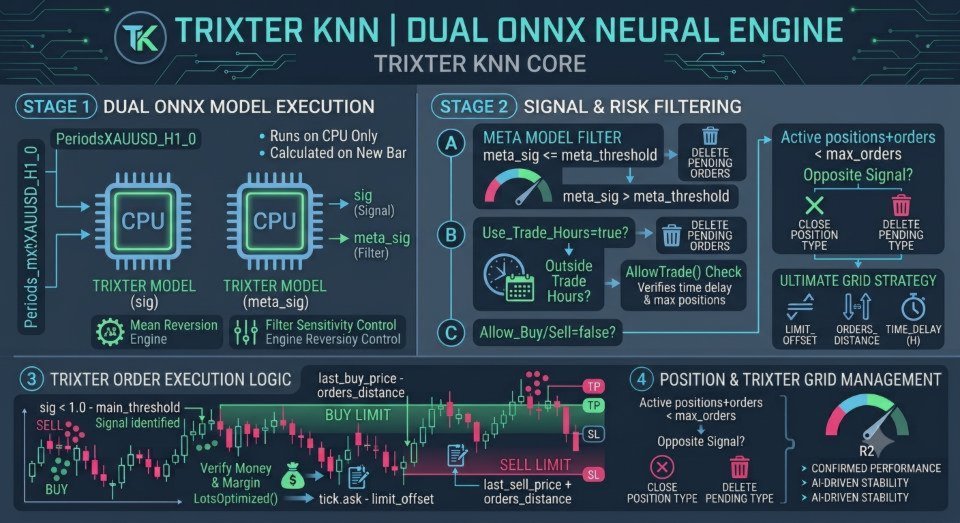
  • 가격에서 선택한 거리에 지정가 주문으로 거래 개시 — 최소 슬리피지.
  • 지정가 주문이 체결되지 않고(가격이 레벨에 닿지 않음) 신호가 사라지면 — 주문이 삭제된다.
  • 열린 포지션은 스톱로스와 테이크프로핏으로 관리되며, 반대 신호 시 시장가로 청산된다.
  • 로봇은 마틴게일, 차익거래 및 기타 고위험 전략을 사용하지 않는다.
  • 권장 타임프레임: M5부터 H1까지. 최적 — H1 XAUUSD.
  • 거래 활동의 유연한 설정이 제공된다(아래 매개변수).

주요 설정

  • Allow BUY signals, Allow SELL signals — 시장 방향에 대한 확신이 있을 때 매수/매도를 허용하거나 금지한다.
  • Signals sensitivity, Filter sensitivity — 신호 민감도와 잡음 필터링의 임계값. 기본값 — 0.5. 더 깨끗한 신호를 위해 0.7–0.9까지 높일 수 있다.
  • Filter by trading hours — 거래 시간 제한. 기본 — 24시간.

자금 관리 설정

  • Distance in points for limit order — 가격에서 지정가 주문까지의 거리. 기본: 250. 더 작게 → 거래 많음, 더 크게 → 더 보수적.
  • Max positions + orders number — 동시에 열 수 있는 최대 포지션 수(평균화 없음). 기본: 3.
  • 추가로 설정 가능: 개시 간 지연, 최대 스프레드 제어, 스톱로스 및 테이크프로핏 레벨.
중요: 기본 설정은 이미 구성되어 있다. 특별한 필요 없이 변경하지 마십시오. 공장 매개변수로 되돌릴 수 있도록 표준 set 파일을 저장하십시오.
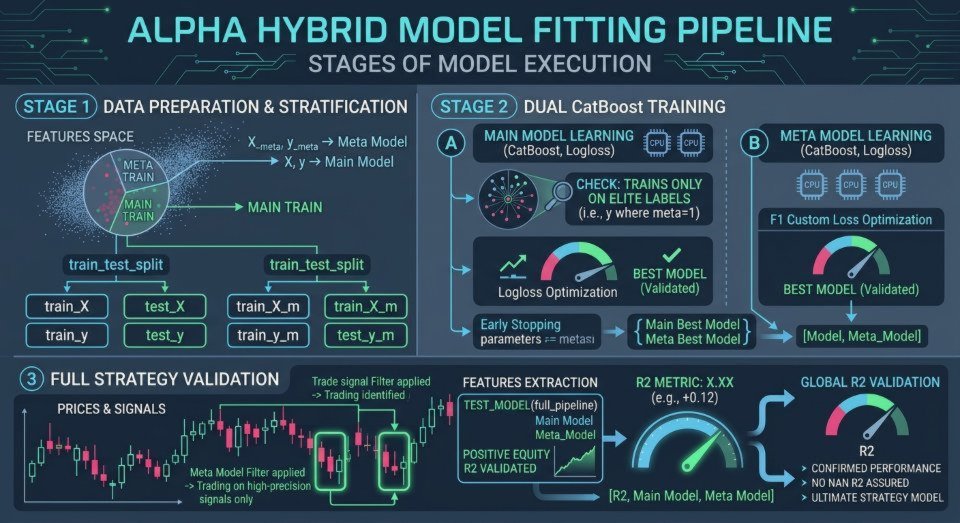
SVM + 두 분류기 → ONNX로 내보내기  |  포워드 기간: 2년  |  권장 타임프레임: H1 XAUUSD
제작자의 제품 더 보기
Trixter ISO
Andrei Samokhin
Isolation Forest 는 이상치(아웃라이어) 탐지 를 위한 머신러닝 알고리즘입니다. 알고리즘 원리: 무작위 분할: 알고리즘은 특성과 임계값을 무작위로 반복 선택하여 데이터를 분할합니다. 각 데이터 포인트가 개별 "셀"에 위치할 때까지 (또는 최대 깊이에 도달할 때까지) 계속됩니다. 격리 깊이: 이상치는 나머지 데이터로부터 분리되는 데 더 적은 분할 횟수 가 필요하므로 더 빠르게 "격리"됩니다 (밀집된 군집에서 멀리 떨어져 있습니다). 포리스트 구축: 여러 개의 무작위 결정 트리(포리스트)가 생성되며, 각 포인트에 대해 전체 트리에서의 평균 격리 깊이 가 계산됩니다. 이상치 점수: 평균 깊이가 작을수록 해당 포인트가 이상치일 확률이 높아집니다 (이를 기반으로 0에서 1 사이의 이상치 점수 가 산출됩니다). 사용 용도: 데이터 내 아웃라이어 탐색 ( 사기 거래 , 장비 오류, 네트워크 침입). 다른 모델 학습 전 데이터 정제 (노이즈 제거). 실시간 시스템 모니터링 (센서 수
Trixter KNN
Andrei Samokhin
Trixter KNN Gold — 금의 변동성 분석에 기반한 지능형 트레이딩 시스템입니다. 이 봇은 최근접 이웃(KNN) 방법을 기반으로 한 스마트 패턴 검색을 사용합니다. 발견된 패턴은 두 개의 분류기로 처리된 후, 모델이 ONNX 형식으로 내보내집니다. 핵심 원칙 여러 시간대 및 지표 기간에 걸친 금 변동성 분석. 효과적인 패턴(100~3000개)을 찾기 위한 변동성 그룹화. 통계적 검증: 높은 수익의 수학적 기대치 및 통계적 유의성. 검증을 통과하지 못한 패턴은 노이즈로 표시되며, 이러한 상황에서는 거래가 개설되지 않습니다. 실계좌 승인 전 2년간의 포워드 테스트가 의무적으로 수행됩니다. 트레이딩 로직 특징 가격에서 선택된 거리에 지정가 주문으로 거래 개설 — 슬리피지 최소화. 지정가 주문이 체결되지 않고(가격이 수준에 도달하지 않음) 신호가 사라진 경우 — 주문이 삭제됩니다. 개설된 포지션은 스탑로스 및 테이크프로핏으로 관리되며, 반대 신호 발생 시 시장가로 청산됩니다. 이
Trixter DTR
Andrei Samokhin
의사결정나무(Decision tree) 는 "예/아니오"의 순차적 질문 원리로 작동하는 지도형 머신러닝 알고리즘입니다. 다음과 같은 트리 구조를 가지고 있습니다: 내부 노드 — 특정 특성에 대한 확인입니다(예: "나이 > 18?"). 가지 — 확인 결과입니다(예/아니오). 잎 노드 — 최종 결정(답변)입니다. 구축 과정은 알고리즘이 각 단계에서 가장 중요한 특성을 자동으로 찾아내고( 지니 계수 또는 엔트로피 같은 기준 사용), 순수한 잎 노드를 얻거나 제약 조건에 도달할 때까지 데이터를 더 균질한 그룹으로 분할하는 것입니다. 용도는 무엇인가요? 의사결정나무는 다용도로 사용되며 두 가지 주요 유형의 작업에 적용됩니다: 분류 (범주형 응답): 은행에서 고객을 "승인" 또는 "거부" 범주로 분류. 특성을 기반으로 동물 종을 식별. 금융 자산의 매수 또는 매도 확률을 결정. 회귀 (수치형 응답): 면적과 위치를 기반으로 아파트 가격을 예측. 금의 움직임 방향을 예측. 주요 장점: 투명성 및
Trixter breakout
Andrei Samokhin
본 봇은 골드 레벨 돌파(Breakout) 전략으로 거래합니다! 핵심 원칙 다중 타임프레임 및 지표 주기를 통한 골드 변동성 분석. 효과적인 패턴을 찾기 위한 변동성 그룹화 (100~3000). 통계적 검증: 높은 수학적 기댓값(수익률) 및 통계적 유의성 확보. 검증을 통과하지 못한 패턴은 노이즈로 분류되며, 해당 상황에서는 거래를 진입하지 않음. 실계좌 운용 전 2년간의 전향적 테스트(Forward Test) 필수 진행. 매매 로직의 특징 현재가로부터 일정 거리에 스탑 주문(Stop Order)을 배치하여 진입 — 레벨 돌파 매매. 스탑 주문이 체결되지 않고(가가 레벨에 도달하지 않음) 신호가 소멸하면 주문 자동 취소. 진입된 포지션은 손절매(Stop Loss) 및 익절매(Take Profit)가 설정되며, 반대 신호 발생 시 시장가로 청산. 마틴게일, 아비트라지(차익거래) 및 기타 고위험 전략은 일체 사용하지 않음. 권장 타임프레임: M5 ~ H1 (최적
Trixter LOF
Andrei Samokhin
LOF(Local Outlier Factor) 알고리즘   은 전역 임계값으로는 감지할 수 없는 데이터 내 이상값을 찾기 위한 머신러닝 방법입니다. 단순한 방법과 달리 LOF는 점의 직접적인 주변에서 밀도를 비교하여   국지적   이상값을 찾습니다. 작동 원리 LOF의 기본 아이디어는 간단합니다. 이상값이란 주변 객체 밀도가 이웃 주변의 밀도보다 현저히 낮은 점입니다 . 이웃 선택.   각 점에 대해 알고리즘은   k   개의 최근접 이웃을 찾습니다 . 국지적 밀도 계산.   점이 이웃에 의해 얼마나 "밀접하게" 둘러싸여 있는지 계산합니다 . 이웃과 비교.   알고리즘은 점 주변의 밀도를 이웃 주변의 평균 밀도와 비교합니다 . 최종 점수.   최종   LOF   값은 점 주변의 밀도가 이웃 주변보다 몇 배나 낮은지를 나타냅니다 . LOF ≈ 1: 점의 밀도가 주변 환경과 비슷함(정상). LOF >> 1: 밀도가 현저히 낮음(잠재적 이상값). 이상값의 일반적인 임계값은   > 1.5
Trixter HFT
Andrei Samokhin
저리스크 고빈도·고속 트레이딩을 선호하시나요? 그렇다면 이 EA는 당신만을 위해 제작되었습니다. 정확한 진입 타점과 높은 기대수익률(Expected Payoff)을 바탕으로, 타이트한 손절(Stop Loss)을 잡고 가면서도 큰 익절(Take Profit) 구간을 먹는 전략입니다. 손절 대 익절 비율(손익비)은 최대 1:10에 달하여 손절 폭이 익절 폭보다 10배 작지만, 백테스트 및 포워드 테스트 결과에 따르면 억지로 물타며 버티지 않고도 꾸준한 수익을 유지합니다. 포지션이 닫힐 때까지 오래 기다리기 답답하고 빠른 승부를 선호하는 스캘퍼에게 최적화된 시스템입니다. 짧은 손절은 큰 드로우다운(Drawdown)으로 계좌가 녹거나 시간을 허비하는 일 없이, 시그널이 진짜 타점인지 단순 뇌동매매인지 검증해 주는 확실한 기준이 됩니다. 핵심 원칙 멀티 타임프레임 및 다양한 지표 주기를 활용한 골드(XAUUSD) 변동성 분석. 유효한 패턴을 찾기 위한 변동성 클러스터링 (100개 ~
Trixter Quantum
Andrei Samokhin
낮은 리스크로 고주파·고속 트레이딩을 즐기시나요? 그렇다면 Trixter Quantum 은 바로 당신을 위해 제작되었습니다. 정확한 진입 타점과 높은 수학적 기댓값을 바탕으로, 이 봇은 타이트한 손절매(Stop Loss)를 설정하면서도 큰 시세 차익을 확정짓습니다. 알고리즘의 핵심은 인접한 상태(패턴)들의 국소 얽힘 분석(Analysis of local entanglement of adjacent states)에 있으며, 이를 통해 시장의 숨겨진 미세 구조 변화를 즉각적으로 포착합니다. 손절매 대 익절매(Take Profit) 비율은 최대 1:10에 달합니다(손절 폭이 익절 폭보다 10배 작음). 테스트 결과에 따르면, 이 스캘핑 봇은 손실을 방치하며 버티지 않고 안정적인 수익을 유지합니다. 포지션이 닫힐 때까지 오래 기다리지 않고 자산의 위험을 최소화하고 싶은 트레이더에게 최적의 시스템입니다. 타이트한 손절매는 시스템의 성과를 검증하는 엄격한 기준이 되며, Trixter Qua
Trixter EE
Andrei Samokhin
Elliptic Envelope(椭圆 包络/Elliptic Envelope)은多维 데이터에서 이상치(outliers) 및 아노말리를 탐지하기 위해 설계된 파라메트릭 머신러닝 알고리즘입니다. 이 방법은 "정상" 데이터(주요 샘플)가 다대다 정규(가우스)分布를 따른다는 가정을 바탕으로 합니다. 작동 원리 타원체 형성: 特徵 공간에서 알고리즘은 중앙 점 그룹 주변에 하이퍼 타원체를 구축합니다. 이 타원체의 경계는 공분산 행렬과 特徵의 평균값에 의해 결정됩니다. 마하relativePath 거리 사용: 각 점에 대해分布의 중심까지의 마할라노비스 거리를 계산합니다. 이 거리는 단순한 거리뿐만 아니라 特徵 간의 상관관계와 서로 다른 축을 따른 데이터의 분산도 고려합니다. 로버스트성 평가(MCD): 이상치 자체가 타원체의 중심과 모양 추정을 왜곡하지 않도록 Minimum Covariance Determinant(MCD)를 사용합니다. 알고리즘은 타원체 "피팅" 과정에서 극단값을 제외하여 공분
Trixter MCD
Andrei Samokhin
방법 robust covariance (mincovdet) , 또는 Minimum Covariance Determinant (MCD) 는 데이터의 이상치에 강인한 공분산 행렬과 평균 벡터 추정 방법입니다. 방법의 아이디어 고전적인 표본 공분산은 "오염"에 매우 민감합니다. MCD는 이상치를 포함하지 않는 "깨끗한" 부분집합 을 찾고, 그것에 대해서만 표준 추정값(평균과 공분산)을 계산함으로써 이 문제를 해결합니다. MCD (mincovdet)의 용도 1. 다변량 이상치 탐지 이것이 주요 용도입니다. MCD는 평균과 공분산의 강인한 추정값을 제공하며, 이를 통해 마할라노비스 거리 가 계산됩니다. 거리가 큰 관측값은 이상치로 표시됩니다. 고전적 접근법과 달리, 추정값 자체가 이상치로 인해 "밀리지" 않기 때문에 이상치를 올바르게 식별할 수 있습니다. 2. 공분산 행렬의 강인한 추정 데이터가 오염되었을 때, 일반 표본 공분산은 크게 왜곡됩니다. MCD는 안정적인 대안을 제공합니다 —
필터:
리뷰 없음
리뷰 답변