
Вы упускаете торговые возможности:
- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Регистрация
Вход
Вы принимаете политику сайта и условия использования
Если у вас нет учетной записи, зарегистрируйтесь
GPT научить )
Хорошо, добавим индикатор Envelopes (оболочки) в наш анализ. Индикатор Envelopes представляет собой линии, расположенные выше и ниже скользящего среднего. Обычно они находятся на фиксированном процентном расстоянии от этого скользящего среднего.
Envelopes для последнего месяца (ноябрь 2023):
Общий тренд с использованием RSI, Bollinger Bands и Envelopes:
Также, учтем, что сигналы от различных индикаторов могут быть конфликтными, и важно анализировать их вместе.
Давайте продолжим с расчетами и анализом.
GPT научить )
Хорошо, добавим индикатор Envelopes (оболочки) в наш анализ. Индикатор Envelopes представляет собой линии, расположенные выше и ниже скользящего среднего. Обычно они находятся на фиксированном процентном расстоянии от этого скользящего среднего.
Envelopes для последнего месяца (ноябрь 2023):
Общий тренд с использованием RSI, Bollinger Bands и Envelopes:
Также, учтем, что сигналы от различных индикаторов могут быть конфликтными, и важно анализировать их вместе.
Давайте продолжим с расчетами и анализом.
Вы же бустнгом считаете?
Вы совершенно правы, речь идёт о CatBoost!
Там только первое дерево обучается по меткам исходного учителя.
Для всех остальных деревьев, учителем является ошибка предсказания, т.е. (Y - Pred).
Действительно, так следует из теории.
Да еще и с коэффициентом eta = 0.1...0.001
Коэффициент "скорости обучения", во всяком случае в CatBoost, фиксируется для всех деревьев.
Влияние листьев этих деревьев - незначительно, они лишь корректируют. Что вы и показали (их незначительность).
Вы действительно можете объяснить, как расставляются коэффициенты листьям в CatBoost?
Есть моменты, которые я плохо понимаю.
Однако, я продемонстрировал изменение "класса" в листьях, т.е. фактически 40% листьев оказалось тянут общий итог не в ту сторону на новых данных.
Вы действительно можете объяснить, как расставляются коэффициенты листьям в CatBoost?
Хотите, чтобы я вам перекопал код катбуста и дал точный ответ? Я копаю только то, что мне интересно. Катбустом не пользуюсь.
Учебный и простой код буста тут https://habr.com/ru/companies/vk/articles/438562/Про коэффициенты листьям впервые слышу - что это?
Сообщаю, что на отдельной выборке test - 7467, а на exam - 7177, но там есть не малое число листьев без активаций вообще - сразу не посчитал.
Так выглядит распределение сменивших класс листьев по их значению для выборки test
а это exam.
А это разбивка на классы - их три, третий "-1" - отсутствие активации.
Для выборки train
Для выборки test
Для выборки exam
В общем видно, что веса листьев больше не соответствуют логике класса - ниже график с выборки test - уже нет чёткого вектора.
В общем, аппроксимирует данный способ обучения что угодно, но вот за качество предикторов он не ручается.
Вообще, допускаю, что отчётливые "столбики" на графике выше - весьма схожие листья по месту и частоте активации.
Сложно обсуждать то, о чём не знаешь. Поэтому, могу только порадоваться за Ваши успехи. Если бы у меня был такой метод, то я бы использовал его :)
Мой метод, пока, не даёт таких качественных результатов, но он достаточно хорошо паралеллиться.
А вы не задумывались почему так происходит?
Скорость тестирования экспортированной в наивный код модели (катбуст)
И экспортированной в ONNX
внутрянка почти аналогичная у двух версий бота, результаты тоже
Хотите, чтобы я вам перекопал код катбуста и дал точный ответ? Я копаю только то, что мне интересно. Катбустом не пользуюсь.
Допустил, что Вы знаете, а так - нет - я не думал Вас обременять.
Про коэффициенты листьям впервые слышу - что это?
Значения в листьях, которые суммируются, образуя координату Y функции.
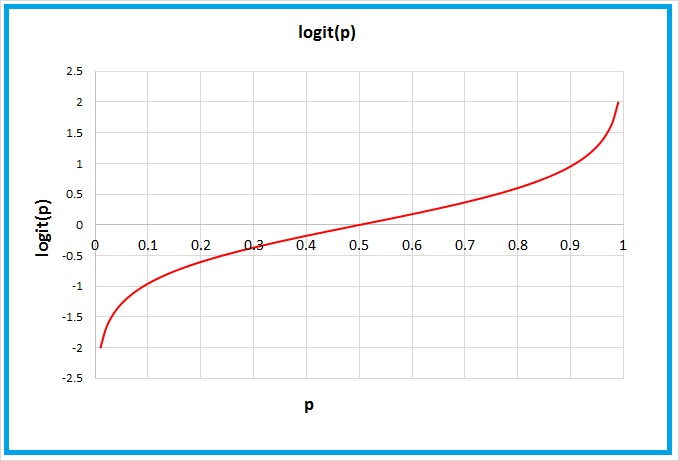
Больше или равно 0,5 по X означает, что класс "1" по умолчанию в CatBoost.А вы не задумывались почему так происходит?
По факту ошибочная закономерность в листе. Почему она такая - может быть ряд причин.
Или у Вас есть конкретный однозначный ответ?
Скорость тестирования экспортированной в наивный код модели (катбуст)
И экспортированной в ONNX
внутрянка почти аналогичная у двух версий бота, результаты тоже
Плата за универсальность.
Жаль, что у CatBoost существенные ограничения по конвертации модели.
Плата за универсальность.
Жаль, что у CatBoost существенные ограничения по конвертации модели.