Как поймать утечку будущего в обучающей выборке ещё до обучения модели
14 октября 2026, 19:54

0
7
Как поймать утечку будущего в обучающей выборке ещё до обучения модели
Готовим датасет для ONNX-модели прямо в MetaTrader 5: признаки, метки и контроль причинности
Большинство провалов машинного обучения в трейдинге случается не из-за плохой модели, а из-за
«отравленных» данных: в обучающую выборку незаметно попадает информация из будущего. Модель
выглядит отлично на истории — и разваливается в реальной торговле.
В этой заметке — как подготовить датасет в MetaTrader 5 и как встроенной проверкой поймать самую
частую ошибку на этом пути: нормализацию по всей истории. Показываю на примере утилиты
ARV ML Dataset Export и на реальных цифрах прогона.
Самая дорогая ошибка: нормализация по всей истории
Стандартный рецепт подготовки данных выглядит так: собрать признаки, посчитать среднее и
стандартное отклонение по всей истории, нормализовать, разделить на train и test, обучить модель.
Проблема в третьем шаге.
Если среднее и стандартное отклонение посчитаны по всей истории, то в признаках баров 2015 года уже
содержится информация о 2026 годе. Формально модель обучается на прошлом, а фактически видит
статистику будущего. На валидации такое решение выглядит отлично и почти всегда разваливается в
реальной торговле.
Правильно считать статистики только по обучающему окну. Тогда возникает естественный вопрос:
насколько сильно обучающая статистика отличается от полной? Если отличие мало, ошибка не критична.
Если велико — нормализация по всей истории сместит модель заметно. Именно это отличие утилита
измеряет и печатает в журнал.
Что делает утилита
ARV ML Dataset Export — скрипт для MetaTrader 5. Один запуск на графике даёт два файла.
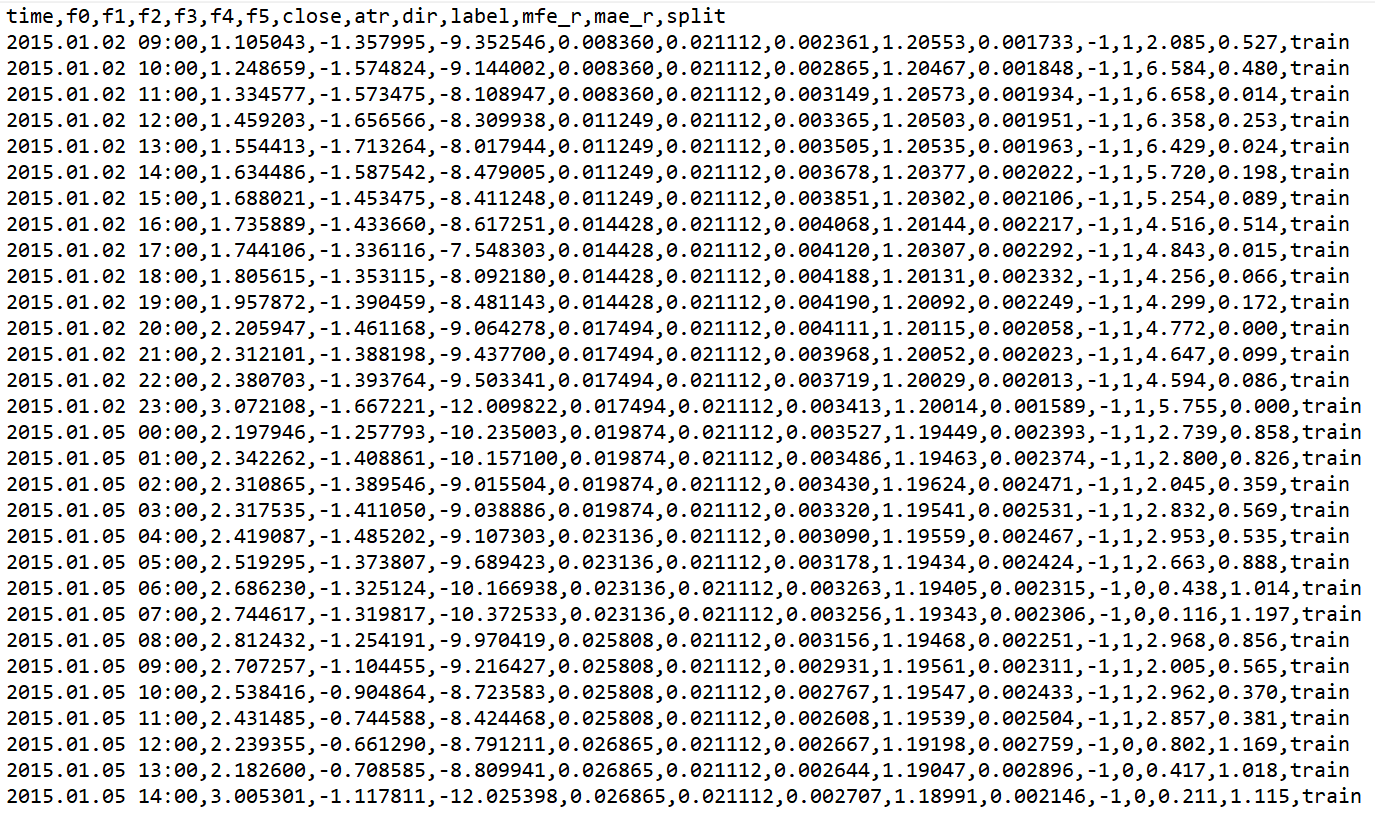
Первый — `ARV_ML_<SYMBOL>_H1.csv`: матрица признаков, метки и разбиение train/test.
| time,f0,f1,f2,f3,f4,f5,close,atr,dir,label,mfe_r,mae_r,split |
Признаки считаются по сериям H1, H4 и M15 выбранного символа и приведены к единицам ATR, то есть
сопоставимы между инструментами:
f0 = |EMA20(H1) - EMA50(H1)| / ATR14(H1) // расстояние между скользящими в единицах волатильности
f1 = (EMA20(H1) - EMA20(H1) 5 баров назад) / ATR14(H1) // импульс: скорость изменения EMA20
f2 = (Close(H1) - EMA200(H1)) / ATR14(H1) // отклонение цены от долгосрочного тренда
f3 = (BB_upper(H4) - BB_lower(H4)) / EMA20(H4) // ширина канала Боллинджера относительно средней
f4 = ATR14(M15) / Close(M15) * 100 // волатильность M15 в процентах от цены
f5 = StdDev20(H1, SMA) / EMA20(H1) // изменчивость цены относительно средней
Метка `label` — результат гонки тейк-профита и стоп-лосса внутри горизонта в 48 баров H1: `1`, если
TP достигнут раньше SL, `0`, если первым был SL, пусто, если за горизонт не сработало ни то, ни
другое. Дистанции TP и SL задаются в множителях ATR, поэтому разметка не зависит от волатильности
конкретного инструмента. Дополнительно сохраняются `mfe_r` и `mae_r` — максимальное благоприятное и
неблагоприятное отклонение внутри горизонта в единицах R.
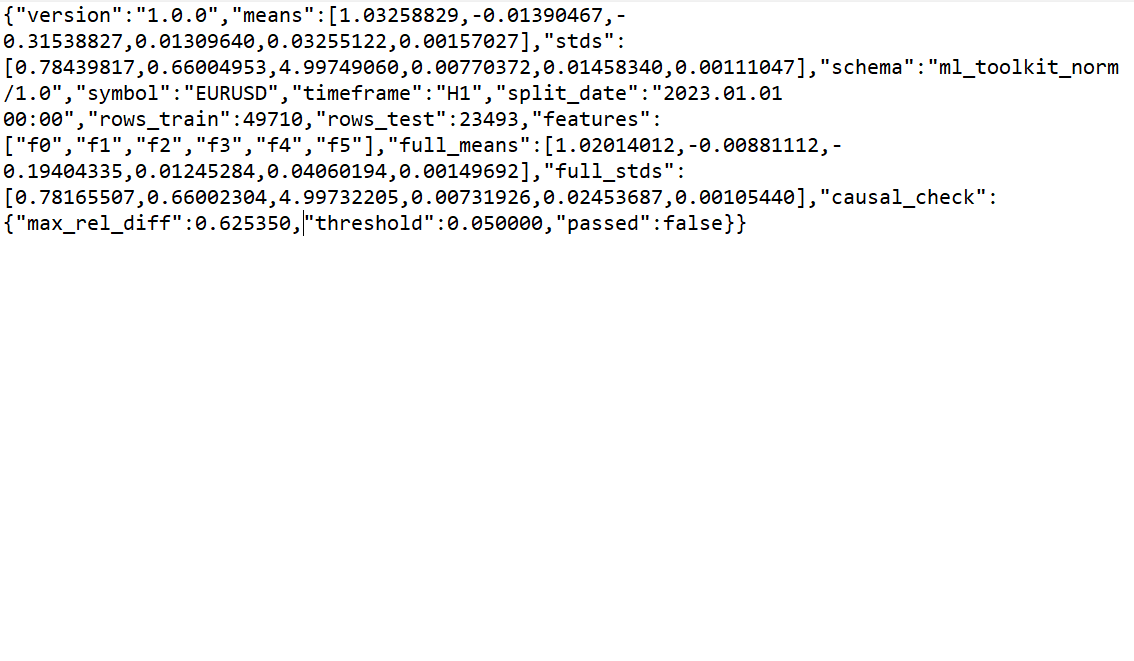
Второй файл — `ARV_ML_Norm_<SYMBOL>_H1.json`:
version, means[6], stds[6], schema, symbol, timeframe, split_date,
rows_train, rows_test, features[], full_means[6], full_stds[6],
causal_check{max_rel_diff, threshold, passed}
Здесь и лежит главное: `means` и `stds` посчитаны только по строкам train, а `full_means` и
`full_stds` — по всей выборке. Блок `causal_check` сравнивает их и даёт измеримое число
`max_rel_diff`.
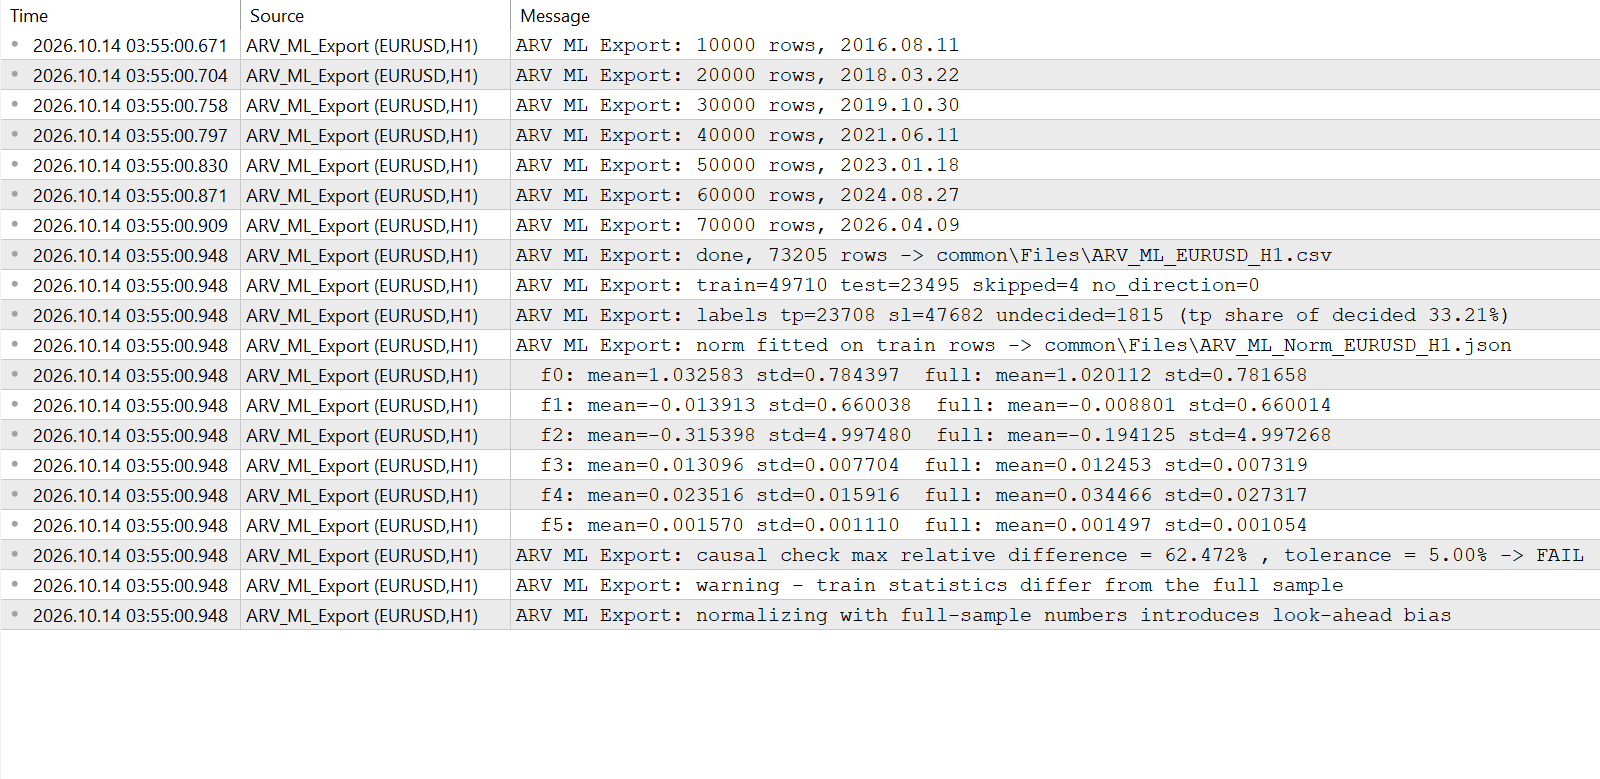
Как это выглядит на реальном прогоне
EURUSD H1, история с 2015.01.01, граница train/test — 2023.01.01:
ARV ML Export: done, 73205 rows -> common\Files\ARV_ML_EURUSD_H1.csv
ARV ML Export: train=49710 test=23495 skipped=4 no_direction=0
ARV ML Export: labels tp=23708 sl=47682 undecided=1815 (tp share of decided 33.21%)
ARV ML Export: norm fitted on train rows -> common\Files\ARV_ML_Norm_EURUSD_H1.json
ARV ML Export: causal check max relative difference = 62.472% , tolerance = 5.00% -> FAIL
ARV ML Export: warning - train statistics differ from the full sample
ARV ML Export: normalizing with full-sample numbers introduces look-ahead bias
FAIL — это и есть цель проверки: расхождение train-статистик с полной выборкой 62.5% означает, что наивная нормализация по всей истории действительно заглядывает в будущее. Инструмент сообщает вам об этом до обучения модели.
Главная цифра здесь — 62.472 %. Это расхождение обучающей статистики с полной выборкой, и оно
почти в 12.5 раза выше порога в 5 %. Разбираем, откуда оно берётся, — в JSON видно по признакам:
| Признак | Величина | По train | По полной выборке | Относительное расхождение |
|---|---|---|---|---|
| f2 | среднее | -0.315398 | -0.194125 | 62.5 % |
| f1 | среднее | -0.013913 | -0.008801 | 58.1 % |
| f4 | стандартное отклонение | 0.015916 | 0.027317 | 41.7 % |
Признак `f2` — отклонение цены от EMA200 в единицах ATR. На обучающем окне среднее заметно
отрицательное, на полной истории — почти вдвое ближе к нулю. То есть обучающее окно живёт в другом
режиме рынка, и нормализация по всей истории сдвинула бы его признаки на величину порядка двух
третей их полного разброса.
Важно не перепутать две вещи. `FAIL` в отчёте — не ошибка утилиты. Это её полезный результат: она
показывает, что полная выборка и обучающее окно живут в разных статистических режимах, и
нормализовать по полной выборке нельзя. Если бы расхождение уложилось в допуск, отчёт напечатал бы
`PASS`.
Разбиение по дате, а не случайное
Финансовые ряды не независимы: соседние бары принадлежат одному режиму рынка — тренд, флэт,
новостной всплеск. Если перемешать данные случайно, одни и те же режимы попадут и в train, и в test
одновременно. Оценка качества окажется завышенной, а модель — переобученной.
Поэтому разбиение делается по дате: граница задаётся параметром `InpSplitDate`, а в CSV добавляется
колонка `split` со значением `train` или `test`. Никакой дополнительной обработки при обучении не
требуется.
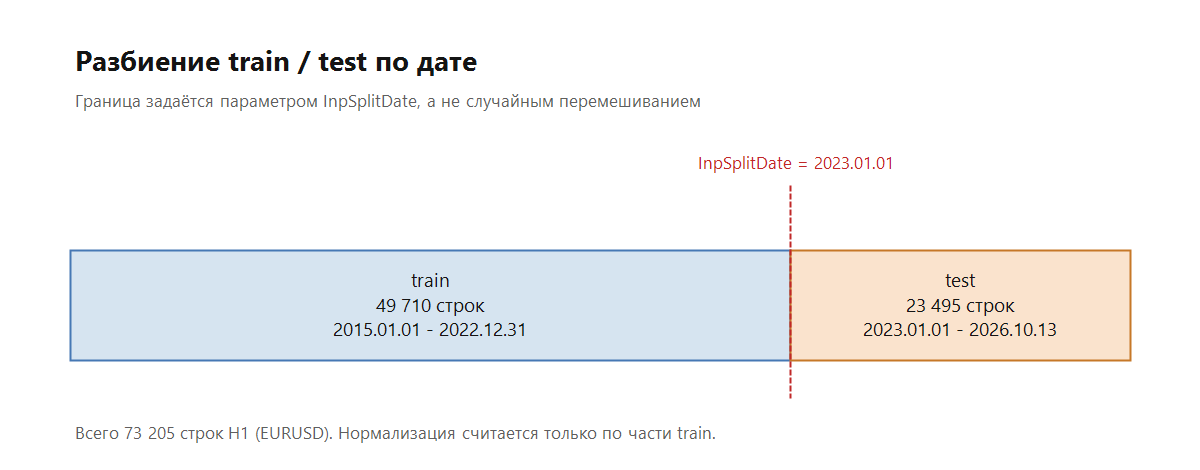
Рис. 1. Граница train/test задаётся параметром InpSplitDate ; нормализация считается только по части train.
Что дальше делать с датасетом
Обучение намеренно вынесено за пределы терминала. Порядок такой: загрузить CSV, нормализовать
признаки значениями `means` и `stds` из JSON, обучить любую модель, которую можно выгрузить в ONNX, и
загрузить её в MetaTrader 5 вызовом `OnnxCreateFromBuffer`. Формат одинаково читается любым
инструментом — и Python с NumPy, и чем угодно ещё.
Отдельно подчеркну: сам датасет — это не стратегия. Цифры вроде доли меток tp/sl описывают только
то, что лежит в файле, и ничего не говорят о будущей доходности. Любая модель, обученная на этих
данных, требует независимой проверки вне выборки, а результаты прошлых периодов не гарантируют
будущих.
Что делать читателю
Если вы делаете ML-подход в трейдинге, проверяйте, насколько статистики обучающего окна отличаются
от полной выборки. Даже если модель обучается вне терминала, подготовка данных и контроль
причинности должны быть прозрачными и воспроизводимыми. Начните с простого: посчитайте среднее и
стандартное отклонение дважды — только по train и по всей истории — и сравните. Если расхождение
больше нескольких процентов, нормализация по всей истории уже испортит модель.
Скрипт ARV ML Dataset Export опубликован в Market.
Работает в MetaTrader 5 сборки 3000 и выше. Чистый MQL5, без DLL, без WebRequest и без внешних
сервисов; по отношению к счёту — только чтение, никаких торговых операций.
Файлы:
ARV_ML_Export_docs.zip
11 kb
ARV_ML_EURUSD_H1_sample.csv
109 kb
02_journal_report.png
115 kb
03_csv_export.png
125 kb
04_json_causal_check.png
33 kb