Discussão do artigo "Recursos do SQLite em MQL5: Exemplo de painel interativo com estatísticas de trading por símbolo e magic"
Faltam ferramentas que permitam que você trabalhe com um grande histórico de negociações.
Infelizmente, esse kit de ferramentas simplesmente desliga quando solicita o histórico, como muitos outros.
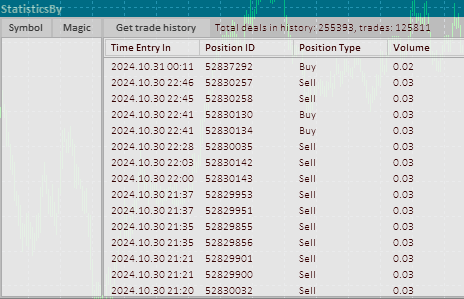
Leva cinco minutos para obter o histórico. Depois, é impossível fazer qualquer coisa com a janela - carga total da CPU.
Há uma falta de ferramentas para lidar com um grande histórico de negociações.
Infelizmente, esse kit de ferramentas, como muitos outros, simplesmente trava quando solicita o histórico.
Cinco minutos para obter o histórico. Depois, é impossível fazer qualquer coisa com a janela - carga total da CPU.
Posso ter acesso de investidor à conta?
Infelizmente, não existe essa possibilidade. Mas você mesmo pode criar algo assim: em uma conta de demonstração, use um script para abrir/fechar o número necessário de posições por diferentes símbolos/mágicos em uma hora usando OrderSend assíncrono.
Não quer trabalhar na bolsa de valores de Moscou
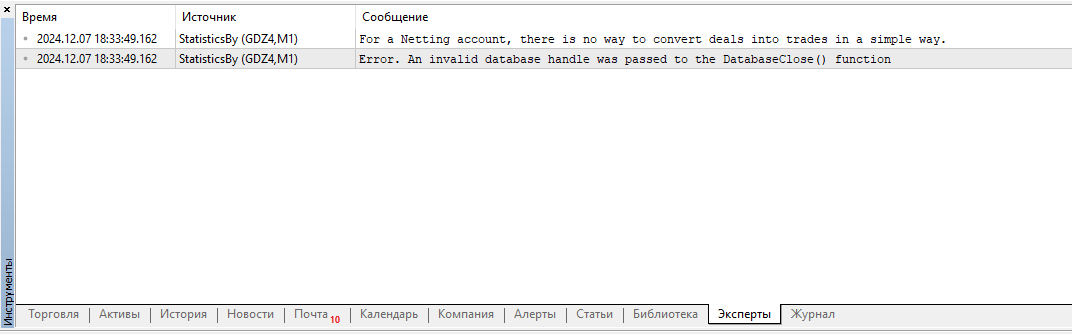
Faltam ferramentas que permitam trabalhar com um grande histórico de negociações.
Infelizmente, esse conjunto de ferramentas simplesmente trava ao solicitar o histórico, assim como muitos outros.
Leva cinco minutos para obter o histórico. Depois disso, fica impossível fazer qualquer coisa com a janela — a CPU fica totalmente sobrecarregada.
Faltam ferramentas que permitam trabalhar com um histórico extenso de negociações.
Infelizmente, essa ferramenta simplesmente trava ao solicitar o histórico, assim como muitas outras.
Leva cinco minutos para obter o histórico. Depois disso, não é possível fazer mais nada com a janela — a CPU fica totalmente sobrecarregada.
Não, não, não
Talvez o PostgreSWL fosse melhor. No entanto, o autor do artigo não usa índices nas tabelas e, se você observar as consultas, fica claro por que isso só funciona de maneira ágil com um conjunto de dados minúsculo. Se forem aplicados índices com consultas adaptadas a esses índices, ele consegue lidar com um grande conjunto de dados sem problema algum.
Salvar uma estrutura só é útil se você não precisar consultar os dados, mas apenas carregá-los. Se você precisar consultar dados, nada supera o SQL.
Não, não, não
Em nossos casos (quando você não tem 100.500 clientes), o SQLite dá um baile no PostgreSQL. Outra questão é que o TS não é DBA e nunca trabalhou com bancos de dados :-) Tudo o que está no artigo não pode deixar o sistema lento
não há índices, nem aquelas consultas aninhadas complicadíssimas com agregação dupla, e a carga no banco é enorme, mas o artigo foi escrito por motivos que vocês mesmos sabem.
ps/ para evitar discussões, perguntem em sites especializados o que há de errado na consulta
//--- obteremos as estatísticas de negociação por robôs, por Magic Number
   request=DatabasePrepare(db, "SELECT r.*,"
                           "   (case when r.trades != 0 then (r.gross_profit+r.gross_loss)/r.trades else 0 end) as expected_payoff,"
                           "   (case when r.trades != 0 then r.win_trades*100.0/r.trades else 0 end) as win_percent,"
                           "   (case when r.trades != 0 then r.loss_trades*100.0/r.trades else 0 end) as loss_percent,"
                           "   r.gross_profit/r.win_trades as average_profit,"
                           "   r.gross_loss/r.loss_trades as average_loss,"
                           "   (case when r.gross_loss!=0.0 then r.gross_profit/(-r.gross_loss) else 0 end) as profit_factor "
                           "FROM "
                           "   ("
                           "   SELECT MAGIC,"
                           "   sum(case when entry =1 then 1 else 0 end) as trades,"
                           "   sum(case when profit > 0 then profit else 0 end) as gross_profit,"
                           "   sum(case when profit < 0 then profit else 0 end) as gross_loss,"
                           "   sum(swap) as total_swap,"
                           "   sum(commission) as total_commission,"
                           "   sum(profit) as total_profit,"
                           "   sum(profit+swap+commission) as net_profit,"
                           "   sum(case when profit > 0 then 1 else 0 end) as win_trades,"
                           "   sum(case when profit < 0 then 1 else 0 end) as loss_trades "
                           "   FROM DEALS "
                           "   WHERE SYMBOL <> '' and SYMBOL is not NULL "
                           "   GROUP BY MAGIC"
                           "   ) as r");
Resumindo, rapidinho, pra que não digam que estou sendo exigente:
SYMBOL deve ter o tipo TEXT NOT NULL. No SQLite, há poucos tipos de dados: int, real, text, blob (e mesmo esses são opcionais, não é preciso especificá-los). NOT NULL evita verificações desnecessárias do tipo WHERE SYMBOL NOT NULL em cada consulta
ID, TRADE_ID e similares não são apenas KEY, são PRIMARY KEY
campos que são frequentemente usados em expressões WHERE e GROUP BY devem ser indexados. Faltam índices no esquema, e as consultas ficam lentas. Veja mais abaixo sobre o EXPLAIN
É melhor preencher o banco de dados em “lotes”. Fazer um INSERT para cada transação demora muito, muito tempo. Quando possível, envie 100 registros por consulta. (O ideal seria sincronizar a cada inicialização, e não apenas preencher na criação)
nas consultas há muitos cálculos duplicados e coisas que podem/devem ser transferidas para a aplicação. SELECTs aninhados, por si só, já são um sinal de alerta; se não houver outra alternativa, é preciso usar o EXPLAIN separadamente e otimizar o banco de dados e as consultas.
Para uso real e um grande número de transações, é claro que são necessárias paginação e tabelas virtuais (quando você carrega os dados em suas visualizações conforme necessário, em vez de manter um conjunto enorme de estruturas), mas isso provavelmente vai além do escopo deste artigo.
---
No fim das contas, o esquema do banco de dados simplesmente não foi bem pensado, e é por isso que tudo ficou lento no fxsaber. É sensato corrigir e complementar o esquema, otimizar as consultas e, com alterações mínimas, tudo deve voltar a funcionar.

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso
Novo artigo Recursos do SQLite em MQL5: Exemplo de painel interativo com estatísticas de trading por símbolo e magic foi publicado:
Essa função é responsável por desenhar a tabela de estatísticas consolidadas para o símbolo, magic ou conta selecionado. Ela recebe como parâmetros o tipo de tabela de estatísticas e o nome do símbolo, o valor em string do magic ou o número da conta. A partir do texto fornecido, determina-se o índice correspondente no array de estruturas de dados estatísticos. Em seguida, todos os dados da estrutura referente a esse índice são obtidos e posicionados na tabela desenhada, de acordo com as coordenadas das células. Os deslocamentos horizontais dos textos exibidos são calculados de forma que o título do dado fique alinhado à esquerda da célula e o valor correspondente fique alinhado à direita da sua célula. Todos os dados são exibidos em quatro colunas, organizados visualmente no painel como dois pares “cabeçalho: valor”.
Vamos compilar o indicador e ver na prática o que conseguimos:
E então, vemos que toda a funcionalidade prevista está operando conforme esperado. Sim, há pequenos “piscares” de texto nas tabelas ao mover o cursor e rolar a tela. No entanto, isso é resultado de um esquema de redesenho não otimizado: toda a parte visível da tabela é redesenhada continuamente. Esse efeito poderia ser evitado com uma lógica mais sofisticada para tratar apenas as linhas sob o cursor, o que, no entanto, foge ao escopo deste artigo.
Autor: Artyom Trishkin