Discusión sobre el artículo "Capacidades de SQLite en MQL5: Ejemplo de panel interactivo con estadísticas comerciales por símbolos y números mágicos"
Faltan herramientas que permitan trabajar con un amplio historial de operaciones.
Por desgracia, este conjunto de herramientas simplemente se cuelga al solicitar el historial, como muchos otros.
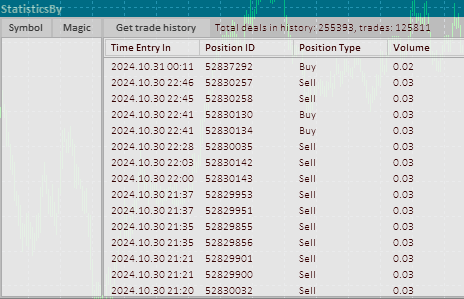
Tarda cinco minutos en obtener el historial. Entonces es imposible hacer nada con la ventana - carga completa de la CPU.
Faltan herramientas para gestionar un amplio historial comercial.
Por desgracia, este conjunto de herramientas se cuelga al solicitar el historial, como muchos otros.
Cinco minutos para obtener el historial. Entonces es imposible hacer nada con la ventana - carga completa de la CPU.
¿Puedo tener acceso como inversor a la cuenta?
Lamentablemente, no existe tal posibilidad. Pero puede crear algo así usted mismo: en una cuenta demo, utilice un script para abrir/cerrar el número requerido de posiciones por diferentes símbolos/magias en una hora utilizando OrderSend asíncrono.
No quiere trabajar en la Bolsa de Moscú
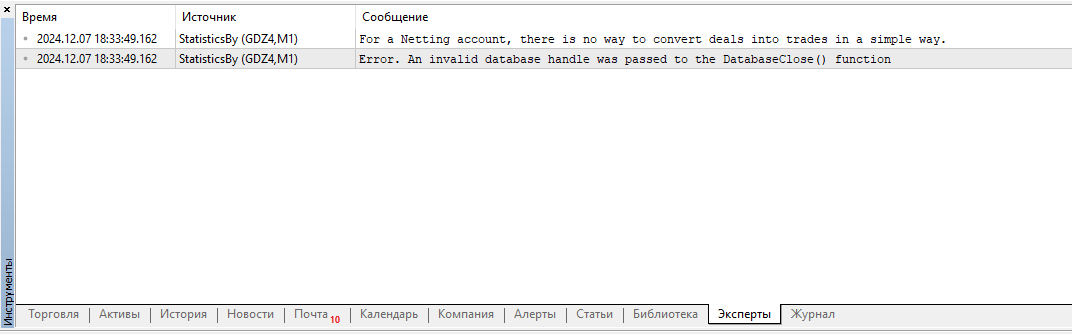
Faltan herramientas que permitan trabajar con un historial de operaciones extenso.
Por desgracia, este kit de herramientas, al igual que muchos otros, simplemente se cuelga al solicitar el historial.
Tarda cinco minutos en obtener el historial. Después, es imposible hacer nada con la ventana: la CPU está a plena carga.
Faltan herramientas que permitan trabajar con un historial de operaciones extenso.
Por desgracia, esta herramienta, al igual que muchas otras, simplemente se cuelga al solicitar el historial.
Se tarda cinco minutos en obtener el historial. A partir de ahí, es imposible hacer nada más con la ventana: la CPU está totalmente saturada.
No, no, no
Quizá PostgreSWL sería mejor. Sin embargo, el autor del artículo no utiliza índices en las tablas y, si te fijas en las consultas, queda claro por qué solo funciona con rapidez con un conjunto de datos muy pequeño. Si se aplican índices con consultas adaptadas a ellos, puede gestionar un gran conjunto de datos sin ningún problema.
Guardar una estructura solo resulta útil si no necesitas consultar los datos, sino simplemente cargarlos. Si necesitas consultar datos, nada supera a SQL.
No, no, no
En nuestros casos (cuando no tienes 100 500 clientes), SQLite le da mil vueltas a PostgreSQL. Otra cosa es que TS no es en absoluto un administrador de bases de datos y nunca ha trabajado con ellas :-) Todo lo que aparece en el artículo no puede ralentizar el sistema
: no hay índices, hay un montón de consultas anidadas con doble agregación, y la carga recae sobre la base de datos, mientras que el artículo está escrito, ya sabéis por qué.
P. D.: Para no entrar en discusiones, preguntad en foros especializados qué falla en la consulta
//--- Obtendremos las estadísticas de operaciones desglosadas por asesores según el «Magic Number»
   request=DatabasePrepare(db, "SELECT r.*,"
                           "   (case when r.trades != 0 then (r.gross_profit+r.gross_loss)/r.trades else 0 end) as expected_payoff,"
                           "   (case when r.trades != 0 then r.win_trades*100.0/r.trades else 0 end) as win_percent,"
                           "   (case when r.trades != 0 then r.loss_trades*100.0/r.trades else 0 end) as loss_percent,"
                           "   r.gross_profit/r.win_trades as average_profit,"
                           "   r.gross_loss/r.loss_trades as average_loss,"
                           "   (case when r.gross_loss!=0.0 then r.gross_profit/(-r.gross_loss) else 0 end) as profit_factor "
                           "FROM "
                           "   ("
                           "   SELECT MAGIC,"
                           "   sum(case when entry =1 then 1 else 0 end) as trades,"
                           "   sum(case when profit > 0 then profit else 0 end) as gross_profit,"
                           "   sum(case when profit < 0 then profit else 0 end) as gross_loss,"
                           "   sum(swap) as total_swap,"
                           "   sum(commission) as total_commission,"
                           "   sum(profit) as total_profit,"
                           "   sum(profit+swap+commission) as net_profit,"
                           "   sum(case when profit > 0 then 1 else 0 end) as win_trades,"
                           "   sum(case when profit < 0 then 1 else 0 end) as loss_trades "
                           "   FROM DEALS "
                           "   WHERE SYMBOL <> '' and SYMBOL is not NULL "
                           "   GROUP BY MAGIC"
                           "   ) as r");
En resumen, y para que no digan que estoy buscando tres pies al gato:
SYMBOL debe ser de tipo TEXT NOT NULL. En SQLite hay muy pocos tipos de datos: int, real, text, blob (y además son opcionales, no es necesario especificarlos). NOT NULL evitará comprobaciones innecesarias del tipo WHERE SYMBOL NOT NULL en cada consulta
ID, TRADE_ID y similares no son simplemente KEY, sino PRIMARY KEY
Los campos que se utilizan a menudo en expresiones WHERE o GROUP BY conviene indexarlos. Faltan índices en el esquema; las consultas se ralentizan. Véase más abajo lo relativo a EXPLAIN
Es mejor rellenar la base de datos «por lotes». Realizar un INSERT por cada transacción lleva muchísimo tiempo. Cuando sea posible, envía 100 registros por consulta. (Lo ideal sería sincronizarla cada vez que se inicie, en lugar de limitarse a rellenarla al crearla)
En las consultas hay muchos cálculos duplicados y cosas que se pueden o deben trasladar a la aplicación. Los SELECT anidados son, en sí mismos, una mala señal; si no hay otra opción, hay que analizar por separado con EXPLAIN y optimizar la base de datos y las consultas.
Para un uso real y un gran número de transacciones, por supuesto, se necesita paginación y tablas virtuales (cuando se cargan los datos en las vistas según sea necesario, en lugar de mantener un enorme conjunto de estructuras), pero esto probablemente va más allá del alcance de este artículo.
---
En definitiva, el esquema de la base de datos simplemente no está bien pensado, por lo que todo se ha ralentizado en fxsaber. Lo más sensato es corregir y completar el esquema, optimizar las consultas y, con unos pocos ajustes, debería funcionar.

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Artículo publicado Capacidades de SQLite en MQL5: Ejemplo de panel interactivo con estadísticas comerciales por símbolos y números mágicos:
La función está diseñada para dibujar una tabla resumen de estadísticas según el símbolo o número mágico seleccionados, o según la cuenta al completo. A la función se transmitirá el tipo de la tabla estadística y el nombre del símbolo, o el valor de la línea del número mágico o el número de cuenta. El índice del símbolo, número mágico o cuenta en el correspondiente array de estructuras de datos estadísticos se determinará a partir del texto. Obtendremos todos los datos estadísticos de la estructura requerida según el índice obtenido en la estructura, y luego los clasificaremos en la tabla dibujada según las coordenadas de la ubicación de sus celdas. En este caso, los desplazamientos horizontales del texto visualizado se calcularán de tal forma que el encabezado de los datos quede ligado al borde izquierdo de la celda de la tabla, mientras que el texto del valor de estos datos queda ligado al borde derecho de su celda de la tabla. Todos los datos se mostrarán en cuatro columnas, de forma que visualmente se agrupen en el panel en dos columnas como "encabezado -- valor".
Recopilemos el indicador y veamos por nosotros mismos lo que tenemos:
Bien, vemos que toda la funcionalidad indicada funciona como esperábamos. Sí, percibimos un leve "parpadeo" del texto en las tablas al mover el cursor y desplazarnos por ellas. Pero este es el resultado de un esquema de redibujado subóptimo: toda la parte visible de la tabla se redibuja constantemente. Podemos evitar esto usando una lógica más compleja para manejar las filas de la tabla bajo el cursor, lo cual queda fuera del alcance de este artículo.
Autor: Artyom Trishkin