
Está perdiendo oportunidades comerciales:
- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Registro
Entrada
Usted acepta la política del sitio web y las condiciones de uso
Si no tiene cuenta de usuario, regístrese
Otro hecho divertido, yo estaba pensando, al parecer esto es sólo el reciclaje, y decidió ver en qué índices se produjo el cambio de clase - Pensé que era cerca del final y esto es sólo una buena ilustración de reciclaje.
De hecho, resultó así
En la muestra de prueba
¡Resulta que son las primeras mil hojas (en la siguiente secuencia de adición al modelo) las que son en su mayoría inestables!
Sorprendido.
En una muestra
Para todos los demás árboles, el maestro es el error de predicción, es decir (Y - Pred). E incluso con eta = 0.1...0.001. La influencia de las hojas de estos árboles es insignificante, sólo corrigen. Lo que usted ha demostrado (su insignificancia).
GPT para enseñar )
Bien, añadamos el indicador Envelopes a nuestro análisis. El indicador Envelopes representa líneas por encima y por debajo de una media móvil. Suelen estar a un porcentaje fijo de distancia de esa media móvil.
Envolventes del último mes (noviembre 2023):
Tendencia global utilizando RSI, Bandas de Bollinger y Envolventes:
También hay que tener en cuenta que las señales de diferentes indicadores pueden ser contradictorias y es importante analizarlas conjuntamente.
Continuemos con los cálculos y el análisis.
Envolventes del último mes (noviembre 2023):
Tendencia global utilizando RSI, Bandas de Bollinger y Envolventes:
Además, tengamos en cuenta que las señales de diferentes indicadores pueden ser contradictorias, por lo que es importante analizarlas conjuntamente.
Continuemos con los cálculos y el análisis.
Estás contando "boosting", ¿verdad?
Tienes toda la razón, ¡estamos hablando de CatBoost!
Allí sólo el primer árbol es entrenado por las etiquetas del profesor inicial.
Para todos los demás árboles, el profesor es el error de predicción, es decir (Y - Pred).
Efectivamente, esto es lo que sugiere la teoría.
Sí también con coeficiente eta = 0,1...0,001
El coeficiente "tasa de aprendizaje", al menos en CatBoost, es fijo para todos los árboles.
La influencia de las hojas de estos árboles es insignificante, sólo corrigen. Que es lo que has demostrado (su insignificancia).
¿Puedes explicar realmente cómo están dispuestos los coeficientes de las hojas en CatBoost?
Hay puntos que no entiendo bien.
Sin embargo, he demostrado un cambio de "clase" en las hojas, es decir, en realidad el 40% de las hojas parecían tirar de los totales de forma equivocada en los nuevos datos.
¿Puede explicar realmente cómo se ordenan los coeficientes a las hojas en CatBoost?
¿Quieres que escarbe en el código de CatBoost y te dé la respuesta exacta? Sólo desentierro lo que me interesa. No utilizo CatBoost.
Tutorial y código boost simple aquí https://habr.com/ru/companies/vk/articles/438562/Es la primera vez que oigo hablar de coeficientes de hoja, ¿qué son?
Informo de que en una prueba de muestra separada - 7467, y en el examen - 7177, pero no hay un pequeño número de hojas sin activaciones en absoluto - no conté a la vez.
Esta es la distribución de las hojas que cambiaron de clase por su valor para la muestra de prueba
de examen.
Y este es el desglose en clases - hay tres de ellos, el tercero es "-1" - sin activación.
Para el tren de muestra
Para la muestra de ensayo
Para muestra de examen
En general, podemos ver que los pesos de las hojas ya no se corresponden con la lógica de la clase -a continuación se muestra el gráfico de la muestra de examen- no hay un vector claro.
En general, este método aproxima cualquier cosa, pero no garantiza la calidad de los predictores.
En general, supongo que las distintas "barras" del gráfico anterior son hojas muy similares por lugar y frecuencia de activación.
Es difícil discutir lo que no se sabe. Por lo tanto, sólo puedo alegrarme de su éxito. Si yo tuviera un método así, lo utilizaría :)
Mi método aún no da resultados tan cualitativos, pero se parece bastante.
¿Se ha preguntado alguna vez por qué ocurre esto?
Velocidad de prueba del modelo exportado a código ingenuo (catbust)
Y exportado a ONNX
El funcionamiento interno de las dos versiones del bot es casi similar, los resultados son los mismos.
¿Quieres que escarbe en el código catbust por ti y te dé una respuesta exacta? Sólo indago en lo que me interesa. No uso catbust.
Supuse que lo sabías, pero no es así. No pensé en agobiarte.
Es la primera vez que oigo hablar de coeficientes de hoja - ¿qué son?
Valores de hoja que se suman para formar la coordenada Y de una función.
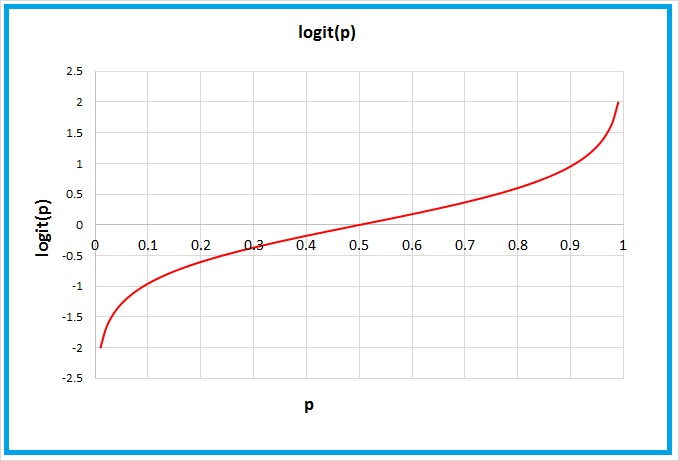
Mayor o igual a 0.5 en X significa que la clase por defecto es "1" en CatBoost.¿Se ha preguntado alguna vez por qué ocurre esto?
En realidad se trata de un patrón erróneo en la hoja.Puede haber varias razones para que sea así.
¿O tienes una respuesta concreta e inequívoca?
Velocidad de prueba del modelo exportado al código ingenuo (catbust)
Y exportado a ONNX
El funcionamiento interno de las dos versiones del bot es casi similar, los resultados son los mismos.
Paga por la universalidad.
Es una pena que CatBoost tenga limitaciones importantes en la conversión de modelos.