
Alım-satım fırsatlarını kaçırıyorsunuz:
- Ücretsiz alım-satım uygulamaları
- İşlem kopyalama için 8.000'den fazla sinyal
- Finansal piyasaları keşfetmek için ekonomik haberler
Kayıt
Giriş yap
Web sitesi politikasını ve kullanım şartlarını kabul edersiniz
Hesabınız yoksa, lütfen kaydolun
Birisi HMM'yi anlıyorsa, sorunu çözmek için yardım istiyorum, sorunu çözersek kaseyi paylaşacağım)
https://ru.stackoverflow.com/questions/984699/%D0%A1%D0%BA%D1%80%D1%8B%D1%82%D0%B0%D1%8F-%D0%9C%D0% B0%D1%80%D0%BA%D0%BE%D0%B2%D1%81%D0%BA%D0%B0%D1%8F-%D0%BC%D0%BE%D0%B4%D0%B5 %D0%BB%D1%8C-hmm-%D0%BF%D0%BE%D1%87%D0%B5%D0%BC%D1%83-%D0%BE%D1%82%D0%BB%D0 %B8%D1%87%D0%B0%D1%8E%D1%82%D1%81%D1%8F-%D0%BF%D1%80%D0%BE%D0%B3%D0%BD%D0% BE%D0%B7%D1%8B-%D1%81%D0%BE%D1%81D1%82%D0%BE%D1%8F%D0%BD%D0%B8%D0%B9
Birisi HMM'yi anlıyorsa, sorunu çözmek için yardım istiyorum, sorunu çözersek kaseyi paylaşacağım)
https://ru.stackoverflow.com/questions/984699/%D0%A1%D0%BA%D1%80%D1%8B%D1%82%D0%B0%D1%8F-%D0%9C%D0% B0%D1%80%D0%BA%D0%BE%D0%B2%D1%81%D0%BA%D0%B0%D1%8F-%D0%BC%D0%BE%D0%B4%D0%B5 %D0%BB%D1%8C-hmm-%D0%BF%D0%BE%D1%87%D0%B5%D0%BC%D1%83-%D0%BE%D1%82%D0%BB%D0 %B8%D1%87%D0%B0%D1%8E%D1%82%D1%81%D1%8F-%D0%BF%D1%80%D0%BE%D0%B3%D0%BD%D0% BE%D0%B7%D1%8B-%D1%81%D0%BE%D1%81D1%82%D0%BE%D1%8F%D0%BD%D0%B8%D0%B9
peki, devlet Markovian, ama hangi model? tablo yöntemi veya ne
yani sk için daha fazla puana ihtiyacın var. en azından pencereler
ve rastgele bir seri verilirse 50/50 dışında nasıl bir tahminden bahsedebiliriz?yani sk için daha fazla puana ihtiyacın var. en azından pencereler
hatta birkaç bin puan aldığını yazdı
ve rastgele bir seri verilirse 50/50 dışında nasıl bir tahminden bahsedebiliriz?
ne fark eder veri aynı model aynı
Tüm paketteki fonksiyon aracılığıyla yeni verileri tahmin ediyorum (İnternetteki tüm örneklerde vs...) sonuçlar süper
Aynı verileri aynı modelle ancak kayan bir pencerede tahmin ediyorum ve sonuç farklı, kabul edilemez.
İçinde ve aslında bir soru - Bu ne sorun?hatta birkaç bin puan aldığını yazdı
ne fark eder veri aynı model aynı
Tüm paketteki fonksiyon aracılığıyla yeni verileri tahmin ediyorum (İnternetteki tüm örneklerde vs...) sonuçlar süper
Aynı verileri aynı modelle ancak kayan bir pencerede tahmin ediyorum ve sonuç farklı, kabul edilemez.
İçinde ve aslında bir soru - Bu ne sorun?nasıl bir model ve durumları nereden aldığınız belli değil. Herhangi bir paket olmadan, kavramsal olarak ne yıkandı
belki oradaki rng öyle ki rastgele dağılmaz, bu yüzden 1. durumda onu tahmin ettiği ortaya çıkıyor. Trenin tohumunu değiştirmeye çalışın ve ilk durumda herhangi bir şeyi tahmin etmenin imkansız olduğunu görmek için test edin, aksi takdirde fikir nasıl yardımcı olacağı net değil
Sınıflandırma olasılığına göre bölmeler yapılır. Daha doğrusu, olasılıkla değil, sınıflandırma hatasıyla. Çünkü eğitim hesabında her şey biliniyor ve elimizde bir olasılık değil, kesin bir tahmin var.
Farklı bölme işlevleri olmasına rağmen, yani. safsızlık ölçüleri (sol veya sağdaki numuneler).
Sınıflandırma doğruluğunun şu anda yapıldığı gibi toplam değil, örneklem üzerinden dağılımını kastettim.
nasıl bir model ve durumları nereden aldığınız belli değil. Herhangi bir paket olmadan, kavramsal olarak ne yıkandı
belki oradaki rng öyle ki rastgele dağılmaz, bu yüzden 1. durumda onu tahmin ettiği ortaya çıkıyor. Trenin tohumunu değiştirmeye çalışın ve ilk durumda herhangi bir şeyi tahmin etmenin imkansız olduğunu görmek için test edin, aksi takdirde fikir nasıl yardımcı olacağı net değil
İşte dosya, fiyatlar ve "data1" ve "data2" tahmin edicileri olan iki sütun var.
HMM'yi sadece iki durumla (öğretmensiz veri treninde) bu iki sütun üzerinde ("data1" ve "data2") python'unuzda veya istediğiniz yerde alıp eğitiyorsunuz, fiyata hiç dokunmuyorsunuz, sadece o zaman sadece görselleştirme için
Sonra Viterbi algoritmasını alıp (veri testi) ortaya çıkarırsınız.
iki durum elde ediyoruz, bunun gibi görünmeli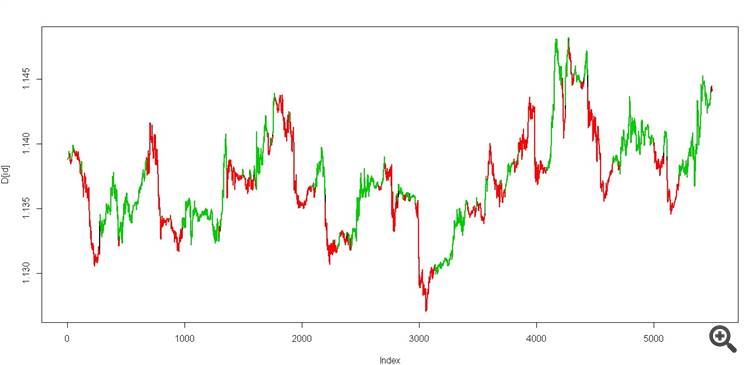
karoch kase gerçek))
Ve sonra aynı veriler üzerinde kayan bir pencerede hesaplamak için aynı Viterbi'yi deneyin
İşte dosya, fiyatlar ve "data1" ve "data2" tahmin edicileri olan iki sütun var.
HMM'yi sadece iki durumla (veri treninde) bu iki sütun üzerinde ("veri1" ve "veri2") python'unuzda veya istediğiniz yerde alıp eğitirsiniz, fiyata hiç dokunmazsınız, ancak o zaman için görselleştirme
Sonra Viterbi algoritmasını alıp (veri testi) ortaya çıkarırsınız.
iki durum elde ediyoruz, bunun gibi görünmeli
karoch kase gerçek))
Ve sonra aynı veriler üzerinde kayan bir pencerede hesaplamak için aynı Viterbi'yi deneyin
senk, pozyryu che evet daha sonra abonelikten çıkacağım, tk. Markov'la çalışıyorum.
senk, pozyryu che evet daha sonra abonelikten çıkacağım, tk. Markov'la çalışıyorum.
nasılsın?
nasılsın?
Henüz izlemedim izin günü) Vaktim olursa yazarım, hafta sonu anlamında
paketler bakarken. Bence https://hmmlearn.readthedocs.io/en/latest/tutorial.html işinizi görecektir