Midjourney и другие нейросети - страница 1226

Вы упускаете торговые возможности:
- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Регистрация
Вход
Вы принимаете политику сайта и условия использования
Если у вас нет учетной записи, зарегистрируйтесь
Причина "характера" Claude
Пара слов о Qwen 3.8 Max.
Впервые китайский ИИ стал передовым в тексте. Это сильный контраст с другими китайскими ИИ, который заточены на код.
Также очень хорошее зрение у модели. Если вы нарисуете дизайн приложения, то перевод в код будет близок к оригиналу.
Умная собака
//генерация ИИ
Minimax выложил открытый код видеогенератора H3.
https://huggingface.co/MiniMaxAI/MiniMax-H3
На текущий момент занимает 1 место по редактированию, а также в топ 3 всех ИИ подобного типа.
Режиссура и сценарий говно (ну дилетанты промтовали и графоманы), но ИИ со своей визуальной задачей справляется на 5+.
В очередной раз подтверждается, что ИИ в нужных руках - имба, а в корявых - нейрослоп.
Спор об AGI застрял в архитектуре 2017 года
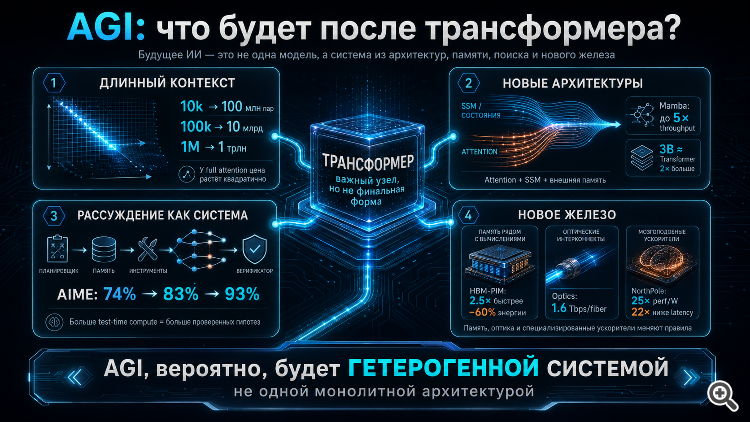
// Картинка и текст ЧатЖиПиТи
Все спорят, появится ли AGI. Одни считают, что достаточно увеличивать модели, объёмы данных и вычислительные мощности — и в какой-то момент количество перейдёт в качество. Другие отвечают, что трансформер всего лишь предсказывает следующий токен, поэтому настоящий интеллект из него принципиально получиться не может. Однако обе стороны делают одно и то же скрытое предположение: рассуждают так, будто Transformer, представленный в 2017 году, является последней возможной архитектурой искусственного интеллекта.
История вычислительной техники никогда так не развивалась. Перцептрон не оказался последней нейросетью, свёрточные сети не стали окончательной формой компьютерного зрения, а LSTM не сохранила монополию на обработку последовательностей. Поэтому нет особых оснований считать, что механизм attention внезапно оказался финальной конструкцией машинного разума. Трансформер может стать основой будущего AGI, может сохраниться только в отдельных модулях, а может постепенно уступить место гибридным системам. Но обсуждать пределы всего искусственного интеллекта исключительно по ограничениям одной архитектуры 2017 года — слишком смелое обобщение.
Цена длинного контекста
Ограничения обычного трансформера хорошо видны в числах. В полном attention каждый токен сопоставляется с остальными, поэтому размер матрицы внимания растёт приблизительно как квадрат длины контекста.
Для 10 тысяч токенов получается до 100 миллионов пар,
для 100 тысяч — уже до 10 миллиардов,
а для одного миллиона — до триллиона потенциальных взаимодействий в одном attention-слое.
Реальные реализации используют маски, оптимизированные ядра, разбиение вычислений и другие методы, но фундаментальная зависимость остаётся: увеличение контекста в 10 раз способно увеличить объём попарной работы примерно в 100 раз, а увеличение в 100 раз — примерно в 10 тысяч раз.
Поэтому идея «просто дадим трансформеру бесконечную память» упирается не только в объём видеопамяти. Архитектура заставляет систему постоянно платить за огромное число сравнений, даже если большая часть контекста в данный момент несущественна. Альтернативные последовательные архитектуры пытаются решить эту проблему иначе. Например, авторы Mamba заявили линейное масштабирование по длине последовательности, до пятикратного увеличения throughput при инференсе и результаты трёхмиллиардной модели, сопоставимые с трансформером примерно вдвое большего размера. Это не означает, что Mamba всегда лучше attention: точный произвольный доступ к конкретному фрагменту прошлого по-прежнему естественнее реализуется через внимание. Но сам результат показывает, что смена архитектурного механизма может дать кратный выигрыш без кратного увеличения числа параметров.
Будущая система поэтому, вероятно, не станет выбирать между attention и recurrence по принципу «только одно из двух». Attention может использоваться там, где нужен точный доступ к определённой информации, а state-space или рекуррентные блоки — там, где требуется непрерывно и дёшево обрабатывать длинный поток. Внешняя память сможет хранить факты и события без необходимости заново пропускать всю историю через каждый слой. Вместо одной универсальной операции появится несколько специализированных механизмов, каждый из которых будет применяться там, где он эффективнее.
Интеллект масштабируется не только параметрами
Ещё интереснее направление test-time compute — увеличение объёма вычислений уже во время решения задачи. В опубликованных OpenAI результатах модель o1 решала в среднем около 74% заданий AIME с одной попытки. При выборе ответа консенсусом из 64 решений показатель вырос до 83%, а при генерации и последующем ранжировании примерно 1000 кандидатов — до 93%. Между этими результатами модель не получила новые параметры и не прошла дополнительное обучение на всём интернете. Изменилась организация вычислительного процесса: система создала больше гипотез, потратила больше времени на задачу и использовала отдельную процедуру отбора.
Это важнее, чем кажется. Мы привыкли считать интеллект свойством одного прохода одной модели: вопрос подаётся на вход, ответ выходит с другой стороны. Но более сильная система может работать иначе. Одна модель предлагает несколько решений, планировщик разбивает задачу на части, инструменты выполняют вычисления и получают внешние данные, долговременная память предоставляет прошлый опыт, а верификатор проверяет промежуточные и конечные результаты. Дополнительные ресурсы при этом выделяются не каждому запросу одинаково, а только там, где система обнаруживает сложность или неуверенность.
В такой конструкции предсказание следующего токена остаётся важной операцией, но перестаёт быть всем интеллектом. Примерно так же выполнение машинной инструкции является основой программы, но не объясняет поведение всей операционной системы. AGI может возникнуть не внутри одной гигантской нейросети, а на уровне взаимодействия множества компонентов, каждый из которых сам по себе универсальным разумом не является. // Китайская комната?
Иногда главный выигрыш даёт не новый алгоритм, а другое железо
Современные ускорители расходуют огромные ресурсы не только на арифметику, но и на перенос данных между памятью и вычислительными блоками. Samsung экспериментировала с HBM-PIM — памятью, внутри которой размещены вычислительные элементы. В конкретной тестовой системе это дало почти 2,5-кратный рост общей производительности и более чем 60-процентное снижение энергопотребления. Модель не стала умнее, алгоритм не изменился и количество транзисторов не выросло на порядок. Вычисление просто переместили ближе к данным — и получили кратный системный эффект.
IBM развивает ещё более тесное объединение памяти и вычислений в архитектуре NorthPole. В одном из сравнений на ResNet-50 чип показал примерно в 25 раз больше кадров на ватт и в 22 раза меньшую задержку, чем GPU сопоставимого 12-нм техпроцесса. Это результат конкретного benchmark компьютерного зрения, поэтому переносить коэффициенты напрямую на любую языковую модель нельзя. Но он показывает, насколько дорого современным системам обходится традиционное разделение памяти и процессора.
Позже IBM продемонстрировала систему из 16 NorthPole с экспериментальной языковой моделью на три миллиарда параметров. Компания сообщила о задержке менее одной миллисекунды на токен, throughput около 28 тысяч токенов в секунду и более чем 70-кратном преимуществе по энергоэффективности относительно GPU с наименьшей задержкой в проведённом сравнении. Это специальная исследовательская модель, специализированное оборудование и ограниченный набор сравниваемых систем, а не готовая универсальная замена современных дата-центров. Однако речь уже идёт не о теоретической возможности, а о физически работающем прототипе.
Аналоговый трансформер уже перестал быть фантастикой
Ещё одно направление — аналоговые вычисления в памяти. Вместо того чтобы хранить каждый вес как цифровое число, постоянно передавать его в вычислительный блок и выполнять умножение, вес можно представить физическим состоянием элемента памяти. Тогда часть матричной операции выполняется непосредственно законами Ома и Кирхгофа. Экспериментальный аналоговый чип IBM содержал около 35 миллионов устройств фазовой памяти и достигал до 12,4 триллиона операций на ватт на уровне самого чипа.
Особенно интересен другой результат: IBM запустила на 14-нм аналоговом ускорителе трансформерную модель ALBERT. Миллионы весов модели были физически размещены в устройствах памяти, а средняя точность аппаратной реализации оказалась лишь примерно на 1,8 процентного пункта ниже floating-point-версии. После компенсации дрейфа дополнительную ошибку удалось снизить до уровня менее одного процента. Иными словами, альтернативное железо не обязательно уничтожит трансформер. Оно может дать ему вторую жизнь, выполняя те же математические операции совсем другим физическим способом.
Свет, скорее всего, сначала станет нервной системой ИИ
С фотонными вычислениями связано множество обещаний об ускорении в сотни и тысячи раз. К таким цифрам следует относиться осторожно: быстрый оптический матричный оператор ещё не означает настолько же быстрый инференс всей модели. Системе по-прежнему необходимы память, модуляторы, лазеры, фотодетекторы, преобразование сигналов, нелинейности, нормализация и управление. Поэтому показатель отдельного компонента нельзя автоматически распространять на весь сервер.
Но в области передачи данных фотоника уже демонстрирует более понятные результаты. Lightmatter сообщала об оптическом соединении с пропускной способностью около 1,6 терабита в секунду на одно волокно — это приблизительно 200 гигабайт сырого потока в секунду — и о многократном преимуществе по плотности полосы относительно сравниваемых решений. Другой модуль компании заявлен на 6,4 терабита в секунду в каждом направлении. Это пока не «мозг из света», но вполне может стать нервной системой будущего вычислительного комплекса, соединяющей сотни или тысячи специализированных чипов без привычных ограничений электрических линий.
AGI может оказаться не моделью, а системой
Мы часто представляем будущий AGI как один огромный файл весов: сегодня модель содержит сотни миллиардов параметров, завтра получит триллион, затем десять триллионов, после чего внезапно станет разумной. Однако более вероятна другая конструкция. Языковая модель будет работать с понятиями и формулировать гипотезы, state-space или рекуррентная сеть — непрерывно обрабатывать поток, внешняя память — хранить накопленный опыт, world model — прогнозировать последствия действий, планировщик — строить последовательность шагов, а верификатор — искать ошибки и противоречия.
Разные части такой системы могут исполняться на разном железе. Универсальные операции останутся на GPU или их потомках, работа с большими объёмами памяти перейдёт к near-memory и processing-in-memory, отдельные матричные слои — к аналоговым массивам, передача данных — к фотонике, а обработка событий от сенсоров и управление роботами — к neuromorphic-чипам. AGI в таком случае будет похож не на одну нейросеть, а на вычислительную цивилизацию в миниатюре, где множество узких механизмов совместно создают универсальное поведение.
Уже сейчас отдельные технологии демонстрируют около пятикратного роста throughput за счёт смены последовательной архитектуры, приблизительно 2,5-кратный прирост производительности и снижение энергии более чем на 60% благодаря вычислениям внутри памяти, десятки раз преимущества по производительности на ватт для специализированных ускорителей, многократный рост плотности оптических соединений и повышение результата reasoning-задач с 74% до 93% за счёт генерации и отбора дополнительных решений. Эти коэффициенты относятся к разным уровням системы, поэтому их нельзя перемножить и объявить, что AGI станет в миллион раз быстрее. Но именно их разнообразие и создаёт настоящий повод для оптимизма.
Будущему искусственному интеллекту необязательно найти одну волшебную технологию, которая улучшит всё сразу в тысячу раз. Достаточно перестать выполнять каждую операцию самым дорогим способом: не использовать квадратичный attention там, где достаточно линейного потока; не переносить веса между памятью и процессором, если вычисление можно выполнить на месте; не заставлять одну модель угадывать окончательный ответ, если можно создать множество гипотез и проверить их; не передавать данные по перегруженным электрическим линиям, если их можно отправить светом.
Поэтому аргумент «трансформер не способен на AGI» ещё не доказывает невозможность AGI. Но и утверждение «достаточно бесконечно масштабировать трансформер» ничего не доказывает. Возможно, трансформер станет для AGI тем же, чем транзистор стал для современного компьютера: важнейшим элементом, который сам по себе компьютером не является.
Главный вопрос поэтому звучит не так:
«Сможет ли трансформер превратиться в разум?»
Правильнее спросить:
«Какая система будет построена вокруг него — и сколько сегодняшних ограничений исчезнет после смены архитектуры, памяти, алгоритмов и железа?»
FLUX 3 Video: Революционный мультимодальный ИИ от Black Forest Labs
//текст и обложка Qwen 3.8. Новость https://bfl.ai/blog/flux-3-video
Black Forest Labs (BFL) представила FLUX 3 Video — первый компонент их нового мультимодального foundation-моделя, способного генерировать видео, изображения, аудио и даже предсказывать действия.
Это не просто очередная модель для создания видео — это попытка моделировать реальность во всей её мультимодальности, без ограничения одним стилем или форматом.
Ключевые возможности
FLUX 3 Video уже доступен для широкой аудитории через BFL API и избранных партнёров. Модель может создавать видеоклипы длиной до 20 секунд с нативным аудио в разрешении HD (720p) и Full HD (1080p).
Основные функции:
Текст в видео — опишите сцену простыми словами или детальным промптом, и модель создаст видео с естественными движенияами, логикой сцены и синхронизированным аудио.
Изображение в видео и ключевые кадры — начните с одного изображения, укажите конечный кадр или задайте несколько ключевых точек, и FLUX 3 соединит их в последовательность, сохраняя визуальный язык.
Продолжение видео — загрузите до 4 секунд существующего видео с аудио и укажите, что должно произойти дальше. Модель продолжит движение, поведение камеры, диалоги и звуковой ряд.
Множественные ракурсы — создавайте несколько сцен и углов камеры в рамках одного видео, сохраняя последовательность и когерентность.
Нативное аудио и диалоги — генерируйте диалоги, звуковые эффекты и фоновые шумы одновременно с видеорядом.
Мультиязычность и точный lip-sync
Одна из сильных сторон FLUX 3 — поддержка множества языков с точной синхронизацией губ: английский (различные диалекты), китайский, испанский, французский, немецкий, японский, португальский, русский, итальянский, индонезийский, турецкий, хинди, панджаби и другие.
Модель особенно сильна в воспроизведении человеческих мимики и выражений лица, а также в ассоциации звуков с физическими событиями.
Бенчмарки: лидерство в индустрии
Независимые оценки показывают высокую стилевую гибкость — от любительской съёмки до кинематографических кадров и анимации.
Модель хорошо работает с документальными и образовательными материалами благодаря встроенным мировым знаниям и возможности grounding в реальном времени.
Draft Mode: итеративная работа
Уникальная функция Draft Mode позволяет быстро получить превью промпта за малую часть стоимости полной генерации. Это даёт возможность итеративно улучшать идеи, а затем рендерить финальную версию в полном качестве с теми же субъектами, композицией и движением.
Доступность и перспективы
FLUX 3 Video уже доступен через BFL API и партнёрские платформы. Модель ориентирована на креативные инструменты, медиа, дизайн, электронную коммерцию и физический ИИ (включая робототехнику).
В будущих обновлениях ожидается полная версия FLUX 3, включающая генерацию изображений и аудио, а также расширенные возможности для физического ИИ и управления роботами.
FLUX 3 представляет собой серьёзный шаг вперёд в области генеративного ИИ, предлагая не просто видео, а полноценное мультимодальное моделирование реальности с аудио, движением и контекстом в одной генерации.
Такое чувство, что качество картинки в видеогенерациях лучше, чем в генерациях картинок))
Вполне возможно, что изначально надо было генераторы картинок обучать на видео, и не было бы проблем с пальцами.
В любом случае, те самые "модели мира" - следующий этап развития видеогенераторов.