Diskussion zum Artikel "SQLite-Fähigkeiten in MQL5: Beispiel für ein Dashboard mit Handelsstatistiken nach Symbolen und magischen Zahlen"
Es fehlt an Werkzeugen, die es Ihnen ermöglichen, mit einer umfangreichen Handelshistorie zu arbeiten.
Leider hängt sich dieses Toolkit bei der Abfrage der Historie einfach auf, wie viele andere auch.
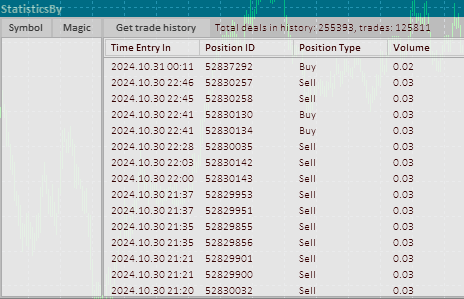
Es dauert fünf Minuten, um die Historie abzurufen. Dann ist es unmöglich, irgendetwas mit dem Fenster zu tun - volle CPU-Last.
Es mangelt an Instrumenten für den Umgang mit einer umfangreichen Handelsgeschichte.
Leider hängt sich dieses Toolkit bei der Abfrage der Historie auf, wie viele andere auch.
Fünf Minuten, um den Verlauf zu erhalten. Dann ist es unmöglich, etwas mit dem Fenster zu tun - volle CPU-Last.
Kann ich als Anleger Zugriff auf das Konto haben?
Leider gibt es keine solche Möglichkeit. Aber Sie können so etwas selbst erstellen: Verwenden Sie auf einem Demokonto ein Skript, um die erforderliche Anzahl von Positionen für verschiedene Symbole/Magier in einer Stunde mit asynchronem OrderSend zu öffnen/zu schließen.
Möchte nicht an der Moskauer Börse arbeiten
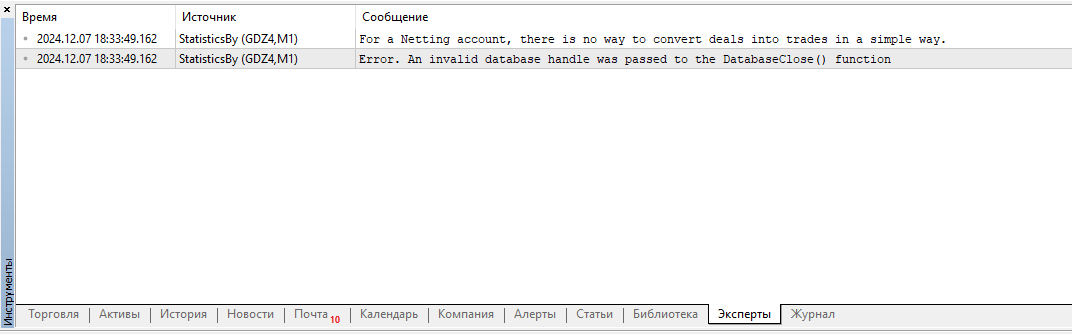
Es mangelt an Tools, mit denen man große Handelshistorien auswerten könnte.
Leider hängt sich dieses Toolkit, wie viele andere auch, bei der Abfrage des Verlaufs einfach auf.
Es dauert fünf Minuten, bis der Verlauf angezeigt wird. Danach lässt sich mit dem Fenster nichts mehr anfangen – die CPU-Auslastung ist zu 100 % ausgelastet.
Es fehlen die Werkzeuge, mit denen man große Handelsverläufe auswerten könnte.
Leider friert dieses Tool, genau wie viele andere auch, bei der Abfrage der Historie einfach ein.
Fünf Minuten, bis der Verlauf angezeigt wird. Danach lässt sich mit dem Fenster nichts mehr anfangen – die CPU ist voll ausgelastet.
Nein, nein, nein
Vielleicht wäre PostgreSWL besser. Der Autor des Artikels verwendet jedoch keine Indizes für die Tabellen, und wenn man sich die Abfragen ansieht, wird klar, warum das Ganze nur bei einem winzigen Datensatz reaktionsschnell funktioniert. Wenn Indizes eingesetzt und die Abfragen auf diese Indizes zugeschnitten sind, lassen sich auch große Datensätze problemlos verarbeiten.
Das Speichern einer Struktur ist nur dann sinnvoll, wenn man die Daten nicht abfragen, sondern lediglich laden muss. Wenn man Daten abfragen muss, geht nichts über SQL.
Nein, nein, nein
In unseren Gegebenheiten (wenn man nicht gerade 100.500 Kunden hat) übertrifft SQLite PostgreSQL um Längen. Eine andere Sache ist, dass TS überhaupt kein DBA ist und noch nie mit Datenbanken gearbeitet hat :-) Alles, was in dem Artikel steht, kann nicht für Verzögerungen sorgen
– da gibt es keine Indizes, und es wimmelt nur so von verschachtelten Abfragen mit doppelter Aggregation, und die Datenbank wird stark belastet, und der Artikel dient, na ja, ihr wisst schon wozu.
P.S.: Um Streit zu vermeiden, fragt doch mal in den entsprechenden Foren nach, was an der Abfrage falsch ist.
//--- Wir rufen die Handelsstatistik nach Expert Advisors anhand der Magic Number ab
   request=DatabasePrepare(db, "SELECT r.*,"
                           "   (case when r.trades != 0 then (r.gross_profit+r.gross_loss)/r.trades else 0 end) as expected_payoff,"
                           "   (case when r.trades != 0 then r.win_trades*100.0/r.trades else 0 end) as win_percent,"
                           "   (case when r.trades != 0 then r.loss_trades*100.0/r.trades else 0 end) as loss_percent,"
                           "   r.gross_profit/r.win_trades as average_profit,"
                           "   r.gross_loss/r.loss_trades as average_loss,"
                           "   (case when r.gross_loss!=0.0 then r.gross_profit/(-r.gross_loss) else 0 end) as profit_factor "
                           "FROM "
                           "   ("
                           "   SELECT MAGIC,"
                           "   sum(case when entry =1 then 1 else 0 end) as trades,"
                           "   sum(case when profit > 0 then profit else 0 end) as gross_profit,"
                           "   sum(case when profit < 0 then profit else 0 end) as gross_loss,"
                           "   sum(swap) as total_swap,"
                           "   sum(commission) as total_commission,"
                           "   sum(profit) as total_profit,"
                           "   sum(profit+swap+commission) as net_profit,"
                           "   sum(case when profit > 0 then 1 else 0 end) as win_trades,"
                           "   sum(case when profit < 0 then 1 else 0 end) as loss_trades "
                           "   FROM DEALS "
                           "   WHERE SYMBOL <> '' and SYMBOL is not NULL "
                           "   GROUP BY MAGIC"
                           "   ) as r");
Kurz gesagt, damit niemand behauptet, ich würde mich an Kleinigkeiten aufhängen:
SYMBOL muss den Datentyp TEXT NOT NULL haben. In SQLite gibt es nur wenige Datentypen: int, real, text, blob (und selbst diese sind optional, man muss sie nicht angeben). NOT NULL erspart uns sinnlose Prüfungen wie WHERE SYMBOL NOT NULL in jeder Abfrage
ID, TRADE_ID und ähnliche Felder sind nicht einfach nur KEY, sondern PRIMARY KEY
Felder, die häufig in WHERE- und GROUP BY-Ausdrücken verwendet werden, sollten indiziert werden. Es fehlen Indizes im Schema, die Abfragen werden dadurch verlangsamt. Siehe weiter unten zu EXPLAIN
Es ist besser, die Datenbank „in Stapeln“ zu füllen. Ein INSERT für jede einzelne Transaktion dauert sehr, sehr lange. Wenn möglich, sollten 100 Datensätze in einer Abfrage gesendet werden. (Im Idealfall sollte bei jedem Start eine Synchronisierung erfolgen und nicht nur beim Anlegen der Datenbank)
In den Abfragen gibt es viele doppelte Berechnungen und Dinge, die auf die Anwendung ausgelagert werden können/sollten. Verschachtelte SELECT-Anweisungen sind an sich schon ein Warnsignal; wenn es gar nicht anders geht, sollte man sie separat mit EXPLAIN analysieren und die Datenbank sowie die Abfragen optimieren.
Für den realen Einsatz und eine große Anzahl von Transaktionen sind natürlich Paginierung und virtuelle Tabellen erforderlich (wenn man Daten bei Bedarf in eigene Views lädt und kein riesiges Array an Strukturen vorhält), aber das würde wohl den Rahmen dieses Artikels sprengen.
---
Im Großen und Ganzen ist die Datenbankschema einfach nicht gut durchdacht, weshalb bei fxsaber alles ins Stocken geraten ist. Es ist sinnvoll, das Schema zu korrigieren und zu ergänzen sowie die Abfragen zu optimieren – mit minimalen Änderungen sollte es dann funktionieren.

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Neuer Artikel SQLite-Fähigkeiten in MQL5: Beispiel für ein Dashboard mit Handelsstatistiken nach Symbolen und magischen Zahlen :
Die Funktion dient dazu, die endgültige statistische Tabelle für das ausgewählte Symbol, die magische Zahl oder das gesamte Konto zu erstellen. Die Funktion erhält den Typ der Statistiktabelle und den Namen des Symbols oder den Stringwert der magischen Zahl oder die Kontonummer. Der Text bestimmt den Index des Symbols, der magischen Zahl oder des Kontos in dem entsprechenden Array der statistischen Datenstrukturen. Ausgehend von der gewünschten Struktur verwenden wir den erhaltenen Index, um alle statistischen Daten in die Struktur zu bringen, und ordnen sie dann in der gerenderten Tabelle entsprechend den Koordinaten ihrer Zellen an. In diesem Fall werden die horizontalen Versätze des angezeigten Textes so berechnet, dass die Datenüberschrift an den linken Rand der Tabellenzelle und der Text des Datenwertes an den rechten Rand seiner Tabellenzelle gebunden ist. Alle Daten werden in vier Spalten angezeigt, sodass sie auf dem Panel visuell in zwei Spalten in der Form „Titel - Wert“ gruppiert sind.
Kompilieren wir den Indikator und sehen wir, was wir haben:
Wir können sehen, dass alle angegebenen Funktionen wie erwartet funktionieren. Beim Bewegen des Cursors und beim Scrollen von Tabellen ist ein leichtes „Blinken“ des Textes in den Tabellen zu sehen. Dies ist jedoch das Ergebnis eines suboptimalen Schemas des Neuzeichnens - der gesamte sichtbare Teil der Tabelle wird ständig neu dargestellt. Dies kann durch eine komplexere Logik für die Behandlung von Tabellenzeilen unter dem Cursor vermieden werden, aber das ist hier nicht unser Ziel.
Autor: Artyom Trishkin