Maxim Dmitrievsky #: Теперь, чтобы получить адекватные оценки ошибок, нужно остационарить ряд. При наличии автокорреляции ошибки занижаются.
Не, мотивация возникает после почти реала, хотя бы на тесте в терминале, что то не то, а тестить в первоначальной моделе дешевле, а ошибки лучше на начале пути оценивать, а не после переноса в почти реал)))
Maxim Dmitrievsky #: Теперь, чтобы получить адекватные оценки ошибок, нужно остационарить ряд. При наличии автокорреляции ошибки занижаются.
ChatGPT: Для остационаривания ряда можно использовать несколько методов, в том числе дифференцирование, применение скользящего среднего или экспоненциального сглаживания.
При тестировании для остационаривания ряда я выбрала скользящую среднюю с периодом 15, которая полностью перекрывает окно обучения модели с периодом 12. Если я правильно понимаю, данные в окне "учителя" полностью стационарны.
USDX_2023.04.20_Data_1y.txt
ADF Statistic: -8.653242
p-value: 0.000000
Если p-value меньше 0.05, то ряд можно считать стационарным.
seq_series = pd.Series(seq)
# вычисление скользящего среднего
seq_moving_avg_window_size = 15
seq_moving_avg = seq_series.rolling(seq_moving_avg_window_size).mean().dropna().round(0)
# проверка на стационарность
from statsmodels.tsa.stattools import adfuller
result = adfuller(seq_moving_avg)
print('ADF Statistic: %f' % result[0])
print('p-value: %f' % result[1])
print('Если p-value меньше 0.05, то ряд можно считать стационарным.')
# Convert the list to a numpy array
seq = np.array(seq_moving_avg)
Стационарный ряд — это временной ряд, статистические свойства которого не меняются во времени. График стационарного ряда выглядит как ломаная линия, которая хаотично «наматывается» на горизонтальную прямую, оставаясь на среднем расстоянии от нее.
По данным сайта *.com, на 22 апреля 2023 года курс евро-доллар составляет 1 евро = 1,13 доллара. На сайте *.org прогнозируют, что в 2024 году курс EUR/USD не достигнет новых максимумов но будет торговаться на довольно высоких уровнях.
Яна Кане https://www.litefinance.org/ru/blog/authors/jana-kane/
www.litefinance.org
Любые долгосрочные прогнозы неточны. Однако пара EUR/USD следует определенным долгосрочным трендам. Если вы посмотрите на ценовой график, вы заметите: цена повторяет свои действия в долгосрочной перспективе. Для входа в краткосрочные сделки следует проверять фундаментальные факторы, которые обычно влияют на курс EUR/USD.
Важной часть работы является оценка моделей. Автоматические метрики не всегда коррелируют с человеческим мнением об ответе модели, поэтому ключевой оценкой были SBS (side by side) тесты. В таких тестах разметчики определяют предпочтительный вариант ответа от разных моделей. Также мы использовали более развернутые метрики типа ODMEN (наша внутренняя метрика, которую стоит обсуждать отдельно) и уделили время оценке этичности модели.
От эксперимента к эксперименту мы замеряли таким образом качество и выбрали самую удачную модель в кандидаты для релиза.
Не обошли стороной и сравнение с ChatGPT. Собрав "корзину" из запросов разной тематики, мы провели на ней SBS между нашей моделью и моделью от OpenAI (gpt-3.5-turbo). Начиная от 3:97 в пользу ChatGPT, нам удалось добиться результата 30:70 в финальной версии модели.
Дообучать LLaMA 13B на наших инструкциях мы тоже пробовали и результаты оказались неплохи, однако ruGPT-3.5 13B показала себя лучше в SBS тестировании — 58:42 в пользу нашей модели.
Теперь главное. Мы плавно открываем модель для всех желающих, в том числе и по API. Также мы запустилизакрытый Telegram-канал— вступившие в него пользователи в числе первых получат доступ к GigaChat. Доступ будет открываться волнами, чтобы адекватно поддерживать нагрузку. Хочется, чтобы у пользователей не было каких-то чрезмерных таймаутов при работе с моделью.
А модельruGPT-3.5 13B, на основе которой был обучен GigaChat, мы скоро выложим в открытый доступ на huggingface. Поэтому сообщество скоро сможет само обучать качественные русскоязычные модели даже на домашних видеокартах и в Colab’е. Благо, что в последнее время у многих появился опыт дообучения LLaMA, используя LoRA адаптеры (при таком подходе обучается не вся сеть, а только отдельные дополнительные слои).
Хайп вокруг нейросетей, выровненных при помощи инструкций и человеческой оценки (известных в народе под единым брендом «ChatGPT»), трудно не заметить. Люди разных профессий и возрастов дивятся примерам нейросетевых генераций, используют ChatGPT для создания контента и рассуждают на темы сознания, а также повсеместного отнимания нейросетями...
Некоторые результаты были достигнуты с помощью кода машинного обучения, предложенного ИИ, для прогнозирования данных временных рядов. Обученная модель может прогнозировать данные индикатора RSI практически для любого символа и таймфрейма. Из исходных результатов тестирования модели были выбраны те Символы и таймфреймы, для которых ошибка от "AVG(mse;mae;mpl;rmse;rrmse)" была меньше среднего значения ошибки и значения метрики от "AVG(d2p;r2 )" было больше, чем среднее значение метрики. Все остальные результаты тестов были отброшены как менее точные.
На данный момент похоже можно попробовать создать стратегию, в которой прогнозы делаются по нескольким таймфреймам одновременно, и искать сигнал: если направление изменения значений младших таймфреймов совпадают с направлением изменения значений для старших таймфреймов.
+
В приложении тестовые данные, из которых была получена метрика обученной модели. Метрика рассчитывается для целых чисел, например, цель 46,00, прогноз 46,33, ошибка 0,33.
Кто-то может попытаться продать то, что кто-то другой опубликовал бесплатно. Потому Я пока не буду публиковать здесь код модели. Но для интересующихся я опубликую описание модели, позволяющее понять, как она устроена.
Эта модель глубокого обучения имеет сверточные слои, плотные слои и слои LSTM. Сверточные слои используются для извлечения признаков, а плотные слои - для классификации. Слои LSTM используются для прогнозирования последовательности.
Модель имеет12 входных признакови1 выходной признак. Форма ввода -(12, 1). В модели всего4 064 обучаемых параметров.
Модель построена с использованиемKeras Sequential API. Это популярный API высокого уровня для создания моделей глубокого обучения.
Архитектура модели может быть описана следующим образом:
Сверточный слой с * фильтрами и ядром размером * с функцией активации * и формой ввода (12, 1).
Слой пакетной нормализации.
Сверточный слой с * фильтрами и ядром размером * с функцией активации *.
Слой пакетной нормализации.
Сверточный слой с * фильтрами и ядром размером * с функцией активации *.
Слой пакетной нормализации.
Плотный слой с * единицами и функцией активации *.
Dropout-слой со значением *.
Плотный слой с *единицами и функцией активации *.
Dropout-слой со значением *.
Плотный слой с * и * функцией активации.
Слои LSTM с * единицами и возвратом последовательности.
Слой пакетной нормализации.
Dropout-слой со значением *.
Слои LSTM с *единицами.
Слой пакетной нормализации.
Dropout-слой со значением *.
Плотный слой с *единицами, функцией активации *, регуляризатором ядра L2 (*), регуляризатором смещения L2 (*) и инициализатором ядра RandomNormal (*).
Dropout-слой со значением *.
Плотный слой с *, функцией активации *, регуляризатором ядра L2 (*), регуляризатором смещения L2 (*) и инициализатором ядра RandomNormal (*)
Используя это описание, программист или ИИ очень легко создадут собственную модель, которая фактически будет копией модели, предложенной ИИ.
Кто-то может попытаться продать то, что кто-то другой опубликовал бесплатно. Потому Я пока не буду публиковать здесь код модели.
Lilita, никто не сможет продать то, что пока не имеет своего красивого стейта.
Если эта штука работает в тестере и показывает что-то похожее на стабильность (пусть и на небольшом форварде, пусть и с постоянным дообучением), то тогда уже можно говорить о продажах.
Lilita, никто не сможет продать то, что пока не имеет своего красивого стейта.
Если эта штука работает в тестере и показывает что-то похожее на стабильность (пусть и на небольшом форварде, пусть и с постоянным дообучением), то тогда уже можно говорить о продажах.
Может быть, я ошибаюсь, но мой опыт пока учит, что стабильный результат должен быть достигнут на каждом этапе разработки, прежде чем двигаться дальше. Так что сейчас речь идет только об обучении модели и анализе результатов прогноза. Вероятно, это связано с тем, что я давно перестала искать единственный вариант, на который возлагались все мои надежды, то есть у меня нет принципиальной необходимости сразу пытаться адаптировать код для торговли.
Например, для меня важно, чтобы модель была универсальной (способной делать прогнозы для любого символа). Как видно из таблицы, опубликованной выше, из 26 используемых символов и 14 таймфреймов выкристаллизовались конкретные таймфреймы, на которых делаются наиболее точные предсказания для нескольких символов.
И только когда такие таймфреймы были найдены, стоит начинать думать о создании будущей торговой стратегии.
Например, тест M20 имеет 8 символов среди лучших результатов. Что из этого можно сделать, покажет время.
Итак, какова наихудшая производительность модели при прогнозировании следующего значения?
Самая большая средняя ошибка:
Наименьшая точность:
CNHAUD M5 (самая большая средняя ошибка)
EURCHF M5 (наименьшая точность)
В чем разница между лучшими и худшими результатами?
Наименьшая средняя ошибка ((mse+mae+mpl+rmse+rrmse)/5) 0,273, наибольшая средняя ошибка 0,576.
Самая низкая средняя точность ((d2p+r2)/2) 0,960, самая высокая средняя точность 0,980
Самая маленькая ошибка:
Высочайшая точность:
Критически ли велика эта разница? Сравнивая 352 возможных варианта, можно увидеть, что разница между лучшими и худшими результатами составляет всего несколько процентов.
Для авторизации и пользования сайтом MQL5.com необходимо разрешить использование файлов Сookie.
Пожалуйста, включите в вашем браузере данную настройку, иначе вы не сможете авторизоваться.
Вы вошли в аккаунт. Двухфакторная аутентификация отключена. Настройте её заново и отсканируйте новый QR-код или продолжите с отключённой двухфакторной аутентификацией.
Теперь, чтобы получить адекватные оценки ошибок, нужно остационарить ряд. При наличии автокорреляции ошибки занижаются.
Не, мотивация возникает после почти реала, хотя бы на тесте в терминале, что то не то, а тестить в первоначальной моделе дешевле, а ошибки лучше на начале пути оценивать, а не после переноса в почти реал)))
Теперь, чтобы получить адекватные оценки ошибок, нужно остационарить ряд. При наличии автокорреляции ошибки занижаются.
ChatGPT:
Для остационаривания ряда можно использовать несколько методов, в том числе дифференцирование, применение скользящего среднего или экспоненциального сглаживания.
При тестировании для остационаривания ряда я выбрала скользящую среднюю с периодом 15, которая полностью перекрывает окно обучения модели с периодом 12. Если я правильно понимаю, данные в окне "учителя" полностью стационарны.
seq_series = pd.Series(seq) # вычисление скользящего среднего seq_moving_avg_window_size = 15 seq_moving_avg = seq_series.rolling(seq_moving_avg_window_size).mean().dropna().round(0) # проверка на стационарность from statsmodels.tsa.stattools import adfuller result = adfuller(seq_moving_avg) print('ADF Statistic: %f' % result[0]) print('p-value: %f' % result[1]) print('Если p-value меньше 0.05, то ряд можно считать стационарным.') # Convert the list to a numpy array seq = np.array(seq_moving_avg)Стационарный ряд — это временной ряд, статистические свойства которого не меняются во времени. График стационарного ряда выглядит как ломаная линия, которая хаотично «наматывается» на горизонтальную прямую, оставаясь на среднем расстоянии от нее.
были:
стали:
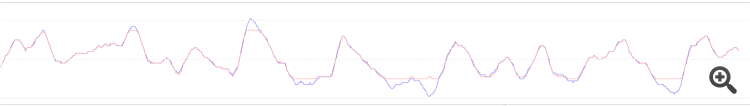
были:
стали:
Надо спросить мнение знающих форумчан. Почему при остационаривания ряда Наивный прогноз вдруг резко улучшил свои показатели?
Какой прогноз по евро-доллару?
Скажет 1.2065, похлопаю в ладошки
;)
Какой прогноз по евро-доллару?
Скажет 1.2065, похлопаю в ладошки
;)
По данным сайта *.com, на 22 апреля 2023 года курс евро-доллар составляет 1 евро = 1,13 доллара. На сайте *.org прогнозируют, что в 2024 году курс EUR/USD не достигнет новых максимумов но будет торговаться на довольно высоких уровнях.
Прогноз евро/доллар: курс EUR/USD на 2023, 2024-2025 годы и долгосрочные перспективы | LiteFinance
+
Со своей стороны могу добавить, что на данный момент у меня нет никаких сигналов по EURUSD.
Важной часть работы является оценка моделей. Автоматические метрики не всегда коррелируют с человеческим мнением об ответе модели, поэтому ключевой оценкой были SBS (side by side) тесты. В таких тестах разметчики определяют предпочтительный вариант ответа от разных моделей. Также мы использовали более развернутые метрики типа ODMEN (наша внутренняя метрика, которую стоит обсуждать отдельно) и уделили время оценке этичности модели.Цитата из статьи:
От эксперимента к эксперименту мы замеряли таким образом качество и выбрали самую удачную модель в кандидаты для релиза.
Не обошли стороной и сравнение с ChatGPT. Собрав "корзину" из запросов разной тематики, мы провели на ней SBS между нашей моделью и моделью от OpenAI (gpt-3.5-turbo). Начиная от 3:97 в пользу ChatGPT, нам удалось добиться результата 30:70 в финальной версии модели.
Дообучать LLaMA 13B на наших инструкциях мы тоже пробовали и результаты оказались неплохи, однако ruGPT-3.5 13B показала себя лучше в SBS тестировании — 58:42 в пользу нашей модели.
Теперь главное. Мы плавно открываем модель для всех желающих, в том числе и по API. Также мы запустили закрытый Telegram-канал — вступившие в него пользователи в числе первых получат доступ к GigaChat. Доступ будет открываться волнами, чтобы адекватно поддерживать нагрузку. Хочется, чтобы у пользователей не было каких-то чрезмерных таймаутов при работе с моделью.
А модель ruGPT-3.5 13B, на основе которой был обучен GigaChat, мы скоро выложим в открытый доступ на huggingface. Поэтому сообщество скоро сможет само обучать качественные русскоязычные модели даже на домашних видеокартах и в Colab’е. Благо, что в последнее время у многих появился опыт дообучения LLaMA, используя LoRA адаптеры (при таком подходе обучается не вся сеть, а только отдельные дополнительные слои).
Некоторые результаты были достигнуты с помощью кода машинного обучения, предложенного ИИ, для прогнозирования данных временных рядов. Обученная модель может прогнозировать данные индикатора RSI практически для любого символа и таймфрейма. Из исходных результатов тестирования модели были выбраны те Символы и таймфреймы, для которых ошибка от "AVG(mse;mae;mpl;rmse;rrmse)" была меньше среднего значения ошибки и значения метрики от "AVG(d2p;r2 )" было больше, чем среднее значение метрики. Все остальные результаты тестов были отброшены как менее точные.
На данный момент похоже можно попробовать создать стратегию, в которой прогнозы делаются по нескольким таймфреймам одновременно, и искать сигнал: если направление изменения значений младших таймфреймов совпадают с направлением изменения значений для старших таймфреймов.
+
В приложении тестовые данные, из которых была получена метрика обученной модели. Метрика рассчитывается для целых чисел, например, цель 46,00, прогноз 46,33, ошибка 0,33.
Кто-то может попытаться продать то, что кто-то другой опубликовал бесплатно. Потому Я пока не буду публиковать здесь код модели. Но для интересующихся я опубликую описание модели, позволяющее понять, как она устроена.
Эта модель глубокого обучения имеет сверточные слои, плотные слои и слои LSTM. Сверточные слои используются для извлечения признаков, а плотные слои - для классификации. Слои LSTM используются для прогнозирования последовательности.
Модель имеет 12 входных признаков и 1 выходной признак. Форма ввода - (12, 1). В модели всего 4 064 обучаемых параметров.
Модель построена с использованием Keras Sequential API. Это популярный API высокого уровня для создания моделей глубокого обучения.
Архитектура модели может быть описана следующим образом:
Используя это описание, программист или ИИ очень легко создадут собственную модель, которая фактически будет копией модели, предложенной ИИ.
Кто-то может попытаться продать то, что кто-то другой опубликовал бесплатно. Потому Я пока не буду публиковать здесь код модели.
Lilita, никто не сможет продать то, что пока не имеет своего красивого стейта.
Если эта штука работает в тестере и показывает что-то похожее на стабильность (пусть и на небольшом форварде, пусть и с постоянным дообучением), то тогда уже можно говорить о продажах.
Lilita, никто не сможет продать то, что пока не имеет своего красивого стейта.
Если эта штука работает в тестере и показывает что-то похожее на стабильность (пусть и на небольшом форварде, пусть и с постоянным дообучением), то тогда уже можно говорить о продажах.
Может быть, я ошибаюсь, но мой опыт пока учит, что стабильный результат должен быть достигнут на каждом этапе разработки, прежде чем двигаться дальше. Так что сейчас речь идет только об обучении модели и анализе результатов прогноза. Вероятно, это связано с тем, что я давно перестала искать единственный вариант, на который возлагались все мои надежды, то есть у меня нет принципиальной необходимости сразу пытаться адаптировать код для торговли.
Например, для меня важно, чтобы модель была универсальной (способной делать прогнозы для любого символа). Как видно из таблицы, опубликованной выше, из 26 используемых символов и 14 таймфреймов выкристаллизовались конкретные таймфреймы, на которых делаются наиболее точные предсказания для нескольких символов.
И только когда такие таймфреймы были найдены, стоит начинать думать о создании будущей торговой стратегии.
Например, тест M20 имеет 8 символов среди лучших результатов. Что из этого можно сделать, покажет время.
Итак, какова наихудшая производительность модели при прогнозировании следующего значения?
Самая большая средняя ошибка:
Наименьшая точность:
CNHAUD M5 (самая большая средняя ошибка)
EURCHF M5 (наименьшая точность)
В чем разница между лучшими и худшими результатами?
Наименьшая средняя ошибка ((mse+mae+mpl+rmse+rrmse)/5) 0,273, наибольшая средняя ошибка 0,576.
Самая низкая средняя точность ((d2p+r2)/2) 0,960, самая высокая средняя точность 0,980
Самая маленькая ошибка:
Высочайшая точность:
Критически ли велика эта разница?
Сравнивая 352 возможных варианта, можно увидеть, что разница между лучшими и худшими результатами составляет всего несколько процентов.