
Você está perdendo oportunidades de negociação:
- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Registro
Login
Você concorda com a política do site e com os termos de uso
Se você não tem uma conta, por favor registre-se
|
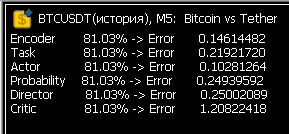
Ran Research 1 mês de 5 minutos, obteve 300 MB de DACGLSTM.bd. Executou o estudo. As taxas de erro são assustadoras. Ou isso é normal para a primeira execução?
Depois do Study, apareceram os arquivos .nnw da rede neural. Iniciei uma segunda rodada de coleta de dados, no mês seguinte - a pesquisa parou de fazer negócios....
Muito bom! Após várias semanas de dança do pandeiro, os valores de erro no Study finalmente voltaram ao normal! Agora o neurônio está realmente aprendendo.
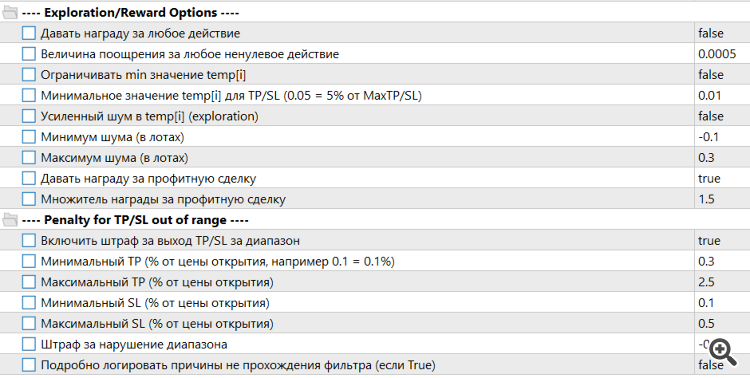
Tivemos de ampliar o algoritmo de recompensas e penalidades
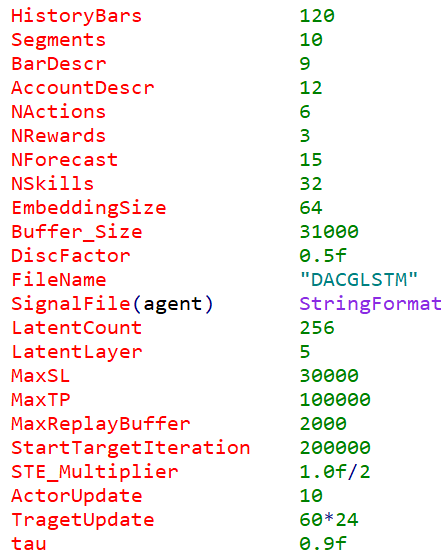
Também tivemos que fazer alguns ajustes importantes nos parâmetros de entrada do Trajectory.
Muito bom! Após várias semanas de dança do pandeiro, os valores de erro no Study finalmente voltaram ao normal! Agora o neurônio está realmente aprendendo.
O mais interessante agora é como ele negociará com novos dados... Estou fazendo modelos de madeira - eles são mais claros. Mas, com os novos dados, a negociação é quase aleatória, pois não há recursos significativos.
Agora, o mais interessante é como ele será negociado com novos dados... Estou fazendo modelos de madeira - eles são mais claros. Mas, com novos dados, a negociação é quase aleatória, pois não há características significativas.
Após algumas rodadas de Research-Study, as negociações começam a ser fechadas muito rapidamente. A Neuronka está aprendendo a sobreviver, não a ganhar dinheiro. E quanto mais curta a negociação, mais ela sente que está recebendo uma penalidade menor. A dança do pandeiro continua. Preciso acertar o algoritmo de recompensa e penalidade, e essa parece ser a parte mais difícil. Até agora, estou apenas tentando estabelecer alguns limites rígidos. Por exemplo, não permito definir paradas e retiradas menores que o valor limite. Também estou tentando limitar a vida útil mínima de uma negociação para que ela não seja fechada quase imediatamente após a abertura. Uso o LLM, o Grok ou o ChatGPT 4.1, mas às vezes eles são tão estúpidos que minha cabeça não consegue suportar. Mas, pouco a pouco, o progresso ainda está sendo feito. Muito tempo é gasto em círculos de aprendizado. Eu também gostaria de unir forças com alguém, pois o assunto é muito promissor.