Footprint MLP
- Indicadores
- Versión: 1.0
- Activaciones: 5

Footprint MLP transforma la actividad del mercado a nivel de tick en características de huella y utiliza un modelo de aprendizaje automático de perceptrón multicapa para aprender las relaciones no lineales entre el flujo de órdenes y el comportamiento futuro de los precios.
Captura el contexto temporal mediante entradas con desfase, estadísticas móviles, características de múltiples marcos temporales y datos de símbolos emparejados, con entrenamiento configurable, validación cronológica y selección de características.
- «Base Learn » entrena un modelo utilizando los parámetros configurados; el entrenamiento se lleva a cabo a lo largo de múltiples épocas y conjuntos «walk-forward».
- El «Genetic Learn» utiliza un algoritmo evolutivo para evaluar las configuraciones de modelo candidatas. La idoneidad de las candidatas se determina a partir de los resultados validados de los mejores puntos de control en los conjuntos «walk-forward». Esto permite al sistema explorar diferentes configuraciones de modelo y retener las candidatas más sólidas en función del rendimiento de la validación.
- El «Deep Learn» evalúa una cuadrícula estructurada de parámetros de modelo y de entrenamiento configurados. Los modelos candidatos se comparan utilizando los resultados de validación, y se retiene la configuración validada más sólida.
Dos modos de predicción
- El modode clasificación estima la dirección del movimiento futuro de los precios a lo largo del horizonte de predicción configurado. El modelo genera una salida con signo limitada por su función de activación configurada (-1/+1). El rendimiento se evalúa mediante la precisión direccional u otra puntuación de clasificación seleccionada.
- El modode regresión estima la rentabilidad futura en forma de porcentaje. Las opciones de regresión se evalúan principalmente mediante el error de validación, con una puntuación personalizada basada en el RMSE como principal métrica de selección y en las estadísticas de coincidencia direccional.
Herramientas
-
Extracción de características: cuando está habilitada, el sistema evalúa los conjuntos de entrada candidatos y entrena el modelo final utilizando las características seleccionadas que ofrecen el mejor resultado. -La extracción genética busca subconjuntos de características eficaces mediante un proceso de optimización evolutiva; esto permite al sistema probar combinaciones de características e identificar conjuntos de entrada más sólidos. -Extracción secuencial evalúa prefijos de características clasificados para identificar un tamaño de subconjunto eficaz. -Extracción de las mejores características clasifica las características por importancia y selecciona el número configurado de entradas mejor clasificadas.
- Entrenamiento y validación «walk-forward»: Los datoshistóricos se dividen cronológicamente en conjuntos «walk-forward»; cada conjunto contiene su propia ventana de entrenamiento y su propia ventana de validación; para cada conjunto «walk-forward», se selecciona la época con mejor rendimiento basándose en la evidencia de validación. Las configuraciones candidatas se clasifican utilizando sus puntos de control seleccionados, no simplemente los pesos de la última época; este enfoque evalúa el comportamiento del modelo a lo largo de múltiples ventanas históricas en lugar de basarse en una única división entre entrenamiento y validación.
- Parada temprana / Paciencia profunda: La «pacienciaprofunda» detiene el entrenamiento de un candidato tras el número configurado de épocas consecutivas sin mejora en su puntuación de selección de validación; la «parada temprana» detiene el entrenamiento de un candidato cuando la métrica de validación configurada alcanza o supera el umbral objetivo.
- Arquitectura de características en múltiples marcos temporales: El indicador permite configurar el marco temporal de las características independientemente del marco temporal del gráfico; las barras completadas del marco temporal de origen se alinean con las observaciones del marco temporal del gráfico, de modo que el modelo pueda utilizar el contexto de múltiples marcos temporales a la hora de predecir futuras velas en el marco temporal del gráfico. Esta estructura ayuda a mantener la coherencia cronológica, al tiempo que permite al modelo acceder a información de diferentes resoluciones de marcos temporales.
- Características de símbolos emparejados: Un símbolo emparejado opcional puede proporcionar contexto entre mercados durante la construcción de características y el entrenamiento.
- Calibración Ridge: La calibraciónRidge es una etapa opcional de refinamiento posterior al entrenamiento que se aplica a las predicciones brutas del modelo; utiliza una regresión lineal regularizada L2 para aprender una correspondencia estable entre la salida del modelo base y la predicción calibrada final. La penalización Ridge restringe los coeficientes de calibración, lo que reduce la sensibilidad ante resultados del modelo ruidosos o inestables y ayuda a evitar el sobreajuste a pequeñas variaciones en las puntuaciones sin procesar.
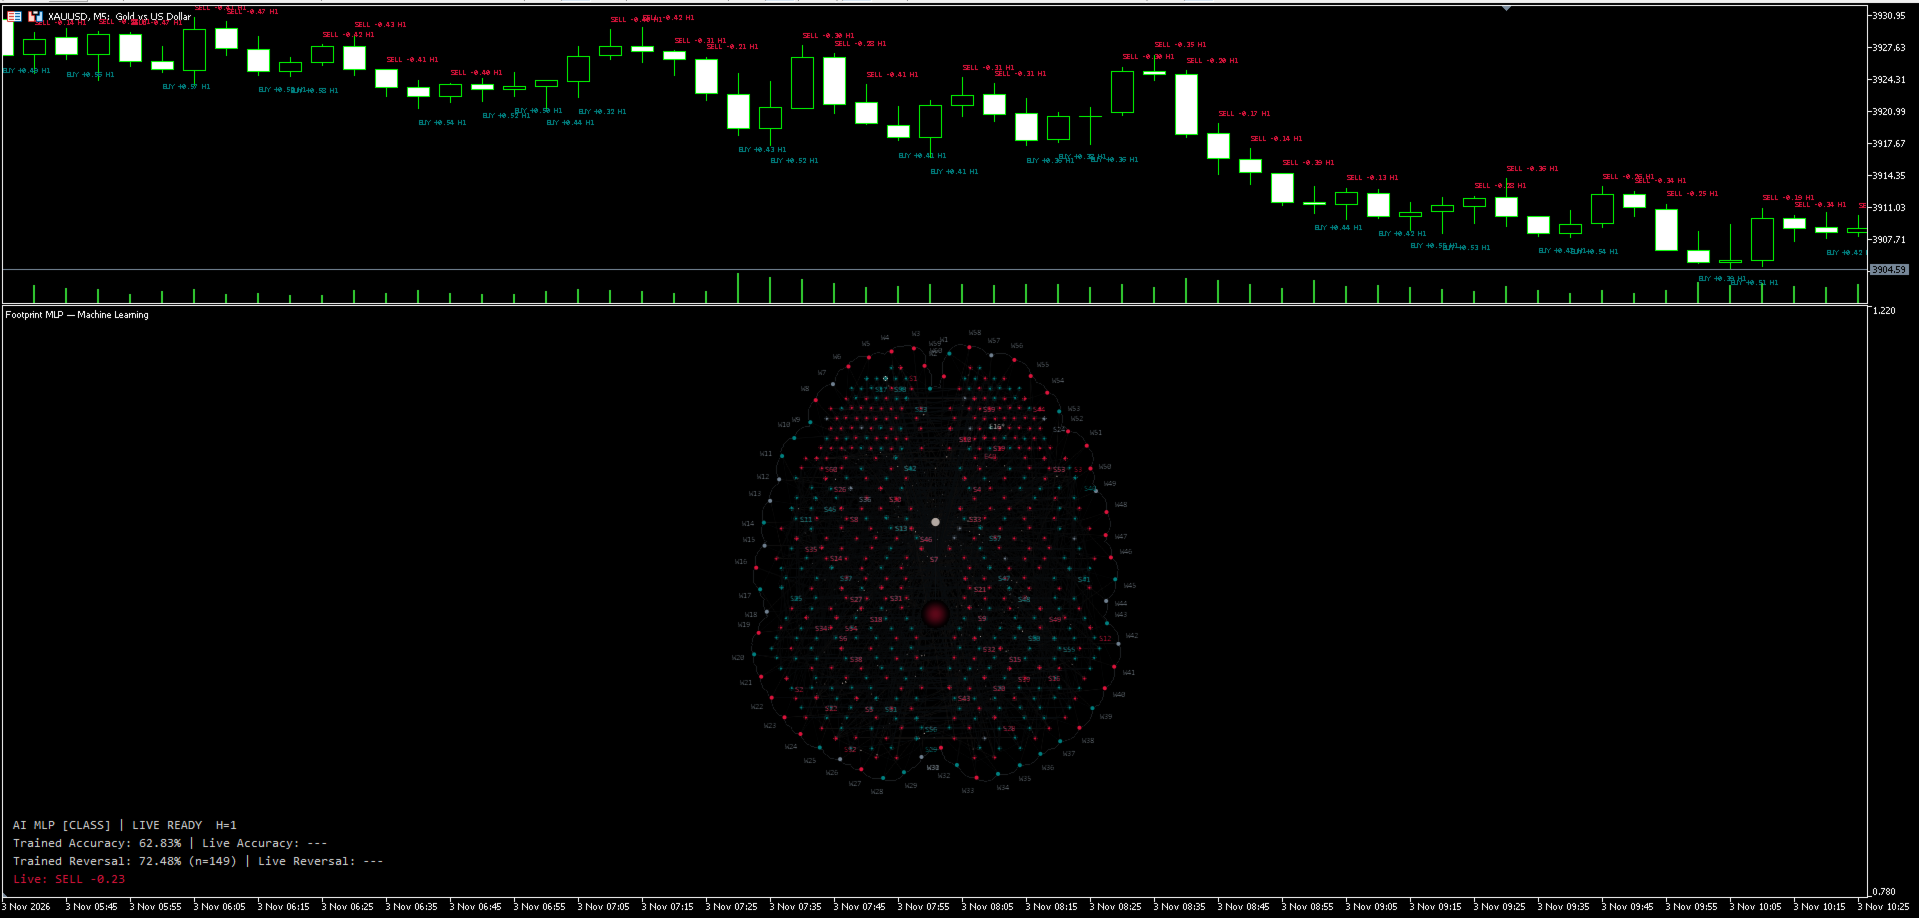
- Gráfico de aprendizaje automático: El gráfico de visualización muestra las relaciones entre las características de entrada, las épocas de entrenamiento, los modelos candidatos, los conjuntos de validación y las etapas de calibración; los nodos conectados y las rutas resaltadas ilustran cómo evolucionan los linajes de los modelos candidatos y conducen a la red neuronal del modelo seleccionado.
Nota: MT5 proporciona datos históricos nativos «tick a tick», lo que permite que las filas de «footprint» muestren el volumen real negociado y ejecutado en cada nivel de precio cuando el bróker facilita datos de volumen real.