Footprint MLP
- Indikatoren
- Version: 1.0
- Aktivierungen: 5

Footprint MLP wandelt Marktaktivitäten auf Tick-Ebene in Footprint-Merkmale um und nutzt ein maschinelles Lernmodell auf Basis eines mehrschichtigen Perzeptrons, um nichtlineare Zusammenhänge zwischen dem Orderfluss und dem zukünftigen Kursverhalten zu ermitteln.
Es erfasst den zeitlichen Kontext durch verzögerte Eingaben, rollierende Statistiken, Merkmale aus mehreren Zeitrahmen und gepaarte Symbol-Daten, wobei Training, chronologische Validierung und Merkmalsauswahl konfigurierbar sind.
- „Base Learn“ trainiert ein Modell unter Verwendung der konfigurierten Parameter; das Training erstreckt sich über mehrere Epochen und Walk-Forward-Sätze.
- „Genetic Learn“ nutzt einen evolutionären Algorithmus, um Kandidatenkonfigurationen für das Modell zu bewerten. Die Eignung der Kandidaten wird anhand der validierten Ergebnisse der besten Checkpoints über die Walk-Forward-Sätze hinweg bestimmt. Dies ermöglicht es dem System, verschiedene Modellkonfigurationen zu untersuchen und die stärksten Kandidaten auf der Grundlage der Validierungsleistung beizubehalten.
- „Deep Learn“ bewertet ein strukturiertes Raster aus konfigurierten Modell- und Trainingsparametern. Die Modellkandidaten werden anhand der Validierungsergebnisse verglichen, und die am besten validierte Konfiguration wird beibehalten.
Zwei Prognosemodi
- Der Klassifikationsmodus schätzt die Richtung der zukünftigen Kursbewegung über den konfigurierten Prognosehorizont. Das Modell liefert einen vorzeichenbehafteten Ausgabewert, der durch die konfigurierte Aktivierungsfunktion begrenzt ist (-1/+1). Die Leistung wird anhand der Richtungsgenauigkeit oder eines anderen ausgewählten Klassifikationswerts bewertet.
- DerRegressionsmodus schätzt die zukünftige Rendite in Prozent. Regressionskandidaten werden in erster Linie anhand des Validierungsfehlers bewertet, wobei ein benutzerdefinierter Score auf Basis des RMSE als Hauptauswahlkriterium sowie die „Directional-Match“-Statistik herangezogen werden.
Werkzeuge
-
Merkmalsextraktion: Wenn diese Option aktiviert ist, bewertet das System Kandidaten-Eingabemengen und trainiert das endgültige Modell unter Verwendung der ausgewählten Merkmale, die das beste Ergebnis liefern. -Die genetische Extraktion sucht mithilfe eines evolutionären Optimierungsprozesses nach effektiven Merkmalsuntermengen; dies ermöglicht es dem System, Kombinationen von Merkmalen zu testen und stärkere Eingabemengen zu identifizieren. -Sequential Extraction wertet rangierte Merkmalspräfixe aus, um eine effektive Teilmengengroße zu ermitteln. -Top Extraction ordnet Merkmale nach ihrer Wichtigkeit und wählt die konfigurierte Anzahl der am höchsten rangierenden Eingaben aus.
- Walk-Forward-Training und -Validierung: Historische Daten werden chronologisch in Walk-Forward-Sätze unterteilt; jeder Satz enthält ein eigenes Trainingsfenster und ein eigenes Validierungsfenster; für jeden Walk-Forward-Satz wird die Epochen mit der besten Leistung auf der Grundlage der Validierungsergebnisse ausgewählt. Kandidatenkonfigurationen werden anhand ihrer ausgewählten Checkpoints bewertet, nicht lediglich anhand der Gewichte aus der letzten Epoche; dieser Ansatz bewertet das Modellverhalten über mehrere historische Fenster hinweg, anstatt sich auf eine einzige Trennung zwischen Training und Validierung zu stützen.
- Early-Stop / Deep-Patience: „Deep-Patience“ beendet das Training eines Kandidaten nach der konfigurierten Anzahl aufeinanderfolgender Epochen, wenn sich dessen Validierungsauswahlwert nicht verbessert; „Early-Stop“ beendet das Training eines Kandidaten, sobald die konfigurierte Validierungsmetrik den Zielschwellenwert erreicht oder überschreitet.
- Architektur mit Merkmalen aus mehreren Zeitrahmen: Der Indikator ermöglicht es, den Zeitrahmen der Merkmale unabhängig vom Zeitrahmen des Charts zu konfigurieren; abgeschlossene Balken des Quellzeitrahmens werden an die Beobachtungen des Chart-Zeitrahmens angeglichen, sodass das Modell bei der Vorhersage zukünftiger Kerzen im Chart-Zeitrahmen den Kontext mehrerer Zeitrahmen nutzen kann. Diese Struktur trägt zur Wahrung der chronologischen Konsistenz bei und ermöglicht es dem Modell gleichzeitig, auf Informationen aus verschiedenen Zeitraumauflösungen zuzugreifen.
- Merkmale mit gepaarten Symbolen: Ein optionales gepaartes Symbol kann während der Merkmalskonstruktion und des Trainings marktübergreifenden Kontext liefern.
- Ridge-Kalibrierung: Die Ridge-Kalibrierung ist eine optionale Verfeinerungsphase nach dem Training, die auf die Rohvorhersagen des Modells angewendet wird; sie nutzt eine L2-regulierte lineare Regression, um eine stabile Abbildung von der Ausgabe des Basismodells auf die endgültige kalibrierte Vorhersage zu erlernen. Die Ridge-Straffung schränkt die Kalibrierungskoeffizienten ein, wodurch die Empfindlichkeit gegenüber verrauschten oder instabilen Modellausgaben verringert und eine Überanpassung an kleine Schwankungen der Rohwerte vermieden wird.
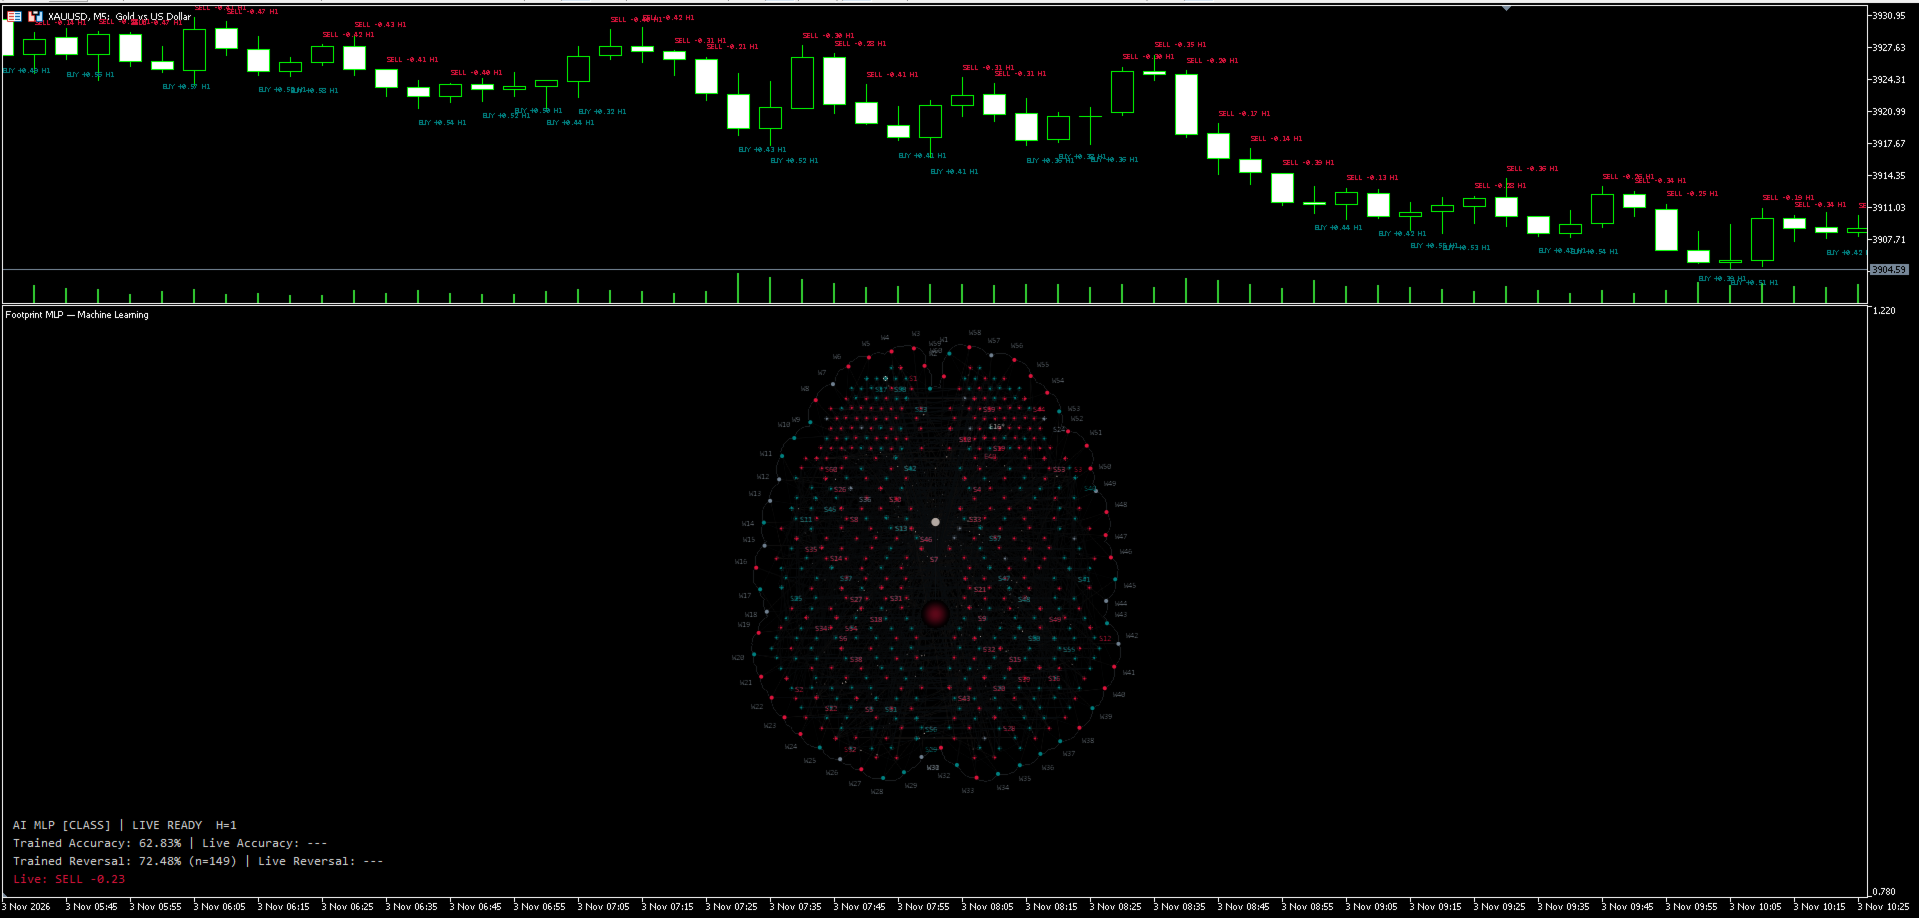
- ML-Diagramm: Das Visualisierungsdiagramm zeigt Beziehungen zwischen Eingabemerkmalen, Trainings-Epochen, Modellkandidaten, Validierungssätzen und Kalibrierungsphasen an; verbundene Knoten und hervorgehobene Pfade veranschaulichen, wie sich die Modellkandidaten-Linien entwickeln und zum ausgewählten neuronalen Modellnetzwerk führen.
Hinweis: MT5 stellt native historische Tick-by-Tick-Daten bereit, sodass in den Footprint-Zeilen das gemeldete, tatsächlich gehandelte Volumen angezeigt werden kann, das auf jeder Preisstufe ausgeführt wurde, sofern der Broker Echtvolumendaten bereitstellt.